


Top 15 plateformes et bibliothèques d'IA open source
Déployer votre propre model d’IA ou, dans certains cas, effectuer le fine-tuning de models préexistants s’accompagne de plusieurs défis :
- Choisir un fournisseur cloud : Vous pouvez vous intégrer profondément à un fournisseur, ce qui rend difficile d’en changer plus tard si nécessaire.
- Pénurie de ressources GPU : Si votre déploiement est limité à une zone géographique, vous pouvez rencontrer des pénuries de ressources GPU disponibles en raison d’une forte demande dans cette région.
- Enfermement propriétaire et évolutivité : De nombreuses plateformes vous lient à des services cloud spécifiques.
Les plateformes open source offrant des APIs unifiées aident à relever ces défis en permettant un déploiement multi-cloud et en optimisant la gestion des ressources GPU. Ci-dessous, nous listons 15 exemples de plateformes/bibliothèques open source :
Outil / Plateforme | Catégorie | Idéal pour & principaux atouts |
|---|---|---|
TensorFlow | Frameworks de machine learning | ML en production, entraînement évolutif, pipelines de déploiement |
PyTorch | Frameworks de machine learning | Recherche, expérimentation, prototypage en deep learning |
JAX | Frameworks de machine learning | Calcul numérique rapide, recherche avancée en ML |
Keras | Frameworks de machine learning | Débutants, développement rapide de models, deep learning simplifié |
Scikit-learn | Frameworks de machine learning | ML traditionnel, workflows faciles à utiliser, datasets petits et moyens |
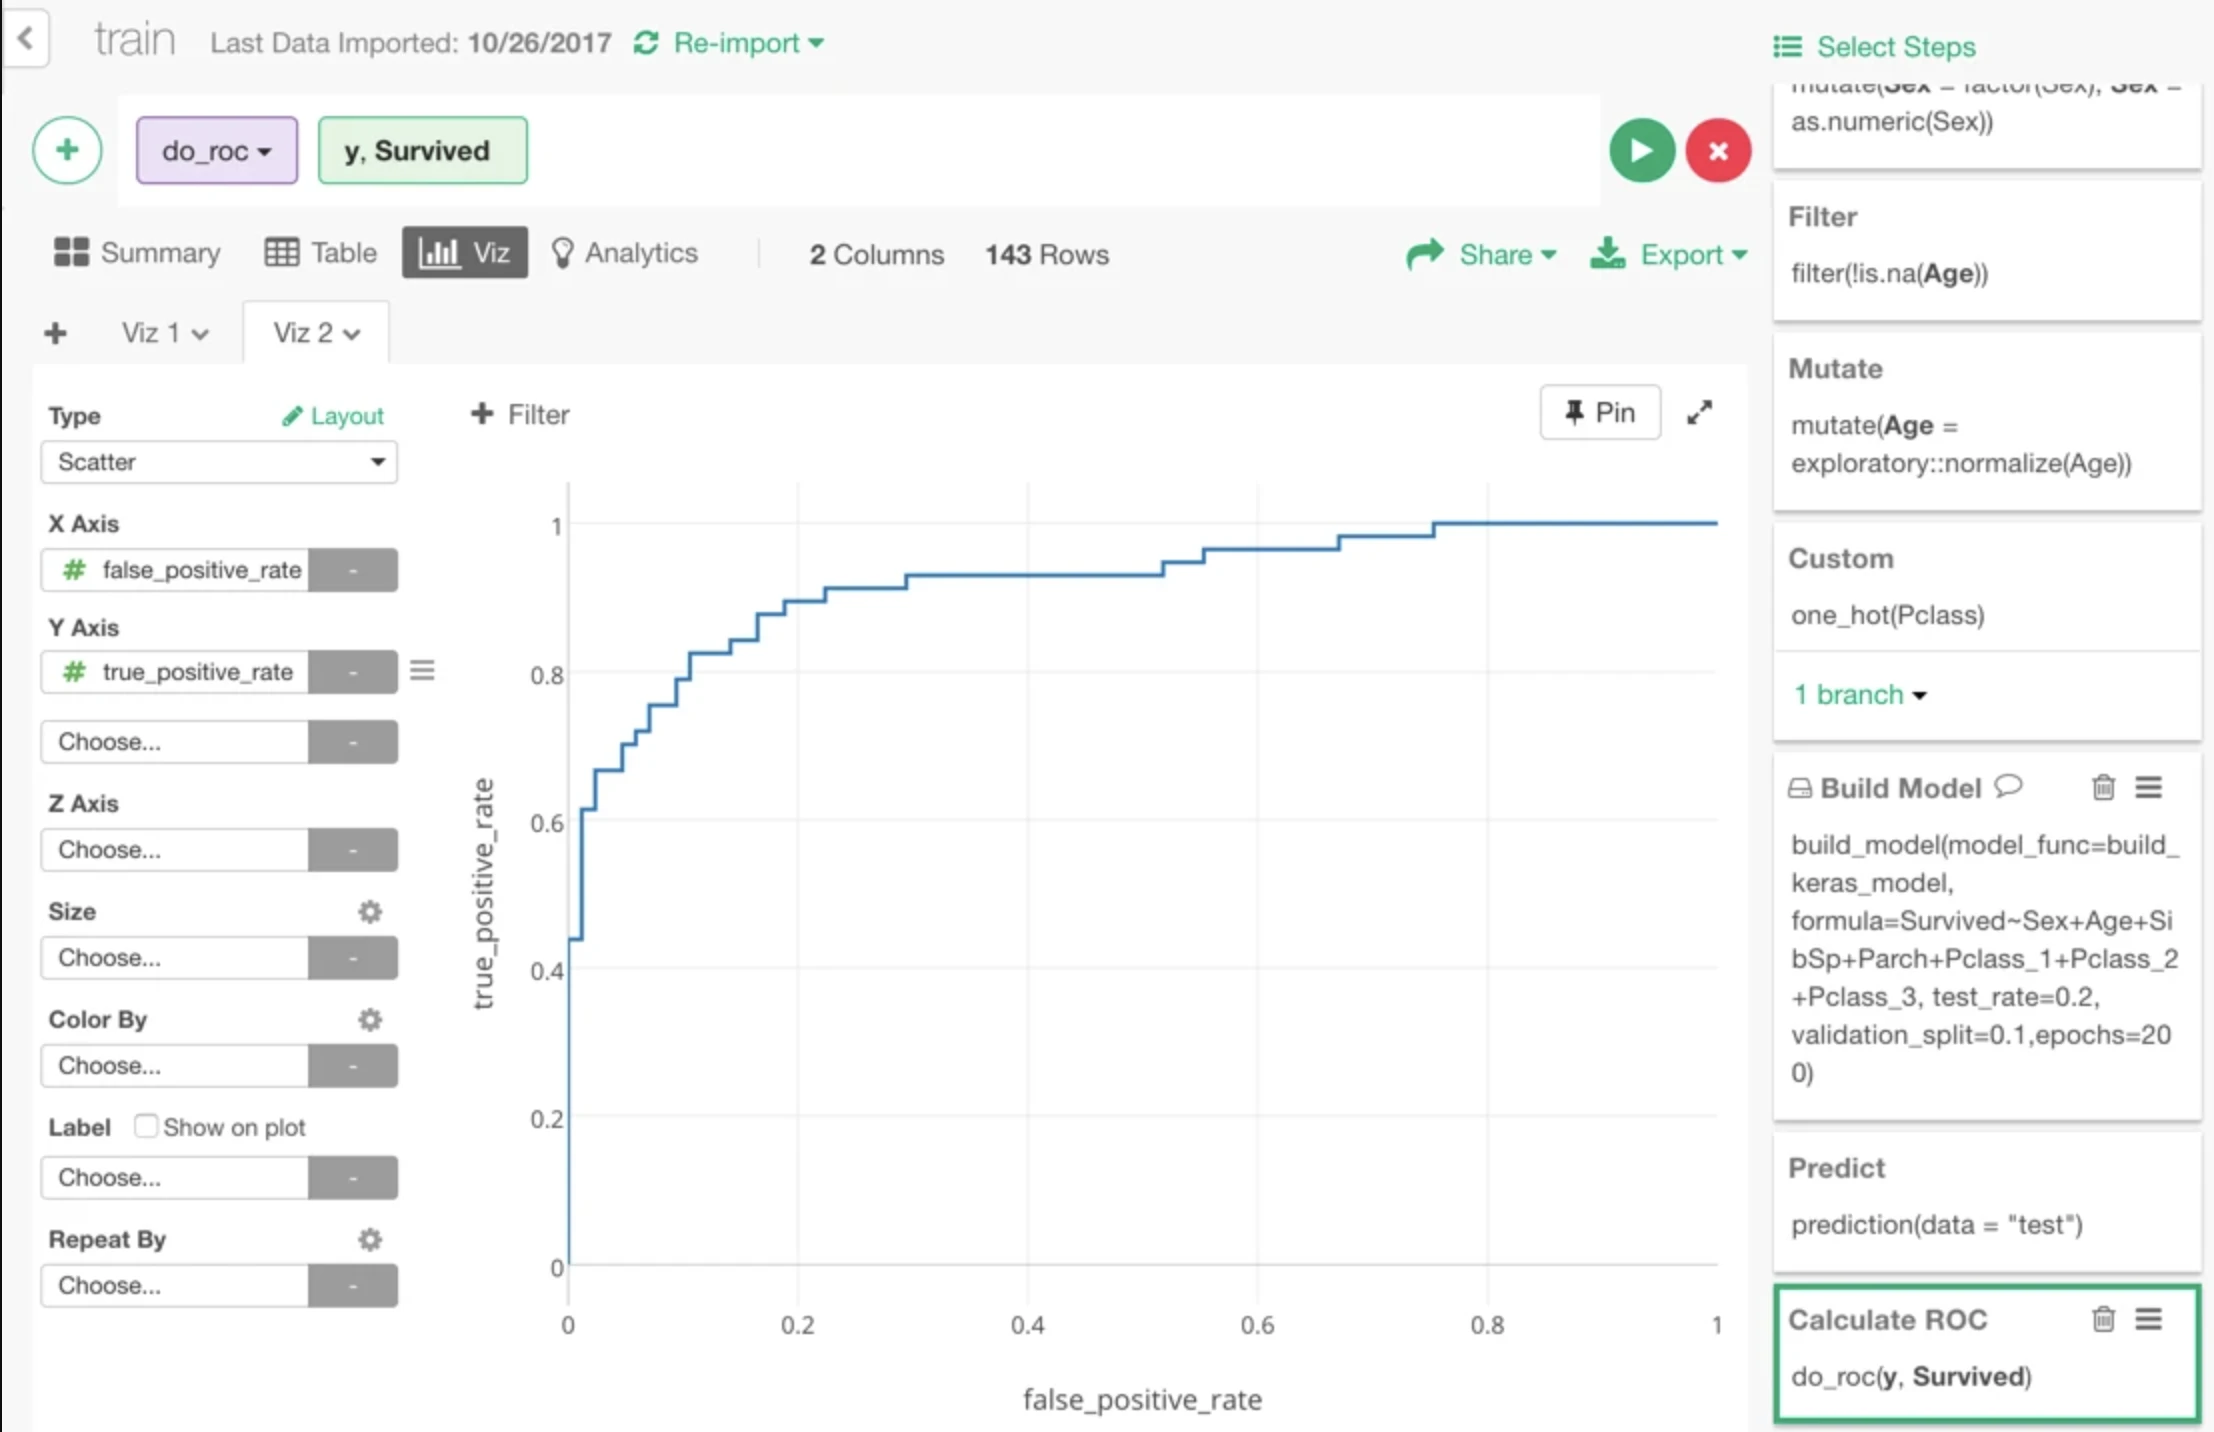
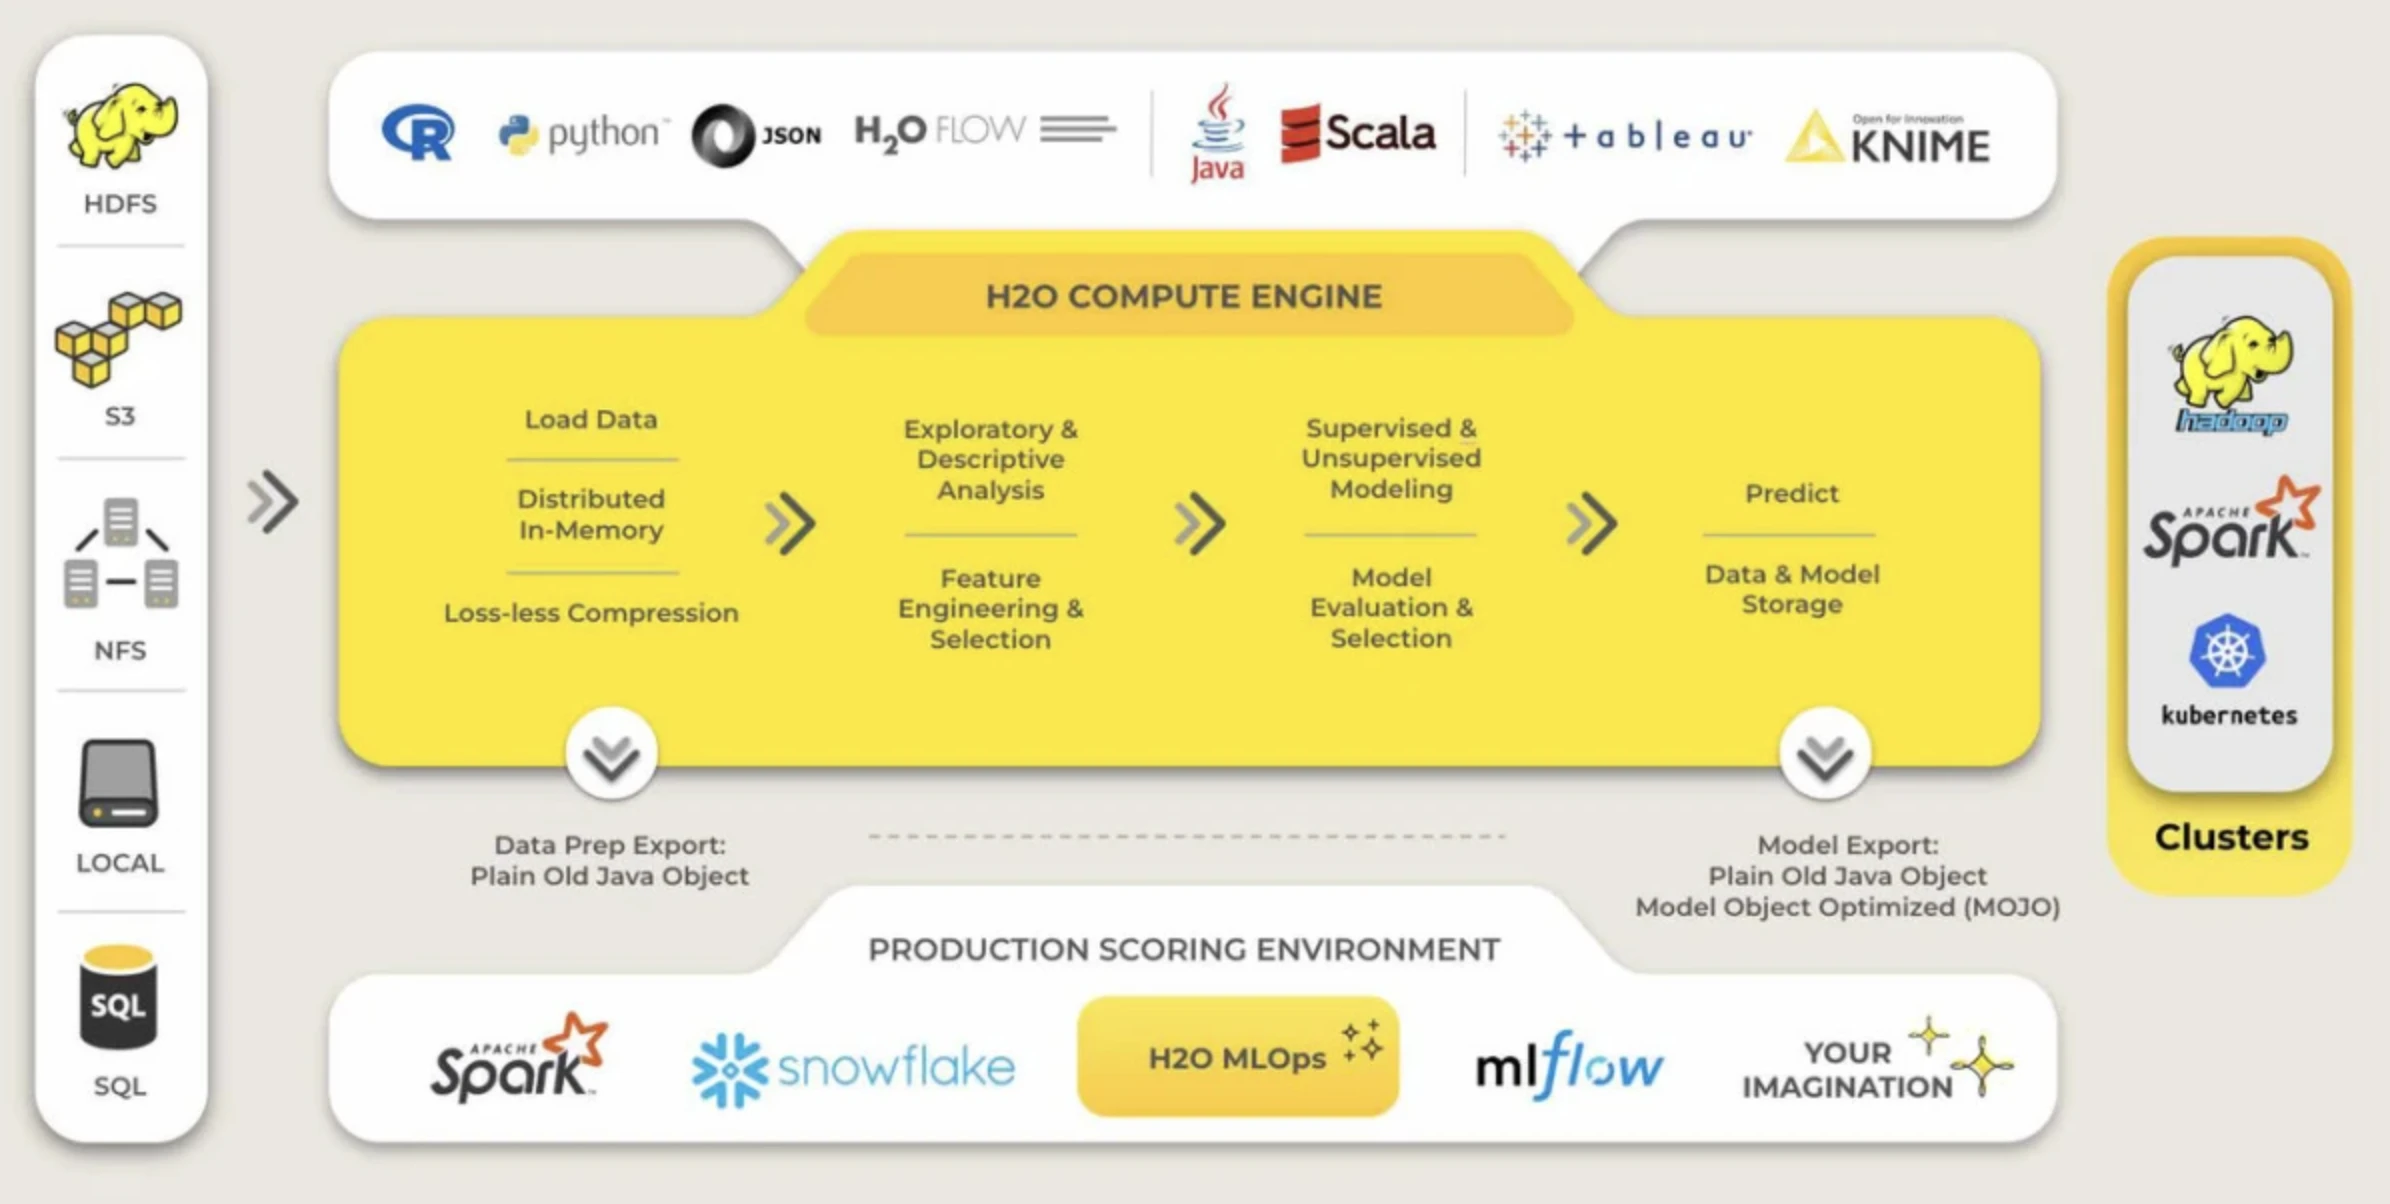
H2O.ai | Plateformes d’AutoML et de ML distribué | AutoML, ML sur big data, construction de models scalable |
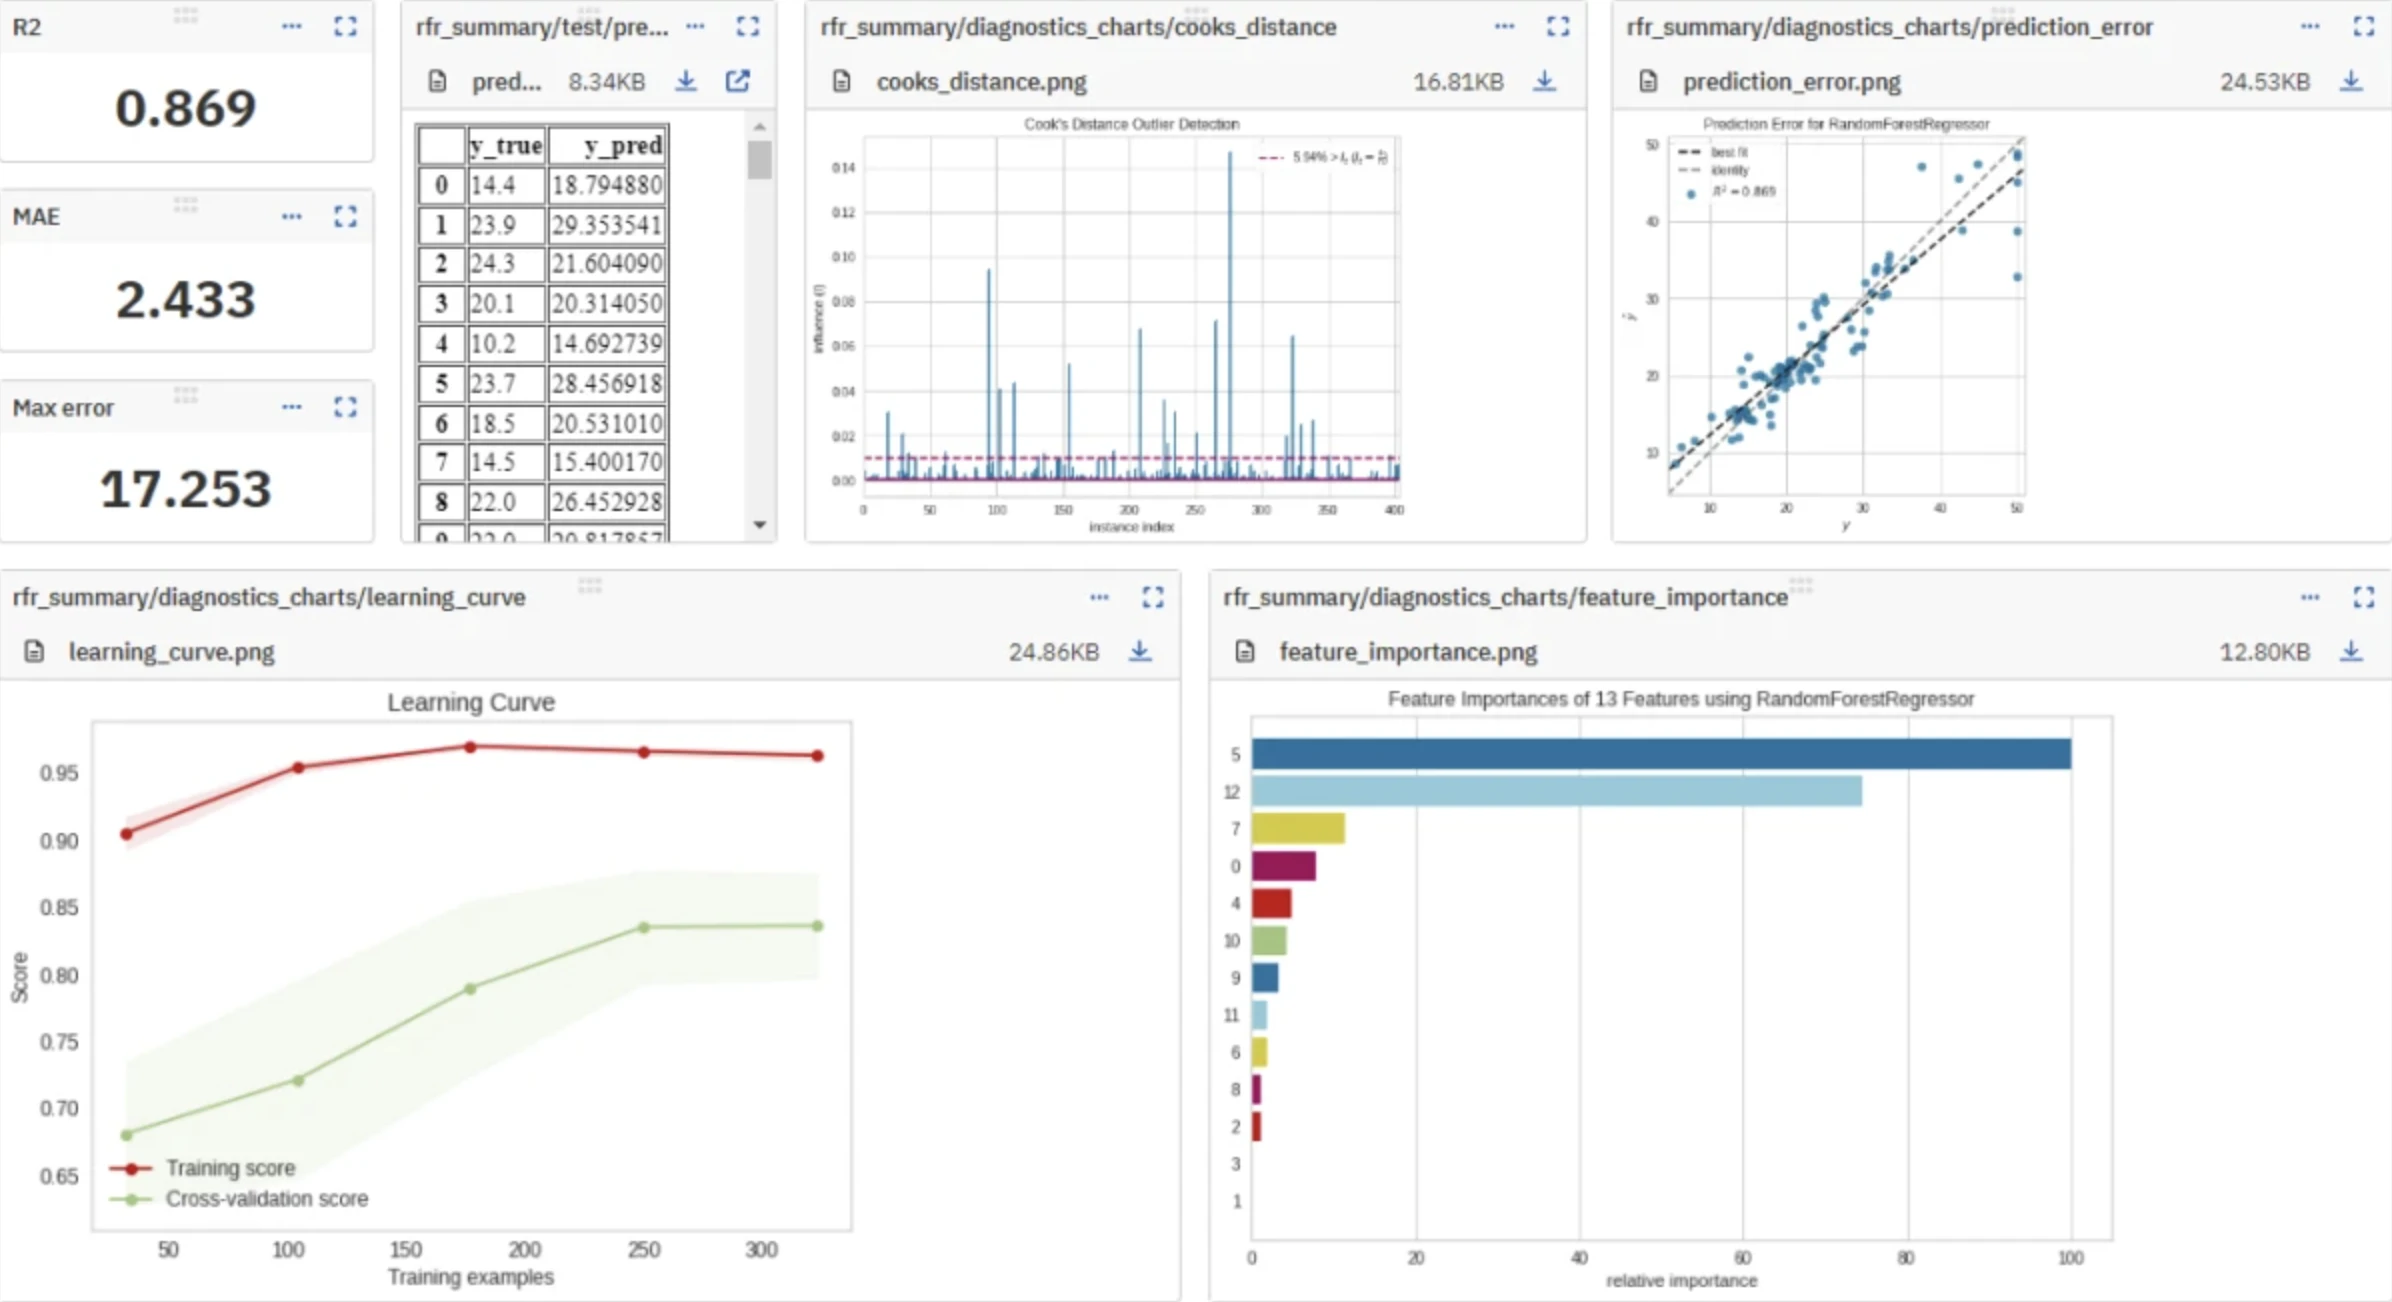
MLflow | Plateformes d’AutoML et de ML distribué | Suivi des expériences, gestion des models, workflows de ML reproductibles |
Hugging Face Transformers | Écosystèmes de Large Language Model | Models pré-entraînés, NLP, IA multimodale, partage de models |
GPT4All | Écosystèmes de Large Language Model | Utilisation locale de LLM, inference hors ligne, workflows axés sur la confidentialité |
Open WebUI | Écosystèmes de Large Language Model | Interfaces LLM auto-hébergées, récupération documentaire, extensibilité |
Bref aperçu des plateformes et bibliothèques open source
Lors du choix de ces plateformes, nous sommes principalement concentrés sur leur capacité à monter en charge, leur facilité d’intégration et leur aptitude à une utilisation en entreprise.
Vous pouvez cliquer sur les liens pour explorer des explications détaillées pour chacune :
1. Frameworks de machine learning :
- TensorFlow : Une bibliothèque pour l’entraînement ML à grande échelle et le déploiement en production. Permet l’entraînement de models sur CPUs, GPUs et TPU.
- PyTorch : Un framework de deep learning pythonique avec des graphes de calcul dynamiques. Idéal pour la recherche et l’expérimentation en deep learning. Prise en charge limitée des TPU.
- JAX : Une plateforme de calcul numérique haute performance et de recherche en ML. Vise une exécution rapide des calculs numériques sur CPUs, GPUs et TPU.
- Keras : Une API de haut niveau pour le deep learning qui s’exécute sur des frameworks comme TensorFlow. Sa syntaxe est adaptée aux débutants.
- Scikit-learn : Une bibliothèque Python open source pour les tâches de ML classiques telles que la classification, la régression et le clustering. Fournit une API facile à utiliser. Fonctionne bien sur des datasets de petite et moyenne taille.
2. Plateformes d’AutoML et de ML distribué :
- H2O.ai : Une plateforme distribuée pour automatiser les workflows de ML sur le big data.
- MLflow : Une plateforme de gestion du cycle de vie du ML. Elle prend en charge le suivi des expériences, le packaging des models et fonctionne avec TensorFlow, PyTorch, scikit-learn, R.
3. Écosystèmes de Large Language Model (LLM) :
- Hugging Face Transformers : Une plateforme/bibliothèque avec 63 000+ models pré-entraînés pour les tâches de texte, de vision, d’audio et multimodales. Elle s’intègre avec TensorFlow, PyTorch et JAX.
- GPT4All : Un écosystème pour exécuter des LLMs localement sur des CPUs ou des GPUs, en ligne ou hors ligne. Prend en charge 1 000+ models comme LLaMA, Mistral et DeepSeek R1.
- Open WebUI : Interface web auto-hébergée pour interagir avec des LLMs qui prend en charge plusieurs fournisseurs de models, la récupération documentaire (RAG) et des plugins extensibles.
4. Plateformes d’IA conversationnelle :
- Rasa : Plateforme de création de chatbots et d’assistants virtuels. Offre des outils de revue des conversations, d’étiquetage et de collaboration.
- Botpress : Plateforme avec conception visuelle de flux et intégrations GPT. Combine la construction par glisser-déposer avec une personnalisation au niveau du code.
5. Plateformes d’agents :
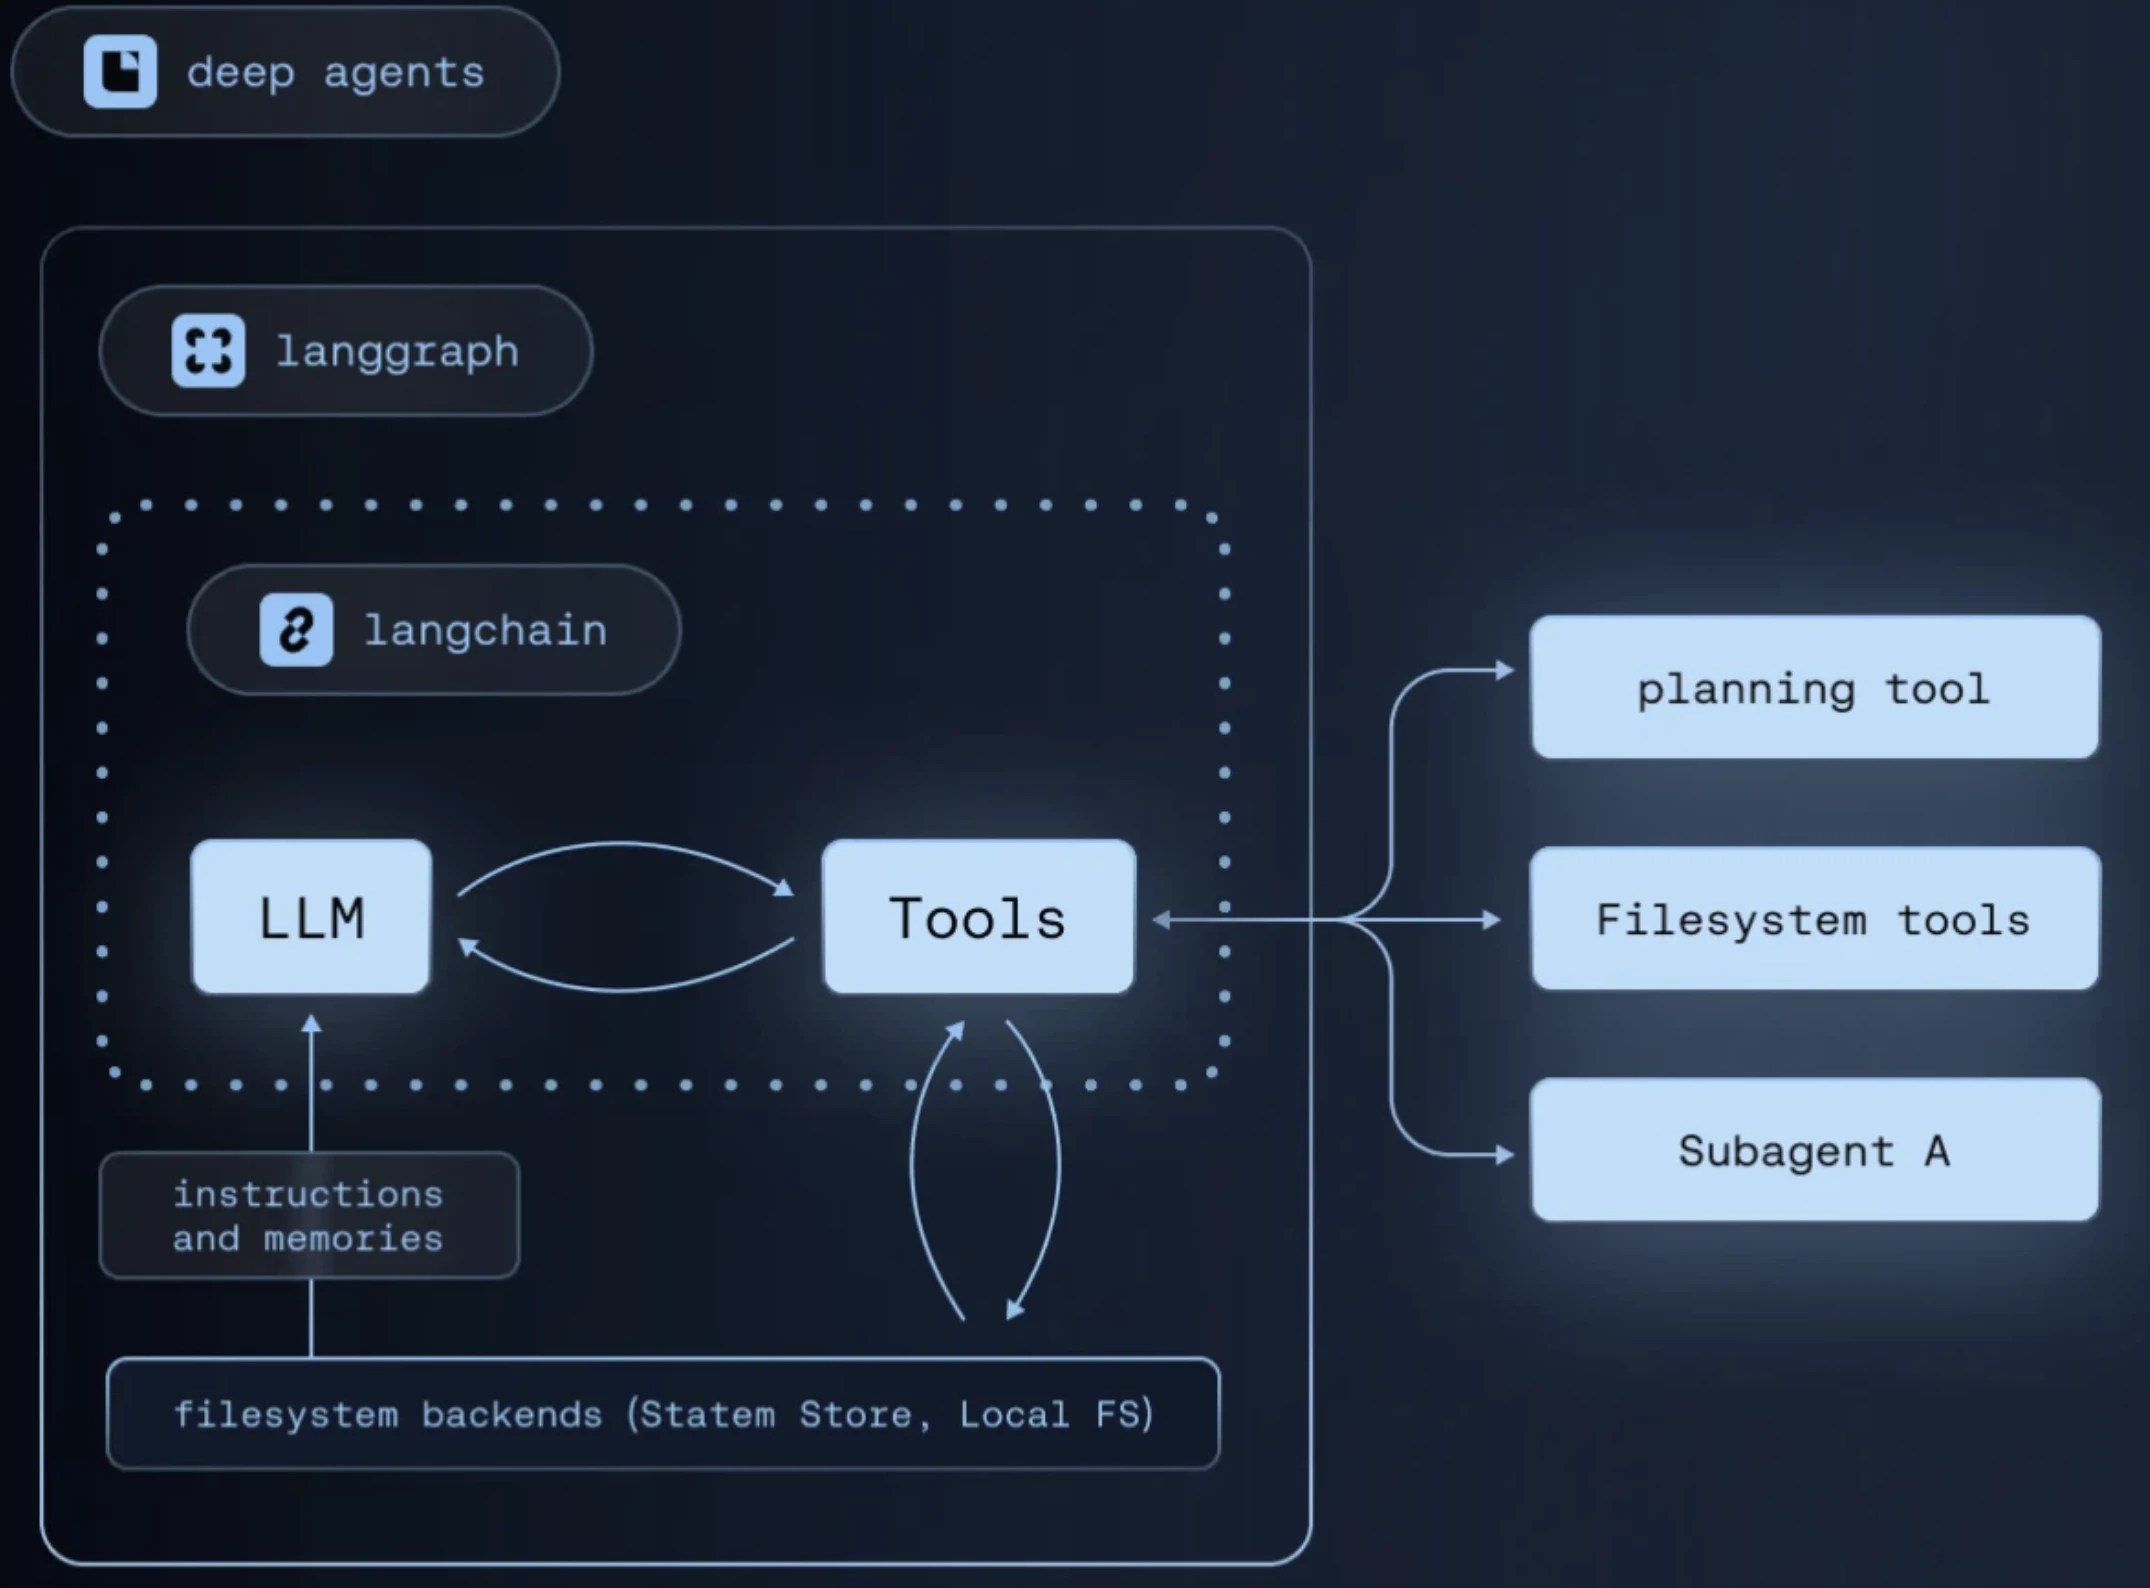
- Langchain Deep Agents : Fournit un framework pour créer des agents IA avec planification des tâches, délégation à des sous-agents, mémoire persistante et capacités d’intégration d’outils.
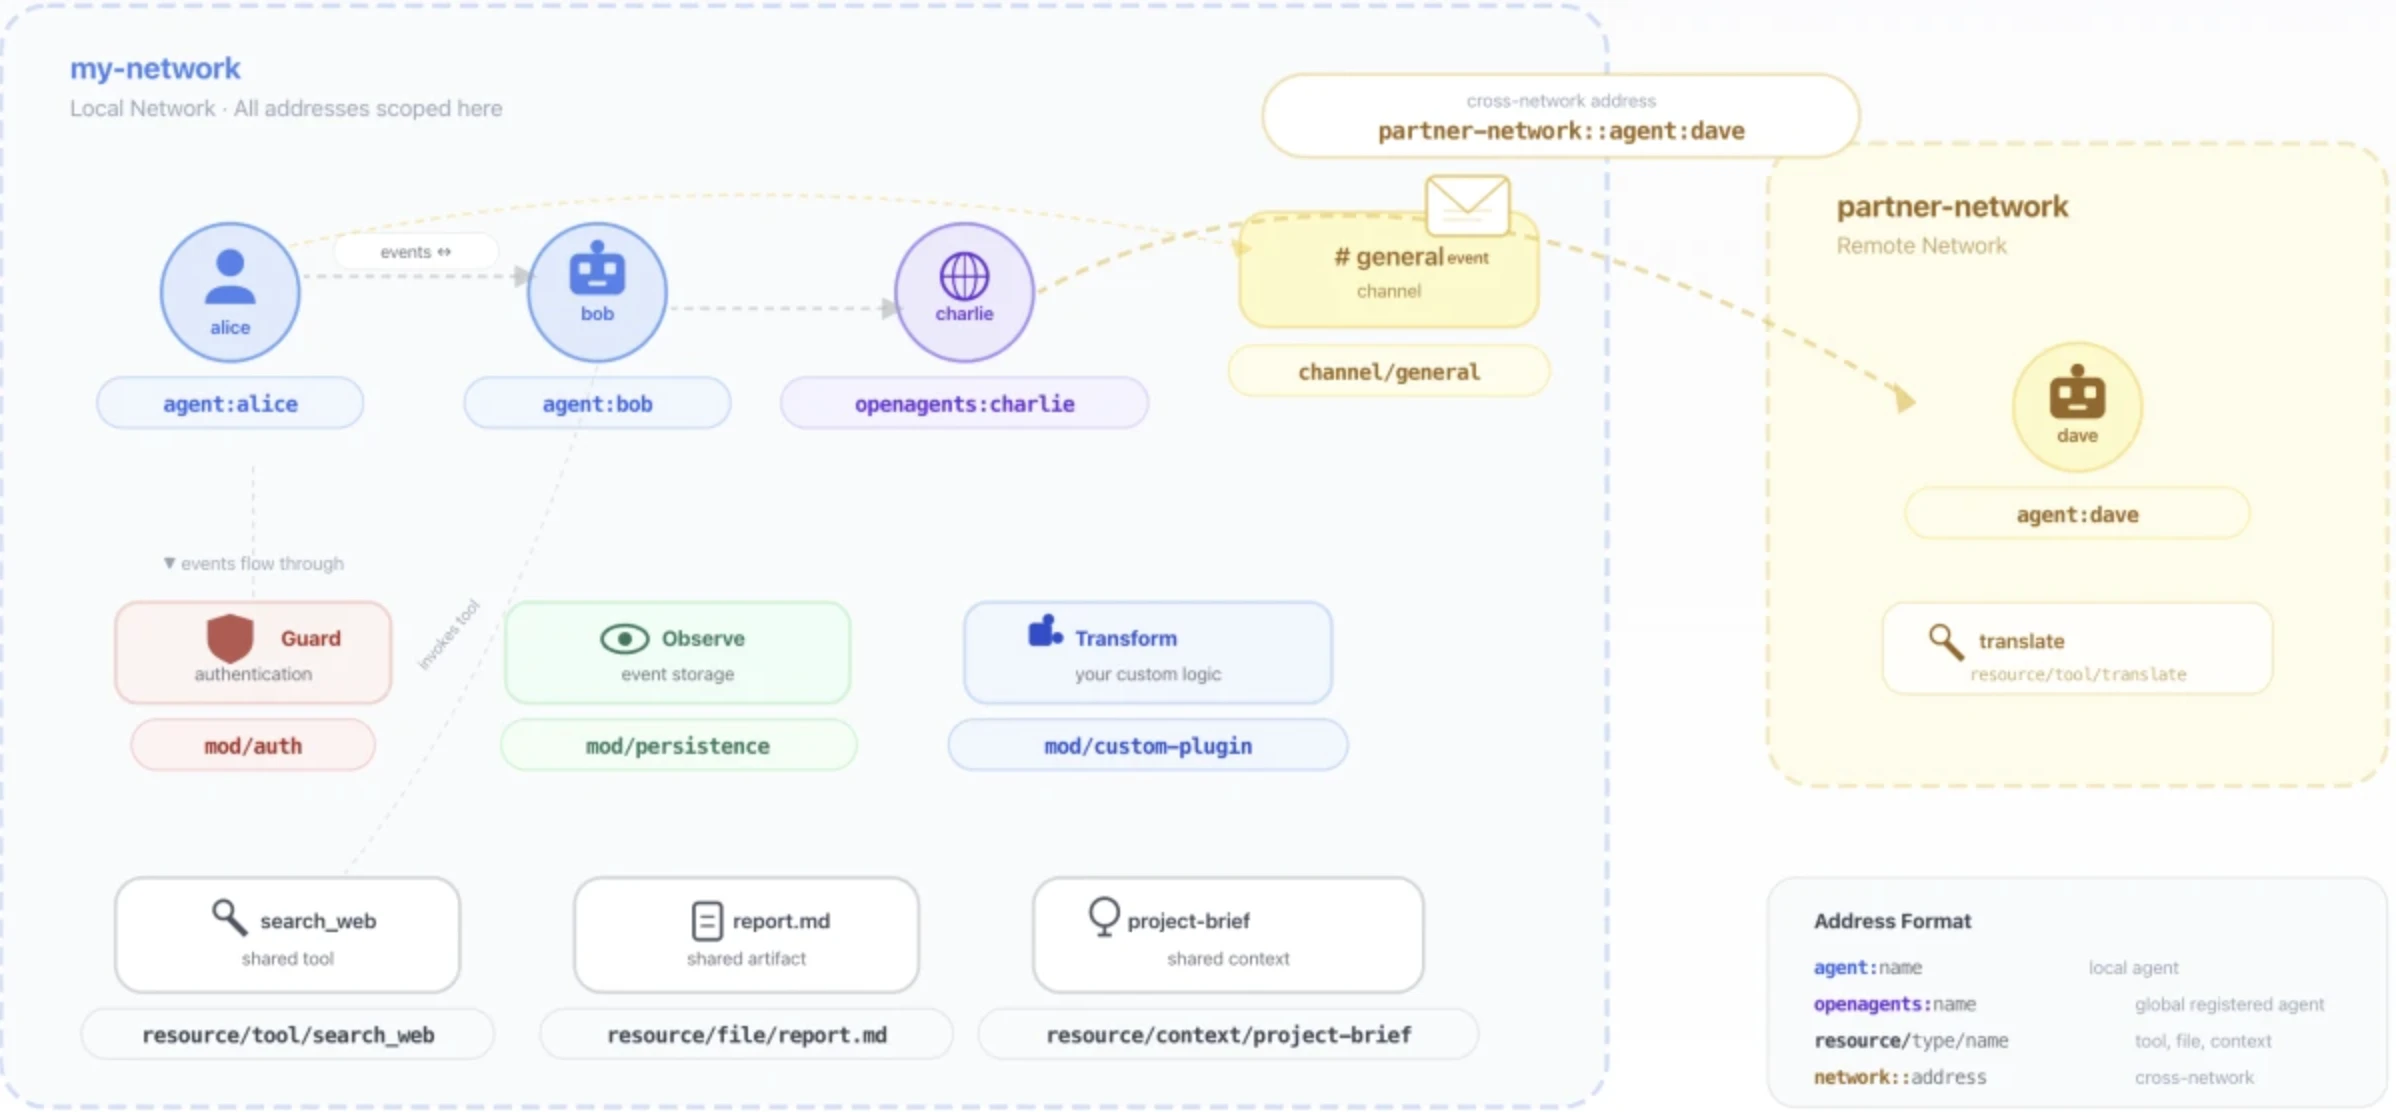
- OpenAgents : Permet à des réseaux d’agents IA de se découvrir mutuellement, de communiquer et de collaborer sur des tâches grâce à une architecture modulaire et à des protocoles de communication standardisés.
- OpenClaw : Agit comme une passerelle auto-hébergée qui connecte les models d’IA aux plateformes de messagerie, permettant aux utilisateurs d’automatiser des tâches.
1. Frameworks de machine learning
TensorFlow
TensorFlow, développé par l’équipe Google Brain, est une bibliothèque open source de calcul numérique et de machine learning à grande échelle. Elle utilise des graphes de flux de données (un diagramme où les opérations sont des nœuds et les données circulent le long de lignes de connexion) pour construire des models, ce qui la rend scalable et adaptée à la production.
TensorFlow prend en charge plusieurs types de matériel, notamment les CPUs, les GPUs, permettant un déploiement sur le web, le mobile, l’edge et les systèmes d’entreprise.
- Abstraction avec Keras : TensorFlow s’intègre à Keras, une API de haut niveau qui réduit la complexité de la construction et de l’entraînement des models. Cela facilite la prise en main pour les débutants tout en offrant des possibilités de personnalisation.
- Prêt pour la production : TensorFlow est largement utilisé en production. Il prend en charge le calcul distribué (exécution sur de nombreuses machines à la fois) et propose des outils de déploiement comme TensorFlow Serving, TensorFlow Lite et TensorFlow.js.
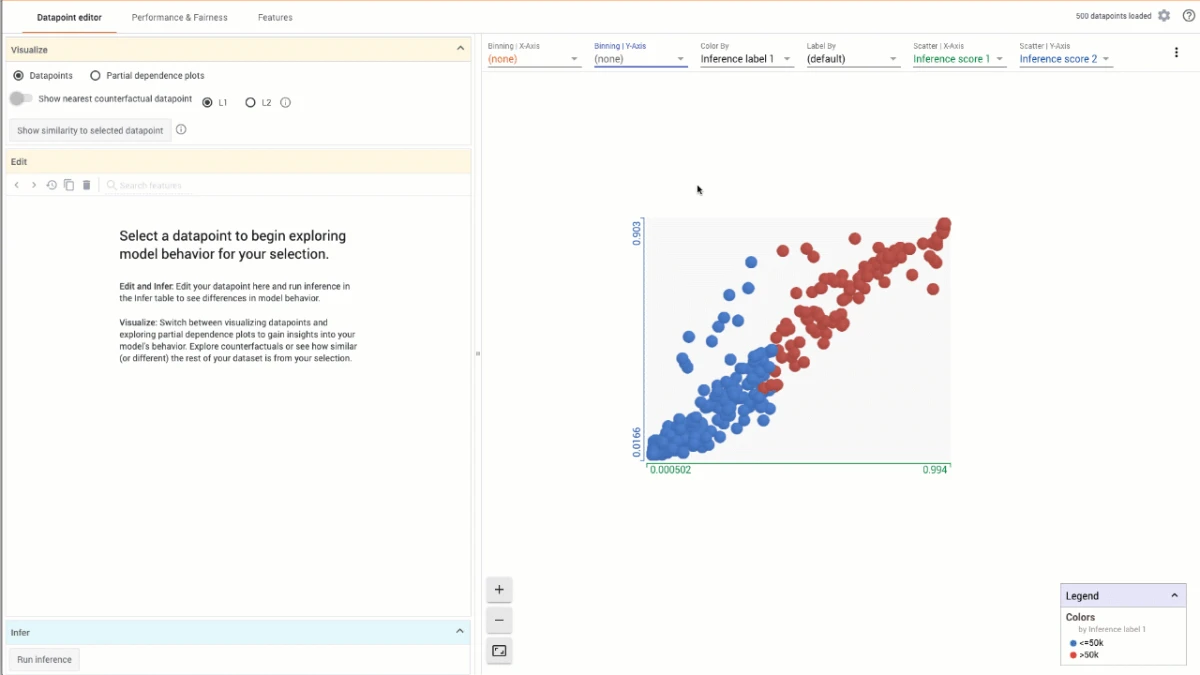
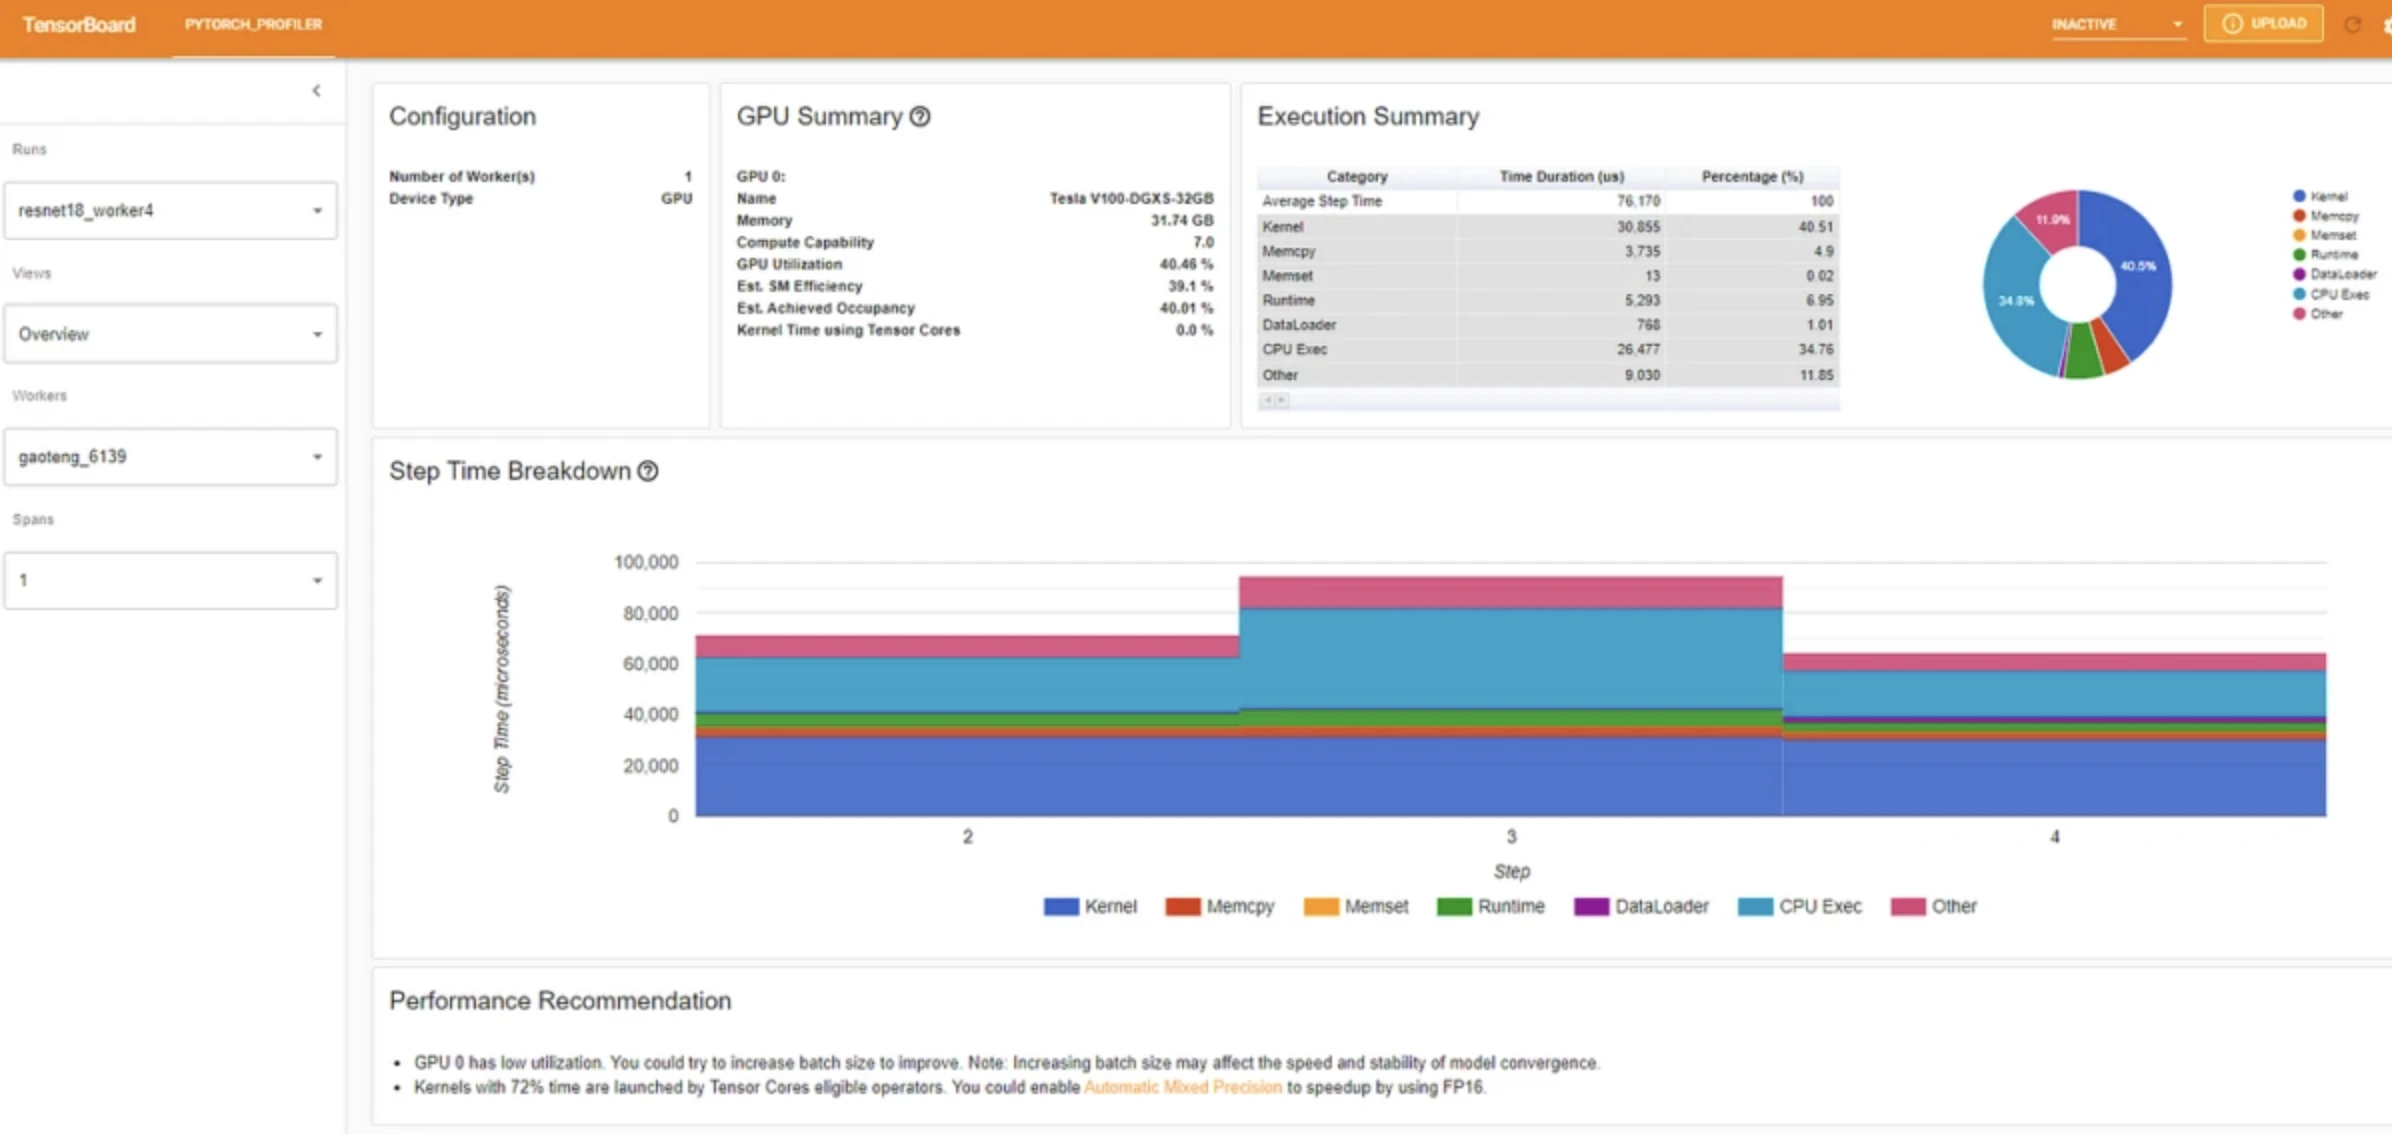
- TensorBoard : Inclut TensorBoard, un outil de visualisation pour suivre l’entraînement, les performances et la structure des models. Utile pour le débogage et l’optimisation.
Limites de TensorFlow
- Principalement axé sur les données numériques : TensorFlow est adapté au calcul numérique (par exemple, les données d’images, de texte et de signaux), mais il est moins efficace pour les tâches de raisonnement symbolique telles que le traitement de règles ou le raisonnement sur graphes de connaissances.
PyTorch
PyTorch, développé par le laboratoire de recherche en IA de Facebook, est une bibliothèque open source de machine learning et de deep learning.
- Maturité de l’écosystème : PyTorch soutient la recherche avec des graphes de calcul dynamiques et l’interopérabilité des models via ONNX.
- Le déploiement en production est de plus en plus assuré par des frameworks de serving externes tels que vLLM et NVIDIA Triton Inference Server. Les outils antérieurs, comme TorchServe, auparavant utilisés pour le déploiement de models, ont été archivés et ne sont plus activement maintenus.
- Graphes de calcul dynamiques : Permet de modifier l’architecture du model pendant l’exécution, offrant une flexibilité pour l’expérimentation et la recherche.
- Facilité de débogage : Semblable à un langage de programmation, PyTorch fournit des messages d’erreur détaillés et prend en charge le débogage pas à pas.
- PyTorch Lightning : Un wrapper piloté par la communauté qui rationalise le code PyTorch grâce à des abstractions de haut niveau. Bien qu’il ne fasse pas officiellement partie de PyTorch, il améliore l’utilisabilité et est souvent comparé à Keras de TensorFlow.
Limites de PyTorch
- Principalement axé sur le deep learning : PyTorch est fortement optimisé pour les réseaux de neurones profonds, mais peut être moins polyvalent pour des tâches d’IA plus larges telles que la modélisation probabiliste.
JAX
Google Research a présenté publiquement JAX vers 2018.
Le nom signifie « Just Another XLA », XLA faisant référence à Accelerated Linear Algebra. JAX est reconnu pour ses atouts en calcul numérique et en différenciation automatique.
- Différenciation automatique : JAX peut calculer automatiquement le degré d’ajustement de chaque paramètre d’un model pour en améliorer la précision.
- Ce processus est appelé rétropropagation (comparaison de la prédiction du model avec le résultat correct, puis propagation de l’erreur en arrière dans le réseau pour mettre à jour ses paramètres).
- En automatisant ces calculs, JAX élimine le besoin de coder manuellement les gradients.
- Accélération matérielle : Fonctionne sur les CPUs, les GPUs et les TPU.
- Parallélisation et vectorisation : Répartit automatiquement les charges de travail sur plusieurs appareils, améliorant ainsi l’évolutivité.
Limites de JAX
- Écosystème plus restreint : Comparé à TensorFlow ou PyTorch, JAX dispose de moins de bibliothèques tierces et de tutoriels.
- Outils de production limités : Ne dispose pas d’une suite mature d’outils de déploiement prêts pour la production.
Remarque : Bien qu’il ne s’agisse pas de plateformes d’IA complètes, des bibliothèques comme Keras (une API de haut niveau pour le deep learning) et Scikit-learn (pour le machine learning classique) sont souvent incluses dans les outils d’IA open source :
Keras
Keras est une API de haut niveau pour la construction et l’entraînement de models de deep learning. Elle fonctionne principalement au-dessus de TensorFlow, bien qu’elle puisse également s’intégrer à d’autres backends. Son API de haut niveau est intuitive pour les débutants, tout en étant suffisamment flexible pour le développement de réseaux de neurones plus complexes.
- Flexibilité du backend : Fonctionne sur plusieurs backends tels que TensorFlow et PyTorch.
- Implémentation efficace : Prend en charge la compilation XLA (algèbre linéaire accélérée) pour accélérer l’entraînement et l’inference des models.
Limites de Keras
- Contrôle de bas niveau : Offre un contrôle moins fin que l’utilisation directe de bibliothèques backend comme TensorFlow ou PyTorch.
- Portée étroite : Principalement conçu pour le deep learning.
Scikit-learn
Scikit-learn (souvent appelé sklearn) est une bibliothèque Python open source pour le machine learning. Elle est construite au-dessus de NumPy (calcul numérique) et de Matplotlib (visualisation de données), et fournit une large gamme d’outils pour le prétraitement des données, la modélisation et l’évaluation.
La bibliothèque se concentre sur les tâches fondamentales de machine learning telles que la classification, la régression et le clustering.
- Large couverture algorithmique : Implémente la plupart des techniques classiques de ML, notamment la régression linéaire, les arbres de décision, les SVM, les k-moyennes et les méthodes d’ensemble.
- Intégration : Construite au-dessus de NumPy et de SciPy, elle est compatible avec l’écosystème plus large de la science des données en Python.
Limites de Scikit-learn
- Non adapté au deep learning : Contrairement à TensorFlow ou PyTorch, il ne gère pas les réseaux de neurones ni les tâches de deep learning à grande échelle.
- Limites de performances : Optimisé pour les datasets de petite à moyenne taille ; moins efficace sur des données à grande échelle que les frameworks distribués.
- Moins spécialisé pour la production : Principalement conçu pour la recherche et le prototypage plutôt que pour un déploiement à grande échelle.
2. Plateformes d’AutoML et de ML distribué
H2O.ai
H2O.ai est une plateforme de machine learning distribuée en mémoire. Elle prend en charge des algorithmes statistiques et de machine learning couramment utilisés, tels que les gradient boosted machines (GBM), les modèles linéaires généralisés (GLM) et le deep learning.
- Workflows automatisés : Exécute le processus de machine learning de bout en bout (entraînement, réglage et évaluation de plusieurs models) dans un délai défini par l’utilisateur.
- Traitement distribué en mémoire : Les données sont traitées sur plusieurs nœuds (machines ou serveurs) d’un réseau, chaque nœud stockant une partie des données en mémoire (RAM) plutôt que de dépendre d’un stockage disque plus lent. Ainsi, si vous analysez des téraoctets de données, disposer des données en mémoire permet des calculs plus rapides.
Limites de H2O.ai
- Gourmand en ressources : La conception distribuée en mémoire peut nécessiter des ressources informatiques importantes.
- Moins de flexibilité pour la recherche : Optimisé pour le machine learning appliqué et les workflows d’AutoML. Pas adapté aux tâches de recherche personnalisées.
MLflow
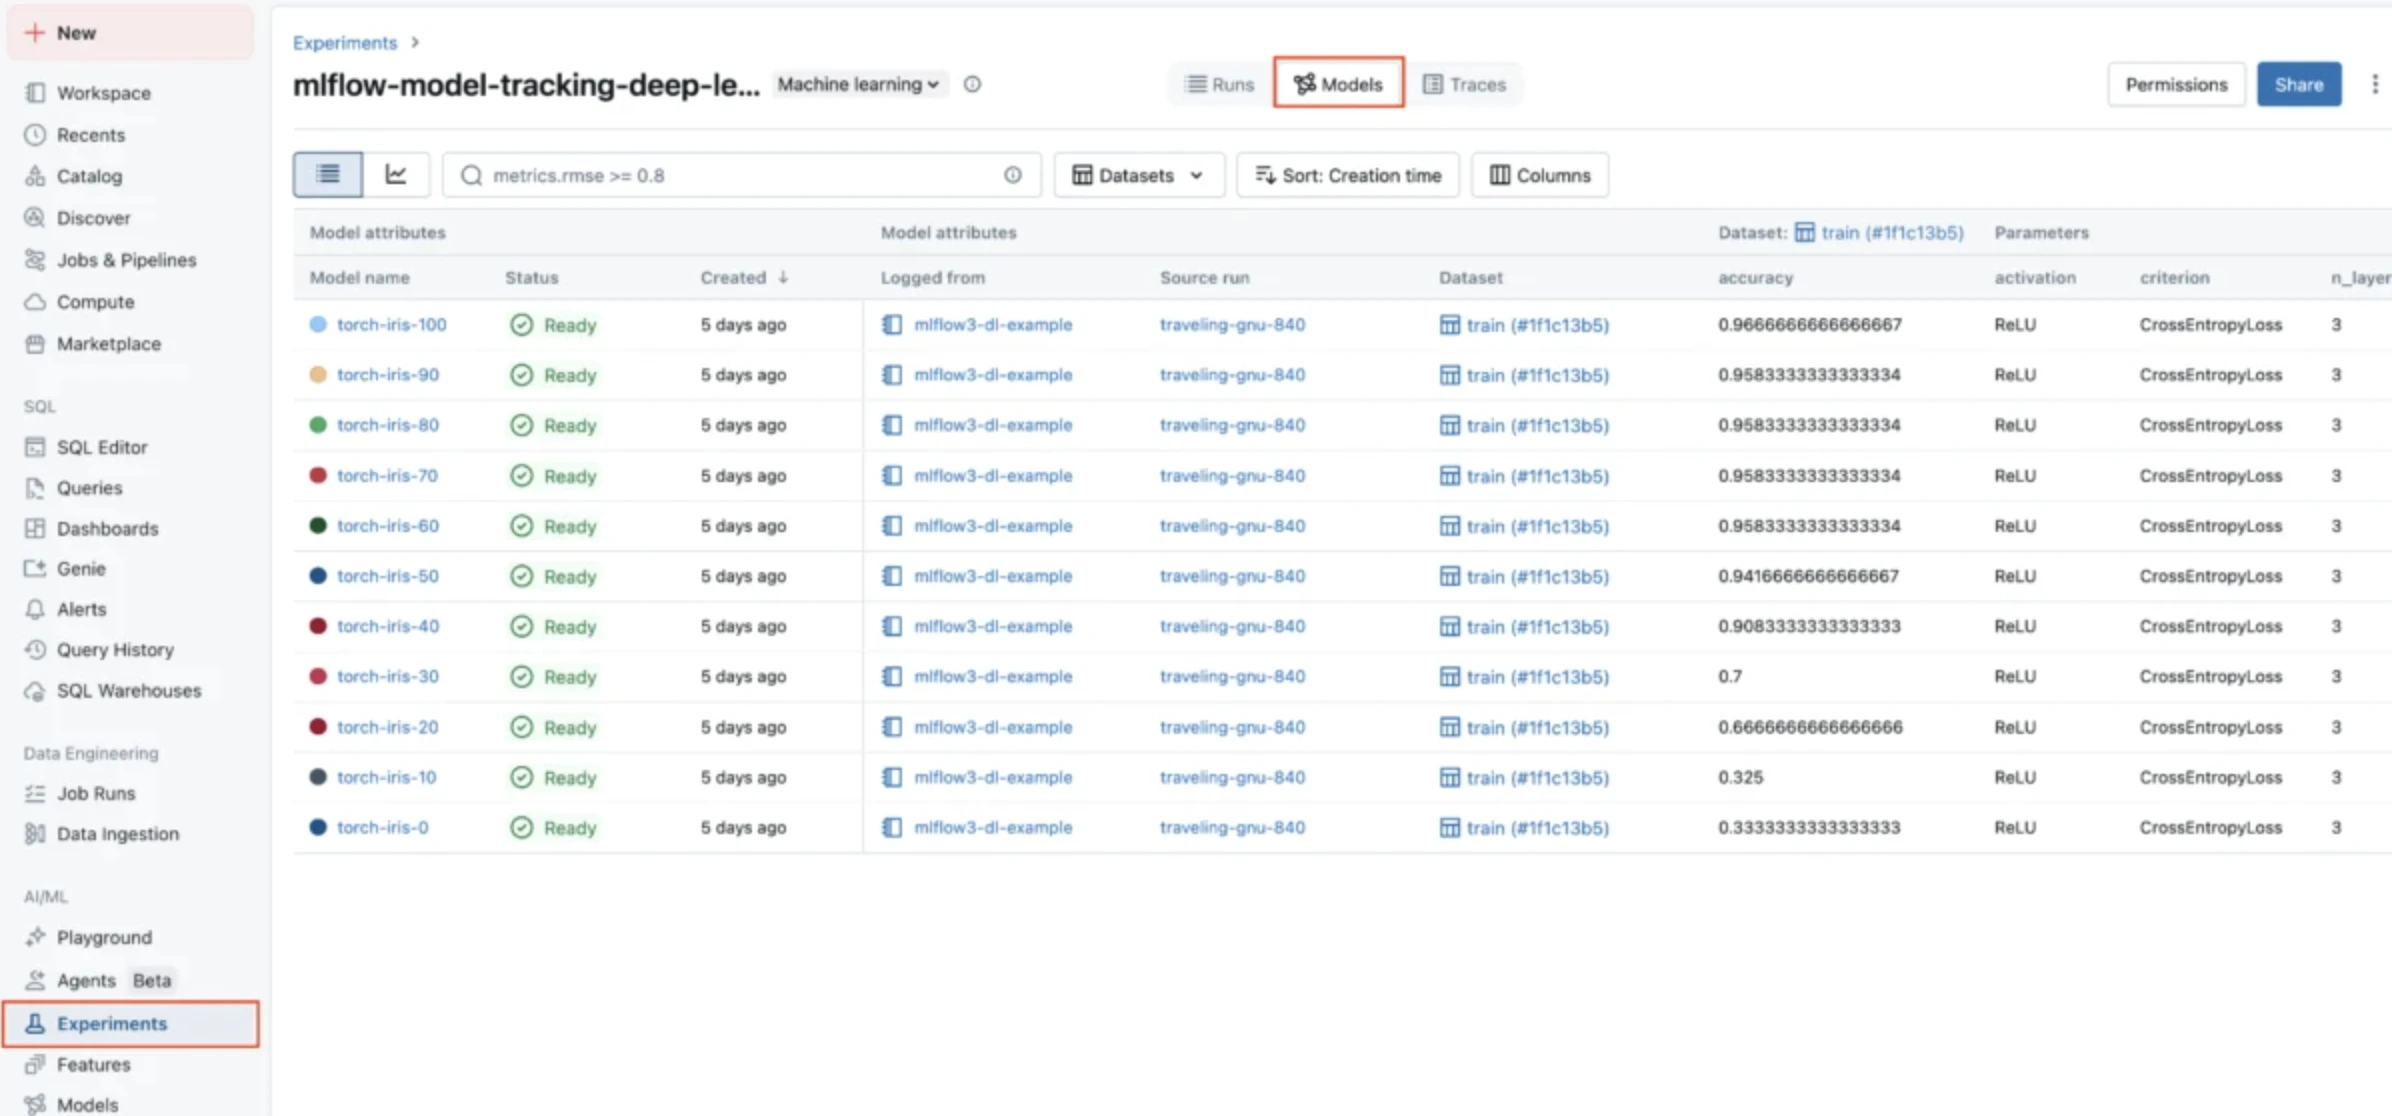
MLflow est une plateforme open source conçue pour soutenir le développement de models de machine learning et d’applications d’IA générative. Elle comporte quatre composants fondamentaux :
- Suivi : Permet le suivi des expériences en journalisant les paramètres, les métriques et les résultats, ce qui facilite la comparaison des différentes exécutions.
- Models : Offre des outils pour empaqueter, gérer et déployer des models issus de diverses bibliothèques de ML vers plusieurs environnements de serving et d’inference.
- Évaluation et traçage des agents IA : Aide les développeurs à construire des agents IA fiables en offrant des capacités d’évaluation, de comparaison et de débogage des comportements des agents.
- Registre de models : Facilite la gestion du cycle de vie des models, y compris le contrôle des versions, les transitions d’étapes (de la phase de préproduction à la production) et les annotations.
Fonctionnalités :
- Suivi des expériences : Journalise et compare les paramètres, les métriques, les artefacts et les résultats afin que les équipes puissent reproduire les expériences et identifier les models les plus performants.
- Registre de models : Référentiel centralisé pour gérer le cycle de vie des models, y compris la gestion des versions (conservation de différentes versions enregistrées d’un model) et les annotations (ajout de notes ou de métadonnées de contexte).
- Large prise en charge des frameworks et des APIs : Compatible avec Python, Java, R et les APIs REST, et s’intègre aux frameworks de ML populaires tels que Scikit-learn, TensorFlow, PyTorch et XGBoost.
Limites de MLflow
- Complexité de la mise à l’échelle : Faire fonctionner MLflow à grande échelle nécessite une infrastructure importante (bases de données, serveurs de suivi).
- Orchestration limitée : MLflow ne fournit pas nativement d’orchestration des workflows ; une intégration avec des outils comme Airflow, Kubeflow ou Prefect est nécessaire.
3. Écosystèmes de Large Language Model (LLM)
Hugging Face Transformers
Hugging Face Transformers est une bibliothèque open source fournissant des models pré-entraînés pour l’inference et l’entraînement. La bibliothèque est principalement construite autour de PyTorch, avec une prise en charge du développement de models à grande échelle, des utilitaires d’entraînement et un déploiement simplifié grâce aux pipelines et aux trainers.
La prise en charge de JAX est disponible via des intégrations avec Keras, tandis que la prise en charge antérieure de TensorFlow a été supprimée dans les versions récentes.
Hugging Face héberge des models pour différents domaines :
- Texte
- Vision
- Audio
- Multimodal
Fonctionnalités clés :
- Models transformers pré-entraînés : Hugging Face propose des millions de models pré-entraînés (entraînés sur de grands datasets, ce qui permet aux utilisateurs de les fine-tuner ou de les appliquer directement sans repartir de zéro).
- Communauté active et documentation : Des tutoriels, des guides et des contributions fréquentes maintiennent la bibliothèque à jour avec les dernières avancées.
Limites de Hugging Face Transformers
- Exigences de calcul élevées : De nombreux models nécessitent du matériel puissant (GPUs/TPU) pour fonctionner efficacement.
- Qualité variable des models : Les models issus de la communauté peuvent être obsolètes ou maintenus de manière incohérente.
GPT4All
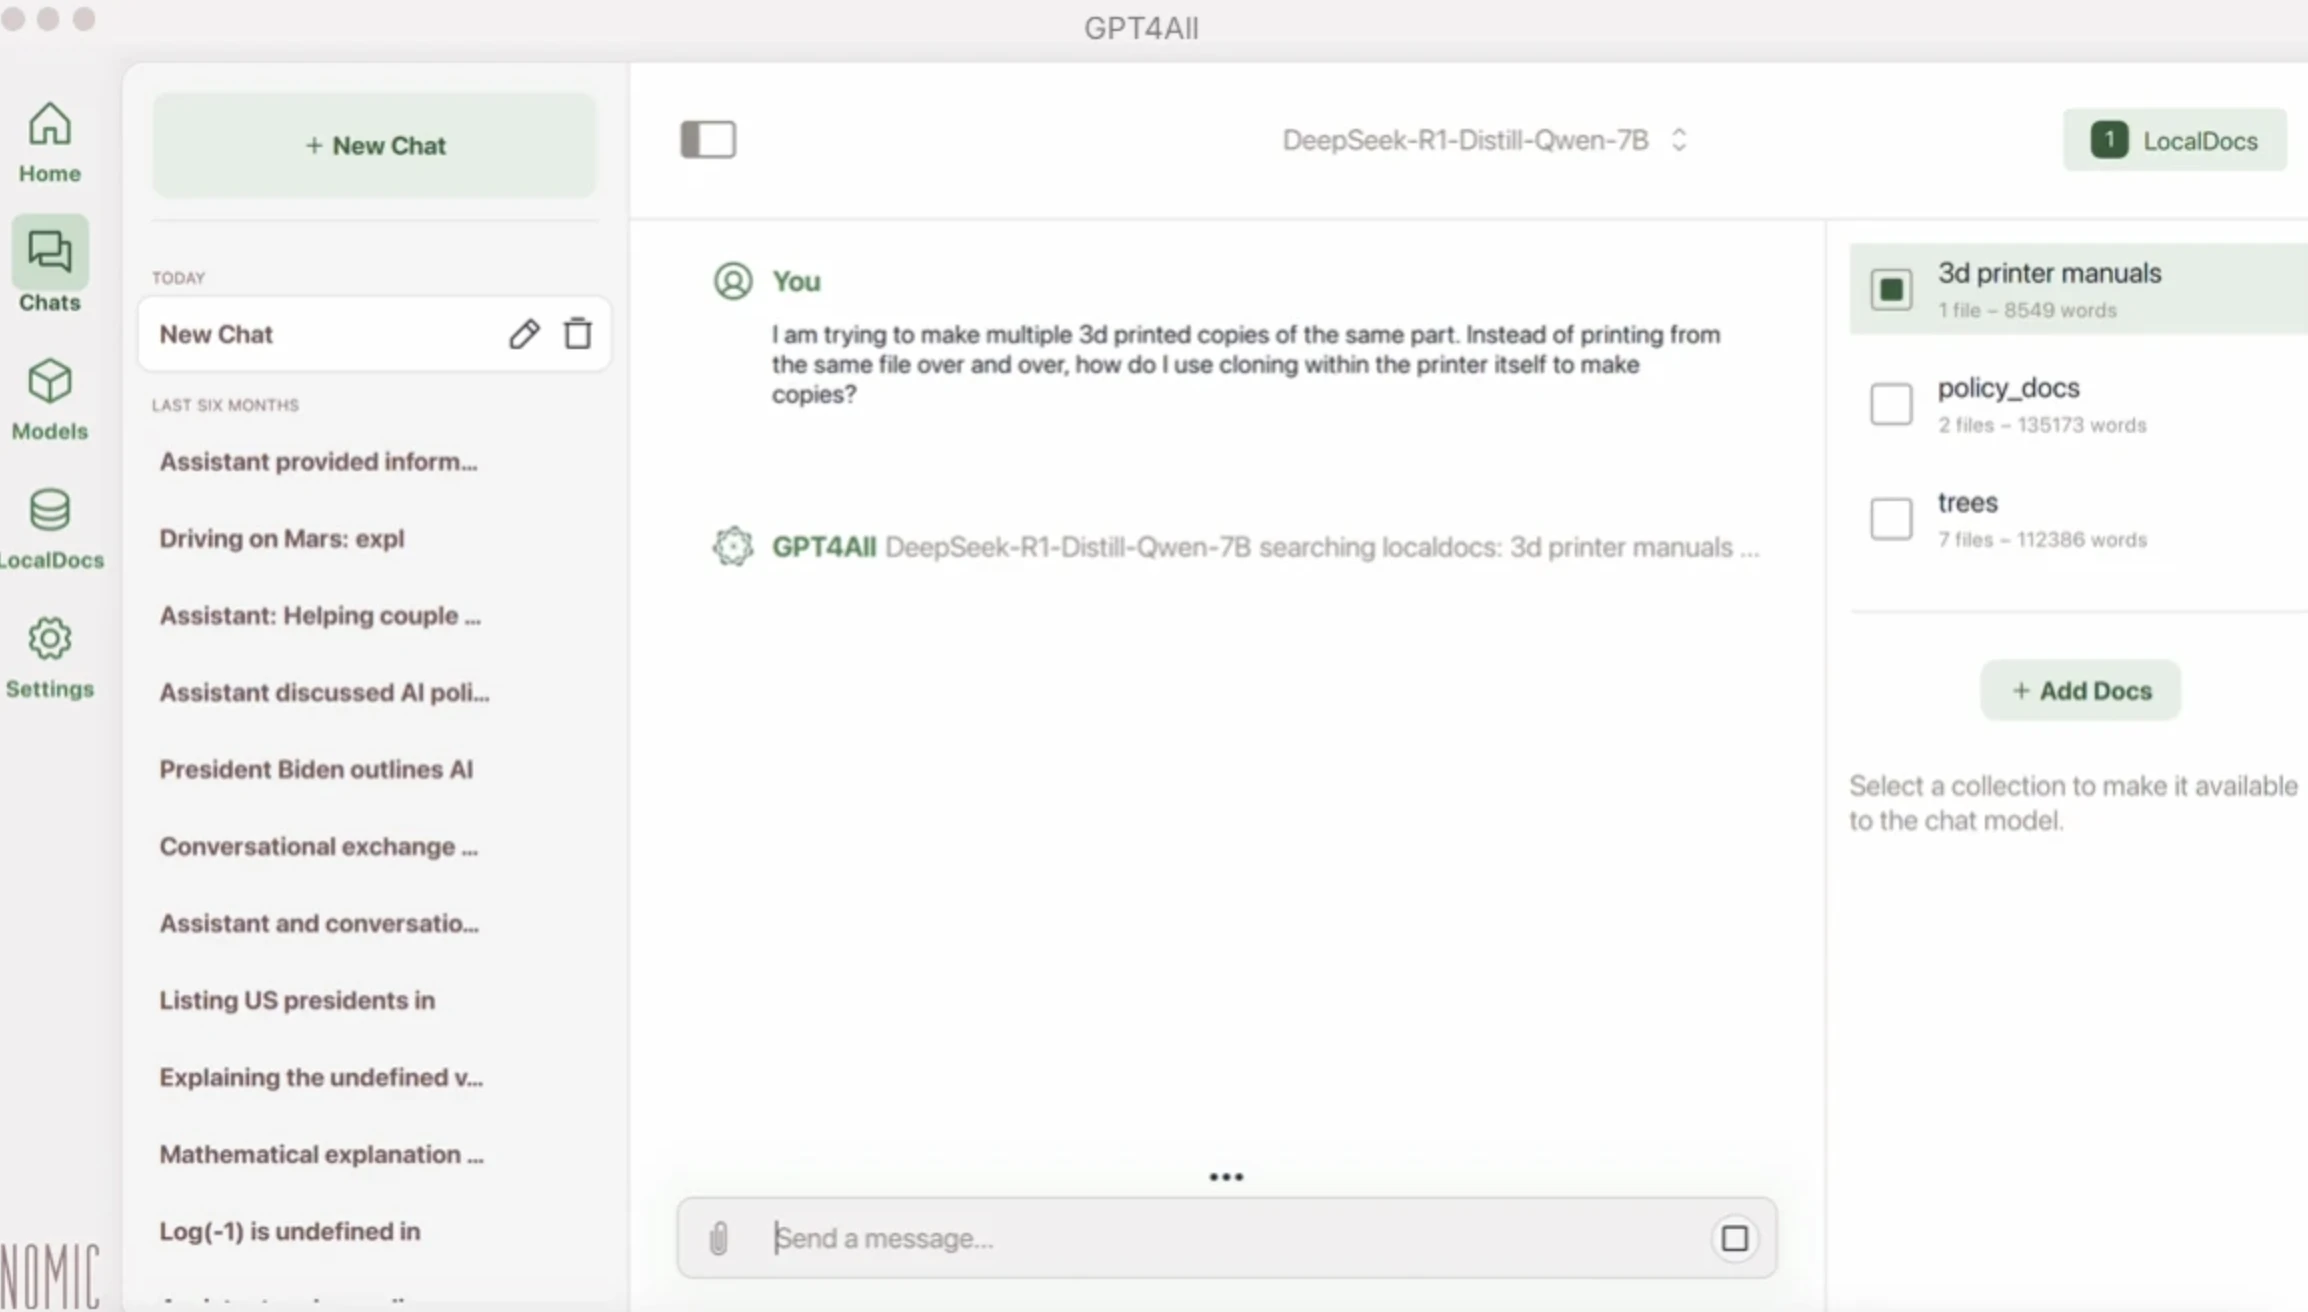
GPT4All est essentiellement un écosystème de LLMs open source (prenant en charge 1 000+ models, notamment LLaMA, Mistral et DeepSeek R1).
Il s’agit d’un chatbot local et privé pour des charges de travail multi-appareils, fonctionnant à la fois sur CPUs et GPUs, et pouvant opérer en ligne ou hors ligne.
- Capacité hors ligne : Peut fonctionner sans connexion Internet sur des ordinateurs portables ou des appareils mobiles.
- Large prise en charge des models : Compatible avec des models tels que DeepSeek R1, LLaMa, Mistral et Nous-Hermes (couvrant la plupart des LLMs open source les plus utilisés).
- Confidentialité : Conserve toutes les données en local (les réponses sont générées sur la machine de l’utilisateur), garantissant la sécurité des informations sensibles.
Limites de GPT4All
- Portée étroite : Principalement conçu comme un chatbot, avec des applications limitées au-delà de l’IA conversationnelle.
Open WebUI
Open WebUI est une interface web auto-hébergée pour interagir avec des models de langage de grande taille, disponible localement ou via des OpenAI-compatibles APIs.
- Prise en charge multi-models : Se connecte à des models locaux ou cloud (par exemple Ollama ou des OpenAI-compatibles APIs) via une interface unifiée.
- RAG intégré et chat documentaire : Prend en charge l’interrogation de documents téléversés et de bases de connaissances à l’aide de la génération augmentée par récupération.
- Système de plugins et d’extensibilité : Les développeurs peuvent étendre les fonctionnalités avec des outils, des pipelines et des plugins, ou ajouter la prise en charge de fournisseurs de models supplémentaires.
- Options de déploiement flexibles : Peut être installé à l’aide de Docker, Kubernetes ou d’autres outils de conteneurs.
Limites d’Open WebUI
- Risques de sécurité en cas de mauvaise configuration : Des vulnérabilités ou des connexions non sécurisées vers des serveurs de models externes pourraient exposer des tokens ou permettre une compromission du système si elles ne sont pas correctement sécurisées.
4. Plateformes d’IA conversationnelle
Rasa
Rasa est une plateforme d’IA conversationnelle open source conçue pour construire des chatbots et des assistants virtuels. Elle se concentre sur l’ IA conversationnelle et le développement de chatbots. Rasa apporte des concepts standard des plateformes d’IA comme la gestion des données, la surveillance, la collaboration et l’intégration des workflows dans le domaine de l’IA conversationnelle.
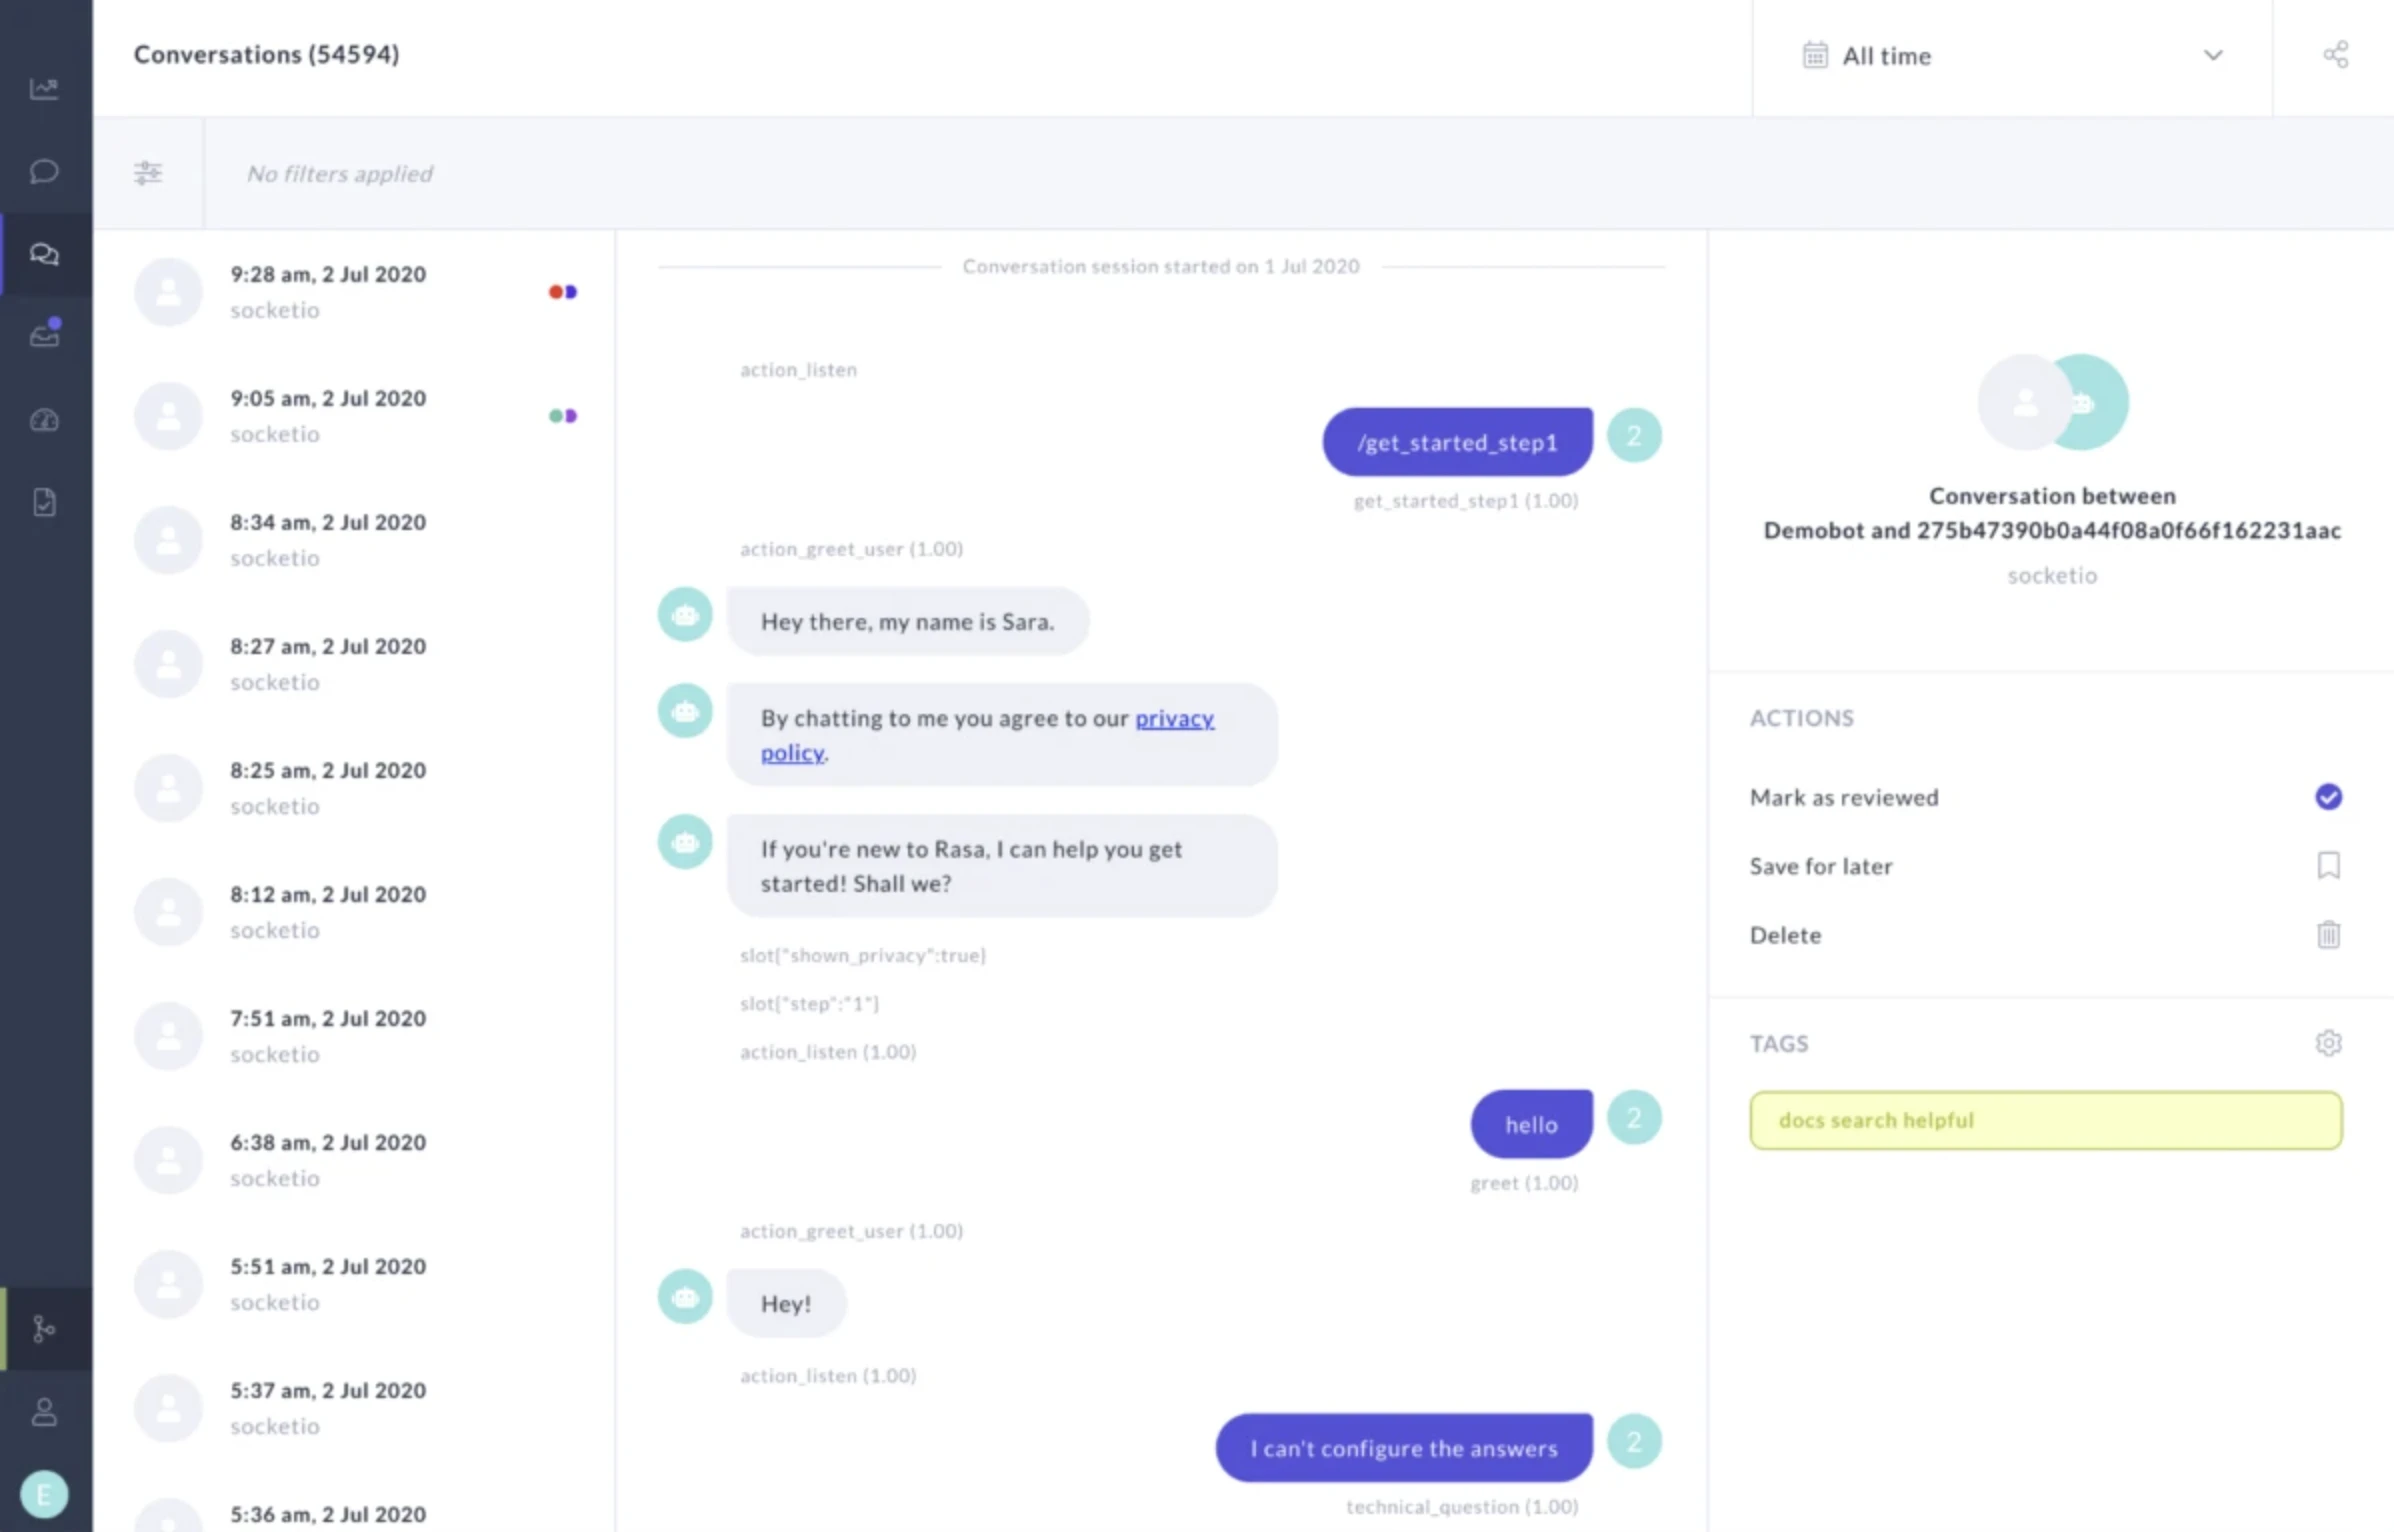
- Outils de revue des conversations : Offre une boîte de réception dédiée pour examiner les dialogues réels des utilisateurs, aidant les équipes à comprendre comment les gens interagissent naturellement avec un chatbot déployé avec Rasa.
- Étiquetage et filtrage : Prend en charge la classification des conversations par intention, action, valeurs de slots et statut de revue.
- Fonctionnalités de collaboration : Permet aux équipes de partager des workflows, d’attribuer des revues et de catégoriser les conversations.
- Détection des erreurs : Permet de signaler les messages problématiques afin qu’ils puissent être traités ultérieurement dans le cycle de développement.
Limites de Rasa
- Portée ciblée : Principalement conçu pour améliorer les assistants grâce à la revue des conversations, et non comme une plateforme générale de NLP ou de science des données.
- Effort manuel requis : Bien que le filtrage et l’étiquetage aident, l’essentiel du processus d’amélioration dépend encore de la revue manuelle des conversations.
Botpress
Botpress est une plateforme d’IA conversationnelle open source conçue pour construire, déployer et gérer des chatbots.
- Flux visuel et contrôle : Fournit un générateur de flux par glisser-déposer pour concevoir des conversations de chatbot tout en permettant une personnalisation avancée via le code.
- Intégration d’IA générative : Intégration native GPT pour la réponse aux questions d’une base de connaissances et les réponses free-form.
Limites de Botpress
- Immaturité de l’écosystème de plugins et d’intégrations : La bibliothèque de plugins et d’intégrations est plus petite que celle de concurrents comme Dialogflow ou Rasa (les plugins communautaires ne sont pas encore largement pris en charge).
- Fonctionnalités d’entreprise limitées dans les offres gratuit/open : des capacités telles que la SSO, les outils de conformité et les configurations à haute disponibilité sont principalement disponibles dans l’offre Enterprise payante.
- Risques de dépendance à l’IA générative : Forte dépendance aux intégrations GPT. L’utilisation de LLM APIs externes ou de grands models entraîne souvent des coûts ou de la latence.
 Ajouter comme source préférée
5. Plateformes d’agents
Langchain Deep Agents
Deep Agents est un framework d’agents open source de LangChain et fournit un « harnais d’agent » structuré avec planification, utilisation d’outils, mémoire et coordination de sous-agents intégrés.
- Planification et décomposition des tâches : Les agents peuvent automatiquement décomposer des tâches complexes en étapes plus petites à l’aide d’outils de planification intégrés (par exemple, un suivi des tâches de type todo).
- Délégation à des sous-agents : Le framework permet aux agents de créer des sous-agents spécialisés pour traiter des sous-tâches.
- Gestion du contexte avec des systèmes de fichiers : Les agents peuvent stocker et récupérer des informations via des systèmes de fichiers virtuels ou enfichables.
- Mémoire persistante : Le système peut stocker des connaissances d’une conversation ou session à l’autre, permettant aux agents de conserver un contexte à long terme.
- Outils de développement et CLI : Le SDK Deep Agents et l’interface en ligne de commande permettent aux développeurs de construire des agents capables d’exécuter du code, d’accéder à des fichiers, d’effectuer des requêtes web et de s’intégrer à des APIs externes.
Limites de Langchain Deep Agents
- Adapté aux tâches complexes : Le framework est conçu pour des workflows longs ou en plusieurs étapes, il peut donc représenter une surcharge inutile pour des applications d’agents plus simples.
- Complexité plus élevée : Des fonctionnalités comme les sous-agents, les systèmes de fichiers et les outils de planification peuvent accroître la complexité du système et nécessiter une configuration minutieuse.
OpenAgents
OpenAgents fournit l’infrastructure nécessaire pour créer des réseaux d’agents dans lesquels les agents IA peuvent se découvrir mutuellement, communiquer et collaborer sur des tâches.
- Réseaux d’agents : Permet à plusieurs agents IA de se connecter et de collaborer dans des réseaux structurés pour résoudre des tâches complexes.
- Protocoles de communication entre agents : Inclut des mécanismes intégrés de découverte, de messagerie et de collaboration entre agents.
- Intégration avec les outils et frameworks LLM : Fonctionne avec les fournisseurs LLM et les frameworks d’agents courants et prend en charge des protocoles comme MCP et A2A pour l’interaction entre agents.
- Architecture modulaire : Utilise un système modulaire et événementiel qui permet aux développeurs d’étendre les fonctionnalités et de personnaliser le comportement des agents.
Limites d’OpenAgents
- Encore en évolution : La documentation et les APIs sont en cours de développement actif, ce qui signifie que les exemples ou les interfaces peuvent changer.
- Complexité des systèmes multi-agents : La construction et la gestion de grands réseaux d’agents peuvent introduire des défis de coordination et d’infrastructure.
Openclaw
OpenClaw agit comme une passerelle qui connecte les plateformes de chat aux models d’IA, permettant à l’assistant d’effectuer des tâches telles que la gestion des e-mails, la planification d’événements et l’automatisation des workflows.
- Intégration de messagerie multiplateforme : L’assistant fonctionne via des applications de chat courantes (par exemple WhatsApp, Telegram, Discord, Slack), permettant aux utilisateurs d’interagir avec l’IA depuis les plateformes qu’ils utilisent.
- Architecture auto-hébergée : Les utilisateurs exécutent la passerelle OpenClaw localement ou sur leur propre serveur, conservant ainsi le contrôle des données et des clés API plutôt que de dépendre d’un service hébergé dans le cloud.
- Automatisation des tâches : L’IA peut exécuter des actions réelles telles que l’envoi d’e-mails, la gestion de calendriers ou la gestion de workflows numériques directement à partir de commandes de chat.
- Prise en charge multi-models : OpenClaw peut se connecter à différents fournisseurs de models d’IA (par exemple OpenAI, Anthropic ou d’autres), permettant aux utilisateurs de choisir des models selon leurs besoins.
- Routage des agents et gestion des sessions : La plateforme prend en charge le routage multi-agents et des sessions distinctes pour différents utilisateurs ou espaces de travail.
Limites d’OpenClaw
- Risques de sécurité liés aux extensions : Les plugins tiers peuvent contenir du code malveillant, exposant potentiellement des données sensibles s’ils ne sont pas soigneusement examinés.
- Permissions système élevées : Comme l’assistant peut accéder à des fichiers, exécuter des scripts ou contrôler des applications, une mauvaise configuration ou des instructions malveillantes pourraient créer des vulnérabilités de sécurité.
Qu’est-ce que l’IA open source ?
Dans la pratique, l’IA open source désigne des systèmes, des models ou des algorithmes mis à la disposition du public pour être utilisés, étudiés, modifiés et partagés. Les applications typiques incluent les models de langage de grande taille, les systèmes de traduction, les chatbots et d’autres outils pilotés par l’IA.
Cependant, il n’a historiquement existé aucune norme largement acceptée définissant ce qui constitue une IA open source :
- Exemples closed-source : OpenAI et Anthropic ont gardé secrets les datasets, les models et les algorithmes.
- Models en zone grise : Meta et Google ont publié des models adaptables, mais les critiques ont fait valoir qu’ils n’étaient pas véritablement open source en raison de restrictions de licence et de datasets non divulgués.
Pour y remédier, l’Open Source Initiative (OSI), l’organisation connue pour établir les standards open source, a publié une définition formelle de l’IA.1
Selon l’OSI, un système d’IA open source devrait :
- Pouvoir être utilisé à n’importe quelle fin sans autorisation.
- Permettre l’inspection de ses composants afin que les chercheurs puissent comprendre son fonctionnement.
- Pouvoir être modifié à n’importe quelle fin, y compris pour modifier ses sorties.
- Pouvoir être partagé, avec ou sans modifications, à n’importe quelle fin.
Dans la pratique, cependant, de nombreuses publications d’IA décrites comme « ouvertes » sont mieux caractérisées comme des models à poids ouverts, c’est-à-dire qu’elles publient les poids du model mais ne divulguent pas l’intégralité des données d’entraînement ni le processus de développement requis pour satisfaire aux critères open source de l’OSI.
Citer cette recherche
Choisissez le format qui correspond à votre lieu de publication. Coller la version avec lien dans votre CMS préserve le lien retour.
@misc{dilmegani2026,
  author = {Dilmegani, Cem},
  title  = {{Top 15 plateformes et bibliothèques d'IA open source}},
  year   = {2026},
  month  = jul,
  howpublished    = {\url{https://aimultiple.com/open-source-ai-platforms}},
  note   = {AIMultiple. Consulté le 1 juillet 2026}
}Résultats et horodatages de 15 points de données. Téléchargez les données de synthèse présentées dans les graphiques et les tableaux de cet article sous forme de fichier ZIP contenant un fichier CSV.
Vous voulez les données détaillées derrière ? Rejoindre Premium
Journal des modifications
1 mises à jourAjout de Open WebUI à la section des écosystèmes de grands modèles linguistiques (LLM).
Liens de référence
Le travail de Cem chez AIMultiple a été cité par des publications mondiales de premier plan, notamment Business Insider, Forbes, Morning Brew et Washington Post, par des entreprises mondiales comme Deloitte et HPE, par des ONG comme World Economic Forum et par des organisations supranationales comme European Commission. [1], [2], [3], [4], [5]
Tout au long de sa carrière, Cem a été consultant en technologies, acheteur de technologies et entrepreneur technologique. Il a conseillé des entreprises sur leurs décisions technologiques chez McKinsey & Company et Altman Solon pendant plus de dix ans. Il a également publié un rapport McKinsey sur la digitalisation.
Il a dirigé la stratégie technologique et les achats d'un opérateur télécom, sous la responsabilité du PDG. Il a également dirigé la croissance commerciale de l'entreprise de technologie profonde Hypatos, qui a atteint un revenu récurrent annuel à 7 chiffres et une valorisation à 9 chiffres, passant de 0 à ce résultat en deux ans. Le travail de Cem chez Hypatos a été couvert par des publications technologiques de premier plan comme TechCrunch et Business Insider.
Cem intervient régulièrement lors de conférences technologiques internationales. Il est diplômé de Bogazici University en tant qu'ingénieur informatique et titulaire d'un MBA de la Columbia Business School.





Commentaires 1
Partagez vos idées
Votre adresse courriel ne sera pas publiée. Tous les champs sont obligatoires. Les commentaires sont laissés dans leur langue d'origine.
Excelente conteúdo.