


Open Source Embedding Models: 11 Models benchmarkés pour la récupération
We benchmarked 11 open-weight embedding models, 200 questions and 341,040 text passages across four corpora. Finance, legal contract, technical support and medical questions each searched their own domain's corpus.

nDCG@10 évalue le placement des passages pertinents enregistrés dans les dix premiers résultats de recherche. Un score de 1 représente le classement idéal pour les positifs enregistrés. Les passages plus proches du sommet reçoivent plus de poids.
PPLX Embed v1 4B a mené la comparaison à 0.741 nDCG@10, suivi de PPLX Embed v1 0.6B à 0.698. Multilingual E5 Large s’est classé troisième à 0.628. Le petit écart entre BGE Large et E5 Large est masqué par un arrondi à trois décimales. Leurs scores non arrondis déterminent l’ordre.
Model | nDCG@10 | 95 % IC | Recall@10 |
|---|---|---|---|
PPLX Embed v1 4B | 0.741 | 0.700–0.782 | 90,46 % |
PPLX Embed v1 0.6B | 0.698 | 0.651–0.744 | 86,71 % |
Multilingual E5 Large | 0.628 | 0.578–0.680 | 79,38 % |
BGE Large EN v1.5 | 0.624 | 0.572–0.676 | 78,21 % |
E5 Large v2 | 0.624 | 0.572–0.675 | 78,88 % |
BGE-M3 (dense) | 0.614 | 0.562–0.666 | 79,50 % |
GTE Large | 0.612 | 0.563–0.660 | 77,71 % |
All-MPNet Base v2 | 0.608 | 0.556–0.661 | 77,33 % |
GTE Base | 0.596 | 0.547–0.645 | 76,21 % |
E5 Base v2 | 0.586 | 0.534–0.640 | 75,21 % |
Recall@10 est la fraction moyenne des passages pertinents enregistrés de chaque question trouvés dans les dix premiers résultats. Il mesure la couverture des passages et n’évalue pas si une réponse générée est correcte.
Les 95 % intervalles de confiance (IC) estiment l’incertitude de la nDCG@10 moyenne due à l’échantillonnage des questions. Des intervalles plus larges indiquent des estimations moins précises.
Les questions ont été sélectionnées pour mettre au défi BM25, qui a obtenu zéro sur cet ensemble. Nous rapportons cette baseline parallèlement à la procédure de sélection. Les performances sur le trafic de recherche ordinaire restent non testées. L’inference a été effectuée via des endpoints hébergés.
Résultats de récupération au sein des open-weight models
PPLX Embed v1 4B a enregistré le nDCG@10 le plus élevé à 0.741
PPLX Embed v1 0.6B a suivi à 0.698. Le 4B model a obtenu un score significativement supérieur à neuf des dix autres open-weight models après correction pour les comparaisons multiples. Son écart par rapport au 0.6B n’était pas significatif. Leurs scores Recall@10 étaient de 90,46 % et 86,71 %, également sans différence significative. Ces tests n’établissent pas une performance égale.
BGE Large a enregistré le score en finance le plus élevé à 0.604
PPLX 4B a obtenu 0.596 sur les mêmes 50 questions de finance. Cette différence n’était pas significative après correction. BGE Large s’est classé quatrième au classement général, illustrant comment l’ordre observé change selon les domaines.
GTE Large a récupéré tous les positifs MedRAG enregistrés dans les dix premiers résultats
GTE Large a atteint 100 % de Recall@10 sur les 50 questions médicales. Sa nDCG@10 était de 0.894, comparée à celle de PPLX 4B de 0.954. Récupérer les positifs enregistrés et les classer en premier sont des résultats distincts. Ces scores concernent la récupération de passages et ne mesurent pas l’exactitude des réponses médicales.
Comparaisons par domaine pour les onze models
nDCG@10 au niveau du domaine. Les vues Finance, CUAD, TechQA et MedRAG conservent les onze models et les trient selon le score du domaine sélectionné.
BGE-M3 a atteint 0.616 sur CUAD et 0.743 sur MedRAG. Ces chiffres décrivent la configuration à vecteurs denses utilisée ici. BGE-M3 prend également en charge la récupération sparse et multi-vectorielle. Ces modes et les combinaisons hybrides étaient hors du cadre de cette expérience.1
Les quatre domaines ont le même poids dans le résultat global. Une performance MedRAG élevée d’un model peut compenser une récupération financière plus faible dans cette moyenne, même si les cas d’usage financiers et médicaux exigent des preuves différentes.
Représentations d’embedding et choix de déploiement
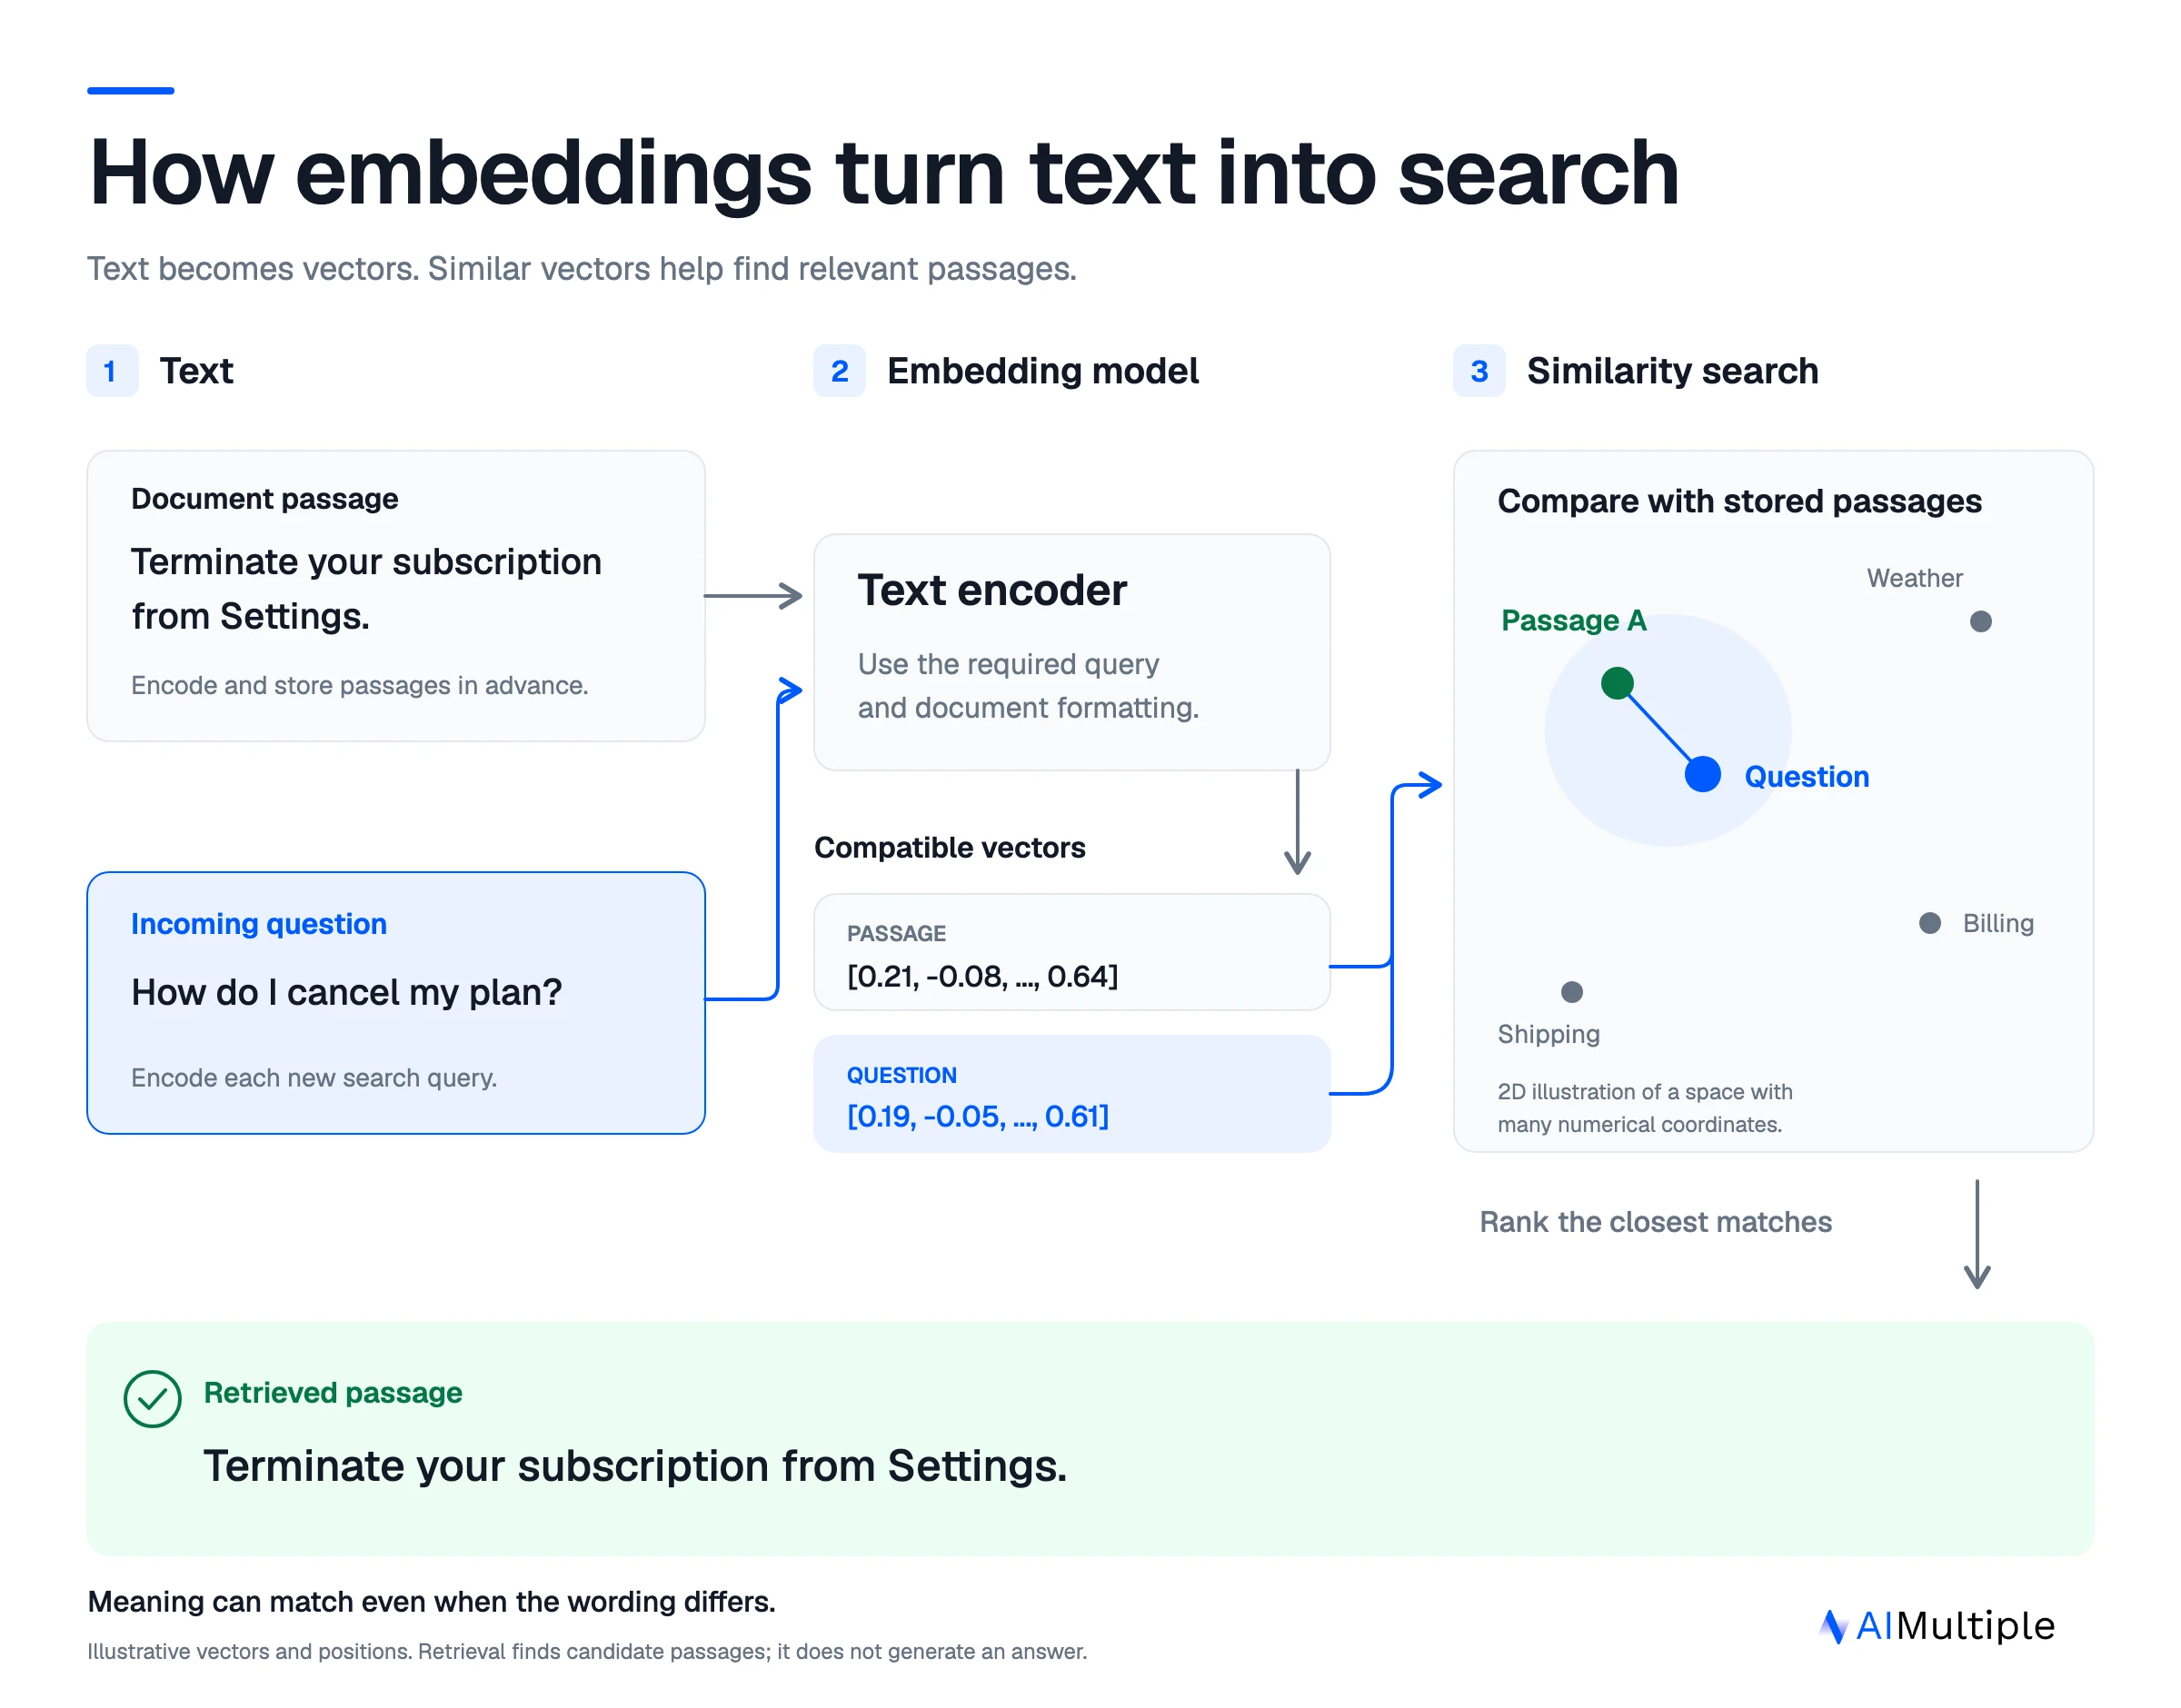
La récupération par embedding encode les passages et les requêtes en vecteurs compatibles, puis compare ces vecteurs pour sélectionner les passages candidats. Les documents peuvent être encodés avant la recherche. Chaque requête entrante a besoin de sa propre représentation. Les prompts ou rôles de requête et de document spécifiques au model doivent suivre la configuration de récupération du model.2
Le comportement de stockage et de recherche dépend également de la base de données vectorielle et de sa configuration d’index. Le choix du model, la précision des vecteurs, les paramètres d’index et la profondeur de récupération doivent rester des décisions distinctes lors de la planification d’un déploiement. Le benchmark d’embedding models plus large place ces onze entrées aux côtés des models d’API commerciaux sur les mêmes questions.
Méthodologie du benchmark des embedding models open source
Chaque model a recherché les mêmes passages avec 200 questions gelées et 225 paires question-passage pertinentes enregistrées. Les questions et les étiquettes de pertinence ont été fixées avant de comparer les scores d’embedding. Les entrées de requête contenaient uniquement la question d’origine.
Les passages financiers provenaient des rapports annuels FinQA et les passages juridiques des contrats CUAD v1.34 Le support technique utilisait les notes techniques TechQA, et la littérature médicale utilisait un échantillon de résumés PubMed MedRAG.56
Les passages étaient des paragraphes entiers, des tableaux avec contexte, des clauses contractuelles ou des résumés avec titres. Nous avons exclu les unités de plus de 256 tokens selon le tokenizer all-MiniLM-L6-v2 et conservé les passages acceptés intacts. Les models à 512 tokens ont reçu au maximum 459 tokens par passage, donc cette évaluation couvre des passages courts.
Les LLMs de pointe ont rédigé les questions à partir des passages sources. Un membre de l’équipe a vérifié 20 % des questions (40 sur 200). Les LLMs ont également jugé les 20 premiers passages de BM25 par question, ajoutant 25 passages pertinents aux 200 passages sources d’origine.
Récupération et analyse statistique
Chaque requête a été comparée à chaque passage de son domaine. MultiQA a utilisé le produit scalaire, conformément à sa model card.7 Les dix autres models ont utilisé la similarité cosinus. BGE-M3 a utilisé ses vecteurs denses.1 Les entrées utilisaient les rôles ou préfixes de récupération configurés pour chaque model.
Les deux métriques sont des moyennes sur les questions. Nous avons calculé des IC à 95 % avec 10 000 échantillons bootstrap, en rééchantillonnant 50 questions dans chaque domaine. La significativité utilise les tests appariés par changement de signe du benchmark complet, avec correction de Holm sur toutes les 231 paires parmi ses 22 models pour chaque métrique et chaque portée. Les différences sont significatives à une p-value corrigée inférieure à 0.05.
Identifiants des models testés, dimensions et limites d’entrée
Les exécutions ont eu lieu via OpenRouter, avec un fournisseur backend fixe par model et les fallbacks désactivés. Voici les identifiants d’API, les dimensions de sortie et les limites d’entrée utilisées lors de ces exécutions.
Les identifiants d’API ne garantissent pas une capture immuable d’un model. Les révisions du tokenizer ont été épinglées et les poids des models hébergés n’ont pas été vérifiés indépendamment. Les limites d’entrée décrivent la configuration du benchmark. Les passages courts n’ont pas testé la récupération à long contexte.
Limites de la comparaison
Les questions forment un ensemble de développement sélectionné par BM25. Les résultats sur des requêtes de production ordinaires peuvent différer. Les jugements de pertinence étaient limités aux passages sources et aux 20 premiers résultats de BM25. Sur ces onze models, environ 85 % des paires question-passage distinctes récupérées dans les dix premiers résultats n’ont pas été jugées et n’ont reçu aucun crédit de pertinence.
Chaque model a été exécuté une seule fois. Les IC reflètent l’échantillonnage des questions et excluent la variation entre les exécutions d’API ou l’incertitude liée aux étiquettes incomplètes. La contamination par les données d’entraînement n’a pas été testée.
L’évaluation couvre la récupération de texte en anglais. Les charges de travail d’embedding multilingues et les embedding models multimodaux nécessitent des preuves distinctes. La précision des réponses générées, la récupération hybride, le reranking, la mémoire du GPU, le débit local et le coût de service étaient hors du champ de cette comparaison.
Conclusion
PPLX Embed v1 4B et 0.6B ont obtenu les scores globaux les plus élevés parmi les onze open-weight models. Leur différence n’était pas statistiquement significative. BGE Large a enregistré le score en finance le plus élevé, et GTE Large a récupéré tous les positifs MedRAG enregistrés dans les dix premiers résultats.
Avant le déploiement, testez l’ensemble de requêtes prévu et mesurez la vitesse de service locale, l’utilisation de la mémoire et le coût.
 Ajouter comme source préférée
Lectures complémentaires
- Benchmark des embedding models
- Embedding models multilingues pour RAG
- Benchmark des bases de données vectorielles open source
- Dimensionnement et sélection de la base de données vectorielle
Citez ce benchmark
Choisissez le format qui correspond à votre lieu de publication. Coller la version avec lien dans votre CMS préserve le lien retour.
@misc{sari2026,
  author = {Sarı, Ekrem},
  title  = {{Open Source Embedding Models: 11 Models benchmarkés pour la récupération}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/open-source-embedding-models}},
  note   = {AIMultiple. Consulté le 26 septembre 2026}
}Résultats et horodatages de 105 points de données. Téléchargez les données de synthèse présentées dans les graphiques et les tableaux de cet article sous forme de fichier ZIP contenant 7 fichiers CSV et un README.
Vous voulez les données détaillées derrière ? Rejoindre Premium
Journal des modifications
4 mises à jourLe benchmark Top-K de 16 modèles sur les avis Amazon a été remplacé par un benchmark de 14 modèles avec nDCG@3 et coûts sur CUAD, TechQA et MedRAG.
Ajout de la section Licence et utilisation commerciale à l'aperçu des modèles d'intégration open source.
Le benchmark a été étendu pour inclure cinq modèles open source supplémentaires.
Matériel, taille de lot et précision mis à jour dans la configuration d'évaluation.
Liens de référence






Soyez le premier à commenter
Votre adresse courriel ne sera pas publiée. Tous les champs sont obligatoires. Les commentaires sont laissés dans leur langue d'origine.