


Outils d'agents IA: comparaison de 15+ plateformes

Un agent IA lit le contexte, choisit un outil, agit et vérifie le résultat avant de choisir l’étape suivante. Cette boucle distingue un agent d’un chatbot. Les agents fonctionnent comme des copilotes : ils recherchent, rédigent et exécutent, et une personne approuve tout ce qui a des conséquences.
Les 15 outils ci-dessous couvrent quatre catégories : les agents de codage, les plateformes d’agents d’entreprise, les agents conversationnels et de service client, ainsi que les frameworks de développement et d’automatisation d’agents.
Agents de codage IA
Outil | Meilleur choix | Principale limite |
|---|---|---|
Claude Code | Travail en terminal, problèmes architecturaux difficiles | Statut de passation de marchés fédéral non réglé2 |
OpenAI Codex | Tâches parallèles déléguées au cloud | Le modèle par défaut change souvent, donc les benchmarks deviennent obsolètes |
Cursor | Itération rapide dans un IDE complet | La propriété est passée à SpaceX en août 20263 |
GitHub Copilot | Équipes standardisées sur GitHub et VS Code | La profondeur par agent reste en retrait par rapport aux outils dédiés |
Kiro | Équipes AWS qui veulent des spécifications avant le code | Se présente comme une migration forcée depuis Amazon Q Developer |
Claude Code est l’agent de codage en terminal d’Anthropic, qui lit un dépôt, modifie des fichiers, exécute des tests et itère sur les échecs. Sa fonctionnalité Code Review répartit des agents parallèles sur une pull request, vérifie les résultats pour filtrer les faux positifs et publie des commentaires en ligne classés par gravité sans approuver elle-même la PR.1
OpenAI Codex est l’agent de codage d’OpenAI, disponible via une CLI, une application de bureau, des intégrations IDE et ChatGPT. La CLI est open source, se connecte aux serveurs MCP et peut importer la configuration existante et les sessions passées depuis Claude Code et Cursor.2
Cursor est un éditeur de code IA basé sur VS Code qui exécute côte à côte des agents locaux et cloud. Il fournit ses propres modèles Composer aux côtés de modèles tiers, ainsi que des plugins, des serveurs MCP, des hooks, des compétences et un contrôle à distance iOS pour les agents cloud.3
GitHub Copilot est un environnement de développement multi-agents couvrant la CLI, VS Code et les IDE JetBrains. Sa CLI délègue à quatre agents spécialisés qui s’exécutent en parallèle, Explore, Task, Plan et Code-review, et compresse automatiquement l’historique de conversation à 95 % de la limite de tokens.4
Kiro (AWS) est un IDE et une CLI pilotés par les spécifications qui inverse l’ordre habituel du travail. Une demande en langage naturel devient une spécification structurée, un document de conception et des tâches séquencées avant l’écriture de tout code, avec des hooks et des sous-agents personnalisés qui s’exécutent selon ce plan.
Plateformes d’agents d’entreprise
OpenAI Frontier est une plateforme de bout en bout pour créer et gérer des agents, y compris des agents conçus en dehors d’OpenAI. Chaque agent reçoit sa propre identité limitée à l’accès requis par une tâche, avec une surveillance et des journaux détaillés, ainsi qu’une couche de contexte partagée reliant CRM, entrepôts de données et applications internes.
Microsoft Agent 365 est un plan de contrôle qui gouverne les agents, qu’ils aient été créés dans Copilot Studio, achetés auprès d’un fournisseur ou installés sur l’appareil d’un utilisateur. Il étend les contrôles réseau de Microsoft Entra à ces agents, en restreignant les destinations qu’ils peuvent atteindre et en filtrant les mouvements de fichiers risqués.
Gemini Enterprise Agent Platform est le successeur de Vertex AI chez Google, couvrant la sélection de modèles, la création d’agents, l’orchestration et la gouvernance dans une seule console. Plus de 200 modèles sont disponibles via Model Garden, aux côtés de serveurs MCP gérés avec Apigee reliant les API existantes aux agents.
IBM watsonx Orchestrate est une couche d’orchestration destinée aux secteurs réglementés. Son Agentic Control Plane ajoute un tableau de bord de gouvernance, un centre de contrôle de sécurité et des traces d’observabilité qui montrent comment le contexte évolue au fil du workflow.
Creatio IA Studio est la couche d’agents de la plateforme CRM et workflow de Creatio, fonctionnant aux côtés de Business Studio pour les applications no-code et d’IA Twin pour les agents personnels créés par les utilisateurs finaux. Il propose deux concepteurs : un Prompt Agent Designer pour les agents en langage naturel et un Workflow Agent Designer pour les processus déterministes à plusieurs étapes. La gouvernance couvre l’application des politiques, les points de contrôle d’approbation, la surveillance de l’exécution et le suivi de la consommation par agent, par modèle et par action. Les agents se connectent via REST et MCP et fonctionnent sur le chat web, la messagerie, les SMS, la voix et la vidéo. Des agents préconçus sont fournis pour les ventes, le marketing et le service, ainsi que des ensembles sectoriels pour la banque (intégration, préparation de prêt, gestion de prêt, parrainage, renouvellement, fidélisation) et les visites terrain dans l’industrie manufacturière.
Agents conversationnels et de service client
Salesforce Agentforce propose des agents de service client et de vente qui travaillent directement sur les enregistrements Salesforce, couvrant Agentforce Sales, Agentforce Service et Agentforce Analytics sur une plateforme partagée. Salesforce mesure la production en Agentic Work Units, c’est-à-dire les tâches accomplies par un agent, plutôt qu’en sièges ou sessions.
OpenAI Presence est un produit d’agent vocal et de chat où chaque déploiement est limité à une seule tâche, comme résoudre un problème de facturation ou une demande de service informatique. L’entreprise définit les politiques, les actions approuvées et les règles d’escalade ; Codex propose ensuite des mises à jour issues des sessions de production que les équipes testent par rapport à la version en direct avant le déploiement.
Tidio Lyro est un agent de chat pour PME construit sur Claude. Il répond à partir du contenu fourni par l’opérateur, comme des entrées de FAQ, des articles d’aide et des pages de site récupérées, plutôt que par génération ouverte, et transfère les questions qu’il ne peut pas résoudre à un agent humain.
Frameworks de développement et d’automatisation d’agents
Les équipes utilisent ces produits pour créer des agents plutôt que de les acheter.
LangGraph est un runtime d’orchestration de bas niveau qui modélise les workflows d’agents sous forme de graphes avec un schéma d’état explicite. Lorsqu’un checkpoint est configuré, une exécution peut être sauvegardée et reprise à tout moment, ce qui rend pratiques les processus d’approbation sur plusieurs jours et les tâches en arrière-plan.
CrewAI est un framework Python où chaque agent reçoit un rôle, un objectif et une histoire, puis collabore via un orchestrateur de crew. Il prend en charge MCP pour l’accès aux outils, A2A pour la délégation entre agents et le checkpointing qui rejoue ou bifurque une exécution à partir d’une étape choisie.
n8n est une plateforme d’automatisation de workflows dotée de nœuds d’agents IA dédiés. Ses nœuds client et serveur MCP permettent à un workflow à la fois d’appeler des outils externes et d’agir comme un outil appelé par d’autres agents, et la Community Edition s’auto-héberge sans limite d’exécution.
Qu’est-ce qu’un agent IA ?
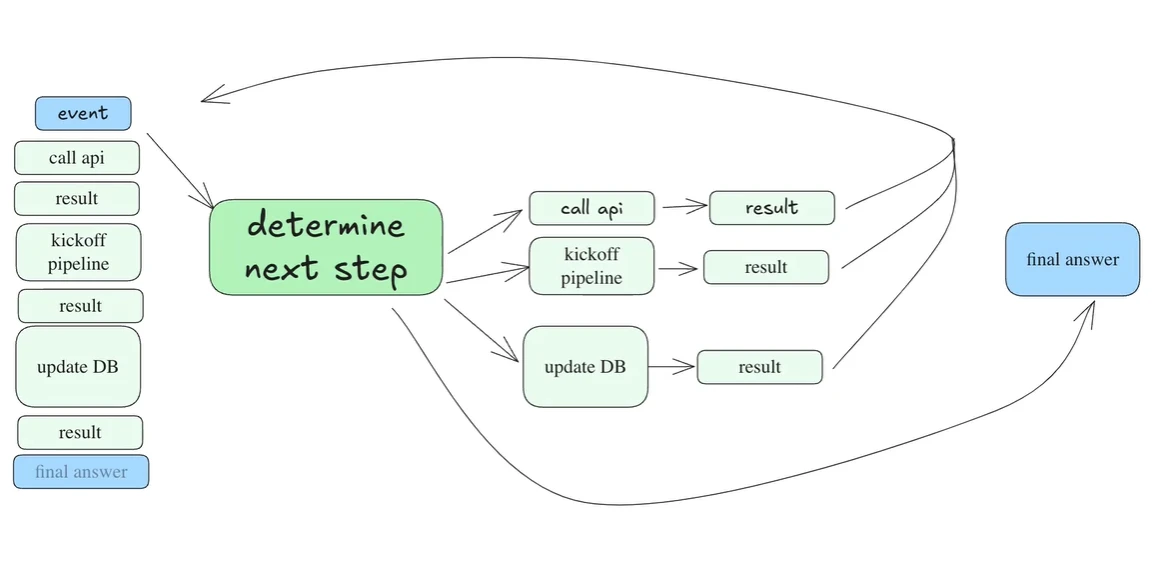
Un agent IA fonctionne en boucle. C’est la différence fondamentale avec un chatbot. Un chatbot répond. Un agent planifie une étape, appelle un outil, lit le résultat et décide de la suite jusqu’à ce que la tâche se termine ou qu’une limite l’arrête.
Source : GitHub5
Aucune définition unique ne fait consensus dans le secteur. L’IA traditionnelle définit un agent comme un système qui perçoit un environnement et agit sur celui-ci. Certains cabinets d’analystes réservent le terme aux systèmes fonctionnant de manière indépendante sur de longs horizons. D’autres l’appliquent aux workflows prescriptifs avec un modèle au centre.
Le projet d’agents 12-facteurs propose des principes d’ingénierie pour construire des applications fiables propulsées par des LLM, notamment des appels d’outils structurés, une gestion explicite du contexte, un état d’exécution, des transferts humains et un flux de contrôle explicite.6
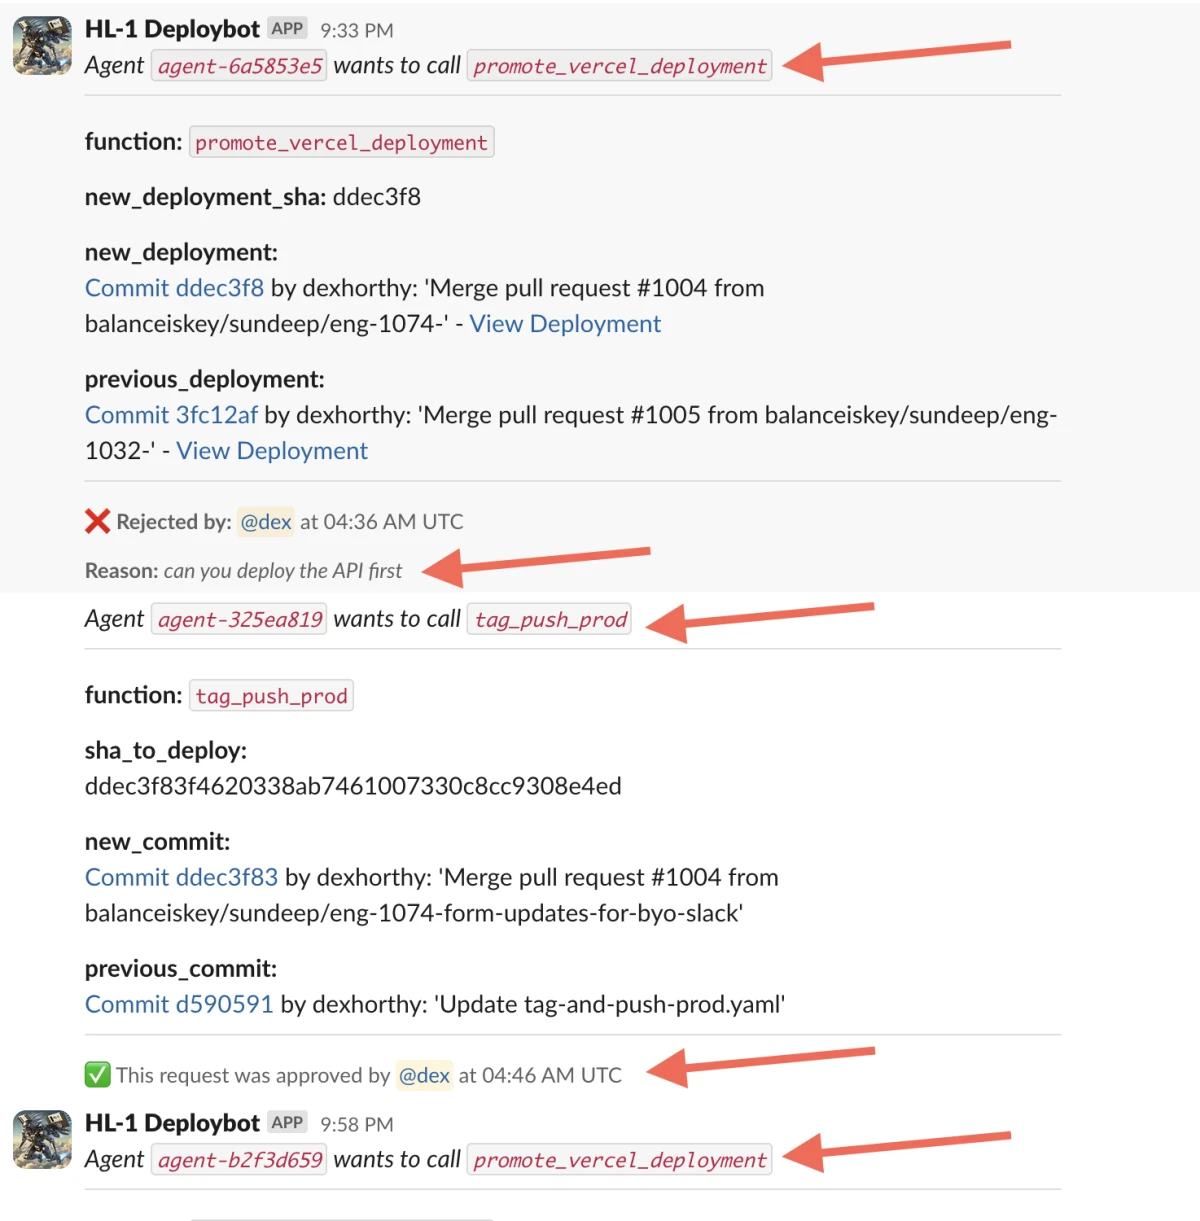
Deux propriétés comptent plus que l’étiquette. Premièrement, l’agent entreprend-il des actions aux conséquences réelles ? Deuxièmement, une personne examine-t-elle ces actions avant qu’elles ne soient appliquées ?
Voici un exemple concret et une conversation d’un agent logiciel open source gérant des déploiements chez Humanlayer :7
Source : GitHub 7
Capacités des systèmes d’IA agentique
Adapté de : Cobus Greyling8
Pour en savoir plus : constructeurs d’agents IA, modèles d’action de grande taille (LAMs), et IA agentique en cybersécurité.
Comment choisir
Autonomie vs contrôle
La première décision concerne l’étendue de l’indépendance.
Les agents copilotes tels que Cursor et Claude Code maintiennent une personne au point de décision. Ils recherchent et exécutent, puis attendent l’approbation avant d’entreprendre une action irréversible. Les plateformes de workflow telles que n8n suivent des chemins prédéfinis avec une prise de décision en temps réel limitée, ce qui est prévisible mais échoue face à une entrée inattendue. Les systèmes basés sur des règles répondent à des déclencheurs sans compréhension contextuelle.
Une autonomie totale crée plus de problèmes qu’elle n’en résout sans garde-fous étendus en place au préalable.
Fiabilité vs précision
La précision des benchmarks répond à une question : à quelle fréquence un agent termine-t-il la tâche ? Le déploiement en soulève trois autres. Se comporte-t-il de la même manière deux fois ? Tient-il lorsque les conditions changent ? Reconnaît-il lorsqu’il se trompe ?
Une équipe de Princeton a mesuré ces quatre dimensions sur 15 modèles avec GAIA et τ-bench, couvrant les sorties de modèles de début 2024 à mi-2026 et en exécutant chaque tâche de manière répétée plutôt qu’une seule fois. Leur principal constat : environ 24 mois de gains de précision n’ont produit que des gains de fiabilité minimes. La précision a progressé régulièrement ; la fiabilité est restée bien en retrait sur les deux benchmarks. Les auteurs décrivent ce schéma comme un plateau à l’échelle du secteur plutôt qu’une faiblesse d’un fournisseur, car tous les fournisseurs de pointe se regroupent.9
Deux points importent pour les achats :
- La cohérence des résultats reste faible sur tous les modèles testés. Un agent capable de résoudre une tâche échoue souvent à la résoudre à chaque exécution. Un agent de remboursement qui approuve une réclamation trois fois sur cinq et la refuse les deux autres fois crée de la responsabilité, pas des économies.
- La robustesse des prompts varie fortement selon les modèles. Les agents absorbent mieux les vraies défaillances d’infrastructure, comme les délais d’attente d’API, que les instructions reformulées. « Je veux annuler mon abonnement » et « veuillez mettre fin à mon forfait » peuvent produire des résultats différents.
Un test pratique avant achat : exécutez la même tâche cinq fois, reformulez l’instruction, injectez une défaillance d’outil et comparez. Une seule exécution de benchmark ne répond à aucune de ces questions.
Profondeur d’intégration
Deux standards ouverts sous-tendent désormais la plupart des déploiements d’agents, et ils résolvent des problèmes différents.
MCP connecte un agent à des outils. Anthropic a fait don du Model Context Protocol à l’Agentic IA Foundation de la Linux Foundation en décembre 2025, le plaçant sous le même modèle de gouvernance indépendant que Kubernetes et Node.js.10
MCP a livré sa plus importante révision le 28 juillet 2026. La spécification 2026-07-28 supprime la poignée de main initialize et l’en-tête de session, transformant MCP d’un protocole bidirectionnel avec état en un protocole requête/réponse sans état. Chaque requête porte sa propre version de protocole, l’identité du client et ses capacités, de sorte que toute requête peut atterrir sur n’importe quelle instance de serveur derrière un simple load balancer.
Quatre changements comptent en production :
- Routage basé sur les en-têtes. Les noms de méthode et d’outil transitent dans les en-têtes
Mcp-MethodetMcp-NameHTTP, de sorte que les passerelles et les limiteurs de débit routent sans analyser le corps des requêtes. - Résultats de liste pouvant être mis en cache. Les réponses de
tools/listet des appels associés portent des indications de cache et un ordre déterministe, ce qui maintient la stabilité des caches de prompts en amont lors des reconnexions. - Renforcement de l’autorisation. Les serveurs d’autorisation renvoient un paramètre issuer conformément à la RFC 9207, et les clients doivent le valider avant d’échanger un code, ce qui élimine une faille de confusion entre serveurs d’autorisation. Dynamic Client Registration est déprécié au profit des Client ID Metadata Documents.
- Un plancher de dépréciation de douze mois. Roots, Sampling, Logging et le transport historique HTTP+SSE continuent de fonctionner pendant au moins un an.
Les mainteneurs de MCP font état de près d’un demi-milliard de téléchargements mensuels sur les SDK de niveau 1, les SDK TypeScript et Python dépassant chacun un milliard de téléchargements au total.11
A2A connecte les agents entre eux. Google a publié le protocole Agent2Agent en avril 2025 et l’a donné à la Linux Foundation deux mois plus tard. Au bout d’un an, en avril 2026, la Linux Foundation a fait état de plus de 150 organisations de soutien, d’une intégration sur les plateformes Google, Microsoft et AWS, et de déploiements en production dans la chaîne d’approvisionnement, les services financiers, l’assurance et l’exploitation informatique. La spécification 1.0 a ajouté des Agent Cards signées pour la vérification cryptographique de l’identité.12
Les deux standards rendent compte de leurs progrès différemment, et la différence mérite d’être nommée. MCP publie le volume de téléchargements et un registre public de serveurs. A2A publie le nombre de soutiens et les intégrations de plateformes, sans métriques d’utilisation. Dans une évaluation, « soutenu par » est un signal plus faible que « fonctionne en production chez ».
Sécurité, identité et conformité
Les certifications de sécurité décrivent la plateforme. L’identité d’un agent décrit ce qu’un agent peut atteindre, et c’est là que se concentrent les travaux récents.
OWASP a publié le Top 10 des applications agentiques le 9 décembre 2025, avec les identifiants ASI01 à ASI10. La liste traite un agent comme un principal doté d’objectifs, d’outils, de mémoire et de protocoles inter-agents, chacun constituant une surface d’attaque distincte. Le détournement d’objectif figure en tête : un attaquant insère des instructions dans un document, un e-mail ou une invitation de calendrier que l’agent lit ensuite comme contexte et exécute.13
Les produits des fournisseurs ont convergé vers une réponse similaire. OpenAI Frontier attribue à chaque agent une identité définie avec des autorisations limitées. Microsoft Agent 365 étend les contrôles réseau Entra aux agents sur les appareils terminaux. Le schéma commun traite un agent comme une équipe d’identité traite un compte de service.
La liste de contrôle pratique pour un agent en production est courte : une identité distincte, des autorisations limitées à une seule tâche, une piste d’audit et un coupe-circuit qui interrompt l’exécution en cours de route.
Réglementation. Les dates de conformité ont été décalées deux fois en 2026, et la couverture a été incohérente. Deux éléments sont devenus exécutoires dans l’UE le 2 août 2026 : les obligations de transparence de l’article 50 et les pouvoirs d’exécution de la Commission européenne sur les modèles d’IA à usage général.
L’article 50 est plus étroit que ne le suggère le raccourci. Il impose une obligation de divulgation aux fournisseurs de systèmes qui interagissent directement avec des personnes, avec une exception lorsque la nature IA de l’interaction est évidente pour une personne raisonnablement bien informée, ainsi que d’autres exemptions dans des domaines tels que l’application de la loi. Par ailleurs, il impose une obligation de marquage lisible par machine aux fournisseurs de systèmes génératifs, et une obligation de divulgation aux déployeurs qui publient du contenu synthétique. Les sanctions atteignent 15 millions d’euros ou 3 % du chiffre d’affaires annuel mondial, le montant le plus élevé étant retenu.
Les obligations à haut risque ne sont pas entrées en vigueur à cette date. Le Digital Omnibus sur l’IA a reporté les systèmes autonomes de l’annexe III au 2 décembre 2027 et les systèmes de l’annexe I intégrés dans des produits au 2 août 2028.14
Pour un déploiement d’agents touchant des utilisateurs de l’UE, le travail à court terme consiste à délimiter le périmètre plutôt qu’à réaliser une évaluation de conformité : identifier quelles surfaces d’agents relèvent des obligations de divulgation et de marquage, et lesquelles en sont exclues. Un étiquetage généralisé n’est ni requis ni suffisant.
Coût et modèle de tarification
Les coûts directs couvrent les appels d’API de modèle, l’exécution des outils et l’infrastructure des systèmes auto-hébergés. Les coûts cachés sont moins visibles :
- L’utilisation de la fenêtre de contexte s’accumule au fil des sessions multi-tours.
- Les tentatives échouées sont facturées, y compris les nouvelles tentatives.
- Le débogage et l’affinage des prompts consomment du temps d’ingénierie.
- L’infrastructure de gouvernance et de sécurité a ses propres postes de coûts.
- Les équipes ont besoin de formation pour travailler avec des agents.
Les organisations de pointe considèrent le coût des agents comme une contrainte architecturale plutôt que comme un poste à examiner après le déploiement. Optimisations courantes : orienter les requêtes simples vers des modèles plus petits, mettre en cache le contexte répété, installer des disjoncteurs qui arrêtent les agents emballés, surveiller l’utilisation des tokens par tâche et regrouper les requêtes lorsque la latence le permet.
La structure tarifaire évolue en même temps que le niveau de prix. Une licence par siège suppose qu’une connexion équivaut à une unité de travail productif. Cette hypothèse s’effondre lorsqu’un agent travaille indépendamment de tout utilisateur, et les fournisseurs commencent à le dire publiquement : le cofondateur de Sierra, Clay Bavor, l’a affirmé à CNBC en juillet 2026.15
Trois structures sont présentes sur le marché :
- Par siège ou par instance d’agent, un forfait mensuel par unité.
- Consommation, facturée par tâche lancée, par appel d’API ou par minute vocale.
- Résultat, facturé par ticket résolu, rendez-vous planifié ou facture encaissée, sans frais en cas d’escalade.
Une quatrième structure émerge au niveau de la plateforme : un forfait illimité avec des frais de plateforme fixes et sans plafond d’utilisateurs, d’agents ou de workflows, la consommation de modèles d’IA restant la seule variable. Creatio a lancé ce modèle en mai 2026 ; les frais de plateforme sont fixes, tandis que l’utilisation des modèles est suivie au moyen de crédits.16 La question pratique pour un acheteur est la même qu’avec la tarification à la consommation : combien coûte l’exécution d’un agent, et qui contrôle choix du modèle qui la détermine.
La tarification hybride, avec des frais de plateforme de base plus un niveau d’utilisation ou de résultat, est devenue la structure courante, car elle offre aux acheteurs un plancher prévisible et aux fournisseurs une part des gains.
Le risque contractuel tient en un seul mot. « Résolution » doit être défini par écrit dans le contrat, sinon c’est le fournisseur qui en fournit une. Une conversation qui se termine sans escalade n’est pas la même chose qu’un problème client résolu, et l’écart entre ces deux interprétations représente toute la facture.
 Ajouter comme source préférée
Le problème de gouvernance que personne n’a encore résolu
L’outillage de gouvernance commence à rattraper son retard. Plusieurs solutions concrètes ont été livrées :
- Cisco IA Agent Monitor pour Splunk Observability Cloud : suivi en temps réel de la qualité des workflows d’agents, du coût par exécution et des anomalies comportementales, en phase de test public. 17
- OpenAI Frontier : chaque agent se voit attribuer une identité définie avec des autorisations explicites, des pistes d’audit et des garde-fous, sur le modèle de la gestion des accès des employés humains.18
- Agentic IA Foundation (AAIF) : OpenAI, Anthropic et Block ont cofondé en décembre 2025 un consortium soutenu par la Linux Foundation afin d’établir des standards de gouvernance ouverts et neutres vis-à-vis des fournisseurs pour l’IA agentique. AWS, Google, Microsoft, Bloomberg et Cloudflare l’ont rejoint en tant que membres Platinum. Anthropic a fait don de MCP à la fondation, garantissant qu’il reste un standard industriel ouvert plutôt qu’un protocole propriétaire.19
- Creatio IA Studio : un tableau de bord de gouvernance montrant l’historique d’exécution, les taux de réussite, les violations de politiques et la consommation par agent, avec des contrôles PII et PCI définis par l’administrateur et des étapes d’approbation humaine placées dans les workflows d’agents.
Ce qui fonctionne et ce qui ne fonctionne pas encore
Fonctionne aujourd’hui
Aide au codage avec un réviseur humain. Un schéma courant associe un agent d’IDE rapide à un agent de raisonnement plus lent : le premier pour l’itération, le second pour les décisions architecturales. L’agent exécute des tests et itère sur les échecs. Une personne vérifie avant la fusion.
Support répétitif à volume élevé. Les agents résolvent les demandes courantes à des taux publiés par les fournisseurs que les acheteurs devraient vérifier par rapport à la qualité de leur propre contenu. La latence de réponse s’améliore quel que soit le taux de résolution, car une réponse partielle instantanée vaut mieux qu’une réponse le lendemain.
Synthèse de recherche avec citations. Les agents parcourent les nouvelles publications, extraient les sections pertinentes et tiennent à jour des listes de références. Le résultat doit être vérifié, et le temps gagné reste considérable.
Inventaires d’agents gouvernés. Les produits les plus récents de cette catégorie résolvent le comptage et les autorisations plutôt que la capacité. C’est un problème réel dans les organisations où les agents proviennent de plusieurs équipes à la fois.
Ne fonctionne pas encore
Déploiement en production entièrement autonome. Les agents qui livrent du code ou déplacent de l’argent sans approbation restent trop risqués pour la plupart des organisations. Les recherches sur la fiabilité expliquent pourquoi : la cohérence s’est à peine améliorée en deux ans de gains de capacités. Les systèmes bornés avec des défaillances récupérables sont l’exception.
Situations client complexes. Les agents s’effondrent lorsque de l’empathie, du jugement ou un contexte non exprimé est nécessaire.
Décisions multipartites. Les agents ne savent pas lire les jeux politiques organisationnels ni négocier autour de contraintes implicites.
Stratégie inédite. Les agents optimisent à l’intérieur de paramètres donnés. Ils ne remettent pas en question les paramètres.
Confinement des défaillances multi-agents. Lorsque les agents consomment la sortie les uns des autres, une erreur devient une prémisse acceptée en aval. La littérature sur la fiabilité signale la propagation des erreurs entre agents comme un problème de recherche ouvert, tandis que les entreprises déploient malgré tout des architectures multi-agents.
Pour aller plus loin
Citer cette recherche
Choisissez le format qui correspond à votre lieu de publication. Coller la version avec lien dans votre CMS préserve le lien retour.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Arslan, Ezgi},
  title  = {{Outils d'agents IA: comparaison de 15+ plateformes}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/ai-agent-tools}},
  note   = {AIMultiple. Consulté le 11 septembre 2026}
}Résultats et horodatages de 20 points de données. Téléchargez les données de synthèse présentées dans les graphiques et les tableaux de cet article sous forme de fichier ZIP contenant 5 fichiers CSV.
Vous voulez les données détaillées derrière ? Rejoindre Premium
Journal des modifications
12 mises à jourAjout d'une section Fiabilité vs Précision citant une étude de Princeton sur les agents.
Suppression de la liste d'exemples de plateformes et outils d'IA agentique dans l'introduction.
Mise à jour des données pour Cursor, Claude Code, GitHub Copilot et Kiro dans la section Agents de codage.
OpenAI Frontier et Kiro (AWS) ont été ajoutés à la liste des plateformes agéntiques populaires.
Ajout de Creatio à la liste des plateformes et outils populaires de style agentique.
Liens de référence
Le travail de Cem chez AIMultiple a été cité par des publications mondiales de premier plan, notamment Business Insider, Forbes, Morning Brew et Washington Post, par des entreprises mondiales comme Deloitte et HPE, par des ONG comme World Economic Forum et par des organisations supranationales comme European Commission. [1], [2], [3], [4], [5]
Tout au long de sa carrière, Cem a été consultant en technologies, acheteur de technologies et entrepreneur technologique. Il a conseillé des entreprises sur leurs décisions technologiques chez McKinsey & Company et Altman Solon pendant plus de dix ans. Il a également publié un rapport McKinsey sur la digitalisation.
Il a dirigé la stratégie technologique et les achats d'un opérateur télécom, sous la responsabilité du PDG. Il a également dirigé la croissance commerciale de l'entreprise de technologie profonde Hypatos, qui a atteint un revenu récurrent annuel à 7 chiffres et une valorisation à 9 chiffres, passant de 0 à ce résultat en deux ans. Le travail de Cem chez Hypatos a été couvert par des publications technologiques de premier plan comme TechCrunch et Business Insider.
Cem intervient régulièrement lors de conférences technologiques internationales. Il est diplômé de Bogazici University en tant qu'ingénieur informatique et titulaire d'un MBA de la Columbia Business School.

À lire ensuite
Comparer les 10 meilleures plateformes de gestion informatique tout-en-un


Meilleurs proxies Discord: Offres gratuites, fonctionnalités et configuration

MFT Benchmark: Files.com, Diplomat MFT, Cerberus et Serv-U testés




Soyez le premier à commenter
Votre adresse courriel ne sera pas publiée. Tous les champs sont obligatoires. Les commentaires sont laissés dans leur langue d'origine.