


Recherche approfondie IA: Codex vs Claude vs Grok vs Exa

Un outil de recherche approfondie répond à une question par un rapport écrit au lieu d’une page de liens. Nous avons exécuté cinq façons d’en produire un sur les mêmes 20 cahiers des charges de recherche métier et avons noté chaque rapport selon des règles rédigées avant les exécutions pour trouver le meilleur outil de recherche approfondie. Quatre des cinq sont des agents de codage, des outils en ligne de commande conçus pour le développement logiciel qui peuvent également rechercher et lire le web ; le cinquième, Exa Agent, est conçu pour la recherche.
Résultats du DR-20 Bench
Chacun des cinq outils a produit un rapport pour chacune des 20 tâches, soit 100 rapports au total, notés en aveugle selon des règles rédigées avant les exécutions. Voir plus de détails sur la méthodologie.
Le seul produit de recherche approfondie spécialement conçu s’est classé en dessous de trois des quatre agents de codage. Exa Agent a obtenu 0.584, et chacun de ces trois écarts survit à la correction de Holm dans les dix comparaisons par paires. Sur ces cahiers des charges, Codex CLI, Claude Code et Grok CLI ont tous obtenu des scores supérieurs au produit conçu pour cette tâche.
Exa Agent et Gemini CLI n’ont montré aucune différence statistiquement significative dans les scores d’exigences.
Nous n’avons trouvé aucune différence statistiquement significative entre Codex CLI et Claude Code sur ces 20 tâches. L’écart est de 0.015 sur une échelle de 0 à 1, avec un p non ajusté de 0.67 et 0.96 après correction de Holm. Sur 10 000 échantillons bootstrap, les deux présentaient un intervalle de rang de 95 % de 1 à 2. Ils dominent sur des mesures différentes : Codex CLI sur les exigences écrites de 0.015, Claude Code sur la reproduction des faits de 1.2 points de pourcentage.
Faits exacts reproduits
Claude Code a entièrement reproduit 202 des 434 éléments factuels requis, Codex CLI 198 et Exa Agent 89. Aucun outil n’a atteint la moitié. Un élément n’était crédité que lorsque le rapport incluait correctement tous ses détails requis. Ce contrôle portait sur une liste de faits prédéfinie ; nous n’avons pas audité chaque affirmation des rapports.
Coût & qualité de la recherche
Grok CLI a obtenu 0.699 pour $1,91 par tâche ; les deux leaders coûtent de $13,38 à $18,35, soit sept à dix fois plus. Grok suivait Claude Code avec un écart de 0.076 et un p ajusté selon Holm de 0.006. Son écart de 0.091 par rapport à Codex CLI n’était pas significatif après correction, à 0.072.
Les deux outils les moins chers ont aussi obtenu les scores les plus bas. Gemini CLI a coûté $0,58 par tâche et a obtenu 0.565 ; Exa Agent a coûté $1,00 et a obtenu 0.584, soit une différence avec un p ajusté selon Holm de 0.958.
Codex CLI, Claude Code et Grok CLI ont fonctionné ici sur abonnement ; leurs chiffres sont des équivalents au tarif API public. Consultez la LLM tarification pour connaître le coût de ces abonnements et de leurs tarifs API. Exa a été facturé en utilisation API et $20,00 correspond à ses dépenses réelles. Le $0,58 par tâche de Gemini couvre uniquement les tokens et exclut le grounding de recherche, dont le nombre de requêtes facturables n’a pas été capturé.
Durée des tâches & qualité de la recherche
Les deux leaders sont aussi les deux plus lents. La tâche médiane de Codex CLI a pris 42 minutes pour un score de 0.790, et celle de Claude Code a pris 36 minutes pour 0.775, contre 13 minutes pour Grok CLI à 0.699. La durée d’exécution ne classe pas le reste. Gemini CLI a mis 1.5 minutes de plus qu’Exa Agent et a obtenu 0.019 de moins.
Longueur du rapport & travail accompli
Le contre-exemple le plus clair à l’idée que plus long est meilleur se trouve en haut du tableau. Dans le rapport médian, Claude Code dépense 271 mots par exigence satisfaite et Codex CLI 137, et les deux obtiennent des scores à 0.015 l’un de l’autre. Exa Agent est le plus économe avec 91 mots par exigence, pour un score de 0.584.
L’étendue et la qualité des sources se séparent. Le rapport médian de Claude Code cite 28 sites web distincts, contre 16 pour Codex CLI, tandis qu’une part plus élevée des citations de Codex CLI renvoie vers des pages officielles et primaires, 34,8 % contre 25,8 %. Gemini CLI cite le moins densément, avec 4.2 liens pour 1 000 mots.
Certains liens cités étaient cassés. Nous avons compté les URL ayant renvoyé une erreur 404 ou 410 ou ayant un format invalide. Les totaux sur les 20 rapports par outil étaient :
- Gemini CLI : 63
- Claude Code : 26
- Grok CLI : 16
- Codex CLI : 14
- Exa Agent : 14
Évolutions des outils de recherche approfondie IA
La recherche approfondie a atteint l’Gemini API
Google a ajouté Deep Research à l’Gemini API en tant qu’agent que les développeurs appellent directement, parallèlement à la fonctionnalité déjà intégrée dans l’application Gemini.1 Il est disponible en deux versions : deep-research-preview-04-2026 pour la vitesse, et deep-research-max-preview-04-2026 pour l’exhaustivité.
Google le facture en paiement à l’usage sur les models et outils sous-jacents, et estime une tâche typique entre $1 et $3 pour la version standard et entre $3 et $7 pour Max. Une tâche s’exécute en arrière-plan et est plafonnée à 60 minutes, la plupart se terminant en moins de 20.
Exa a indexé des publications universitaires
Exa a lancé la recherche sémantique sur les articles universitaires le 23 juillet 2026, couvrant environ 350 millions de publications et 30 millions d’auteurs.2 L’argument est de retrouver un article à partir d’un souvenir vague plutôt que d’un titre exact.
Exa annonce un rappel de 86,4 % sur son benchmark de récupération, contre 66,8 % pour Perplexity et 28,0 % pour Google Scholar. Ce sont les chiffres du fournisseur sur son propre benchmark ; il faut donc les considérer comme une indication plutôt qu’un classement définitif. Le même billet cite deux latences moyennes différentes, ce qui est une raison d’attendre une vérification indépendante.
Bright Data Deep Lookup répond à une question différente
Deep Lookup de Bright Data renvoie des lignes d’entités, et non un rapport de recherche rédigé. Chaque ligne représente une entreprise, une personne ou un produit. Les utilisateurs peuvent créer des listes pour la prospection commerciale, la recherche d’investissement ou le recrutement.3
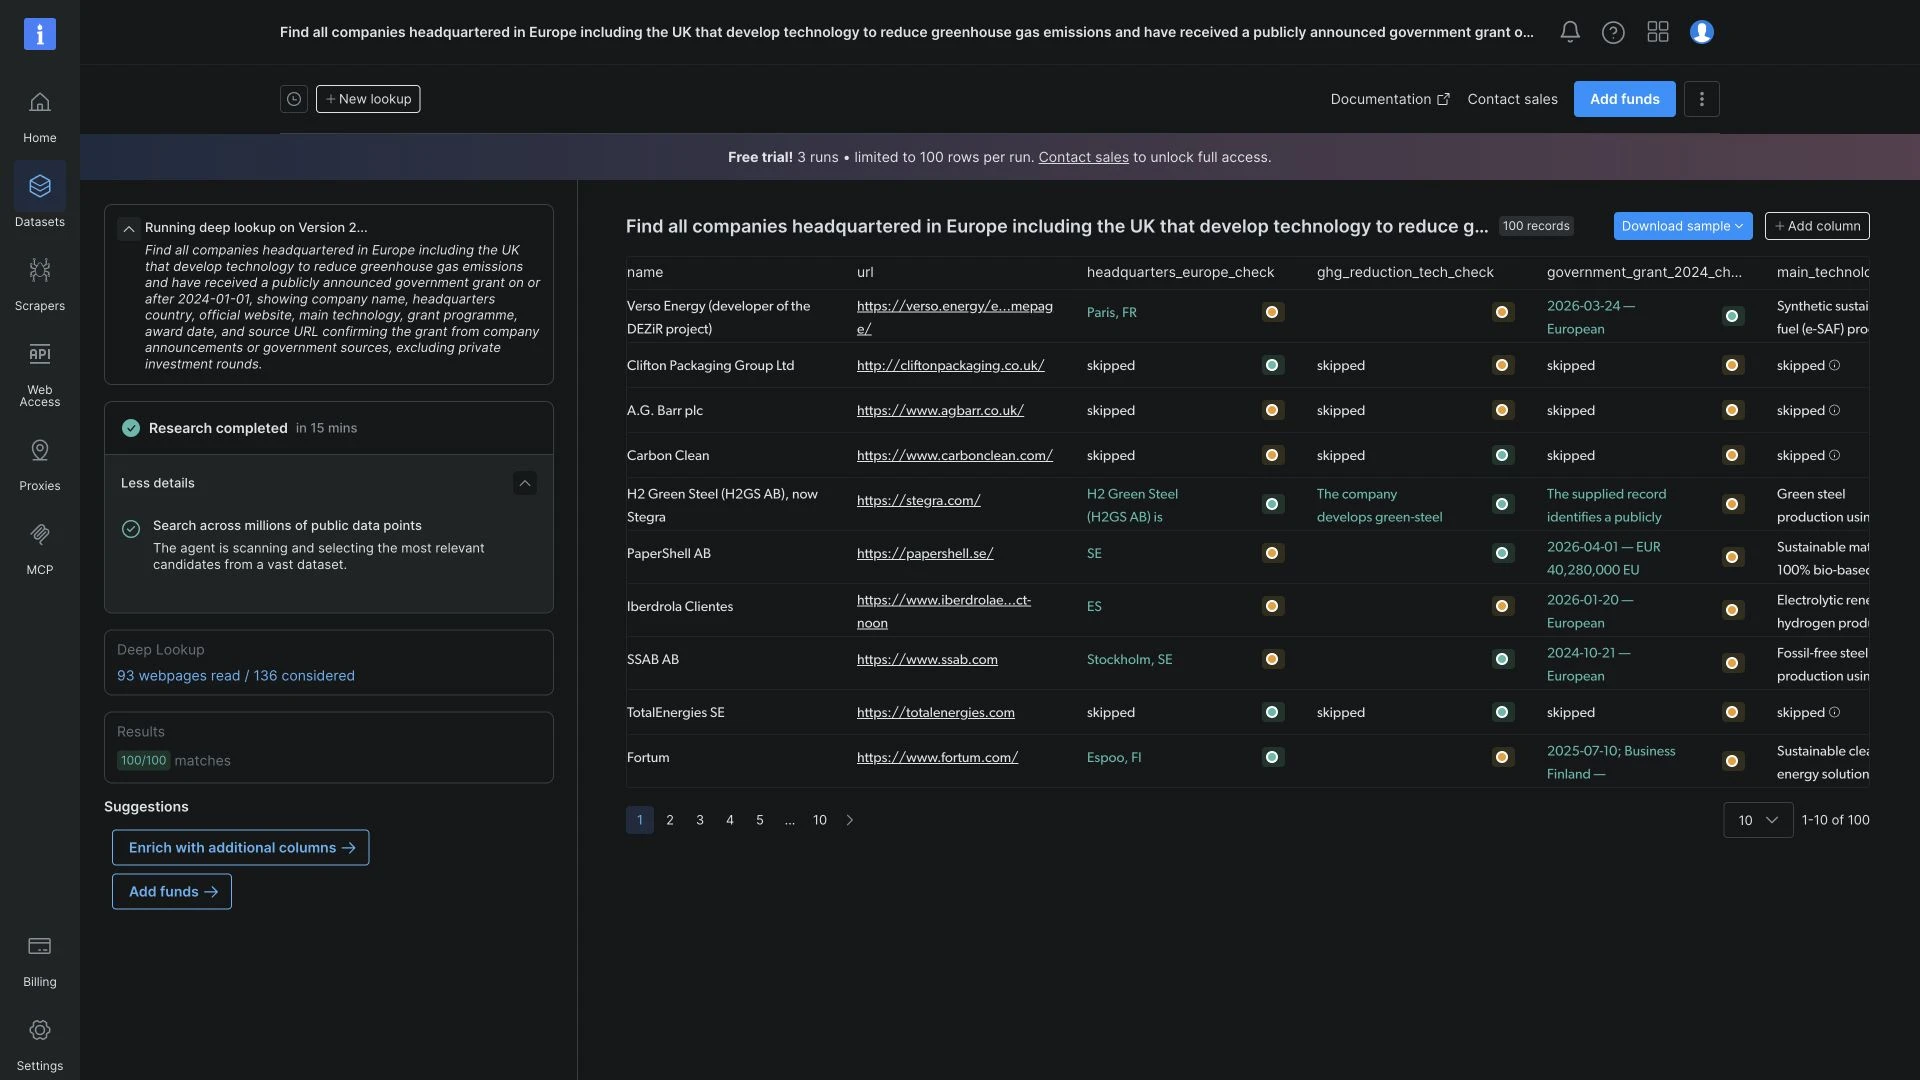
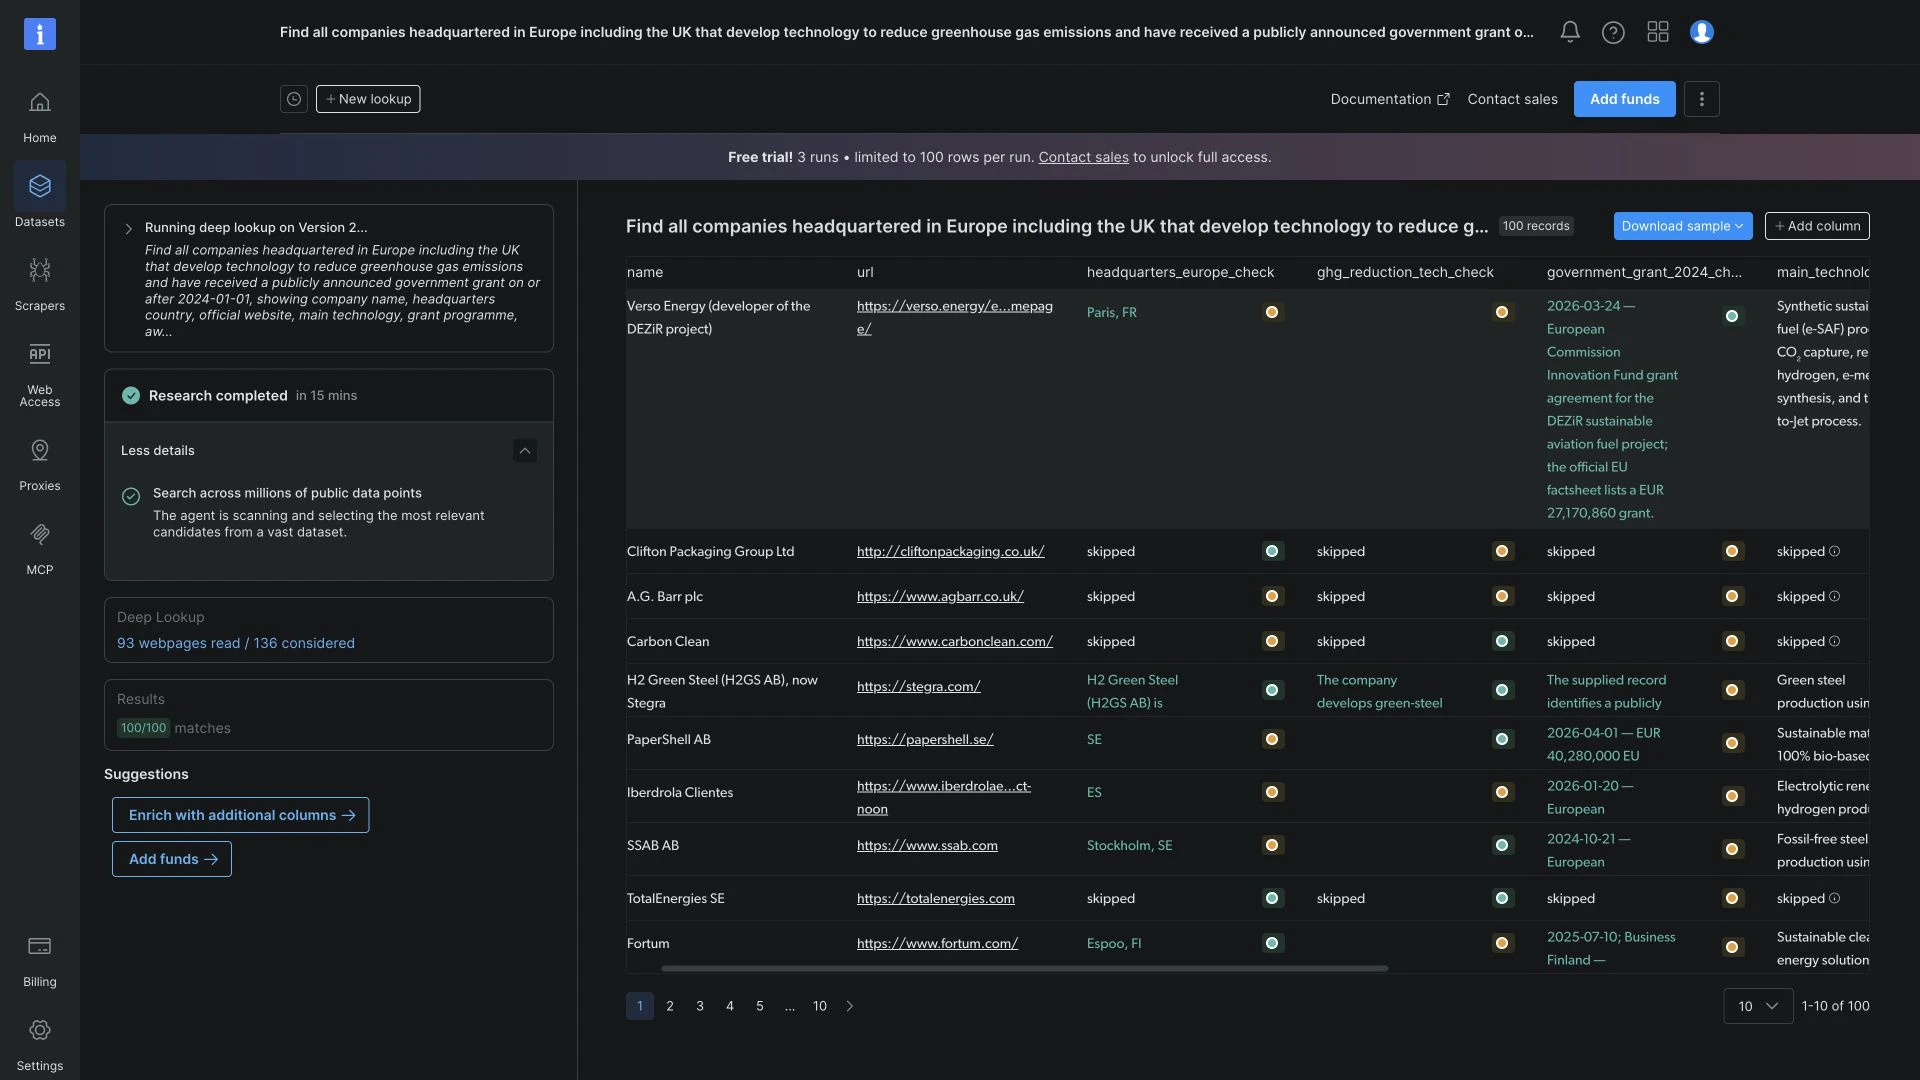
Nous avons recherché des entreprises européennes développant des technologies de réduction des émissions de gaz à effet de serre. La requête incluait le Royaume-Uni et exigeait une subvention publique annoncée depuis le 1er janvier 2024.
Deep Lookup a créé une colonne distincte pour chaque condition. L’expansion d’une ligne affichait des explications plus longues, avec des indicateurs de confiance colorés à côté des détails individuels. L’interface indiquait une exécution de 15 minutes qui a atteint la limite de 100 enregistrements de l’essai.
Des colonnes supplémentaires contenaient les descriptions des technologies, les programmes de subvention, les dates d’attribution et les liens sources. Les liens nous ont permis de vérifier les affirmations relatives aux subventions par rapport aux annonces. Le menu de téléchargement proposait les formats CSV et JSON.3
Les équipes commerciales peuvent utiliser Deep Lookup pour trouver des entreprises dans un secteur et une région cibles. Les investisseurs peuvent identifier des entreprises développant une technologie particulière ou recevant des financements publics. Les recruteurs peuvent rechercher des professionnels ayant des rôles et une expérience pertinents.3
La combinaison de plusieurs conditions de recherche avec des colonnes de résultats personnalisées permet aux équipes de créer des listes selon leurs propres critères et de comparer les détails en un seul endroit.
L’outil Deep Research d’Azure comporte un avertissement de limite de données
Microsoft propose Deep Research dans Azure AI Foundry Agent Service, accessible depuis les SDK Python, C# et JavaScript, et désormais documenté au sein de son outillage d’agents classique.4
La raison de lire cette page avant de l’adopter figure sur la page elle-même : Microsoft indique que la requête de recherche Bing, les paramètres de l’outil et la clé de ressource sont transférés hors de la limite de conformité Azure vers Grounding with Bing Search. Les équipes qui ont choisi Azure pour que rien ne quitte cette limite doivent vérifier quelles parties d’une exécution de recherche la franchissent.
Avantages des outils de recherche approfondie IA
Un rapport de recherche sourcé en quelques minutes
Dans notre benchmark, les durées médianes des tâches allaient de 5.5 à 42 minutes selon l’outil. Chaque exécution a produit un rapport de recherche avec des liens sources. Nous n’avons pas mesuré le temps qu’une personne mettrait à accomplir les mêmes tâches.
Les scores d’exigences ont atteint 0.790 au maximum sur les cinq outils et 20 cahiers des charges. Les exigences couvrent l’ensemble du rapport, des sections demandées aux calculs du tableau des coûts ; un score à ce niveau signifie donc que la majeure partie du cahier des charges a été traitée dans la forme demandée.
L’étendue en un seul passage
Un agent de recherche peut rassembler des éléments provenant de plusieurs sites web pour une comparaison de fournisseurs, une revue des modifications d’une norme sectorielle ou une introduction à un sujet de recherche peu familier. Le rapport obtenu donne au lecteur une vue d’ensemble initiale et des sources à approfondir.
Un brouillon de recherche modifiable
Le résultat est un document ; il peut donc être modifié, contesté et relancé. C’est un mode de travail différent d’une page de résultats de recherche. Un document à l’aspect fini est aussi le risque : il incite à moins vérifier qu’une liste de liens.
 Ajouter comme source préférée
Défis et limites des outils de recherche approfondie IA
Ce sont les faits qui posent problème, pas la structure
La plupart des gens savent qu’un LLM peut inventer une réponse, et ils vérifient ce qu’il produit. Un rapport de recherche approfondie incite moins à cette vérification, car il est long, sourcé et bien organisé, de sorte qu’il semble déjà vérifié.
Un rapport peut satisfaire aux exigences concernant ses sections, tableaux et calculs tout en omettant ou en énonçant incorrectement des faits requis.
Avant d’utiliser un rapport pour prendre une décision, vérifiez les dates, chiffres et conclusions réglementaires pertinents par rapport aux sources originales.
Les citations ne signifient pas que la source le dit
Notre audit des citations a vérifié si les liens fonctionnaient et a classé leurs sources. Il n’a pas vérifié si chaque page étayait l’affirmation qui lui était associée. Même un lien fonctionnel vers une source officielle nécessite cette vérification : la page peut traiter du sujet sans étayer le chiffre précis ou la conclusion du rapport.
La longueur n’est pas la profondeur
Le rapport médian de Claude Code contenait 11 449 mots, contre 5 734 pour Codex CLI, sans différence statistiquement significative dans les scores d’exigences.
Les lecteurs doivent prendre en compte la quantité de contenu qu’ils devront examiner, ainsi que la durée d’exécution et le prix de l’outil.
Biais, confidentialité et dépendance excessive
Les données d’entraînement portent les biais de ce qui a été écrit, et une étape de synthèse peut les durcir en quelque chose qui se lit comme une conclusion. Avec un outil hébergé, tout document interne téléversé pour le contexte quitte vos systèmes ; il vaut donc la peine de vérifier les conditions du fournisseur avant que cela ne devienne une routine. Le risque le plus difficile à mesurer est le dernier : un rapport soigné que personne ne vérifie érode l’habitude de vérifier.
Méthodologie
Environnement de test
Nous avons exécuté les quatre outils CLI depuis un serveur cloud Linux et avons accédé à Exa Agent via son API. Chacun utilisait ses propres outils de recherche.
Tâches et procédure de test
- Nous avons rédigé 20 cahiers des charges couvrant la sélection de fournisseurs, la planification de migration, les models de coûts et la recherche réglementaire. Chacun précisait une date limite de reporting et disposait de réponses de référence établies à partir de sources primaires.
- Chaque outil a reçu les mêmes prompts de tâche. Nous avons évalué un rapport par outil et par tâche, soit 100 rapports sur cinq outils.
- Nous avons fixé les prompts, les configurations de models et les règles de notation avant la production. Aucune tâche n’a été relancée pour améliorer un score faible.
Critères de notation
- Exigences : chaque tâche comportait de 42 à 74 contrôles réussite/échec. Par exemple, un tableau des coûts pouvait nécessiter un prix unitaire et sa source.
- Pénalités : des défauts prédéfinis réduisaient le score, par exemple traiter un problème comme résolu après l’avoir qualifié d’irrésolu ailleurs dans le rapport. Score = max(0, (exigences réussies − pénalités déclenchées) / exigences totales). Le score global de chaque outil est la moyenne de ses 20 scores de tâche. Nous avons également vérifié une formule alternative qui déduit 0.1 par pénalité de la fraction d’exigences réussies, avec un score minimum de zéro. C’est l’option Pénalité alternative du graphique. L’ordre des cinq outils était inchangé.
- Détails factuels : une liste de contrôle distincte contenait 434 faits requis. Un élément n’était crédité que lorsque le rapport incluait correctement chaque détail requis dans la tolérance indiquée. Les réponses partielles ne rapportaient aucun crédit. Ces contrôles ne contribuaient pas au score d’exigences. Les pourcentages de faits donnent un poids égal à chaque tâche. Les totaux cumulent les réussites sur l’ensemble des 434 éléments.
Juges model
- Nous avons supprimé les métadonnées identifiantes et les chemins de fichiers locaux avant la notation. Les deux juges ont reçu le même rapport, les mêmes règles de tâche, les mêmes faits de référence et le même audit des citations.
- GPT-5.6 Sol et Grok 4.6 ont noté chaque rapport de manière indépendante. Pour chaque exigence et pénalité, chaque juge a consigné une raison liée au rapport avant d’attribuer un verdict de réussite ou d’échec. Ils ont également vérifié chaque élément factuel.
- Claude Opus 5 a résolu les désaccords en utilisant les mêmes preuves. Les décisions sur lesquelles les deux premiers juges étaient d’accord sont restées inchangées. Les deux juges initiaux étaient d’accord sur 93,3 % des verdicts de règles et 89,1 % des décisions sur les éléments factuels.
Analyse statistique
Nous avons utilisé des tests appariés sur les 20 tâches et appliqué la correction de Holm sur les dix comparaisons d’outils par paires. Nous avons estimé les intervalles de rang à 95 % en rééchantillonnant les tâches 10 000 fois.
Limites
- Un rapport par outil et par tâche ne mesure pas dans quelle mesure les réponses d’un même outil varient d’une exécution à l’autre.
- Nous avons vérifié la disponibilité des liens et le type de source, mais n’avons pas vérifié si chaque page citée étayait l’affirmation associée. Les contrôles exigeant cette vérification ont reçu un verdict d’échec pour tous les outils : les contrôles positifs n’ont apporté aucun crédit et les contrôles négatifs n’ont déclenché aucune pénalité.
- Nous avons affiné huit tâches après un essai pilote antérieur. Nous gardons les cahiers des charges non publiés pour de futures évaluations.
FAQ
La recherche assistée par IA utilise des outils d’IA pour trouver, analyser et résumer des informations. Un outil de recherche approfondie va au-delà d’une réponse de chat : il s’exécute pendant des minutes, ouvre de nombreuses sources et produit un rapport avec des citations.
Ce dans quoi il excelle, d’après nos propres mesures, c’est la forme de la réponse. Là où il est faible, ce sont les détails précis. Le plus performant des cinq outils que nous avons testés a reproduit 202 des 434 valeurs, dates et noms requis, et le moins performant en a reproduit 89.
C’est pourquoi un rapport de recherche approfondie doit être vérifié avant toute publication. Le rapport peut sembler terminé même si les chiffres sont faux. Benchmarks associés : codage IA.
Les outils d’IA peuvent aider à différents aspects des revues de littérature, notamment identifier les articles pertinents, résumer les principales conclusions et organiser les thèmes de recherche. Ces outils peuvent traiter rapidement de grands volumes de littérature universitaire et aider les chercheurs à repérer des lacunes ou des tendances entre les études. Toutefois, l’IA ne peut pas remplacer entièrement le jugement humain dans l’évaluation de la qualité des sources, la synthèse d’arguments complexes ou l’analyse critique. Les chercheurs doivent toujours examiner, vérifier et interpréter le contenu généré par l’IA afin de garantir l’exactitude et de maintenir la rigueur académique de leurs revues de littérature.
Les outils d’IA peuvent aider à l’analyse de données et aux travaux statistiques en nettoyant les datasets, en effectuant des tests statistiques, en créant des visualisations et en repérant des schémas dans de grands datasets. Ces outils peuvent suggérer des méthodes statistiques appropriées en fonction du type de données et des questions de recherche. Toutefois, les chercheurs doivent comprendre le contexte de leurs données et valider les résultats, car l’IA peut passer à côté de nuances propres à un domaine ou poser des hypothèses inappropriées.
La plupart des outils modernes de recherche IA utilisent des interfaces en langage naturel qui ne nécessitent pas de compétences en programmation. Cependant, une culture de base des données et la compréhension des concepts fondamentaux de la recherche aident les utilisateurs à formuler de meilleures requêtes et à interpréter les résultats plus efficacement. Les applications avancées peuvent bénéficier de connaissances techniques pour des analyses personnalisées ou des flux de travail spécialisés.
Ouvrez chaque source utilisée pour une affirmation importante et vérifiez qu’elle étaye les chiffres, dates et conclusions du rapport. Confirmez que la source s’applique à la période et au contexte pertinents. La liste de contrôle des faits de notre benchmark couvrait des détails prédéfinis ; ses scores n’établissent donc pas l’exactitude de chaque affirmation d’un rapport.
Citez ce benchmark
Choisissez le format qui correspond à votre lieu de publication. Coller la version avec lien dans votre CMS préserve le lien retour.
@misc{kalelioglu2026,
  author = {Kalelioğlu, Berk},
  title  = {{Recherche approfondie IA: Codex vs Claude vs Grok vs Exa}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/ai-deep-research}},
  note   = {AIMultiple. Consulté le 11 septembre 2026}
}Résultats et horodatages de 20 points de données. Téléchargez les données de synthèse présentées dans les graphiques et les tableaux de cet article sous forme de fichier ZIP contenant 3 fichiers CSV et un README.
Vous voulez les données détaillées derrière ? Rejoindre Premium
Journal des modifications
8 mises à jourRemplacé le résumé Agents contre modèles de recherche approfondie par le constat que les agents égalent leur précision à moindre coût.
Ajout d'une section de benchmark Agents vs modèles de recherche approfondie comparant six outils sur cinq tâches.
Ajout d'une section de méthodologie du benchmark détaillant les cinq tâches de recherche, les sources de référence, la notation et les interfaces des outils.
Ajout du DR-2T (Deep Research 2 Task) Bench à la section de référence de la recherche approfondie en IA.
Liens de référence





Soyez le premier à commenter
Votre adresse courriel ne sera pas publiée. Tous les champs sont obligatoires. Les commentaires sont laissés dans leur langue d'origine.