


LLM Tarification: comparatif des 15+ principaux fournisseurs

Nous suivons les prix de lancement de plus de 160 LLMs, depuis GPT-3.5 Turbo en mars 2023 jusqu’aux dernières sorties, regroupés par classe de taille. Nous comparons également les prix des API des modèles actuels avec leurs résultats de référence et passons en revue les plans d’abonnement des principaux fournisseurs.
LLM tendances des prix de lancement
- Claude Opus lancement prix sont passés de $30,00 (Opus 4.1, août 2025) à $8,00 (Opus 5.5, septembre 2026).
- Claude Fable 5 a été lancé à $20,00 en juin 2026, soit le double du prix de Claude Opus 4.8 deux semaines plus tôt. OpenAI a suivi avec GPT-6 Astra à $20,00 en septembre.
- GPT-6 Sol a été lancé à $4,00 en septembre 2026, soit 64 % de moins que les $11,25 de GPT-5.6 Sol en juillet. GPT-6 Luna a été lancé à $0,20, contre $2,25 pour GPT-5.6 Luna.
- Le prix de lancement médian des petits modèles fermés est passé de $0,53 en 2024 à $0,85 en 2025. En 2026, Gemini 3.5 à 3.8 Flash a été lancé à $3,00 à $3.38.
- En 2025, le prix de lancement médian des grands modèles à poids ouverts était inférieur au quart de la médiane des modèles fermés de milieu de gamme. Le Kimi K3 de Moonshot a été lancé à $6,00 en juillet 2026, au-dessus des $4,00 de Claude Sonnet 5.
Les prix sont indiqués par million de tokens, avec un mélange de trois parts d’entrée pour une part de sortie, et excluent les promotions à durée limitée. Les modèles à poids ouverts ont des poids publiés publiquement ; pour ceux sans API de première partie, le prix correspond au tarif d’un hébergeur autour du lancement. Les nouveaux lancements peuvent encore modifier les moyennes du trimestre en cours.
LLM API : évaluation des prix
Il existe deux façons de payer pour un LLM : les plans d’abonnement avec une tarification forfaitaire LLM des principaux fournisseurs, ou un modèle API à l’usage facturé en fonction des tokens consommés.
Cliquez sur les noms des modèles pour afficher leurs résultats de benchmark, leur latence réelle et leur tarification, afin d’évaluer l’efficacité et le rapport coût-efficacité de chaque modèle.
Classement : les modèles sont classés selon leur position moyenne sur l’ensemble des benchmarks.
Vous pouvez consulter les taux d’hallucination et les performances de raisonnement des meilleurs LLMs dans nos benchmarks.
Comparatif des plans d’abonnement LLM
Les utilisateurs non techniques peuvent préférer utiliser l’interface utilisateur plutôt que l’API. En 2026, la plupart des abonnements des fournisseurs incluent bien plus qu’une interface de chat. Les agents de codage comme Claude Code, Codex, Kimi Code et Mistral Vibe sont inclus dans les plans de niveau Pro. Pour les développeurs et les utilisateurs intensifs, le bon abonnement à $10–$200 remplace souvent ce qui représenterait autrement un abonnement séparé à un IDE de codage, un budget d’API par token et un outil vidéo ou de recherche combinés.
OpenAI
Le plan Free inclut des conversations texte quotidiennes illimitées avec GPT-5.6 Luna, le mode vocal standard, des téléversements limités et la génération d’images de base. Les publicités contextuelles touchent environ 40 marchés en août 2026, y compris les États-Unis et la majeure partie de l’Europe, et n’apparaissent que sur les plans Free et Go.
- ChatGPT Go ($8/mois) est un plan à bas prix pouvant inclure des publicités. Les conversations texte sont illimitées, comme sur Free ; la mise à niveau offre des limites plus élevées pour les téléversements de fichiers, la création d’images, la voix et la mémoire, le tout sur GPT-5.6 Luna.
- ChatGPT Plus ($20/mois) inclut des limites d’utilisation étendues, l’accès à GPT-5.6 Sol, Terra et Luna, le mode vocal avancé, l’agent Codex, la génération d’images et des fonctionnalités en accès anticipé.
Le plan Pro propose deux niveaux depuis avril 2026 :
- ChatGPT Pro ($100/mois) fournit la même gamme de modèles que le niveau à $200 (dont GPT-5.6 Sol) avec environ 5x les limites d’utilisation de Plus.
- ChatGPT Pro ($200/mois) offre les limites d’utilisation individuelles les plus élevées (environ 20x Plus), l’allocation maximale de Deep Research, la voix avancée avec vidéo et partage d’écran, Codex avec une augmentation maximale de l’utilisation et Sora.
Les deux niveaux Pro incluent un accès prioritaire pendant les heures de pointe. La tarification de Codex sur Plus, Pro et Business est passée d’une facturation par message à une utilisation alignée sur les tokens de l’API en avril 2026.
ChatGPT Work, l’agent d’OpenAI pour les projets multi-étapes de longue durée (lancé le 9 juillet 2026), est inclus dans les plans payants, et l’application de bureau regroupant Chat, Work et Codex est disponible sur tous les plans, y compris Free.
- Plan Business ($20/utilisateur/mois en annuel ou $25/utilisateur/mois en mensuel) est le plan d’OpenAI pour les petites et moyennes équipes (anciennement ChatGPT Team, renommé en août 2025). Il ajoute des limites de messages plus élevées, une console d’administration, la SSO, des données d’équipe exclues de l’entraînement et des pools de crédits partagés pour les fonctionnalités avancées. Applications incluses : Codex avec des crédits d’espace de travail partagés. Les sièges Codex uniquement ont été fermés aux nouveaux espaces de travail le 24 juin 2026 ; OpenAI a annoncé des sièges Premium à $100/utilisateur/mois en annuel ($125 en mensuel) avec une utilisation Standard 5x. Le plan nécessite au moins 2 sièges.
- Le plan Enterprise (tarification personnalisée) offre un accès aux modèles à grande vitesse, des fenêtres de contexte étendues, des contrôles de données de niveau entreprise, la vérification de domaine, des analyses et des journaux d’audit. Applications incluses : Codex avec un pool de crédits partagé et des sièges Codex uniquement en option.
Anthropic (Claude)
Le plan Free inclut un accès web et mobile, une analyse de base, l’accès à Claude Sonnet 5 et Haiku, ainsi que le téléversement de documents. L’utilisation quotidienne est plafonnée et les modèles Opus et Fable ne sont pas disponibles.
- Plan Pro ($20/mois, ou $17/mois facturé annuellement) donne accès à Opus 5, Sonnet 5 et Haiku, avec environ 5x plus d’utilisation que Free, une organisation par projets et un accès prioritaire pendant les heures de pointe. Fable 5 ne fait pas partie des limites d’utilisation du plan Pro ; il est facturé aux tarifs de l’API via des crédits d’utilisation à la demande. Applications incluses : Claude Code (l’agent de codage d’Anthropic dans le terminal et l’IDE), Cowork, Claude Design et Claude pour Microsoft 365, tous partageant le même pool d’utilisation que le chat.
- Plan Max 5x ($100/mois) offre environ 5x plus d’utilisation que Pro, un accès prioritaire aux nouvelles fonctionnalités et modèles, et un accès complet à Claude Code au niveau d’utilisation Max supérieur.
- Plan Max 20x ($200/mois) offre environ 20x plus d’utilisation que Pro, un accès prioritaire maximal et un accès complet à Claude Code. Conçu pour les utilisateurs intensifs quotidiens exécutant des charges de travail Claude Code. Les deux niveaux Max incluent Fable 5, le modèle plus cher d’Anthropic ; son utilisation peut représenter jusqu’à la moitié de la limite d’utilisation hebdomadaire du plan.
Le plan Team propose deux types de sièges et prend en charge de 2 à 150 membres :
- Siège Standard : $20/utilisateur/mois en annuel ($25/utilisateur/mois en mensuel). Inclut les fonctionnalités de base, des limites d’utilisation standard et l’accès à Claude Code.
- Siège Premium : $100/utilisateur/mois en annuel ($125/utilisateur/mois en mensuel). Tout ce qui est inclus dans Standard, plus des limites d’utilisation plus élevées pour les utilisateurs intensifs exécutant des charges de travail Claude Code plus lourdes.
Applications incluses : Claude Code et Cowork sont inclus avec chaque siège Team (Standard et Premium) ; la différence réside dans l’allocation d’utilisation, pas dans l’accès. Les deux types de sièges incluent la facturation centralisée, les outils de collaboration et les contrôles d’administration.
- Plan Enterprise ($20/siège/mois plus l’utilisation aux tarifs de l’API sur le niveau en libre-service ; tarification personnalisée avec le service commercial) offre des fenêtres de contexte étendues, la SSO, la capture de domaine, l’accès basé sur les rôles, SCIM, des journaux d’audit et des intégrations de données. Applications incluses : sur les nouveaux plans Enterprise et en libre-service, Claude Code et Cowork sont inclus avec chaque siège ; les anciens contrats Enterprise peuvent distinguer les sièges Chat seul des sièges Chat + Claude Code avec une facturation basée sur l’utilisation.
Google (Gemini)
Le plan gratuit donne accès à Gemini 3.6 Flash et à un accès variable à Gemini 3.1 Pro, à la génération d’images de base, à Deep Research, Gemini Live, Canvas et Gems. Applications incluses : Gemini Notebook (anciennement NotebookLM) et Flow avec un accès limité à Nano Banana Pro.
Google applique des tarifs régionaux, de sorte que les prix peuvent varier selon la région.
- Google IA Plus ($4,99/mois, États-Unis) est le niveau payant d’entrée de gamme avec des limites d’utilisation 2x celles du plan Free. Applications incluses : plus d’accès à Gemini 3.1 Pro dans le chat, génération d’images avec Nano Banana Pro, génération vidéo avec Gemini Omni Flash, 200 crédits Flow, Gemini Notebook avec plus d’Audio Overviews, Gemini dans Gmail, Docs et Vids, et un accès anticipé à Gemini dans Chrome. Inclut 400 Go de stockage.
- Google IA Pro ($19,99/mois, États-Unis) offre des limites d’utilisation 4x celles du plan Free et 5 To de stockage. Applications incluses : Jules (agent de codage asynchrone), Google Antigravity (plateforme de développement agentique), des limites IA Studio étendues, $40/mois en crédits Google Cloud, Gemini Notebook avec 5x d’Audio Overviews, Deep Research, 1 000 crédits Flow, YouTube Premium Lite et Google Home Premium (plan Standard).
- Google IA Ultra (États-Unis) coûte $99,99/mois pour des limites d’utilisation 5x celles d’IA Pro ou $199,99/mois pour 20x. Applications incluses : raisonnement Deep Think, Gemini Agent (États-Unis uniquement), Gemini Spark, Project Genie (modèle de monde interactif), Jules aux limites les plus élevées, Antigravity de niveau supérieur, 10 000 ou 25 000 crédits Flow, Google Home Premium (plan Advanced) et un abonnement individuel YouTube Premium. Le stockage commence à 20 To.
Microsoft Copilot
Le plan gratuit (Copilot Chat) est disponible sans coût supplémentaire pour tous les utilisateurs de Microsoft Entra disposant d’un abonnement Microsoft 365 éligible. Il inclut le chat Copilot de base dans les applications Microsoft sans les fonctionnalités approfondies dans les documents.
- Microsoft 365 Premium ($19,99/mois ou $199,99/an) est désormais le plan Copilot grand public. Il regroupe les applications Office, jusqu’à 6 To de stockage (1 To chacun pour jusqu’à six personnes) et les limites Copilot grand public les plus élevées ; les fonctionnalités d’IA s’appliquent uniquement au titulaire de l’abonnement. L’ancien Copilot Pro ($20/mois) est fermé aux nouveaux achats, et les abonnés existants peuvent le conserver ou passer à Premium.
- Microsoft 365 Copilot Business ($21/utilisateur/mois en annuel ; tarif de première année de $18/utilisateur/mois pour les achats jusqu’au 30 septembre 2026 ; $25,20/utilisateur/mois en mensuel) ajoute Copilot dans les applications Microsoft 365, l’intégration de Teams et des contrôles d’administration. Applications incluses : Copilot Studio Lite pour créer des agents légers, Copilot dans SharePoint et Copilot Pages pour les brouillons collaboratifs. Limité aux organisations comptant jusqu’à 300 utilisateurs.
- Microsoft 365 Copilot Enterprise ($30/utilisateur/mois en annuel, ou $31,50/utilisateur/mois facturé mensuellement ; nécessite une licence Microsoft 365 éligible) offre une sécurité, une conformité et des analyses avancées en plus des fonctionnalités Business. Applications incluses : création d’agents avec Copilot Studio (les données de travail et les agents prédéfinis peuvent être mesurés ; Copilot Studio autonome est vendu séparément), Copilot dans Microsoft Purview et Intune pour les flux de travail informatiques et de sécurité, ainsi que la gouvernance des agents déployés.
xAI (Grok)
Le plan gratuit offre un accès limité à Grok.
- SuperGrok Lite ($10/mois) est le niveau payant d’entrée de gamme. Il inclut des conversations 2x plus longues, des limites de débit accrues et la création d’images et de vidéos par IA. Applications incluses : Grok Build (l’agent de création d’applications de xAI, également gratuit sur le web depuis août 2026) et Grok Imagine pour la génération d’images et de vidéos.
- SuperGrok ($30/mois, ou $300/an) inclut un raisonnement amélioré avec Grok 4.6, des conversations 5x plus longues, des téléversements de fichiers plus longs, le mode Voice pour le chat vocal et 20x plus de générations d’images et de vidéos Grok Imagine, y compris des vidéos HD 720p de 30 secondes.
- SuperGrok Plus ($100/mois) ajoute l’accès à Grok Bot, la génération de vidéos 1080p, des limites d’utilisation plus élevées, des réponses plus rapides et un accès prioritaire.
- SuperGrok Heavy ($300/mois) offre tout ce qui est inclus dans Plus, une équipe d’agents pour le travail en parallèle, des limites de débit maximales, des avant-premières des prochaines fonctionnalités xAI et un abonnement X Premium+. En juillet 2026, xAI a également lancé des compléments pour Excel, Outlook et Google Workspace ainsi que des automatisations planifiées ; la plupart sont gratuit, le complément Outlook et les automatisations déclenchées par e-mail étant réservés aux utilisateurs payants.
Grok est également inclus dans les abonnements X : X Premium ($8/mois) est le chemin payant le moins cher vers Grok dans l’application X et inclut un statut vérifié et une réduction des publicités. X Premium+ ($40/mois) supprime les publicités sur X et offre les limites d’utilisation de Grok les plus élevées, ainsi qu’une monétisation complète pour les créateurs.
Moonshot IA (Kimi)
Les plans grand public de Kimi portent des noms de tempos musicaux, du plus lent au plus rapide. Les tarifs internationaux sont en USD ; les utilisateurs chinois paient en CNY à des tarifs inférieurs. Depuis août 2026, les nouveaux achats sont sur liste d’attente. La page de tarification annonce des plans à venir qui séparent les avantages Kimi et Kimi Code, et l’avis de Moonshot du 20 juillet mentionne des contraintes de capacité de calcul expliquant le lancement retardé, quatre jours après la sortie de K3. Les abonnés existants conservent leur plan et peuvent le renouveler.
- Adagio (Free) offre des conversations de base illimitées avec 6 utilisations d’agent, des requêtes Deep Research plafonnées et des tâches d’agent OK Computer de base.
- Moderato ($19/mois) ajoute Kimi K3 dans le chat et les tâches d’agent, ainsi que des sessions Deep Research étendues. Applications incluses : Kimi Code (agent de codage IA axé sur le terminal ; environ 300 à 1 200 requêtes par fenêtre de 5 heures, facturées à partir du pool de crédits partagé), plus les outils de création Slides et Websites.
- Allegretto ($39/mois) offre une utilisation plus élevée sur tout ce qui est inclus dans Moderato. Applications incluses : Agent Swarm (orchestration de sous-agents en parallèle, jusqu’à 4 sous-tâches parallèles sur ce niveau), le déploiement cloud Kimi Claw pour les groupes d’agents hétérogènes avec mémoire persistante et 2x les crédits d’agent de Moderato.
- Allegro ($99/mois) offre 5x les crédits d’agent, Agent Swarm avec jusqu’à 8 sous-tâches parallèles et le chat K3 avec jusqu’à 1M tokens de contexte.
- Vivace ($199/mois) offre 10x les crédits d’agent, 4 tâches simultanées, Agent Swarm avec jusqu’à 8 sous-tâches parallèles et le chat K3 avec jusqu’à 1M tokens de contexte, destiné aux charges de recherche intensives et agentiques.
L’adhésion inclut des clés d’API Kimi Code à utiliser dans des outils de codage tiers ; l’API distincte Kimi Open Platform est facturée par token.
MiniMax
MiniMax vend un plan Token unifié au-dessus de ses modèles M3 et M2.7. Il a remplacé les anciens plans de crédits Agent et le plan Coding distincts à la mi-2026.
MiniMax Token Plan (un quota unique pour les agents, le codage et le travail multimodal) :
- Plus ($20/mois) : fenêtres de quota glissantes de 5 heures et hebdomadaires, suffisantes pour 3 à 4 agents de codage exécutés en parallèle ; pour les projets personnels et le prototypage.
- Max ($50/mois) : les mêmes fenêtres pour 4 à 5 agents parallèles ; pour le codage quotidien avec des agents et le travail multimodal.
- Ultra ($120/mois) : 6 à 7 agents parallèles ; pour les flux de travail d’agents lourds et les sessions prolongées.
- Packs de crédits : 5 $ pour 5 000 crédits, 25 $ pour 25 000, 100 $ pour 100 000 (1 000 crédits = 1 $, valables 365 jours), utilisables en plus de tout plan.
Le Token Plan couvre l’ensemble de la gamme de modèles (M3, M2.7, image et voix) dans un quota unique, ce qui en fait l’un des chemins les moins chers vers un modèle de codage de pointe lorsqu’il est associé à une CLI comme Cline ou Kilo Code.
Mistral AI
Le plan Free de Mistral Vibe (anciennement Le Chat) inclut la navigation web, l’analyse de fichiers de base, la génération d’images, des sessions de codage limitées, 100+ connecteurs et $10/mois en crédits d’API.
- Plan Pro ($14,99/utilisateur/mois) inclut plus de messages et de recherches web, plus de rapports de réflexion étendue et Deep Research, 15 Go de stockage de documents, jusqu’à 1 000 projets, la génération d’images et $30/mois en crédits d’API. Applications incluses : le mode Code de Mistral Vibe dans la CLI, l’IDE ou le web, avec une facturation à l’usage au-delà du quota inclus. Les étudiants vérifiés bénéficient de Pro pour $5,99/mois.
- Plan Team ($24,99/utilisateur/mois) inclut tout ce qui est inclus dans Pro avec jusqu’à 30 Go de stockage par utilisateur, la facturation centralisée, le contrôle d’accès basé sur les rôles, la vérification du nom de domaine et l’exportation de données. Applications incluses : Mistral Vibe au niveau d’utilisation Team avec des contrôles d’administration partagés.
- Plan Enterprise (tarification personnalisée) offre des options de déploiement sécurisé, y compris l’auto-hébergement et le cloud privé, la SSO SAML, des journaux d’audit, un support premium et des analyses détaillées. Applications incluses : Mistral Vibe avec des options de déploiement sur site pour les charges de travail réglementées.
DeepSeek
DeepSeek ne propose pas de plans d’abonnement traditionnels. L’accès au chat web et mobile aux derniers modèles (actuellement DeepSeek V4-Flash et V4-Pro) est gratuit pour tous les utilisateurs, avec une limitation d’utilisation équitable.
L’accès à l’API est facturé par token avec des tarifs de pointe et hors pointe depuis le 16 août 2026. Hors pointe, V4-Flash coûte $0,22 par million de tokens en entrée (échec de cache) et $0,66 par million de tokens en sortie ; les tarifs de pointe sont le double ($0,44 et $1,32). V4-Pro coûte $0,66 et $1,98 hors pointe. Les touches de cache coûtent environ 3 % du tarif d’échec, et les heures de pointe sont de 01:00 à 04:00 et de 06:00 à 10:00 UTC en semaine.
DeepSeek s’est également lancé dans l’outillage d’agents. DeepSeek Harness, une boîte à outils open source et à base de plugins pour créer et exécuter des agents IA, est en avant-première développeur avec un code source public. Elle n’a pas de prix propre et est indépendante du modèle ; l’utilisation est facturée par l’API du modèle que l’agent appelle.
Meta (Muse Spark)
Meta IA reste gratuit dans WhatsApp, Instagram, Facebook, Messenger, l’application Meta IA et les lunettes Ray-Ban Meta, propulsé par Muse Spark (lancé le 8 avril 2026, désormais en version 1.2). Meta a commencé à tester de manière limitée les abonnements payants Meta One. Les plans Plus et Premium augmentent l’allocation mensuelle d’utilisation de l’IA et l’accès au mode Thinking, rapportés à $7,99 et $19,99 par mois.1
Le Meta Model API est en avant-première publique, en libre-service et compatible avec le SDK d’OpenAI. La tarification à l’usage de Muse Spark 1.2 commence à $1,25 par million de tokens en entrée et $4,25 par million de tokens en sortie avec une fenêtre de contexte de 1M tokens. Muse Code, un agent de codage en terminal, est sorti en version bêta le 5 août 2026.
Comprendre la tarification LLM
Tokens : l’unité fondamentale de tarification
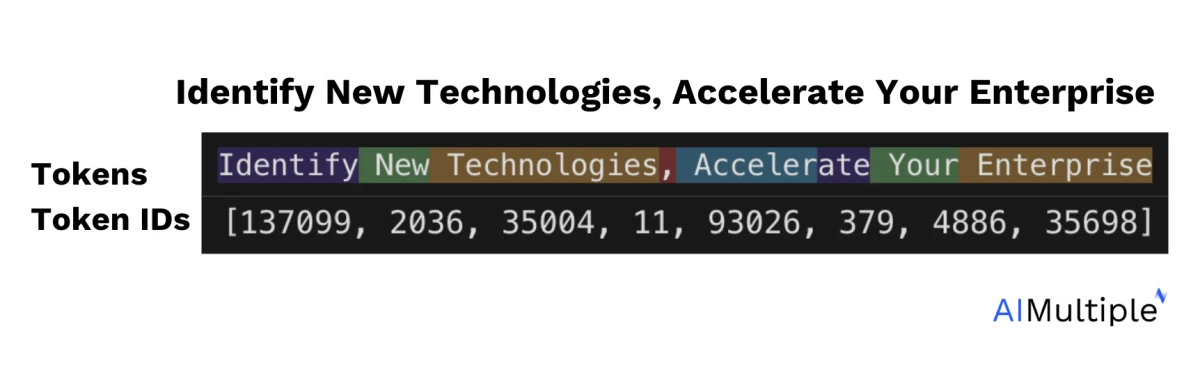
Figure 1 : Exemple de tokenisation utilisant le tokenizer GPT-4o et GPT-4o mini pour la phrase « Identifier les nouvelles technologies, accélérer votre entreprise. »2
Bien que les fournisseurs proposent diverses structures tarifaires, la tarification par token est la plus courante. Les méthodes de tokenisation diffèrent selon les modèles ; en voici des exemples :
- Byte-Pair Encoding (BPE) : Divise les mots en unités de sous-mots fréquentes, équilibrant taille du vocabulaire et efficacité.3
- Exemple : « unbelievable » → [« un », « believ », « able »]
- WordPiece : Similaire à BPE mais optimisé pour la vraisemblance du modèle de langue, utilisé dans BERT.4
- Exemple : « tokenization » → [« token », « ##ization »]. « token » est un mot autonome ; « ##ization » est un suffixe.
- SentencePiece : Tokenise le texte sans dépendre des espaces, efficace pour les modèles multilingues comme T5.5
- Exemple : « natural language » → [« natural », « lan », « guage »] ou [« natu », « ral », « language »].
Veuillez noter que les sous-mots exacts dépendent des données d’entraînement et du processus BPE/WordPiece. Pour mieux comprendre ces méthodes de tokenisation, regardez la vidéo ci-dessous :
Une fois la tokenisation comprise, un prix moyen peut être estimé en fonction de la longueur en tokens du projet. Le tableau 2 présente les plages de tokens par type de contenu, notamment les prompts d’interface, les extraits d’e-mails, les articles de blog marketing, les rapports détaillés et les articles de recherche, et note que le nombre de tokens varie selon les modèles. Une fois un modèle choisi, son tokenizer peut être utilisé pour estimer le nombre moyen de tokens du contenu.
Tableau 2 : Types de contenu typiques, leurs plages de taille et considérations pour l’entreprise (les plages sont des estimations et peuvent varier).
Implications de la fenêtre de contexte
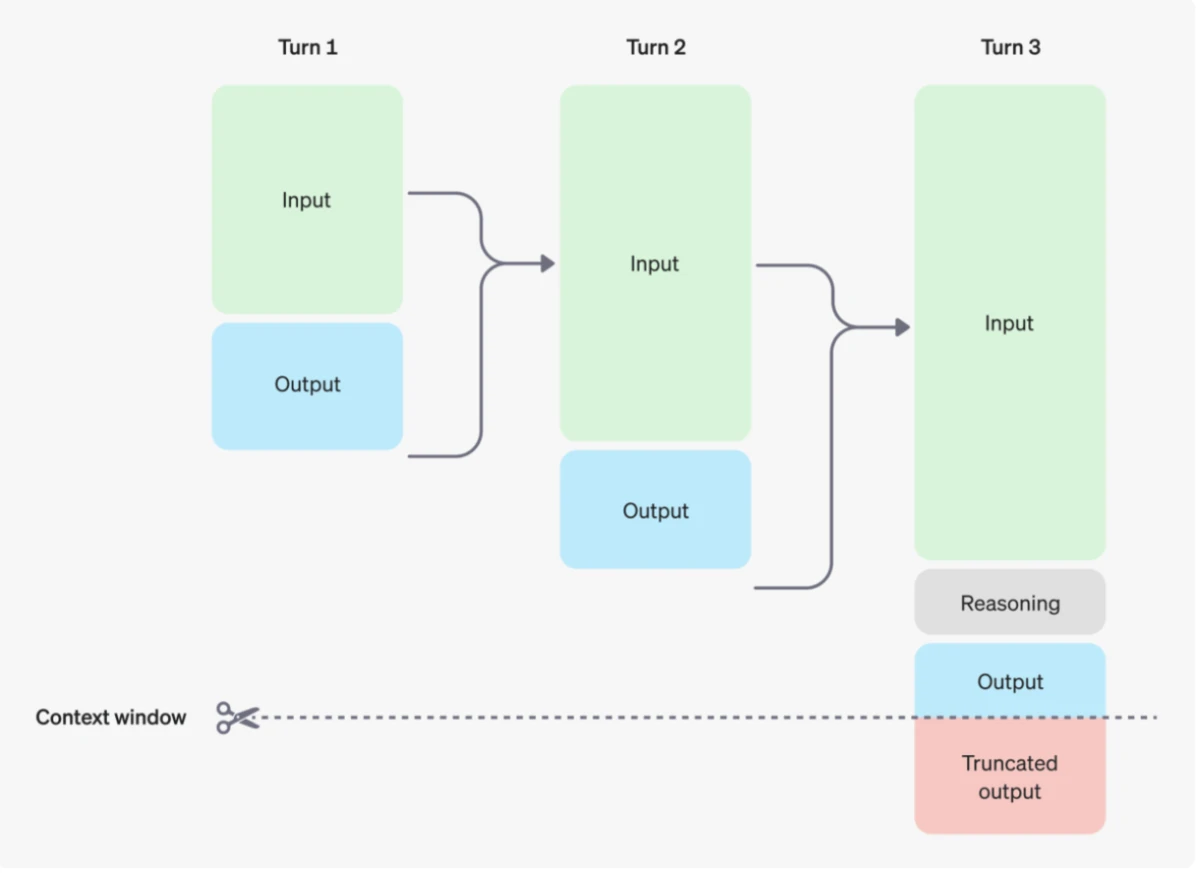
La fenêtre de contexte fixe une limite stricte au nombre de tokens d’entrée et de sortie par appel, y compris les tokens utilisés par les modèles de raisonnement pour le raisonnement en chaîne de pensée. Si le total dépasse cette limite, la réponse est tronquée ou la requête échoue immédiatement.
Figure 2 : Illustration des limites de la fenêtre de contexte entraînant une troncature de la sortie dans une conversation à plusieurs tours.6
Pour les applications qui maintiennent de longues conversations, chaque tour supplémentaire ajoute de l’historique dans l’entrée. Sans intervention, les tokens d’entrée augmentent linéairement avec la longueur de la conversation, tout comme la facture. Les utilisateurs d’API répondent généralement à cela de trois façons :
- Mise en cache des prompts. OpenAI, Anthropic, Google et DeepSeek mettent tous en cache les préfixes de prompt répétés côté serveur et facturent les accès au cache à une fraction du tarif d’entrée standard, généralement de 3 à 10 pour cent du prix en cas d’échec de cache. Pour les applications qui réutilisent un long prompt système ou préfixe de conversation, la mise en cache peut réduire le coût d’entrée d’un ordre de grandeur.
- Fenêtre glissante ou génération augmentée de récupération (RAG). Supprimez les tours les plus anciens une fois un seuil atteint, ou récupérez uniquement les messages passés pertinents depuis un magasin vectoriel à chaque appel.
- Résumé. Condensez périodiquement les tours plus anciens en un résumé au lieu de les renvoyer tels quels.
Pour les charges de travail agentiques telles que les sessions de codage ou les recherches approfondies, les agents de codage modernes gèrent cela automatiquement en session. Claude Code, par exemple, est livré avec une compaction de contexte : lorsque la conversation approche de la limite, il résume les messages plus anciens en une version condensée tout en conservant les tours récents intacts. Les tours suivants n’envoient que le résumé plus le contexte récent au modèle.
L’impact sur la tarification est direct. Sur les API à facturation par token, la compaction plafonne la croissance de l’entrée de chaque appel et la mise en cache réduit le prix du préfixe répété, de sorte que le coût par tour reste prévisible sur les longues sessions. Sur les abonnements à tarif fixe comme Claude Pro, ChatGPT Plus ou Kimi Moderato, la compaction étire les limites d’utilisation quotidiennes et hebdomadaires car chaque appel transporte moins de contexte. Une session de codage qui brûlerait autrement une limite de débit de 5 heures peut durer plus longtemps lorsque les anciens tours sont compressés.
Le compromis est que toute forme de résumé est avec perte. Le résumé peut omettre des détails qui s’avèrent importants plus tard, obligeant l’utilisateur à les fournir à nouveau.
Nombre maximal de tokens de sortie
Le nombre maximal de tokens de sortie plafonne la longueur de la réponse d’un modèle. Bien que de nombreuses documentations mentionnent qu’il peut être ajusté à l’aide du paramètre max_tokens, il est crucial de consulter la documentation de l’API spécifique utilisée pour identifier le paramètre correct. Il doit être ajusté en fonction des besoins spécifiques :
S’il est réglé trop bas, cela peut entraîner des sorties incomplètes, amenant le modèle à couper les réponses avant de fournir la réponse complète.
S’il est réglé trop haut, selon la température (un paramètre qui contrôle la créativité des réponses), il peut entraîner des sorties inutilement verbeuses, des temps de réponse plus longs et une augmentation des coûts.
C’est donc un paramètre qui nécessite une attention particulière pour optimiser l’utilisation des ressources tout en équilibrant la qualité de la sortie, le coût et les performances.
Tableau 3 : Exemples de prompts d’entrée et nombre de tokens estimé par type de contenu.
*Ceci suppose que chaque modèle produit des réponses avec un nombre égal de tokens de sortie, bien que le nombre de tokens en entrée et en sortie puisse varier selon la tokenisation de chaque modèle ; le nombre a été maintenu constant ici pour chaque modèle.
En combinant les plages de tokens du tableau 2 avec les tarifs par token d’un modèle, on obtient le coût attendu par type de contenu ; les exemples de prompts du tableau 3 montrent les tailles d’entrée et de sortie derrière ces estimations.
Utiliser plusieurs modèles de langage
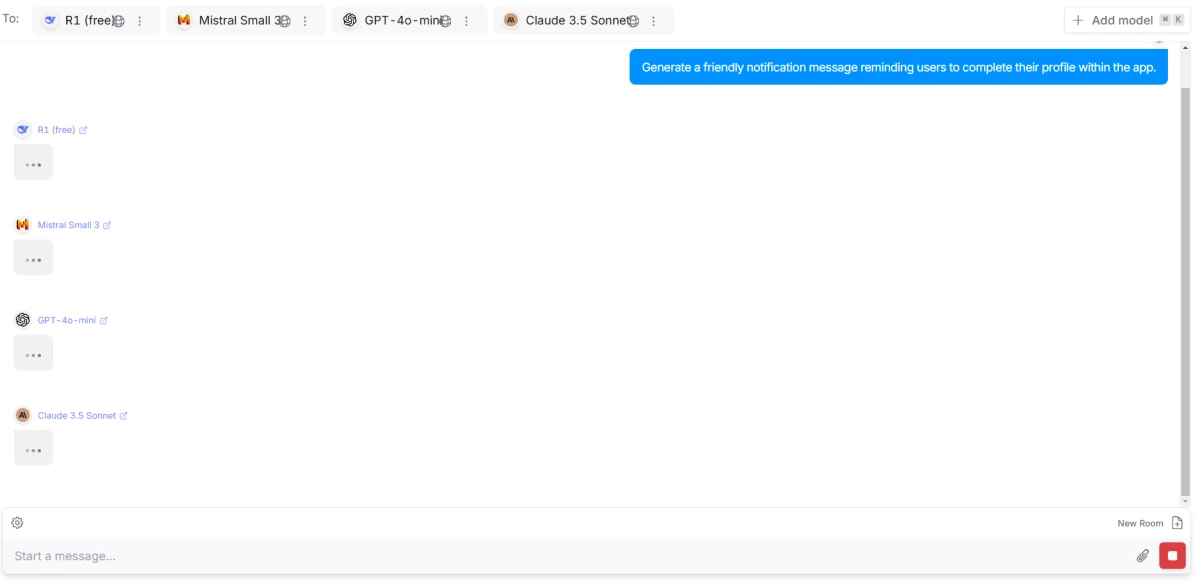
Une passerelle IA telle qu’OpenRouter permet d’envoyer le même prompt à plusieurs modèles simultanément. Les réponses, la consommation de tokens, le temps de réponse et la tarification peuvent ensuite être comparés pour déterminer quel modèle est le plus adapté à la tâche.
Figure 3 : Interface présentant un prompt envoyé à plusieurs Large Language Models via OpenRouter.7
Avantages et défis
- Adaptabilité et efficacité accrues : L’orchestration améliore la réactivité, permettant une évaluation en temps réel de l’efficacité des modèles et l’identification d’un modèle rentable et d’économies potentielles.
- Sensibilité des prompts et optimisation : Des prompts identiques peuvent produire des sorties très différentes selon les modèles, ce qui nécessite un prompt engineering adapté à chaque modèle pour obtenir les résultats souhaités, ajoutant à la complexité de développement et de maintenance.
Mécanismes de tarification et coûts cachés
Tokens de raisonnement et tokens de sortie
Un nombre croissant de fournisseurs ont introduit des modèles de raisonnement qui dépensent des calculs supplémentaires pour effectuer un raisonnement en chaîne de pensée en interne. OpenAI, Anthropic et Google facturent ces tokens de raisonnement comme des tokens de sortie au tarif de sortie standard du modèle, de sorte que l’augmentation des coûts provient du volume et non d’un prix par token plus élevé.
Des modèles comme GPT-5.5 Pro, Claude Opus 5 avec réflexion étendue ou Gemini 3.1 Pro Deep Think génèrent des traces de raisonnement internes
même lorsque vous ne les demandez pas explicitement. Ces tokens internes comptent dans votre facture et peuvent augmenter considérablement les coûts, en particulier dans les longues tâches analytiques telles que l’analyse juridique, l’analyse de données ou le raisonnement en plusieurs étapes.
Il est donc essentiel de :
- Choisir un modèle de raisonnement uniquement lorsque la précision l’emporte nettement sur le coût.
- Désactiver la chaîne de pensée ou définir un nombre maximal de tokens de sortie plus court lorsque cela est possible.
- Tester la même tâche sur des modèles sans raisonnement pour voir si les performances sont comparables à une fraction du prix.
Étant donné qu’un modèle de raisonnement peut émettre 10 à 30 fois plus de tokens de sortie que le même prompt sans raisonnement, il est essentiel de comprendre cette distinction pour la planification des coûts.
Différences de tarification liées à l’architecture
Les architectures des LLM influencent directement l’efficacité des modèles et, par conséquent, la tarification des API. Par exemple :
- Les modèles Mixture-of-Experts (MoE) n’activent qu’un sous-ensemble de paramètres par requête, ce qui réduit le coût de calcul et permet aux fournisseurs d’offrir des tarifs par token plus bas.
- Le décodage spéculatif associe un petit modèle de brouillon à un modèle plus grand, améliorant le débit et réduisant les coûts pour les tâches déterministes.
- Les variantes quantifiées (par exemple, 4 bits ou 8 bits) peuvent effectuer l’inférence avec une précision moindre, ce qui permet des tarifs plus bas pour les versions déployées localement ou hébergées dans le cloud.
Comprendre ces choix d’architecture aide les utilisateurs à prévoir non seulement les différences de tarification, mais aussi la latence, la qualité et la façon dont un modèle évolue sous des charges de travail en production.
Coûts opérationnels au-delà des frais d’API
Bien que la tarification par token soit le principal facteur de coût, de nombreux déploiements en production entraînent des coûts supplémentaires au-delà de l’utilisation de l’API :
- Embeddings et bases de données vectorielles : le stockage et la récupération de vecteurs (par exemple, Pinecone, Weaviate, ChromaDB) ajoutent un coût par requête et par Go de stockage.
- Modèles de reranking et de post-traitement : de nombreuses applications utilisent des modèles plus petits pour résumer, filtrer ou classifier avant d’envoyer une requête finale à un modèle plus grand.
- Couches de mise en cache : des fournisseurs comme OpenAI proposent désormais une mise en cache au niveau des prompts, mais l’infrastructure de mise en cache locale peut nécessiter des calculs supplémentaires.
- Journalisation, surveillance et audit : les entreprises supportent souvent des coûts pour la surveillance au niveau des tokens, le suivi de la latence et les audits de sécurité.
Ces coûts cachés représentent souvent 20 à 40 % des dépenses opérationnelles totales liées aux LLM et doivent être pris en compte lors de l’évaluation des structures tarifaires.
 Ajouter comme source préférée
Considérations tarifaires spécifiques aux entreprises
De nombreux fournisseurs de LLM facturent des frais supplémentaires pour les fonctionnalités de sécurité et de conformité de niveau entreprise, telles que :
- Déploiements à locataire unique
- Clusters GPU dédiés
- SLA améliorés (par exemple, garanties de disponibilité et de latence)
- Résidence des données et contrôles régionaux
- Modes de conformité SOC2, HIPAA ou RGPD
Ces offres peuvent augmenter considérablement les coûts, mais elles sont essentielles pour les secteurs réglementés tels que la santé, la finance, les services juridiques et les institutions publiques.
Tendances futures de la tarification LLM
Trois éléments ont défini la tarification des LLM en 2025 : les modèles de base sont devenus bon marché, presque tous les grands fournisseurs ont lancé un abonnement de chat et les modèles de raisonnement sont restés chers. L’écart est structurel et devrait se creuser : un million de tokens de sortie coûte $0,66 sur DeepSeek V4-Flash (hors pointe) et $180 sur GPT-5.5 Pro. Les questions intéressantes pour 2026 et au-delà portent sur ce qui évolue au-dessus de cette base.
La facturation par token cède la place à la tarification par tâche
Les agents représentent désormais la majeure partie de l’utilisation intensive des LLM. Une seule tâche de codage avec Claude Code, une session de recherche avec Cowork ou une session de navigation autonome avec Operator peut entraîner des centaines d’appels de modèle séquentiels. La facturation par token devient imprévisible tant pour l’acheteur que pour le vendeur.
En réponse, les fournisseurs passent des compteurs de tokens à des quotas par tâche et par session. Moonshot estime entre 300 et 1 200 requêtes Kimi Code par fenêtre de 5 heures à partir d’un pool de crédits partagé. Claude Code plafonne l’utilisation par session de 5 heures plutôt que par message. MiniMax définit les quotas de son Token Plan sous forme de fenêtres glissantes de 5 heures et hebdomadaires dimensionnées selon le nombre d’agents de codage parallèles. Kimi fixe des limites spécifiques au niveau sur les sous-agents Agent Swarm parallèles.
Les harnais d’agents multi-fournisseurs comme OpenClaw et MaxHermes vont encore plus loin. Ils se placent entre les utilisateurs et plusieurs API de modèles, et leur tarification suit de plus en plus le débit par tâche plutôt que par million de tokens. Attendez-vous à ce que davantage de fournisseurs publient des SKU par tâche ou par session au cours de l’année à venir.
Les petits modèles de raisonnement se déplacent vers l’appareil
Apple Intelligence exécute l’inférence sur l’appareil pour les requêtes courantes, ne basculant vers Private Cloud Compute que pour les requêtes complexes. Les PC Microsoft Copilot+ sont livrés avec un modèle local. Les appareils Pixel exécutent Gemini Nano. De petits modèles récents tels que Phi-4 de Microsoft et Gemma 3 de Google sont capables de raisonnement à des tailles qui tiennent sur l’unité de traitement neuronal d’un téléphone ou d’un ordinateur portable.
L’implication tarifaire est un marché grand public à deux vitesses. Le travail courant s’exécute gratuit sur l’appareil au token marginal. Les abonnements cloud rivalisent sur ce que le local ne peut pas faire : raisonnement de pointe, contexte étendu, génération multimodale et orchestration d’agents. Le plancher gratuit local pousse les abonnements de chat uniquement vers zéro, faisant des applications groupées la véritable raison de payer.
Contexte long et mémoire décident qui gagne le travail agentique
Les tâches agentiques à long horizon échouent lorsque les modèles perdent le fil des instructions précédentes ou hallucinent des faits qu’ils devraient mémoriser. Le travail agentique soutenu dépend de trois éléments : une grande fenêtre de contexte, une mémoire persistante et un faible taux d’hallucination.
En un an, trois capacités de pointe se sont effondrées vers la ligne de base. Claude Opus 5, Gemini 3.1 Pro, GPT-5.6 et Kimi K3 offrent des fenêtres de contexte de 1M tokens. Sur OpenAI, Anthropic, Google et DeepSeek, les accès au cache coûtent de 3 à 10 pour cent des échecs de cache. ChatGPT et Claude incluent désormais une mémoire persistante sur leurs niveaux gratuit.
Des modèles agentiques spécialisés émergent au sommet de ce marché. En juin 2026, Anthropic a lancé Claude Fable 5, un modèle de classe Mythos généralement disponible8, au prix de $10 en entrée et $50 en sortie par million de tokens, soit le double du tarif d’Opus 5. Fable 5 cible le codage agentique, l’utilisation d’un ordinateur et la recherche à long horizon ; Claude Mythos 5, le même modèle avec certaines protections levées, reste limité aux partenaires approuvés au même prix.
La question concurrentielle passe de « quelle est la taille de la fenêtre de contexte » à « à quel coût et avec quelle fiabilité le modèle peut-il soutenir une longue tâche agentique ? » Les fournisseurs qui résolvent bien ce problème pourront imposer des tarifs supérieurs. Ceux qui n’y parviennent pas perdront les charges de travail agentiques, quel que soit le prix par token affiché.
FAQ
L’accès aux Large Language Models (LLMs) via une Application Programming Interface (API) vous accorde un accès à distance aux modèles d’IA. Cet accès est soumis à des frais, souvent appelés « frais d’API », facturés par le fournisseur de services. Ces frais sont un élément essentiel à prendre en compte lors de l’intégration de LLMs dans vos applications.
Il représente le coût associé à chaque requête, demande ou tâche effectuée via l’API du fournisseur. Comme les structures tarifaires peuvent varier considérablement (selon des facteurs comme la consommation de tokens, le volume d’appels à l’API, l’utilisation des fonctionnalités ou les modèles d’abonnement), il est essentiel de comprendre comment les fournisseurs calculent ces coûts.
La tarification des LLM API peut être complexe en raison de facteurs comme la consommation de tokens, la longueur de contexte et le choix du modèle. Les procédures de tokenisation varient selon les modèles, certains utilisant le Byte-Pair Encoding (BPE), WordPiece ou SentencePiece, chacune influençant la façon dont le texte est divisé en tokens et ayant un impact sur l’efficacité des coûts. Comprendre ces différences aide à optimiser l’utilisation et la tarification de l’API.
Les coûts des LLM sont principalement déterminés par la consommation de tokens (en entrée et en sortie), le volume d’appels à l’API et le modèle de tarification (par exemple, par token ou par abonnement).
Comparez les prix des tokens en entrée et en sortie, les limites de fenêtre de contexte et les éventuels frais supplémentaires. Des outils comme OpenRouter vous permettent d’envoyer le même prompt à plusieurs modèles et de comparer directement leurs résultats, leur consommation de tokens, leur vitesse et leur tarification. Tenez compte de la longueur typique de votre contenu et de vos habitudes d’utilisation pour estimer les coûts globaux.
Les tokens d’entrée sont les tokens du prompt que vous envoyez au LLM, tandis que les tokens de sortie sont les tokens de la réponse générée. Pour les modèles de raisonnement, les tokens générés pendant le processus de raisonnement lui-même sont également comptés comme tokens de sortie, ce qui a un impact sur le coût final. L’entrée et la sortie contribuent toutes deux au coût global.
Les demandes de texte plus volumineuses nécessitent davantage de traitement, ce qui augmente le temps de réponse et les coûts. Optimisez la taille des entrées et utilisez un calculateur de tarification LLM API pour estimer le nombre de tokens et gérer efficacement votre budget.
La communauté LLM a développé divers outils et benchmarks pour aider les utilisateurs à comprendre et à optimiser la tarification des LLM. Ces ressources comprennent souvent des calculateurs et des tableaux comparatifs qui donnent un aperçu de la puissance et de l’efficacité des différents modèles.
Des plateformes comme Hugging Face et GitHub hébergent des outils et du code développés par la communauté pour analyser les performances et les coûts des modèles. De nombreux services offrent un support communautaire via des forums ou des fonctionnalités de chat.
Citer cette recherche
Choisissez le format qui correspond à votre lieu de publication. Coller la version avec lien dans votre CMS préserve le lien retour.
@misc{dilmegani2026,
  author = {Dilmegani, Cem},
  title  = {{LLM Tarification: comparatif des 15+ principaux fournisseurs}},
  year   = {2026},
  month  = aug,
  howpublished    = {\url{https://aimultiple.com/llm-pricing}},
  note   = {AIMultiple. Consulté le 26 août 2026}
}Résultats et horodatages de 285 points de données. Téléchargez les données de synthèse présentées dans les graphiques et les tableaux de cet article sous forme de fichier ZIP contenant 6 fichiers CSV et un README.
Vous voulez les données détaillées derrière ? Rejoindre Premium
Journal des modifications
8 mises à jourMise à jour de la description du graphique dans l'introduction.
Un graphique a été ajouté à la section des types de tarification LLM.
La section « Comprendre la tarification des LLM » a été supprimée.
La section « Implications de la fenêtre contextuelle » a été étendue avec des stratégies de gestion de l'utilisation des jetons dans les conversations longues.
Ajout de ChatGPT Go à la section OpenAI.
Liens de référence
Le travail de Cem chez AIMultiple a été cité par des publications mondiales de premier plan, notamment Business Insider, Forbes, Morning Brew et Washington Post, par des entreprises mondiales comme Deloitte et HPE, par des ONG comme World Economic Forum et par des organisations supranationales comme European Commission. [1], [2], [3], [4], [5]
Tout au long de sa carrière, Cem a été consultant en technologies, acheteur de technologies et entrepreneur technologique. Il a conseillé des entreprises sur leurs décisions technologiques chez McKinsey & Company et Altman Solon pendant plus de dix ans. Il a également publié un rapport McKinsey sur la digitalisation.
Il a dirigé la stratégie technologique et les achats d'un opérateur télécom, sous la responsabilité du PDG. Il a également dirigé la croissance commerciale de l'entreprise de technologie profonde Hypatos, qui a atteint un revenu récurrent annuel à 7 chiffres et une valorisation à 9 chiffres, passant de 0 à ce résultat en deux ans. Le travail de Cem chez Hypatos a été couvert par des publications technologiques de premier plan comme TechCrunch et Business Insider.
Cem intervient régulièrement lors de conférences technologiques internationales. Il est diplômé de Bogazici University en tant qu'ingénieur informatique et titulaire d'un MBA de la Columbia Business School.




Commentaires 1
Partagez vos idées
Votre adresse courriel ne sera pas publiée. Tous les champs sont obligatoires. Les commentaires sont laissés dans leur langue d'origine.
"Really well-written and timely article! Your analysis of how different large language model (LLM) providers compare - based on token pricing, context window, and performance - really helps demystify an often opaque cost structure. I found the detailed breakdown of token-based billing (input vs output tokens), context-window implications, and the built-in “price calculator” particularly useful for anyone trying to realistically estimate LLM usage