


Benchmark AIM-Text-to-SQL: précision SQL sur plus de 70 LLMs
We evaluated SQL answers from 70+ LLMs on a 759-question BIRD-SQL subset. Each model selected a database from 11 candidates, then produced a query.
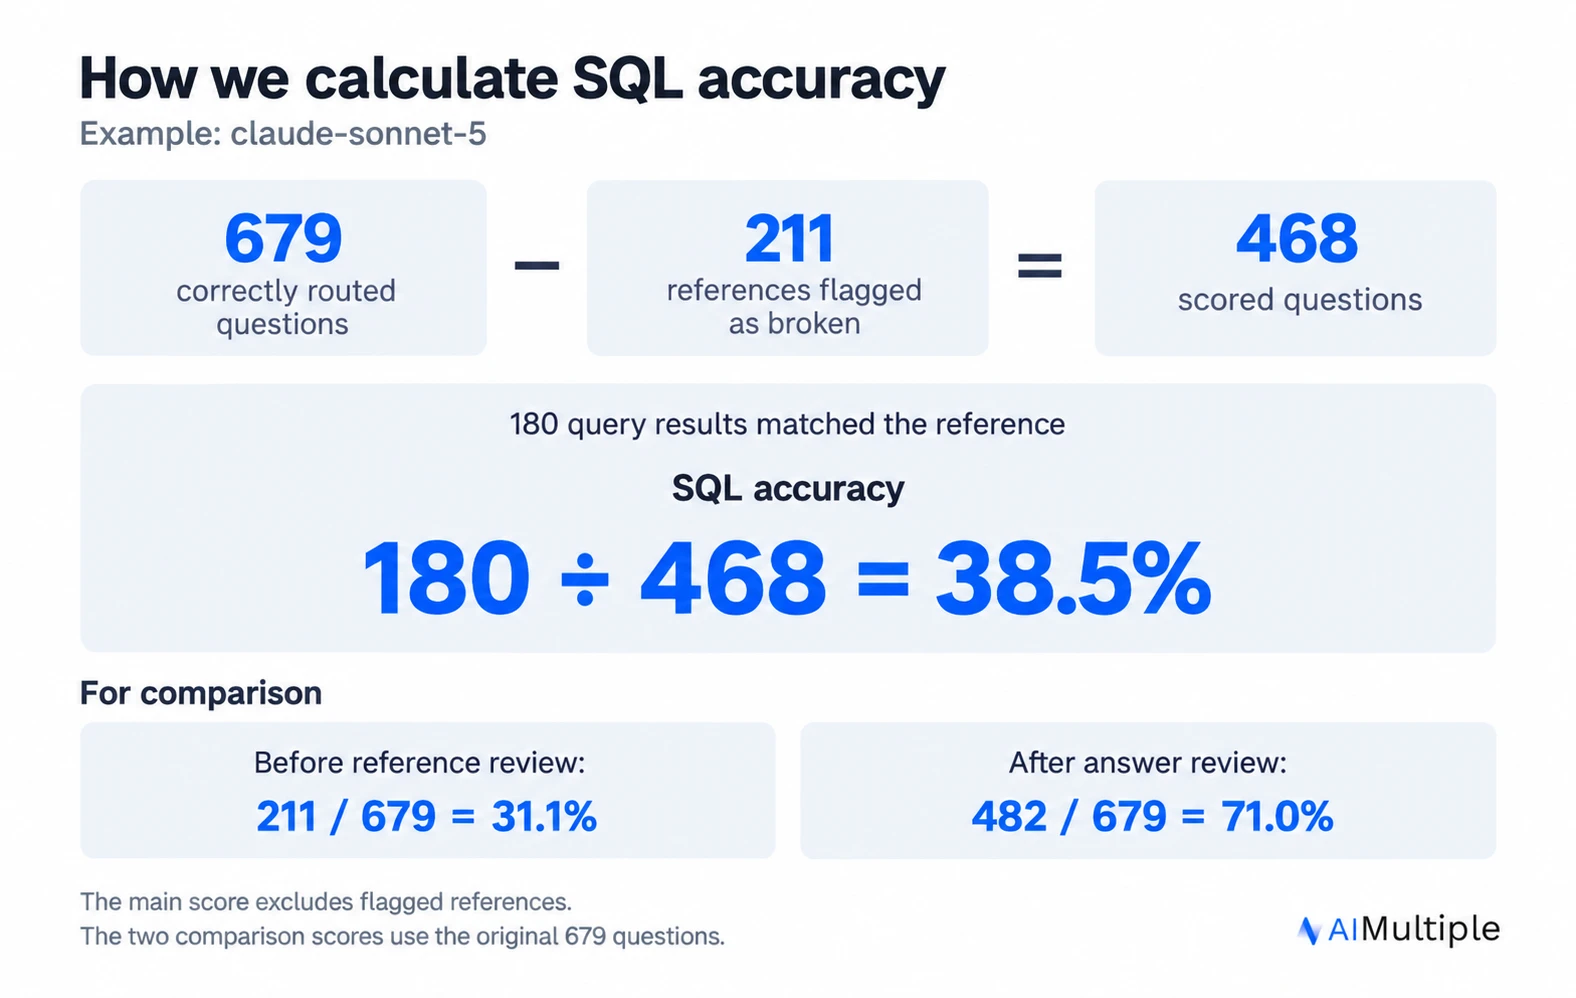
La précision SQL est le pourcentage de requêtes notées qui renvoient le résultat de référence. Les routages incorrects et les références signalées comme défaillantes sont exclus. Une requête de référence est le SQL fourni comme réponse attendue.
Chaque model atteint un ensemble différent de questions SQL, car la notation dépend de ses choix de base de données. Les différences entre ces sous-ensembles et la configuration d’exécution limitent les comparaisons.
Constatations sur le text-to-SQL
Opus 5.5 a enregistré 87,8 % de précision SQL
claude-opus-5.5 a trouvé le résultat de référence sur 444 questions notées sur 506. gemini-4-argon suit avec 78,6 % (407 sur 518), puis gemini-3.8-flash avec 77,2 % (342 sur 443). Ce sont les trois meilleurs scores de précision SQL du panel de 81 models. Muse Wonder a enregistré 56,4 % (285 sur 505). GPT-6.1 Terra a enregistré 56,6 % (280 sur 495). MiniMax M3.1 Flash a enregistré 36,5 % (177 sur 485). Kimi K3.1 Pro a enregistré 52,3 % (257 sur 491). Muse Spark Open a enregistré 44,9 % (219 sur 488), et DeepSeek V4.1 Flash 1017 a enregistré 22,8 % (108 sur 474).
Le score exclut les choix de base de données incorrects et les références signalées comme défaillantes. Opus 5.5 a utilisé Claude Code. Gemini 4 Argon et Gemini 3.8 Flash ont utilisé OpenRouter. Le classement reflète à la fois les conditions d’exécution et les différences dans les questions que chaque model a correctement routées.
Trois variantes Pro ont obtenu un score inférieur à leurs models de base
gpt-6.1-sol-pro a enregistré 63,6 % de précision SQL, contre 65,1 % pour gpt-6.1-sol. gpt-6-sol-pro a obtenu 53,6 % contre 53,8 % pour gpt-6-sol. gpt-6-luna-pro a obtenu 44,2 % contre 45,4 % pour gpt-6-luna.
Tous les six models ont utilisé OpenRouter. Ces scores proviennent d’une exécution par model et de différents sous-ensembles de questions correctement routées. Des exécutions répétées sur les mêmes questions SQL seraient nécessaires pour évaluer si les petits écarts persistent.
Coût vs précision SQL
Le coût d’exécution couvre les réponses de routage et SQL conservées de chaque exécution de benchmark du model. La cible était de 759 questions. Sept exécutions ont moins de réponses conservées. Les tests fumée séparés, les tentatives de nouvelle tentative abandonnées et les appels du jury sont exclus. La précision SQL utilise les questions correctement routées de chaque model après exclusion des références signalées comme défaillantes.
gemini-3-flash-preview a enregistré 67,7 % de précision SQL au coût de 7.67 $ par exécution. gemini-3.8-flash a atteint 77,2 % à 26.48 $. Le score de 87,8 % d’Opus 5.5 est associé à un coût estimé équivalent API de 188.71 $. Gemini 4 Argon a atteint 78,6 % à 41.41 $ en coûts d’exécution conservés. Muse Wonder a atteint 56,4 % à 77.44 $ en coûts d’exécution conservés. GPT-6.1 Terra a atteint 56,6 % à 7.19 $ en coûts d’exécution conservés. MiniMax M3.1 Flash a atteint 36,5 % à 2.30 $ en coûts d’exécution conservés. Kimi K3.1 Pro a atteint 52,3 % à 27.14 $ en coûts d’exécution conservés. Muse Spark Open a coûté 22.03 $ et DeepSeek V4.1 Flash 1017 a coûté 1.75 $ pour les exécutions conservées de routage plus SQL.
Les 78 models API utilisent des coûts mesurés. Opus 5.5, Fable 5.1 et GPT-6 Astra disposent d’estimations étiquetées séparément basées sur leurs tokens CLI enregistrés et les prix OpenRouter vérifiés le 1er octobre 2026, avec l’utilisation du cache enregistré préservée.
Les coûts incluent l’exploration des bases de données, et les scores SQL couvrent différents sous-ensembles de questions. Cette comparaison décrit donc le coût et la précision du flux de travail de benchmark combiné. Les coûts isolés de génération SQL n’ont pas été mesurés. Le benchmark RAG agentique rapporte la sélection de base de données séparément.
Résultats de précision SQL
Avant examen des références mesure la correspondance exacte des résultats sur toutes les questions correctement routées. Après examen des réponses ajoute du crédit pour les réponses acceptées par le jury. Les deux colonnes de comparaison utilisent le dénominateur d’origine, tandis que la précision SQL exclut les références signalées.
Comment les models ont répondu à la même question SQL
La même question a produit des correspondances exactes, des réponses correctes avec des colonnes supplémentaires et une institution sans rapport. Les huit models ont choisi la bonne base de données, college_completion. La table institution_details stocke les noms d’institutions dans chronname, les villes dans city et les États dans state. Ces réponses proviennent d’exécutions de benchmark sauvegardées. Sept models ont utilisé OpenRouter, tandis qu’Opus 5.5 a utilisé Claude Code.
GPT-6.1 Terra, Kimi K3.1 Pro, Gemini 4 Argon et Opus 5.5 ont renvoyé Georgia et réussi la correspondance d’exécution. Muse Spark Open et DeepSeek V4.1 Flash 1017 ont également identifié Georgia, mais incluaient les colonnes de nom et de ville. Ils ont échoué à la comparaison stricte des résultats. Les trois jurés de l’examen des réponses ont accepté chaque réponse.
MiniMax M3.1 Flash et GLM 5.3 ont utilisé LIKE '%Mercer%', qui a également renvoyé Mercer County Community College dans le New Jersey. Les trois jurés ont classé chaque réponse comme une erreur de model. La référence a réussi l’audit de validité séparé.
Nous avons sélectionné ce cas pour montrer comment le filtrage et les colonnes de sortie affectent l’évaluation. Il illustre des réponses individuelles. Les résultats complets du benchmark ci-dessus fournissent la comparaison globale des models.
Conditions affectant la précision SQL
Les indices de BIRD ont augmenté la précision de Gemini Flash en SQL de 8.7 points
Nous avons répété gemini-3-flash-preview avec les preuves supplémentaires de BIRD. Sur les questions correctement routées dans les deux conditions, la précision SQL est passée de 67,5 % à 76,2 %. La précision stricte, avant examen des références, est passée de 55,0 % à 61,6 %.
Il s’agissait d’une expérience sur un seul model. Elle n’établit pas d’amélioration commune pour le panel de 81 models. Le panel principal retient les indices car ils peuvent également révéler quelle base de données sélectionner.
Les models ont atteint différents ensembles de questions SQL
Les choix de base de données de chaque model déterminent quelles questions atteignent la notation SQL. Pour claude-opus-5, le dénominateur strict contient 717 questions, dont 156 provenant du groupe de routage le plus difficile. Pour nova-lite-v1, il contient 285 questions, dont 22 provenant de ce groupe. Les parts sont de 21,8 % et 7,7 %.
Leurs pourcentages SQL combinent donc la performance d’écriture de requêtes avec la difficulté des cas ayant atteint la notation. Une comparaison SQL contrôlée fournirait à chaque model la bonne base de données pour les mêmes questions. Cette expérience n’a pas été menée.
La sélection des questions compte également lors de la comparaison de benchmarks d’IA qui fournissent différents schémas, indices ou budgets d’outils.
Constatations issues de l’examen des références et des réponses
L’audit des références a signalé 236 requêtes sur 759
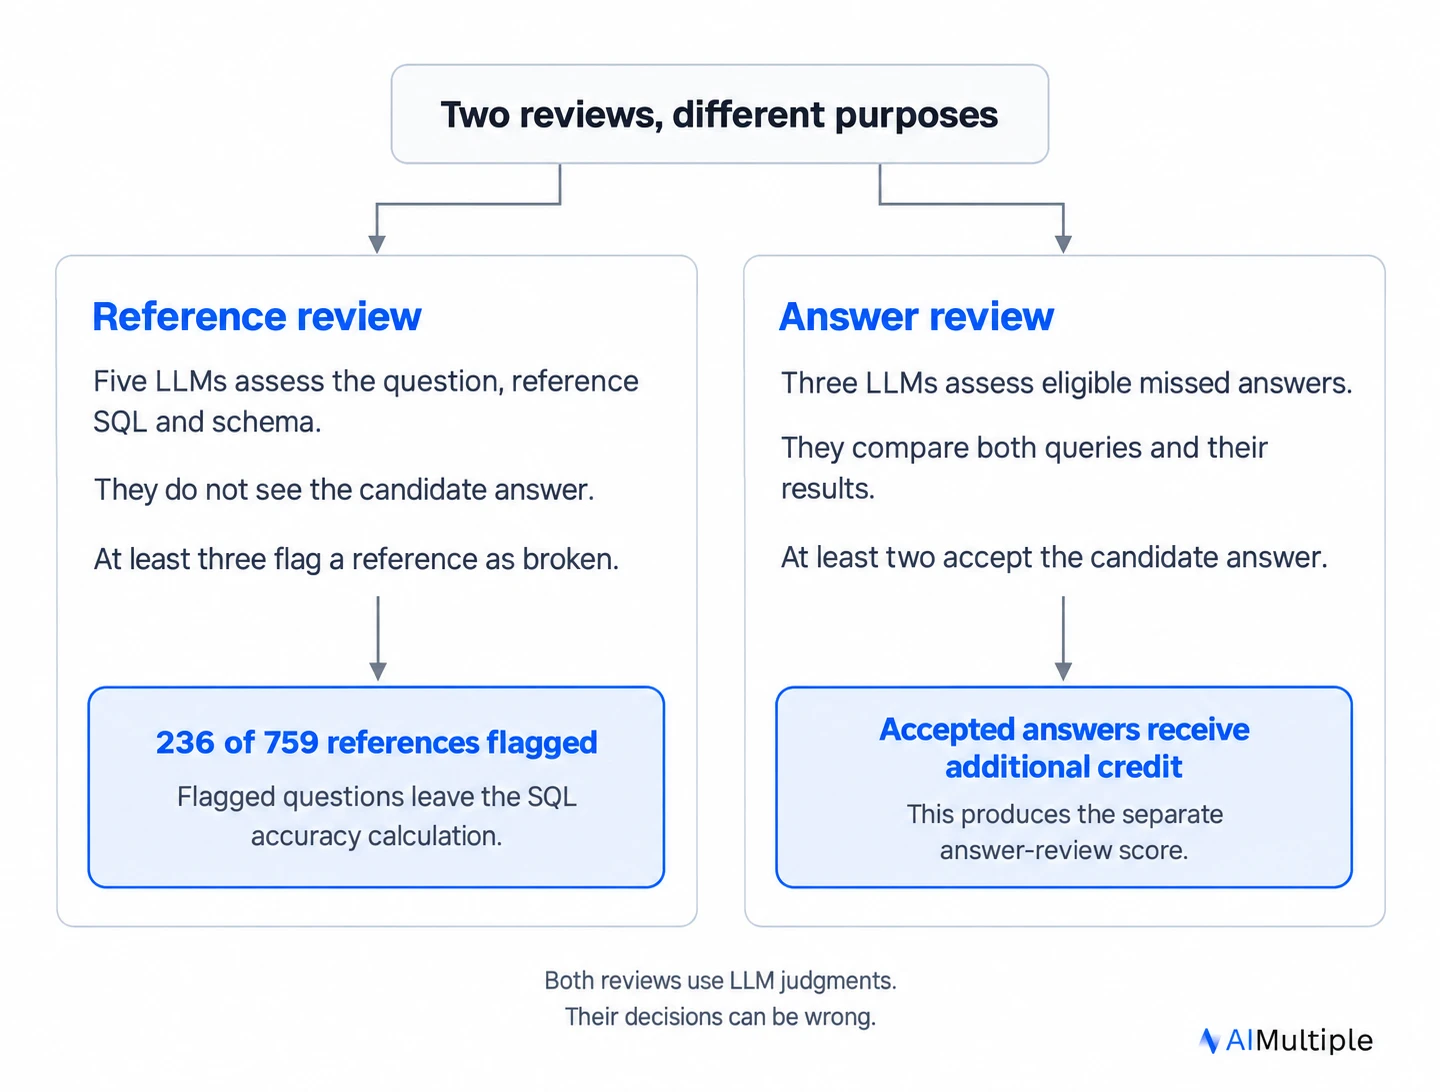
Cinq models ont évalué chaque requête de référence par rapport à sa question et aux informations de schéma disponibles. Ils n’ont vu aucune réponse candidate de model. Une majorité d’au moins trois a signalé 236 références comme défaillantes, soit 31,1 % de l’ensemble.
Après l’audit, le propriétaire du benchmark a examiné les signalements. Des annotateurs humains indépendants n’ont pas répété cet examen. Ces pourcentages décrivent le sous-ensemble audité. Ils ne doivent pas être généralisés à l’ensemble de BIRD.
Des réponses équivalentes ont ajouté 22.7 points au score de claude-sonnet-5
claude-sonnet-5 a réussi 211 questions strictement notées sur 679, soit 31,1 %. Un jury a accepté 154 autres réponses comme équivalentes à la référence. Celles-ci ont contribué à hauteur de 22.7 points de pourcentage.
117 autres réponses ont reçu du crédit parce que le jury a accepté la requête du model et rejeté la référence. Celles-ci ont contribué à hauteur de 17.2 points. Together, les deux catégories ont porté le score à 71,0 %, soit une augmentation de 39.9 points.
Les réponses équivalentes peuvent renvoyer les informations demandées avec une colonne supplémentaire ou une projection différente. La comparaison stricte peut rejeter ce résultat même lorsqu’un examinateur l’accepte comme réponse à la question. Sur l’augmentation, 22.7 points proviennent des décisions du jury concernant ces cas. Les défauts de référence représentent les 17.2 points restants.
 Ajouter comme source préférée
Méthodologie du benchmark text-to-SQL
Questions and execution
BIRD-SQL fournit des questions en langage naturel, des références SQL et le contenu des bases de données.1 Nous avons utilisé une sélection figée de 759 questions provenant de 11 bases de données, couvrant 560 exemples train et 199 exemples dev.
Les models ont reçu de courtes descriptions de bases de données et des outils pour lister les tables, lire les définitions de colonnes et exécuter du SQL. Chaque question autorisait jusqu’à neuf appels avec des outils et une réponse finale contenant la base de données choisie et le SQL. La limite d’aperçu du schéma était de 4 000 caractères, et les aperçus de requêtes étaient plafonnés à 50 lignes.
La requête candidate finale et la référence ont été exécutées sur le même fichier de base de données. La notation stricte comparait leurs résultats, y compris un mode sensible à l’ordre pour les questions demandant une réponse ordonnée. Les requêtes candidates manquantes, mal formées ou en échec d’exécution ne recevaient aucun crédit strict sur les questions par ailleurs éligibles et correctement routées.
Pour les 78 exécutions OpenRouter, nous avons demandé une température de 0. Parmi celles-ci, 61 utilisaient la couche de récupération d’appels d’outils v3, 15 la précédaient, et deux combinaient des enregistrements des deux versions. GPT-6 Astra est passé par Codex CLI. Opus 5.5 et Fable 5.1 ont utilisé Claude Code. Les trois exécutions CLI utilisaient un effort de raisonnement moyen. Les exécutions de GPT-6 Luna, Luna Pro, Sol et Sol Pro ainsi que GPT-5.2 ont utilisé OpenRouter. Ces différences d’exécution empêchent d’attribuer un écart de score au seul model.
Sept exécutions ont complété moins de 759 questions. Les enregistrements manquants sont absents des dénominateurs de notation. Le tableau indique les tailles d’échantillon réelles pour les scores principal et supplémentaires. GPT-6.1 Terra, MiniMax M3.1 Flash et Kimi K3.1 Pro ont chacun complété l’ensemble des 759 questions via OpenRouter le 27 octobre. Les réponses réussies antérieures ont été préservées à travers les étapes de mesure. DeepSeek V4.1 Flash 1017 et Muse Spark Open ont chacun complété l’ensemble des 759 questions via OpenRouter le 30 octobre.
Notation SQL
Le score principal exclut les questions signalées à la fois de son numérateur et de son dénominateur. Trois références marquées comme incertaines restent dans le calcul. Les fichiers de résultats appellent cette métrique ex_gold_clean.
Deux scores supplémentaires montrent comment l’examen modifie le résultat :
Avant l’examen des références, le score strict mesure la correspondance d’exécution exacte sur toutes les questions correctement routées. Il inclut les questions avec des références signalées.
Après l’examen des réponses, le score ajoute du crédit lorsqu’un jury distinct accepte une réponse manquée éligible. Il utilise le même dénominateur que le score strict. Les fichiers de résultats appellent cela la précision après adjudication.
La taille de l’échantillon (n) est le nombre de questions notées. Le score principal utilise un sous-ensemble plus petit que les deux scores supplémentaires.
Pour claude-sonnet-5, l’exclusion des références signalées a réduit les réponses acceptées de 211 à 180 et les questions notées de 679 à 468. Sa précision SQL était de 38,5 %.
L’exclusion modifie les deux comptes. L’examen des réponses conserve au contraire le dénominateur d’origine et ajoute du crédit pour les échecs acceptés.
Examen des références et des réponses
L’audit des références et l’examen des réponses candidates nécessitent des entrées différentes.
Les auditeurs de référence étaient claude-opus-4.8, gpt-5.6-sol, gemini-3.1-pro-preview, grok-4.5 et deepseek-v4-pro. Les réponses candidates ont été retenues pour garder les signalements indépendants du model évalué.
L’adjudication des réponses a utilisé trois jurés issus de familles de models différentes de celle du candidat. Les requêtes de référence et candidates apparaissaient dans des positions A/B aléatoires sans étiquettes révélant leurs rôles. Les cas ambigus et les cas avec des votes valides insuffisants n’ont reçu aucun crédit supplémentaire. GPT-6.1 Terra, MiniMax M3.1 Flash et Kimi K3.1 Pro avaient au moins deux votes de jurés valides pour chaque cas éligible. Les votes individuels échoués restent dans les journaux d’audit. Une réponse de jury tronquée de GPT-6.1 Terra a été complétée avec une limite de sortie de 4 000 tokens, augmentée par rapport à 1 200. Le model de jury, le prompt et les règles de notation n’ont pas changé. DeepSeek V4.1 Flash 1017 et Muse Spark Open avaient au moins deux votes de jurés valides pour chaque cas éligible.
La couverture de l’examen est asymétrique. Les réussites strictes restent acceptées, tandis que les échecs éligibles reçoivent une autre évaluation. Par conséquent, l’adjudication peut conserver des faux positifs de la notation stricte et ajouter ses propres faux positifs. Il s’agit d’une estimation supplémentaire, sans exactitude garantie ni borne supérieure garantie sur la précision réelle.
Un échec était admissible à l’adjudication lorsque la requête candidate s’exécutait et que le chevauchement F1 entre ses lignes de résultat et la référence était inférieur à 0.5. Le F1 combine la proportion de lignes candidates trouvées dans la référence avec la proportion de lignes de référence récupérées par le candidat.
Par exemple, gemini-3.5-flash-lite avait 346 échecs stricts. Parmi ceux-ci, 314 étaient admissibles à l’examen. Le jury a accepté le candidat dans 144 cas : 92 avec une référence rejetée et 52 avec les deux réponses acceptées. Il a classé 105 comme erreurs de model et laissé 65 ambigus. Les 32 autres échecs comprenaient 27 avec un chevauchement de résultats plus élevé et cinq échecs d’exécution.
Le jury a accepté 45,9 % des 314 échecs examinés.
Limites
Les erreurs de référence restent incertaines. L’audit à cinq models a inspecté les colonnes des tables utilisées par chaque requête de référence, il peut donc manquer une réponse située dans une autre table. L’audit peut également rejeter une référence valide. Un nouvel examen par des annotateurs humains indépendants est nécessaire pour estimer les deux types d’erreur.
Les jugements du jury dépendent de l’interprétation LLM. Aucun examen humain indépendant n’a vérifié tous les verdicts d’adjudication. Dans le contrôle nova-lite-v1, la précision est passée de 18,9 % en notation stricte à 31,6 % après adjudication, ce qui montre que l’examen n’a pas automatiquement produit un score élevé. Ce contrôle seul ne peut pas établir la précision du jury.
La comparaison stricte peut échouer dans les deux sens. Des colonnes supplémentaires ou un ordre de colonnes différent peuvent rejeter une réponse utile. La normalisation de la casse et l’arrondi des valeurs à virgule flottante à six chiffres significatifs peuvent accepter des différences importantes.
Les intervalles d’échantillonnage des questions sont disponibles pour les scores stricts et la précision SQL dans l’export des résultats. Ils omettent l’incertitude des étiquettes de référence, l’erreur du jury et la variation entre des exécutions SQL répétées. Aucune analyse répétée de SQL n’est rapportée ici.
Il s’agit de résultats pour une charge de travail sélectionnée, indice-free, avec une exigence de routage de base de données. Ils ne sont pas directement comparables au classement BIRD. Les données publiques d’entraînement laissent également un risque de chevauchement des données d’entraînement, comme indiqué dans l’article sur le routage.
Conclusion
claude-opus-5.5 a dominé la précision SQL avec 87,8 %, suivi de gemini-4-argon à 78,6 % et de gemini-3.8-flash à 77,2 %.
Chaque score SQL reflète les questions que le model a correctement routées et les références conservées après examen. Une comparaison SQL contrôlée donnerait à chaque model les mêmes questions et informations de base de données, avec des vérifications indépendantes des étiquettes de référence et des décisions du jury.
Lectures complémentaires
- Benchmark RAG agentique : routage multi-bases de données
- 800+ principaux benchmarks d’IA
- HALC-Bench : hallucination de LLM sur le benchmark de récupération à long contexte
Citez ce benchmark
Choisissez le format qui correspond à votre lieu de publication. Coller la version avec lien dans votre CMS préserve le lien retour.
@misc{sari2026,
  author = {Sarı, Ekrem},
  title  = {{Benchmark AIM-Text-to-SQL: précision SQL sur plus de 70 LLMs}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/text-to-sql}},
  note   = {AIMultiple. Consulté le 30 octobre 2026}
}Résultats et horodatages de 1.5 mille points de données. Téléchargez les données de synthèse présentées dans les graphiques et les tableaux de cet article sous forme de fichier ZIP contenant 5 fichiers CSV et un README.
Vous voulez les données détaillées derrière ? Rejoindre Premium
Journal des modifications
9 mises à jourRésultats du benchmark texte-vers-SQL remplacés par un panel de 36 modèles noté selon la correspondance d'exécution strict, gold-clean et adjudicated.
Ajout d'un journal des modifications à la section "Agentic RAG benchmark: multi-database routing and query generation".
Remplacé la section méthodologie par un résumé et une référence à un autre article.
Liens de référence





Commentaires 1
Partagez vos idées
Votre adresse courriel ne sera pas publiée. Tous les champs sont obligatoires. Les commentaires sont laissés dans leur langue d'origine.
Curious, how much of the context engineering and specific prompting did you apply in your benchmarks. Or, was it to review the models only? I have found much higher return of correct and consistent responses. A higher fidelity. To do that, I needed to provide a most sophisticated prompt that fed the context window as the question was being asked. Not perfect, but better than those scores represented in this article when using the Grok 4.x .
Great point. This benchmark intentionally uses zero-shot, minimal prompting with temperature=0. No few-shot examples, no domain-specific instructions, no iterative refinement. The goal was to measure each model's baseline text-to-SQL capability. So your experience with Grok 4 getting higher fidelity through sophisticated context engineering is completely expected. A well-crafted prompt with detailed schema descriptions, few-shot examples, and domain-specific rules will improve any model's performance significantly. What this benchmark isolates is how well the model performs out-of-the-box when given only the raw question and retrieved schema, which helps compare the models' inherent SQL reasoning abilities on a level playing field. We'll make this clearer in the methodology section. Thanks for raising it.