


AIM-Agentic RAG Benchmark: routage entre 11 bases de données SQL
We benchmarked 70+ LLMs on 759 questions that require choosing among 11 SQL databases. The benchmark measures whether each model identifies the right database, explores alternatives and states a final choice.
La précision du routage est le pourcentage de questions notées pour lesquelles le modèle nomme explicitement la bonne base de données dans sa réponse finale. Le résultat principal utilise les 184 questions signalées comme difficiles à la fois par notre test de similarité et par un jury de trois LLMs. Les déclarations explicites manquantes ne reçoivent aucun crédit.
Constats sur le routage des bases de données
Gemini 4 Argon a enregistré la précision de routage la plus élevée avec 94,0 %
gemini-4-argon a sélectionné la bonne base de données pour 173 des 184 questions difficiles. claude-opus-5.5 a suivi avec 90,2 % (166 sur 184). Muse Wonder a enregistré 86,4 % (159 sur 184). GPT-6.1 Terra a enregistré 83,7 % (154 sur 184). MiniMax M3.1 Flash a enregistré 81,5 % (150 sur 184). Kimi K3.1 Pro a enregistré 84,8 % (156 sur 184). Muse Spark Open a enregistré 81,0 % (149 sur 184), et DeepSeek V4.1 Flash 1017 a enregistré 77,2 % (142 sur 184).
Gemini 4 Argon a dominé sur l’ensemble des questions avec 98,4 % (747 sur 759). Il a été exécuté via OpenRouter. Les scores observés reflètent à la fois le modèle et les conditions d’exécution.
DeepSeek V4 Flash 0731 a enregistré une précision de routage de 82,1 % pour $1,37
DeepSeek V4 Flash 0731 a répondu correctement à 151 des 184 questions difficiles. Ses réponses conservées sur l’ensemble des 759 questions ont coûté $1.37. Qwen3.8 Flash a obtenu 79,3 % pour $2,08, tandis que MiMo-V2.6-Pro a atteint 82,6 % pour $4.17.
Ces coûts additionnent les réponses réussies conservées dans chaque fichier de résultats. Les tentatives échouées et remplacées sont exclues. Ces totaux dépendent des fournisseurs et des conditions de mise en cache utilisées lors des mesures. Le graphique des coûts comprend 78 totaux d’API mesurés et trois estimations équivalentes OpenRouter étiquetées séparément pour Opus 5.5, Fable 5.1 et GPT-6 Astra. Ces estimations appliquent les tarifs API du 1er octobre 2026 aux tokens CLI enregistrés et à l’utilisation du cache. Elles ne mesurent pas les dépenses d’abonnement.
Grok 4.6 a gagné 41.8 points après son premier choix de base de données
La précision de routage de Grok 4.6 sur les questions difficiles est passée de 38,0 % lors de sa première vérification à 79,9 % lors de sa déclaration finale. GPT-6 Sol Pro a gagné 34.2 points au cours de son exécution. Nova Lite a perdu 14.0 points.
Ces variations concernent les questions avec une seule base de données au premier tour. Elles décrivent les trajectoires enregistrées. Aucune intervention distincte n’a isolé le bénéfice des appels supplémentaires.
Sur l’ensemble des 81 modèles, 8 203 enregistrements de questions difficiles comprenaient un changement de base de données :
Ce tableau prend en compte la première base de données dans l’ordre d’appel enregistré, y compris les premiers tours avec plusieurs bases de données. Le crédit final exige une déclaration correcte explicite. Les variations en points de pourcentage ci-dessus utilisent le sous-ensemble plus étroit du premier choix unique.
Résultats du routage des bases de données
Les modèles sont triés par précision du routage, du plus élevé au plus faible. La méthodologie identifie des différences dans les logiciels utilisés pour les exécuter. Ces conditions sont importantes pour interpréter les petits écarts de score.
Les intervalles estiment l’incertitude liée à l’échantillonnage des questions. Les coûts enregistrés couvrent les enregistrements réussis de chaque exécution. Ils reflètent les fournisseurs et les conditions de mise en cache utilisées au moment des mesures.
Conditions affectant la sélection des bases de données
Des bases de données similaires ont réduit la précision du routage d’environ 20 points
Nous avons testé la méthode de sélection des bases de données dans une expérience distincte portant sur 128 questions. Chaque question conservait sa base de données correcte, tandis que les 10 autres candidates provenaient soit de notre groupe sélectionné, soit d’un tirage aléatoire.
Sur le sous-ensemble difficile, claude-opus-4.8 a obtenu 71,3 % avec des candidates similaires et 92,0 % avec des candidates aléatoires. gemini-3.5-flash a obtenu 77,0 % et 96,6 %. Les deux différences présentaient des valeurs p inférieures à 0.001 dans des tests appariés.
Cette expérience utilisait des descriptions et une réponse de modèle par question, sans la boucle d’outils agentiques. Elle étaye le constat plus restreint selon lequel la sélection de candidates similaires rend le choix de la base de données plus difficile. L’écart mesuré ne doit pas être présenté comme l’effet de l’exploration agentique.
Les noms seuls ont produit une précision de 68,8 % et de 71,1 % dans une expérience pilote
Dans un autre pilote de 128 questions, claude-opus-4.8 a choisi la bonne base de données 68,8 % du temps à partir des seuls noms. Son score avec noms et descriptions était de 67,2 %. gemini-3.5-flash a obtenu 71,1 % à partir des noms et 75,0 % à partir du catalogue complet.
Des noms tels que california_schools et toxicology révèlent directement le sujet. Pour le benchmark principal, nous remplaçons les noms de bases de données par des alias de db_01 à db_11. Les descriptions expliquent toujours le domaine de chaque base de données, et les réponses des outils exposent les noms de ses tables et colonnes.
Fiabilité des comparaisons de routage et de coûts
Des exécutions répétées ont modifié la précision du routage de 1.6 à 2.7 points
claude-opus-5 a sélectionné la bonne base de données pour 156 des 184 questions difficiles lors de sa première exécution et 151 lors de sa répétition. Sa précision est tombée de 84,8 % à 82,1 %. qwen3.8-max est passé de 153 réponses correctes à 150, soit une baisse de 83,2 % à 81,5 %.
Les deux répétitions utilisaient les mêmes questions, l’anonymisation, la température et les paramètres de fournisseur que leurs exécutions initiales. qwen3.8-max a modifié sa réponse sur 13 questions difficiles même si son total n’a varié que de trois. Des améliorations sur certaines questions ont annulé des erreurs sur d’autres.
Ces répétitions montrent que de petits écarts de score peuvent disparaître lors d’une autre exécution. Une seule répétition par modèle ne permet pas d’établir une distribution des résultats, et les 79 autres modèles n’ont pas de mesure répétée.
Les coûts enregistrés dépendent des paramètres du fournisseur et de la mise en cache
La mise en cache des prompts réutilise les entrées déjà traitées pour réduire les coûts d’entrée facturés. L’exécution de claude-opus-5 a coûté $62,78, contre une estimation de $105,54 aux tarifs catalogue sans cache pour le même usage enregistré. Cette estimation implique une économie de 40,5 %. Il s’agit d’une comparaison comptable, sans exécution distincte de précision sans cache.
RAG agentique et sélection des bases de données
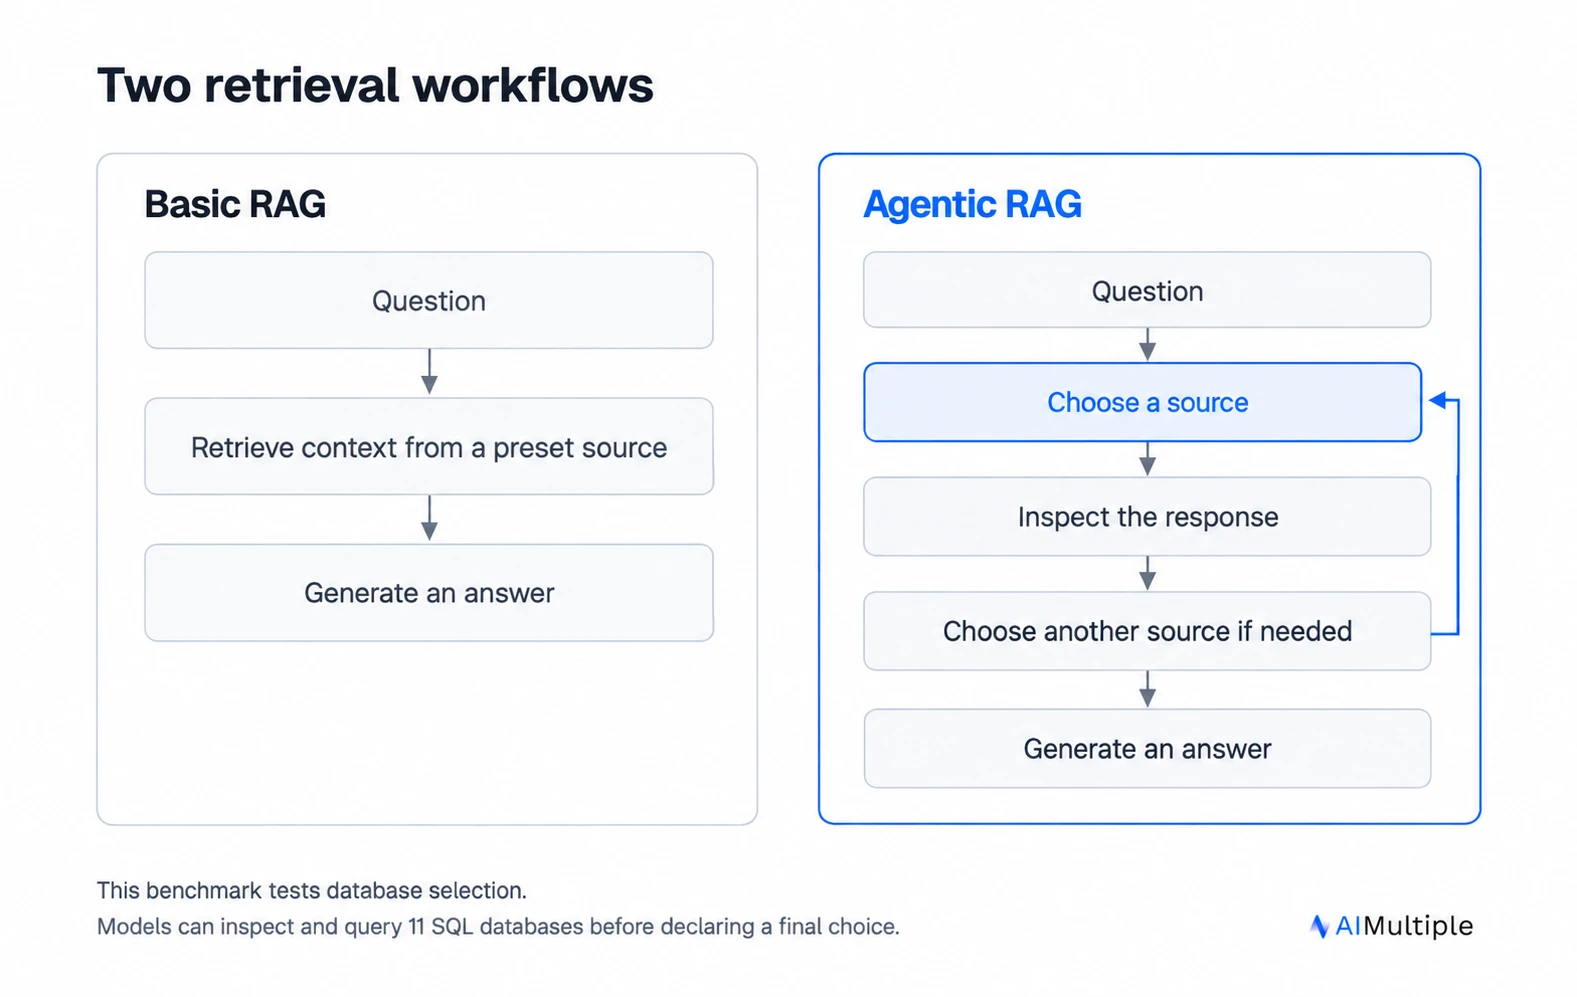
Le RAG agentique donne au modèle contrôle des décisions de récupération. Il peut choisir une source, examiner la réponse et effectuer une autre requête. Un simple RAG pipeline récupère du contexte selon une séquence prédéterminée avant de générer une réponse.
Ce benchmark teste la sélection de sources à l’aide d’outils de bases de données SQL. Il ne contient pas d’index de documents, de passages récupérés ni de score d’ancrage des réponses. Les résultats décrivent donc une partie d’un système de récupération agentique. La recherche documentaire est couverte séparément dans notre benchmark de recherche agentique.
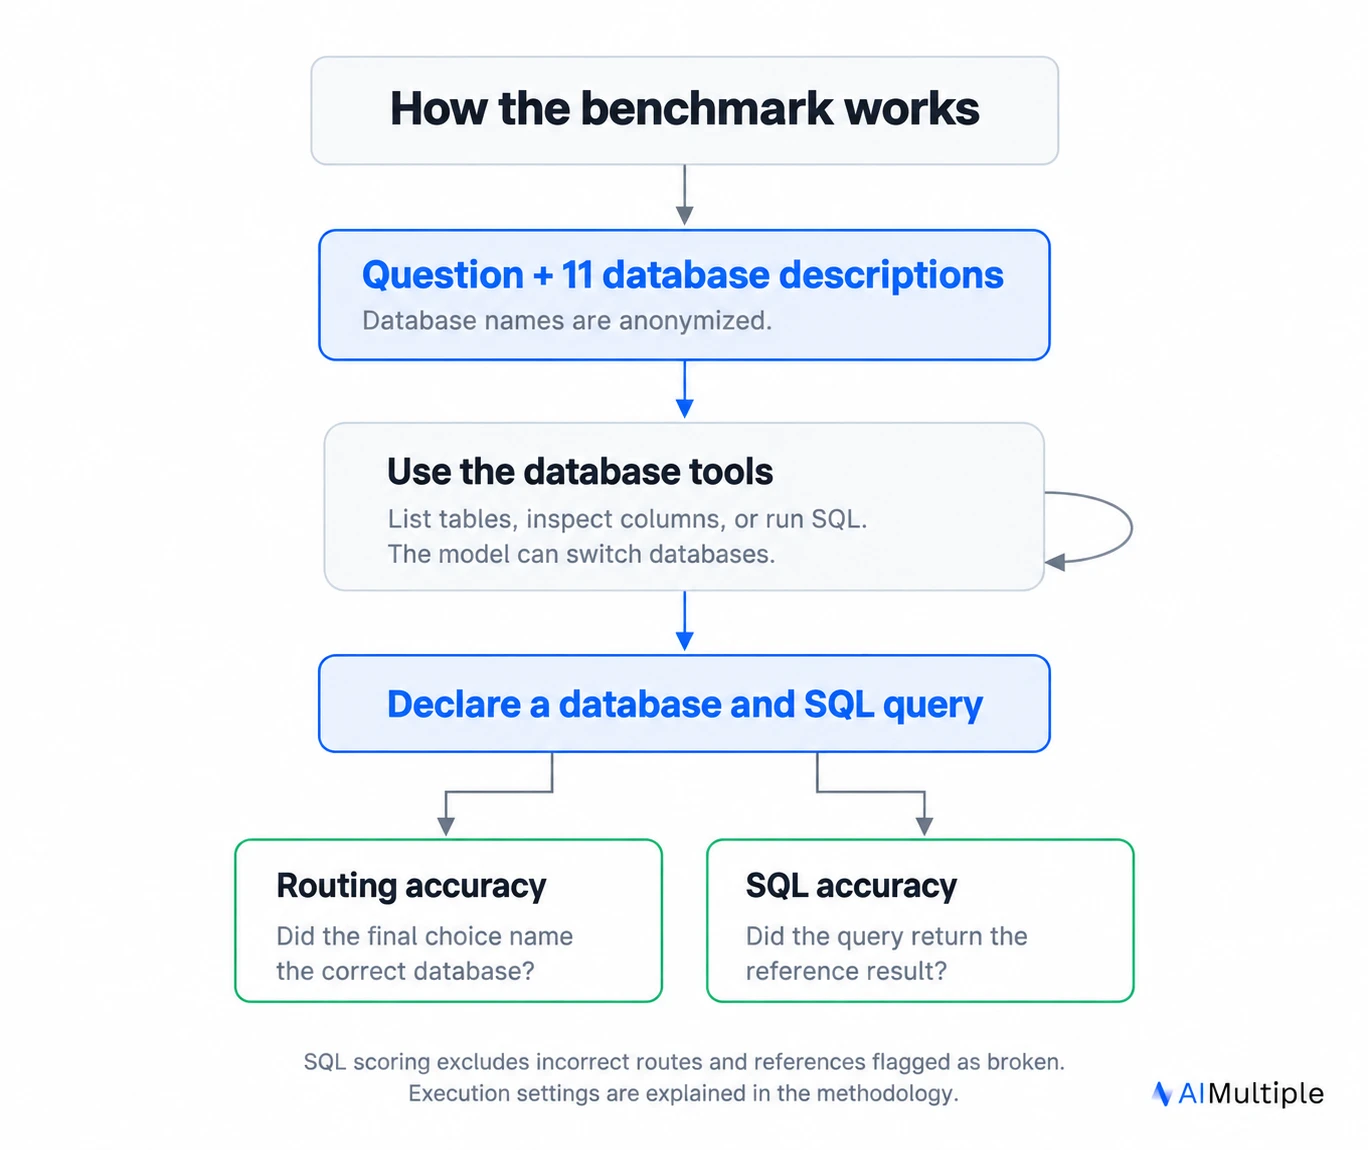
Un modèle commence avec de courtes descriptions de bases de données. Il peut demander des listes de tables, inspecter des colonnes, exécuter du SQL et changer de base de données. Sa réponse finale contient un choix de base de données et une requête. Notre text-to-SQL benchmark indique la précision du SQL et deux scores de revue supplémentaires.
Méthodologie du benchmark RAG agentique
L’ensemble de questions est un sous-ensemble gelé de BIRD-SQL, qui associe des questions en langage naturel à des requêtes SQL de référence.1
Deux signaux définissent la difficulté. Le test de similarité compte combien des 20 plus proches voisins d’une question appartiennent à d’autres bases de données. Trois LLMs évaluent si la question est ambiguë d’une base de données à l’autre. L’appartenance au groupe le plus difficile exige au moins cinq voisins inter-bases de données et une étiquette du jury signalant une ambiguïté.
Le routage utilise la base de données nommée sous le champ explicite selected_database. Un routage déduit de la prose est exclu du résultat principal. La correction SQL est évaluée séparément et ne détermine pas le crédit de routage.
Le harnais est le logiciel qui présente les outils et enregistre les réponses des modèles. Le panneau contient 78 exécutions OpenRouter, deux exécutions Claude Code et une exécution Codex CLI. Parmi les exécutions API, 61 utilisaient la v3, 15 utilisaient une version antérieure, et deux combinaient des enregistrements des deux versions. Dans la v3, une couche de récupération analyse les formats d’appels d’outils alternatifs pris en charge. Pour llama-4-maverick, la part des formats non natifs enregistrée était de 97,9 %, de sorte que ce résultat dépend fortement de l’adaptateur. minimax-m2.7 a été exclu car il n’a pas émis les appels d’outils de base de données requis par la tâche.
GPT-6 Astra a été exécuté dans Codex CLI. Opus 5.5 et Fable 5.1 ont été exécutés via Claude Code. Tous les trois utilisaient un effort de raisonnement moyen et ont terminé 759 questions. Les exécutions Claude Code utilisaient des abonnements, et Astra n’a signalé aucun coût en dollars. Le graphique des coûts comprend des estimations équivalentes OpenRouter étiquetées séparément pour ces trois exécutions CLI. Les exécutions GPT-6 Luna, Luna Pro, Sol et Sol Pro ainsi que GPT-5.2 utilisaient OpenRouter.
 Ajouter comme source préférée
Limites
Le sous-ensemble difficile se concentre sur le commerce. Quatre bases de données contribuent à 171 de ses 184 questions, soit 92,9 %. Cinq des 11 bases de données n’y contribuent pas. Cela étaye les conclusions sur le choix entre des bases de données similaires au sein d’un domaine, avec des preuves limitées pour d’autres combinaisons de domaines. GPT-6.1 Terra, MiniMax M3.1 Flash et Kimi K3.1 Pro ont chacun terminé l’ensemble des 759 questions via OpenRouter le 27 octobre. Les réponses réussies antérieures ont été conservées. Les résultats des nouvelles tentatives peuvent dépendre de changements dans la disponibilité des services. DeepSeek V4.1 Flash 1017 et Muse Spark Open ont chacun terminé l’ensemble des 759 questions via OpenRouter le 30 octobre.
Les données de benchmark publiques peuvent avoir été incluses dans l’entraînement des modèles. Des contrôles utilisant 138 paraphrases validées et 65 questions nouvellement rédigées n’ont constaté aucune baisse de précision dans les modèles testés à moindre coût. Leur couverture était limitée respectivement à six et trois bases de données. Ils ne résolvent pas la contamination pour l’ensemble du panel, et aucun contrôle n’a utilisé de bases de données publiées après la date limite d’entraînement des modèles.
La troncature des schémas peut masquer des tables utiles. Dans works_cycles, la limite de 4 000 caractères laisse visibles 26 des 66 tables dans la liste initiale des schémas. Le modèle peut demander plus de détails, mais la vue initiale est incomplète.
Conclusion
gemini-4-argon a enregistré le meilleur score de routage sur les questions difficiles avec 94,0 %. DeepSeek V4 Flash 0731 a atteint 82,1 % avec $1,37 de coûts de réponses conservées sur l’ensemble de l’exécution.
La configuration d’exécution, les nouvelles tentatives et la tarification des fournisseurs limitent les comparaisons. Ces résultats mesurent la sélection de bases de données parmi des sources SQL similaires. La récupération de documents et la génération de réponses ancrées nécessitent des évaluations distinctes.
Lectures complémentaires
- Text-to-SQL : comparaison de la précision des LLM
- RAG Frameworks : LangChain vs LangGraph vs LlamaIndex
- Meilleurs outils, frameworks et bibliothèques RAG
- Recherche agentique en 2026 : benchmark de 8 APIs de recherche pour agents
Citez ce benchmark
Choisissez le format qui correspond à votre lieu de publication. Coller la version avec lien dans votre CMS préserve le lien retour.
@misc{sari2026,
  author = {Sarı, Ekrem},
  title  = {{AIM-Agentic RAG Benchmark: routage entre 11 bases de données SQL}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/agentic-rag}},
  note   = {AIMultiple. Consulté le 27 octobre 2026}
}Résultats et horodatages de 1.1 mille points de données. Téléchargez les données de synthèse présentées dans les graphiques et les tableaux de cet article sous forme de fichier ZIP contenant 7 fichiers CSV et un README.
Vous voulez les données détaillées derrière ? Rejoindre Premium
Journal des modifications
16 mises à jourLa section « Qu'est-ce qui rend une question difficile dans ce benchmark ? » a été mise à jour avec un nouveau contenu.
La méthodologie a été mise à jour pour clarifier la répartition des questions les plus difficiles entre les bases de données.
La section de méthodologie de référence RAG Agentic a été remplacée par une nouvelle couvrant 36 LLM et 11 bases de données.
Ajout de nouveaux modèles au benchmark : Claude Fable 5, Claude Opus 4.8, Gemini 3.5 Flash, Grok 4.3, Claude Opus 4.7.
La section méthodologie a été mise à jour avec de nouveaux détails sur l'environnement de la base de données, l'architecture de l'agent et le processus d'évaluation.
Ajout d'une section sur les modèles à long contexte par rapport au RAG agentique.
Suppression des métriques agentiques supplémentaires de la méthodologie.
Liens de référence








Soyez le premier à commenter
Votre adresse courriel ne sera pas publiée. Tous les champs sont obligatoires. Les commentaires sont laissés dans leur langue d'origine.