


15 Outils d'observabilité des agents IA: AgentOps & Langfuse

Nous avons testé 15 plateformes d'observabilité pour les applications LLM et les agents IA. Chaque plateforme a été mise en œuvre de manière pratique en configurant des workflows, en configurant des intégrations et en exécutant des scénarios de test. Nous avons évalué 4 outils d'observabilité pour mesurer s'ils introduisent une surcharge dans les pipelines de production. Nous avons également démontré un LangChain tutoriel d'observabilité utilisant Langfuse.
Benchmark de surcharge des outils de surveillance agentique
Nous avons intégré chaque plateforme d'observabilité dans notre système de planification de voyage multi-agents et exécuté 100 requêtes identiques pour mesurer leur surcharge de performance par rapport à une base de référence sans instrumentation. Lisez notre méthodologie de benchmark.
- LangSmith a démontré une efficacité exceptionnelle avec pratiquement aucune surcharge mesurable, ce qui le rend idéal pour les environnements de production critiques en termes de performances.
- Laminar a introduit une surcharge minimale de 5 %, ce qui le rend très adapté aux environnements de production où les performances sont critiques.
- AgentOps et Langfuse ont montré une surcharge modérée de 12 % et 15 % respectivement, ce qui représente un compromis raisonnable entre les fonctionnalités d'observabilité et l'impact sur les performances. Ces plateformes maintiennent toujours une latence acceptable pour la plupart des cas d'utilisation en production.
Raisons potentielles des différences de performances
Notre benchmark indique que les différences de latence sont dues à la profondeur de l'instrumentation et à l'implication dans le chemin d'exécution, en particulier dans les workflows multi-agents. Les outils offrant une observabilité plus profonde au niveau des étapes ont montré une surcharge plus élevée, tandis que les approches de traçage plus légères restaient plus proches de la base de référence.
1. Profondeur de l'instrumentation sur le chemin d'exécution
Les outils d'observabilité ajoutent de la logique au flux d'exécution de l'agent pour capturer les traces et les métadonnées. Lorsque cette logique s'exécute de manière synchrone pendant le traitement des requêtes, elle augmente directement la latence de bout en bout, car l'agent doit terminer ce travail supplémentaire avant de renvoyer une réponse.
Par exemple :
- LangSmith n'a ajouté pratiquement aucune surcharge mesurable (~0 %), indiquant peu de travail synchrone,
- L'instrumentation plus profonde au niveau des étapes de Langfuse a contribué à une surcharge plus élevée (~15 %).
2. Amplification des événements dans les pipelines multi-étapes
Dans les systèmes multi-agents, une seule requête utilisateur déclenche plusieurs actions d'agent. Lorsqu'un outil enregistre des données détaillées à chaque étape, le nombre total d'événements augmente rapidement, ce qui accroît la surcharge de traitement et de gestion des traces à mesure que le workflow s'approfondit.
Dans les résultats du benchmark :
- Langfuse et AgentOps ont généré une surcharge nettement plus élevée (15 % et 12 %) dans notre workflow de planification de voyage multi-étapes
- LangSmith et Laminar ont émis moins d'événements par étape d'agent.
3. Surcharge d'évaluation et de validation en ligne
Certaines plateformes effectuent des contrôles ou une surveillance supplémentaires pendant que l'agent est en cours d'exécution. Bien que chaque contrôle soit léger, les appliquer à plusieurs reprises sur toutes les étapes de l'agent ajoute une latence mesurable.
Par exemple :
- La surveillance au niveau du cycle de vie d'AgentOps a coïncidé avec une surcharge de 12 %
- Laminar n'a montré aucune preuve que l'évaluation en ligne affecte l'exécution, restant à ~5 %.
4. Fréquence de sérialisation et de persistance
La capture de données d'observabilité détaillées nécessite de sérialiser les traces et de les écrire dans le stockage ou les backends externes. Un niveau de détail plus élevé des traces augmente la fréquence de cette opération, ajoutant une surcharge d'E/S à chaque requête.
Dans notre benchmark :
- Le traçage détaillé des prompts, des sorties et des tokens de Langfuse a entraîné la surcharge la plus élevée (~15 %)
- Les artefacts de trace plus légers de LangSmith sont restés proches de la base de référence.
5. Intégration étroite avec le framework d'agent
Le degré d'intégration d'un outil avec le framework d'agent affecte les performances. Des intégrations plus étroites réduisent les étapes de traduction et d'orchestration, tandis que des SDK plus génériques ajoutent des couches de traitement supplémentaires.
Par exemple :
- L'alignement étroit de LangSmith avec l'exécution de l'agent a été corrélé à une surcharge de ~0 %
- AgentOps et Langfuse ont montré un impact plus élevé sur la latence, conforme à des chemins d'intégration plus découplés.
Plateformes d'observabilité des agents IA
Niveau 1 : Observabilité fine des LLM & des prompts / sorties
* Les capacités listées dans ces colonnes sont des exemples illustratifs de ce que chaque outil peut surveiller lorsqu'il est étendu via des intégrations ou une personnalisation. Elles ne sont pas exclusives à une seule plateforme.
Niveau 2 : Observabilité du workflow, du model & de l'évaluation
Niveau 3 : Observabilité du cycle de vie & des opérations des agents
Niveau 4 : Surveillance système & infrastructure (non natif pour les agents)
Datadog (avec son module d'observabilité LLM) et Prometheus (via des exportateurs) sont de plus en plus utilisés aux côtés de Langfuse/LangSmith.
Plateformes de développement & d'orchestration d'agents :
- Des outils comme Flowise, Langflow, SuperAGI et CrewAI permettent de créer, d'orchestrer et d'optimiser des workflows d'agents avec des interfaces no-code/low-code.
Déploiement, éditions gratuit & tarification
Les éditions gratuit varient selon les limites d'utilisation (par exemple, observations, traces, tokens ou unités de travail). Les prix de départ correspondent généralement à un plan de base, qui peut comporter des restrictions sur les fonctionnalités, les utilisateurs ou les limites d'utilisation.
CoreWeave Forge (W&B Weave)
Cas d'utilisation : Débogage des échecs dans les systèmes multi-agents en traçant la propagation des erreurs à travers les appels d'agents.
W&B Weave, qui fait partie de CoreWeave Forge (anciennement Weights & Biases), enregistre des traces d'exécution structurées pour les systèmes multi-agents, en préservant les relations parent-enfant entre les appels d'agents.
Fonctionnalités de surveillance de Weave
- Traçage hiérarchique des agents plutôt que des journaux de requêtes plats
- Attribution des coûts et de la latence au niveau de l'agent
- Support natif des scoreurs d'évaluation appliqués directement aux traces.
Capacités d'évaluation
Weave fournit également des scoreurs intégrés pour l'évaluation, notamment :
- HallucinationFreeScorer pour détecter les hallucinations,
- SummarizationScorer pour évaluer la qualité des résumés,
- EmbeddingSimilarityScorer pour la similarité sémantique,
- ValidJSONScorer et ValidXMLScorer pour la validation de format,
- PydanticScorer pour la conformité au schéma,
- OpenAIModerationScorer pour la sécurité du contenu,
- Scoreurs RAGAS comme ContextEntityRecallScorer,
- ContextRelevancyScorer pour l'évaluation de systèmes RAG.
Idéal pour : Les équipes exécutant des workflows multi-étapes ou multi-agents qui ont besoin d'une analyse des causes profondes au niveau des traces plutôt que de métriques de surface.
Langfuse
Cas d'utilisation : Suivre les interactions LLM, gérer les versions de prompts et surveiller les performances des models avec les sessions utilisateur.
Langfuse offre une visibilité approfondie sur la couche de prompts, en capturant les prompts, les réponses, les coûts et les traces d'exécution pour aider à déboguer, surveiller et optimiser les applications LLM.
Cependant, Langfuse peut ne pas convenir aux équipes qui préfèrent les workflows basés sur Git pour la gestion du code et des prompts, car son système externe de gestion des prompts peut ne pas offrir le même niveau de contrôle de version et de collaboration.
Fonctionnalités de surveillance de Langfuse
- Visibilité sur l'évolution des prompts et les modèles d'utilisation
- Analyse basée sur les sessions adaptée aux applications orientées utilisateur
- Modèle pratique de métadonnées et de balisage pour le filtrage et la révision
Fonctionnalités de niveau entreprise :
Certaines de ces fonctionnalités incluent :
- Niveaux de journalisation : Ajuster la verbosité des journaux pour des informations plus granulaires.
- Multi-modalité : Prend en charge le texte, les images, l'audio et d'autres formats pour les applications LLM multi-modales.
- Versions & gestion des versions : Suivre l'historique des versions et voir comment les nouvelles versions affectent les performances du model.
- URLs de trace : Accéder à des traces détaillées via des URLs uniques pour une inspection et un débogage plus poussés.
- Graphes d'agents : Visualiser les interactions et dépendances des agents pour une meilleure compréhension du comportement des agents.
- Échantillonnage : Collecter des données représentatives des interactions à analyser sans surcharger le système.
- Suivi des tokens & des coûts : Suivre l'utilisation des tokens et les coûts pour chaque appel de model, garantissant une gestion efficace des ressources.
- Masquage : Protéger les données sensibles en les masquant dans les traces, garantissant confidentialité et conformité.
Idéal pour : Les équipes qui itèrent sur les prompts et surveillent l'utilisation en production, en particulier là où les sessions utilisateur comptent.
Galileo
Cas d'utilisation : Surveiller le coût/la latence, évaluer la qualité des sorties, bloquer les réponses non sécurisées et fournir des correctifs actionnables.
Galileo suit les métriques de coût, de latence et de qualité des sorties tout en appliquant des contrôles de sécurité et de conformité en temps réel.
La plateforme combine l'observabilité traditionnelle (latence, coût, performances) avec le débogage et l'évaluation assistés par IA (détection d'hallucinations, exactitude factuelle, cohérence, adhérence au contexte).
Fonctionnalités de surveillance de Galileo
- Identification des modes de défaillance au-delà des erreurs de surface (par exemple, hallucinations conduisant à des entrées d'outils invalides)
- Retour prescriptif tel que des suggestions de modifications de prompts ou des ajouts few-shot
- Couplage étroit entre les résultats d'évaluation et les correctifs recommandés.
Idéal pour : Les organisations qui privilégient la qualité des sorties, la sécurité et des cycles d'itération rapides avec une remédiation guidée.
Guardrails AI
Cas d'utilisation : Prévenir les sorties nuisibles, valider les réponses LLM et garantir la conformité avec les politiques de sécurité
Guardrails valide les entrées et sorties LLM par rapport à des règles configurables, notamment la toxicité, les biais, l'exposition aux PII, le signalement des hallucinations et la conformité au format.
Guardrails AI fonctionnalités de surveillance
- Validation déterministe via les spécifications RAIL
- Contrôles d'entrée pour la détection d'injection de prompt et de jailbreak
- Nouvelles tentatives automatiques lorsque la validation échoue.
Idéal pour
Les équipes qui doivent appliquer des garanties strictes de sécurité, de conformité ou de formatage avant le renvoi des réponses.
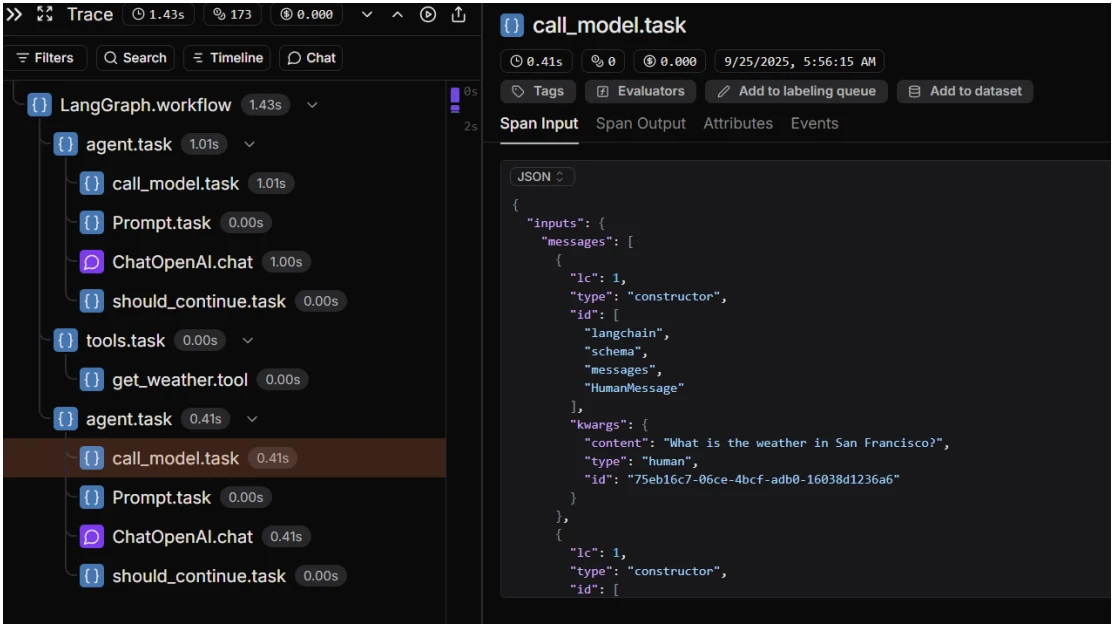
LangSmith
Cas d'utilisation : Raisonnement des agents et débogage des appels d'outils (centré sur LangChain)
LangSmith capture les traces de raisonnement complètes pour les agents basés sur LangChain, y compris les prompts, le contexte récupéré, la logique de sélection des outils, les entrées/sorties des outils, les erreurs et les exceptions.
Fonctionnalités de surveillance de LangSmith
- Inspection étape par étape des chemins de décision des agents
- Relecture des exécutions et comparaison côte à côte entre prompts, models ou outils
- Intégration étroite avec LangChain via des callbacks.
Idéal pour
Les équipes qui construisent avec LangChain et qui ont besoin de déboguer en détail un raisonnement incorrect ou une invocation d'outils.
Langtrace IA
Cas d'utilisation : Identifier les goulets d'étranglement de coût et de latence dans les applications LLM
Langtrace suit le nombre de tokens, la durée d'exécution, les coûts d'API et les paramètres de requête dans les pipelines LLM en utilisant des traces compatibles OpenTelemetry.
Langtrace IA fonctionnalités de surveillance
- Alignement OpenTelemetry pour l'intégration avec les backends existants
- Visibilité sur les facteurs de coût et de latence par étape
- Gestion légère des versions de prompts et terrain de test.
Idéal pour : Les équipes qui optimisent les performances et les dépenses dans les workflows LLM plutôt que d'évaluer la qualité des sorties.
Arize (Phoenix)
Cas d'utilisation : Surveiller la dérive des models, détecter les biais et évaluer les sorties LLM avec des systèmes de notation complets
Phoenix se concentre sur la dérive comportementale, la détection de biais et la notation LLM-as-a-judge pour la pertinence, la toxicité et l'exactitude.
Cependant, il présente une surcharge d'intégration plus élevée par rapport aux proxies légers et ne gère pas la gestion des versions des prompts aussi proprement que les outils dédiés.
Fonctionnalités de surveillance de Phoenix
- Cœur open-source avec des extensions d'entreprise en option
- Terrain de jeu interactif de prompts pour le développement
- Détection de dérive pour suivre les changements comportementaux dans le temps
- Contrôles de biais pour identifier les biais de réponse,
- Notation LLM-as-a-judge pour l'exactitude, la toxicité et la pertinence.
Idéal pour : Les équipes qui surveillent le comportement des models à long terme et le risque de régression plutôt que l'itération sur les prompts.
Agenta
Cas d'utilisation : Trouver quel prompt fonctionne le mieux sur quel model
Agenta compare les réponses des models en termes de coût, de latence et de qualité de sortie en utilisant des entrées partagées et un contexte contrôlé.
Fonctionnalités de surveillance d'Agenta
- Évaluation côte à côte des models
- Aide à la décision en pré-production.
Idéal pour : L'évaluation précoce et la sélection de models.
AgentOps.ai
Cas d'utilisation : Surveiller le raisonnement des agents, suivre les coûts et déboguer les sessions en production
AgentOps capture les traces de raisonnement, les appels d'outils/API, l'état de session, le comportement de mise en cache et les métriques de coût pour les agents déployés.
Fonctionnalités de surveillance d'AgentOps
- Relecture de session pour le débogage en production
- Se concentrer sur le comportement des agents en direct plutôt que sur l'évaluation hors ligne.
Idéal pour : Les équipes qui exécutent des agents en production et qui ont besoin d'une visibilité opérationnelle.
Braintrust
Cas d'utilisation : Trouver quel prompt, dataset ou model offre de meilleures performances avec une évaluation détaillée et une analyse des erreurs
Braintrust évalue les prompts, datasets et models par rapport aux sorties attendues, en suivant la latence, le coût, les erreurs d'outils et les métriques d'exécution.
Fonctionnalités de surveillance de Braintrust
- Évaluer des datasets de test avec des entrées et des sorties attendues, puis comparer les prompts ou models côte à côte en utilisant des variables telles que
{{input}},{{expected}}et{{metadata}}. - Ventilation des métriques incluant la qualité d'exécution des outils
Idéal pour : Les équipes qui benchmarkent les models et les prompts avant le déploiement.
AgentNeo
Cas d'utilisation : Déboguer les interactions multi-agents, tracer l'utilisation des outils et évaluer les workflows de coordination
AgentNeo suit la communication des agents, l'utilisation des outils, les graphes d'exécution et le coût et la latence par agent via un SDK Python.
Fonctionnalités de surveillance d'AgentNeo
- Open-source et exécutable localement
- Tableau de bord local interactif (
localhost:3000) pour la surveillance en temps réel des workflows multi-agents. - Intégration à l'aide de décorateurs (par exemple,
@tracer.trace_agent,@tracer.trace_tool)
Idéal pour : Les équipes d'ingénierie qui expérimentent avec des systèmes multi-agents.
 Ajouter comme source préférée
Laminar
Cas d'utilisation : Suivre les performances à travers différents frameworks et models LLM.
Laminar suit les spans d'exécution, les coûts, l'utilisation des tokens et les percentiles de latence à travers les frameworks et models LLM.
Fonctionnalités de surveillance de Laminar
- Analyse des performances indépendante du framework
- Inspection fine des spans.
Idéal pour : L'analyse comparative des performances à travers des stacks hétérogènes.
Helicone
Cas d'utilisation : Suivre les workflows d'agents multi-étapes et analyser les modèles de sessions utilisateur.
Helicone capture les volumes de requêtes, les coûts, les erreurs, les tendances de latence et les workflows d'agents au niveau de la session.
Fonctionnalités de surveillance d'Helicone
- Visibilité sur le parcours utilisateur
- Analyse des tendances historiques.
Idéal pour : Les équipes produit qui surveillent les modèles d'utilisation et le comportement au niveau de l'utilisateur.
Coval
Cas d'utilisation : Simuler des milliers de conversations d'agents, tester les interactions vocales/chat et valider le comportement avant le déploiement.
Coval simule des milliers de conversations pour mesurer l'achèvement des tâches, l'exactitude et l'efficacité des appels d'outils.
Fonctionnalités de surveillance de Coval
- Tests d'agents basés sur la simulation
- Détection automatique des régressions
- Support des agents vocaux et textuels.
Idéal pour : Validation pré-déploiement et détection des régressions.
Datadog
Cas d'utilisation : Observabilité de l'infrastructure et des applications avec corrélation des signaux LLM.
Datadog collecte des métriques d'infrastructure (CPU, mémoire, réseau), des données de performance d'application (latence, taux d'erreurs, débit) et des journaux. Pour les applications LLM, il peut ingérer l'utilisation des tokens, le coût par requête, la latence des models et des signaux liés à la sécurité tels que les tentatives d'injection de prompt.
Datadog fonctionnalités de surveillance
- Observabilité large et à l'échelle du système à travers l'infrastructure, les applications et les charges de travail d'IA
- Vaste écosystème d'intégrations (900+ intégrations) permettant la corrélation entre le comportement de l'IA et la santé de l'infrastructure
Idéal pour : Les organisations qui souhaitent corréler le comportement LLM avec l'infrastructure sous-jacente et les performances des applications plutôt que d'inspecter le raisonnement des agents ou les prompts
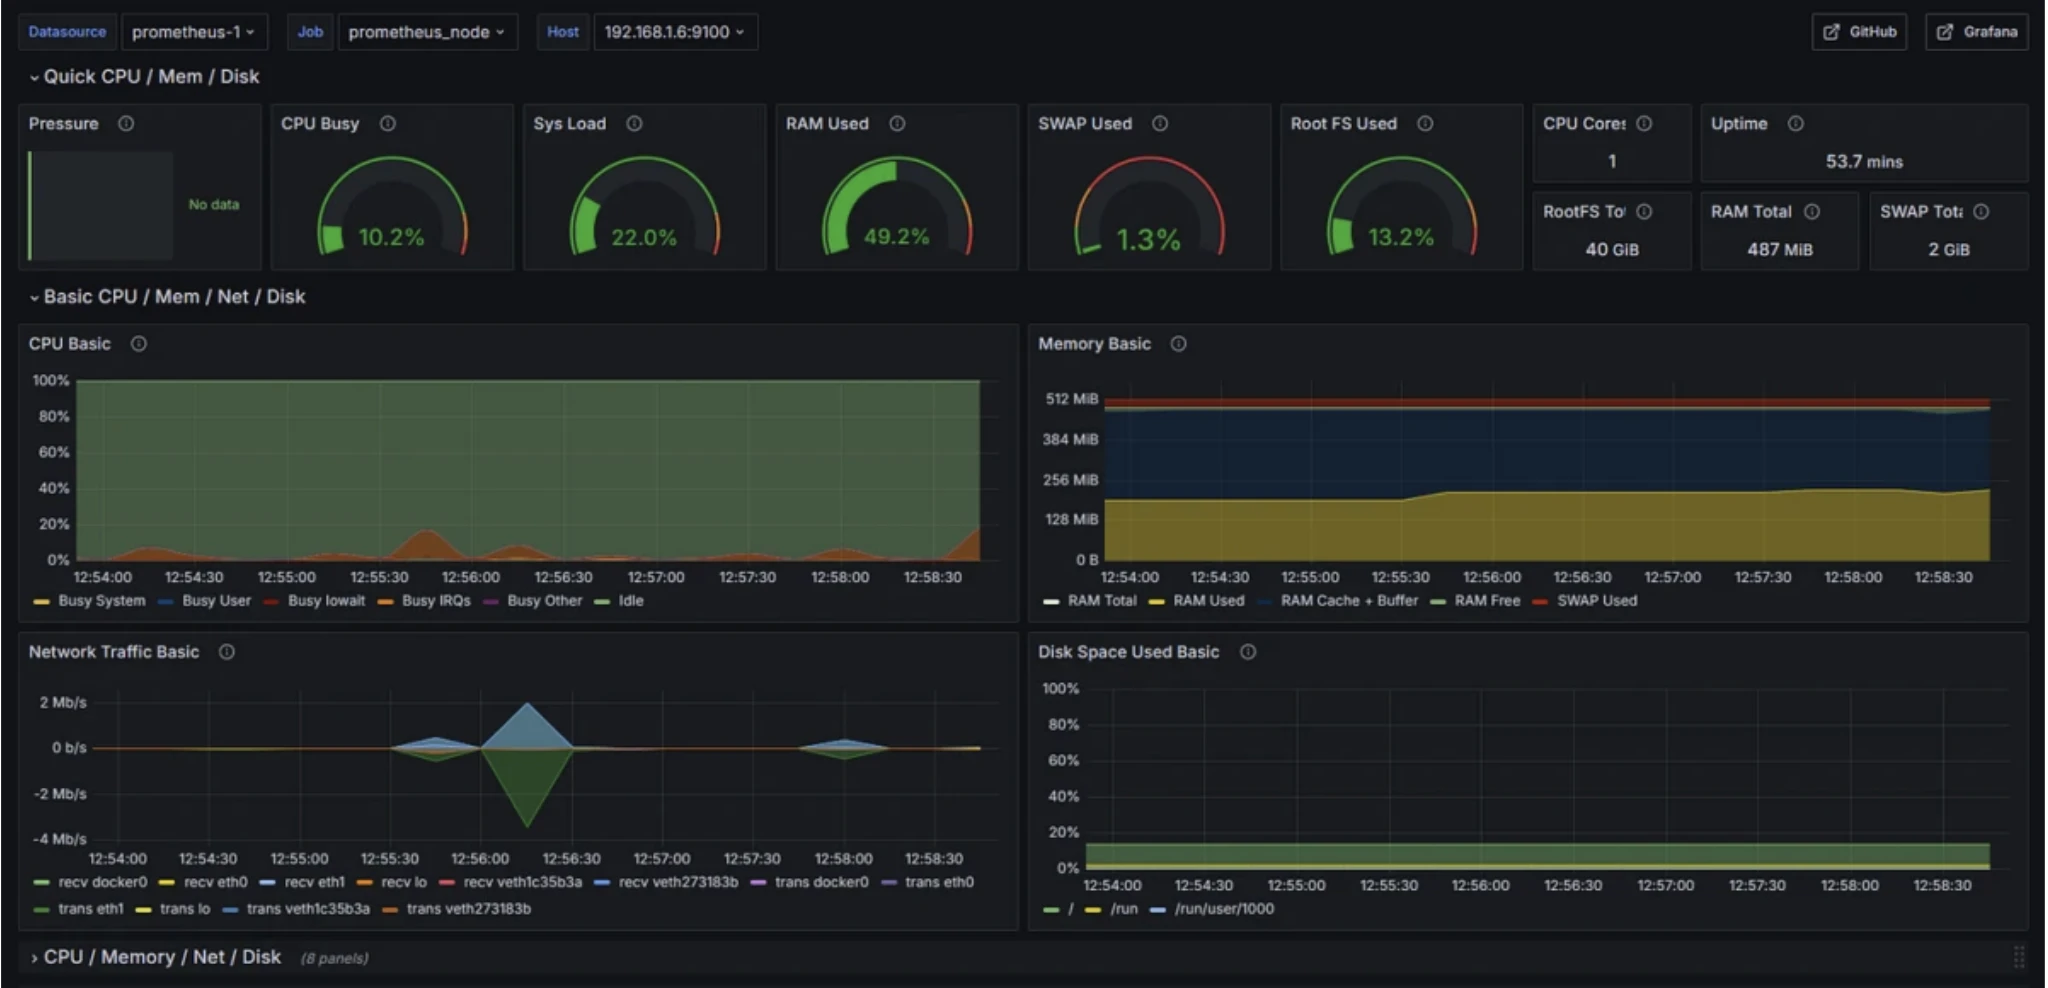
Prometheus
Cas d'utilisation : Surveiller les performances du système, suivre les métriques d'application et configurer des alertes pour les problèmes d'infrastructure.
Prometheus est un système de surveillance open-source qui collecte des métriques de séries temporelles à partir des endpoints HTTP à intervalles réguliers pour suivre l'infrastructure, les applications, les bases de données, les conteneurs et les métriques métier personnalisées.
Fonctionnalités de surveillance de Prometheus
- Collecte de métriques de séries temporelles via un scraping basé sur le pull
- PromQL pour les requêtes, l'agrégation et les conditions d'alerte
- Écosystème d'exportateurs (par exemple, Node Exporter) pour une couverture système étendue
Idéal pour : La surveillance de l'infrastructure et des applications avec des alertes basées sur des règles.
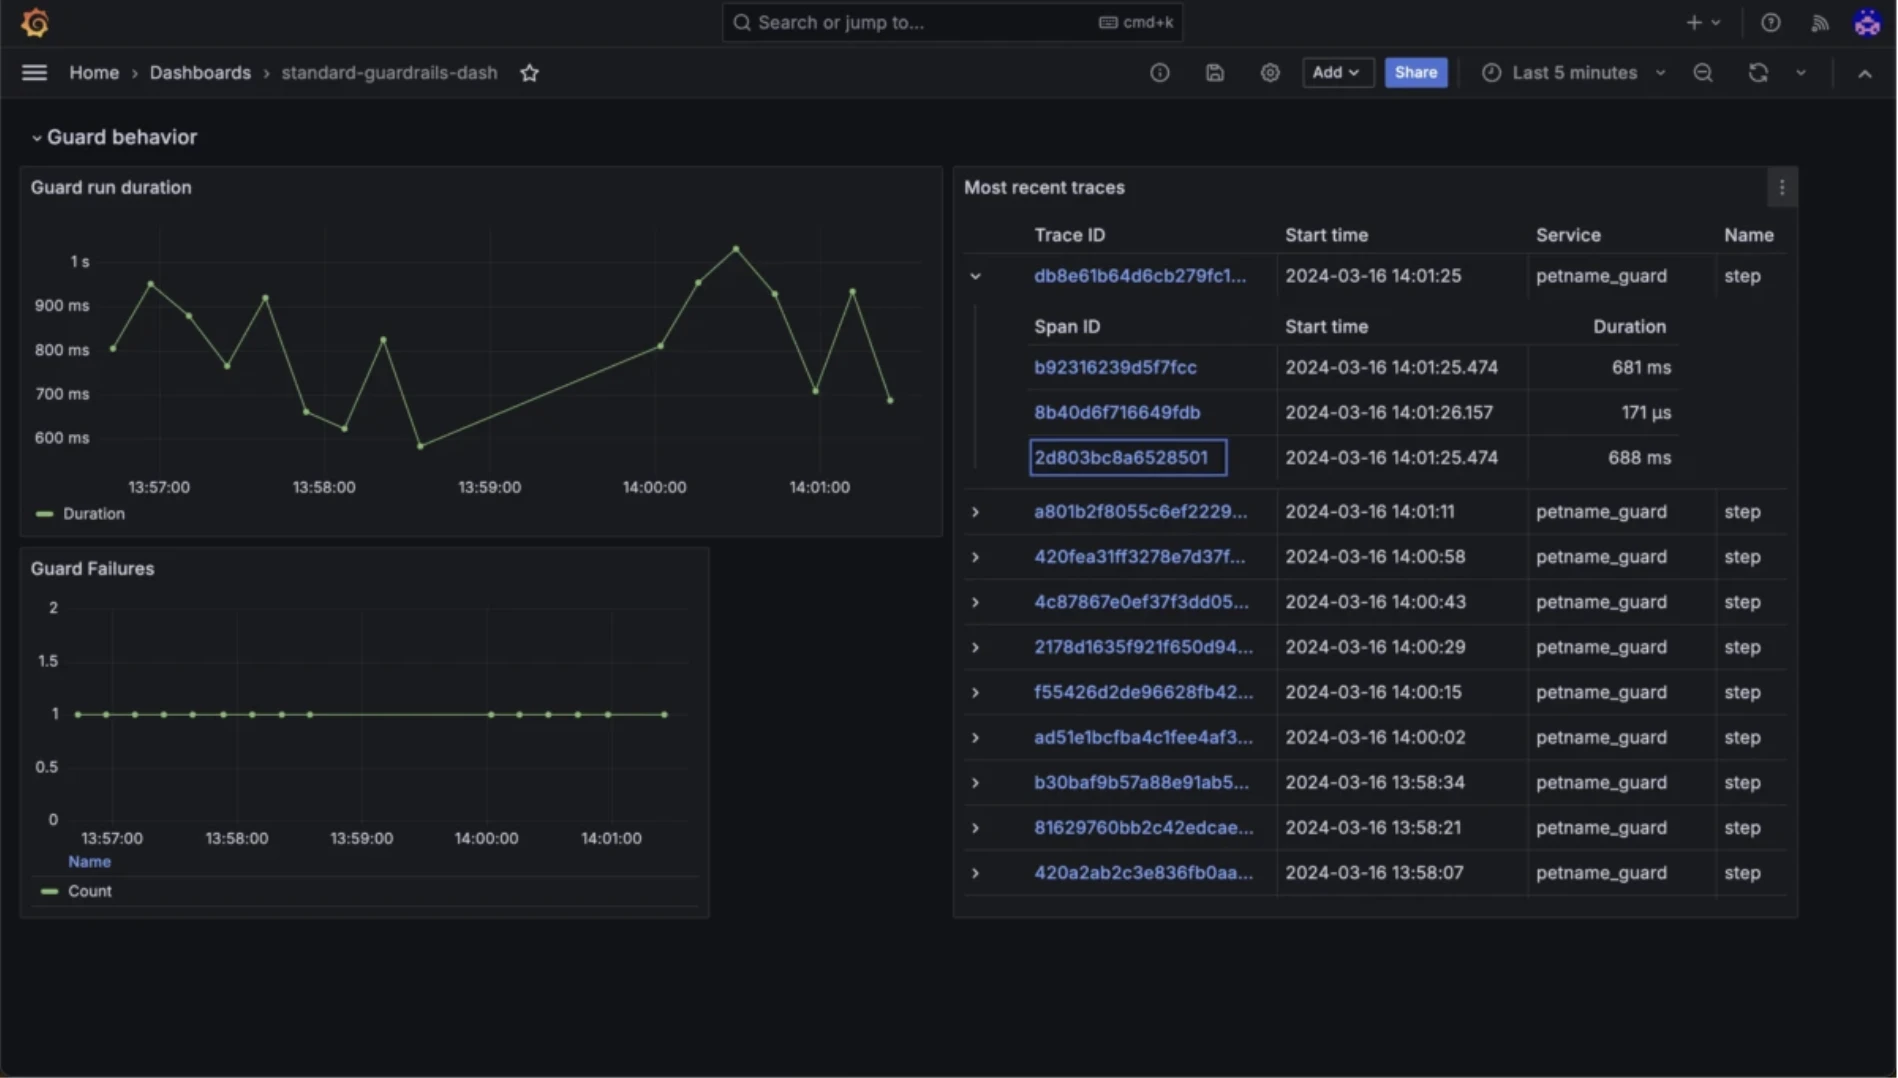
Grafana
Cas d'utilisation : Visualiser les métriques, créer des tableaux de bord et router les alertes à travers les données LLM, d'agents et d'infrastructure.
Grafana est une plateforme open-source de visualisation et d'analyse qui s'intègre à des sources de données telles que Prometheus, OpenTelemetry et Datadog pour fournir des tableaux de bord d'observabilité unifiés.
Fonctionnalités de surveillance de Grafana
- Tableaux de bord couvrant les métriques, les journaux et les traces
- Corrélation inter-systèmes pour les signaux LLM, d'agents et d'infrastructure
- Routage des alertes et gestion des notifications.
Idéal pour : La visualisation centralisée de l'observabilité et la réponse aux incidents.
Tutoriel : observabilité LangChain avec Langfuse
Nous avons construit un pipeline LangChain multi-étapes avec trois étapes :
- analyse de la question
- génération de la réponse
- vérification de la réponse
Après avoir configuré le pipeline, nous l'avons connecté à Langfuse pour surveiller et suivre l'exécution en temps réel. Ce faisant, nous avons pu explorer comment Langfuse nous aide à recueillir des informations détaillées sur les performances, les coûts et le comportement des applications d'IA.
Voici ce que nous avons observé via Langfuse :
Vue d'ensemble du tableau de bord
Langfuse nous a fourni plusieurs tableaux de bord qui nous donnent une visibilité sur différents aspects des performances du pipeline :
- Tableau de bord des coûts : Il suit les dépenses sur tous les appels API, avec des ventilations détaillées par model et par période.
- Gestion de l'utilisation : Il surveille les métriques d'exécution, telles que le nombre d'observations et l'allocation des ressources, nous aidant à suivre comment les ressources sont utilisées pendant l'exécution.
- Tableau de bord de latence : Ce tableau de bord nous a aidés à analyser les temps de réponse, à détecter les goulets d'étranglement et à visualiser les tendances de performance.
Métriques d'utilisation
Le tableau de bord des métriques d'utilisation nous a donné les informations suivantes sur les performances du système :
- Nombre total de traces : Nous avons suivi huit traces, chacune proxy un cycle complet question-réponse dans le pipeline.
- Nombre total d'observations : En moyenne, chaque trace comportait 16 observations, reflétant la nature multi-étapes du processus.
De plus, Langfuse nous permet de suivre les modèles d'utilisation, l'allocation des ressources et les heures de pointe au cours des 7 derniers jours, nous aidant à comprendre quand le système est le plus actif et comment les ressources sont réparties dans le temps.
Inspection des traces
En explorant une trace individuelle, nous avons pu voir des informations d'exécution détaillées :
- Lignes de trace : Chaque ligne représente une exécution complète du pipeline avec un ID de trace unique.
- Métriques de latence : Le temps d'exécution variait, allant de 0.00s à 34.08s.
- Nombre de tokens : Le tableau de bord suivait l'utilisation des tokens d'entrée/sortie, ce qui aide à la gestion des coûts et de l'efficacité.
- Filtrage par environnement : Nous pouvions filtrer les traces en fonction des environnements de déploiement (par exemple, développement, production).
Détails d'une trace individuelle
Nous avons exploré davantage la trace en détail pour comprendre la décomposition de l'exécution :
- Architecture de chaîne séquentielle : La trace affichait un flux visuel montrant chaque étape, en commençant par SequentialChain → LLMChain → ChatOpenAI, avec une structure hiérarchique.
- Suivi des entrées/sorties : La question originale, « Quels sont les avantages d'utiliser Langfuse pour l'observabilité des agents IA ? », a été suivie à chaque étape, ainsi que les sorties respectives produites par l'IA à chaque étape.
- Analyse des tokens : Nous avons observé que 1 203 tokens ont été utilisés pour l'entrée et 1 516 tokens pour la sortie, ce qui a des implications de coût liées à l'utilisation des tokens et aide à optimiser la gestion des ressources.
- Données de temps : La latence totale pour la trace complète était de 34.08s, décomposée à travers chaque composant :
- SequentialChain → 14.02s
- LLMChain → 10.25s
- ChatOpenAI → 9.81s
- Informations sur le model : Langfuse a confirmé l'utilisation du model Anthropic Claude-Sonnet-4, avec des détails sur les réglages spécifiques, y compris la configuration de la température.
- Sortie formatée : Les vues Aperçu et JSON ont été fournies pour le débogage, donnant un aperçu de la réponse du model sous forme lisible par l'homme et sous forme lisible par machine.
Analyse automatisée
Langfuse a également fourni des évaluations automatisées de nos réponses :
- Évaluation de la qualité : Le système a évalué la structure, la cohérence et l'exhaustivité des réponses, en mettant en évidence des sections bien organisées mais en suggérant que les réponses pourraient être plus concises.
- Suggestions d'amélioration : Il a identifié les sections redondantes, suggérant où la formulation pourrait être améliorée, et combiné les points liés pour rendre la réponse plus transparente et plus efficace.
- Informations sur les performances : Le système a donné un retour sur l'utilisation des tokens et la pertinence des réponses, nous aidant à optimiser l'efficacité tout en garantissant que la sortie reste utile et pertinente.
- Retour structuré : Le retour était organisé en catégories, ce qui nous a permis de traiter des domaines d'amélioration spécifiques de manière ciblée.
Analyses utilisateur
Langfuse suit les interactions détaillées entre les utilisateurs et l'agent IA :
- Chronologie d'activité des utilisateurs : Affiche la première et la dernière interaction de chaque utilisateur, aidant à identifier les utilisateurs actifs par rapport aux utilisateurs dormants. Nous pouvons voir quand les utilisateurs se sont engagés avec le système pour la première et la dernière fois.
- Suivi du volume d'événements : Suit le nombre d'événements déclenchés par chaque utilisateur. Par exemple, certains utilisateurs ont généré plus de 2 000 événements, montrant leur niveau d'engagement avec le système.
- Analyse de la consommation de tokens : Surveille le nombre total de tokens consommés par chaque utilisateur. L'utilisation des tokens variait de 6.59K à 357K tokens, fournissant des informations sur l'utilisation des ressources.
- Attribution des coûts : Décompose les coûts associés à chaque utilisateur, facilitant le suivi des dépenses et l'optimisation de l'allocation budgétaire pour l'utilisation des ressources.
- Identification des utilisateurs : Utilise des identifiants utilisateur anonymisés pour préserver la confidentialité tout en suivant les interactions individuelles des utilisateurs, aidant à l'analyse de l'utilisation sans compromettre la confidentialité des utilisateurs.
La vue de session nous permet de suivre des détails granulaires des interactions utilisateur :
- Flux de conversation complet : Montre l'interaction question-réponse complète, facilitant le suivi de toute la conversation du début à la fin.
- Visibilité de l'implémentation : Affiche le code Python réel utilisé pendant la session, fournissant un aperçu de l'implémentation technique.
- Corrélation entrée/sortie : Relie les questions des utilisateurs aux réponses système correspondantes, nous aidant à résoudre les problèmes et à identifier où des problèmes ont pu survenir dans la conversation.
- Métadonnées de session : Inclut des détails techniques tels que le timing, le contexte utilisateur et des données d'implémentation spécifiques, offrant une vue complète de l'exécution de la session.
Quand ne pas utiliser les outils d'observabilité
- Développement à un stade précoce : Si vous validez encore l'adéquation produit-marché ou si vous construisez vos premiers workflows d'agents, l'accent doit être mis sur les fonctionnalités de base plutôt que sur une observabilité étendue.
- Goulots d'étranglement API : Si vos principaux problèmes sont les coûts, la latence ou la mise en cache des API, la priorité immédiate devrait être d'optimiser ces domaines, et non de suivre les métriques au niveau du système.
- Optimisation des models : Si les améliorations sont principalement motivées par la sélection de models, le fine-tuning ou l'ingénierie de prompt, les outils d'observabilité pour la dérive et les biais peuvent ne pas être encore nécessaires.
Quand utiliser les outils d'observabilité
- Production à grande échelle : Lorsque vous opérez sur plusieurs models, agents ou chaînes, les outils d'observabilité sont essentiels pour surveiller les performances et garantir la santé du système.
- Applications d'entreprise ou orientées client : Pour les applications où la fiabilité, la sécurité et la conformité sont non négociables, les outils d'observabilité fournissent la visibilité et le contrôle nécessaires.
- Surveillance continue : Lorsque vous devez surveiller la dérive, les biais, les performances et les problèmes de sécurité au fil du temps, qui ne peuvent pas être facilement capturés avec des scripts de base ou des contrôles manuels, les outils d'observabilité sont cruciaux.
- Scénarios à haut risque : Dans les environnements où le coût de l'échec (par exemple, les hallucinations, les sorties non sécurisées) est important, l'observabilité garantit que les risques sont minimisés et que les problèmes sont détectés tôt.
Méthodologie du benchmark
Pour évaluer la surcharge de performance des plateformes d'observabilité dans les applications LLM en production, nous avons développé une approche de benchmarking systématique utilisant un workflow agentique réel.
Application de test
Nous avons construit un système séquentiel multi-agents de planification de voyage utilisant LangChain qui traite les demandes de voyage en langage naturel à travers cinq étapes :
- Agent analyseur : Extrait les données structurées (origine, destination, dates, durée) à partir de l'entrée utilisateur
- Agent de recherche de vols : Récupère les vols disponibles via l'API Amadeus
- Agent de météo : Récupère les prévisions météo de destination à l'aide de WeatherAPI
- Agent de recommandation d'activités : Suggère des activités en fonction des conditions météorologiques
- Agent planificateur de voyage : Synthétise toutes les sorties en un itinéraire complet
Le système utilise Claude 4 Haiku via OpenRouter pour tous les appels LLM et intègre des APIs externes pour les données en temps réel.
Conception du benchmark
Établissement de la base de référence : Nous avons d'abord mesuré les performances de l'application sans aucune instrumentation d'observabilité, en exécutant 100 requêtes identiques pour établir une base de référence pour la comparaison.
Intégration des plateformes : Nous avons ensuite intégré cinq plateformes d'observabilité de premier plan (LangSmith, Laminar, AgentOps, Langfuse) une à la fois, en instrumentant les mêmes points de traçage sur toutes les plateformes pour la cohérence.
Exécution séquentielle : Chaque plateforme a été testée indépendamment en exécutant toutes les 100 requêtes consécutivement avant de passer à la plateforme suivante. Cette approche minimise la variabilité due à des facteurs externes tels que les conditions réseau ou les limites de taux d'API.
Environnement contrôlé : Tous les tests ont été exécutés sur la même infrastructure serveur avec des ensembles de requêtes identiques pour garantir une comparaison équitable. Pour isoler la surcharge des variations de latence induites par les LLM, nous avons configuré le model avec temperature=0 et des prompts structurés pour minimiser la variabilité des réponses entre les exécutions.
Métriques collectées
Pour chaque plateforme, nous avons mesuré la latence moyenne et calculé la surcharge comme la latence supplémentaire introduite par rapport à la base de référence : ((Platform Latency - Base Latency) / Base Latency) × 100
FAQ
L'observabilité est la capacité de comprendre le fonctionnement interne d'un agent IA en examinant des signaux externes tels que les journaux, les métriques et les traces.
Pour les agents IA, cela implique de surveiller les actions, l'utilisation des outils, les interactions avec les models et les réponses pour résoudre les problèmes et améliorer les performances.
L'observabilité des agents est cruciale pour suivre et améliorer les performances de l'IA en permettant :
Comprendre les compromis : Cela aide à mesurer des métriques clés comme l'exactitude et le coût, facilitant l'équilibre entre les performances et l'utilisation des ressources.
Mesurer la latence : Le suivi de la latence en temps réel offre des informations sur les temps de réponse, aidant à optimiser les performances des agents.
Détecter les entrées malveillantes : L'observabilité aide à identifier le langage nuisible et les injections de prompt, permettant une intervention rapide pour prévenir les problèmes.
Surveillance des retours utilisateur : En observant les interactions et les retours des utilisateurs, l'observabilité fournit des données précieuses pour l'amélioration continue et le fine-tuning des agents.
Les composants clés incluent :
– Suivi des actions : Surveiller chaque étape effectuée par l'agent.
– Utilisation des outils : Observer les outils et les ressources que l'agent utilise.
– Mesure de la latence : Surveiller les temps de réponse pour optimiser les performances.
– Évaluations : Évaluer le comportement de l'agent et les performances des models.
– Détection d'entrées malveillantes : Identifier les prompts nuisibles ou les attaques.
Citez ce benchmark
Choisissez le format qui correspond à votre lieu de publication. Coller la version avec lien dans votre CMS préserve le lien retour.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Şipi, Nazlı},
  title  = {{15 Outils d'observabilité des agents IA: AgentOps & Langfuse}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/agentic-monitoring}},
  note   = {AIMultiple. Consulté le 3 juin 2026}
}Résultats et horodatages de 39 points de données. Téléchargez les données de synthèse présentées dans les graphiques et les tableaux de cet article sous forme de fichier ZIP contenant 6 fichiers CSV.
Vous voulez les données détaillées derrière ? Rejoindre Premium
Journal des modifications
8 mises à jourLa section « Raisons potentielles des différences de performance » a été mise à jour avec de nouvelles explications et exemples.
La section « Plateformes d'observabilité des agents IA » a été étendue avec les raisons potentielles des différences de performance.
Le travail de Cem chez AIMultiple a été cité par des publications mondiales de premier plan, notamment Business Insider, Forbes, Morning Brew et Washington Post, par des entreprises mondiales comme Deloitte et HPE, par des ONG comme World Economic Forum et par des organisations supranationales comme European Commission. [1], [2], [3], [4], [5]
Tout au long de sa carrière, Cem a été consultant en technologies, acheteur de technologies et entrepreneur technologique. Il a conseillé des entreprises sur leurs décisions technologiques chez McKinsey & Company et Altman Solon pendant plus de dix ans. Il a également publié un rapport McKinsey sur la digitalisation.
Il a dirigé la stratégie technologique et les achats d'un opérateur télécom, sous la responsabilité du PDG. Il a également dirigé la croissance commerciale de l'entreprise de technologie profonde Hypatos, qui a atteint un revenu récurrent annuel à 7 chiffres et une valorisation à 9 chiffres, passant de 0 à ce résultat en deux ans. Le travail de Cem chez Hypatos a été couvert par des publications technologiques de premier plan comme TechCrunch et Business Insider.
Cem intervient régulièrement lors de conférences technologiques internationales. Il est diplômé de Bogazici University en tant qu'ingénieur informatique et titulaire d'un MBA de la Columbia Business School.





















Soyez le premier à commenter
Votre adresse courriel ne sera pas publiée. Tous les champs sont obligatoires. Les commentaires sont laissés dans leur langue d'origine.