


Modèles d'embedding: 25 modèles évalués pour la récupération
Nous avons évalué 25 modèles d'embedding sur 200 questions de récupération portant sur la finance, les contrats juridiques, le support technique et la littérature médicale. Les quatre corpus contenaient 341 040 passages de texte au total. Chaque requête interrogeait son propre domaine.
Résultats du benchmark des modèles d'embedding
Le nDCG@10 mesure à quel point les passages pertinents enregistrés apparaissent en bonne position parmi les dix premiers résultats. Les scores vont de 0 à 1, les valeurs plus élevées récompensant un meilleur classement.
Recall@10 mesure la part des passages pertinents enregistrés de chaque question récupérés dans les dix premiers résultats, moyennée sur les questions. La précision des réponses générées ne faisait pas partie de cette évaluation.
Les intervalles de confiance (IC) à 95 % estiment l'incertitude du nDCG@10 moyen due à l'échantillonnage des questions. Des intervalles plus larges indiquent des estimations moins précises.
Les questions ont été sélectionnées parce que BM25 a manqué les passages répondant à ces questions dans ses dix premiers résultats. Son score nul reflète cette sélection et limite les comparaisons avec la récupération par mots-clés sur le trafic ordinaire.
Résultats de récupération sur 25 modèles
Voyage 4 Large a enregistré le nDCG@10 le plus élevé, à 0.851
Son IC à 95 % était de 0.817–0.884. Des tests appariés n'ont trouvé aucune différence significative avec Cohere Embed 5 Pro, Cohere Embed 5 Fast, Gemini Embedding 2, Voyage 4 ou Gemini Embedding 001 après correction pour comparaisons multiples. Le classement reste incertain. Un résultat non significatif n'établit pas une performance égale.
Cohere Embed 5 Pro et Fast ont obtenu des scores significativement supérieurs à Embed v4.0
Pro a obtenu 0.850 et Fast 0.839, contre 0.772 pour Cohere Embed v4.0. Leurs gains de 0.078 et 0.067 de nDCG@10 étaient significatifs après correction sur l'ensemble des 300 paires de modèles. La différence de 0.010 entre Pro et Fast n'était pas significative.
Gemini Embedding 2 a enregistré le Recall@10 le plus élevé, à 96,50 %
Cohere Embed 5 Pro suit à 95,88 % et Voyage 4 à 95,83 %. Aucune différence par rapport à Gemini Embedding 2 n'était significative après correction. Faire passer un passage pertinent de la cinquième à la première place améliore le nDCG sans modifier le rappel.
PPLX Embed v1 4B a mené les modèles open-weight à 0.741 de nDCG@10
PPLX Embed v1 0.6B suit à 0.698. Le modèle 4B a obtenu un score significativement supérieur à neuf des dix autres modèles open-weight. Son écart par rapport à 0.6B n'était pas significatif. La comparaison des modèles d'embedding open source couvre ce sous-ensemble.
Résultats par domaine pour la finance, les contrats, le support et la médecine
Les six scores nDCG@10 les plus élevés dans chaque domaine. Chaque filtre reclasse les modèles évalués sur les 50 questions de ce domaine.
Chaque domaine contribue également à la moyenne globale. Cohere Embed 5 Fast a obtenu le meilleur score CUAD à 0.762, et Pro a obtenu le meilleur score TechQA à 0.894. MedRAG a produit le nDCG@10 le plus élevé de chaque modèle. Avec 50 questions par domaine, de petites différences entre ces scores restent incertaines.
Coût d'embedding et qualité de récupération
Nous avons calculé le coût d'API pour l'embedding des mêmes 341 040 passages et des 200 requêtes pour chaque modèle.
PPLX Embed v1 0.6B avait le coût d'embedding le plus bas, à $0,13, et a obtenu 0.698 de nDCG@10. Voyage 4 Lite coûtait $0,62 et a obtenu 0.793. À $1,87, Voyage 4 a atteint 0.829.
Cohere Embed 5 Fast coûtait $2,52 et a obtenu 0.839, tandis que Pro coûtait $3,40 et a obtenu 0.850. Le coût d'embedding de Fast était inférieur de 26 % sur cette charge de travail. La différence entre leurs scores de récupération n'était pas statistiquement significative après correction pour comparaisons multiples.
Voyage 4 Large coûtait $3,74 et a enregistré le score le plus élevé à 0.851. Gemini Embedding 2 avait le coût le plus élevé, à $6,68, et a obtenu 0.830. Dépenser davantage pour les embeddings n'a pas systématiquement produit un meilleur score de récupération dans ce test.
Les coûts couvrent les appels d'embedding réussis utilisés dans l'évaluation. Les totaux de Cohere utilisent les tokens d'entrée déclarés multipliés par le tarif enregistré. Le coût de $3,72 d'Embed v4.0 est une estimation car son tarif API direct n'a pas été vérifié. Les nouvelles tentatives, les diagnostics, les frais de compte, le stockage et le calcul de recherche sont exclus. Ces montants décrivent la charge de travail testée et les routes API. Les coûts de production dépendront du volume de texte, de la tokenisation et de la tarification des fournisseurs.
Comment les embeddings de texte soutiennent la récupération
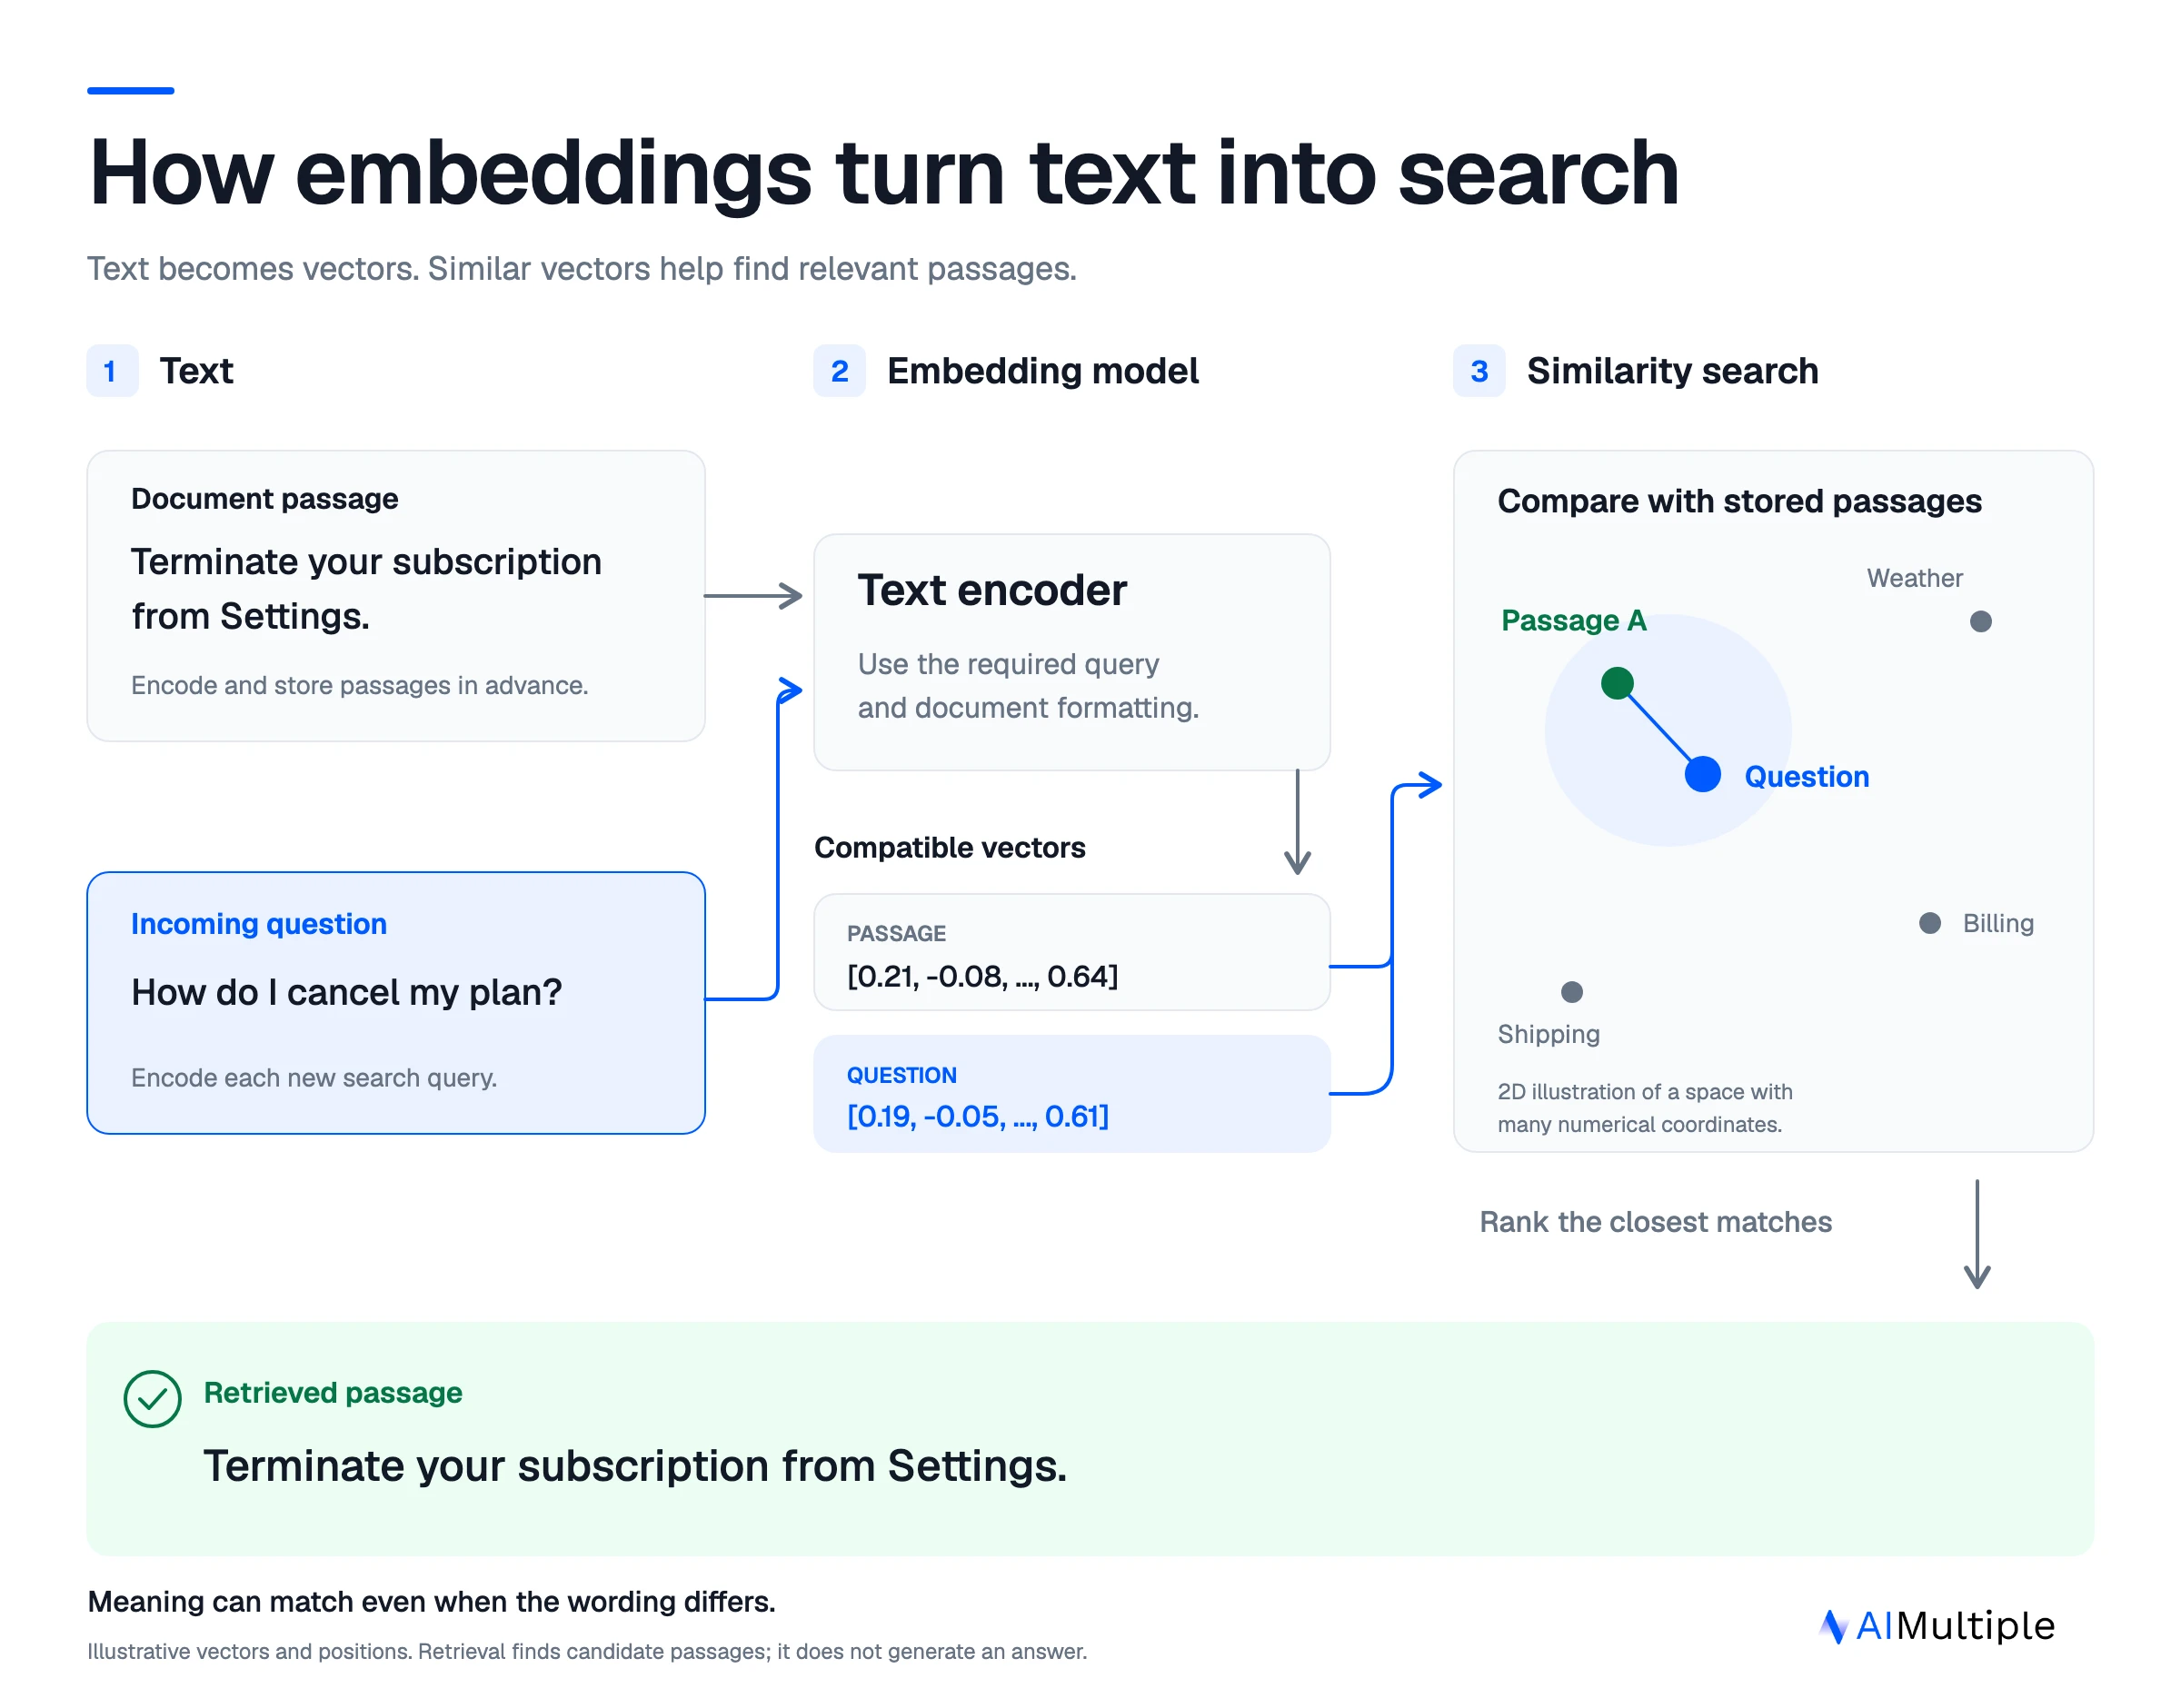
Un modèle d'embedding convertit le texte en vecteur, une liste de valeurs numériques pouvant être comparée à d'autres vecteurs issus d'un modèle compatible. En récupération sémantique, les passages de documents sont encodés à l'avance. Au moment de la recherche, le système encode la requête et classe les passages stockés par similarité vectorielle.1
Par exemple, une question sur l'annulation d'un forfait peut être proche d'un passage sur la résiliation d'un abonnement malgré une formulation différente. L'entraînement du modèle détermine les relations que les vecteurs préservent.2 Le diagramme compresse cette idée en deux dimensions. Les embeddings déployés contiennent généralement beaucoup plus de coordonnées.
Le formatage des requêtes et des documents importe également. Un modèle peut attendre des rôles ou des préfixes de récupération distincts même lorsque les deux sorties occupent un espace vectoriel compatible. Nous avons appliqué le formatage de requête et de document requis par chaque modèle.
Une base de données vectorielles stocke et recherche des vecteurs, tandis que le modèle d'embedding détermine les représentations recherchées. Les passages récupérés peuvent ensuite servir de contexte à un générateur de réponses. Ce benchmark s'arrête à la récupération des passages et ne note pas les réponses générées.
Méthodologie du benchmark des modèles d'embedding
Tous les modèles ont recherché les mêmes passages en utilisant les mêmes 200 questions et 225 paires question-passage pertinentes enregistrées. Les questions et les étiquettes ont été figées avant la comparaison des scores d'embedding. Les entrées de requête contenaient uniquement la question originale.
Les passages financiers provenaient des rapports annuels FinQA et les passages juridiques des contrats CUAD v1.34 Le support technique a utilisé les notes techniques TechQA, et la littérature médicale a utilisé un échantillon des résumés PubMed de MedRAG.56
Les passages étaient des paragraphes entiers, des tableaux avec contexte, des clauses contractuelles ou des résumés avec titres. Nous avons exclu les unités de plus de 256 tokens selon le tokenizer all-MiniLM-L6-v2. Les passages acceptés ont été conservés intacts, et les modèles à 512 tokens ont reçu au plus 459 tokens par passage. Ce benchmark évalue donc des passages courts.
Des LLM de pointe ont rédigé les questions à partir des passages sources. Un membre de l'équipe a vérifié 20 % des questions (40 sur 200). Les LLM ont également jugé les 20 meilleurs passages BM25 par question, ajoutant 25 passages pertinents aux 200 passages sources d'origine.
Analyse de la récupération et statistique
La récupération a comparé chaque requête à chaque passage de son domaine. Nous avons utilisé la similarité cosinus pour 21 modèles et le produit scalaire pour MultiQA MPNet Base Dot v1. BGE-M3 a utilisé ses vecteurs denses.7 Les entrées de requête et de document utilisaient les rôles ou préfixes de récupération configurés pour chaque modèle.
Les deux métriques sont des moyennes sur les questions. Nous avons calculé les IC à 95 % avec 10 000 échantillons bootstrap, en rééchantillonnant 50 questions dans chaque domaine. Les comparaisons par paires ont utilisé des tests de signe appariés avec correction de Holm sur l'ensemble des 231 paires de modèles pour chaque métrique et chaque portée. Nous avons considéré les différences comme significatives à une valeur p corrigée inférieure à 0.05.
ID des modèles testés, dimensions et limites d'entrée
Les 22 modèles d'origine ont été exécutés via OpenRouter, avec un fournisseur backend fixe par modèle et les fallbacks désactivés. Les trois modèles Cohere ont été exécutés via l'API Cohere en utilisant les rôles natifs de document et de requête (search_document et search_query). Le tableau indique les identifiants API, les dimensions de sortie et les limites d'entrée utilisées, y compris des bornes prudentes.
Les identifiants API ne garantissent pas un instantané immuable du modèle. Les révisions du tokenizer ont été épinglées lorsque cela était possible. Les poids des modèles hébergés n'ont pas été vérifiés de manière indépendante. Les longueurs d'entrée de Gemini et de Cohere ont été vérifiées à l'aide d'estimations prudentes. Les passages courts n'ont pas testé la récupération à long contexte.
 Ajouter comme source préférée
Périmètre et limites
Les questions forment un ensemble de développement sélectionné par BM25. Les résultats sur des requêtes de production ordinaires peuvent différer. Les jugements de pertinence se limitaient aux passages sources et aux 20 meilleurs passages selon BM25. Sur l'ensemble des 25 modèles, 87 % des paires question-passage distinctes récupérées dans le top dix n'ont pas été jugées et n'ont reçu aucun crédit de pertinence.
Chaque modèle n'a été exécuté qu'une seule fois. Les IC reflètent l'échantillonnage des questions et excluent la variation entre les exécutions d'API ou l'incertitude liée à des étiquettes incomplètes. La contamination par les données d'entraînement n'a pas été testée.
Cette évaluation couvre la récupération de texte. La précision des réponses générées, la récupération hybride, le reranking, la latence et le coût de service étaient hors de son périmètre. Le benchmark des rerankers, la comparaison des embeddings multilingues et la comparaison des embeddings multimodaux couvrent des charges de travail distinctes.
Conclusion
Voyage 4 Large a enregistré le nDCG@10 le plus élevé, sans écart significatif par rapport à Cohere Embed 5 Pro ou Fast. Les deux modèles Cohere ont obtenu des scores significativement supérieurs à Embed v4.0. Gemini Embedding 2 a mené le rappel, et PPLX Embed v1 4B a mené le groupe open-weight.
Utilisez les résultats par domaine pour choisir des candidats, puis comparez-les sur des requêtes représentatives avec des étiquettes de pertinence révisées. Mesurez séparément la latence et le coût de service de bout en bout.
Pour aller plus loin
- Benchmark des modèles d'embedding open source
- Modèles d'embedding multilingues pour le RAG
- Modèles d'embedding multimodaux
- Benchmark des bases de données vectorielles open source
Citez ce benchmark
Choisissez le format qui correspond à votre lieu de publication. Coller la version avec lien dans votre CMS préserve le lien retour.
@misc{sari2026,
  author = {Sarı, Ekrem},
  title  = {{Modèles d'embedding: 25 modèles évalués pour la récupération}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/embedding-models}},
  note   = {AIMultiple. Consulté le 1 octobre 2026}
}Résultats et horodatages de 180 points de données. Téléchargez les données de synthèse présentées dans les graphiques et les tableaux de cet article sous forme de fichier ZIP contenant 8 fichiers CSV et un README.
Vous voulez les données détaillées derrière ? Rejoindre Premium
Journal des modifications
5 mises à jourAjout de la définition de la métrique Top-1 hit à la méthodologie du benchmark d'embeddings.
Remplacé le benchmark par 15 modèles et une référence BM25 testés sur des corpus juridiques, de support client et de santé.
Liens de référence





Soyez le premier à commenter
Votre adresse courriel ne sera pas publiée. Tous les champs sont obligatoires. Les commentaires sont laissés dans leur langue d'origine.