


Top 3 des générateurs de documents synthétiques comparés

Les générateurs de documents synthétiques créent des images de documents annotées et réalistes qui aident à entraîner et évaluer des modèles d'apprentissage automatique sans dépendre de grands jeux de données étiquetés manuellement.
Nous évaluons 3 générateurs de documents synthétiques, Genalog, DocCreator et Tonic Textual, en créant plus de 2 500 documents synthétiques, en comparant leur efficacité en matière de mises en page réalistes, de données numériques précises et de jeux de données d'entraînement pour les tâches d'analyse de documents.
Résultats du comparatif de génération de documents
Les résultats montrent que
- Genalog et DocCreator sont de bons performants en termes d'utilité et de fidélité, Genalog étant légèrement meilleur en précision numérique.
- Tonic Textual excelle en réalisme de mise en page visuelle mais est en retrait dans d'autres domaines, ce qui le rend plus adapté aux tâches nécessitant des documents réalistes.
Pour plus d'informations sur les métriques, consultez la méthodologie du comparatif.
- Utilité mesure dans quelle mesure les modèles entraînés sur des données synthétiques sont performants sur des documents réels.
- Fidélité de mise en page mesure dans quelle mesure l'agencement spatial des éléments dans les documents synthétiques correspond à celui des documents réels.
- Fidélité numérique vérifie si les valeurs numériques des documents synthétiques ressemblent aux données réelles.
Commentaire sur les résultats : Pour mieux comprendre les différences de performance, le comparatif a également été réalisé en utilisant le jeu d'entraînement au lieu du jeu de test séparé. Cette évaluation secondaire visait à déterminer si fournir aux modèles du matériel d'entraînement améliorerait leur capacité à reproduire des sorties structurées et numériquement précises.
Les résultats montrent que, même lorsqu'ils sont évalués sur les données d'entraînement, les modèles obtiennent des scores légèrement plus élevés. Cela indique que les résultats reflètent la capacité des outils à traiter la tâche elle-même. Les résultats modérés sont probablement influencés par les limitations de la qualité de l'OCR et de la capacité du modèle entraîné, plutôt que par la procédure de comparatif elle-même.
Genalog
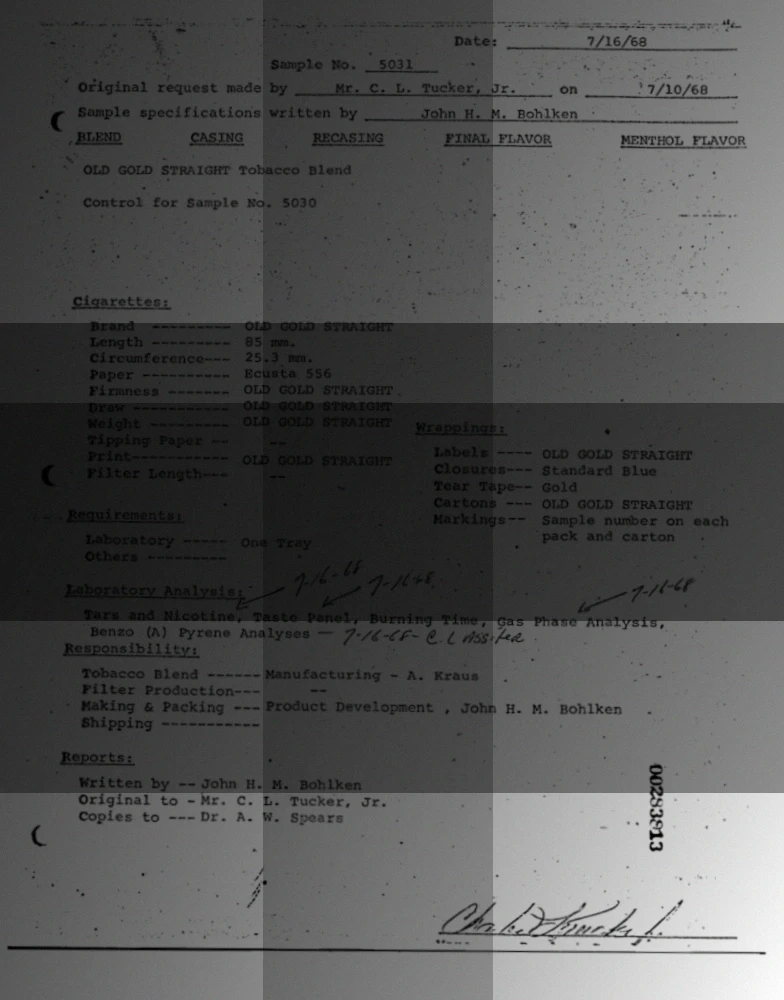
Genalog a obtenu les meilleurs résultats globaux. Ses documents synthétiques se sont révélés efficaces pour l'entraînement de modèles et ont maintenu un bon équilibre entre des éléments de mise en page réalistes et la précision numérique. Les documents générés reflétaient fidèlement la structure et l'espacement des formulaires et reçus réels, ce qui les rend adaptés à une variété de tâches d'analyse de documents.
DocCreator
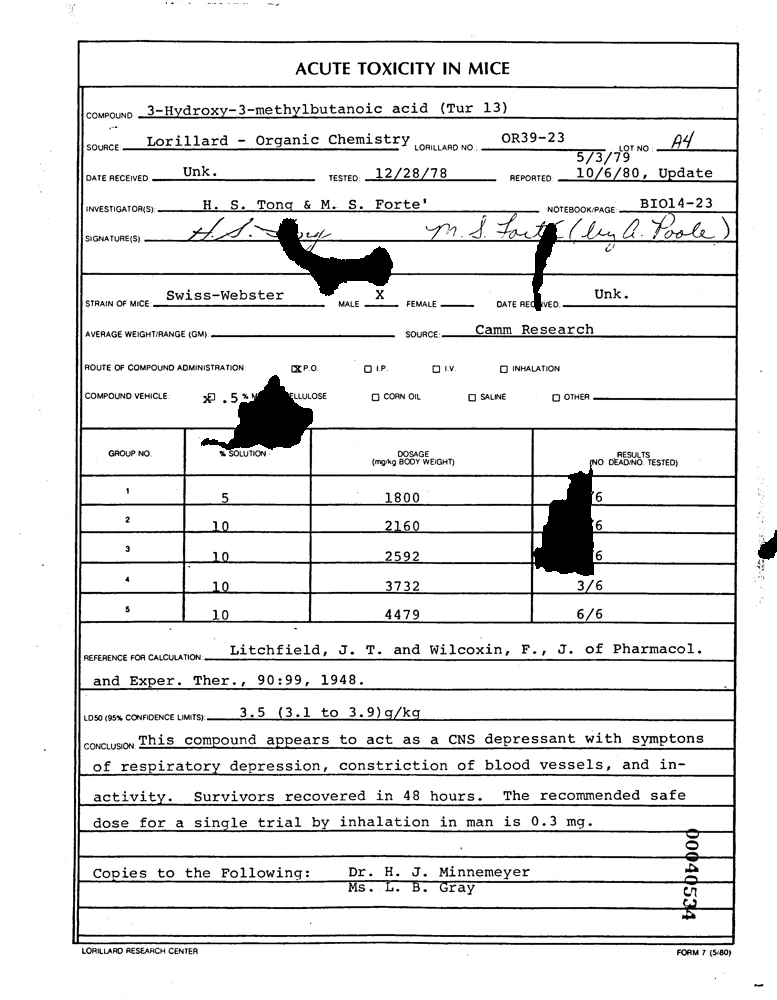
DocCreator a également produit des résultats de haute qualité. Les documents de ce générateur de documents étaient presque aussi utiles pour l'entraînement que ceux de Genalog. Les mises en page étaient réalistes et les documents synthétiques préservaient les propriétés statistiques des nombres. La force de DocCreator réside dans la combinaison d'une génération de mises en page diversifiées avec ses modèles de dégradation, ce qui rend les résultats visuellement similaires à des documents réels numérisés.
Tonic Textual

Tonic Textual a obtenu des résultats mitigés. Bien que ce générateur de documents synthétiques produise des mises en page propres et cohérentes, les documents étaient moins efficaces pour l'entraînement des modèles. De plus, les nombres synthétiques n'étaient pas toujours statistiquement similaires aux données réelles. Cela suggère que Tonic Textual est plus adapté aux tâches axées sur l'apparence des documents ou le remplacement d'informations personnelles (PII) préservant la confidentialité, plutôt qu'à un entraînement à grande échelle pour la structure de mise en page et les tâches d'extraction d'informations.
En mars 2026, Tonic Textual a remplacé son composant de liaison d'entités d'un modèle basé sur LLM par un modèle basé sur BERT afin d'améliorer le débit.1 La même version (v391) a également ajouté un filtrage et un tri améliorés sur la page Datasets.1
Aperçu global
Genalog est l'outil le plus équilibré, offrant à la fois des mises en page réalistes et des nombres précis.
DocCreator est performant pour les mises en page complexes et diverses et la dégradation de documents, avec de légères inexactitudes numériques.
Tonic Textual est idéal pour les tâches axées sur la mise en page, mais pas pour les tâches nécessitant des données numériques précises.
Aperçu de la méthodologie
Métriques d'évaluation
Chaque jeu de données généré a été évalué par rapport aux données d'origine à l'aide des métriques suivantes :
Score d'utilité
(Score F1 KIE) : Un score compris entre 0 et 1, où plus il est élevé, mieux c'est. Il est défini par le score F1 du modèle LayoutLMv3 entraîné sur les données synthétiques lorsqu'il est évalué sur le jeu de test réel. Un score élevé indique que les données synthétiques constituent un substitut très efficace aux données réelles.
Scores de fidélité
Ces métriques mesurent à quel point les documents synthétiques ressemblent aux documents réels.
- Fidélité de mise en page (score EMD) : La distance Earth Mover’s Distance (dEMD) mesure la différence entre la distribution des points centraux des boîtes englobantes dans les documents réels et synthétiques. C'est une valeur comprise entre 0 et 1, où plus il est faible, mieux c'est. Un score faible signifie que les éléments de mise en page spatiale sont bien préservés.
- Fidélité numérique (distance K-S) : La distance de Kolmogorov-Smirnov (DKS) mesure la différence maximale entre les fonctions de répartition (CDF) des valeurs numériques (par exemple, prix, quantités) dans les données réelles et synthétiques. Elle varie de 0 à 1, où plus il est faible, mieux c'est. Un score faible signifie que le générateur reproduit fidèlement les propriétés statistiques des nombres.
Toutes les métriques ont été normalisées pendant le calcul.
Jeux de données
FUNSD : un ensemble de 199 formulaires numérisés caractérisés par un texte bruité, des mises en page complexes et diverses, et des annotations manuscrites. Il a été téléchargé plus de 1 500 fois le mois dernier. Cela teste la capacité d'un générateur à traiter des données non structurées et imparfaites. 2
- Nous divisons l'échantillon en deux : 80 % des données sont utilisées pour entraîner le modèle, tandis que les 20 % restants sont réservés aux tests après l'entraînement.
- Chaque outil a produit entre trois et six documents synthétiques pour chaque original, ce qui donne un total de plus de 2 500 documents synthétiques.
Évaluation de la tâche
Pour mesurer l'utilité, un modèle populaire LayoutLMv3 avec 22K étoiles GitHub et plus de 750K téléchargements a été entraîné sur les données synthétiques générées par chaque outil de génération de documents synthétiques. 3
La performance de ce modèle a ensuite été évaluée sur un jeu de test distinct de documents réels provenant des jeux de données d'origine. Cela mesure directement l'utilité des données synthétiques pour une tâche du monde réel.
Outils de génération synthétique
Genalog
Une bibliothèque Python open source de Microsoft pour générer des images de documents synthétiques avec du bruit synthétique. Elle fonctionne en prenant des modèles de texte et de mise en page (écrits en HTML + CSS) et en les rendant via WeasyPrint, puis en appliquant des effets de dégradation (flou, transpercement, bruit sel et poivre, opérations morphologiques).4
DocCreator
Un outil open source multiplateforme pour générer des images de documents synthétiques avec la vérité terrain associée. Il a été largement utilisé dans la recherche en analyse et reconnaissance d'images de documents (DIAR).5,6
Tonic Textual
Une solution de suppression et de synthèse dans des formats de documents du monde réel (PDF, Word). Elle prétend analyser des documents non structurés, identifier des entités nommées (par exemple, les informations personnelles identifiables, PII), les masquer ou les remplacer par des valeurs synthétiques, et produire des documents dé-identifiés dans des formats similaires.
8 méthodes de dégradation de documents synthétiques
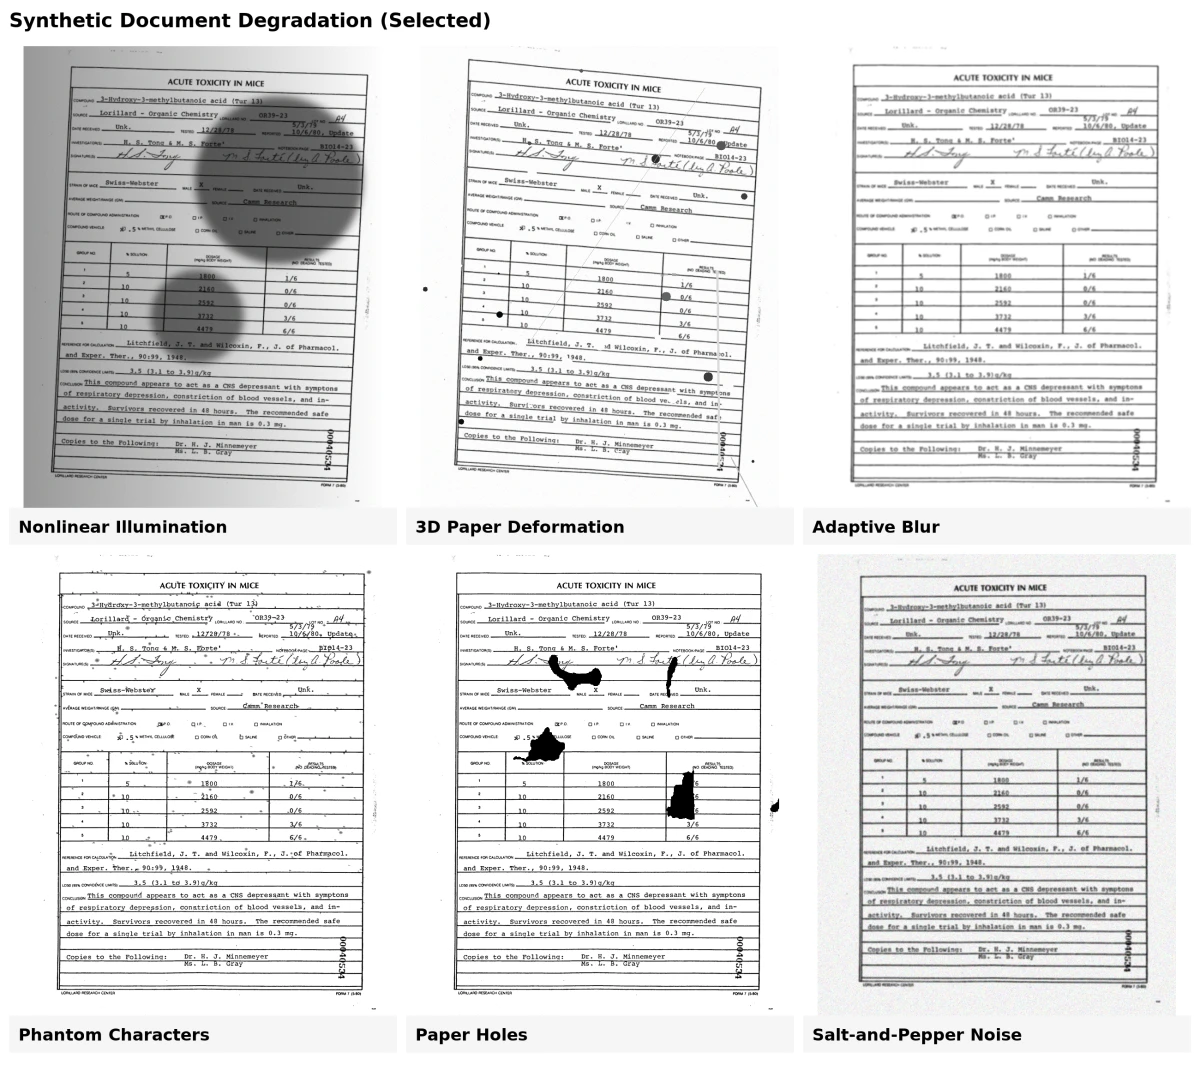
La génération de documents synthétiques inclut souvent l'ajout de défauts réalistes pour rendre les données artificielles similaires à des documents réels. Ces défauts, ou modèles de dégradation, aident à entraîner des modèles plus performants sur des documents bruités, anciens ou numérisés. Ces outils appliquent plusieurs transformations physiques et visuelles pour simuler les imperfections courantes des documents.6
1. Dégradation de l'encre
Ce modèle simule la décoloration, les taches ou les traînées causées par le vieillissement ou une impression de mauvaise qualité. Il ajoute de petites taches d'encre ou retire des parties de lettres pour imiter la dégradation réelle de l'encre.
2. Caractères fantômes
Les anciens outils d'impression laissaient souvent de légers contours ou des marques « fantômes » autour des lettres. Le modèle de caractères fantômes les recrée en insérant des défauts extraits de numérisations réelles entre les caractères imprimés.
3. Trous dans le papier
Des trous de formes et de tailles différentes sont ajoutés aléatoirement aux documents, reproduisant les déchirures ou les marques de perforation visibles sur les papiers usés.
4. Transpercement
Cet effet imite l'encre qui traverse depuis l'autre côté de la page. Il utilise à la fois les images recto et verso d'un document pour recréer la manière dont l'encre se transfère partiellement à travers le papier.
5. Flou adaptatif
La numérisation ou la photographie de documents crée souvent un léger flou. Ce modèle compare des exemples flous réels et applique un flou similaire à l'aide de filtres gaussiens, en gardant le résultat subtil et réaliste.
6. 3D déformation du papier
Les documents peuvent se plier, se replier ou se courber lorsqu'ils sont numérisés ou photographiés. En utilisant des maillages 3D issus de papiers réels, ce modèle recrée ces formes et effets d'éclairage, aidant à entraîner des modèles pour l'analyse de documents basée sur caméra.
7. Éclairage non linéaire
Un éclairage inégal pendant la numérisation peut rendre un côté d'un document plus sombre. Ce modèle ajuste la luminosité en fonction d'angles d'éclairage simulés et de la courbure de la page, reproduisant l'effet d'un mauvais éclairage.
8. Bruit sel et poivre
Ajoute des pixels noirs et blancs aléatoires pour simuler la poussière, la texture du papier ou le bruit du capteur de numérisation. Cet effet « sel et poivre » aide à créer l'aspect granuleux des numérisations numériques anciennes ou de mauvaise qualité.
 Ajouter comme source préférée
La génération de documents synthétiques comme solution aux défis de l'analyse de la mise en page
Le défi de l'analyse de la mise en page
Comprendre la structure des documents est plus difficile que lire le texte. Les outils d'OCR peuvent extract des mots, mais ils n'expliquent pas le rôle de chaque bloc, tel que les titres, les tableaux ou les figures.
Pour relever ce défi, des méthodes ont été développées :
Les premières méthodes d'analyse de la mise en page étaient basées sur des règles. Elles s'appuyaient sur des règles géométriques et l'analyse de texture pour diviser les pages en blocs. Bien qu'utiles, ces approches nécessitaient un réglage manuel important et ne généralisaient pas bien.
Les approches d'apprentissage automatique telles que les machines à vecteurs de support (SVM) et les modèles de mélange gaussien (GMM) ont amélioré cela en apprenant à partir des données.7 Cependant, elles dépendaient encore de caractéristiques manuelles et peinaient face à la diversité des documents du monde réel.
L'apprentissage profond a transformé le domaine. Les réseaux de neurones convolutifs (CNN) ont permis de traiter la reconnaissance de mise en page comme la détection d'objets, en identifiant des tableaux, des figures ou des formules de la même manière que les modèles détectent des objets dans des images naturelles.8 Certains modèles combinent également des caractéristiques textuelles et visuelles pour des résultats plus précis.
Le défi de l'apprentissage profond : nécessite de grands jeux de données étiquetés pour l'entraînement.
Les données synthétiques comme solution : le processus de génération de documents synthétiques offre un moyen évolutif de créer des données d'entraînement annotées sans le coût de l'étiquetage manuel.
Les modèles génératifs apportent désormais des possibilités plus avancées. Les autoencodeurs variationnels (VAE), les modèles basés sur l'attention et les GAN peuvent apprendre les schémas structurels des documents et produire de nouvelles mises en page réalistes.9
Principales différences entre les générateurs de documents synthétiques
Les trois générateurs de documents synthétiques comparés diffèrent par leur orientation, la qualité de leurs résultats et leur facilité d'utilisation :
- Genalog : Le meilleur équilibre entre des mises en page réalistes et la précision numérique. Son flux de travail basé sur Python avec des modèles HTML/CSS et des modèles de dégradation le rend idéal pour entraîner des modèles d'apprentissage automatique sur diverses tâches d'analyse de documents.
- DocCreator : Performant pour générer des documents visuellement complexes et dégradés, en préservant la diversité des mises en page. Légèrement moins précis numériquement que Genalog, mais efficace pour les tâches nécessitant une simulation réaliste de documents numérisés.
- Tonic Textual : Excelle dans les mises en page propres et visuellement cohérentes et la synthèse de données préservant la confidentialité. Moins adapté à la précision numérique ou aux jeux de données d'entraînement complets, ce qui le rend meilleur pour les tâches axées sur la mise en page ou le remplacement d'informations personnelles (PII).
Ces différences reflètent leurs approches principales : Genalog équilibre réalisme et fidélité des données, DocCreator met l'accent sur la variété des mises en page et la dégradation des documents, et Tonic Textual privilégie l'apparence et la confidentialité. Cela aide les utilisateurs à choisir le bon outil selon que la priorité est l'efficacité de l'entraînement, le réalisme de la mise en page ou la dé-identification des données.
Autres générateurs de documents synthétiques couramment utilisés
YData SDK : propose un générateur de documents synthétiques capable de produire des documents synthétiques de haute qualité aux formats PDF, DOCX ou HTML, souvent utilisé pour contourner les obstacles de conformité en matière de confidentialité.10
DoGe : un outil open source spécialement conçu pour synthétiser des numérisations de documents réalistes avec du texte significatif, des titres et des tableaux pour l'entraînement de Document IA.11
DocXPand : spécialisé dans la génération de documents d'identité (passeports, cartes d'identité) basés sur les normes ISO, en remplissant des modèles avec de fausses informations et des visages générés par l'IA.12
Lectures complémentaires
- Benchmark de génération de données synthétiques & bonnes pratiques
- Top 25 des cas d'utilisation des données synthétiques
- Utilisateurs synthétiques expliqués : Top 7 des outils de recherche utilisateur basés sur l'IA
Citez ce benchmark
Choisissez le format qui correspond à votre lieu de publication. Coller la version avec lien dans votre CMS préserve le lien retour.
@misc{arslan2026,
  author = {Arslan, Ezgi},
  title  = {{Top 3 des générateurs de documents synthétiques comparés}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/synthetic-document-generator}},
  note   = {AIMultiple. Consulté le 3 juin 2026}
}Résultats et horodatages de 9 points de données. Téléchargez les données de synthèse présentées dans les graphiques et les tableaux de cet article sous forme de fichier ZIP contenant 3 fichiers CSV.
Vous voulez les données détaillées derrière ? Rejoindre Premium
Journal des modifications
2 mises à jourL'introduction a été enrichie avec des noms de produits spécifiques.
Liens de référence
À lire ensuite
Top 10 générateurs de documents Word IA: évalués et testés

Meilleurs outils de génération de documents IA
Utilisateurs synthétiques expliqués: Top 7 des outils de recherche utilisateur IA



Soyez le premier à commenter
Votre adresse courriel ne sera pas publiée. Tous les champs sont obligatoires. Les commentaires sont laissés dans leur langue d'origine.