


Top 6 Open-Source-Log-Analyse-Tools: Wazuh, Graylog & mehr
Als CISO in einer stark regulierten Branche mit rund zwei Jahrzehnten Erfahrung im Bereich Cybersicherheit habe ich mit mehreren SIEM-ähnlichen Log-Analyse-Plattformen gearbeitet. Aus diesen habe ich die Top 6 Open-Source-Log-Analyse-Tools ausgewählt. Bei der Bewertung dieser Tools habe ich mich auf Schlüsselfaktoren wie Flexibilität bei der Log-Sammlung, Echtzeit-Ereigniserkennung, Skalierbarkeit und Unterstützung verschiedener Log-Formate konzentriert.
Log-Management- und Erkennungsfunktionen
Integritäts- und Nichtabstreitbarkeitsfunktionen
Preisgestaltung von Log-Analyse-Tools
Wazuh
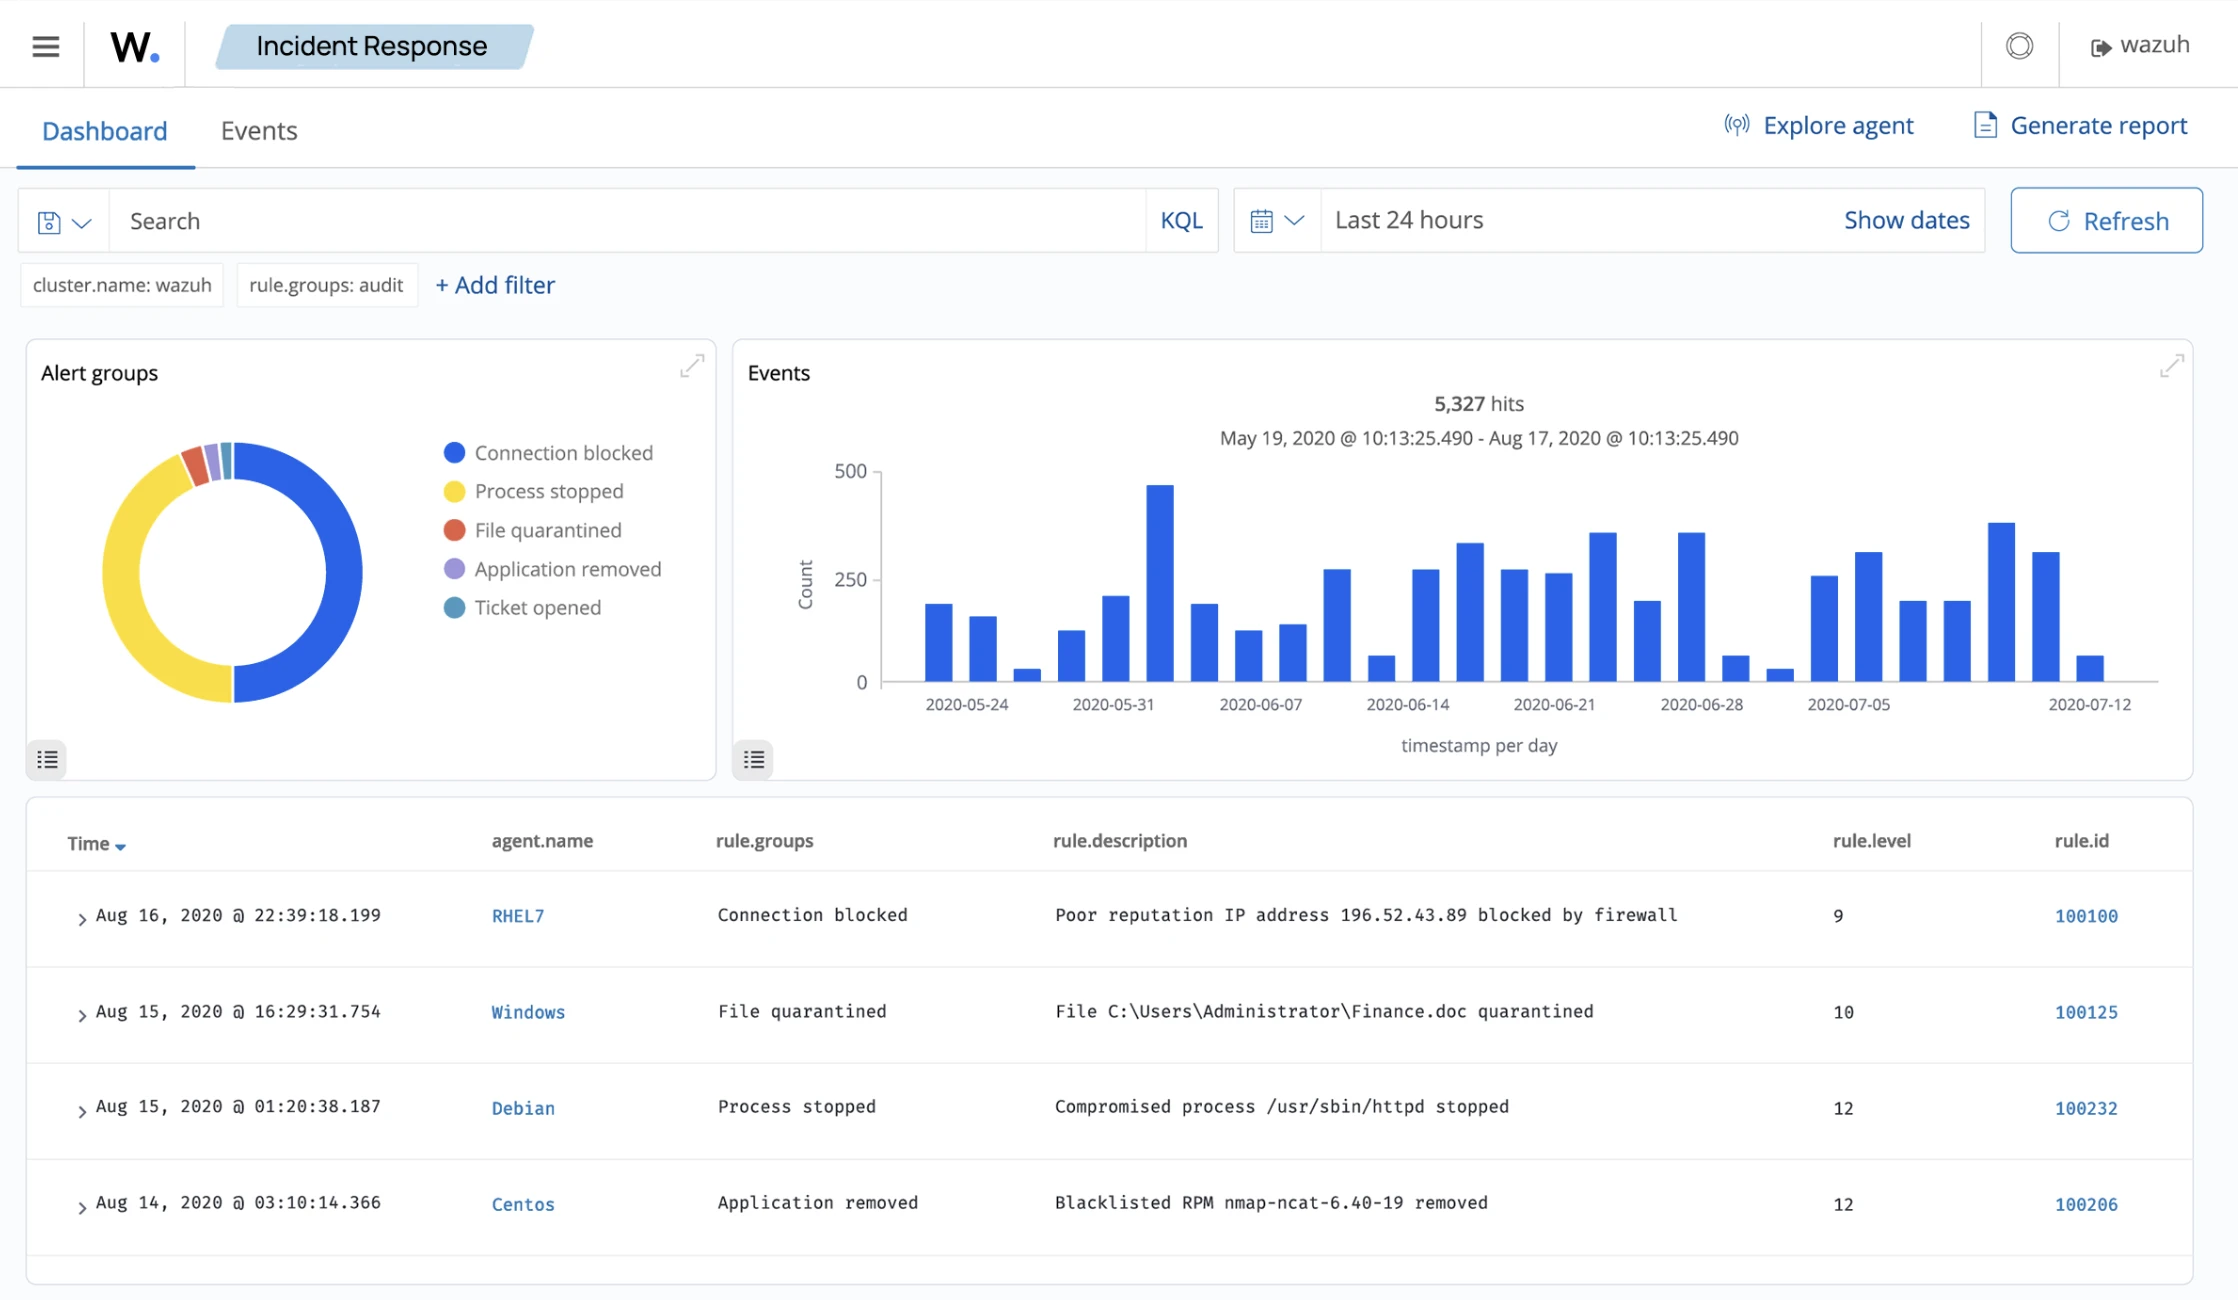
Wazuh ist ein Open-Source-SIEM, das weiter geht als die meisten Tools in dieser Kategorie. Es vereint Protokollüberwachung, Endpoint-Sicherheit, Dateiintegritätsüberwachung, Schwachstellenerkennung und Echtzeit-Erkennung von Sicherheitsereignissen in einer einzigen agentenbasierten Plattform.
So funktioniert das Log-Management in Wazuh
Ein Endpoint-Agent, der auf jedem überwachten System bereitgestellt wird, sammelt Protokolle lokal und leitet sie zur Verarbeitung und Analyse an den Wazuh-Management-Server weiter. Der Agent übernimmt die Protokollsammlung, Integritätsüberwachung und aktive Reaktion lokal. Wazuh integriert sich nativ in den Elastic Stack und verwendet Elasticsearch für die Protokollspeicherung und -suche sowie Kibana (über das Wazuh-Plugin) für Dashboards und Untersuchungen.
Die Regel-Engine läuft auf dem Manager und bewertet eingehende Protokollereignisse anhand eines Regelsatzes, der Standardregeln, CIS-Benchmarks, MITRE ATT&CK-Zuordnungen und alle von Ihnen geschriebenen benutzerdefinierten Regeln umfasst. Wenn eine Regel ausgelöst wird, generiert Wazuh eine Warnung und kann, sofern eine aktive Reaktion konfiguriert ist, automatisch auf dem Endpoint Maßnahmen ergreifen: eine IP blockieren, einen Prozess beenden oder eine Datei unter Quarantäne stellen.
Hosting-Optionen:
- Selbst gehostet: Die Plattform ist kostenlos zum Herunterladen und Verwenden. Optionaler jährlicher Support wird basierend auf der Anzahl der überwachten Endpoints (Server, Workstations und Netzwerkgeräte) bepreist. Die Organisation ist in diesem Modell für die Wartung von Hardware und Ressourcen verantwortlich.
- Cloud-gehostet: Der Hosting-Anbieter verwaltet den Wazuh-Server und den Elastic Stack; Sie müssen Agents bereitstellen. Die Preisgestaltung hängt von den indexierten Daten (früher als Hot Storage bezeichnet) und der gewählten Aufbewahrungsdauer ab.
Herausragende Funktionen:
- Flexible Protokollsammlung: Wazuh nimmt Protokolle aus der Windows-Ereignisanzeige, Linux-Systemmeldungen, JSON-formatierten Anwendungsprotokollen und einer Vielzahl von Quellentypen ohne zusätzliche Plugins auf. Die Out-of-the-Box-Abdeckung ist breiter als bei Graylog oder Logstash, die mehr Konfiguration erfordern, um denselben Umfang zu erreichen.
- MITRE ATT&CK-Zuordnung: Regeln werden standardmäßig den MITRE ATT&CK-Techniken zugeordnet, sodass Warnungen nicht nur mitteilen, was passiert ist, sondern auch, wo es in eine Angriffskette passt. Dies ist für die Triage wichtig; Sie können den Unterschied zwischen einer verrauschten Authentifizierungsfehlermeldung und einem Credential-Stuffing-Versuch erkennen, ohne eine benutzerdefinierte Korrelation zu schreiben.
- Integrationen von Drittanbietern: Native Integrationen mit Office 365, AWS, GCP, Azure und Rapid7. Eine integrierte Python-Bibliothek unterstützt benutzerdefinierte Integrationen ohne die Plugin-Konfiguration, die Syslog-ng oder Fluentd erfordern.
- API und aktive Reaktion: Eine RESTful API deckt Protokollabfragen, Regel- und Decoder-Verwaltung, Warnungsabfragen und Agenteninteraktionen ab. Die Funktion für aktive Reaktion führt auf dem überwachten Endpoint bei Warnungen Skripte aus – Blockieren von IP-Adressen, Beenden von Prozessen, Isolieren von Hosts. Dies ist im Elastic Stack ohne zusätzliche Tools nicht verfügbar.
Graylog
Graylog ist eine Log-Management-Plattform mit einem quelloffenen Kern (Graylog Open) und kostenpflichtigen Editionen, die sich auf Security Operations erstrecken. Dieser Unterschied ist wichtiger, als die meisten Anbieterbeschreibungen vermuten lassen: Graylog Open bietet Protokollsammlung, Suche, Verarbeitungs-Pipelines, Dashboards und streambasierte Warnmeldungen – genug für betriebliche Anwendungsfälle. Sigma-Regeln, MITRE ATT&CK-Abgleich, UEBA, Anomalieerkennung und Fallverwaltung sind kostenpflichtige Features von Graylog Security und Graylog Enterprise. Wenn Ihr primärer Anwendungsfall Security Operations statt Infrastrukturüberwachung ist, sollten Sie das in die Kostenkalkulation einbeziehen.
So funktioniert Graylog
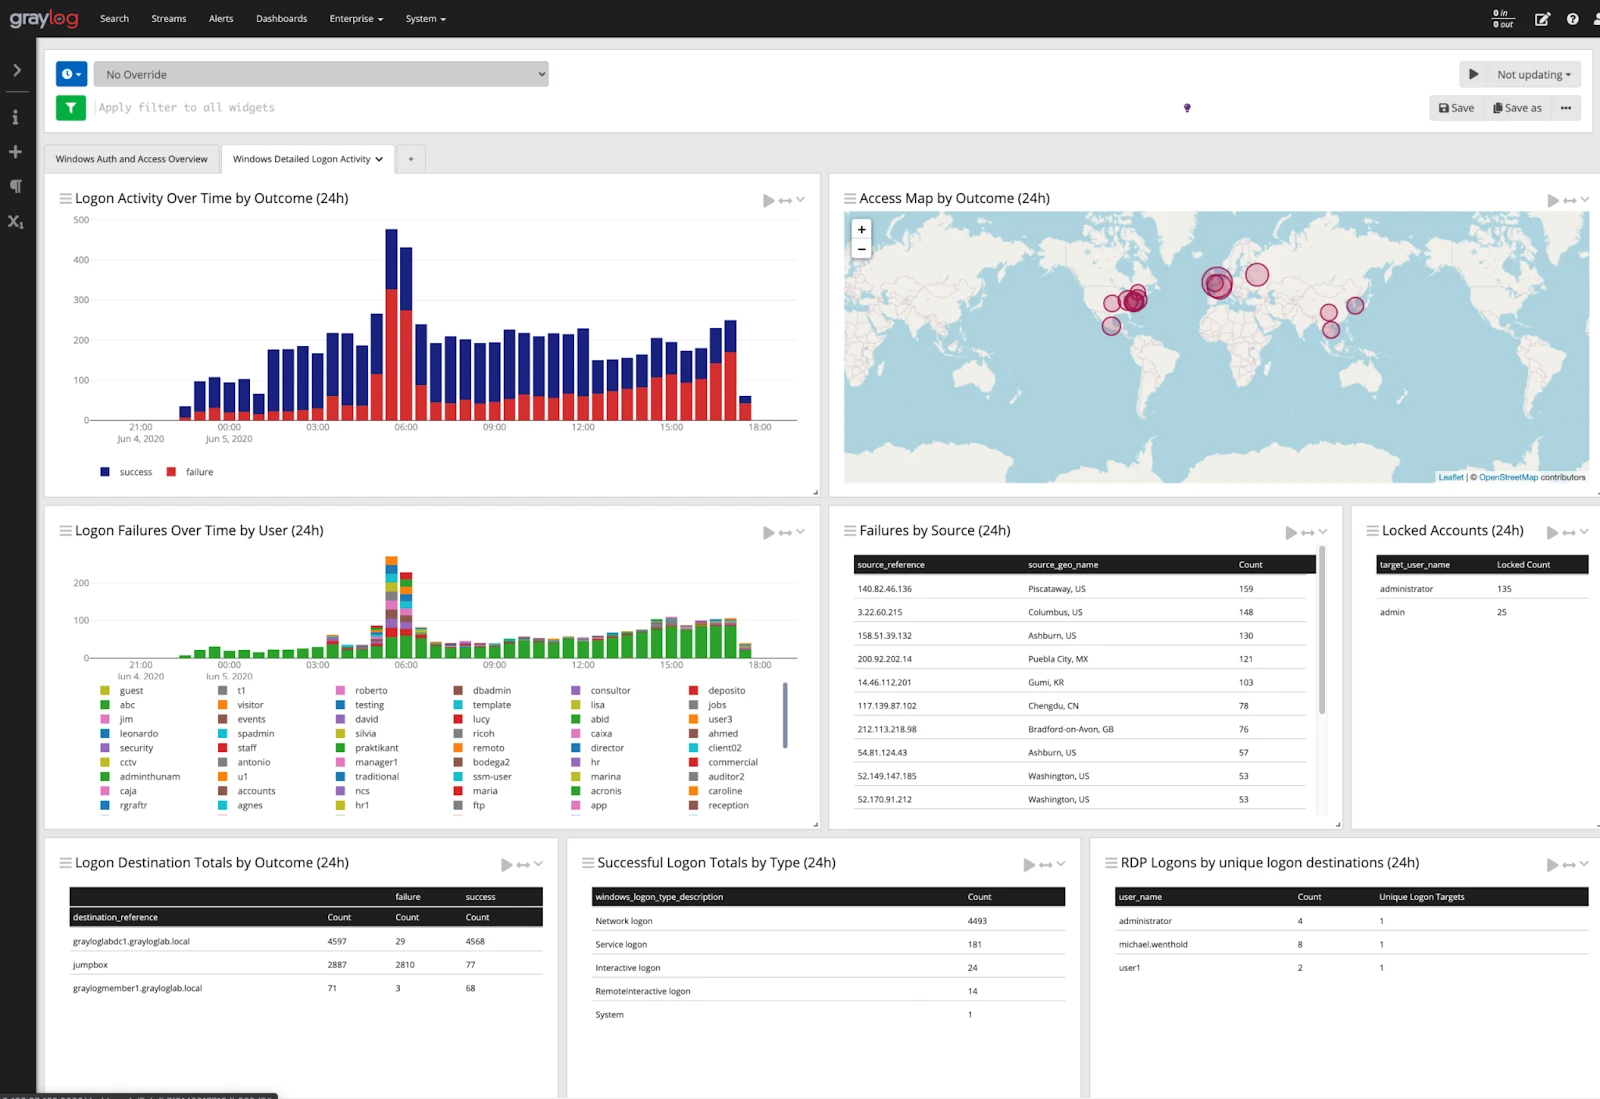
Graylog empfängt Logdaten über GELF (Graylog Extended Log Format), Syslog, Beats oder HTTP-Inputs, speichert sie in Elasticsearch oder OpenSearch (über den Graylog Data Node) und macht sie über eine Webschnittstelle durchsuchbar. Das Stream-System ist zentral für die Funktionsweise von Graylog: Eingehende Nachrichten werden basierend auf Regeln an Streams weitergeleitet, und Warnmeldungen, Pipelines und Zugriffskontrollen sind alle an Streams und nicht an die Speicherschicht gebunden. Das bedeutet, Sie können einen Stream für Anwendungsfehler an ein Team und einen separaten Stream für Authentifizierungsereignisse an die Sicherheit weiterleiten, jeweils mit unterschiedlichen Aufbewahrungsrichtlinien und Berechtigungen.
Verarbeitungs-Pipelines ermöglichen es Ihnen, Nachrichten vor der Speicherung zu parsen, anzureichern, zu verwerfen oder neu zu schreiben. Wenn Ihre Anwendungsprotokolle als unstrukturierter Text ankommen, schreiben Sie eine Pipeline-Regel, um Felder in strukturierte Daten zu extrahieren. Graylog Illuminate (in den kostenpflichtigen Editionen enthalten, für Open mit Einschränkungen verfügbar) bietet vorgefertigte Parser und Dashboards für gängige Quellen: Windows-Ereignisprotokolle, Cisco, Palo Alto, AWS CloudTrail und andere.
- Mindestversion des Kafka-Brokers ist 2.1. Jeder Kafka-Input, der mit einem älteren Broker verbunden ist, wird nach dem Upgrade fehlschlagen.
- API-Tokens laufen jetzt standardmäßig nach 30 Tagen ab. Jede Automatisierung, Überwachungsintegration oder jedes Skript, das ein langlebiges API-Token verwendet, funktioniert nicht mehr, sofern Sie keine Richtlinie zur Token-Rotation eingerichtet haben. Dies tritt tendenziell eher als nächtlicher Vorfall auf, wenn etwas nicht mehr meldet, und nicht während des Upgrades selbst.
Herausragende Funktionen:
- Streambasiertes Routing und Verarbeitung: Das Stream-Modell ermöglicht es Ihnen, Logdaten bereits bei der Aufnahme nach Quelle, Anwendung oder Vertraulichkeitsstufe zu segmentieren und anschließend unterschiedliche Pipelines, Aufbewahrungsrichtlinien und Zugriffskontrollen pro Stream anzuwenden. Dies ist operativ flexibler als Elasticsearch-Muster mit einem Index pro Quelle.
- Protokollextraktion und -parsing: Extractors ziehen bei der Aufnahme bestimmte Felder aus Protokollmeldungen. Verarbeitungs-Pipelines bewältigen komplexere Transformationen, bedingte Logik, Lookups, Feldumbenennungen und das Verwerfen von Nachrichten. Together geben sie Ihnen eine feingranulare Kontrolle darüber, was im Speicher landet. Graylog Illuminate lieferte außerdem Parser-Korrekturen in 7.0.3, darunter eine Korrektur des Apache-HTTPD-Zeitstempel-Parsings, das falsche Zeitwerte erzeugte.
- Suche und Untersuchung: Die Suchsyntax von Graylog ist für einfache Abfragen einfacher als Lucene/KQL, was wichtig ist, wenn ein Bereitschaftsingenieur mitten in der Nacht Protokolle ohne Referenzdokumentation durchsuchen muss. Gespeicherte Suchen, relative Zeitbereiche und Histogramm-Überlagerungen sind alle ohne kostenpflichtige Add-ons verfügbar.
- Benutzerverwaltung mit AD/LDAP-Integration: Active Directory- und LDAP-Authentifizierung werden in Graylog Open unterstützt. Rollenbasierte Zugriffskontrollen ermöglichen es Ihnen, einzuschränken, welche Streams und Dashboards jedes Team sehen kann.
Wo Graylog an Grenzen stößt
Die free-Stufe von Graylog weist erhebliche Lücken auf, wenn Security Operations Ihr Anwendungsfall ist: Sigma-Regel-Unterstützung, Anomalieerkennung und Fallverwaltung sind alle kostenpflichtig. Die Abhängigkeit von Elasticsearch/OpenSearch erhöht die operative Komplexität ähnlich wie beim ELK Stack. In großem Maßstab kann die Pipeline-Verarbeitung Leistungsengpässe verursachen, die eine sorgfältige Abstimmung der Reihenfolge der Pipeline-Stufen und der Zuweisung von Worker-Threads erfordern.
Elastic Stack (ELK Stack) – Logstash
Elastic Stack ist eine Reihe von Open-Source-Produkten; seine Kernkomponenten sind Elasticsearch, Kibana und Logstash.
So funktioniert die ELK-Log-Analyse
Logstash ist eine serverseitige Datenverarbeitungs-Pipeline. Sie empfängt Logdaten aus Inputs (Dateien, Beats, Syslog, Kafka, HTTP und Dutzenden anderen), wendet Filter-Plugins an, um die Daten zu parsen und anzureichern, und leitet die Ausgabe an ein oder mehrere Ziele weiter. Die meisten Bereitstellungen senden die Ausgabe an Elasticsearch, aber Logstash kann gleichzeitig an S3, ein SIEM, eine Nachrichtenwarteschlange oder einen anderen Elasticsearch-Cluster schreiben.
Elasticsearch speichert die verarbeiteten Logdaten und macht sie mithilfe eines invertierten Index durchsuchbar. Es ist der Grund, warum ELK auf Petabytes skaliert und dennoch bei gezielten Abfragen Ergebnisse in Sekundenbruchteilen liefert; diese Leistung beruht jedoch auf der Indexstruktur, was bedeutet, dass schreibintensive Workloads ein sorgfältiges Index-Lifecycle-Management erfordern. Kibana sitzt über Elasticsearch und stellt die visuelle Schicht bereit: Dashboards, die Discover-Ansicht für Ad-hoc-Protokollsuche, Canvas für benutzerdefinierte Berichte und Lens für Drag-and-Drop-Visualisierungen.
- Volltextsuche in großem Maßstab: Die invertierte Indexarchitektur von Elasticsearch unterstützt Suchen in Sekundenbruchteilen über Milliarden von Protokolleinträgen hinweg. KQL (Kibana Query Language) und ES|QL (die neuere Pipe-basierte Abfragesprache in 9.x) geben Analysten zwei verschiedene Abfrageschnittstellen, je nachdem, wie sie bevorzugt arbeiten. Für komplexe Protokolluntersuchungen über große Datensätze hinweg erreicht im Open-Source-Bereich nichts die Suchtiefe von ELK.
- Multi-Source-Erfassung und -Filterung: Logstash verfügt über rund 200 Input-Plugins und 200 Filter-Plugins. Der Grok-Filter verarbeitet unstrukturierten Text mithilfe benannter Erfassungsmuster; der JSON-Filter verarbeitet strukturierte JSON-Protokolle; der CSV-Filter verarbeitet tabellarische Daten. Mehrere Filterstufen laufen nacheinander ab, sodass Sie eine rohe Syslog-Zeile parsen, Felder extrahieren, eine IP anhand einer GeoIP-Datenbank nachschlagen und Nachrichten auf Debug-Ebene verwerfen können, bevor das Ereignis Elasticsearch erreicht – und das alles in einer einzigen Pipeline.
- Anomalieerkennung per Machine Learning: Die ML-Funktionen von Kibana (kostenpflichtig) erkennen ungewöhnliche Muster in Logdaten, ohne dass Sie Schwellenwerte definieren müssen. Nützlich für die Erkennung schleichender Angriffe oder allmählicher Leistungsverschlechterungen, die Warnmeldungen mit festen Schwellenwerten übersehen.
- Kibana-Dashboards: Die Visualisierungsoptionen von Kibana sind umfangreich: Zeitreihen, Karten, Heatmaps, Datentabellen, Messanzeigen und mehr. Gespeicherte Suchen und Indexmuster ermöglichen es Analysten, Untersuchungskontexte teamübergreifend zu teilen.
- Erweiterbares Ausgabe-Routing: Eine einzige Logstash-Pipeline kann gleichzeitig in Elasticsearch, einen S3-Bucket, einen zweiten Elasticsearch-Cluster für die Notfallwiederherstellung und ein Kafka-Topic für die nachgelagerte Verarbeitung schreiben.
Wo ELK an Grenzen stößt
Der operative Aufwand ist real. Elasticsearch-Cluster erfordern Speicherplanung (der JVM-Heap muss sorgfältig dimensioniert werden), Shard-Verwaltung (sowohl zu viele kleine Shards als auch zu wenige große beeinträchtigen die Leistung) und die Konfiguration von Index-Lifecycle-Richtlinien, um die Aufbewahrungskosten zu kontrollieren.
Die meisten Teams, die ELK in großem Maßstab betreiben, stellen am Ende einen dedizierten Plattform-Ingenieur ein, dessen Hauptverantwortung Elasticsearch ist. Die Lizenzsituation ist ebenfalls wichtig zu verstehen: Die Elastic-Stack-Komponenten unterliegen der Elastic License 2.0, nicht einer OSI-genehmigten Open-Source-Lizenz. Die selbst gehostete Nutzung ist kostenlos, aber das Anbieten von Elasticsearch als verwalteter Dienst für Dritte ist in der free-Stufe nicht gestattet.
Fluentd
Fluentd ist ein Open-Source-Datensammler unter der Apache-Lizenz 2.0, der entwickelt wurde, um die Protokollaufnahme und das Routing über heterogene Infrastrukturen hinweg zu vereinheitlichen. Die Kernaufgabe ist einfach: Protokollereignisse aus Quellen annehmen, optionale Verarbeitung anwenden und sie an Ziele weiterleiten. Fluentd speichert oder analysiert Protokolle nicht selbst; es ist ein Sammler und Router, keine Log-Analyse-Plattform1
Dieser Unterschied ist wichtig, wenn man Fluentd mit Wazuh oder Graylog vergleicht. Fluentd ist typischerweise die erste Schicht in einer größeren Pipeline. Eine häufige Architektur: Fluentd-Agents auf jedem Server sammeln Anwendungs-, System- und Containerprotokolle, puffern sie lokal (damit nichts verloren geht, wenn das nachgelagerte Ziel vorübergehend nicht erreichbar ist), wenden Parsing und Filterung an und leiten das Ergebnis an Elasticsearch, Splunk, ein Cloud-SIEM oder ein anderes Speicher-Backend weiter. Die Analyse findet in dem System statt, das die Daten empfängt.
Fluentd vs. Fluent Bit
Teams, die Fluentd für Kubernetes-Umgebungen evaluieren, entscheiden sich oft für Fluent Bit, und es lohnt sich zu verstehen, warum. Fluent Bit ist ein leichtgewichtiger Forwarder im selben CNCF-Ökosystem, ungefähr eine 4 MB große Binärdatei im Vergleich zu Fluentds Ruby-basiertem Prozess, der deutlich schwerer läuft. Für Kubernetes-Bereitstellungen, bei denen ein Logsammler als DaemonSet auf jedem Node laufen soll, ist der Unterschied beim Ressourcenbedarf in großem Maßstab erheblich. Fluent Bit unterstützt außerdem mehrzeiliges Protokoll-Parsing, dynamische Metadaten-Injektion aus Kubernetes-Pod-Labels und -Annotationen sowie integrierte Backpressure-Verarbeitung, um Datenverlust zu verhindern, wenn nachgelagerte Ziele langsamer werden.
Fluentd ist die bessere Wahl, wenn Sie das volle 500+ Plugin-Ökosystem oder komplexe Routing-Logik benötigen, die kleinere Plugin-Bibliothek von Fluent Bit nicht abdecken kann. Für die meisten Kubernetes-nativen Bereitstellungen, die einfaches Log-Shipping betreiben, ist Fluent Bit die praktische Wahl. Die Projekte teilen sich Konfigurationskonzepte, sodass ein Wechsel zwischen ihnen keine vollständige Neufassung erfordert.
Wie Fluentd Logdaten verarbeitet
Fluentd modelliert Logdaten als Stream von markierten Ereignissen. Jedes Ereignis hat einen Tag (eine durch Punkte getrennte Zeichenkette wie app.web oder system.syslog), einen Zeitstempel und einen Datensatz. Tags steuern das Routing: Match-Direktiven in der Konfiguration legen fest, welche Tags wohin gesendet werden, welche Filter angewendet werden und in welcher Reihenfolge. Mehrere Outputs können denselben Tag matchen, sodass Sie dieselben Ereignisse gleichzeitig an Elasticsearch und ein S3-Archiv senden können.
Das Puffersystem macht Fluentd in der Produktion zuverlässig. Anstatt direkt in das Ziel zu schreiben, sammeln sich Ereignisse in einem Puffer an und werden in Blöcken in konfigurierbaren Intervallen oder wenn der Puffer eine Größenschwelle erreicht, geleert. Wenn das Ziel nicht erreichbar ist, bleiben die Ereignisse im Puffer und werden mit exponentiellem Backoff erneut versucht.
Herausragende Funktionen:
- 500+ Community-Plugins: Deckt Integrationen mit den meisten gängigen Protokollzielen und Datenquellen ohne individuelle Entwicklung ab.
- Flexibles Daten-Routing: Ereignisse können an mehrere gleichzeitige Ziele wie Dateien, RDBMS, NoSQL, IaaS, SaaS und Hadoop weitergeleitet werden – basierend auf tagbasierten Routing-Regeln.
- Fokus auf Protokollverarbeitung: Fluentd ist für die Protokollverarbeitung und -weiterleitung in großem Maßstab optimiert und eignet sich daher gut als Sammel- und Routing-Schicht vor Elasticsearch oder anderen Speicher-Backends und weniger als eigenständige Analyseplattform.
 Als bevorzugte Quelle hinzufügen
Syslog-ng
Syslog-ng ist ein Open-Source-Log-Management-Programm, das Protokolldaten aus mehreren Quellen sammelt, klassifiziert, transformiert und an Speicher- oder nachgelagerte Plattformen weiterleitet. Seine herausragende Fähigkeit ist die strukturierte Verarbeitung: Protokolle können in ein konsistentes Format normalisiert werden, bevor sie an Systeme wie Apache Kafka oder Elasticsearch weitergeleitet werden.
Funktionen:
- Protokolle klassifizieren und strukturieren mithilfe integrierter Parser wie csv-parser
- Protokolle speichern in Dateien, Nachrichtenwarteschlangen (AMQP) oder Datenbanken (PostgreSQL, MongoDB)
- Weiterleitung an Big-Data-Plattformen, einschließlich Elasticsearch, Apache Kafka oder Hadoop
Besondere Funktionen:
- Automatisierte Protokollarchivierung: Syslog-ng übernimmt die Protokollrotation und -archivierung nativ, einschließlich Komprimierung und Dateibenennung mit Zeitstempel. In Umgebungen mit Anforderungen an die Aufbewahrungskonformität reduziert dies den Bedarf an externen Tools wie logrotate, die zusätzlich eingesetzt werden müssten.
- Unterstützung mehrerer Nachrichtenformate: RFC3164 (traditionelles Syslog), RFC5424 (strukturiertes Syslog), JSON und Schlüssel-Wert-Formate werden alle nativ geparst. Syslog-ng kann eine RFC3164-Nachricht empfangen und als RFC5424 mit zusätzlichen strukturierten Datenfeldern ausgeben, was nützlich ist, wenn Daten an Systeme geliefert werden, die ein modernes Syslog-Format erwarten.
- Verschlüsselter Transport: TLS-verschlüsselter Syslog-Transport wird nativ sowohl für den Empfang als auch für die Weiterleitung unterstützt. Dies ist in Umgebungen wichtig, in denen Protokolldaten nicht vertrauenswürdige Netzwerksegmente durchqueren.
- Bedingtes Routing: Filterausdrücke ermöglichen das Routing basierend auf jedem geparsten Feld – Schweregrad, Facility, Host oder benutzerdefinierten Feldern, die von Parsern extrahiert wurden. Eine einzige Syslog-ng-Instanz kann Authentifizierungsfehler an den Stream des Sicherheitsteams, Anwendungsfehler an den Stream des Entwicklungsteams und Debug-Meldungen nach /dev/null weiterleiten.
Wo Syslog-ng passt (und wo nicht)
Syslog-ng ist die richtige Wahl, wenn Ihre Protokollquellen hauptsächlich Netzwerkgeräte und Server sind, die Syslog sprechen, und wenn Sie eine zuverlässige Sammlung mit hohem Durchsatz und strukturierter Feldextraktion benötigen, bevor die Daten an ein Speicher-Backend weitergeleitet werden. Es ist keine Log-Analyse-Plattform; es gibt keine Abfrageschnittstelle, keine Dashboards und keine integrierte Alarmierung. Es fungiert als Sammel- und Routing-Schicht vor Elasticsearch oder Graylog und nicht als eigenständiges Tool.
Nagios
Eine notwendige Klarstellung vorab: Nagios Core ist das GPL-lizenzierte Open-Source-Monitoring-Projekt und konzentriert sich auf Host-, Service- und Netzwerküberwachung statt auf Log-Analyse.[15] Das hier beschriebene Produkt ist der Nagios Log Server, ein separates kommerzielles Produkt von Nagios Enterprises. Wenn Sie speziell ein kostenloses Open-Source-Log-Analyse-Tool suchen, ist der Nagios Log Server nicht das Richtige. Was er bietet, ist eine kommerziell unterstützte Log-Management-Plattform von einem Anbieter mit langer Erfahrung in der Infrastrukturüberwachung.
Der Nagios Log Server sammelt Protokolldaten in Echtzeit und leitet sie an eine Suchoberfläche weiter. Er ist mit Windows-, Linux- und Unix-Servern kompatibel und enthält einen Setup-Assistenten für die Integration neuer Endpoints oder Anwendungen.2
Herausragende Funktionen:
- Überwachung von Netzwerkdiensten: Umfasst SMTP, POP3, HTTP, PING und andere Netzwerkdienste mit Fokus auf den Zustand der Infrastruktur.
- Überwachung von Host-Ressourcen: Verfolgt Prozessorlast, Festplattenauslastung und Systemzustand auf den überwachten Hosts.
- Rotation und Archivierung von Protokolldateien: Automatisierte Rotation und langfristige Archivierung ohne manuellen Eingriff.
- Geografische Protokollfilterung: Filtert Protokolldaten nach geografischer Herkunft und erzeugt Verkehrsfluss-Karten.
- Weboberfläche: Optionale Oberfläche zur Anzeige des aktuellen Netzwerkstatus und von Protokolldateien.
FAQs
Open-Source-Log-Analyse-Tools ermöglichen es Benutzern, Protokolldaten aus verschiedenen Quellen wie Servern, Anwendungen und Netzwerkgeräten zu sammeln, zu verarbeiten, zu speichern, zu durchsuchen und zu analysieren. Diese Tools können SecOps-, ITOps- und DevOps-Teams dabei helfen:
-System-Fehlerbehebung durch Überwachung von Transaktionsprotokolldateien durchzuführen.
-Sicherheits-Incident Response und Untersuchung zu nutzen, um eine optimale Datenbankleistung aufrechtzuerhalten oder Benutzer- und Entitätsverhaltensanalyse (UEBA) auszuführen.
-Compliance mit Audits, Gesetzen und besonderen Sicherheitsregeln (DSGVO) aufrechtzuerhalten.
Diese Forschung zitieren
Wählen Sie das Format, das zu Ihrem Veröffentlichungsort passt. Wenn Sie die Link-Version in Ihr CMS einfügen, bleibt der Backlink erhalten.
@misc{hafa2026,
  author = {Hafa, Adil and PhD., Ezgi Arslan,},
  title  = {{Top 6 Open-Source-Log-Analyse-Tools: Wazuh, Graylog & mehr}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/open-source-log-analysis-tools}},
  note   = {AIMultiple. Abgerufen am 14. September 2026}
}Ergebnisse und Zeitstempel von 18 Datenpunkten. Laden Sie die Zusammenfassungsdaten aus den Diagrammen und Tabellen dieses Artikels als ZIP-Datei herunter, die 3 CSV-Dateien enthält.
Möchten Sie die granularen Daten dahinter? Premium beitreten
Änderungsprotokoll
6 AktualisierungenAbschnitte zur Funktionsweise und zu Einschränkungen für Graylog, den ELK Stack, Fluentd und syslog-ng hinzugefügt.
Aktualisierte das Wazuh-Produkt mit neuen Erkennungsfunktionen und einer SCA-Richtlinie.
Referenzlinks





Seien Sie der Erste, der kommentiert
Ihre E-Mail-Adresse wird nicht veröffentlicht. Alle Felder sind erforderlich. Kommentare werden in ihrer Originalsprache belassen.