


Embedding-Models: 25 Models für Retrieval gebenchmarkt

Wir haben 25 Embedding-Models anhand von 200 Retrieval-Fragen aus den Bereichen Finanzen, Rechtsverträge, technischer Support und medizinische Literatur gebenchmarkt. Die vier Korpora enthielten insgesamt 341.040 Textpassagen. Jede Query durchsuchte ihre eigene Domäne.
Embedding-Models-Benchmark-Ergebnisse
nDCG@10 misst, wie weit oben die erfassten relevanten Passagen in den ersten zehn Ergebnissen erscheinen. Die Scores reichen von 0 bis 1; höhere Werte belohnen eine bessere Platzierung.
Recall@10 misst den Anteil der erfassten relevanten Passagen jeder Frage, die innerhalb der ersten zehn Ergebnisse abgerufen wurden, gemittelt über alle Fragen. Die Genauigkeit generierter Antworten lag außerhalb dieser Evaluierung.
Die 95 %-Konfidenzintervalle (KIs) schätzen die Unsicherheit der durchschnittlichen nDCG@10 durch die Stichprobenziehung der Fragen. Breitere Intervalle deuten auf weniger präzise Schätzungen hin.
Die Fragen wurden ausgewählt, weil BM25 die antwortgebenden Passagen in seinen ersten zehn Ergebnissen verfehlt hatte. Sein Null-Score spiegelt diese Auswahl wider und schränkt Vergleiche mit Keyword-Retrieval im normalen Betrieb ein.
Retrieval-Ergebnisse über 25 Models hinweg
Voyage 4 Large erzielte den höchsten nDCG@10 mit 0.851
Das 95 %-KI lag bei 0.817–0.884. Paarweise Tests ergaben nach Korrektur für multiple Vergleiche keinen signifikanten Unterschied zu Cohere Embed 5 Pro, Cohere Embed 5 Fast, Gemini Embedding 2, Voyage 4 oder Gemini Embedding 001. Das Ranking bleibt unsicher. Ein nicht signifikantes Ergebnis belegt keine gleichwertige Leistung.
Cohere Embed 5 Pro und Fast schnitten signifikant besser ab als Embed v4.0
Pro erzielte 0.850 und Fast 0.839, im Vergleich zu 0.772 für Cohere Embed v4.0. Ihre Gewinne von 0.078 und 0.067 nDCG@10 waren nach Korrektur über alle 300 Model-Paare signifikant. Der Unterschied von 0.010 zwischen Pro und Fast war nicht signifikant.
Gemini Embedding 2 erzielte den höchsten Recall@10 mit 96,50 %
Cohere Embed 5 Pro folgte mit 95,88 % und Voyage 4 mit 95,83 %. Keiner der Unterschiede zu Gemini Embedding 2 war nach Korrektur signifikant. Das Verschieben einer relevanten Passage von Platz fünf auf Platz eins verbessert nDCG, ohne den Recall zu verändern.
PPLX Embed v1 4B führte die Open-Weight-Models mit 0.741 nDCG@10 an
PPLX Embed v1 0.6B folgte mit 0.698. Das 4B-Model lag signifikant über neun der anderen zehn Open-Weight-Models. Der Abstand zu 0.6B war nicht signifikant. Der Open-Source-Embedding-Model-Vergleich deckt diese Teilmenge ab.
Domänen-Ergebnisse für Finanzen, Verträge, Support und Medizin
Die sechs höchsten nDCG@10-Scores innerhalb jeder Domäne. Jeder Filter ordnet die fertigen Models anhand der 50 Fragen dieser Domäne neu.
Jede Domäne trägt gleich zum Gesamtdurchschnitt bei. Cohere Embed 5 Fast erzielte den höchsten CUAD-Score mit 0.762, und Pro erzielte den höchsten TechQA-Score mit 0.894. MedRAG erzeugte für jedes Model den höchsten nDCG@10. Bei 50 Fragen pro Domäne bleiben kleine Unterschiede bei diesen Scores unsicher.
Embedding-Kosten und Retrieval-Qualität
Wir haben die API-Kosten für das Embedding derselben 341.040 Passagen und 200 Queries für jedes Model berechnet.
PPLX Embed v1 0.6B verursachte die niedrigsten Embedding-Kosten von $0,13 und erreichte 0.698 nDCG@10. Voyage 4 Lite kostete $0,62 und erreichte 0.793. Für $1,87 erreichte Voyage 4 0.829.
Cohere Embed 5 Fast kostete $2,52 und erreichte 0.839, während Pro $3,40 kostete und 0.850 erreichte. Fast’s Embedding-Kosten lagen bei dieser Workload 26 % niedriger. Der Unterschied in ihren Retrieval-Scores war nach Korrektur für multiple Vergleiche statistisch nicht signifikant.
Voyage 4 Large kostete $3,74 und erzielte den höchsten Score mit 0.851. Gemini Embedding 2 hatte die höchsten Kosten von $6,68 und erreichte 0.830. Mehr Ausgaben für Embeddings führten in diesem Test nicht durchgängig zu einem höheren Retrieval-Score.
Die Kosten decken erfolgreiche Embedding-Aufrufe ab, die in der Evaluierung verwendet wurden. Die Summen für Cohere verwenden gemeldete Input-Tokens multipliziert mit dem erfassten Tarif. Die Kosten von Embed v4.0 in Höhe von $3,72 sind eine Schätzung, da sein direkter API-Tarif nicht verifiziert wurde. Wiederholungen, Diagnosen, Kontogebühren, Speicher- und Suchrechenleistung sind ausgeschlossen. Diese Beträge beschreiben die getestete Workload und die API-Routen. Die Produktionskosten hängen vom Textvolumen, der Tokenisierung und den Anbieterpreisen ab.
Wie Text-Embeddings Retrieval unterstützen
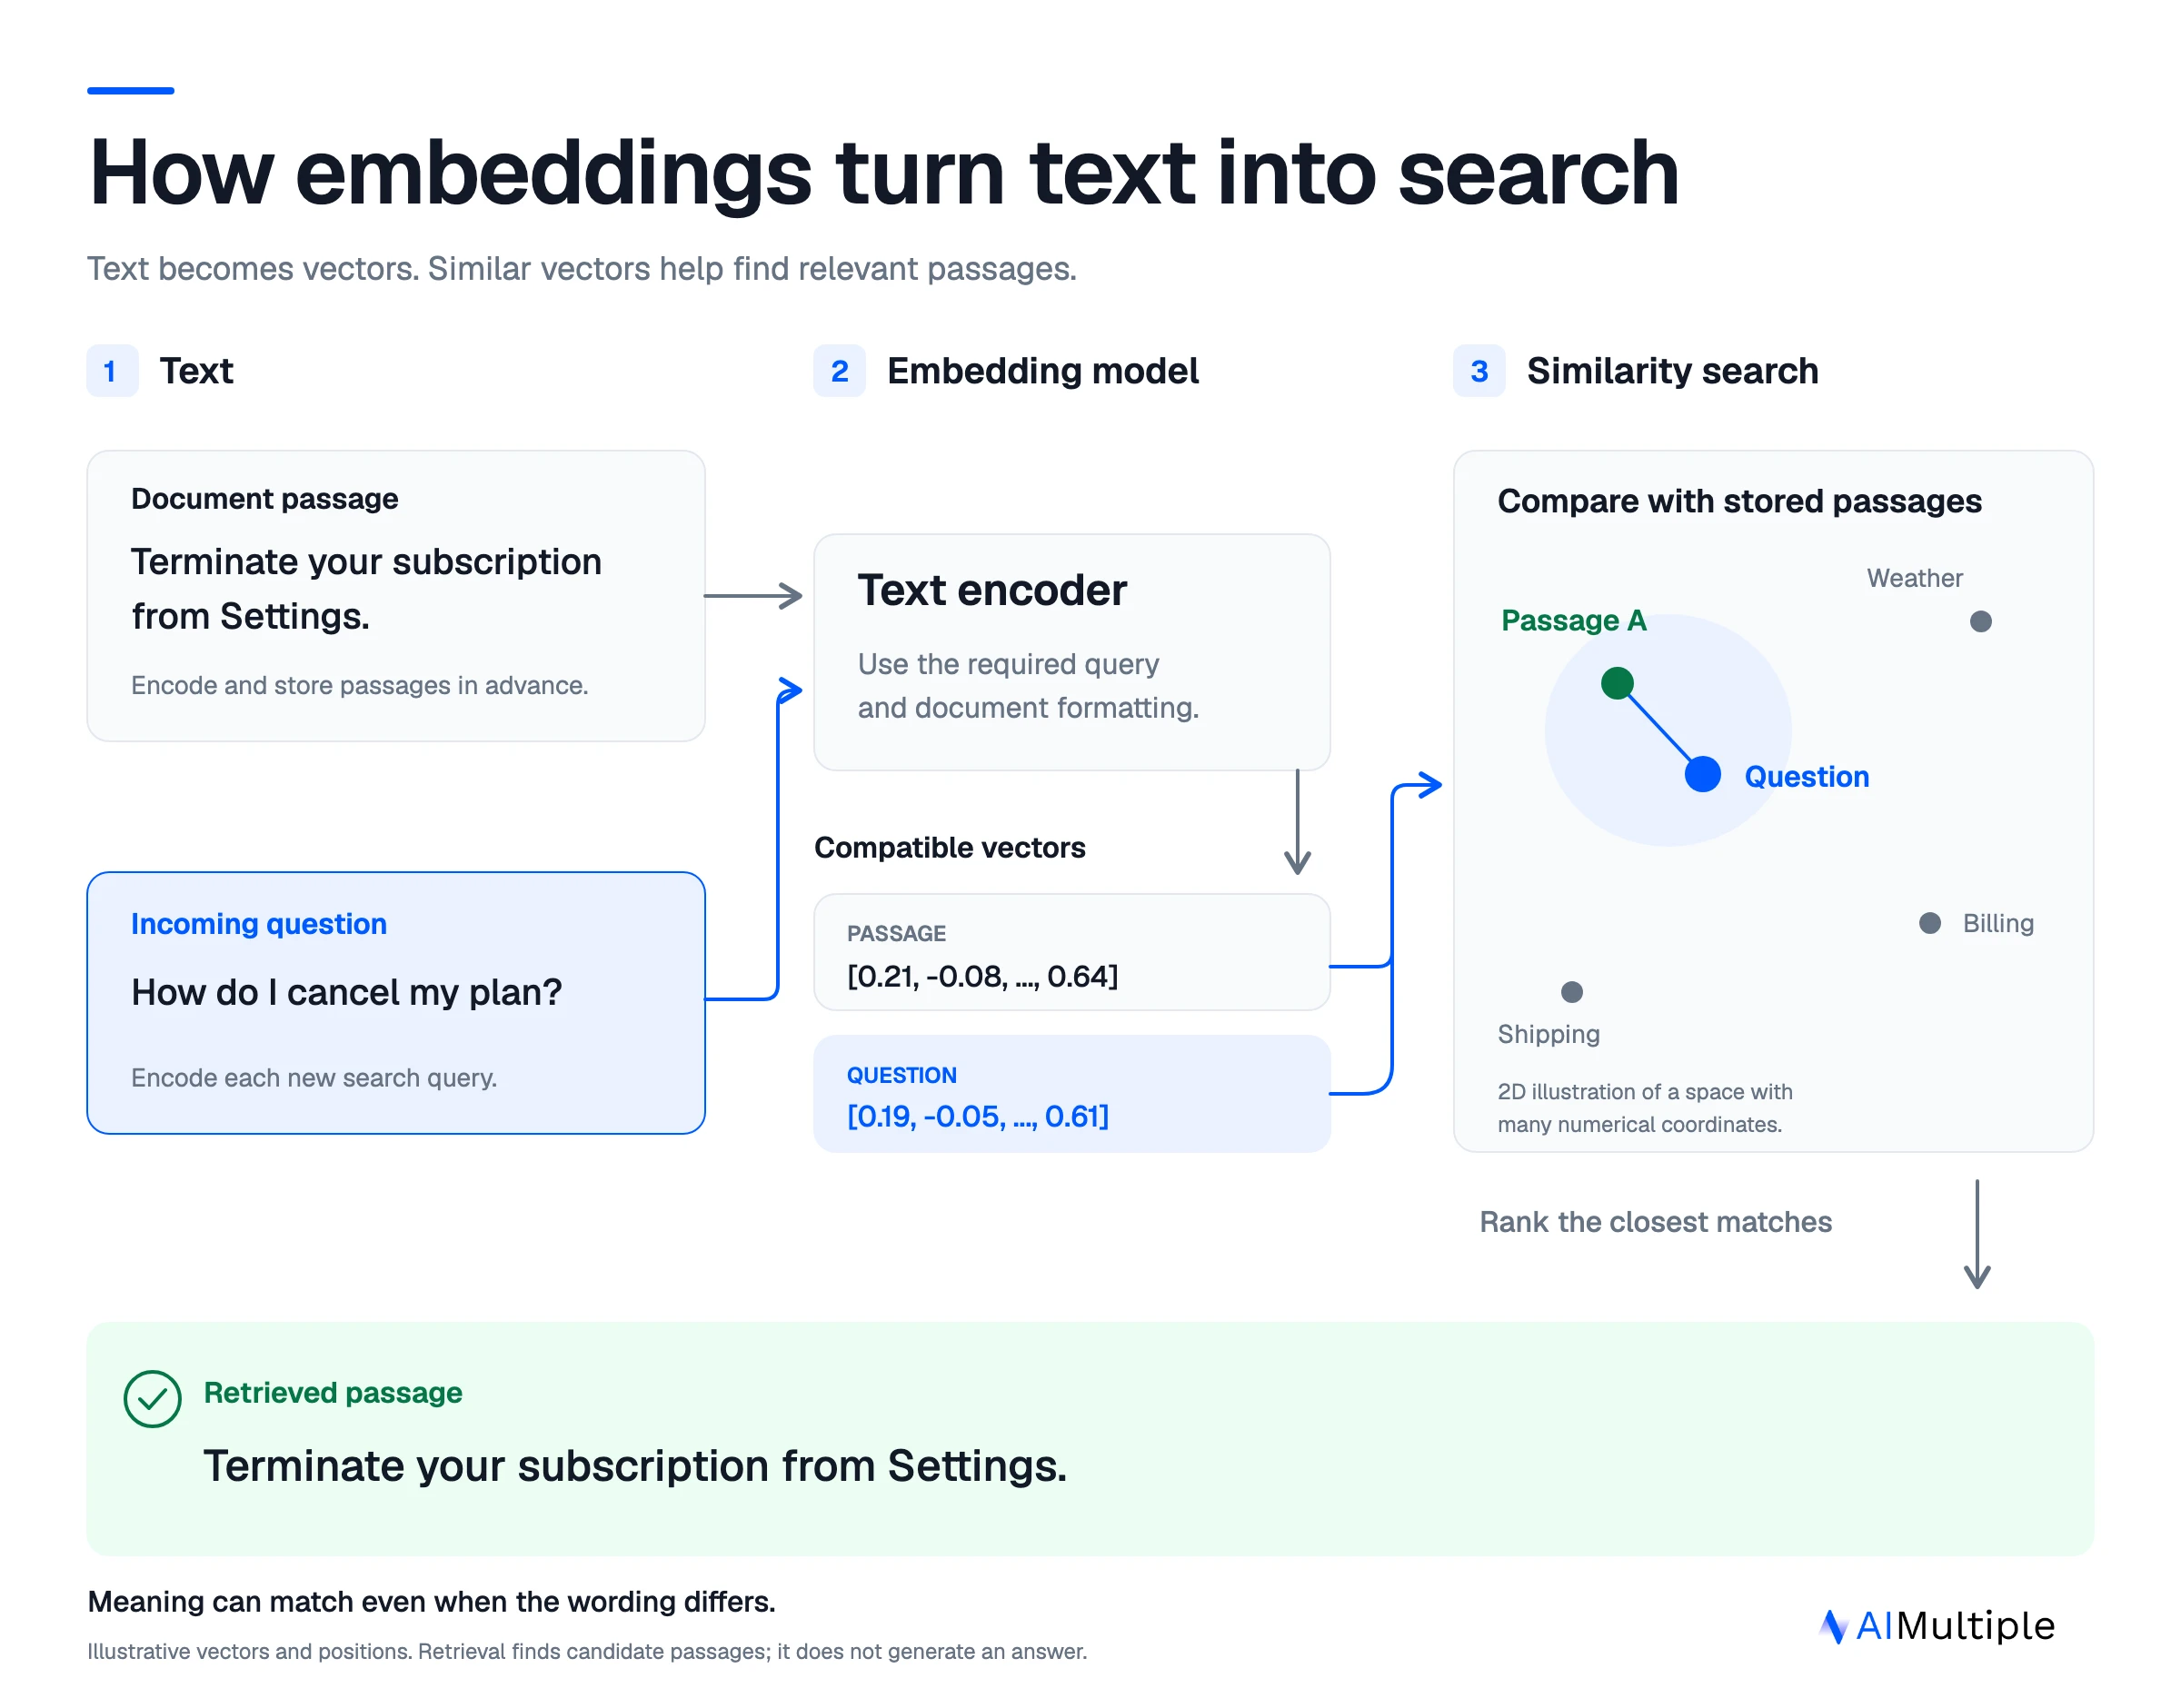
Ein Embedding-Model konvertiert Text in einen Vektor, eine Liste numerischer Werte, die mit anderen Vektoren eines kompatiblen Models verglichen werden können. Beim semantischen Retrieval werden Dokumentpassagen im Voraus encodiert. Zur Suchzeit encodiert das System die Query und ordnet gespeicherte Passagen nach Vektorähnlichkeit.1
Zum Beispiel kann eine Frage zum Kündigen eines Tarifs trotz unterschiedlicher Formulierungen nahe bei einer Passage über die Beendigung eines Abonnements liegen. Das Training des Models bestimmt, welche Beziehungen die Vektoren bewahren.2 Das Diagramm komprimiert diese Idee auf zwei Dimensionen. Bereitgestellte Embeddings enthalten im Allgemeinen viel mehr Koordinaten.
Auch die Formatierung von Query und Dokument ist wichtig. Ein Model kann getrennte Retrieval-Rollen oder Präfixe erwarten, selbst wenn beide Ausgaben denselben kompatiblen Vektorraum belegen. Wir haben die für jedes Model erforderliche Query- und Dokumentformatierung angewendet.
Eine Vektordatenbank speichert und durchsucht Vektoren, während das Embedding-Model die durchsuchten Repräsentationen bestimmt. Abgerufene Passagen können dann als Kontext für einen Antwortgenerator dienen. Dieser Benchmark endet bei der Passagen-Retrieval und bewertet keine generierten Antworten.
Embedding-Models-Benchmark-Methodik
Alle Models durchsuchten dieselben Passagen mit denselben 200 Fragen und 225 erfassten relevanten Frage-Passage-Paaren. Fragen und Labels wurden vor dem Vergleich der Embedding-Scores eingefroren. Die Query-Eingaben enthielten nur die ursprüngliche Frage.
Finanz-Passagen stammten aus FinQA-Jahresberichten und juristische Passagen aus CUAD-v1-Verträgen.34 Der technische Support verwendete TechQA-Technotes, und die medizinische Fachliteratur verwendete eine Stichprobe von MedRAG-PubMed-Abstracts.56
Passagen waren ganze Absätze, Tabellen mit Kontext, Vertragsklauseln oder Abstracts mit Titeln. Wir haben Einheiten ausgeschlossen, die länger als 256 Tokens unter dem all-MiniLM-L6-v2-Tokenizer waren. Akzeptierte Passagen wurden unverändert beibehalten, und die 512-Token-Models erhielten höchstens 459 Tokens pro Passage. Dieser Benchmark bewertet daher kurze Passagen.
Frontier-LLMs entwarfen die Fragen aus Quellpassagen. Ein Teammitglied verifizierte 20 % der Fragen (40 von 200). LLMs beurteilten außerdem die Top-20-Passagen von BM25 pro Frage und fügten den ursprünglichen 200 Quellpassagen 25 relevante Passagen hinzu.
Retrieval und statistische Analyse
Das Retrieval verglich jede Query mit jeder Passage in ihrer Domäne. Wir verwendeten Kosinus-Ähnlichkeit für 21 Models und das Skalarprodukt für MultiQA MPNet Base Dot v1. BGE-M3 verwendete seine dichten Vektoren.7 Query- und Dokumenteingaben verwendeten die konfigurierten Retrieval-Rollen oder -Präfixe jedes Models.
Beide Metriken sind Durchschnittswerte über alle Fragen. Wir berechneten 95 %-KIs mit 10.000 Bootstrap-Stichproben, wobei innerhalb jeder Domäne 50 Fragen erneut gezogen wurden. Paarweise Vergleiche verwendeten gepaarte Vorzeichenwechsel-Tests mit Holm-Korrektur über alle 231 Model-Paare für jede Metrik und jeden Umfang. Unterschiede wurden bei einem korrigierten p-Wert unter 0.05 als signifikant bezeichnet.
Getestete Model-IDs, Dimensionen und Eingabelimits
Die ursprünglichen 22 Models liefen über OpenRouter, mit einem festen Backend-Anbieter pro Model und deaktivierten Fallbacks. Die drei Cohere-Models liefen über die Cohere-API mit nativen Dokument- und Query-Rollen (search_document und search_query). Die Tabelle erfasst die verwendeten API-Identifikatoren, Ausgabedimensionen und Eingabelimits, einschließlich konservativer Obergrenzen.
API-Identifikatoren garantieren keinen unveränderlichen Model-Snapshot. Tokenizer-Revisionen wurden, wo verfügbar, festgepinnt. Gehostete Model-Gewichte wurden nicht unabhängig verifiziert. Die Eingabelängen von Gemini und Cohere wurden anhand konservativer Schätzungen geprüft. Die kurzen Passagen testeten kein Long-Context-Retrieval.
 Als bevorzugte Quelle hinzufügen
Umfang und Einschränkungen
Die Fragen bilden ein von BM25 ausgewähltes Entwicklungsset. Ergebnisse bei gewöhnlichen Produktions-Queries können abweichen. Die Relevanzbewertungen waren auf die Quellpassagen und die Top-20 von BM25 beschränkt. Über alle 25 Models hinweg waren 87 % der unterschiedlichen Frage-Passage-Paare, die in den Top Ten abgerufen wurden, unbewertet und erhielten keine Relevanzgutschrift.
Jedes Model wurde einmal ausgeführt. Die KIs spiegeln die Fragen-Stichprobe wider und schließen Variationen zwischen API-Läufen oder Unsicherheit durch unvollständige Labels aus. Eine Kontamination durch Trainingsdaten wurde nicht getestet.
Diese Evaluierung deckt Text-Retrieval ab. Die Genauigkeit generierter Antworten, hybrides Retrieval, Reranking, Latenz und Bereitstellungskosten lagen außerhalb ihres Umfangs. Der Reranker-Benchmark, der multilinguale Embedding-Vergleich und der multimodale Embedding-Vergleich decken separate Workloads ab.
Fazit
Voyage 4 Large erzielte den höchsten nDCG@10, ohne signifikanten Abstand zu Cohere Embed 5 Pro oder Fast. Beide Cohere-Models schnitten signifikant besser ab als Embed v4.0. Gemini Embedding 2 führte beim Recall, und PPLX Embed v1 4B führte die Open-Weight-Gruppe an.
Verwenden Sie die Domänen-Ergebnisse, um Kandidaten auszuwählen, und vergleichen Sie anschließend anhand repräsentativer Queries mit überprüften Relevanzlabels. Messen Sie Latenz und End-to-End-Bereitstellungskosten separat.
Weiterführende Lektüre
- Open-Source-Embedding-Model-Benchmark
- Multilinguale Embedding-Models für RAG
- Multimodale Embedding-Models
- Open-Source-Vektordatenbank-Benchmark
Zitieren Sie diesen Benchmark
Wählen Sie das Format, das zu Ihrem Veröffentlichungsort passt. Wenn Sie die Link-Version in Ihr CMS einfügen, bleibt der Backlink erhalten.
@misc{sari2026,
  author = {Sarı, Ekrem},
  title  = {{Embedding-Models: 25 Models für Retrieval gebenchmarkt}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/embedding-models}},
  note   = {AIMultiple. Abgerufen am 1. Oktober 2026}
}Ergebnisse und Zeitstempel von 180 Datenpunkten. Laden Sie die Zusammenfassungsdaten aus den Diagrammen und Tabellen dieses Artikels als ZIP-Datei herunter, die 8 CSV-Dateien und eine README enthält.
Möchten Sie die granularen Daten dahinter? Premium beitreten
Änderungsprotokoll
5 AktualisierungenTop-1-Treffer-Metrikdefinition zur Embedding-Benchmark-Methodik hinzugefügt.
Ersetzte den Benchmark durch 15 Modelle und eine BM25-Baseline, getestet an Rechts-, Kundensupport- und Gesundheitskorpora.
Referenzlinks





Seien Sie der Erste, der kommentiert
Ihre E-Mail-Adresse wird nicht veröffentlicht. Alle Felder sind erforderlich. Kommentare werden in ihrer Originalsprache belassen.