


KI-Deep-Research: Codex vs Claude vs Grok vs Exa

Ein Deep-Research-Tool beantwortet eine Frage mit einem schriftlichen Bericht statt mit einer Seite voller Links. Wir haben fünf Möglichkeiten zur Erstellung eines solchen Berichts über dieselben 20 Business-Research-Briefings getestet und jeden Bericht anhand von Regeln bewertet, die vor den Durchläufen festgelegt wurden, um das beste Tool für Deep Research zu finden. Vier der fünf sind Coding-Agenten, Kommandozeilen-Tools, die für Softwarearbeit entwickelt wurden, aber auch das Web durchsuchen und lesen können; das fünfte, Exa Agent, ist für Recherchen gebaut.
DR-20 Bench-Ergebnisse
Jedes der fünf Tools erstellte für jede der 20 Aufgaben einen Bericht, insgesamt 100 Berichte, die blind anhand von vor den Durchläufen festgelegten Regeln bewertet wurden. Weitere Einzelheiten finden Sie unter Methodik.
Das einzige speziell für Deep Research entwickelte Produkt landete hinter drei der vier Coding-Agenten. Exa Agent erreichte 0.584, und jede dieser drei Lücken bleibt nach Holm-Korrektur über alle zehn paarweisen Vergleiche bestehen. Bei diesen Briefings erzielten Codex CLI, Claude Code und Grok CLI alle höhere Werte als das Produkt, das für diese Aufgabe entwickelt wurde.
Exa Agent und Gemini CLI zeigten keinen statistisch signifikanten Unterschied bei den Anforderungswerten.
Wir fanden keinen statistisch signifikanten Unterschied zwischen Codex CLI und Claude Code bei diesen 20 Aufgaben. Der Abstand beträgt 0.015 auf einer Skala von 0 bis 1, mit einem unkorrigierten p-Wert von 0.67 und 0.96 nach Holm-Korrektur. Über 10.000 Bootstrap-Stichproben hinweg hatten beide ein 95 %-Ranking-Intervall von 1 bis 2. Sie führen bei unterschiedlichen Messgrößen: Codex CLI bei den schriftlichen Anforderungen mit 0.015 Vorsprung, Claude Code bei der Wiedergabe von Fakten mit 1.2 Prozentpunkten.
Exakt wiedergegebene Fakten
Claude Code gab 202 der 434 geforderten Fakten vollständig wieder, Codex CLI 198 und Exa Agent 89. Kein Tool erreichte die Hälfte. Ein Element wurde nur dann gewertet, wenn der Bericht alle geforderten Details korrekt enthielt. Diese Prüfung bezog sich auf eine vordefinierte Faktenliste; wir haben nicht jede Behauptung in den Berichten geprüft.
Kosten & Recherchequalität
Grok CLI erreichte 0.699 bei $1,91 pro Aufgabe; die beiden Spitzenreiter kosteten zwischen $13,38 und $18,35, also das Sieben- bis Zehnfache. Grok lag 0.076 hinter Claude Code, mit einem Holm-korrigierten p-Wert von 0.006. Der Abstand von 0.091 zu Codex CLI war nach Korrektur mit 0.072 nicht signifikant.
Die beiden günstigeren Tools erzielten auch die niedrigsten Werte. Gemini CLI kostete $0,58 pro Aufgabe und erreichte 0.565; Exa Agent kostete $1,00 und erreichte 0.584, ein Unterschied mit einem Holm-korrigierten p-Wert von 0.958.
Codex CLI, Claude Code und Grok CLI liefen hier über Abonnements; ihre Zahlen sind API-Listenäquivalente. Siehe LLM-Preise für die Kosten dieser Abonnements und ihrer API-Tarife. Exa wurde als API-Nutzung abgerechnet, und $20,00 sind die tatsächlichen Ausgaben. Bei Gemini decken $0,58 pro Aufgabe nur Tokens ab und schließen die Such-Grounding aus, deren abrechenbare Abfrageanzahl nicht erfasst wurde.
Aufgabenzeit & Recherchequalität
Die beiden Spitzenreiter sind auch die beiden langsamsten. Die mediane Aufgabe von Codex CLI dauerte 42 Minuten für einen Wert von 0.790, und die von Claude Code 36 Minuten für 0.775, gegenüber 13 Minuten für Grok CLI bei 0.699. Die Laufzeit ordnet die übrigen nicht. Gemini CLI benötigte 1.5 Minuten länger als Exa Agent und erzielte 0.019 weniger.
Berichtslänge & geleistete Arbeit
Das deutlichste Gegenbeispiel dafür, dass länger besser ist, steht oben in der Tabelle. Im Medianbericht verwendet Claude Code 271 Wörter pro erfüllter Anforderung und Codex CLI 137, und die beiden liegen innerhalb von 0.015 zueinander. Exa Agent ist mit 91 Wörtern pro Anforderung am sparsamsten, bei einem Wert von 0.584.
Breite und Quellenqualität fallen auseinander. Der mediane Bericht von Claude Code zitiert 28 verschiedene Websites, gegenüber 16 bei Codex CLI, während ein höherer Anteil der Zitate von Codex CLI auf offizielle und primäre Seiten verweist: 34,8 % gegenüber 25,8 %. Gemini CLI zitiert am wenigsten dicht mit 4.2 Links pro 1.000 Wörtern.
Einige zitierte Links waren defekt. Wir zählten URLs, die einen Fehler 404 oder 410 zurückgaben oder ein ungültiges Format hatten. Die Gesamtzahlen über 20 Berichte pro Tool waren:
- Gemini CLI: 63
- Claude Code: 26
- Grok CLI: 16
- Codex CLI: 14
- Exa Agent: 14
Entwicklungen bei KI-Deep-Research-Tools
Deep Research erreicht die Gemini-API
Google hat Deep Research zur Gemini-API als Agenten hinzugefügt, den Entwickler direkt aufrufen, zusätzlich zu der Funktion, die bereits in der Gemini-App enthalten ist.1 Es wird in zwei Versionen angeboten: deep-research-preview-04-2026 für Geschwindigkeit und deep-research-max-preview-04-2026 für Vollständigkeit.
Google bepreist das Angebot pay-as-you-go auf Basis der zugrunde liegenden Models und Tools und schätzt eine typische Aufgabe auf $1 bis $3 für die Standardversion und $3 bis $7 für Max. Eine Aufgabe läuft im Hintergrund und ist auf 60 Minuten begrenzt; die meisten werden innerhalb von 20 Minuten abgeschlossen.
Exa indexiert wissenschaftliche Publikationen
Exa startete am 23. Juli 2026 eine semantische Suche über wissenschaftliche Arbeiten, die etwa 350 Millionen Publikationen und 30 Millionen Autoren abdeckt.2 Der Reiz besteht darin, einen Artikel aus einer vagen Erinnerung heraus zu finden und nicht über einen exakten Titel.
Exa meldet 86,4 % Recall bei seinem Retrieval-Benchmark, gegenüber 66,8 % für Perplexity und 28,0 % für Google Scholar. Das sind die eigenen Zahlen des Anbieters auf dem eigenen Benchmark, also sollte man sie eher als Richtung und nicht als endgültiges Ranking betrachten; derselbe Beitrag nennt zwei unterschiedliche mittlere Latenzen, was ein Grund ist, auf eine unabhängige Überprüfung zu warten.
Bright Data Deep Lookup beantwortet eine andere Frage
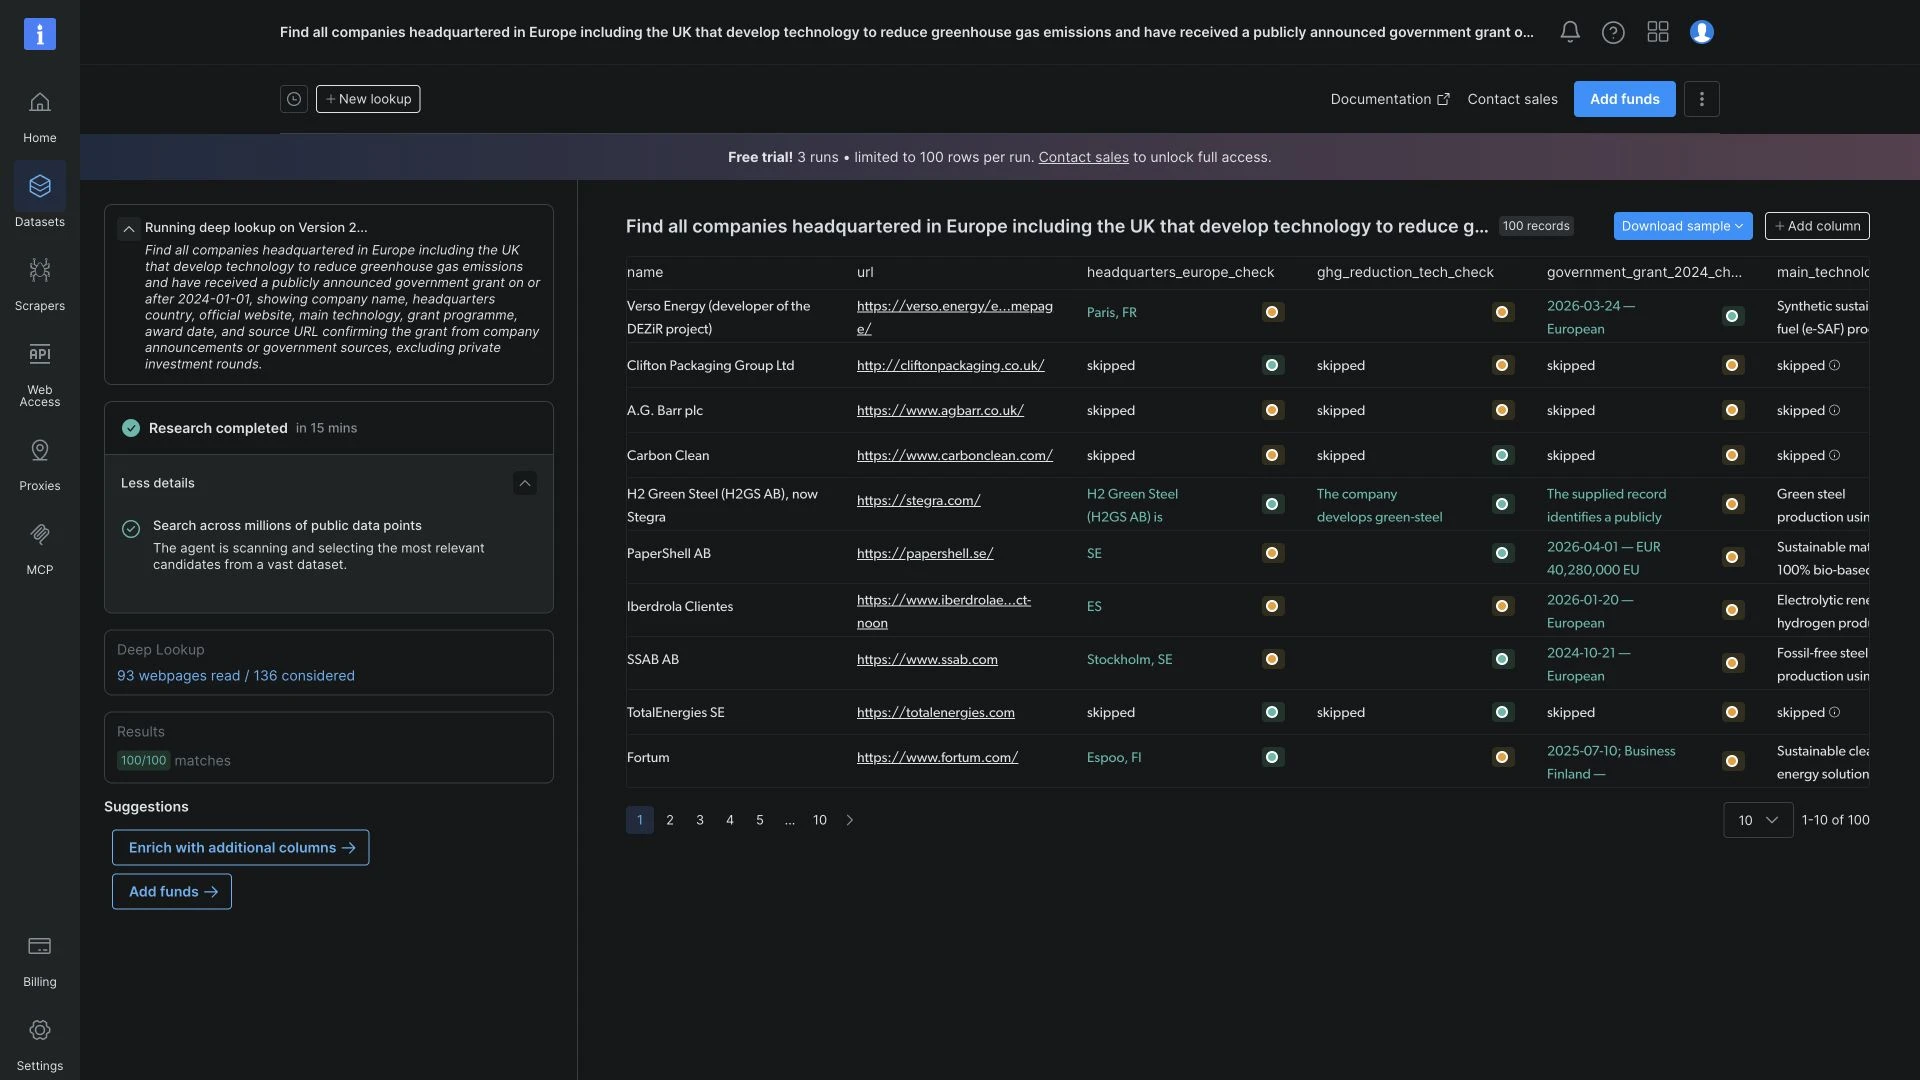
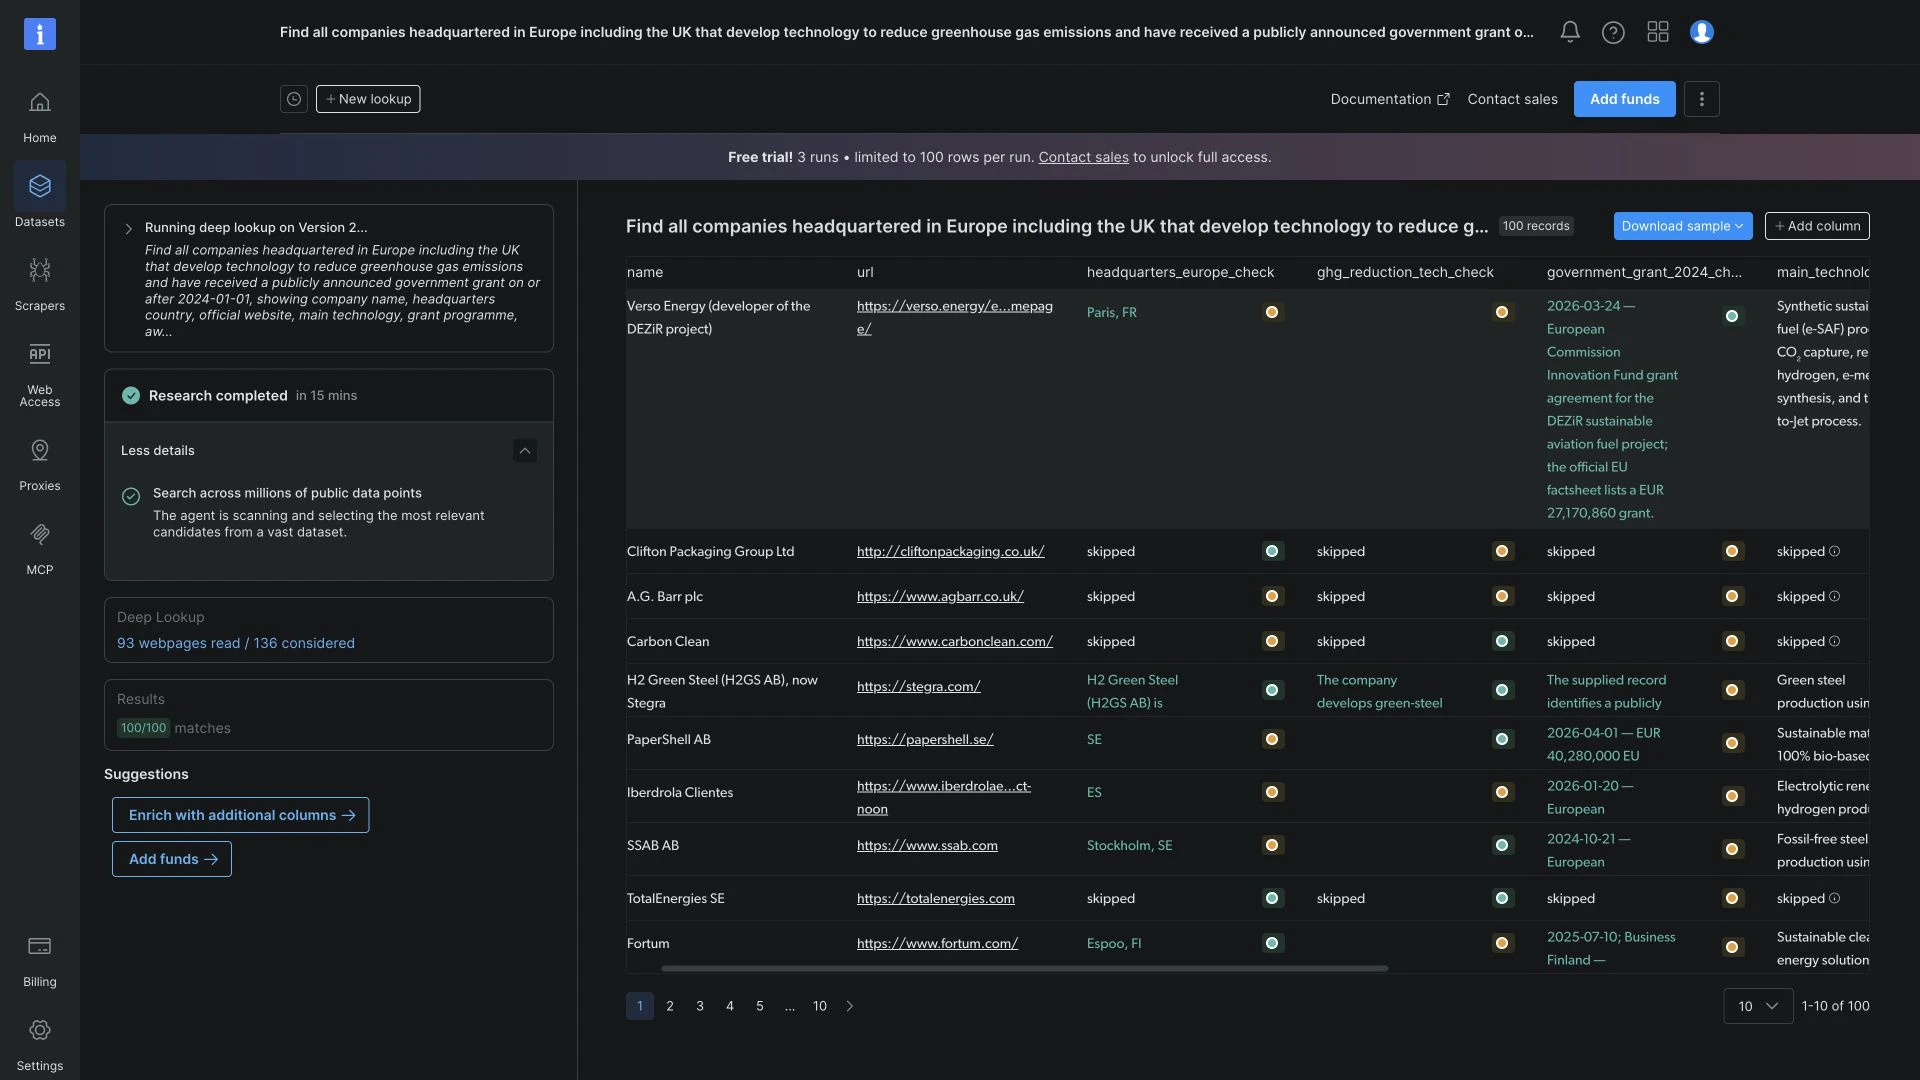
Deep Lookup von Bright Data liefert Entitätszeilen und keinen schriftlichen Recherchebericht. Jede Zeile steht für ein Unternehmen, eine Person oder ein Produkt. Nutzer können Listen für die Vertriebsansprache, Investmentrecherche oder Personalgewinnung erstellen.3
Wir suchten nach europäischen Unternehmen, die Technologien zur Reduzierung von Treibhausgasemissionen entwickeln. Die Abfrage schloss das Vereinigte Königreich ein und verlangte eine öffentlich angekündigte staatliche Förderung seit dem 1. Januar 2024.
Deep Lookup legte für jede Bedingung eine eigene Spalte an. Beim Aufklappen einer Zeile erschienen längere Erklärungen, mit farbigen Konfidenzindikatoren neben einzelnen Details. Die Oberfläche meldete einen Lauf von 15 Minuten, der das 100-Datensatz-Limit des Tests erreichte.
Zusätzliche Spalten enthielten Technologiebeschreibungen, Förderprogramme, Vergabedaten und Quellenlinks. Über die Links konnten wir Förderangaben mit den Ankündigungen abgleichen. Das Download-Menü bot die Formate CSV und JSON.3
Vertriebsteams können Deep Lookup nutzen, um Unternehmen in einer Zielbranche und -region zu finden. Investoren können Unternehmen identifizieren, die eine bestimmte Technologie entwickeln oder öffentliche Mittel erhalten. Personalvermittler können nach Fachkräften mit passenden Rollen und Erfahrungen suchen.3
Durch die Kombination mehrerer Suchbedingungen mit benutzerdefinierten Ergebnisspalten können Teams Listen nach ihren eigenen Kriterien erstellen und die Details an einem Ort vergleichen.
Das Deep Research-Tool von Azure bringt eine Warnung zur Datengrenze mit
Microsoft bietet Deep Research im Azure AI Foundry Agent Service an, erreichbar über die Python-, C#- und JavaScript-SDKs, und inzwischen unter der klassischen Agenten-Tooling dokumentiert.4
Der Grund, diese Seite vor einer Einführung zu lesen, steht auf der Seite selbst: Microsoft gibt an, dass die Bing-Suchanfrage, die Tool-Parameter und der Ressourcenschlüssel außerhalb der Azure-Compliance-Grenze an Grounding mit Bing Search übertragen werden. Teams, die Azure gewählt haben, damit nichts die Grenze verlässt, sollten prüfen, welche Teile eines Recherchelaufs diese Grenze überschreiten.
Vorteile von KI-Deep-Research-Tools
Ein quellenbasierter Recherchebericht in Minuten
In unserem Benchmark lagen die medianen Aufgabenzeiten je nach Tool zwischen 5.5 und 42 Minuten. Jeder Lauf erzeugte einen Recherchebericht mit Quellenlinks. Wir haben nicht gemessen, wie lange eine Person für dieselben Aufgaben bräuchte.
Die Anforderungswerte erreichten über die fünf Tools und 20 Briefings hinweg in der Spitze 0.790. Die Anforderungen decken den gesamten Bericht ab, von den gewünschten Abschnitten bis zur Berechnung in der Kostentabelle; ein Wert auf diesem Niveau bedeutet also, dass der größte Teil des Briefings in der geforderten Form beantwortet wurde.
Breite in einem Durchgang
Ein Recherche-Agent kann Material von mehreren Websites sammeln, für einen Anbietervergleich, eine Übersicht über Änderungen an einem Industriestandard oder eine Einführung in ein unbekanntes Forschungsthema. Der daraus entstehende Bericht gibt dem Leser einen ersten Überblick und Quellen für die weitere Untersuchung.
Ein bearbeitbarer Rechercheentwurf
Das Ergebnis ist ein Dokument, kann also bearbeitet, hinterfragt und erneut ausgeführt werden. Das ist ein anderer Arbeitsmodus als eine Seite mit Suchergebnissen. Ein fertig aussehendes Dokument ist zugleich das Risiko: Es lädt weniger zum Überprüfen ein als eine Liste von Links.
 Als bevorzugte Quelle hinzufügen
Herausforderungen und Grenzen von KI-Deep-Research-Tools
Die Fakten sind die Schwachstelle, nicht die Struktur
Die meisten Menschen wissen, dass ein LLM eine Antwort erfinden kann, und prüfen, was es erzeugt. Ein Deep-Research-Bericht lädt weniger zu solcher Prüfung ein, weil er lang, mit Quellen belegt und gut strukturiert ist und daher wie bereits verifiziert wirkt.
Ein Bericht kann die Anforderungen an Abschnitte, Tabellen und Berechnungen erfüllen und dennoch geforderte Fakten auslassen oder falsch darstellen.
Bevor Sie einen Bericht für eine Entscheidung nutzen, überprüfen Sie die relevanten Daten, Zahlen und regulatorischen Erkenntnisse anhand der Originalquellen.
Quellenangaben bedeuten nicht, dass die Quelle das aussagt
Unsere Quellenprüfung kontrollierte, ob Links funktionierten, und klassifizierte ihre Quellen. Sie prüfte nicht, ob jede Seite die mit ihr verknüpfte Behauptung stützte. Selbst ein funktionierender Link zu einer offiziellen Quelle erfordert diese Prüfung: Die Seite kann das Thema behandeln, ohne die konkrete Zahl oder Schlussfolgerung des Berichts zu stützen.
Länge ist keine Tiefe
Der Medianbericht von Claude Code enthielt 11.449 Wörter, gegenüber 5.734 bei Codex CLI, ohne statistisch signifikanten Unterschied bei den Anforderungswerten.
Leser sollten berücksichtigen, wie viel Material sie zusätzlich zur Laufzeit und zum Preis des Tools überprüfen müssen.
Verzerrung, Datenschutz und übermäßige Abhängigkeit
Trainingsdaten tragen die Verzerrungen dessen, was geschrieben wurde, und ein Syntheseschritt kann sie zu etwas verhärten, das wie ein Befund klingt. Bei einem gehosteten Tool verlässt jedes für den Kontext hochgeladene interne Dokument Ihre Systeme; das sollte vor der Routine anhand der Anbieterbedingungen geprüft werden. Das am schwersten messbare Risiko ist das letzte: Ein polierter Bericht, den niemand prüft, schwächt die Gewohnheit des Prüfens.
Methodik
Testumgebung
Wir führten die vier CLI-Tools auf einem Linux-Cloudserver aus und griffen über seine API auf Exa Agent zu. Jedes nutzte seine eigenen Recherche-Tools.
Aufgaben und Testverfahren
- Wir schrieben 20 Briefings zu Anbieterauswahl, Migrationsplanung, Kostenmodellen und regulatorischer Recherche. Jedes hatte ein Berichtsstichtag und mit Primärquellen erstellte Referenzantworten.
- Jedes Tool erhielt dieselben Aufgaben-Prompts. Wir bewerteten einen Bericht pro Tool und Aufgabe, was 100 Berichte über fünf Tools ergab.
- Wir legten die Prompts, Model-Konfigurationen und Bewertungsregeln vor der Produktion fest. Keine Aufgabe wurde erneut ausgeführt, um eine niedrige Punktzahl zu verbessern.
Bewertungskriterien
- Anforderungen: Jede Aufgabe hatte 42 bis 74 Bestanden/Nicht-bestanden-Prüfungen. Beispielsweise konnte eine Kostentabelle einen Einzelpreis und dessen Quelle verlangen.
- Strafen: Vordefinierte Mängel reduzierten die Punktzahl, etwa wenn ein Punkt an einer Stelle des Berichts als ungeklärt bezeichnet und an anderer als geklärt behandelt wurde. Punktzahl = max(0, (erfüllte Anforderungen − ausgelöste Strafen) / Gesamtanforderungen). Die Gesamtpunktzahl jedes Tools ist der Mittelwert seiner 20 Aufgabenpunktzahlen. Wir prüften auch eine alternative Formel, die 0.1 pro Strafe vom Anteil erfüllter Anforderungen abzieht, mit einer Mindestpunktzahl von null. Dies ist die Option „Alternative Strafe“ im Diagramm. Die Reihenfolge der fünf Tools blieb unverändert.
- Faktische Details: Eine separate Checkliste enthielt 434 geforderte Fakten. Ein Element erhielt nur dann eine Wertung, wenn der Bericht jedes geforderte Detail innerhalb der angegebenen Toleranz korrekt enthielt. Teilweise Antworten erhielten keine Wertung. Diese Prüfungen flossen nicht in den Anforderungswert ein. Die Faktenprozentsätze gewichten jede Aufgabe gleich. Die Zählungen fassen die Treffer über alle 434 Elemente zusammen.
Model-Juroren
- Vor der Bewertung entfernten wir identifizierende Metadaten und lokale Dateipfade. Beide Juroren erhielten denselben Bericht, dieselben Aufgabenregeln, Referenzfakten und Quellenprüfung.
- GPT-5.6 Sol und Grok 4.6 bewerteten jeden Bericht unabhängig. Für jede Anforderung und jede Strafe hielten die Juroren vor der Vergabe eines Bestanden/Nicht-bestanden-Urteils eine am Bericht festgemachte Begründung fest. Sie prüften auch jedes Faktenelement.
- Claude Opus 5 löste Meinungsverschiedenheiten anhand derselben Belege. Entscheidungen, bei denen die ersten beiden Juroren übereinstimmten, blieben unverändert. Die beiden ersten Juroren stimmten bei 93,3 % der Regelurteile und 89,1 % der Faktenentscheidungen überein.
Statistische Analyse
Wir verwendeten gepaarte Tests über die 20 Aufgaben hinweg und wendeten die Holm-Korrektur über alle zehn paarweisen Tool-Vergleiche an. Wir schätzten 95 %-Rangintervalle durch 10.000-faches Resampling der Aufgaben.
Einschränkungen
- Ein Bericht pro Tool und Aufgabe misst nicht, wie stark die Antworten desselben Tools zwischen den Durchläufen schwanken.
- Wir prüften die Verfügbarkeit und die Art der Quellen, verifizierten aber nicht, ob jede zitierte Seite die zugehörige Behauptung stützte. Prüfungen, die diese Verifikation erforderten, erhielten über alle Tools hinweg ein Nicht-bestanden-Urteil: Positive Prüfungen brachten keine Wertung, und negative Prüfungen lösten keine Strafe aus.
- Wir verfeinerten acht Aufgaben nach einem früheren Pilottest. Die Briefings bleiben für künftige Auswertungen unveröffentlicht.
FAQs
KI-gestützte Forschung nutzt KI-Tools, um Informationen zu finden, zu analysieren und zusammenzufassen. Ein Deep-Research-Tool geht über eine Chat-Antwort hinaus: Es läuft mehrere Minuten, öffnet viele Quellen und erstellt einen Bericht mit Quellenangaben.
Worin es nach unseren eigenen Messungen gut ist, ist die Form der Antwort. Worin es schwach ist, sind die konkreten Einzelheiten. Das stärkste der fünf von uns getesteten Tools reproduzierte 202 der 434 geforderten Werte, Daten und Namen, das schwächste 89.
Deshalb muss ein Deep-Research-Bericht überprüft werden, bevor etwas veröffentlicht wird. Der Bericht kann fertig aussehen, auch wenn die Zahlen falsch sind. Verwandte Benchmarks: KI-Coding.
KI-Tools können bei verschiedenen Aspekten von Literaturübersichten helfen, etwa beim Identifizieren relevanter Arbeiten, beim Zusammenfassen zentraler Ergebnisse und beim Strukturieren von Forschungsthemen. Diese Tools können große Mengen wissenschaftlicher Literatur schnell verarbeiten und Forschern helfen, Lücken oder Muster über Studien hinweg zu erkennen. KI kann jedoch menschliches Urteilsvermögen bei der Bewertung der Quellenqualität, der Synthese komplexer Argumente oder der kritischen Analyse nicht vollständig ersetzen. Forscher müssen KI-generierte Inhalte weiterhin prüfen, verifizieren und interpretieren, um Genauigkeit und akademische Strenge in ihren Literaturübersichten zu gewährleisten.
KI-Tools können bei Datenanalyse und statistischer Arbeit helfen, indem sie Datasets bereinigen, statistische Tests durchführen, Visualisierungen erstellen und Muster in großen Datasets erkennen. Diese Tools können geeignete statistische Methoden auf Grundlage des Datentyps und der Forschungsfragen vorschlagen. Forscher müssen jedoch den Kontext ihrer Daten verstehen und die Ergebnisse validieren, da KI domänenspezifische Nuancen übersehen oder unangemessene Annahmen treffen kann.
Die meisten modernen KI-Recherche-Tools verwenden natürliche Sprachschnittstellen, die keine Programmierkenntnisse erfordern. Grundlegende Datenkompetenz und ein Verständnis grundlegender Forschungskonzepte helfen Nutzern jedoch, bessere Abfragen zu formulieren und Ergebnisse effektiver zu interpretieren. Fortgeschrittene Anwendungen können für benutzerdefinierte Analysen oder spezialisierte Workflows von technischem Wissen profitieren.
Öffnen Sie jede Quelle, die für eine wichtige Behauptung verwendet wurde, und prüfen Sie, ob sie die Zahlen, Daten und Schlussfolgerungen des Berichts stützt. Bestätigen Sie, dass die Quelle auf den relevanten Zeitraum und Kontext zutrifft. Die Faktencheckliste unseres Benchmarks deckte vordefinierte Details ab, daher belegen ihre Werte nicht die Genauigkeit jeder Behauptung in einem Bericht.
Zitieren Sie diesen Benchmark
Wählen Sie das Format, das zu Ihrem Veröffentlichungsort passt. Wenn Sie die Link-Version in Ihr CMS einfügen, bleibt der Backlink erhalten.
@misc{kalelioglu2026,
  author = {Kalelioğlu, Berk},
  title  = {{KI-Deep-Research: Codex vs Claude vs Grok vs Exa}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/ai-deep-research}},
  note   = {AIMultiple. Abgerufen am 11. September 2026}
}Ergebnisse und Zeitstempel von 20 Datenpunkten. Laden Sie die Zusammenfassungsdaten aus den Diagrammen und Tabellen dieses Artikels als ZIP-Datei herunter, die 3 CSV-Dateien und eine README enthält.
Möchten Sie die granularen Daten dahinter? Premium beitreten
Änderungsprotokoll
8 AktualisierungenZusammenfassung zu Agenten vs. Deep-Research-Modelle ersetzt durch den Befund, dass Agenten deren Genauigkeit zu geringeren Kosten erreichen.
Abschnitt „Agenten vs. Deep-Research-Modelle“ hinzugefügt, der sechs Tools über fünf Aufgaben vergleicht.
Ein Benchmark-Methodikabschnitt hinzugefügt, der die fünf Forschungsaufgaben, Ground-Truth-Quellen, Bewertung und Tool-Schnittstellen beschreibt.
Der Abschnitt „AI Deep Research Benchmark“ wurde um den DR-2T (Deep Research 2 Task) Bench erweitert.
Referenzlinks





Seien Sie der Erste, der kommentiert
Ihre E-Mail-Adresse wird nicht veröffentlicht. Alle Felder sind erforderlich. Kommentare werden in ihrer Originalsprache belassen.