


LLM-Preise: Top 15+ Anbieter im Vergleich

Wir verfolgen die Einführungspreise von mehr als 160 LLMs, von GPT-3.5 Turbo im März 2023 bis zu den neuesten Veröffentlichungen, gruppiert nach Größenklasse. Wir vergleichen außerdem die API-Preise aktueller Modelle mit ihren Benchmark-Ergebnissen und betrachten die Abonnementpläne der wichtigsten Anbieter.
LLM-Einführungspreistrends
- Claude Opus Einführungspreise fielen von $30,00 (Opus 4.1, August 2025) auf $8,00 (Opus 5.5, September 2026).
- Claude Fable 5 wurde im Juni 2026 zu $20,00 eingeführt, doppelt so teuer wie Claude Opus 4.8 zwei Wochen zuvor. OpenAIs GPT-6 Astra zog im September zu $20,00 nach.
- GPT-6 Sol wurde im September 2026 zu $4,00 eingeführt, 64 % unter dem Preis von GPT-5.6 Sol von $11,25 im Juli. GPT-6 Luna startete zu $0,20, gegenüber $2,25 für GPT-5.6 Luna.
- Der mittlere Einführungspreis kleiner geschlossener Modelle stieg von $0,53 im Jahr 2024 auf $0,85 im Jahr 2025. 2026 wurden Gemini 3.5 bis 3.8 Flash zu $3,00 bis $3,38 eingeführt.
- Im Jahr 2025 lag der mittlere Einführungspreis großer Open-Weight-Modelle unter einem Viertel des Medians für geschlossene Modelle der Mittelklasse. Moonshots Kimi K3 wurde im Juli 2026 zu $6,00 eingeführt, über dem Preis von Claude Sonnet 5 von $4.00.
Die Preise gelten pro eine Million Tokens, gemischt aus drei Teilen Eingabe zu einem Teil Ausgabe, und schließen zeitlich begrenzte Aktionen aus. Open-Weight-Modelle haben öffentlich zugängliche Gewichte; für Modelle ohne eigene API wird der Preis eines Hosting-Anbieters um den Einführungszeitpunkt herangezogen. Neue Markteinführungen können die Durchschnittswerte des laufenden Quartals noch verändern.
LLM-API-Preisbewertung
Es gibt zwei Möglichkeiten, für einen LLM zu bezahlen: Abonnementpläne mit pauschaler LLM-Preisgestaltung der großen Anbieter oder ein API-Modell mit nutzungsbasierter Abrechnung nach Token-Verbrauch.
Klicken Sie auf die Modellnamen, um deren Benchmark-Ergebnisse, reale Latenz und Preise anzuzeigen und die Effizienz und Kosteneffektivität jedes Modells zu bewerten.
Ranking: Modelle werden nach ihrer durchschnittlichen Platzierung über alle Benchmarks hinweg eingestuft.
Sie können die Halluzinationsraten und die Reasoning-Leistung führender LLMs in unseren Benchmarks überprüfen.
Vergleich der LLM-Abonnementpläne
Nicht-technische Nutzer bevorzugen möglicherweise die Benutzeroberfläche statt der API. Im Jahr 2026 bündeln die meisten Anbieter-Abonnements weit mehr als nur eine Chat-Oberfläche. Coding-Agenten wie Claude Code, Codex, Kimi Code und Mistral Vibe sind in Pro-Tarifen enthalten. Für Entwickler und Vielnutzer ersetzt das passende Abonnement von $10–$200 oft ein separates IDE-Abo, ein Budget für die tokenbasierte API sowie ein Video- oder Recherchetool in einem.
OpenAI
Der Free-Tarif umfasst unbegrenzte alltägliche Text-Chats mit GPT-5.6 Luna, den Standard-Sprachmodus, begrenzte Uploads und die grundlegende Bilderstellung. Kontextbezogene Werbung erreicht im August 2026 etwa 40 Märkte, darunter die USA und den größten Teil Europas, und erscheint nur in den Tarifen Free und Go.
- ChatGPT Go ($8/Monat) ist ein kostengünstiger Tarif, der Werbung enthalten kann. Text-Chats sind wie bei Free unbegrenzt; das Upgrade bietet höhere Limits für Datei-Uploads, Bilderstellung, Sprache und Speicher – alles mit GPT-5.6 Luna.
- ChatGPT Plus ($20/Monat) umfasst erweiterte Nutzungslimits, Zugriff auf GPT-5.6 Sol, Terra und Luna, den erweiterten Sprachmodus, den Codex-Agenten, die Bilderstellung und Early-Access-Funktionen.
Der Pro-Tarif hat seit April 2026 zwei Stufen:
- ChatGPT Pro ($100/Monat) bietet dieselbe Modellpalette wie die $200-Stufe (einschließlich GPT-5.6 Sol) mit etwa 5x Plus-Nutzungslimits.
- ChatGPT Pro ($200/Monat) bietet die höchsten individuellen Nutzungslimits (etwa 20x Plus), das maximale Deep-Research-Kontingent, erweiterten Sprachmodus mit Video und Bildschirmfreigabe, Codex mit maximaler Nutzungssteigerung und Sora.
Beide Pro-Stufen umfassen priorisierten Zugriff während der Spitzenzeiten. Die Codex-Preise in Plus, Pro und Business wurden im April 2026 von einer Abrechnung pro Nachricht auf eine an API-Tokens ausgerichtete Nutzung umgestellt.
ChatGPT Work, der Agent von OpenAI für langlaufende, mehrstufige Projekte (eingeführt am 9. Juli 2026), ist in den kostenpflichtigen Tarifen enthalten, und die Desktop-App, die Chat, Work und Codex bündelt, ist in jedem Tarif verfügbar, einschließlich Free.
- Business-Tarif ($20/Nutzer/Monat jährlich oder $25/Nutzer/Monat monatlich) ist der Tarif von OpenAI für kleine und mittelgroße Teams (früher ChatGPT Team, im August 2025 umbenannt). Er bietet höhere Nachrichtenlimits, eine Admin-Konsole, SSO, vom Training ausgeschlossene Teamdaten und gemeinsame Guthabenpools für erweiterte Funktionen. Gebündelte Apps: Codex mit gemeinsam genutzten Workspace-Guthaben. Nur-Codex-Plätze wurden am 24. Juni 2026 für neue Workspaces geschlossen; OpenAI hat Premium-Plätze zu $100/Nutzer/Monat jährlich ($125 monatlich) mit 5x Standardnutzung angekündigt. Der Tarif erfordert mindestens 2 Plätze.
- Der Enterprise-Tarif (individuelle Preisgestaltung) bietet Hochgeschwindigkeits-Modellzugriff, erweiterte Kontextfenster, Datenkontrollen auf Unternehmensniveau, Domänenüberprüfung, Analysen und Audit-Logs. Gebündelte Apps: Codex mit gemeinsamem Guthabenpool und optionalen Nur-Codex-Plätzen.
Anthropic (Claude)
Der Free-Tarif umfasst Web- und Mobile-Zugriff, grundlegende Analysen, Zugriff auf Claude Sonnet 5 und Haiku sowie das Hochladen von Dokumenten. Die tägliche Nutzung ist begrenzt, und die Modelle Opus und Fable sind nicht verfügbar.
- Pro-Tarif ($20/Monat oder $17/Monat bei jährlicher Abrechnung) bietet Zugriff auf Opus 5, Sonnet 5 und Haiku, etwa 5x mehr Nutzung als Free, Projektorganisation und priorisierten Zugriff zu Spitzenzeiten. Fable 5 ist nicht Teil der Pro-Nutzungslimits; es wird über nutzungsbasierte Guthaben zu API-Tarifen abgerechnet. Gebündelte Apps: Claude Code (der Coding-Agent von Anthropic im Terminal und in der IDE), Cowork, Claude Design und Claude für Microsoft 365 – alle nutzen denselben Nutzungspool wie der Chat.
- Max-5x-Tarif ($100/Monat) bietet etwa 5x mehr Nutzung als Pro, priorisierten Zugriff auf die neuesten Funktionen und Modelle sowie vollständigen Claude Code-Zugriff in der höheren Max-Nutzungsstufe.
- Max-20x-Tarif ($200/Monat) bietet etwa 20x mehr Nutzung als Pro, maximalen priorisierten Zugriff und vollständigen Claude Code-Zugriff. Konzipiert für tägliche Power-User, die Claude Code-Workloads ausführen. Beide Max-Stufen enthalten Fable 5, das teuerste Modell von Anthropic; dessen Nutzung kann bis zur Hälfte des wöchentlichen Nutzungslimits des Tarifs beanspruchen.
Der Team-Tarif bietet zwei Platztypen und unterstützt 2 bis 150 Mitglieder:
- Standard-Platz: $20/Nutzer/Monat jährlich ($25/Nutzer/Monat monatlich). Enthält Basisfunktionen, Standard-Nutzungslimits und Claude-Code-Zugriff.
- Premium-Platz: $100/Nutzer/Monat jährlich ($125/Nutzer/Monat monatlich). Alles aus Standard sowie höhere Nutzungslimits für Power-User mit intensiveren Claude-Code-Workloads.
Gebündelte Apps: Claude Code und Cowork sind in jedem Team-Platz enthalten (Standard und Premium); der Unterschied liegt im Nutzungskontingent, nicht beim Zugriff. Beide Platztypen umfassen zentrale Abrechnung, Tools für die Zusammenarbeit und Admin-Kontrollen.
- Enterprise-Tarif ($20/Platz/Monat zuzüglich Nutzung zu API-Tarifen in der Self-Serve-Stufe; individuelle Preise über den Vertrieb) bietet erweiterte Kontextfenster, SSO, Domain-Erfassung, rollenbasierte Zugriffe, SCIM, Audit-Logs und Datenintegrationen. Gebündelte Apps: In neuen und Self-Serve-Enterprise-Tarifen sind Claude Code und Cowork in jedem Platz enthalten; ältere Enterprise-Verträge unterscheiden möglicherweise zwischen Nur-Chat-Plätzen und Chat + Claude-Code-Plätzen mit nutzungsbasierter Abrechnung.
Google (Gemini)
Der free-Tarif bietet Zugriff auf Gemini 3.6 Flash und unterschiedlichen Zugriff auf Gemini 3.1 Pro, grundlegende Bilderstellung, Deep Research, Gemini Live, Canvas und Gems. Gebündelte Apps: Gemini Notebook (früher NotebookLM) und Flow mit begrenztem Nano-Banana-Pro-Zugriff.
Google verwendet regionale Preise, daher können die Preise je nach Region variieren.
- Google KI Plus ($4,99/Monat, USA) ist der kostenpflichtige Einstiegstarif mit dem 2x der Free-Nutzungslimits. Gebündelte Apps: mehr Zugriff auf Gemini 3.1 Pro im Chat, Bilderstellung mit Nano Banana Pro, Videogenerierung mit Gemini Omni Flash, 200 Flow-Guthaben, Gemini Notebook mit mehr Audio-Overviews, Gemini in Gmail, Docs und Vids sowie Early-Access-Gemini in Chrome. Enthält 400 GB Speicher.
- Google KI Pro ($19,99/Monat, USA) bietet das 4x der Free-Nutzungslimits und 5 TB Speicher. Gebündelte Apps: Jules (asynchroner Coding-Agent), Google Antigravity (agentische Entwicklungsplattform), erweiterte KI-Studio-Limits, $40/Monat Google Cloud-Guthaben, Gemini Notebook mit 5x Audio-Overviews, Deep Research, 1.000 Flow-Guthaben, YouTube Premium Lite und Google Home Premium (Standard-Tarif).
- Google KI Ultra (USA) kostet $99,99/Monat für das 5x-KI-Pro-Nutzungslimit oder $199,99/Monat für 20x. Gebündelte Apps: Deep-Think-Reasoning, Gemini Agent (nur USA), Gemini Spark, Project Genie (interaktives Weltmodell), Jules mit den höchsten Limits, erstklassiges Antigravity, 10.000 oder 25.000 Flow-Guthaben, Google Home Premium (Advanced-Tarif) und ein individuelles YouTube-Premium-Abo. Der Speicher beginnt bei 20 TB.
Microsoft Copilot
Der free-Tarif (Copilot Chat) ist für alle Microsoft-Entra-Nutzer mit einem berechtigten Microsoft-365-Abonnement ohne Zusatzkosten verfügbar. Er umfasst grundlegende Copilot-Chats in Microsoft-Apps, jedoch ohne die tieferen In-Dokument-Funktionen.
- Microsoft 365 Premium ($19,99/Monat oder $199,99/Jahr) ist jetzt der Copilot-Tarif für Verbraucher. Er bündelt die Office-Apps, bis zu 6 TB Speicher (je 1 TB für bis zu sechs Personen) und die höchsten Copilot-Limits für Verbraucher; die KI-Funktionen gelten nur für den Abonnementinhaber. Das frühere Copilot Pro ($20/Monat) ist für Neukäufe geschlossen, und bestehende Abonnenten können es behalten oder zu Premium wechseln.
- Microsoft 365 Copilot Business ($21/Nutzer/Monat jährlich; $18/Nutzer/Monat im ersten Jahr bei Käufen bis zum 30. September 2026; $25,20/Nutzer/Monat monatlich) fügt Copilot in Microsoft-365-Apps, Teams-Integration und Admin-Kontrollen hinzu. Gebündelte Apps: Copilot Studio Lite zum Erstellen leichtgewichtiger Agenten, Copilot in SharePoint und Copilot Pages für gemeinsame Entwürfe. Begrenzt auf Organisationen mit bis zu 300 Nutzern.
- Microsoft 365 Copilot Enterprise ($30/Nutzer/Monat jährlich oder $31,50/Nutzer/Monat bei monatlicher Abrechnung; erfordert eine geeignete Microsoft-365-Lizenz) bietet erweiterte Sicherheit, Compliance und Analysen zusätzlich zu den Business-Funktionen. Gebündelte Apps: Agentenbau mit Copilot Studio (Arbeitsdaten und vorgefertigte Agenten können nutzungsbasiert abgerechnet werden; eigenständiges Copilot Studio wird separat verkauft), Copilot in Microsoft Purview und Intune für IT- und Sicherheitsworkflows sowie Governance für eingesetzte Agenten.
xAI (Grok)
Der free-Tarif bietet begrenzten Zugriff auf Grok.
- SuperGrok Lite ($10/Monat) ist der kostenpflichtige Einstiegstarif. Er umfasst 2x längere Konversationen, erhöhte Ratenlimits sowie KI-Bild- und Videoerstellung. Gebündelte Apps: Grok Build (der App-Building-Agent von xAI, seit August 2026 auch kostenlos im Web) und Grok Imagine für Bild- und Videogenerierung.
- SuperGrok ($30/Monat oder $300/Jahr) umfasst verbessertes Reasoning mit Grok 4.6, 5x längere Konversationen, längere Datei-Uploads, den Voice-Modus für gesprochene Chats und 20x mehr Grok-Imagine-Bild- und Videogenerierungen, einschließlich HD-Videos mit 720p und 30 Sekunden.
- SuperGrok Plus ($100/Monat) bietet zusätzlich Zugriff auf Grok Bot, 1080p-Videogenerierung, höhere Nutzungslimits, schnellere Antworten und priorisierten Zugriff.
- SuperGrok Heavy ($300/Monat) bietet alles aus Plus, ein Agententeam für paralleles Arbeiten, maximale Ratenlimits, frühe Vorschauen auf kommende xAI-Funktionen und ein X-Premium+-Abo. Im Juli 2026 veröffentlichte xAI außerdem Add-ins für Excel, Outlook und Google Workspace sowie geplante Automations; die meisten sind kostenlos, während das Outlook-Add-in und E-Mail-ausgelöste Automations zahlenden Nutzern vorbehalten sind.
Grok ist außerdem in X-Abonnements gebündelt: X Premium ($8/Monat) ist der günstigste kostenpflichtige Zugang zu Grok in der X-App und umfasst den verifizierten Status sowie weniger Werbung. X Premium+ ($40/Monat) entfernt Werbung in ganz X und bietet die höchsten Grok-Nutzungslimits sowie die vollständige Monetarisierung für Creator.
Moonshot KI (Kimi)
Kimis Verbrauchertarife sind nach musikalischen Tempobezeichnungen benannt, von langsam nach schnell. Internationale Preise sind in USD; Nutzer in China zahlen in CNY zu niedrigeren Tarifen. Seit August 2026 stehen Neukäufe auf der Warteliste. Die Preisseite kündigt kommende Tarife an, die Kimi- und Kimi-Code-Leistungen trennen, und Moonshots Mitteilung vom 20. Juli nennt Kapazitätsengpässe bei der Rechenleistung als Grund für den verzögerten Start, vier Tage nach der K3-Veröffentlichung. Bestehende Abonnenten behalten ihre Tarife und können sie verlängern.
- Adagio (Free) bietet unbegrenzte grundlegende Konversationen mit 6 Agentennutzungen, begrenzte Deep-Research-Abfragen und grundlegende Aufgaben mit dem OK-Computer-Agenten.
- Moderato ($19/Monat) fügt Kimi K3 im Chat und bei Agentenaufgaben sowie erweiterte Deep-Research-Sitzungen hinzu. Gebündelte Apps: Kimi Code (terminalorientierter KI-Coding-Agent; geschätzt 300 bis 1.200 Anfragen pro 5-Stunden-Fenster, abgerechnet aus dem gemeinsamen Guthabenpool) sowie Autorenwerkzeuge für Slides und Websites.
- Allegretto ($39/Monat) bietet höhere Nutzung bei allem aus Moderato. Gebündelte Apps: Agent Swarm (parallele Orchestrierung von Subagenten, in diesem Tarif bis zu 4 parallele Teilaufgaben), Kimi-Claw-Cloud-Bereitstellung für heterogene Agentengruppen mit persistentem Speicher und das 2x der Agentenguthaben von Moderato.
- Allegro ($99/Monat) bietet 5x Agentenguthaben, Agent Swarm mit bis zu 8 parallelen Teilaufgaben und K3-Chat mit bis zu 1M Token Kontext.
- Vivace ($199/Monat) bietet 10x Agentenguthaben, 4 gleichzeitige Aufgaben, Agent Swarm mit bis zu 8 parallelen Teilaufgaben und K3-Chat mit bis zu 1M Token Kontext, ausgerichtet auf intensive Recherche- und agentische Workloads.
Die Mitgliedschaft umfasst Kimi-Code-API-Schlüssel für die Verwendung in Coding-Tools von Drittanbietern; die separate Kimi-Open-Platform-API wird pro Token abgerechnet.
MiniMax
MiniMax vertreibt einen einheitlichen Token-Plan auf Basis seiner Modelle M3 und M2.7. Er ersetzte Mitte 2026 die früheren separaten Agentenguthaben- und Coding-Pläne.
MiniMax Token-Plan (ein Kontingent für Agenten, Coding und multimodale Arbeiten):
- Plus ($20/Monat): 5-Stunden-Rolling- und Wochenkontingentfenster, genug für 3 bis 4 parallel laufende Coding-Agenten; für persönliche Projekte und Prototyping.
- Max ($50/Monat): dieselben Fenster für 4 bis 5 parallele Agenten; für tägliches Coding mit Agenten und multimodale Arbeiten.
- Ultra ($120/Monat): 6 bis 7 parallele Agenten; für intensive Agenten-Workflows und lange Sitzungen.
- Guthabenpakete: $5 für 5.000 Guthaben, $25 für 25.000, $100 für 100.000 (1.000 Guthaben = $1, gültig 365 Tage), zusätzlich zu jedem Tarif nutzbar.
Der Token-Plan deckt die gesamte Modellpalette (M3, M2.7, Bild und Sprache) mit einem einzigen Kontingent ab und ist damit einer der günstigsten Wege zu einem Frontier-Coding-Modell, wenn er mit einer CLI wie Cline oder Kilo Code kombiniert wird.
Mistral AI
Der Free-Tarif von Mistral Vibe (früher Le Chat) umfasst Web-Browsing, grundlegende Dateianalyse, Bilderstellung, begrenzte Coding-Sitzungen, 100+ Konnektoren und $10/Monat API-Guthaben.
- Pro-Tarif ($14,99/Nutzer/Monat) umfasst mehr Nachrichten und Websuchen, mehr erweitertes Denken und Deep-Research-Berichte, 15 GB Dokumentenspeicher, bis zu 1.000 Projekte, Bilderstellung und $30/Monat API-Guthaben. Gebündelte Apps: der Code-Modus von Mistral Vibe in der CLI, IDE oder im Web, mit nutzungsbasierter Abrechnung über das enthaltene Kontingent hinaus. Verifizierte Studierende erhalten Pro für $5,99/Monat.
- Team-Tarif ($24,99/Nutzer/Monat) umfasst alles aus Pro mit bis zu 30 GB Speicher pro Nutzer, zentraler Abrechnung, rollenbasierter Zugriffskontrolle, Domänennamen-Überprüfung und Datenexport. Gebündelte Apps: Mistral Vibe in der Team-Nutzungsstufe mit gemeinsamen Admin-Kontrollen.
- Enterprise-Tarif (individuelle Preisgestaltung) bietet sichere Bereitstellungsoptionen, einschließlich Self-Hosted und Private Cloud, SAML SSO, Audit-Logs, Premium-Support und detaillierte Analysen. Gebündelte Apps: Mistral Vibe mit On-Premise-Bereitstellungsoptionen für regulierte Workloads.
DeepSeek
DeepSeek bietet keine herkömmlichen Abonnementpläne an. Der Web- und Mobile-Chat-Zugriff auf die neuesten Modelle (derzeit DeepSeek V4-Flash und V4-Pro) ist für alle Nutzer kostenlos, mit fairer Nutzungsdrosselung.
Der API-Zugriff ist Pay-per-Token mit Spitzen- und Nebenzeitentarifen seit dem 16. August 2026. Außerhalb der Spitzenzeiten kostet V4-Flash $0,22 pro eine Million Eingabe-Tokens (Cache-Miss) und $0,66 pro eine Million Ausgabe-Tokens; die Spitzenpreise sind doppelt so hoch ($0,44 und $1,32). V4-Pro kostet außerhalb der Spitzenzeiten $0,66 und $1.98. Cache-Hits kosten etwa 3 % des Miss-Preises, und die Spitzenzeiten sind 01:00-04:00 und 06:00-10:00 UTC an Wochentagen.
DeepSeek ist auch in den Bereich Agenten-Tooling eingestiegen. DeepSeek Harness, ein Open-Source-Toolkit auf Plugin-Basis zum Erstellen und Ausführen von KI-Agenten, befindet sich mit öffentlichem Quellcode in der Entwicklervorschau. Es hat keinen eigenen Preis und ist modellunabhängig; die Nutzung wird über die API des jeweils aufgerufenen Modells abgerechnet.
Meta (Muse Spark)
Meta KI bleibt in WhatsApp, Instagram, Facebook, Messenger, der Meta KI-App und der Ray-Ban-Meta-Brille kostenlos; angetrieben wird es von Muse Spark (eingeführt am 8. April 2026, jetzt in Version 1.2). Meta hat mit begrenzten Tests für kostenpflichtige Meta One-Abonnements begonnen. Die Tarife Plus und Premium erhöhen das monatliche KI-Nutzungskontingent und den Zugriff auf den Thinking-Modus; sie werden mit $7,99 und $19,99 pro Monat angegeben.1
Die Meta-Model-API befindet sich in der öffentlichen Vorschau, ist self-serve und mit dem OpenAI-SDK kompatibel. Die Pay-as-you-go-Preise für Muse Spark 1.2 beginnen bei $1,25 pro eine Million Eingabe-Tokens und $4,25 pro eine Million Ausgabe-Tokens mit einem Kontextfenster von 1M Tokens. Muse Code, ein terminalbasierter Coding-Agent, wurde am 5. August 2026 in der Beta veröffentlicht.
LLM-Preisgestaltung verstehen
Tokens: Die grundlegende Einheit der Preisgestaltung
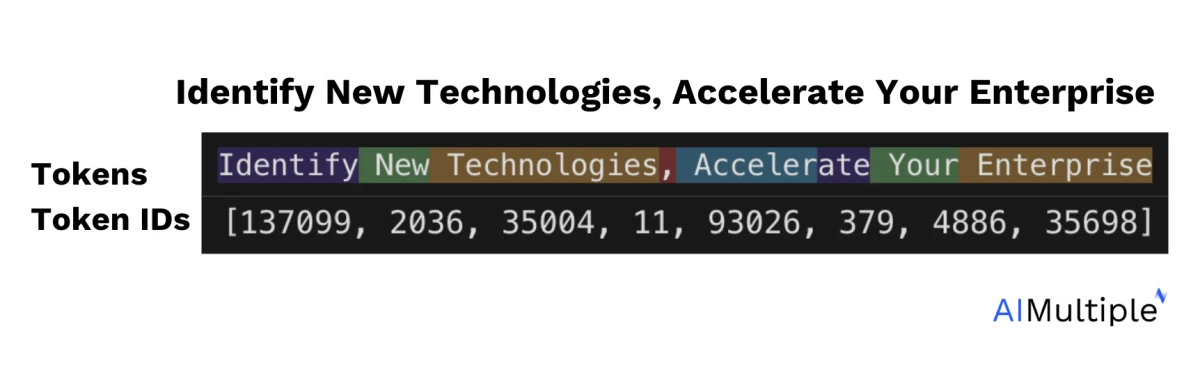
Abbildung 1: Beispiel für die Tokenisierung mit dem GPT-4o- und GPT-4o-mini-Tokenizer für den Satz „Identify New Technologies, Accelerate Your Enterprise.“2
Obwohl Anbieter unterschiedliche Preisstrukturen anbieten, ist die Abrechnung pro Token am gebräuchlichsten. Die Tokenisierungsmethoden unterscheiden sich je nach Modell; Beispiele sind:
- Byte-Pair Encoding (BPE): Zerlegt Wörter in häufige Subworteinheiten und gleicht so Vokabulargröße und Effizienz aus.3
- Beispiel: „unbelievable“ → [„un“, „believ“, „able“]
- WordPiece: Ähnlich wie BPE, optimiert jedoch die Wahrscheinlichkeit für das Sprachmodell; wird in BERT verwendet.4
- Beispiel: „tokenization“ → [„token“, „##ization“]. „token“ ist ein eigenständiges Wort; „##ization“ ist ein Suffix.
- SentencePiece: Tokenisiert Text ohne Leerzeichen zu verwenden und eignet sich für mehrsprachige Modelle wie T5.5
- Beispiel: „natural language“ → [„ natural“, „ lan“, „guage“] oder [„ natu“, „ral“, „ language“].
Bitte beachten Sie, dass die genauen Subwörter von den Trainingsdaten und dem BPE-/WordPiece-Prozess abhängen. Um diese Tokenisierungsmethoden besser zu verstehen, schauen Sie sich das folgende Video an:
Nachdem Sie die Tokenisierung verstanden haben, kann ein Durchschnittspreis anhand der Token-Länge des Projekts geschätzt werden. Tabelle 2 beschreibt Token-Bereiche nach Inhaltstyp, darunter UI-Prompts, E-Mail-Snippets, Marketing-Blogs, detaillierte Berichte und Forschungsarbeiten, und weist darauf hin, dass die Token-Anzahl je nach Modell variiert. Sobald ein Modell gewählt wurde, kann sein Tokenizer verwendet werden, um die durchschnittliche Token-Anzahl für den Inhalt zu schätzen.
Tabelle 2: Typische Inhaltstypen, ihre Größenbereiche und Überlegungen für Unternehmen (Bereiche sind Schätzungen und können variieren).
Auswirkungen des Kontextfensters
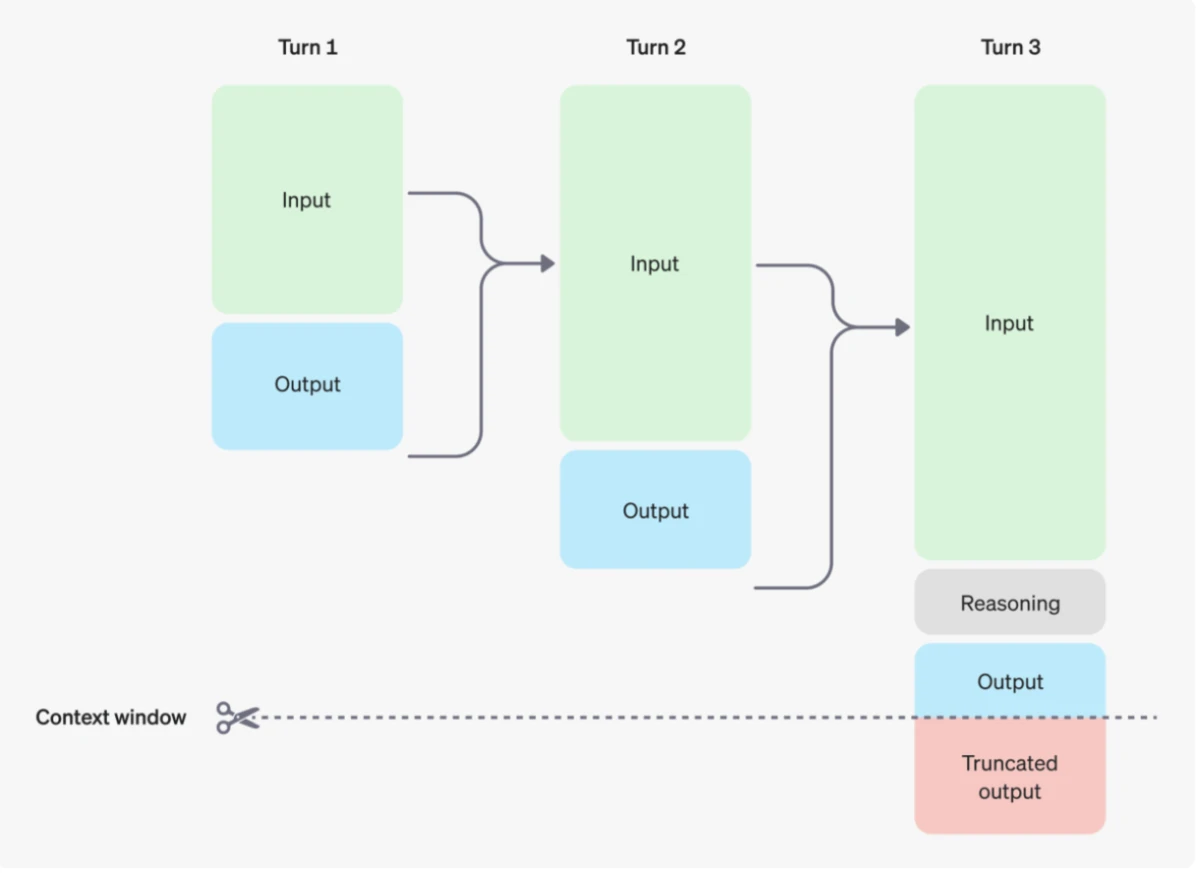
Das Kontextfenster legt eine feste Obergrenze für die Anzahl der Eingabe- und Ausgabe-Tokens pro Aufruf fest, einschließlich aller Tokens, die Reasoning-Modelle für das Chain-of-Thought-Reasoning verwenden. Übersteigt die Gesamtzahl diese Grenze, wird die Antwort abgeschnitten oder die Anfrage schlägt ganz fehl.
Abbildung 2: Veranschaulichung der Einschränkungen des Kontextfensters, die in einer mehrzügigen Konversation zu einer Ausgabekürzung führen.6
Bei Anwendungen mit langen Konversationen schiebt jede weitere Runde mehr Verlauf in die Eingabe. Ohne Gegenmaßnahmen wachsen die Eingabe-Tokens linear mit der Konversationslänge, und ebenso die Rechnung. API-Nutzer begegnen dem typischerweise auf eine von drei Arten:
- Prompt-Caching. OpenAI, Anthropic, Google und DeepSeek cachen alle wiederholte Prompt-Präfixe serverseitig und berechnen Cache-Hits zu einem Bruchteil des Standard-Eingabepreises, typischerweise 3 bis 10 Prozent des Cache-Miss-Preises. Bei Anwendungen, die einen langen System-Prompt oder Konversationspräfix wiederverwenden, kann Caching die Eingabekosten um eine Größenordnung senken.
- Rollierendes Fenster oder Retrieval-Augmented Generation (RAG). Sobald ein Schwellenwert erreicht ist, werden die ältesten Runden verworfen, oder es werden bei jedem Aufruf nur relevante frühere Nachrichten aus einem Vektorspeicher abgerufen.
- Zusammenfassung. Ältere Runden werden regelmäßig zu einer Zusammenfassung verdichtet, statt sie wortwörtlich erneut zu senden.
Bei agentischen Workloads wie Coding-Sitzungen oder Deep Research übernehmen moderne Coding-Agenten dies automatisch innerhalb der Sitzung. Claude Code beispielsweise verfügt über Kontextkomprimierung: Wenn die Konversation sich dem Limit nähert, werden ältere Nachrichten zu einer komprimierten Version zusammengefasst, während die jüngsten Runden erhalten bleiben. Nachfolgende Runden senden nur noch die Zusammenfassung plus den jüngsten Kontext an das Modell.
Die Auswirkungen auf die Preisgestaltung sind direkt. Bei Pay-per-Token-APIs begrenzt die Komprimierung, wie stark die Eingabe pro Aufruf wächst, und Caching senkt den Preis für das wiederholte Präfix, sodass die Kosten pro Runde über lange Sitzungen hinweg planbar bleiben. Bei Pauschalabonnements wie Claude Pro, ChatGPT Plus oder Kimi Moderato dehnt die Komprimierung die täglichen und wöchentlichen Nutzungslimits, weil jeder Aufruf weniger Kontext enthält. Eine Coding-Sitzung, die sonst ein 5-Stunden-Ratenlimit ausreizen würde, kann länger laufen, wenn ältere Runden komprimiert werden.
Der Kompromiss besteht darin, dass jede Form der Zusammenfassung verlustbehaftet ist. Die Zusammenfassung kann Details weglassen, die sich später als wichtig erweisen, und den Nutzer zwingen, sie erneut bereitzustellen.
Maximale Ausgabe-Tokens
Die maximalen Ausgabe-Tokens begrenzen die Länge der Antwort eines Modells. Auch wenn viele Dokumentationen angeben, dass dies über den Parameter max_tokens angepasst werden kann, ist es wichtig, die Dokumentation der jeweiligen API zu prüfen, um den richtigen Parameter zu ermitteln. Der Wert sollte entsprechend den spezifischen Anforderungen angepasst werden:
Ist der Wert zu niedrig, kann dies zu unvollständigen Ausgaben führen, sodass das Modell Antworten abschneidet, bevor die vollständige Antwort geliefert wurde.
Ist der Wert zu hoch, kann dies – abhängig von der Temperatur (einem Parameter, der die Kreativität der Antwort steuert) – zu unnötig ausführlichen Ausgaben, längeren Antwortzeiten und höheren Kosten führen.
Daher ist es ein Parameter, der sorgfältig abgewogen werden sollte, um die Ressourcennutzung zu optimieren und gleichzeitig Ausgabequalität, Kosten und Leistung in Einklang zu bringen.
Tabelle 3: Beispielhafte Eingabe-Prompts und geschätzte Tokenzahlen pro Inhaltstyp.
*Dabei wird angenommen, dass jedes Modell Antworten mit einer gleichen Anzahl von Ausgabe-Tokens erzeugt, obwohl die Tokenzahl sowohl für Eingabe als auch Ausgabe je nach Tokenisierung des jeweiligen Modells variieren kann; die Zahl wurde hier für jedes Modell konstant gehalten.
Durch die Kombination der Token-Bereiche aus Tabelle 2 mit den Token-Preisen eines Modells ergeben sich die erwarteten Kosten pro Inhaltstyp; die Beispiel-Prompts in Tabelle 3 zeigen die Eingabe- und Ausgabegrößen hinter diesen Schätzungen.
Verwendung mehrerer Sprachmodelle
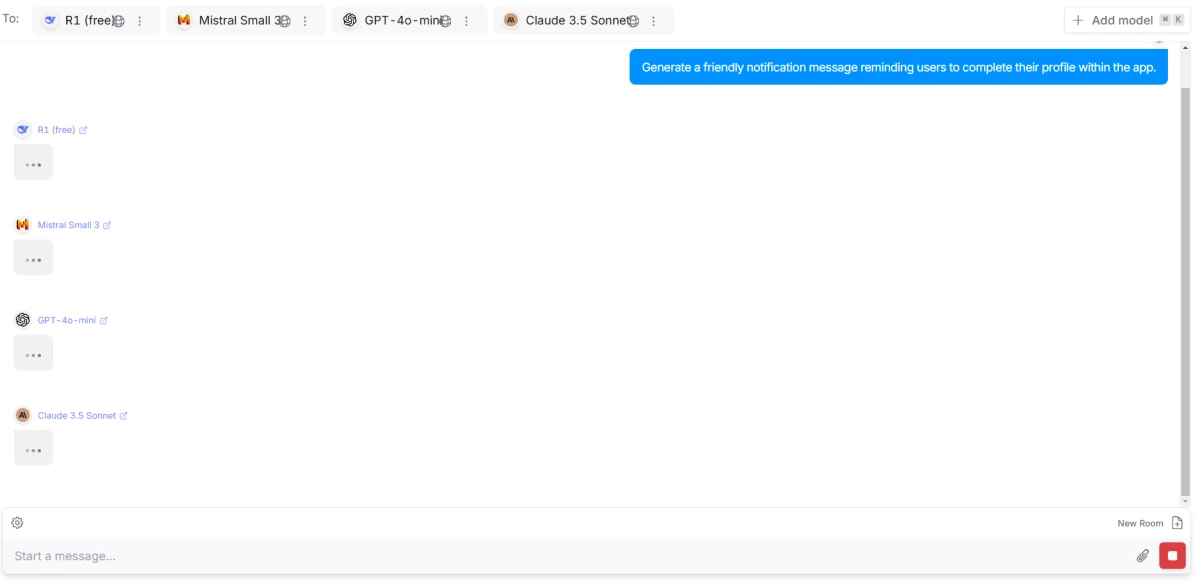
Ein KI-Gateway wie OpenRouter ermöglicht es, denselben Prompt gleichzeitig an mehrere Modelle zu senden. Die Antworten, der Token-Verbrauch, die Antwortzeit und die Preise können dann verglichen werden, um zu bestimmen, welches Modell für die Aufgabe am besten geeignet ist.
Abbildung 3: Oberfläche, die einen Prompt zeigt, der über OpenRouter an mehrere Large Language Models gesendet wird.7
Vorteile und Herausforderungen
- Erhöhte Anpassungsfähigkeit und Effizienz: Orchestrierung verbessert die Reaktionsfähigkeit, ermöglicht die Echtzeitbewertung der Modelleffizienz und identifiziert ein kosteneffizientes Modell sowie mögliche Einsparungen.
- Prompt-Sensitivität und -Optimierung: Identische Prompts können bei verschiedenen Modellen zu sehr unterschiedlichen Ausgaben führen, was ein auf jedes Modell zugeschnittenes Prompt Engineering erfordert, um die gewünschten Ergebnisse zu erzielen, und die Entwicklungs- und Wartungskomplexität erhöht.
Preismechanik & versteckte Kosten
Reasoning-Tokens vs. Ausgabe-Tokens
Immer mehr Anbieter führen Reasoning-Modelle ein, die intern zusätzliche Rechenleistung für Chain-of-Thought-Reasoning aufwenden. OpenAI, Anthropic und Google rechnen diese Reasoning-Tokens als Ausgabe-Tokens zum Standard-Ausgabepreis des Modells ab; der Kostenanstieg resultiert also aus der Menge und nicht aus einem höheren Preis pro Token.
Modelle wie GPT-5.5 Pro, Claude Opus 5 mit erweitertem Denken oder Gemini 3.1 Pro Deep Think erzeugen interne Reasoning-Spuren
selbst dann, wenn Sie nicht ausdrücklich anfordern. Diese internen Tokens fließen in Ihre Rechnung ein und können die Kosten erheblich erhöhen, insbesondere bei langen analytischen Aufgaben wie juristischer Prüfung, Datenanalyse oder mehrstufigem Reasoning.
Daher ist es wichtig:
- Ein Reasoning-Modell nur dann zu wählen, wenn die Genauigkeit die Kosten deutlich überwiegt.
- Die Chain-of-Thought-Funktion zu deaktivieren oder, wenn möglich, eine kürzere maximale Ausgabe-Tokenzahl festzulegen.
- Dieselbe Aufgabe mit Nicht-Reasoning-Modellen zu testen, um zu sehen, ob die Leistung zu einem Bruchteil des Preises vergleichbar ist.
Da ein Reasoning-Modell 10 bis 30 Mal so viele Ausgabe-Tokens erzeugen kann, wie derselbe Prompt ohne Reasoning produzieren würde, ist es für die Kostenplanung entscheidend, diesen Unterschied zu verstehen.
Architekturbedingte Preisunterschiede
LLM-Architekturen beeinflussen direkt die Effizienz von Modellen und damit die API-Preisgestaltung. Zum Beispiel:
- Mixture-of-Experts (MoE)-Modelle aktivieren pro Anfrage nur eine Teilmenge der Parameter, was die Rechenkosten senkt und es Anbietern ermöglicht, niedrigere Token-Preise anzubieten.
- Spekulatives Decoding kombiniert ein kleineres Entwurfsmodell mit einem größeren, verbessert den Durchsatz und senkt die Kosten für deterministische Aufgaben.
- Quantisierte Varianten (z. B. 4-Bit oder 8-Bit) können die Inferenz mit geringerer Präzision ausführen und ermöglichen niedrigere Preise für lokal bereitgestellte oder cloudgehostete Versionen.
Das Verständnis dieser Architekturentscheidungen hilft Nutzern, nicht nur Preisunterschiede vorherzusagen, sondern auch Latenz, Qualität und die Skalierung eines Modells unter Produktions-Workloads.
Betriebskosten jenseits der API-Gebühren
Während die Abrechnung pro Token der Hauptkostentreiber ist, entstehen bei vielen Produktionsbereitstellungen zusätzliche Kosten über die API-Nutzung hinaus:
- Embeddings und Vektordatenbanken: Das Speichern und Abrufen von Vektoren (z. B. Pinecone, Weaviate, ChromaDB) verursacht Kosten pro Abfrage und pro GB Speicher.
- Reranking- und Postprocessing-Modelle: Viele Anwendungen nutzen kleinere Modelle für Zusammenfassung, Filterung oder Klassifizierung, bevor eine endgültige Anfrage an ein größeres Modell gesendet wird.
- Caching-Schichten: Anbieter wie OpenAI bieten jetzt Prompt-Caching an, aber lokale Caching-Infrastruktur kann zusätzliche Rechenleistung erfordern.
- Logging, Monitoring und Auditing: Unternehmen tragen häufig Kosten für Token-Monitoring, Latenzverfolgung und Sicherheitsaudits.
Diese versteckten Kosten machen oft 20–40 % der gesamten LLM-Betriebskosten aus und sollten bei der Bewertung von Preisstrukturen berücksichtigt werden.
 Als bevorzugte Quelle hinzufügen
Unternehmensspezifische Preisüberlegungen
Viele LLM-Anbieter erheben zusätzliche Gebühren für Sicherheits- und Compliance-Funktionen auf Unternehmensniveau, wie zum Beispiel:
- Single-Tenant-Bereitstellungen
- Dedizierte GPU-Cluster
- Erweiterte SLAs (z. B. Uptime- und Latenzgarantien)
- Datenresidenz und regionale Kontrollen
- SOC2-, HIPAA- oder DSGVO-Compliance-Modi
Diese Angebote können die Kosten erheblich erhöhen, sind jedoch für regulierte Branchen wie Gesundheitswesen, Finanzwesen, juristische Dienstleistungen und öffentliche Einrichtungen unerlässlich.
Zukünftige Trends bei der LLM-Preisgestaltung
Drei Dinge prägten die LLM-Preisgestaltung 2025: Commodity-Modelle wurden billig, fast jeder große Anbieter brachte ein Chat-Abo auf den Markt, und Reasoning-Modelle blieben teuer. Die Kluft ist strukturell bedingt und dürfte sich noch vergrößern: Eine Million Ausgabe-Tokens kostet bei DeepSeek V4-Flash (außerhalb der Spitzenzeiten) $0,66 und bei GPT-5.5 Pro $180. Interessant ist ab 2026, was sich zusätzlich zu dieser Basis verändert.
Abrechnung pro Token weicht der Preisgestaltung pro Aufgabe
Agenten treiben inzwischen den größten Teil der intensiven LLM-Nutzung. Eine einzige Coding-Aufgabe mit Claude Code, ein Recherche-Lauf mit Cowork oder eine autonome Browsing-Sitzung mit Operator kann Hunderte von sequenziellen Modellaufrufen auslösen. Die Token-Abrechnung wird für Käufer und Verkäufer unvorhersehbar.
Als Reaktion darauf gehen die Anbieter von Token-Zählern zu Aufgaben- und Sitzungskontingenten über. Moonshot schätzt 300 bis 1.200 Kimi-Code-Anfragen pro 5-Stunden-Fenster aus einem gemeinsamen Guthabenpool. Claude Code begrenzt die Nutzung pro 5-Stunden-Sitzung statt pro Nachricht. MiniMax legt die Kontingente des Token-Plans als rollierende 5-Stunden- und Wochenfenster fest, die nach der Anzahl paralleler Coding-Agenten bemessen sind. Kimi setzt stufenspezifische Limits für parallele Agent-Swarm-Subagenten.
Anbieterübergreifende Agenten-Harnesse wie OpenClaw und MaxHermes treiben dies weiter voran. Sie sitzen zwischen Nutzern und mehreren Modell-APIs, und ihre Preisgestaltung orientiert sich zunehmend am Durchsatz pro Aufgabe statt an einer Million Tokens. Es ist zu erwarten, dass im kommenden Jahr mehr Anbieter SKUs pro Aufgabe oder pro Sitzung veröffentlichen.
Kleine Reasoning-Modelle wandern auf das Gerät
Apple Intelligence führt die Inferenz für Routineanfragen auf dem Gerät aus und greift nur bei komplexen Anfragen auf Private Cloud Compute zurück. Microsoft Copilot+-PCs werden mit einem lokalen Modell ausgeliefert. Pixel-Geräte führen Gemini Nano aus. Aktuelle kleine Modelle wie Microsofts Phi-4 und Googles Gemma 3 sind reasoning-fähig und passen auf die Neural Processing Unit eines Smartphones oder Laptops.
Die Preisimplikation ist ein zweistufiger Verbrauchermarkt. Routinearbeiten laufen kostenlos zu Grenzkosten von nahezu null Token auf dem Gerät. Cloud-Abonnements konkurrieren über das, was lokal nicht möglich ist: Frontier-Reasoning, großer Kontext, multimodale Generierung und Agentenorchestrierung. Die free-lokale Untergrenze drückt reine Chat-Abos gegen null, sodass gebündelte Apps zum eigentlichen Grund werden, zu zahlen.
Langer Kontext und Speicher entscheiden, wer agentische Arbeit gewinnt
Langfristige agentische Aufgaben scheitern, wenn Modelle frühere Anweisungen aus den Augen verlieren oder Fakten halluzinieren, an die sie sich erinnern sollten. Dauerhafte agentische Arbeit hängt von drei Dingen ab: einem großen Kontextfenster, persistentem Speicher und einer niedrigen Halluzinationsrate.
Innerhalb eines Jahres sind drei Fähigkeiten an der Spitze zur Grundausstattung geworden. Claude Opus 5, Gemini 3.1 Pro, GPT-5.6 und Kimi K3 bieten Kontextfenster mit 1M Tokens. Bei OpenAI, Anthropic, Google und DeepSeek kosten Cache-Hits 3 bis 10 Prozent der Cache-Misses. ChatGPT und Claude enthalten inzwischen in ihren free-Stufen persistenten Speicher.
An der Spitze dieses Marktes entstehen spezialisierte agentische Modelle. Im Juni 2026 brachte Anthropic Claude Fable 5 heraus, ein allgemein verfügbares Modell der Mythos-Klasse8, das mit $10 Eingabe und $50 Ausgabe pro eine Million Tokens bepreist ist – doppelt so hoch wie der Opus-5-Tarif. Fable 5 zielt auf agentisches Coding, Computernutzung und langfristige Recherche; Claude Mythos 5, dasselbe Modell mit teilweise aufgehobenen Schutzmaßnahmen, bleibt genehmigten Partnern zum gleichen Preis vorbehalten.
Die Frage im Wettbewerb verschiebt sich von „Wie groß ist das Kontextfenster?“ zu „Wie kostengünstig und zuverlässig kann das Modell eine lange agentische Aufgabe durchhalten?“ Anbieter, die das gut lösen, werden Aufschläge durchsetzen. Wer es nicht tut, verliert agentische Workloads unabhängig vom beworbenen Token-Preis.
FAQs
Der Zugriff auf Large Language Models (LLMs) über ein Application Programming Interface (API) ermöglicht Ihnen den Fernzugriff auf KI-Modelle. Für diesen Zugriff wird vom Dienstanbieter eine Gebühr erhoben, oft als „API-Gebühr“ bezeichnet. Diese Gebühr ist ein entscheidender Faktor, wenn Sie LLMs in Ihre Anwendungen integrieren.
Sie stellt die Kosten dar, die mit jeder Abfrage, Anfrage oder Aufgabe verbunden sind, die über die API des Anbieters ausgeführt wird. Da die Preisstrukturen stark variieren können (je nach Faktoren wie Token-Nutzung, API-Aufrufvolumen, Funktionsnutzung oder Abonnementmodellen), ist es wichtig zu verstehen, wie Anbieter diese Kosten berechnen.
Die LLM-API-Preisgestaltung kann aufgrund von Faktoren wie Token-Verbrauch, Kontextlänge und Modellwahl komplex sein. Die Tokenisierungsverfahren variieren je nach Modell; einige verwenden Byte-Pair Encoding (BPE), WordPiece oder SentencePiece, was jeweils beeinflusst, wie Text in Tokens zerlegt wird, und die Kosteneffizienz beeinflusst. Das Verständnis dieser Unterschiede hilft, die API-Nutzung und die Preise zu optimieren.
Die LLM-Kosten werden in erster Linie durch die Token-Nutzung (sowohl Eingabe als auch Ausgabe), das API-Aufrufvolumen und das Preismodell bestimmt (z. B. pro Token oder Abonnement).
Vergleichen Sie die Preise für Eingabe- und Ausgabe-Tokens, die Limits für das Kontextfenster und etwaige Zusatzgebühren. Tools wie OpenRouter ermöglichen es Ihnen, denselben Prompt an mehrere Modelle zu senden und deren Ergebnisse, Token-Verbrauch, Geschwindigkeit und Preise direkt zu vergleichen. Berücksichtigen Sie Ihre typische Inhaltslänge und Nutzungsmuster, um die Gesamtkosten zu schätzen.
Eingabe-Tokens sind die Tokens in dem Prompt, den Sie an das LLM senden, während Ausgabe-Tokens die Tokens in der generierten Antwort sind. Bei Reasoning-Modellen werden auch Tokens, die während des Reasoning-Prozesses selbst erzeugt werden, als Ausgabe-Tokens gezählt, was die Endkosten beeinflusst. Sowohl Eingabe als auch Ausgabe tragen zu den Gesamtkosten bei.
Größere Textanfragen erfordern mehr Verarbeitung, was die Antwortzeit und die Kosten erhöht. Optimieren Sie die Eingabegrößen und nutzen Sie einen Preisrechner für LLM-APIs, um die Tokenzahlen zu schätzen und Ihr Budget effektiv zu verwalten.
Die LLM-Community hat verschiedene Tools und Benchmarks entwickelt, um Nutzern zu helfen, die LLM-Preisgestaltung zu verstehen und zu optimieren. Diese Ressourcen umfassen oft Rechner und Vergleichstabellen, die Einblicke in die Leistung und Effizienz verschiedener Modelle bieten.
Plattformen wie Hugging Face und GitHub hosten Tools und Code, die von der Community entwickelt wurden, um Modelleistung und Kosten zu analysieren. Viele Dienste bieten Community-Support über Foren oder Chat-Funktionen.
Diese Forschung zitieren
Wählen Sie das Format, das zu Ihrem Veröffentlichungsort passt. Wenn Sie die Link-Version in Ihr CMS einfügen, bleibt der Backlink erhalten.
@misc{dilmegani2026,
  author = {Dilmegani, Cem},
  title  = {{LLM-Preise: Top 15+ Anbieter im Vergleich}},
  year   = {2026},
  month  = aug,
  howpublished    = {\url{https://aimultiple.com/llm-pricing}},
  note   = {AIMultiple. Abgerufen am 26. August 2026}
}Ergebnisse und Zeitstempel von 285 Datenpunkten. Laden Sie die Zusammenfassungsdaten aus den Diagrammen und Tabellen dieses Artikels als ZIP-Datei herunter, die 6 CSV-Dateien und eine README enthält.
Möchten Sie die granularen Daten dahinter? Premium beitreten
Änderungsprotokoll
8 AktualisierungenDie Diagrammbeschreibung in der Einleitung aktualisiert.
Ein Diagramm wurde zum Abschnitt LLM-Preistypen hinzugefügt.
Der Abschnitt „LLM-Preise verstehen“ wurde entfernt.
Der Abschnitt „Auswirkungen des Kontextfensters“ wurde um Strategien zur Verwaltung der Token-Nutzung in langen Konversationen erweitert.
ChatGPT Go wurde dem OpenAI-Abschnitt hinzugefügt.
Referenzlinks
Cems Arbeit bei AIMultiple wurde von führenden globalen Publikationen wie Business Insider, Forbes, Morning Brew und Washington Post, von globalen Unternehmen wie Deloitte und HPE, von NGOs wie dem World Economic Forum und von supranationalen Organisationen wie der European Commission zitiert. [1], [2], [3], [4], [5]
Im Laufe seiner Karriere war Cem als Tech-Berater, Tech-Einkäufer und Tech-Unternehmer tätig. Er beriet Unternehmen bei ihren Technologieentscheidungen bei McKinsey & Company und Altman Solon über mehr als ein Jahrzehnt. Er veröffentlichte außerdem einen McKinsey-Bericht zur Digitalisierung.
Er leitete Technologiestrategie und -beschaffung eines Telekommunikationsunternehmens und berichtete dabei direkt an den CEO. Außerdem verantwortete er das kommerzielle Wachstum des Deep-Tech-Unternehmens Hypatos, das innerhalb von zwei Jahren von 0 einen siebenstelligen jährlich wiederkehrenden Umsatz und eine neunstellige Bewertung erreichte. Cems Arbeit bei Hypatos wurde von führenden Technologiepublikationen wie TechCrunch und Business Insider aufgegriffen.
Cem spricht regelmäßig auf internationalen Technologiekonferenzen. Er absolvierte die Bogazici University als Computeringenieur und hat einen MBA von der Columbia Business School.




Kommentare 1
Teilen Sie Ihre Gedanken
Ihre E-Mail-Adresse wird nicht veröffentlicht. Alle Felder sind erforderlich. Kommentare werden in ihrer Originalsprache belassen.
"Really well-written and timely article! Your analysis of how different large language model (LLM) providers compare - based on token pricing, context window, and performance - really helps demystify an often opaque cost structure. I found the detailed breakdown of token-based billing (input vs output tokens), context-window implications, and the built-in “price calculator” particularly useful for anyone trying to realistically estimate LLM usage