


Unabhängige Enterprise-KI- und Software-Benchmarks
AIM Indices


Vergleichen Sie die Konformität der Codierungsassistenten von KI mit den Spezifikationen und der Codesicherheit.
Identifizieren Sie die günstigste Cloud GPUs für Training und Inferenz.
Messung der GPU-Leistung unter hoher paralleler Anfragelast
Vergleich der Skalierungseffizienz in verschiedenen Multi-GPU-Setups
Analysieren Sie die Funktionen und Kosten führender KI-Gateway-Lösungen.
Vergleichen Sie die Latenz von LLMs
Vergleichen Sie die Input- und Outputkosten der LLM-Modelle.
Vergleich der Genauigkeit und Zuverlässigkeit von LLMs bei der Umwandlung von natürlicher Sprache in SQL
Vergleichen Sie die Bias-Raten von LLMs
Bewertung der Halluzinationsraten der Top-Modelle KI
Evaluierung von Multi-Datenbank-Routing und Abfragegenerierung in agentic RAG
Vergleichen Sie Genauigkeit und Geschwindigkeit der Einbettungsmodelle.
Bewertung der Genauigkeit und Geschwindigkeit führender Open-Source-Embedding-Modelle
Vergleichen Sie Lösungen zur Abruf-gestützten Datengenerierung
Vergleichen Sie Leistung, Preise und Funktionen von Vektordatenbanken für RAG
Vergleich von Latenz und Nutzung von Abschlusstoken für agentenbasierte Frameworks
Analysieren Sie die Leistung von TikTok-Scraper-APIs
Bewerten Sie die Effektivität von Web-Unblocker-Lösungen
Analyse der Leistung des Video-Scrapers APIs
Analyse der Leistung von Code-Editoren, die auf KI basieren
Vergleichen Sie das Scraping APIs für E-Commerce-Daten
Vergleichen Sie die Fähigkeiten und Ergebnisse führender großer Sprachmodelle.
Sehen Sie sich die präzisesten OCR-Engines und LLMs für die Dokumentenautomatisierung an.
Benchmark für Suchmaschinen-Scraping API Erfolgsraten und Preise
Vergleichen Sie die OCRs in der Handschrifterkennung
Vergleich tabellarischer Lernmodelle mit verschiedenen Datensätzen
Vergleichen Sie BF16, FP8, INT8, INT4 hinsichtlich Leistung und Kosten
Vergleich multimodaler Einbettungen für Bild-Text-Schlussfolgerungen
Vergleichen Sie die Effizienz von vLLM, LMDeploy und SGLang mit der von H100.
Vergleichen Sie die Leistung der LLM Schaber.
Vergleiche die visuellen Denkfähigkeiten von LLMs
Vergleichen Sie die Orchestrierungsleistung agentenbasierter Frameworks
Vergleichen Sie die Latenz von KI-Anbietern
Vergleichen Sie mehrsprachige Embedding-Modelle für RAG
Vergleichen Sie Reranker-Modelle für dichte Retrieval
Vergleichen Sie LLMs in verschiedenen Softwareentwicklungsaufgaben.
Vergleichen Sie, wie stark die UI-Grounding-Modelle sind.
AIMultiple Newsletter
1 kostenlose E-Mail pro Woche mit den neuesten B2B-Technachrichten und Experten Einblicken.
Neueste Benchmarks
Top 9 KI-Anbieter im Vergleich
Das Ökosystem der KI-Infrastruktur wächst rasant, und Anbieter verfolgen unterschiedliche Ansätze beim Erstellen, Hosten und Beschleunigen von Modellen. Während sie alle darauf abzielen, KI-Anwendungen mit Rechenleistung zu versorgen, konzentriert sich jeder auf eine andere Ebene des Stacks. Wir haben die am häufigsten genutzten Anbieter auf OpenRouter bewertet: Cerebras, DeepInfra, Fireworks AI, Groq, Nebius und SambaNova…
Vergleich multimodaler KI-Modelle beim visuellen Denken
Wir haben 15 führende multimodale KI-Modelle anhand von 200 visuellen Fragen im visuellen Denken getestet. Die Auswertung bestand aus zwei Bereichen: 100 Fragen zum Diagrammverständnis, die Interpretation von Datenvisualisierungen testen, und 100 Fragen zur visuellen Logik, die Mustererkennung und räumliches Denken bewerten. Jede Frage wurde 5-mal ausgeführt, um konsistente und zuverlässige Ergebnisse sicherzustellen. Siehe…
KI-Halluzinationserkennungs-Tools: W&B Weave & Comet
Wir haben drei Hallucination-Detection-Tools einem Benchmark unterzogen: W&B Weave HallucinationFree Scorer (Teil von CoreWeave Forge, ehemals Weights & Biases), Arize Phoenix HallucinationEvaluator und Comet Opik Hallucination Metric – über 100 Testfälle hinweg. Jedes Tool wurde anhand von Genauigkeit, Präzision, Trefferquote und Latenz bewertet. Wir haben 100 Antworten (50 korrekt, 50 halluziniert) aus faktischen Q&A-Szenarien anhand…
AIM-Text-to-SQL-Benchmark: SQL-Genauigkeit bei über 70 LLMs
SQL-Genauigkeit ist der Prozentsatz der bewerteten Abfragen, die das Referenzergebnis zurückgeben. Falsche Routen und als fehlerhaft markierte Referenzen werden ausgeschlossen. Eine Referenzabfrage ist die als erwartete Antwort angegebene SQL-Abfrage. Jedes Modell erreicht eine andere Menge von SQL-Fragen, da die Bewertung von seinen Datenbankentscheidungen abhängt. Unterschiede in diesen Teilmengen und im Ausführungsaufbau schränken Vergleiche ein. claude-opus-5.5…
Siehe All KI ArtikelNeueste Erkenntnisse
Top 5 KI-Leitplanken: Xnode Cortx & Weights and Biases
KI-Sicherheitsfehler sind teuer und treten immer häufiger auf. Viele Vorfälle sind auf eine schwache Governance zurückzuführen, insbesondere auf Lücken bei der Zugriffskontrolle, den Datenberechtigungen und der Überwachung der Model-Nutzung. KI-Leitplanken reduzieren dieses Risiko, indem sie durchsetzbare Grenzen dafür festlegen, wie KI-Systeme auf Daten zugreifen, Ausgaben generieren und mit Nutzern oder Geschäftsabläufen interagieren. Erfahren Sie, wie…
Top 12 KI-Governance-Tools im Vergleich
Um die KI-Governance-Landschaft abzubilden, haben wir 12 führende Plattformen auf ihre Abdeckung von 11 Kernfähigkeiten geprüft und hervorgehoben, was jedes Tool am besten kann. End-to-End: Deckt beide Seiten der Governance ab – die regulatorische Compliance auf der einen Seite und technische Modelltests auf der anderen. Compliance: Behandelt Richtlinien, Risiken und Audits, überlässt die technischen Modelltests…
10+ Beispiele für große Sprachmodelle
Wir haben Open-Source-Benchmarks zusammengestellt, um führende proprietäre und quelloffene große Sprachmodelle zu vergleichen. Wählen Sie Ihren Anwendungsfall, um das richtige Modell zu finden. Sie können große Sprachmodelle bewerten, indem Sie ihre Benchmark-Leistung und reale Latenz prüfen (verfügbar durch Klicken auf den Namen des jeweiligen Modells in der Tabelle) und ihre Preisgestaltung überprüfen, um die allgemeine…
Chatbot vs ChatGPT: Unterschiede & Funktionen
Herkömmliche Chatbots rufen vorgefertigte Antworten aus einer festen Wissensbasis ab. ChatGPT generiert Antworten von Grund auf mithilfe eines großen Sprachmodells, das auf breiten Daten in Internetmaßstab trainiert wurde. Dieser eine architektonische Unterschied ist der Grund, warum sie völlig unterschiedliche Probleme lösen und warum die Wahl des falschen Zeit und Geld kostet. Lassen Sie uns klären,…
Siehe All KI ArtikelBadges aus neuesten Benchmarks
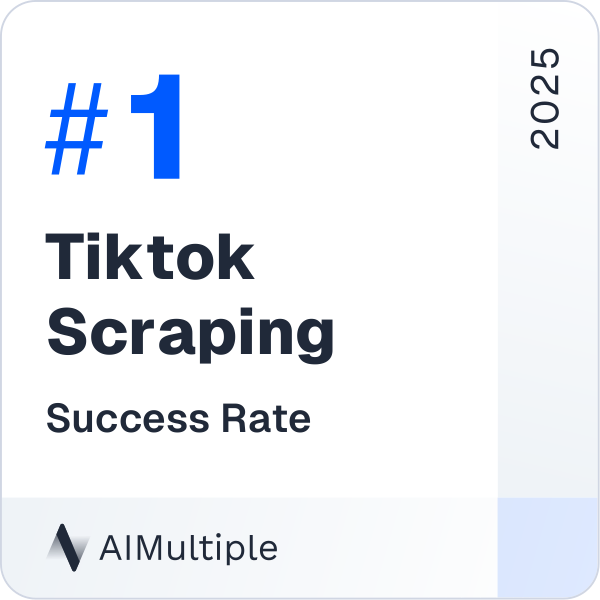
Enterprise Tech Bestenliste
Top 3 Ergebnisse werden angezeigt, für mehr siehe Forschungsartikel.
Anbieter | Benchmark | Metrik | Wert |
|---|---|---|---|
 Bright Data | 1st Success Rate | 100 % | |
 Apify | 2nd Success Rate | 99 % | |
 Decodo | 3rd Success Rate | 95 % | |
 Groq | 1st Latency | 2.00 s | |
 SambaNova | 2nd Latency | 3.00 s | |
 Together.ai | 3rd Latency | 11.00 s | |
 Zyte | 1st Response Time | 1.75 s | |
Bright Data | 2nd Response Time | 2.38 s | |
Decodo | 3rd Response Time | 3.43 s | |
Bright Data | 1st Overall | Leader |
Datengestützte Entscheidungen, untermauert durch Benchmarks
Erkenntnisse basierend auf 45.280 Ingenieurstunden pro Jahr
60 % der Fortune-500-Unternehmen vertrauen monatlich auf AIMultiple
Monatlich vertrauen Fortune-500-Unternehmen auf AIMultiple, um ihre Beschaffungsentscheidungen zu treffen. Laut Similarweb nutzen jährlich 4 Millionen Unternehmen AIMultiple.
Sehen Sie, wie Enterprise KI in der Praxis abschneidet
KI Benchmarking auf Basis öffentlicher Datensätze ist anfällig für Datenverfälschung und führt zu überzogenen Erwartungen. AIMultiple Die eigens für diesen Benchmark verwendeten Datensätze gewährleisten realistische Ergebnisse. Erfahren Sie , wie wir verschiedene Technologielösungen testen .
Steigern Sie Ihr Vertrauen in Technologieentscheidungen
Wir sind unabhängig, zu 100 % im Besitz unserer Mitarbeiter und legen alle unsere Sponsoren und Interessenkonflikte offen. Unsere Verpflichtungen zu objektiven Forschungsergebnissen finden Sie hier.
