


Open Source Embedding Models: 11 Models im Retrieval-Benchmark
We benchmarked 11 open-weight embedding models, 200 questions and 341,040 text passages across four corpora. Finance, legal contract, technical support and medical questions each searched their own domain's corpus.

Der nDCG@10 bewertet die Platzierung der aufgezeichneten relevanten Passagen innerhalb der ersten zehn Suchergebnisse. Ein Wert von 1 repräsentiert das ideale Ranking für die aufgezeichneten Positivtreffer. Passagen, die weiter oben stehen, erhalten mehr Gewicht.
PPLX Embed v1 4B führte den Vergleich mit 0.741 nDCG@10 an, gefolgt von PPLX Embed v1 0.6B mit 0.698. Multilingual E5 Large belegte mit 0.628 den dritten Platz. Der kleine Abstand zwischen BGE Large und E5 Large wird durch die Rundung auf drei Dezimalstellen verdeckt. Ihre ungerundeten Werte bestimmen die Reihenfolge.
Model | nDCG@10 | 95 % KI | Recall@10 |
|---|---|---|---|
PPLX Embed v1 4B | 0.741 | 0.700–0.782 | 90,46 % |
PPLX Embed v1 0.6B | 0.698 | 0.651–0.744 | 86,71 % |
Multilingual E5 Large | 0.628 | 0.578–0.680 | 79,38 % |
BGE Large EN v1.5 | 0.624 | 0.572–0.676 | 78,21 % |
E5 Large v2 | 0.624 | 0.572–0.675 | 78,88 % |
BGE-M3 (dense) | 0.614 | 0.562–0.666 | 79,50 % |
GTE Large | 0.612 | 0.563–0.660 | 77,71 % |
All-MPNet Base v2 | 0.608 | 0.556–0.661 | 77,33 % |
GTE Base | 0.596 | 0.547–0.645 | 76,21 % |
E5 Base v2 | 0.586 | 0.534–0.640 | 75,21 % |
Recall@10 ist der durchschnittliche Anteil der zu jeder Frage aufgezeichneten relevanten Passagen, die in den ersten zehn Ergebnissen gefunden wurden. Er misst die Passagenabdeckung und bewertet nicht, ob eine generierte Antwort korrekt ist.
Die 95 %-Konfidenzintervalle (KIs) schätzen die Unsicherheit des durchschnittlichen nDCG@10 aus der Fragenstichprobe. Breitere Intervalle deuten auf weniger präzise Schätzungen hin.
Die Fragen wurden ausgewählt, um BM25 herauszufordern, das in diesem Set null Punkte erzielte. Wir berichten diese Baseline zusammen mit dem Auswahlverfahren. Die Leistung bei gewöhnlichem Suchverkehr bleibt ungetestet. Inference erfolgte über gehostete Endpoints.
Retrieval-Ergebnisse innerhalb der Open-Weight-Models
PPLX Embed v1 4B erzielte den höchsten nDCG@10 mit 0.741
PPLX Embed v1 0.6B folgte mit 0.698. Das 4B-Model schnitt nach Korrektur für multiple Vergleiche signifikant besser ab als neun der anderen zehn Open-Weight-Models. Der Abstand zu 0.6B war nicht signifikant. Ihre Recall@10-Werte betrugen 90,46 % und 86,71 %, ebenfalls ohne signifikanten Unterschied. Diese Tests belegen keine gleichwertige Leistung.
BGE Large erzielte den höchsten Finance-Score mit 0.604
PPLX 4B erzielte 0.596 bei denselben 50 Finance-Fragen. Dieser Unterschied war nach Korrektur nicht signifikant. BGE Large belegte insgesamt den vierten Platz, was zeigt, wie sich die beobachtete Reihenfolge über die Domänen hinweg ändert.
GTE Large fand alle aufgezeichneten MedRAG-Positivtreffer innerhalb von zehn Ergebnissen
GTE Large erreichte 100 % Recall@10 über die 50 medizinischen Fragen. Sein nDCG@10 lag bei 0.894, verglichen mit PPLX 4B mit 0.954. Das Auffinden der aufgezeichneten Positivtreffer und deren Platzierung ganz vorn sind getrennte Ergebnisse. Diese Werte betreffen das Passagen-Retrieval und messen nicht die Genauigkeit medizinischer Antworten.
Domänenvergleiche für die elf Models
nDCG@10 auf Domänenebene. Die Ansichten Finance, CUAD, TechQA und MedRAG enthalten alle elf Models und sortieren sie nach dem Score der ausgewählten Domäne.
BGE-M3 erreichte 0.616 bei CUAD und 0.743 bei MedRAG. Diese Werte beschreiben die hier verwendete Dense-Vektor-Konfiguration. BGE-M3 unterstützt auch Sparse- und Multi-Vektor-Retrieval. Diese Modi und Hybridkombinationen lagen außerhalb dieses Experiments.1
Alle vier Domänen fließen mit gleichem Gewicht in das Gesamtergebnis ein. Eine starke MedRAG-Leistung eines Models kann in diesem Durchschnitt schwächeres Finance-Retrieval ausgleichen, auch wenn die Finanz- und Medizin-Anwendungsfälle unterschiedliche Evidenz erfordern.
Embedding-Repräsentationen und Deployment-Entscheidungen
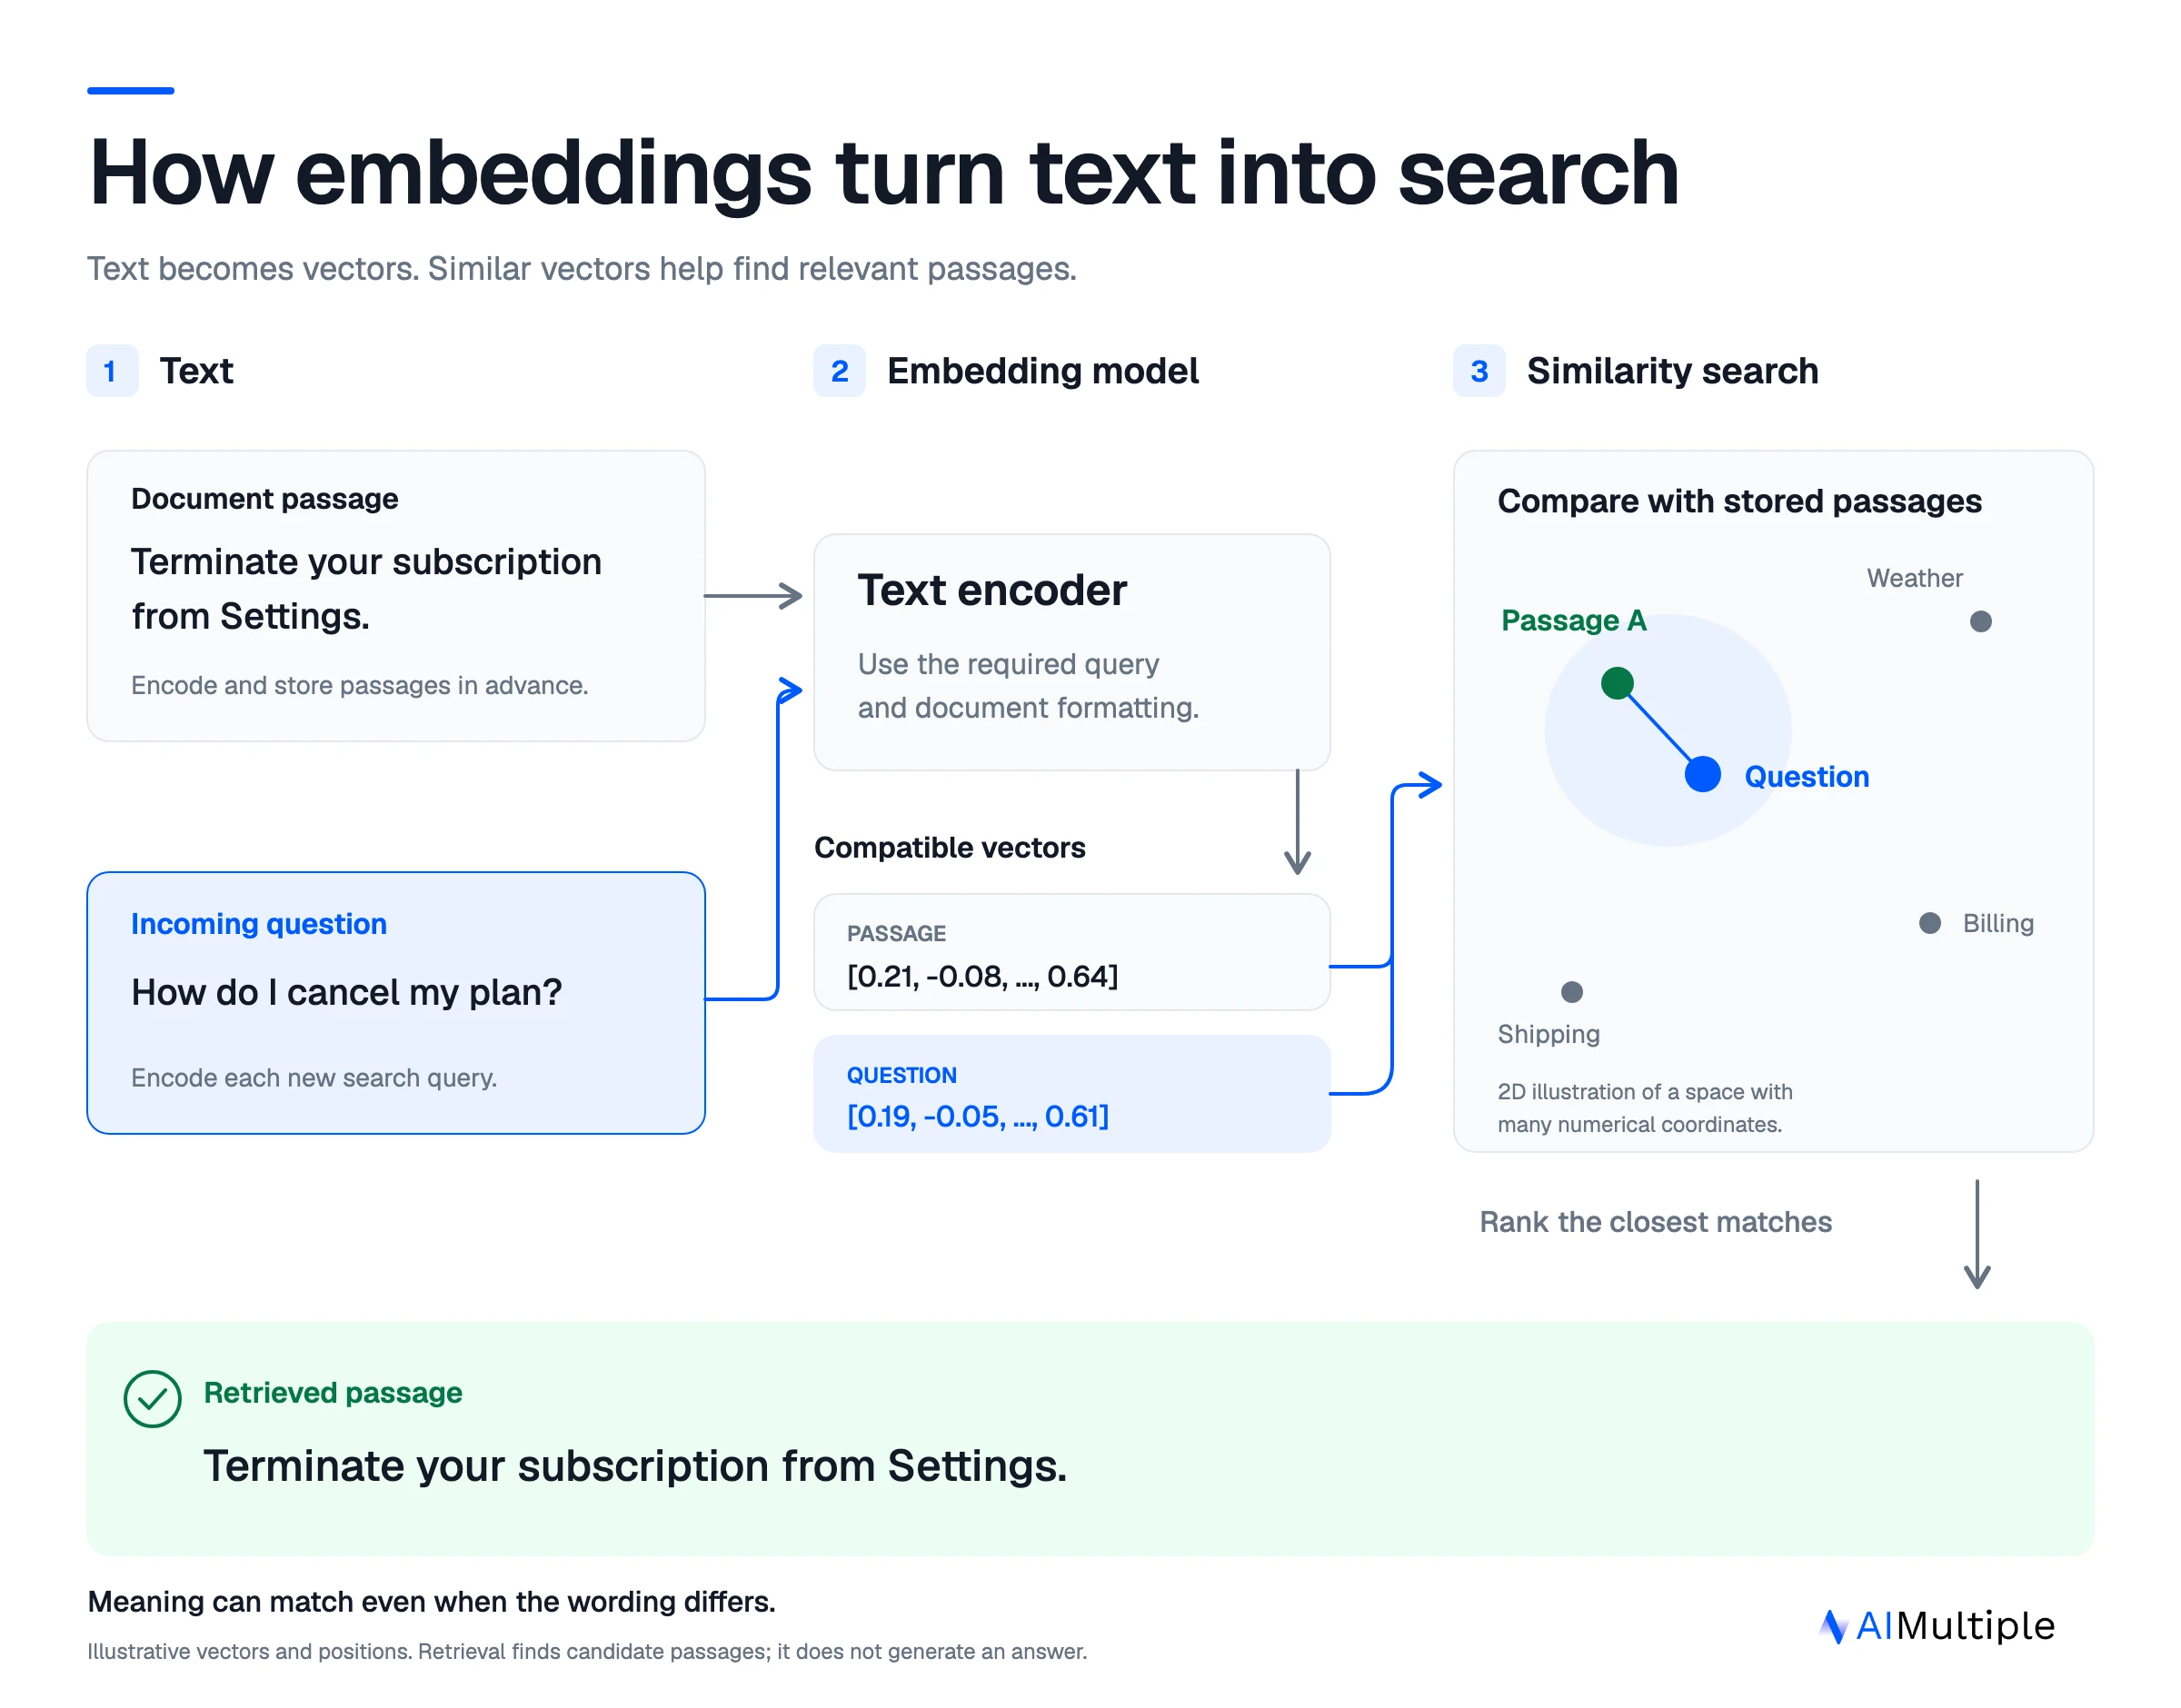
Embedding-Retrieval kodiert Passagen und Abfragen in kompatible Vektoren und vergleicht diese Vektoren dann, um Kandidatenpassagen auszuwählen. Dokumente können vor der Suche kodiert werden. Jede eingehende Abfrage benötigt ihre eigene Repräsentation. Modelspezifische Abfrage- und Dokument-Prompts oder Rollen sollten der Retrieval-Konfiguration des Models folgen.2
Speicher- und Suchverhalten hängen außerdem von der Vektordatenbank und ihrer Indexkonfiguration ab. Modellwahl, Vektorpräzision, Indexeinstellungen und Retrievaltiefe sollten bei der Planung eines Deployments getrennte Entscheidungen bleiben. Der umfassendere Embedding-Model-Benchmark ordnet diese elf Einträge neben den kommerziellen API-Models auf denselben Fragen ein.
Methodik des Benchmarks für Open-Source-Embedding-Models
Jedes Model durchsuchte dieselben Passagen mit 200 eingefrorenen Fragen und 225 aufgezeichneten relevanten Frage-Passage-Paaren. Fragen und Relevanzlabels wurden vor dem Vergleich der Embedding-Scores festgelegt. Die Abfrage-Inputs enthielten nur die ursprüngliche Frage.
Finanz-Passagen stammten aus FinQA-Jahresberichten, und Rechtspassagen aus CUAD-v1-Verträgen.34 Der technische Support nutzte TechQA-Technotes, und die medizinische Literatur verwendete eine Stichprobe der MedRAG-PubMed-Abstracts.56
Die Passagen waren ganze Absätze, Tabellen mit Kontext, Vertragsklauseln oder Abstracts mit Titeln. Wir schlossen Einheiten aus, die unter dem all-MiniLM-L6-v2-Tokenizer länger als 256 Tokens waren, und ließen akzeptierte Passagen unverändert. Die 512-Token-Models erhielten höchstens 459 Tokens pro Passage, sodass diese Evaluation kurze Passagen abdeckt.
Frontier-LLMs erstellten die Fragen aus Quellpassagen. Ein Teammitglied überprüfte 20 % der Fragen (40 von 200). Die LLMs bewerteten außerdem die obersten 20 Passagen von BM25 pro Frage und fügten den ursprünglichen 200 Quellpassagen 25 relevante Passagen hinzu.
Retrieval und statistische Analyse
Jede Abfrage wurde mit jeder Passage in ihrer Domäne verglichen. MultiQA verwendete das Skalarprodukt, entsprechend seiner Model Card.7 Die anderen zehn Models verwendeten Kosinus-Ähnlichkeit. BGE-M3 verwendete seine Dense-Vektoren.1 Die Eingaben verwendeten die konfigurierten Retrieval-Rollen oder -Präfixe jedes Models.
Beide Metriken sind Durchschnitte über die Fragen. Wir berechneten 95 %-KIs mit 10.000 Bootstrap-Stichproben und zogen innerhalb jeder Domäne 50 Fragen erneut. Die Signifikanz verwendet die paarweisen Sign-Flip-Tests des gesamten Benchmarks mit Holm-Korrektur über alle 231 Paare unter seinen 22 Models für jede Metrik und jeden Umfang. Unterschiede sind bei einem korrigierten p-Wert unter 0.05 signifikant.
Getestete Model-IDs, Dimensionen und Input-Limits
Die Durchläufe erfolgten über OpenRouter, mit einem festen Backend-Anbieter pro Model und deaktivierten Fallbacks. Dies sind die API-Kennungen, Ausgabedimensionen und Input-Limits, die in diesen Durchläufen verwendet wurden.
API-Kennungen garantieren keinen unveränderlichen Model-Snapshot. Tokenizer-Revisionen wurden festgepinnt, und gehostete Model-Gewichte wurden nicht unabhängig verifiziert. Die Input-Limits beschreiben die Benchmark-Konfiguration. Die kurzen Passagen testeten kein Langkontext-Retrieval.
Grenzen des Vergleichs
Die Fragen bilden ein von BM25 ausgewähltes Entwicklungsset. Ergebnisse bei gewöhnlichen Produktionsabfragen können abweichen. Die Relevanzurteile beschränkten sich auf die Quellpassagen und die obersten 20 von BM25. Über diese elf Models hinweg war etwa 85 % der unterschiedlichen Frage-Passage-Paare, die in den Top Ten gefunden wurden, unbewertet und erhielt keine Relevanzgutschrift.
Jedes Model wurde einmal ausgeführt. Die KIs spiegeln die Fragenstichprobe wider und schließen Variationen zwischen API-Läufen oder Unsicherheit durch unvollständige Labels aus. Eine Kontamination durch Trainingsdaten wurde nicht getestet.
Die Evaluation deckt das Retrieval von englischem Text ab. Multilinguale Embedding-Workloads und multimodale Embedding-Models benötigen separate Evidenz. Die Genauigkeit generierter Antworten, hybrides Retrieval, Reranking, GPU-Speicher, lokaler Durchsatz und Serving-Kosten lagen außerhalb dieses Vergleichs.
Fazit
PPLX Embed v1 4B und 0.6B hatten die höchsten Gesamtwerte unter den elf Open-Weight-Models. Ihr Unterschied war statistisch nicht signifikant. BGE Large erzielte den höchsten Finance-Score, und GTE Large fand alle aufgezeichneten MedRAG-Positivtreffer innerhalb von zehn Ergebnissen.
Testen Sie vor dem Deployment das beabsichtigte Abfrage-Set und messen Sie lokale Serving-Geschwindigkeit, Speichernutzung und Kosten.
 Als bevorzugte Quelle hinzufügen
Weiterführende Literatur
- Embedding-Model-Benchmark
- Multilinguale Embedding-Models für RAG
- Benchmark für Open-Source-Vektordatenbanken
- Größenbestimmung und Auswahl von Vektordatenbanken
Zitieren Sie diesen Benchmark
Wählen Sie das Format, das zu Ihrem Veröffentlichungsort passt. Wenn Sie die Link-Version in Ihr CMS einfügen, bleibt der Backlink erhalten.
@misc{sari2026,
  author = {Sarı, Ekrem},
  title  = {{Open Source Embedding Models: 11 Models im Retrieval-Benchmark}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/open-source-embedding-models}},
  note   = {AIMultiple. Abgerufen am 26. September 2026}
}Ergebnisse und Zeitstempel von 105 Datenpunkten. Laden Sie die Zusammenfassungsdaten aus den Diagrammen und Tabellen dieses Artikels als ZIP-Datei herunter, die 7 CSV-Dateien und eine README enthält.
Möchten Sie die granularen Daten dahinter? Premium beitreten
Änderungsprotokoll
4 AktualisierungenDer Top-K-Benchmark mit 16 Modellen auf Amazon-Rezensionen wurde durch einen Benchmark mit 14 Modellen zu CUAD, TechQA und MedRAG mit nDCG@3 und Kosten ersetzt.
Lizenz & kommerzielle Nutzung zur Übersicht der Open-Source-Einbettungsmodelle hinzugefügt.
Der Benchmark wurde um fünf zusätzliche Open-Source-Modelle erweitert.
Hardware, Batch-Größe und Präzision im Evaluierungs-Setup aktualisiert.
Referenzlinks






Seien Sie der Erste, der kommentiert
Ihre E-Mail-Adresse wird nicht veröffentlicht. Alle Felder sind erforderlich. Kommentare werden in ihrer Originalsprache belassen.