


AIM-Agentic RAG Benchmark: Routing über 11 SQL-Datenbanken
We benchmarked 70+ LLMs on 759 questions that require choosing among 11 SQL databases. The benchmark measures whether each model identifies the right database, explores alternatives and states a final choice.
Die Routing-Genauigkeit ist der Prozentsatz der bewerteten Fragen, bei denen das Modell in seiner endgültigen Antwort die richtige Datenbank explizit nennt. Die Headline verwendet die 184 Fragen, die sowohl von unserem Ähnlichkeitstest als auch von einer Jury aus drei LLMs als schwierig markiert wurden. Fehlende explizite Angaben erhalten keine Punkte.
Erkenntnisse zum Datenbank-Routing
Gemini 4 Argon verzeichnete mit 94,0 % die höchste Routing-Genauigkeit
gemini-4-argon wählte bei 173 von 184 schweren Fragen die richtige Datenbank. claude-opus-5.5 folgte mit 90,2 % (166 von 184). Muse Wonder verzeichnete 86,4 % (159 von 184). GPT-6.1 Terra verzeichnete 83,7 % (154 von 184). MiniMax M3.1 Flash verzeichnete 81,5 % (150 von 184). Kimi K3.1 Pro verzeichnete 84,8 % (156 von 184). Muse Spark Open verzeichnete 81,0 % (149 von 184), und DeepSeek V4.1 Flash 1017 verzeichnete 77,2 % (142 von 184).
Gemini 4 Argon führte über alle Fragen hinweg mit 98,4 % (747 von 759). Es lief über OpenRouter. Die beobachteten Ergebnisse spiegeln sowohl Modell- als auch Ausführungsbedingungen wider.
DeepSeek V4 Flash 0731 erzielte 82,1 % Routing-Genauigkeit bei $1,37
DeepSeek V4 Flash 0731 beantwortete 151 von 184 schwere Fragen richtig. Die beibehaltenen Antworten über alle 759 Fragen kosteten $1.37. Qwen3.8 Flash erreichte 79,3 % bei $2,08, während MiMo-V2.6-Pro 82,6 % bei $4,17 erreichte.
Diese Kosten summieren die erfolgreichen Antworten, die in jeder Ergebnisdatei beibehalten wurden. Fehlgeschlagene und ersetzte Wiederholungsversuche sind ausgeschlossen. Diese Summen hängen von den verwendeten Anbietern und Caching-Bedingungen während der Messung ab. Die Kostenübersicht enthält 78 gemessene API-Summen und drei separat gekennzeichnete OpenRouter-äquivalente Schätzungen für Opus 5.5, Fable 5.1 und GPT-6 Astra. Diese Schätzungen wenden die API-Preise vom 1. Oktober 2026 auf die aufgezeichneten CLI-Token und die Cache-Nutzung an. Sie messen keine Abonnement-Ausgaben.
Grok 4.6 gewann 41.8 Punkte nach seiner ersten Datenbankwahl
Grok 4.6 verzeichnete bei schweren Fragen einen Anstieg der Routing-Genauigkeit von 38,0 % bei der ersten Prüfung auf 79,9 % bei der endgültigen Angabe. GPT-6 Sol Pro gewann 34.2 Punkte innerhalb seines Laufs. Nova Lite verlor 14.0 Punkte.
Diese Änderungen verwenden Fragen mit einer einzigen Datenbank in der ersten Runde. Sie beschreiben aufgezeichnete Verläufe. Keine separate Intervention isolierte den Nutzen zusätzlicher Aufrufe.
Über alle 81 Modelle hinweg enthielten 8.203 Datensätze zu schweren Fragen einen Datenbankwechsel:
Diese Tabelle verwendet die erste Datenbank in der aufgezeichneten Aufrufreihenfolge, einschließlich Mehrdatenbank-Erstrunden. Für die endgültige Anrechnung ist eine explizite korrekte Angabe erforderlich. Die obigen prozentualen Änderungen verwenden die engere Teilmenge mit nur einer Erstauswahl.
Ergebnisse des Datenbank-Routings
Modelle sind nach Routing-Genauigkeit sortiert, höchste zuerst. Die Methodik kennzeichnet Unterschiede in der Software, mit der sie ausgeführt wurden. Diese Bedingungen sind wichtig, wenn kleine Punktedifferenzen interpretiert werden.
Die Intervalle schätzen die Unsicherheit durch die Fragen-Stichprobe. Die erfassten Kosten decken die erfolgreichen Datensätze in jedem Lauf ab. Sie spiegeln die zum Messzeitpunkt verwendeten Anbieter und Caching-Bedingungen wider.
Bedingungen, die Datenbankauswahl beeinflussen
Ähnliche Datenbanken reduzierten die Routing-Genauigkeit um etwa 20 Punkte
Wir testeten die Methode zur Datenbankauswahl in einem separaten Experiment mit 128 Fragen. Jede Frage behielt ihre richtige Datenbank, während die anderen 10 Kandidaten entweder aus unserer ausgewählten Gruppe oder aus einer zufälligen Ziehung stammten.
Bei der schweren Teilmenge erreichte claude-opus-4.8 71,3 % mit ähnlichen Kandidaten und 92,0 % mit zufälligen Kandidaten. gemini-3.5-flash erreichte 77,0 % und 96,6 %. Beide Unterschiede hatten p-Werte unter 0.001 in gepaarten Tests.
Dieses Experiment verwendete Beschreibungen und eine Modellantwort pro Frage, ohne die agentische Tool-Schleife. Es stützt die engere Erkenntnis, dass die Auswahl ähnlicher Kandidaten die Datenbankauswahl erschwert. Die gemessene Lücke sollte nicht als Effekt der agentischen Exploration dargestellt werden.
Namen allein erzielten in einem Pilotversuch eine Genauigkeit von 68,8 % und 71,1 %
In einem weiteren Pilotversuch mit 128 Fragen wählte claude-opus-4.8 in 68,8 % der Fälle allein anhand der Namen die richtige Datenbank. Sein Ergebnis mit Namen und Beschreibungen betrug 67,2 %. gemini-3.5-flash erreichte 71,1 % anhand der Namen und 75,0 % anhand des vollständigen Katalogs.
Namen wie california_schools und toxicology verraten das Thema direkt. Für den Haupt-Benchmark ersetzen wir Datenbanknamen durch Aliase von db_01 bis db_11. Beschreibungen erläutern weiterhin die Domäne jeder Datenbank, und Tool-Antworten offenbaren ihre Tabellen- und Spaltennamen.
Zuverlässigkeit der Routing- und Kostenvergleiche
Wiederholte Läufe veränderten die Routing-Genauigkeit um 1.6 bis 2.7 Punkte
claude-opus-5 wählte im ersten Lauf bei 156 von 184 schweren Fragen die richtige Datenbank und bei der Wiederholung bei 151. Seine Genauigkeit fiel von 84,8 % auf 82,1 %. qwen3.8-max bewegte sich von 153 richtigen Antworten auf 150, ein Rückgang von 83,2 % auf 81,5 %.
Beide Wiederholungen verwendeten dieselben Fragen, Anonymisierung, Temperatur und Anbietereinstellungen wie ihre ursprünglichen Läufe. qwen3.8-max änderte seine Antwort bei 13 schweren Fragen, obwohl sich seine Gesamtzahl nur um drei veränderte. Verbesserungen bei einigen Fragen glichen Fehler bei anderen aus.
Diese Wiederholungen zeigen, dass kleine Punktedifferenzen in einem weiteren Lauf verschwinden können. Eine Wiederholung pro Modell kann keine Verteilung der Ergebnisse begründen, und die anderen 79 Modelle haben keine Wiederholungsmessung.
Erfasste Kosten hängen von Anbieter- und Caching-Einstellungen ab
Prompt-Caching verwendet bereits verarbeitete Eingaben wieder, um die berechneten Eingabekosten zu senken. Der Lauf von claude-opus-5 kostete $62,78, verglichen mit geschätzten $105,54 bei ungecachten Listenpreisen für dieselbe erfasste Nutzung. Diese Schätzung impliziert eine Ersparnis von 40,5 %. Es handelt sich um einen buchhalterischen Vergleich ohne separaten ungecachten Genauigkeitslauf.
Agentic RAG und Datenbankauswahl
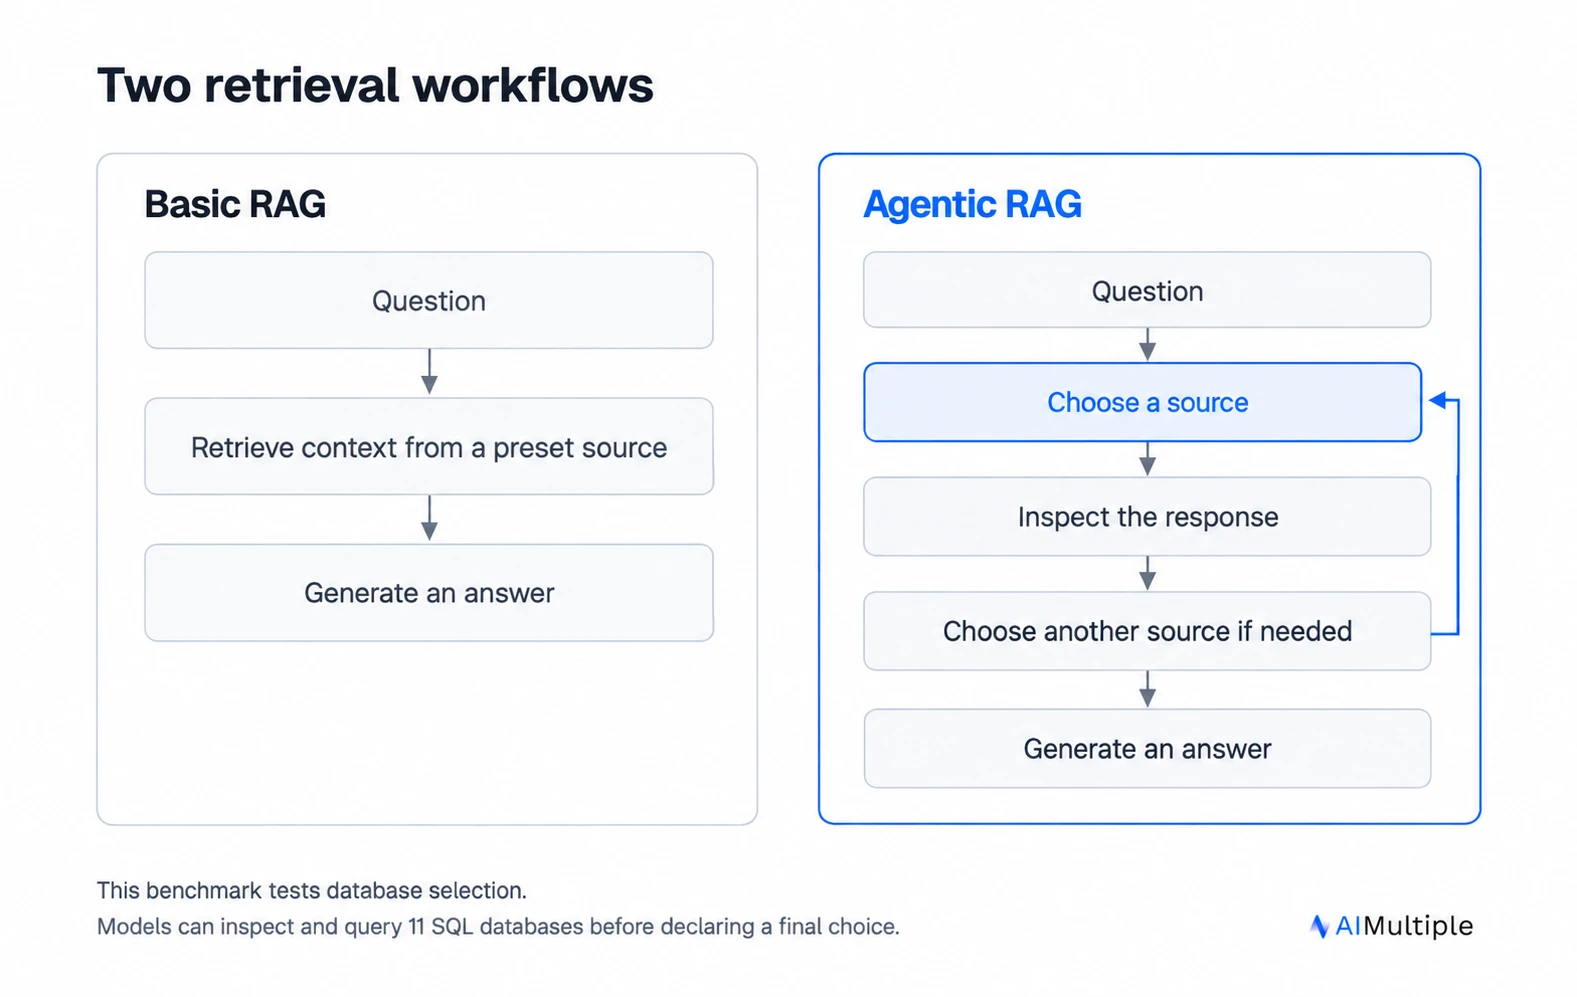
Agentic RAG gibt einem Modell Kontrolle über Abrufentscheidungen. Es kann eine Quelle wählen, die Antwort prüfen und eine weitere Anfrage stellen. Eine einfache RAG-Pipeline ruft Kontext durch eine vorgegebene Sequenz ab, bevor eine Antwort generiert wird.
Dieser Benchmark testet die Quellenauswahl mithilfe von SQL-Datenbank-Tools. Er enthält keinen Dokumentindex, keine abgerufenen Passagen und keinen Wert für die Antwort-Verankerung. Die Ergebnisse beschreiben daher einen Teil eines agentischen Abrufsystems. Die Dokumentsuche wird separat in unserem Agentic Search Benchmark behandelt.
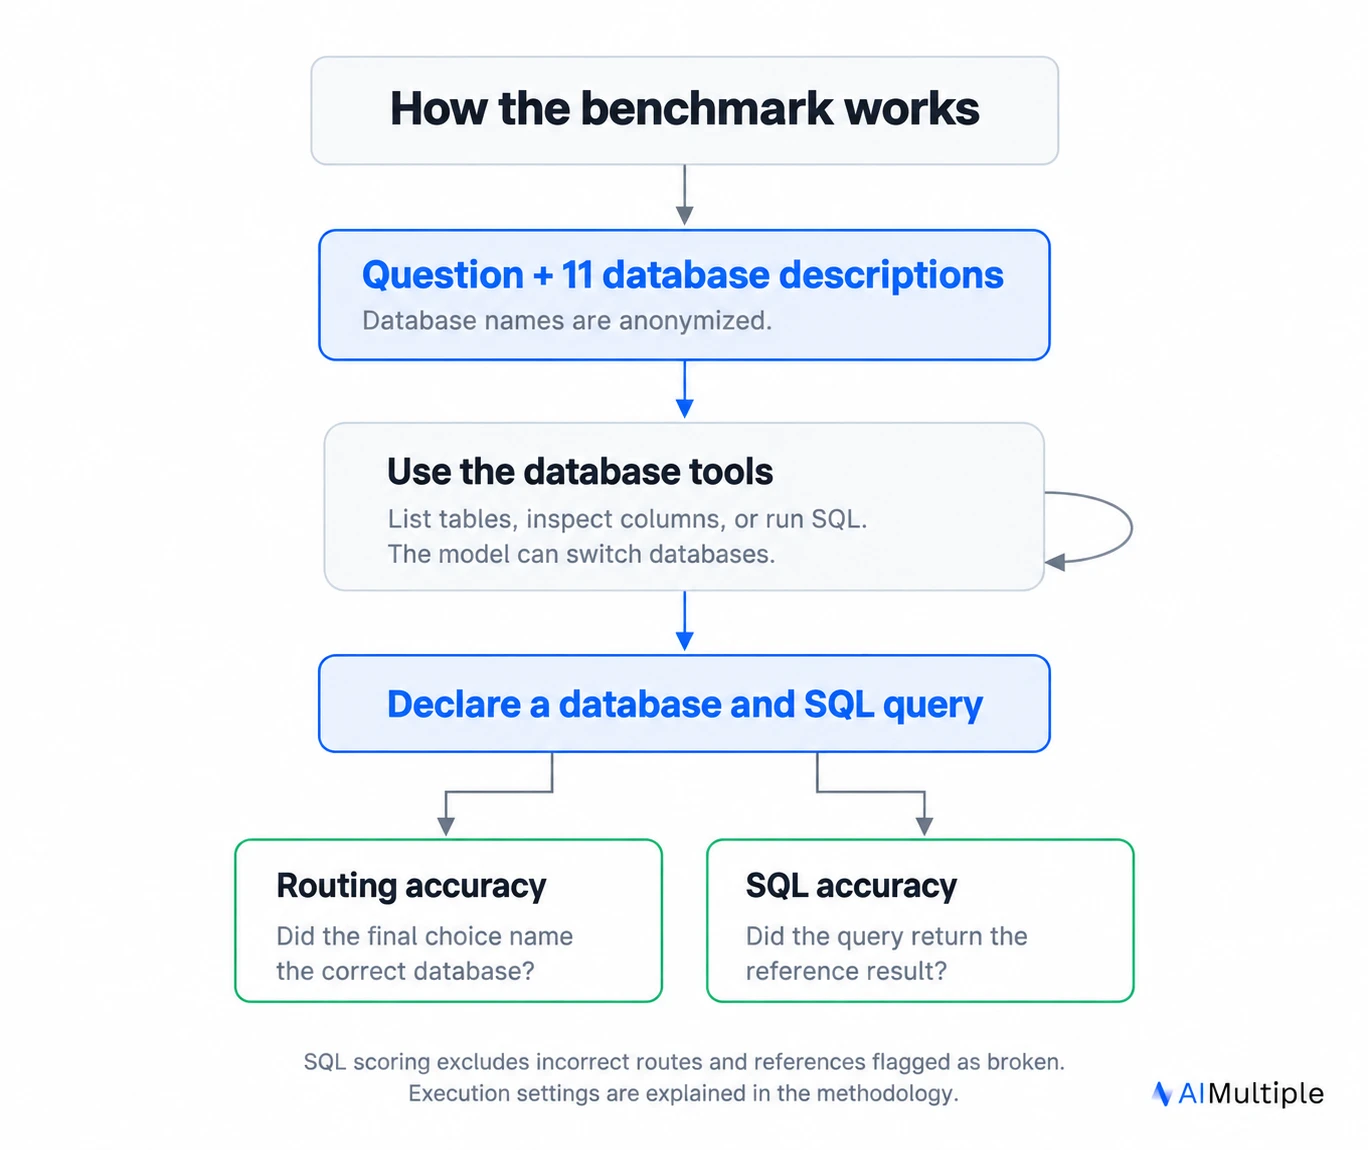
Ein Modell beginnt mit kurzen Datenbankbeschreibungen. Es kann Tabellenlisten anfordern, Spalten prüfen, SQL ausführen und Datenbanken wechseln. Seine endgültige Antwort enthält eine Datenbankauswahl und eine Abfrage. Unser Text-zu-SQL-Benchmark berichtet die SQL-Genauigkeit und zwei ergänzende Prüfwerte.
Agentic RAG Benchmark-Methodik
Der Fragensatz ist eine eingefrorene Teilmenge von BIRD-SQL, die natürlichsprachliche Fragen mit SQL-Referenzabfragen paart.1
Zwei Signale definieren die Schwierigkeit. Der Ähnlichkeitstest zählt, wie viele der 20 nächsten Nachbarn einer Frage zu anderen Datenbanken gehören. Drei LLMs bewerten, ob die Frage über Datenbanken hinweg verwirrend ist. Die Zugehörigkeit zur schwierigsten Gruppe erfordert mindestens fünf datenbankübergreifende Nachbarn und ein verwirrendes Jury-Label.
Das Routing verwendet die Datenbank, die unter dem expliziten Feld selected_database genannt wird. Eine aus Fließtext abgeleitete Route wird von der Headline ausgeschlossen. Die SQL-Korrektheit wird separat bewertet und bestimmt nicht die Routing-Anrechnung.
Der Harness ist die Software, die Tools bereitstellt und Modellantworten aufzeichnet. Das Panel enthält 78 OpenRouter-Läufe, zwei Claude Code-Läufe und einen Codex-CLI-Lauf. Unter den API-Läufen verwendeten 61 v3, 15 eine frühere Version, und zwei kombinierten Datensätze aus beiden Versionen. In v3 analysiert eine Wiederherstellungsschicht unterstützte alternative Tool-Aufrufformate. Für llama-4-maverick lag der aufgezeichnete Anteil nicht-nativer Formate bei 97,9 %, sodass dieses Ergebnis stark vom Adapter abhängt. minimax-m2.7 wurde ausgeschlossen, weil es die für die Aufgabe erforderlichen Datenbank-Tool-Aufrufe nicht ausführte.
GPT-6 Astra lief innerhalb der Codex CLI. Opus 5.5 und Fable 5.1 liefen über Claude Code. Alle drei verwendeten mittleren Denkaufwand und absolvierten 759 Fragen. Die Claude Code-Läufe verwendeten Abonnements, und Astra meldete keine Dollarkosten. Die Kostenübersicht enthält separat gekennzeichnete OpenRouter-äquivalente Schätzungen für diese drei CLI-Läufe. Die Läufe GPT-6 Luna, Luna Pro, Sol und Sol Pro sowie GPT-5.2 verwendeten OpenRouter.
 Als bevorzugte Quelle hinzufügen
Einschränkungen
Die schwere Teilmenge konzentriert sich auf den Handel. Vier Datenbanken tragen 171 der 184 Fragen bei, also 92,9 %. Fünf der 11 Datenbanken tragen nichts bei. Dies stützt Schlussfolgerungen über die Auswahl ähnlicher Datenbanken innerhalb einer Domäne, mit begrenzter Evidenz für andere Domänenkombinationen. GPT-6.1 Terra, MiniMax M3.1 Flash und Kimi K3.1 Pro absolvierten jeweils alle 759 Fragen über OpenRouter am 27. Oktober. Erfolgreiche frühere Antworten wurden beibehalten. Wiederholungsergebnisse können von Änderungen der Dienstverfügbarkeit abhängen. DeepSeek V4.1 Flash 1017 und Muse Spark Open absolvierten jeweils alle 759 Fragen über OpenRouter am 30. Oktober.
Öffentliche Benchmark-Daten könnten im Modelltraining enthalten gewesen sein. Kontrollen mit 138 validierten Paraphrasen und 65 neu verfassten Fragen fanden keinen Genauigkeitsrückgang bei den getesteten kostengünstigeren Modellen. Ihre Abdeckung war auf sechs bzw. drei Datenbanken beschränkt. Sie lösen das Kontaminationsproblem nicht für das gesamte Panel, und keine Kontrolle verwendete Datenbanken, die nach den Trainings-Stichtagen der Modelle veröffentlicht wurden.
Schema-Kürzungen können nützliche Tabellen verbergen. In works_cycles lässt die Begrenzung auf 4.000 Zeichen 26 von 66 Tabellen in der anfänglichen Schema-Auflistung sichtbar. Das Modell kann weitere Details anfordern, aber die anfängliche Ansicht ist unvollständig.
Fazit
gemini-4-argon verzeichnete mit 94,0 % den höchsten Routing-Wert bei schweren Fragen. DeepSeek V4 Flash 0731 erreichte 82,1 % mit $1,37 an Kosten für beibehaltene Antworten über den gesamten Lauf.
Ausführungs-Setup, Wiederholungen und Anbieterpreise begrenzen Vergleiche. Diese Ergebnisse messen die Datenbankauswahl unter ähnlichen SQL-Quellen. Dokumentabruf und fundierte Antwortgenerierung erfordern separate Evaluierungen.
Weiterführende Literatur
- Text-zu-SQL: Vergleich der LLM-Genauigkeit
- RAG Frameworks: LangChain vs LangGraph vs LlamaIndex
- Beste RAG-Tools, Frameworks und Bibliotheken
- Agentic Search im Jahr 2026: Benchmark mit 8 Such-APIs für Agenten
Zitieren Sie diesen Benchmark
Wählen Sie das Format, das zu Ihrem Veröffentlichungsort passt. Wenn Sie die Link-Version in Ihr CMS einfügen, bleibt der Backlink erhalten.
@misc{sari2026,
  author = {Sarı, Ekrem},
  title  = {{AIM-Agentic RAG Benchmark: Routing über 11 SQL-Datenbanken}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/agentic-rag}},
  note   = {AIMultiple. Abgerufen am 27. Oktober 2026}
}Ergebnisse und Zeitstempel von 1.1 Tausend Datenpunkten. Laden Sie die Zusammenfassungsdaten aus den Diagrammen und Tabellen dieses Artikels als ZIP-Datei herunter, die 7 CSV-Dateien und eine README enthält.
Möchten Sie die granularen Daten dahinter? Premium beitreten
Änderungsprotokoll
16 AktualisierungenDer Abschnitt „Was macht eine Frage in diesem Benchmark schwierig?“ wurde mit neuem Inhalt aktualisiert.
Die Methodik wurde aktualisiert, um zu verdeutlichen, wie die schwierigsten Fragen auf die Datenbanken verteilt sind.
Der Abschnitt zur Agentic RAG-Benchmark-Methodik wurde durch einen neuen ersetzt, der 36 LLMs und 11 Datenbanken abdeckt.
Neue Modelle zum Benchmark hinzugefügt: Claude Fable 5, Claude Opus 4.8, Gemini 3.5 Flash, Grok 4.3, Claude Opus 4.7.
Der Methodik-Abschnitt wurde mit neuen Details zur Datenbankumgebung, Agentenarchitektur und dem Evaluierungsprozess aktualisiert.
Ein Abschnitt über Langkontextmodelle im Vergleich zu Agentic RAG wurde hinzugefügt.
Zusätzliche Agentenmetriken aus der Methodik entfernt.
Referenzlinks








Seien Sie der Erste, der kommentiert
Ihre E-Mail-Adresse wird nicht veröffentlicht. Alle Felder sind erforderlich. Kommentare werden in ihrer Originalsprache belassen.