


15 KI-Agenten-Observability-Tools: AgentOps & Langfuse

Wir haben 15 Observability-Plattformen für LLM-Anwendungen und KI-Agenten getestet. Jede Plattform wurde praktisch umgesetzt, indem Workflows eingerichtet, Integrationen konfiguriert und Testszenarien ausgeführt wurden. Wir haben 4 Observability-Tools gebenchmarkt, um zu messen, ob sie in Produktions-Pipelines Overhead verursachen. Außerdem haben wir ein LangChain-Observability-Tutorial mit Langfuse demonstriert.
Benchmark des Overheads agentischer Monitoring-Tools
Wir haben jede Observability-Plattform in unser Multi-Agenten-Reiseplanungssystem integriert und 100 identische Abfragen ausgeführt, um ihren Leistungsoverhead im Vergleich zu einer Basislinie ohne Instrumentierung zu messen. Lesen Sie unsere Benchmark-Methodik.
- LangSmith zeigte außergewöhnliche Effizienz mit praktisch keinem messbaren Overhead und ist daher ideal für leistungskritische Produktionsumgebungen.
- Laminar verursachte minimalen Overhead von 5 % und eignet sich daher hervorragend für Produktionsumgebungen, in denen Leistung entscheidend ist.
- AgentOps und Langfuse zeigten moderaten Overhead von 12 % bzw. 15 %, was einen vernünftigen Kompromiss zwischen Observability-Funktionen und Leistungsauswirkungen darstellt. Diese Plattformen behalten für die meisten Produktionsanwendungsfälle weiterhin akzeptable Latenzzeiten bei.
Mögliche Gründe für Leistungsunterschiede
Unser Benchmark zeigt, dass Latenzunterschiede durch Instrumentierungstiefe und die Beteiligung am Ausführungspfad verursacht werden, insbesondere in Multi-Agenten-Workflows. Tools mit tieferer Observability auf Schrittebene wiesen höheren Overhead auf, während leichtere Tracing-Ansätze näher an der Basislinie blieben.
1. Instrumentierungstiefe im Ausführungspfad
Observability-Tools fügen dem Ausführungsfluss des Agenten Logik hinzu, um Traces und Metadaten zu erfassen. Wenn diese Logik während der Anfragebearbeitung synchron ausgeführt wird, erhöht sie direkt die End-to-End-Latenz, da der Agent diese zusätzliche Arbeit abschließen muss, bevor er eine Antwort zurückgibt.
Zum Beispiel:
- LangSmith verursachte praktisch keinen messbaren Overhead (~0 %), was auf wenig synchrone Arbeit hindeutet,
- Langfuses tiefere Instrumentierung auf Schrittebene trug zu einem höheren Overhead bei (~15 %).
2. Ereignisverstärkung über mehrstufige Pipelines
In Multi-Agenten-Systemen löst eine einzelne Nutzeranfrage mehrere Agentenaktionen aus. Wenn ein Tool bei jedem Schritt detaillierte Daten aufzeichnet, wächst die Gesamtzahl der Ereignisse schnell und erhöht den Verarbeitungs- und Trace-Handling-Overhead, je tiefer der Workflow wird.
In den Benchmark-Ergebnissen:
- Langfuse und AgentOps erzeugten in unserem mehrstufigen Reiseplanungs-Workflow spürbar höheren Overhead (15 % und 12 %)
- LangSmith und Laminar emittierten weniger Ereignisse pro Agentenschritt.
3. Inline-Evaluierungs- und Validierungsoverhead
Einige Plattformen führen während der Ausführung des Agenten zusätzliche Prüfungen oder Überwachungen durch. Obwohl jede Prüfung leichtgewichtig ist, führt ihre wiederholte Anwendung über alle Agentenschritte hinweg zu messbarer Latenz.
Zum Beispiel:
- Das Lifecycle-orientierte Monitoring von AgentOps ging mit einem Overhead von 12 % einher
- Laminar zeigte keine Anzeichen dafür, dass Inline-Evaluierung die Ausführung beeinflusst, und blieb bei ~5 %.
4. Serialisierungs- und Persistenzhäufigkeit
Das Erfassen detaillierter Observability-Daten erfordert das Serialisieren von Traces und das Schreiben in Speicher oder externe Backends. Höhere Trace-Details erhöhen die Häufigkeit dieses Vorgangs und fügen jeder Anfrage I/O-Overhead hinzu.
In unserem Benchmark:
- Das detaillierte Prompt-, Output- und Token-Tracing von Langfuse führte zum höchsten Overhead (~15 %)
- LangSmiths leichtere Trace-Artefakte blieben nahe an der Basislinie.
5. Integrationstiefe mit dem Agenten-Framework
Wie eng ein Tool in das Agenten-Framework integriert ist, wirkt sich auf die Leistung aus. Engere Integrationen reduzieren Übersetzungs- und Orchestrierungsschritte, während generischere SDKs zusätzliche Verarbeitungsschichten hinzufügen.
Zum Beispiel:
- LangSmiths enge Ausrichtung an der Agentenausführung korrelierte mit ~0 % Overhead
- AgentOps und Langfuse zeigten höhere Latenzauswirkungen, passend zu stärker entkoppelten Integrationspfaden.
KI-Agenten-Observability-Plattformen
Stufe 1: Feingranulare LLM- & Prompt-/Output-Observability
* Die in diesen Spalten aufgeführten Funktionen sind illustrative Beispiele dafür, was jedes Tool überwachen kann, wenn es durch Integrationen oder Anpassungen erweitert wird. Sie sind nicht exklusiv für eine einzelne Plattform.
Stufe 2: Workflow-, Modell- & Evaluierungs-Observability
Stufe 3: Agentenlebenszyklus- & Betriebs-Observability
Stufe 4: System- & Infrastrukturüberwachung (nicht agentennativ)
Datadog (mit seinem LLM-Observability-Modul) und Prometheus (über Exporteure) werden zunehmend neben Langfuse/LangSmith eingesetzt.
Plattformen für Agentenentwicklung & -orchestrierung:
- Tools wie Flowise, Langflow, SuperAGI und CrewAI ermöglichen das Erstellen, Orchestrieren und Optimieren von Agenten-Workflows mit No-Code-/Low-Code-Oberflächen
Deployment-free-Editionen & Preise
Die free-Editionen variieren je nach Nutzungslimits (z. B. Beobachtungen, Traces, Tokens oder Arbeitseinheiten). Die Einstiegspreise gelten in der Regel für einen Basisplan, der Einschränkungen bei Funktionen, Nutzern oder Nutzungslimits aufweisen kann.
CoreWeave Forge (W&B Weave)
Anwendungsfall: Debuggen von Fehlern in Multi-Agenten-Systemen durch Nachverfolgen, wie sich Fehler über Agentenaufrufe ausbreiten.
W&B Weave, Teil von CoreWeave Forge (früher Weights & Biases), zeichnet strukturierte Ausführungs-Traces für Multi-Agenten-Systeme auf und bewahrt die Eltern-Kind-Beziehungen zwischen Agentenaufrufen.
Weave-Überwachungsfunktionen
- Hierarchisches Agenten-Tracing statt flacher Anfrageprotokolle
- Kosten- und Latenzzuordnung auf Agenten-Ebene
- Native Unterstützung für Evaluierungs-Scorer, die direkt auf Traces angewendet werden.
Evaluierungsfunktionen
Weave bietet außerdem integrierte Scorer für die Evaluierung, darunter:
- HallucinationFreeScorer zur Erkennung von Halluzinationen,
- SummarizationScorer zur Bewertung der Zusammenfassungsqualität,
- EmbeddingSimilarityScorer für semantische Ähnlichkeit,
- ValidJSONScorer und ValidXMLScorer zur Formatvalidierung,
- PydanticScorer für Schema-Compliance,
- OpenAIModerationScorer für Inhaltssicherheit,
- RAGAS-Scorer wie ContextEntityRecallScorer,
- ContextRelevancyScorer für die RAG-Systemevaluierung.
Am besten geeignet für: Teams, die mehrstufige oder Multi-Agenten-Workflows ausführen und eine Ursachenanalyse auf Trace-Ebene statt oberflächlicher Metriken benötigen.
Langfuse
Anwendungsfälle: LLM-Interaktionen verfolgen, Prompt-Versionen verwalten und die Modellleistung mit Nutzersitzungen überwachen.
Langfuse bietet tiefe Einblicke in die Prompt-Ebene und erfasst Prompts, Antworten, Kosten und Ausführungs-Traces, um LLM-Anwendungen zu debuggen, zu überwachen und zu optimieren.
Langfuse ist jedoch möglicherweise nicht für Teams geeignet, die Git-basierte Workflows für Code- und Prompt-Verwaltung bevorzugen, da sein externes Prompt-Management-System möglicherweise nicht dasselbe Maß an Versionskontrolle und Zusammenarbeit bietet.
Langfuse-Überwachungsfunktionen
- Einblick in die Prompt-Entwicklung und Nutzungsmuster
- Sitzungsbasierte Analyse, geeignet für benutzerorientierte Anwendungen
- Praktisches Metadaten- und Tagging-Modell für Filterung und Überprüfung
Enterprise-Funktionen:
Einige dieser Funktionen sind:
- Protokollstufen: Passen Sie die Ausführlichkeit von Protokollen für detailliertere Einblicke an.
- Multimodalität: Unterstützt Text, Bilder, Audio und andere Formate für multimodale LLM-Anwendungen.
- Releases & Versionierung: Verfolgen Sie den Versionsverlauf und sehen Sie, wie neue Releases die Modellleistung beeinflussen.
- Trace-URLs: Zugriff auf detaillierte Traces über eindeutige URLs zur weiteren Inspektion und Fehlerbehebung.
- Agentengraphen: Visualisieren Sie Agenteninteraktionen und -abhängigkeiten für ein besseres Verständnis des Agentenverhaltens.
- Sampling: Erfassen Sie repräsentative Daten aus Interaktionen zur Analyse, ohne das System zu überlasten.
- Token- & Kostenverfolgung: Verfolgen Sie Token-Nutzung und Kosten für jeden Modellaufruf und sorgen Sie so für effizientes Ressourcenmanagement.
- Maskierung: Schützen Sie sensible Daten, indem Sie in Traces maskieren und so Datenschutz und Compliance gewährleisten.
Am besten geeignet für: Teams, die Prompts iterieren und die Nutzung in der Produktion überwachen, insbesondere dort, wo Nutzersitzungen wichtig sind.
Galileo
Anwendungsfälle: Kosten/Latenz überwachen, Ausgabequalität bewerten, unsichere Antworten blockieren und umsetzbare Korrekturen bereitstellen.
Galileo verfolgt Kosten-, Latenz- und Ausgabequalitätsmetriken und wendet gleichzeitig Echtzeit-Sicherheits- und Compliance-Prüfungen an.
Die Plattform kombiniert traditionelle Observability (Latenz, Kosten, Leistung) mit KI-gestütztem Debugging und Evaluierung (Halluzinationserkennung, faktische Korrektheit, Kohärenz, Kontexttreue).
Galileo-Überwachungsfunktionen
- Erkennung von Fehlermodi jenseits oberflächlicher Fehler (z. B. Halluzinationen, die zu ungültigen Tool-Eingaben führen)
- Präskriptives Feedback wie vorgeschlagene Prompt-Änderungen oder Few-Shot-Ergänzungen
- Enge Kopplung zwischen Evaluierungsergebnissen und empfohlenen Korrekturen.
Am besten geeignet für: Unternehmen, die Ausgabequalität, Sicherheit und schnelle Iterationszyklen mit geführter Behebung priorisieren.
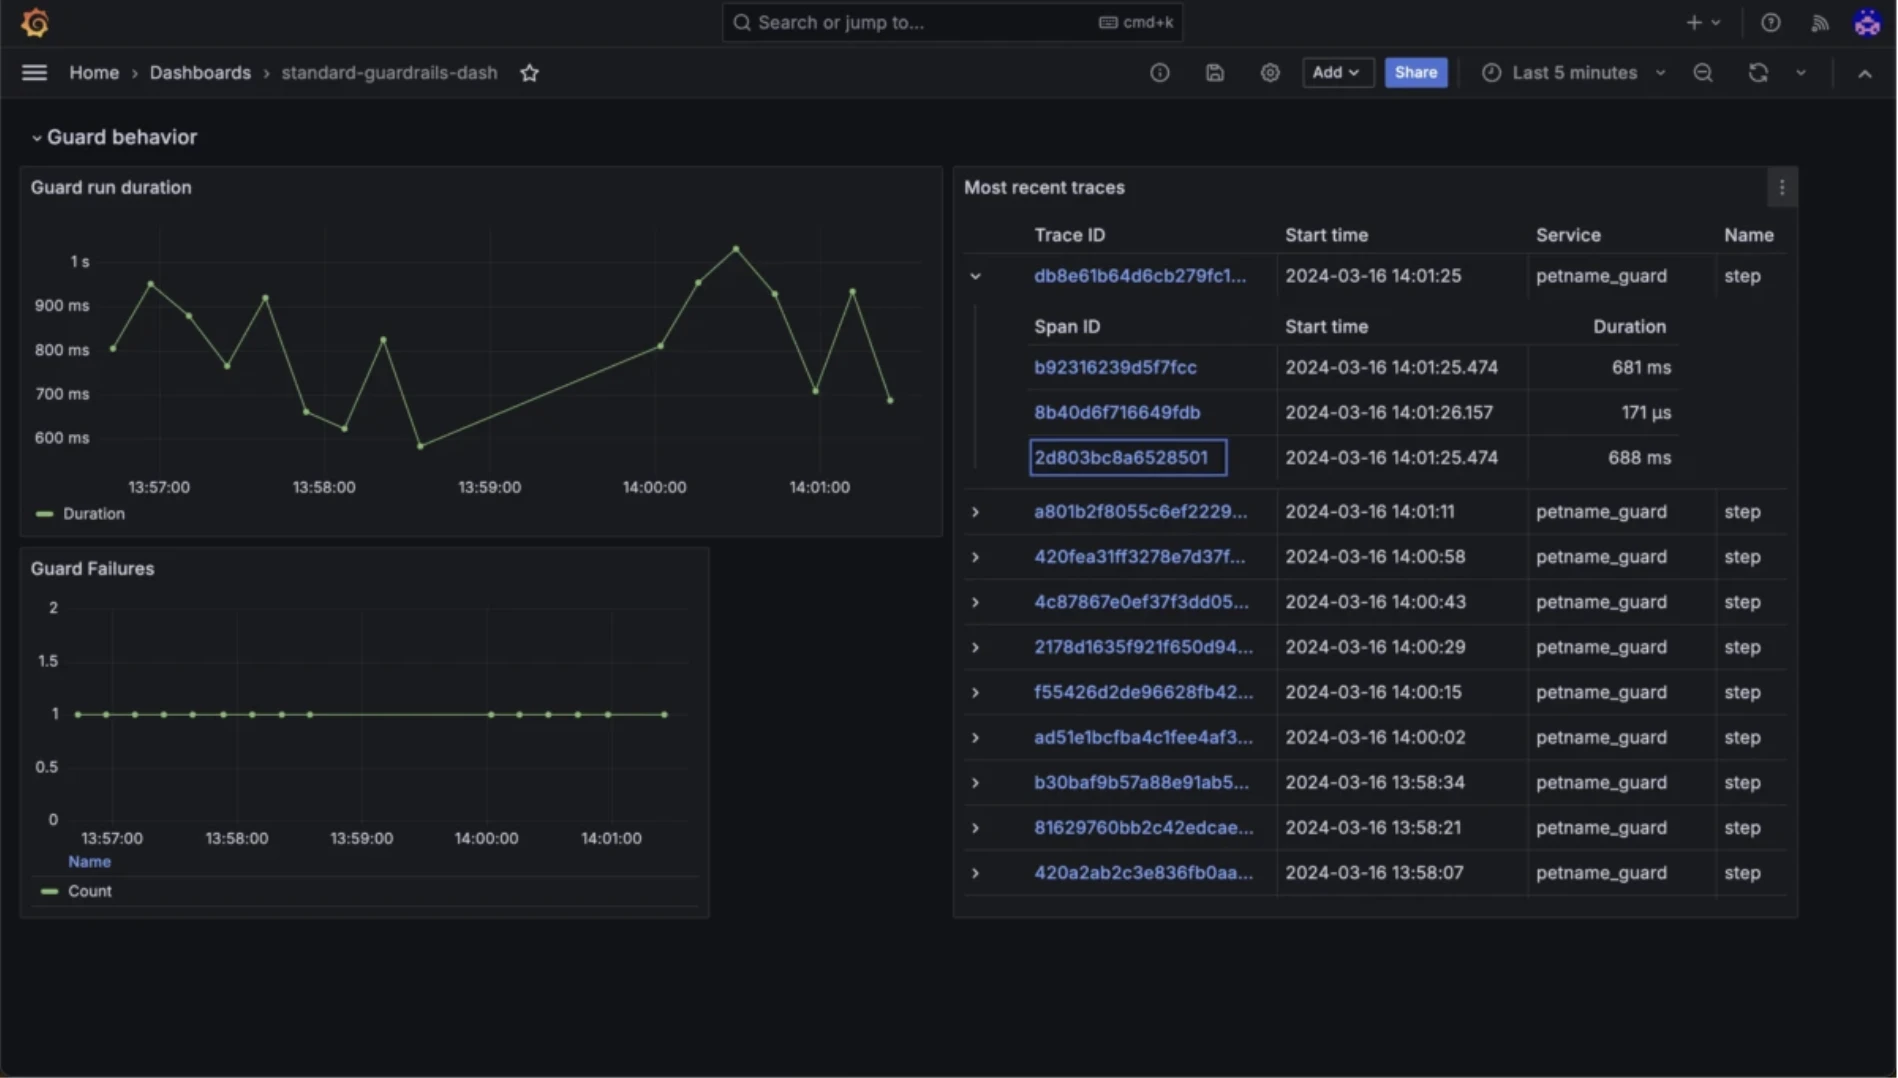
Guardrails AI
Anwendungsfälle: Schädliche Ausgaben verhindern, LLM-Antworten validieren und die Einhaltung von Sicherheitsrichtlinien sicherstellen
Guardrails validiert LLM-Eingaben und -Ausgaben anhand konfigurierbarer Regeln, einschließlich Toxizität, Bias, PII-Exposition, Kennzeichnung von Halluzinationen und Format-Compliance.
Guardrails AI Überwachungsfunktionen
- Deterministische Validierung über RAIL-Spezifikationen
- Input-Guards für Prompt-Injection- und Jailbreak-Erkennung
- Automatische Wiederholungen bei fehlgeschlagener Validierung.
Am besten geeignet für
Teams, die strenge Sicherheits-, Compliance- oder Formatierungsgarantien durchsetzen müssen, bevor Antworten zurückgegeben werden.
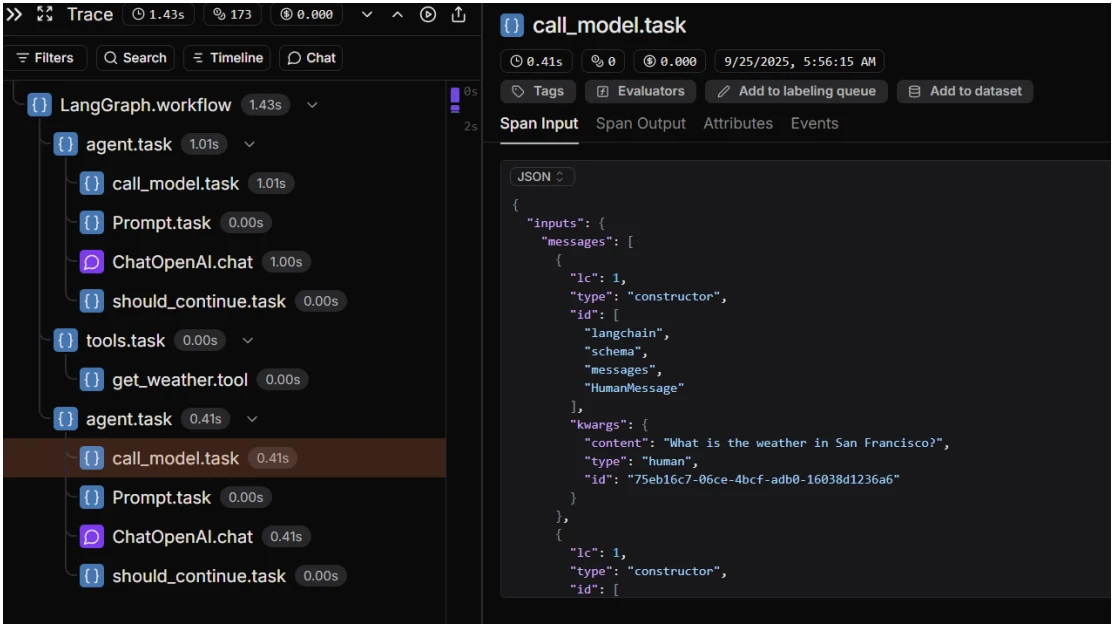
LangSmith
Anwendungsfälle: Agenten-Reasoning und Tool-Aufruf-Debugging (LangChain-zentriert)
LangSmith erfasst vollständige Reasoning-Traces für auf LangChain basierende Agenten, einschließlich Prompts, abgerufenem Kontext, Tool-Auswahllogik, Tool-Eingaben/-Ausgaben, Fehlern und Ausnahmen.
LangSmith-Überwachungsfunktionen
- Schritt-für-Schritt-Inspektion der Entscheidungspfade von Agenten
- Run-Wiedergabe und direkter Vergleich über Prompts, Modelle oder Tools hinweg
- Enge Integration mit LangChain über Callbacks.
Am besten geeignet für
Teams, die mit LangChain entwickeln und fehlerhaftes Reasoning oder Tool-Aufrufe im Detail debuggen müssen.
Langtrace KI
Anwendungsfälle: Identifizieren von Kosten- und Latenzengpässen in LLM-Apps
Langtrace verfolgt Token-Anzahlen, Ausführungsdauer, API-Kosten und Anfrageparameter über LLM-Pipelines hinweg mithilfe OpenTelemetry-kompatibler Traces.
Langtrace KI Überwachungsfunktionen
- OpenTelemetry-Ausrichtung für die Integration in bestehende Backends
- Einblick in Kosten- und Latenztreiber pro Schritt
- Leichtgewichtige Prompt-Versionierung und Test-Playground.
Am besten geeignet für: Teams, die Leistung und Ausgaben über LLM-Workflows hinweg optimieren, statt die Ausgabequalität zu bewerten.
Arize (Phoenix)
Anwendungsfälle: Modelldrift überwachen, Bias erkennen und LLM-Ausgaben mit umfassenden Scoring-Systemen bewerten
Phoenix konzentriert sich auf Verhaltensdrift, Bias-Erkennung und LLM-as-a-Judge-Scoring für Relevanz, Toxizität und Genauigkeit.
Es hat jedoch einen höheren Integrationsoverhead im Vergleich zu leichtgewichtigen Proxys und verwaltet die Prompt-Versionierung nicht so sauber wie dedizierte Tools.
Phoenix-Überwachungsfunktionen
- Open-Source-Kern mit optionalen Enterprise-Erweiterungen
- Interaktiver Prompt-Playground für die Entwicklung
- Drift-Erkennung zur Verfolgung von Verhaltensänderungen im Zeitverlauf
- Bias-Prüfungen zur Identifizierung von Antwortverzerrungen,
- LLM-as-a-Judge-Scoring für Genauigkeit, Toxizität und Relevanz.
Am besten geeignet für: Teams, die langfristiges Modellverhalten und Regressionsrisiken überwachen, statt Prompt-Iterationen durchzuführen.
Agenta
Anwendungsfälle: Herausfinden, welcher Prompt bei welchem Modell am besten funktioniert
Agenta vergleicht Modellantworten hinsichtlich Kosten, Latenz und Ausgabequalität anhand gemeinsamer Eingaben und kontrolliertem Kontext.
Agenta-Überwachungsfunktionen
- Modellbewertung nebeneinander
- Entscheidungsunterstützung vor der Produktion.
Am besten geeignet für: Frühphasen-Evaluierung und Modellauswahl.
AgentOps.ai
Anwendungsfälle: Agenten-Reasoning überwachen, Kosten verfolgen und Sitzungen in der Produktion debuggen
AgentOps erfasst Reasoning-Traces, Tool-/API-Aufrufe, Sitzungsstatus, Caching-Verhalten und Kostenmetriken für eingesetzte Agenten.
AgentOps-Überwachungsfunktionen
- Session-Replay für die Produktions-Fehlerbehebung
- Fokus auf Live-Agentenverhalten statt Offline-Evaluierung.
Am besten geeignet für: Teams, die Agenten in der Produktion betreiben und operative Transparenz benötigen.
Braintrust
Anwendungsfälle: Herausfinden, welcher Prompt, welches Dataset oder welches Modell mit detaillierter Evaluierung und Fehleranalyse besser abschneidet
Braintrust bewertet Prompts, Datasets und Modelle anhand erwarteter Ausgaben und verfolgt Latenz, Kosten, Tool-Fehler und Ausführungsmetriken.
Braintrust-Überwachungsfunktionen
- Evaluieren Sie Test-Datasets mit Eingaben und erwarteten Ausgaben und vergleichen Sie dann Prompts oder Modelle nebeneinander mithilfe von Variablen wie
{{input}},{{expected}}und{{metadata}}. - Metrikaufschlüsselungen einschließlich der Qualität der Tool-Ausführung
Am besten geeignet für: Teams, die Modelle und Prompts vor der Einführung benchmarken.
AgentNeo
Anwendungsfälle: Debuggen von Multi-Agenten-Interaktionen, Nachverfolgen der Tool-Nutzung und Bewerten von Koordinations-Workflows
AgentNeo verfolgt Agentenkommunikation, Tool-Nutzung, Ausführungsgraphen sowie Kosten und Latenz pro Agent über ein Python-SDK.
AgentNeo-Überwachungsfunktionen
- Open Source und lokal ausführbar
- Interaktives lokales Dashboard (
localhost:3000) für die Echtzeitüberwachung von Multi-Agenten-Workflows. - Integration mithilfe von Decorators (z. B.
@tracer.trace_agent,@tracer.trace_tool)
Am besten geeignet für: Engineering-Teams, die mit Multi-Agenten-Systemen experimentieren.
 Als bevorzugte Quelle hinzufügen
Laminar
Anwendungsfall: Verfolgen Sie die Leistung über verschiedene LLM-Frameworks und -Modelle hinweg.
Laminar verfolgt Ausführungs-Spans, Kosten, Token-Nutzung und Latenzperzentile über LLM-Frameworks und -Modelle hinweg.
Laminar-Überwachungsfunktionen
- Framework-agnostische Leistungsanalyse
- Feingranulare Span-Inspektion.
Am besten geeignet für: Vergleichende Leistungsanalysen über heterogene Stacks hinweg.
Helicone
Anwendungsfälle: Mehrstufige Agenten-Workflows verfolgen und Nutzersitzungsmuster analysieren.
Helicone erfasst Anfragevolumen, Kosten, Fehler, Latenztrends und Agenten-Workflows auf Sitzungsebene.
Helicone-Überwachungsfunktionen
- Einblick in die User Journey
- Analyse historischer Trends.
Am besten geeignet für: Produktteams, die Nutzungsmuster und nutzerbezogenes Verhalten überwachen.
Coval
Anwendungsfälle: Tausende von Agentengesprächen simulieren, Sprach-/Chat-Interaktionen testen und das Verhalten vor der Bereitstellung validieren.
Coval simuliert Tausende von Gesprächen, um Aufgabenerfüllung, Korrektheit und Effektivität von Tool-Aufrufen zu messen.
Coval-Überwachungsfunktionen
- Simulationsbasiertes Testen von Agenten
- Automatische Regressionserkennung
- Unterstützung für Sprach- und Textagenten.
Am besten geeignet für: Validierung vor der Bereitstellung und Regressionserkennung.
Datadog
Anwendungsfälle: Infrastruktur- und Anwendungs-Observability mit LLM-Signalkorrelation.
Datadog sammelt Infrastrukturmetriken (CPU, Speicher, Netzwerk), Anwendungsleistungsdaten (Latenz, Fehlerraten, Durchsatz) und Logs. Für LLM-Anwendungen kann es Token-Nutzung, Kosten pro Anfrage, Modelllatenz und sicherheitsrelevante Signale wie Prompt-Injection-Versuche aufnehmen.
Datadog Überwachungsfunktionen
- Breite, systemweite Observability über Infrastruktur, Anwendungen und KI-Workloads hinweg
- Großes Integrations-Ökosystem (900+ Integrationen), das die Korrelation zwischen KI-Verhalten und Infrastrukturzustand ermöglicht
Am besten geeignet für: Unternehmen, die LLM-Verhalten mit der zugrunde liegenden Infrastruktur- und Anwendungsleistung korrelieren möchten, statt Agenten-Reasoning oder Prompts zu untersuchen
Prometheus
Anwendungsfälle: Systemleistung überwachen, Anwendungsmetriken verfolgen und Alerting für Infrastrukturprobleme einrichten.
Prometheus ist ein Open-Source-Überwachungssystem, das Zeitreihenmetriken in regelmäßigen Abständen von HTTP-Endpoints abruft, um Infrastruktur-, Anwendungs-, Datenbank-, Container- und benutzerdefinierte Geschäftsmetriken zu verfolgen.
Prometheus-Überwachungsfunktionen
- Zeitreihenmetriken-Erfassung durch Pull-basiertes Scraping
- PromQL für Abfragen, Aggregation und Alert-Bedingungen
- Exporteur-Ökosystem (z. B. Node Exporter) für breite Systemabdeckung
Am besten geeignet für: Infrastruktur- und Anwendungsüberwachung mit regelbasiertem Alerting.
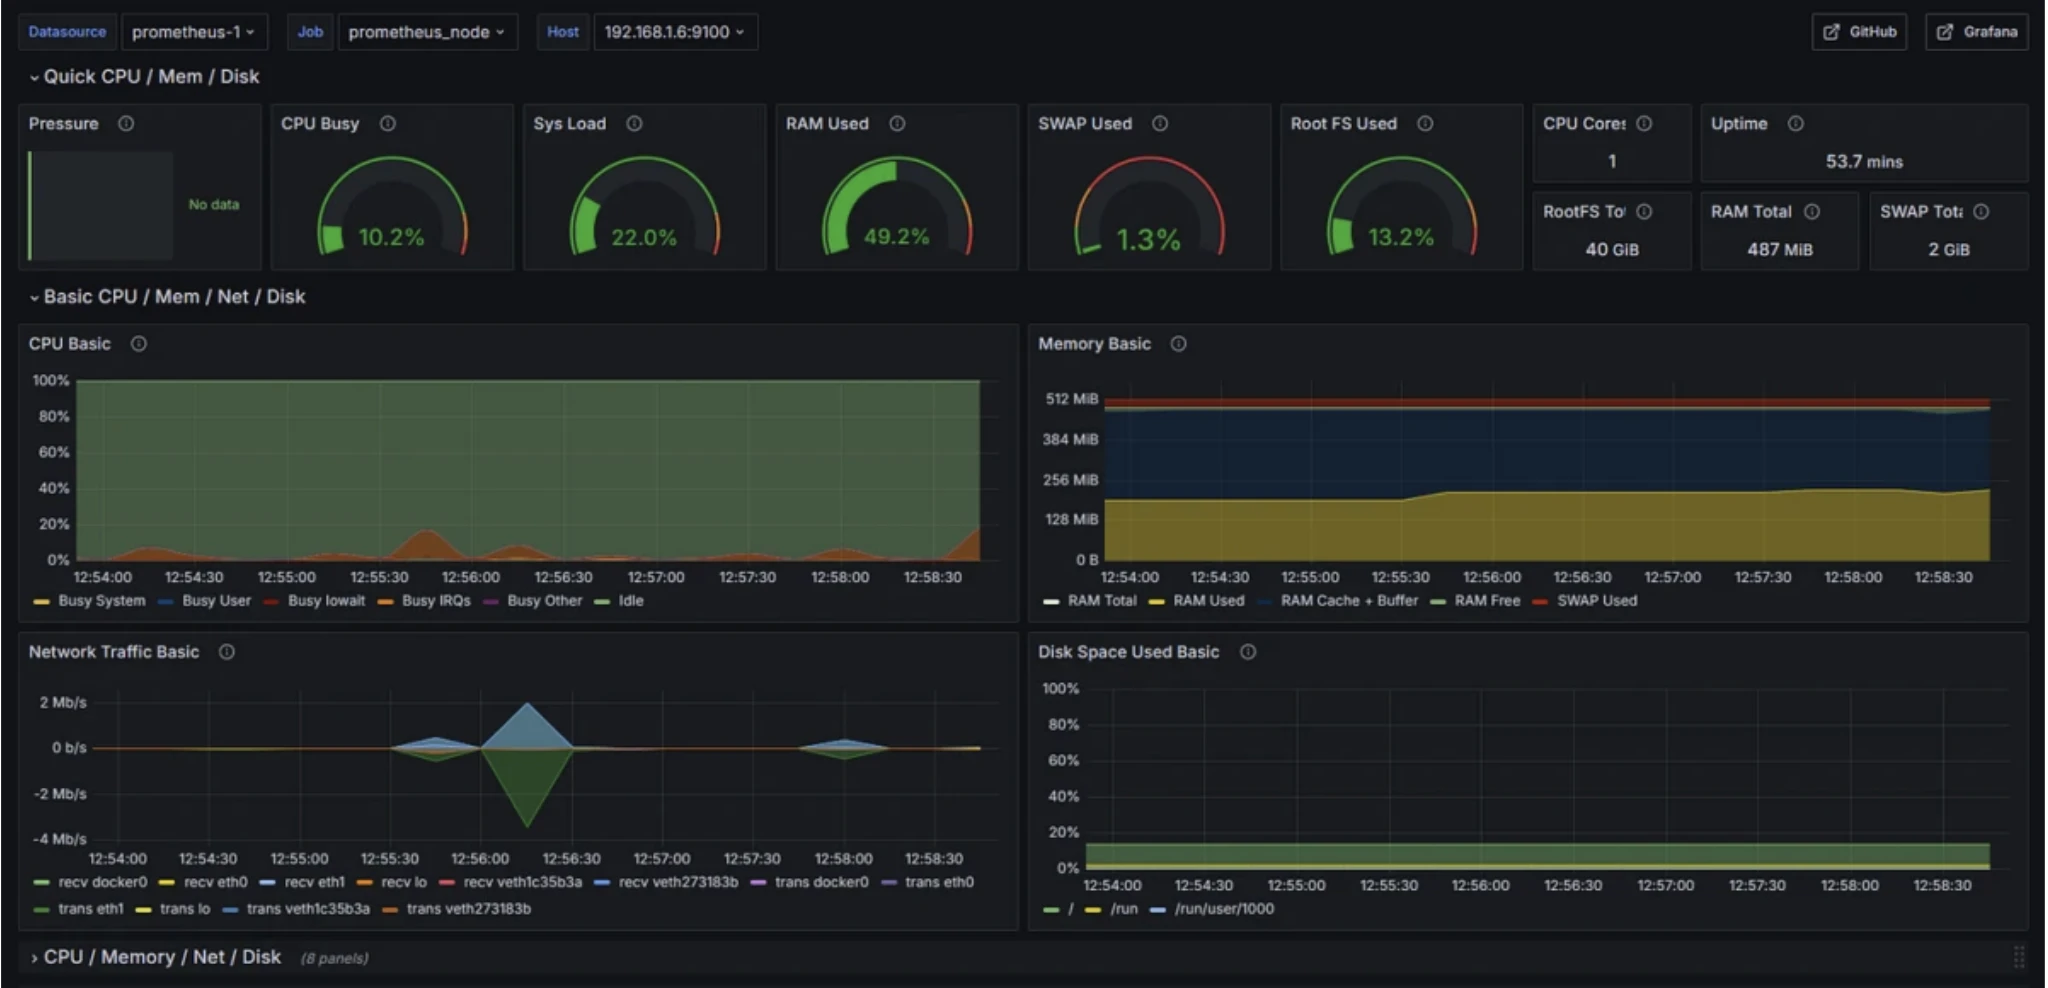
Grafana
Anwendungsfälle: Metriken visualisieren, Dashboards erstellen und Alerts über LLM-, Agenten- und Infrastrukturdaten hinweg routen.
Grafana ist eine Open-Source-Visualisierungs- und Analyseplattform, die sich in Datenquellen wie Prometheus, OpenTelemetry und Datadog integriert, um einheitliche Observability-Dashboards bereitzustellen.
Grafana-Überwachungsfunktionen
- Dashboards für Metriken, Logs und Traces
- Systemübergreifende Korrelation für LLM-, Agenten- und Infrastruktursignale
- Alert-Routing und Benachrichtigungsmanagement.
Am besten geeignet für: Zentralisierte Observability-Visualisierung und Incident-Response.
Tutorial: LangChain-Observability mit Langfuse
Wir haben eine mehrstufige LangChain-Pipeline mit drei Phasen erstellt:
- Fragenanalyse
- Antwortgenerierung
- Antwortverifizierung
Nach dem Einrichten der Pipeline haben wir sie mit Langfuse verbunden, um die Ausführung in Echtzeit zu überwachen und zu verfolgen. Dadurch konnten wir untersuchen, wie Langfuse uns hilft, detaillierte Einblicke in die Leistung, Kosten und das Verhalten von KI-Anwendungen zu gewinnen.
Hier ist, was wir durch Langfuse beobachtet haben:
Dashboard-Übersicht
Langfuse stellte uns mehrere Dashboards zur Verfügung, die uns Einblicke in verschiedene Aspekte der Pipeline-Leistung geben:
- Kosten-Dashboard: Dieses verfolgt die Ausgaben über alle API-Aufrufe hinweg, mit detaillierten Aufschlüsselungen pro Modell und Zeitraum.
- Nutzungsverwaltung: Es überwacht Ausführungsmetriken wie Observationsanzahl und Ressourcenzuweisung und hilft uns zu verfolgen, wie Ressourcen während der Ausführung genutzt werden.
- Latenz-Dashboard: Dieses Dashboard half uns, Antwortzeiten zu analysieren, Engpässe zu erkennen und Leistungstrends zu visualisieren.
Nutzungsmetriken
Das Nutzungsmetriken-Dashboard gab uns folgende Einblicke in die Systemleistung:
- Gesamtzahl der Traces: Wir haben acht Traces verfolgt, von denen jeder einen vollständigen Frage-Antwort-Zyklus in der Pipeline darstellt.
- Gesamtzahl der Observations: Im Durchschnitt hatte jeder Trace 16 Observations, was den mehrstufigen Charakter des Prozesses widerspiegelt.
Darüber hinaus ermöglicht uns Langfuse, Nutzungsmuster, Ressourcenzuweisung und Spitzenzeiten über die letzten 7 Tage zu verfolgen, was uns hilft zu verstehen, wann das System am aktivsten ist und wie Ressourcen über die Zeit verteilt sind.
Trace-Inspektion
Beim Drilldown in einen einzelnen Trace konnten wir detaillierte Ausführungsinformationen sehen:
- Trace-Zeilen: Jede Zeile stellt eine vollständige Pipeline-Ausführung mit einer eindeutigen Trace-ID dar.
- Latenzmetriken: Die Ausführungszeit variierte und reichte von 0.00s bis 34.08s.
- Token-Anzahl: Das Dashboard verfolgte die Eingabe-/Ausgabe-Token-Nutzung, was beim Kosten- und Effizienzmanagement hilft.
- Umgebungsfilterung: Wir konnten Traces anhand von Bereitstellungsumgebungen filtern (z. B. Entwicklung, Produktion).
Details einzelner Traces
Wir haben den Trace weiter im Detail untersucht, um die Ausführungsaufschlüsselung zu verstehen:
- Sequentielle Chain-Architektur: Der Trace zeigte einen visuellen Ablauf mit jedem Schritt, beginnend bei SequentialChain → LLMChain → ChatOpenAI, mit hierarchischer Struktur.
- Input-/Output-Verfolgung: Die ursprüngliche Frage „Welche Vorteile bietet die Nutzung von Langfuse für die Observability von KI-Agenten?“ wurde in jeder Phase zusammen mit den jeweiligen von der KI in jedem Schritt erzeugten Ausgaben verfolgt.
- Token-Analyse: Wir stellten fest, dass 1.203 Tokens für die Eingabe und 1.516 Tokens für die Ausgabe verwendet wurden, was Kostenauswirkungen im Zusammenhang mit der Token-Nutzung hat und zur Optimierung des Ressourcenmanagements beiträgt.
- Zeitdaten: Die Gesamtlatenz für den gesamten Trace betrug 34.08s und verteilte sich auf die einzelnen Komponenten:
- SequentialChain → 14.02s
- LLMChain → 10.25s
- ChatOpenAI → 9.81s
- Modellinformationen: Langfuse bestätigte die Verwendung des Modells Anthropic Claude-Sonnet-4, mit Details zu den spezifischen Einstellungen, einschließlich der Temperaturkonfiguration.
- Formatierte Ausgabe: Sowohl Vorschau als auch JSON-Ansichten wurden für das Debugging bereitgestellt und gaben Einblicke in die Modellantwort in menschenlesbarer Form und maschinenlesbarem Format.
Automatisierte Analyse
Langfuse lieferte außerdem automatisierte Bewertungen unserer Antworten:
- Qualitätsbewertung: Das System bewertete Struktur, Kohärenz und Vollständigkeit der Antworten, hob gut organisierte Abschnitte hervor, wies jedoch darauf hin, dass die Antworten prägnanter sein könnten.
- Verbesserungsvorschläge: Es identifizierte Abschnitte mit Redundanz, schlug vor, wo Formulierungen verbessert werden könnten, und fasste verwandte Punkte zusammen, um die Antwort transparenter und effizienter zu machen.
- Leistungseinblicke: Das System gab Feedback zur Token-Nutzung und Antwortrelevanz und half uns, die Effizienz zu optimieren, während die Ausgabe hilfreich und themenbezogen bleibt.
- Strukturiertes Feedback: Das Feedback war in Kategorien organisiert, sodass wir gezielt bestimmte Verbesserungsbereiche angehen konnten.
Nutzeranalyse
Langfuse verfolgt detaillierte Interaktionen zwischen Nutzern und dem KI-Agenten:
- Nutzeraktivitäts-Zeitstrahl: Zeigt die erste und letzte Interaktion jedes Nutzers und hilft, aktive von inaktiven Nutzern zu unterscheiden. Wir können sehen, wann Nutzer erstmals und zuletzt mit dem System interagiert haben.
- Ereignisvolumen-Verfolgung: Verfolgt die Anzahl der Ereignisse, die jeder Nutzer ausgelöst hat. Einige Nutzer erzeugten beispielsweise über 2.000 Ereignisse, was ihr Engagement mit dem System zeigt.
- Token-Verbrauchsanalyse: Überwacht die Gesamtzahl der von jedem Nutzer verbrauchten Tokens. Die Token-Nutzung reichte von 6.59K bis 357K Tokens und gab Einblicke in die Ressourcennutzung.
- Kostenzuordnung: Schlüsselt die mit jedem Nutzer verbundenen Kosten auf und erleichtert so die Nachverfolgung von Ausgaben und die Optimierung der Budgetzuweisung.
- Nutzeridentifikation: Verwendet anonymisierte Nutzer-IDs, um die Privatsphäre zu wahren und gleichzeitig individuelle Nutzerinteraktionen zu verfolgen. Dies unterstützt die Nutzungsanalyse, ohne die Vertraulichkeit der Nutzer zu gefährden.
Die Sitzungsansicht ermöglicht es uns, granulare Details der Nutzerinteraktionen zu verfolgen:
- Vollständiger Gesprächsfluss: Zeigt die vollständige Frage-Antwort-Interaktion, sodass das gesamte Gespräch von Anfang bis Ende leicht nachvollziehbar ist.
- Implementierungstransparenz: Zeigt den tatsächlich verwendeten Python-Code während der Sitzung und bietet Einblick in die technische Implementierung.
- Input-/Output-Korrelation: Verknüpft Nutzerfragen mit den entsprechenden Systemantworten und hilft uns, Probleme im Gesprächsverlauf zu beheben und zu erkennen.
- Sitzungsmetadaten: Enthält technische Details wie Timing, Nutzerkontext und spezifische Implementierungsdaten und bietet eine umfassende Sicht auf die Ausführung der Sitzung.
Wann man Observability-Tools nicht verwenden sollte
- Frühphasenentwicklung: Wenn Sie noch die Product-Market-Fit validieren oder Ihre ersten Agenten-Workflows erstellen, sollte der Fokus auf den Kernfunktionen liegen, nicht auf umfassender Observability.
- API-Engpässe: Wenn Ihre Hauptprobleme API-Kosten, Latenz oder Caching sind, sollte die unmittelbare Priorität darin bestehen, diese Bereiche zu optimieren, nicht systemweite Metriken zu verfolgen.
- Modelloptimierung: Wenn Verbesserungen hauptsächlich durch Modellauswahl, Fine-Tuning oder Prompt Engineering erzielt werden, sind Observability-Tools für Drift und Bias möglicherweise noch nicht erforderlich.
Wann man Observability-Tools verwenden sollte
- Produktion in großem Maßstab: Wenn Sie mit mehreren Modellen, Agenten oder Chains arbeiten, sind Observability-Tools unerlässlich, um die Leistung zu überwachen und die Systemgesundheit sicherzustellen.
- Unternehmens- oder kundenorientierte Anwendungen: Für Anwendungen, bei denen Zuverlässigkeit, Sicherheit und Compliance nicht verhandelbar sind, bieten Observability-Tools die nötige Transparenz und Kontrolle.
- Kontinuierliche Überwachung: Wenn Sie Drift, Bias, Leistung und Sicherheitsprobleme im Laufe der Zeit überwachen müssen, die mit einfachen Skripten oder manuellen Prüfungen nicht leicht erfasst werden können, sind Observability-Tools entscheidend.
- Hochrisikoszenarien: In Umgebungen, in denen die Kosten eines Fehlers (z. B. Halluzinationen, unsichere Ausgaben) erheblich sind, stellt Observability sicher, dass Risiken minimiert und Probleme frühzeitig erkannt werden.
Benchmark-Methodik
Um den Leistungsoverhead von Observability-Plattformen in Produktions-LLM-Anwendungen zu bewerten, haben wir einen systematischen Benchmarking-Ansatz anhand eines realen agentischen Workflows entwickelt.
Testanwendung
Wir haben ein sequenzielles Multi-Agenten-Reiseplanungssystem mit LangChain erstellt, das natürlichsprachliche Reiseanfragen in fünf Phasen verarbeitet:
- Parser-Agent: Extrahiert strukturierte Daten (Herkunft, Ziel, Daten, Dauer) aus der Nutzereingabe
- Flugfinder-Agent: Ruft verfügbare Flüge über die Amadeus-API ab
- Wetterbericht-Agent: Ruft Wettervorhersagen für das Ziel über WeatherAPI ab
- Aktivitäten-Empfehlungs-Agent: Schlägt Aktivitäten basierend auf den Wetterbedingungen vor
- Reiseplaner-Agent: Führt alle Ausgaben zu einer umfassenden Reiseroute zusammen
Das System verwendet Claude 4 Haiku über OpenRouter für alle LLM-Aufrufe und integriert externe APIs für Echtzeitdaten.
Benchmark-Design
Basislinien-Erstellung: Zuerst haben wir die Leistung der Anwendung ohne Observability-Instrumentierung gemessen und 100 identische Abfragen ausgeführt, um eine Vergleichsbasis zu schaffen.
Plattformintegration: Anschließend haben wir fünf führende Observability-Plattformen (LangSmith, Laminar, AgentOps, Langfuse) nacheinander integriert und aus Konsistenzgründen dieselben Tracing-Punkte auf allen Plattformen instrumentiert.
Sequentielle Ausführung: Jede Plattform wurde unabhängig getestet, indem alle 100 Abfragen nacheinander ausgeführt wurden, bevor zur nächsten Plattform gewechselt wurde. Dieser Ansatz minimiert Schwankungen durch externe Faktoren wie Netzwerkbedingungen oder API-Ratenlimits.
Kontrollierte Umgebung: Alle Tests wurden auf derselben Serverinfrastruktur mit identischen Abfragesätzen ausgeführt, um einen fairen Vergleich zu gewährleisten. Um den Overhead von LLM-bedingten Latenzschwankungen zu isolieren, haben wir das Modell mit Temperatur=0 konfiguriert und Prompts strukturiert, um die Antwortvariabilität zwischen den Läufen zu minimieren.
Erhobene Metriken
Für jede Plattform haben wir die durchschnittliche Latenz gemessen und den Overhead als zusätzliche Latenz im Vergleich zur Basislinie berechnet: ((Platform Latency - Base Latency) / Base Latency) × 100
FAQs
Observability ist die Fähigkeit, die internen Abläufe eines KI-Agenten zu verstehen, indem man externe Signale wie Logs, Metriken und Traces untersucht.
Für KI-Agenten umfasst dies die Überwachung von Aktionen, Tool-Nutzung, Modellinteraktionen und Antworten, um Probleme zu beheben und die Leistung zu verbessern.
Agenten-Observability ist entscheidend, um die KI-Leistung zu verfolgen und zu verbessern, indem sie Folgendes ermöglicht:
Verständnis von Trade-offs: Sie hilft, wichtige Metriken wie Genauigkeit und Kosten zu messen, und erleichtert es, ein Gleichgewicht zwischen Leistung und Ressourcennutzung zu finden.
Latenzmessung: Echtzeit-Latenzverfolgung bietet Einblicke in Antwortzeiten und hilft, die Agentenleistung zu optimieren.
Erkennung bösartiger Eingaben: Observability hilft, schädliche Sprache und Prompt-Injections zu identifizieren, und ermöglicht so ein rechtzeitiges Eingreifen, um Probleme zu verhindern.
Überwachung von Nutzerfeedback: Durch die Beobachtung von Nutzerinteraktionen und Feedback liefert Observability wertvolle Daten für die kontinuierliche Verbesserung und das Fine-Tuning von Agenten.
Zu den Schlüsselkomponenten gehören:
– Aktionen verfolgen: Überwachen jedes Schritts des Agenten.
– Tool-Nutzung: Beobachten der Tools und Ressourcen, die der Agent verwendet.
– Latenzmessung: Überwachen der Antwortzeiten zur Leistungsoptimierung.
– Evaluierungen: Bewerten des Agentenverhaltens und der Modellleistung.
– Erkennung bösartiger Eingaben: Identifizieren schädlicher Prompts oder Angriffe.
Zitieren Sie diesen Benchmark
Wählen Sie das Format, das zu Ihrem Veröffentlichungsort passt. Wenn Sie die Link-Version in Ihr CMS einfügen, bleibt der Backlink erhalten.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Şipi, Nazlı},
  title  = {{15 KI-Agenten-Observability-Tools: AgentOps & Langfuse}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/agentic-monitoring}},
  note   = {AIMultiple. Abgerufen am 3. Juni 2026}
}Ergebnisse und Zeitstempel von 35 Datenpunkten. Laden Sie die Zusammenfassungsdaten aus den Diagrammen und Tabellen dieses Artikels als ZIP-Datei herunter, die 5 CSV-Dateien enthält.
Möchten Sie die granularen Daten dahinter? Premium beitreten
Änderungsprotokoll
8 AktualisierungenDer Abschnitt „Potenzielle Gründe für Leistungsunterschiede“ wurde mit neuen Erklärungen und Beispielen aktualisiert.
Der Abschnitt „AI-Agent-Observability-Plattformen“ wurde um mögliche Gründe für Leistungsunterschiede erweitert.
Cems Arbeit bei AIMultiple wurde von führenden globalen Publikationen wie Business Insider, Forbes, Morning Brew und Washington Post, von globalen Unternehmen wie Deloitte und HPE, von NGOs wie dem World Economic Forum und von supranationalen Organisationen wie der European Commission zitiert. [1], [2], [3], [4], [5]
Im Laufe seiner Karriere war Cem als Tech-Berater, Tech-Einkäufer und Tech-Unternehmer tätig. Er beriet Unternehmen bei ihren Technologieentscheidungen bei McKinsey & Company und Altman Solon über mehr als ein Jahrzehnt. Er veröffentlichte außerdem einen McKinsey-Bericht zur Digitalisierung.
Er leitete Technologiestrategie und -beschaffung eines Telekommunikationsunternehmens und berichtete dabei direkt an den CEO. Außerdem verantwortete er das kommerzielle Wachstum des Deep-Tech-Unternehmens Hypatos, das innerhalb von zwei Jahren von 0 einen siebenstelligen jährlich wiederkehrenden Umsatz und eine neunstellige Bewertung erreichte. Cems Arbeit bei Hypatos wurde von führenden Technologiepublikationen wie TechCrunch und Business Insider aufgegriffen.
Cem spricht regelmäßig auf internationalen Technologiekonferenzen. Er absolvierte die Bogazici University als Computeringenieur und hat einen MBA von der Columbia Business School.





















Seien Sie der Erste, der kommentiert
Ihre E-Mail-Adresse wird nicht veröffentlicht. Alle Felder sind erforderlich. Kommentare werden in ihrer Originalsprache belassen.