


KI-Datenqualität: Herausforderungen & Best Practices

Schlechte Datenqualität verzögert die erfolgreiche Einführung von KI- und ML-Projekten. 1 Selbst die fortschrittlichsten KI-Algorithmen können fehlerhafte Ergebnisse liefern, wenn die zugrunde liegenden Daten von schlechter Qualität sind.
Erfahren Sie mehr über die Bedeutung der Datenqualität in der KI, die Herausforderungen, auf die Unternehmen stoßen, und die Best Practices zur Sicherstellung hochwertiger Daten:
Welche Bedeutung hat die Datenqualität in der KI?
Datenqualität ist für künstliche Intelligenz unerlässlich, da sie die Leistung, Genauigkeit und Zuverlässigkeit von KI-Modellen direkt beeinflusst. Hochwertige Daten ermöglichen es Modellen, bessere Vorhersagen zu treffen und zuverlässigere Ergebnisse zu liefern. Die Auswirkungen schlechter Datenqualität in der KI sind in Abbildung 1 dargestellt.
Abbildung 1: Auswirkungen schlechter Datenqualität und Analytics-Qualität
Quelle: SnapLogic2
Die Bekämpfung von Datenverzerrungen ist entscheidend für die Sicherstellung der Datenqualität. Dadurch wird verhindert, dass Verzerrungen in KI-generierten Ergebnissen fortbestehen und verstärkt werden, und es wird dazu beigetragen, die unfaire Behandlung bestimmter Gruppen oder Personen zu minimieren.
Darüber hinaus verbessert ein vielfältiger und repräsentativer Datensatz die Fähigkeit eines KI-Modells, über verschiedene Situationen und Eingaben hinweg gut zu generalisieren, und gewährleistet so seine Leistung und Relevanz in unterschiedlichen Kontexten und Nutzergruppen.
Wie Andrew Ng, Professor für KI an der Stanford University und Gründer von DeepLearning.KI, sagt: „Wenn 80 Prozent unserer Arbeit Datenaufbereitung sind, dann ist die Sicherstellung der Datenqualität die wichtigste Aufgabe für ein Machine-Learning-Team.“
Warum ist die Vermeidung des „Garbage in, Garbage out“-Problems entscheidend für die Datenqualität?
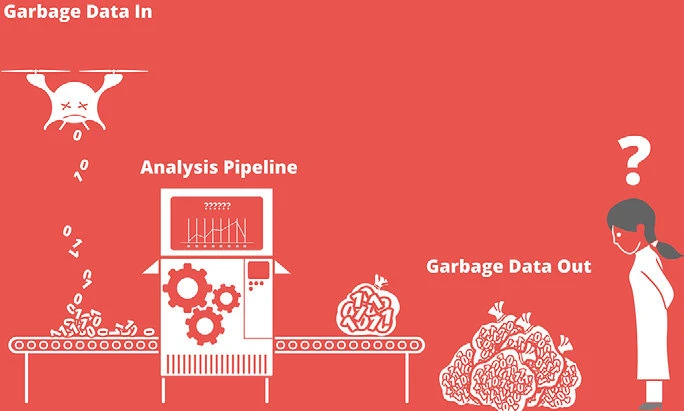
„Garbage in, Garbage out“ (GIGO) ist ein einfaches, aber wirkungsvolles Prinzip, das die Bedeutung der Eingangsqualität für die Datenqualität unterstreicht. Es bedeutet: Wenn die Eingabedaten eines Systems, etwa eines KI-Modells oder Algorithmus, von schlechter Qualität, ungenau oder irrelevant sind, ist auch die Ausgabe des Systems von schlechter Qualität, ungenau oder irrelevant.
Abbildung 2: Datenqualität und Standards: „Garbage in“-Daten, „Garbage out“-Ergebnisse.
Quelle: Shakoor et al. 3
Dieses Konzept ist im KI-Kontext besonders wichtig, da KI-Modelle, einschließlich maschineller Lern- und Deep-Learning-Modelle, stark auf die Daten angewiesen sind, die für Training und Validierung verwendet werden. Das KI-Modell wird wahrscheinlich unzuverlässige oder verzerrte Ergebnisse liefern, wenn die Trainingsdaten verzerrt, unvollständig oder fehlerhaft sind.
Um das GIGO-Problem zu vermeiden, ist es entscheidend, sicherzustellen, dass die in KI-Systemen verwendeten Daten genau, repräsentativ und hochwertig sind. Dazu gehören oft Datenbereinigung, Vorverarbeitung und Augmentierung sowie die Verwendung robuster Bewertungsmetriken zur Beurteilung der Leistung von KI-Modellen.
Was sind die wichtigsten Komponenten qualitativ hochwertiger Daten in der KI?
Genauigkeit: Genaue Daten sind für KI-Algorithmen entscheidend, damit sie korrekte und zuverlässige Ergebnisse erzeugen können. Fehler bei der Dateneingabe können zu falschen Entscheidungen oder irreführenden Erkenntnissen führen und Unternehmen und Einzelpersonen potenziell schaden.
Konsistenz: Stellt sicher, dass Daten einem Standardformat und einer Standardstruktur folgen, was eine effiziente Verarbeitung und Analyse erleichtert. Inkonsistente Daten können zu Verwirrung und Fehlinterpretationen führen und die Leistung von KI-Systemen beeinträchtigen.
Vollständigkeit: Unvollständige Datensätze können dazu führen, dass KI-Algorithmen wesentliche Muster und Zusammenhänge übersehen, was zu unvollständigen oder verzerrten Ergebnissen führt. Die Sicherstellung der Datenvollständigkeit ist entscheidend, um KI-Modelle genau und umfassend zu trainieren.
Aktualität: Die Frische der Daten spielt eine wichtige Rolle für die KI-Leistung. Veraltete Daten spiegeln möglicherweise nicht die aktuelle Umgebung oder aktuelle Trends wider und führen zu irrelevanten oder irreführenden Ergebnissen.
Relevanz: Relevante Daten tragen unmittelbar zur Lösung des jeweiligen Problems bei und helfen KI-Systemen, sich auf die wichtigsten Variablen und Beziehungen zu konzentrieren. Irrelevante Daten können Modelle überladen und zu Ineffizienzen führen.
Was sind die Herausforderungen bei der Sicherstellung der Datenqualität in der KI?
1-Datenerfassung
Da KI-Entwicklungen Branchen wie Finanzwesen, Gesundheitswesen, Fertigung und Unterhaltung zugutekommen, stehen Unternehmen vor der Herausforderung, Daten aus verschiedenen Quellen zu sammeln und gleichzeitig die Qualität zu wahren. Viele greifen auf Web-Scraper zurück, um zu automatisieren und sicherzustellen, dass alle Datenpunkte denselben Standards folgen.
2-Datenkennzeichnung
KI-Algorithmen sind beim Training auf gekennzeichnete Daten angewiesen, aber die manuelle Kennzeichnung ist zeitaufwendig und fehleranfällig. Es ist oft schwierig, genaue Labels zu erhalten, die realen Bedingungen widerspiegeln.
3-Datenspeicherung und -sicherheit
Die Sicherstellung der Datenqualität umfasst den Schutz vor unbefugtem Zugriff und möglicher Beschädigung. Für Unternehmen ist es unerlässlich, über eine sichere, zuverlässige Datenspeicherung zu verfügen, doch dies kann schwierig sein.
4-Daten-Governance
Unternehmen haben oft Schwierigkeiten bei der Implementierung von Data-Governance-Frameworks, die Datenqualitätsprobleme wirksam angehen. Ein Mangel an ordnungsgemäßer Daten-Governance kann zu isolierten Datensilos, Inkonsistenz und Fehlern führen.
5- Datenvergiftung
Datenvergiftung ist ein gezielter Angriff auf KI-Systeme, bei dem Angreifer bösartige oder irreführende Informationen in den Datensatz einschleusen. Diese vergifteten Daten können das Training des Modells verzerren und zu unzuverlässigen oder sogar schädlichen Ergebnissen führen. Um dieses Risiko zu mindern, ist es entscheidend, die Datenintegrität durch regelmäßige Audits und Anomalieerkennung aufrechtzuerhalten.
6-Feedbackschleifen durch synthetische Daten
Das Zurückspeisen KI-generierter Daten in KI-Modelle kann Feedbackschleifen erzeugen, die Modellqualität verschlechtern. Wenn beispielsweise synthetische Daten wiederholt verwendet werden, kann das Modell Muster lernen, die zu künstlich sind und von den realen Bedingungen abweichen. Dies kann dazu führen, dass Modelle bei tatsächlichen Daten schlecht abschneiden und möglicherweise Verzerrungen oder Fehler verstärken. Ein Gleichgewicht zwischen synthetischen und echten Daten ist unerlässlich, um die Robustheit des Modells zu erhalten.
Fallstudien aus der Praxis
Fallstudie 1: Mayo Clinic – Datenverantwortung vor der KI
Mayo Clinic behandelt mit rund 76.000 Mitarbeitenden an drei Standorten die Datenbereitschaft als ersten Schritt jedes KI-Projekts.4
Die Herausforderung: Die Verantwortung für Daten ist auf viele klinische und geschäftliche Einheiten verteilt. Der Chief Data and Analytics Officer Ajai Sehgal sagt, wenn niemand für die Pflege der Daten verantwortlich ist, folgen Datenprobleme, und die KI im Gesundheitswesen kann sich keine minderwertigen Ergebnisse leisten.
Die Lösung: Mayo machte die klinischen und geschäftlichen Teams, die Daten am besten kennen, zu deren Verantwortlichen, die dafür zuständig sind, ihre Daten für die Analyse vorzubereiten. Ein zentrales Team pflegt eine Datenbibliothek, die jedes Datenelement mit seinen Metadaten und zugehörigen klinischen Regeln verknüpft. Die Chirurgiepraxis von Mayo beginnt ihre KI-Arbeit beispielsweise damit, ihre Daten vorzubereiten, und hat ein selbstfinanziertes Daten- und Analyseteam vorgeschlagen.
Fallstudie 2: JPMorgan Chase – Betrugserkennung auf der Grundlage verifizierter interner Daten
JPMorgan Chase nutzt große Sprachmodelle, um Betrug wie Business Email Compromise zu erkennen.5
Die Herausforderung: Ryan Schmiedl, der die Betrugserkennung, Sanktionsprüfung und Know-Your-Customer-Prüfungen der Bank leitet, warnte 2023, dass Modelle, die auf internetweiten Daten trainiert wurden, wie ChatGPT, unbestätigte Behauptungen als Fakten darstellen können.
Die Lösung: Die Bank trainiert ihre LLMs nur mit Daten aus ihrem eigenen Ökosystem und stellt zunächst sicher, dass diese Daten geprüft und validiert wurden. Außerdem nutzt sie KI, um Unternehmens- und Personennamen aus unstrukturierten Daten zu extract und sie auf Betrugsrisiken zu überprüfen.
Fallstudie 3: Walmart – Bereinigung von Produktkatalogdaten mit LLMs
Walmart nutzte generative KI, um die Produktkatalogdaten hinter seinen Such- und Produktseiten zu verbessern.6
Die Herausforderung: Die Vollständigkeit und Genauigkeit der Katalogdaten in der Größenordnung von Walmart aufrechtzuerhalten, ist arbeitsintensiv. CEO Doug McMillon sagte, dass die Arbeit ohne generative KI „fast das 100-fache der derzeitigen Mitarbeiterzahl“ erfordert hätte.
Die Lösung: Walmart nutzte mehrere große Sprachmodelle, um mehr als 850 Millionen Katalogdateneinträge zu erstellen oder zu verbessern, sagte McMillon bei der Bilanztelefonkonferenz des Unternehmens am 15. August 2024. John Furner, CEO von Walmart U.S., sagte, die verbesserten Daten helfen dem Unternehmen, den Katalog an die Suchanfragen der Kunden anzupassen.
Best Practices zur Sicherstellung der Datenqualität in der KI
1-Data-Governance-Richtlinien implementieren
Ein Data-Governance-Framework sollte Datenqualitätsstandards, Prozesse und Rollen definieren. Dies trägt dazu bei, eine Kultur der Datenqualität zu schaffen und sicherzustellen, dass die Datenverwaltungspraktiken mit den Unternehmenszielen in Einklang stehen.
Praxisbeispiel: Airbnb
Airbnb startete die „Data University“, um die Datenkompetenz der gesamten Belegschaft zu verbessern, indem es maßgeschneiderte Kurse anbot, die spezifischen Daten und Tools von Airbnb integrieren. Seit ihrer Einführung im dritten Quartal 2016 hat die Data University das Engagement mit den internen Data-Science-Tools von Airbnb erhöht und die wöchentlich aktiven Nutzer von 30 % auf 45 % gesteigert.
Mit über 500 teilnehmenden Mitarbeitenden unterstreicht die Initiative, wie wichtig es ist, Data-Governance-Bemühungen mit den Unternehmenszielen in Einklang zu bringen und eine unternehmensweite Kultur der Datenqualität und fundierten Entscheidungsfindung zu fördern. Das Programm zeigt beispielhaft, wie maßgeschneiderte Data-Governance-Frameworks die Datenkompetenz vorantreiben und die Ausrichtung an den Geschäftszielen unterstützen können.
2-Datenqualitätstools nutzen
Datenqualitätstools können die Datenbereinigung, Validierung und Überwachung automatisieren und so sicherstellen, dass KI-Modelle konsistenten Zugriff auf hochwertige Daten haben.
Praxisbeispiel: General Electric
Ein relevantes Praxisbeispiel für die Nutzung von Datenqualitätstools ist die Umsetzung der Data-Governance- und Qualitätsmanagementstrategie von General Electric (GE), insbesondere innerhalb der Predix-Plattform für industrielle Datenanalyse. Zur Unterstützung seiner digitalen Transformation und KI-Initiativen investierte GE in ein robustes Datenqualitäts-Toolset, um hohe Datenstandards in seinem industriellen IoT-Ökosystem aufrechtzuerhalten.
GE setzte automatisierte Tools zur Datenbereinigung, Validierung und kontinuierlichen Überwachung ein, um die enormen Datenmengen zu verwalten, die von seinen Industrieanlagen wie Turbinen und Strahltriebwerken erzeugt werden. Diese Tools halfen GE sicherzustellen, dass die Daten, die in seine KI-Modelle einflossen, genau, konsistent und zuverlässig waren, wodurch der Bedarf an manuellen Eingriffen reduziert und datengestützte Erkenntnisse in Echtzeit ermöglicht wurden.
Beispiele für Datenqualitätslösungen
Pandada KI, das Anfang 2026 auf den Markt kam, ist eine KI-gesteuerte Plattform für automatisierte Datenbereinigung und -analyse. Es kann Datendateien (CSVs, Excel-Tabellen, PDFs und sogar Bilder) aufnehmen und strukturierte, teilbare Analyseberichte und Präsentationen erstellen.7 Die Plattform umfasst intelligente Datenbereinigungsfunktionen (Duplikatentfernung, Formatstandardisierung, Erkennung fehlender Werte), die Datenprobleme automatisch beheben und den manuellen Datenaufbereitungsaufwand reduzieren.8
Sieve ist eine Datenbereinigungsplattform eines Startups aus dem Y Combinator Spring 2025, die KI-gesteuerte Verarbeitung mit optionaler menschlicher Überprüfung kombiniert.9 Sie bietet eine API und ein Excel-Add-in für die automatisierte Datenbereinigung und leitet alle markierten Probleme automatisch zur Validierung an menschliche Bearbeiter weiter.9
3-Ein Datenqualitätsteam aufbauen
Der Aufbau eines eigenen Teams, das für die Datenqualität verantwortlich ist, gewährleistet eine kontinuierliche Überwachung und Verbesserung datenbezogener Prozesse. Das Team kann auch andere Mitarbeitende über die Bedeutung der Datenqualität schulen und weiterbilden.
4-Mit Datenanbietern zusammenarbeiten
Der Aufbau starker Beziehungen zu Datenanbietern und deren Verpflichtung zur Datenqualität kann das Risiko minimieren, Daten von geringer Qualität zu erhalten.
5-Datenqualitätsmetriken kontinuierlich überwachen
Die regelmäßige Messung und Überwachung von Datenqualitätsmetriken kann Unternehmen helfen, potenzielle Probleme zu erkennen und zu beheben, bevor sie die KI-Leistung beeinträchtigen.
 Als bevorzugte Quelle hinzufügen
Was sind KI-Daten?
KI-Daten beziehen sich im weiteren Sinne auf alle Daten, die bei der Entwicklung oder dem Betrieb von Systemen der künstlichen Intelligenz verwendet werden. Dazu gehören folglich unter anderem Datensätze, die zum Trainieren von Modellen verwendet werden, Echtzeit-Eingabedaten für Vorhersagen und synthetische Daten, die zur Ergänzung realer Beispiele erzeugt werden. Obwohl es sich nicht um einen formalen Fachbegriff handelt, wird „KI-Daten“ häufig verwendet, um die Informationen zu beschreiben, die Machine-Learning- und Deep-Learning-Systeme antreiben.
FAQs
Laut einer Studie von Gartner kostet schlechte Datenqualität Unternehmen durchschnittlich 12.9 Millionen Dollar pro Jahr. Die tatsächlichen Kosten gehen jedoch über die direkten finanziellen Auswirkungen hinaus. Schlechte Datenqualität führt zu gescheiterten KI-Projekten; Branchenberichte deuten darauf hin, dass bis zu 85 % der KI- und ML-Projekte ihr ursprüngliches Versprechen nicht einlösen, oft aufgrund von Datenqualitätsproblemen. Zu den weiteren Kosten gehören verschwendete Zeit, da Data Scientists 60-80 % ihrer Zeit mit Datenbereinigung statt mit Modellentwicklung verbringen, entgangene Umsätze durch ungenaue Vorhersagen und schlechte Kundenerlebnisse sowie Compliance-Risiken, insbesondere in regulierten Branchen, in denen Datenqualitätsmängel zu erheblichen Bußgeldern führen können.
Untersuchungen aus Branchenquellen zeigen, dass 70-85 % der KI-Projektfehlschläge auf datenbezogene Probleme zurückzuführen sind, wobei die Datenqualität die Hauptursache ist. Die Analyse von KI-Implementierungen durch VentureBeat ergab, dass 87 % der Data-Science-Projekte nie in Produktion gehen, wobei unzureichende oder qualitativ schlechte Daten die Hauptursache sind. Eine Umfrage von Dimensional Research ergab, dass 96 % der Unternehmen bei der Ausbildung von KI-Modellen auf Datenqualitätsprobleme stoßen. Diese Misserfolge zeigen sich auf verschiedene Weise, unter anderem in Modellen, die in Tests gut funktionieren, aber in der Produktion aufgrund von Data-Drift versagen, in verzerrten Ergebnissen, die aus nicht repräsentativen Trainingsdaten resultieren, und in der Unfähigkeit zur Skalierung, weil Daten-Pipelines die Qualität im Produktionsmaßstab nicht aufrechterhalten können.
Obwohl Datenqualität und Daten-Governance eng miteinander verbunden sind, dienen sie unterschiedlichen Zwecken. Datenqualität bezieht sich auf die Eigenschaften der Daten selbst und konzentriert sich darauf, ob Daten genau, vollständig, konsistent, aktuell und relevant sind. Es geht um den Zustand und die Nutzbarkeit von Daten für ihren vorgesehenen Zweck. Datenqualität wird in der Regel anhand von Metriken wie Fehlerraten, Vollständigkeitsprozentsätzen und Duplikatzählungen gemessen.
Daten-Governance hingegen ist das Gefüge aus Richtlinien, Verfahren, Rollen und Verantwortlichkeiten, das eine ordnungsgemäße Datenverwaltung im gesamten Unternehmen sicherstellt. Governance legt fest, wem Daten gehören, wer darauf zugreifen darf, wie sie verwendet werden sollten, welche Standards sie erfüllen müssen und wie die Qualität aufrechterhalten werden sollte.
Betrachten Sie Daten-Governance als die Organisationsstruktur und das Regelwerk, während Datenqualität das angestrebte Ergebnis ist. Eine gute Governance ermöglicht gute Qualität, aber Sie brauchen beides, um bei KI-Initiativen erfolgreich zu sein. Governance bietet die nachhaltige Struktur, die sicherstellt, dass Datenqualität keine einmalige Bereinigung, sondern eine fortlaufende Praxis ist.
Diese Forschung zitieren
Wählen Sie das Format, das zu Ihrem Veröffentlichungsort passt. Wenn Sie die Link-Version in Ihr CMS einfügen, bleibt der Backlink erhalten.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Arslan, Ezgi},
  title  = {{KI-Datenqualität: Herausforderungen & Best Practices}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/data-quality-ai}},
  note   = {AIMultiple. Abgerufen am 23. Oktober 2026}
}
Änderungsprotokoll
6 AktualisierungenPandada AI und Sieve wurden dem Abschnitt „Beispiele für Datenqualitätslösungen“ hinzugefügt.
Der Abschnitt FAQs wurde hinzugefügt.
Referenzlinks
Cems Arbeit bei AIMultiple wurde von führenden globalen Publikationen wie Business Insider, Forbes, Morning Brew und Washington Post, von globalen Unternehmen wie Deloitte und HPE, von NGOs wie dem World Economic Forum und von supranationalen Organisationen wie der European Commission zitiert. [1], [2], [3], [4], [5]
Im Laufe seiner Karriere war Cem als Tech-Berater, Tech-Einkäufer und Tech-Unternehmer tätig. Er beriet Unternehmen bei ihren Technologieentscheidungen bei McKinsey & Company und Altman Solon über mehr als ein Jahrzehnt. Er veröffentlichte außerdem einen McKinsey-Bericht zur Digitalisierung.
Er leitete Technologiestrategie und -beschaffung eines Telekommunikationsunternehmens und berichtete dabei direkt an den CEO. Außerdem verantwortete er das kommerzielle Wachstum des Deep-Tech-Unternehmens Hypatos, das innerhalb von zwei Jahren von 0 einen siebenstelligen jährlich wiederkehrenden Umsatz und eine neunstellige Bewertung erreichte. Cems Arbeit bei Hypatos wurde von führenden Technologiepublikationen wie TechCrunch und Business Insider aufgegriffen.
Cem spricht regelmäßig auf internationalen Technologiekonferenzen. Er absolvierte die Bogazici University als Computeringenieur und hat einen MBA von der Columbia Business School.





Seien Sie der Erste, der kommentiert
Ihre E-Mail-Adresse wird nicht veröffentlicht. Alle Felder sind erforderlich. Kommentare werden in ihrer Originalsprache belassen.