


AIM-Text-to-SQL-Benchmark: SQL-Genauigkeit bei über 70 LLMs
Wir haben SQL-Antworten von über 70 LLMs anhand einer 759 Fragen umfassenden BIRD-SQL-Teilmenge bewertet. Jedes Modell wählte eine Datenbank aus 11 Kandidaten aus und erstellte dann eine Abfrage.
| Name | SQL accuracy (%) |
|---|---|
| claude-opus-5.5 | 87.75 |
| claude-fable-5.2 | 86.43 |
| gemini-4-argon | 78.57 |
| gemini-4-carbon | 78.29 |
| gemini-3.8-flash | 77.2 |
| claude-sonnet-5.5 | 73.75 |
| gemini-3.6-flash | 73.51 |
| gemini-3.7-flash | 72.46 |
| gemini-4-hydrogen | 70.24 |
| gemini-3-flash-preview | 67.68 |
| gpt-6.2-astra | 67.59 |
| claude-fable-5.1 | 67.01 |
| gemini-3.1-pro-preview | 66.95 |
| gpt-6.2-sol | 65.91 |
| gpt-6-astra | 65.73 |
| claude-fable-5 | 65.55 |
| gpt-6.1-sol | 65.11 |
| claude-opus-5 | 64.31 |
| grok-4.6 | 64.21 |
| gpt-6.1-sol-pro | 63.62 |
| qwen4-max | 60.21 |
| qwen3.6-27b | 58.96 |
| gemini-3.5-flash-lite | 57.43 |
| gemini-3.1-flash-lite | 56.99 |
| gpt-6.1-terra | 56.57 |
| muse-wonder | 56.44 |
| grok-4.5 | 55.95 |
| claude-opus-4.8 | 54.87 |
| gpt-5.6-sol | 54.49 |
| grok-4.7 | 53.83 |
| gpt-6-sol | 53.77 |
| muse-spark-1.2 | 53.69 |
| gpt-6-sol-pro | 53.64 |
| qwen3.8-2.4t-a95b | 53.12 |
| kimi-k3.1-pro | 52.34 |
| kimi-k2.6 | 51.12 |
| grok-4.3 | 50.93 |
| qwen3.8-max | 50.52 |
| qwen3.5-27b | 49.49 |
| hy3 | 49.45 |
| qwen3.8-27b | 49.35 |
| muse-spark-1.3 | 49.25 |
| gpt-5.5 | 48.96 |
| qwen3.6-flash | 48.25 |
| kimi-k3 | 48.17 |
| hy4-preview | 47.97 |
| muse-spark-1.1 | 47.78 |
| qwen3.7-plus | 47.71 |
| command-a-plus | 46.33 |
| deepseek-v4-pro-0813 | 46.02 |
| glm-5.2 | 45.96 |
| gpt-6-luna | 45.41 |
| glm-5.1 | 45.37 |
| qwen3.8-flash | 44.95 |
| muse-spark-open | 44.88 |
| gpt-5.6-terra | 44.69 |
| gpt-6-luna-pro | 44.25 |
| glm-5.3 | 42.62 |
| minimax-m3 | 42.08 |
| llama-4-maverick | 41.88 |
| nemotron-3-ultra | 41.75 |
| mimo-v2.6-pro | 41.51 |
| minimax-m2.5 | 41.29 |
| muse-ember | 41.26 |
| glm-5.3-flash | 41.09 |
| deepseek-v4-pro | 39.87 |
| gpt-oss-120b | 39.69 |
| glm-4.7 | 39.34 |
| gpt-5.6-luna | 39.15 |
| gpt-5.4-mini | 39.08 |
| deepseek-v4-flash | 39.07 |
| glm-5.3-prime | 38.82 |
| claude-sonnet-5 | 38.46 |
| muse-glimmer-30b | 38.26 |
| qwen3.8-max-0902 | 38.15 |
| solar-pro4 | 36.86 |
| gpt-5.2 | 36.7 |
| qwen3.8-max-prime | 36.67 |
| deepseek-v4-flash-0731 | 36.65 |
| minimax-m3.1-flash | 36.49 |
| claude-haiku-4.5 | 36.44 |
| gpt-5.4-nano | 34.59 |
| deepseek-v4.1-flash | 33.47 |
| mistral-small | 33.42 |
| mistral-large-4-0 | 29.79 |
| claude-haiku-5.5 | 29.09 |
| nova-lite | 23.47 |
| deepseek-v4.1-flash-1017 | 22.78 |
SQL-Genauigkeit ist der Prozentsatz der bewerteten Abfragen, die das Referenzergebnis zurückgeben. Falsche Routen und als fehlerhaft markierte Referenzen werden ausgeschlossen. Eine Referenzabfrage ist die SQL-Abfrage, die als erwartete Antwort bereitgestellt wird.
Jedes Modell erreicht eine andere Menge an SQL-Fragen, da die Bewertung von seinen Datenbankentscheidungen abhängt. Unterschiede in diesen Teilmengen und im Ausführungssetup schränken Vergleiche ein.
Text-to-SQL-Ergebnisse
Opus 5.5 erzielte 87,8 % SQL-Genauigkeit
Opus 5.5 führte die SQL-Genauigkeit im Panel mit 88 Modellen mit 87,8 % (444 von 506) an. Weitere Spitzenwerte waren 86,4 % (446 von 516) für Fable 5.2 und 78,6 % (407 von 518) für Gemini 4 Argon. Die neuen Läufe erzielten 67,6 % (342 von 506) für GPT-6.2 Astra und 65,9 % (321 von 487) für GPT-6.2 Sol.
Die Punktzahl schließt falsche Datenbankentscheidungen und als fehlerhaft markierte Referenzen aus. Opus 5.5 verwendete Claude Code. Fable 5.2 verwendete OpenRouter. Gemini 4 Argon verwendete OpenRouter. Das Ranking spiegelt sowohl die Ausführungsbedingungen als auch die Unterschiede bei den Fragen wider, die jedes Modell korrekt weitergeleitet hat.
Drei Pro-Varianten schnitten schlechter ab als ihre Basismodelle
gpt-6.1-sol-pro erreichte 63,6 % SQL-Genauigkeit, verglichen mit 65,1 % für gpt-6.1-sol. gpt-6-sol-pro erzielte 53,6 % gegenüber 53,8 % für gpt-6-sol. gpt-6-luna-pro erzielte 44,2 % gegenüber 45,4 % für gpt-6-luna.
Alle sechs Modelle verwendeten OpenRouter. Diese Ergebnisse stammen aus einem Lauf pro Modell und unterschiedlichen Teilmengen korrekt weitergeleiteter Fragen. Wiederholte Läufe mit denselben SQL-Fragen wären erforderlich, um zu beurteilen, ob die kleinen Unterschiede bestehen bleiben.
Kosten vs. SQL-Genauigkeit
| Name | Cost per run (USD, log scale) | SQL accuracy (%) | Name | C | Cost basis | Actual cost basis | Harness | Cache note | Cached input pct | Harness label |
|---|---|---|---|---|---|---|---|---|---|---|
| Anthropic | 188.71 | 87.75 | claude-opus-5.5 | off | estimated_openrouter_equivalent | subscription | claude_cli_transcript_v1 | Recorded cache reads + 1h writes | 23.6 | Claude Code CLI |
| Anthropic | 88.66 | 86.43 | claude-fable-5.2 | on | metered | metered | v3 | 60.0% of input reported as cache reads; explicit request on | 60 | API |
| Anthropic | 42.67 | 73.75 | claude-sonnet-5.5 | off | metered | metered | v3 | 0.0% of input reported as cache reads; explicit request off | 0 | API |
| Anthropic | 556.16 | 67.01 | claude-fable-5.1 | off | estimated_openrouter_equivalent | subscription | claude_cli_transcript_v1 | Recorded cache reads + 1h writes | 35.5 | Claude Code CLI |
| Anthropic | 121.55 | 65.55 | claude-fable-5 | on | metered | metered | v3 | 61.4% of input reported as cache reads; explicit request on | 61.4 | API |
| Anthropic | 62.78 | 64.31 | claude-opus-5 | on | metered | metered | v3 | 62.2% of input reported as cache reads; explicit request on | 62.2 | API |
| Anthropic | 117.82 | 54.87 | claude-opus-4.8 | off | metered | metered | mixed | Cache reads unreported | — | API |
| Anthropic | 61.93 | 38.46 | claude-sonnet-5 | off | metered | metered | mixed | Cache reads unreported | — | API |
| Anthropic | 30 | 36.44 | claude-haiku-4.5 | off | metered | metered | pre_v3 | Cache reads unreported | — | API |
| Anthropic | 1.54 | 29.09 | claude-haiku-5.5 | on | metered | metered | v3 | 64.1% of input reported as cache reads; explicit request on | 64.1 | API |
| DeepSeek | 11.93 | 46.02 | deepseek-v4-pro-0813 | off | metered | metered | v3 | 63.9% of input reported as cache reads; explicit request off | 63.9 | API |
| DeepSeek | 8.99 | 39.87 | deepseek-v4-pro | off | metered | metered | v3 | Cache reads unreported | — | API |
| DeepSeek | 2.34 | 39.07 | deepseek-v4-flash | off | metered | metered | v3 | Cache reads unreported | — | API |
| DeepSeek | 1.37 | 36.65 | deepseek-v4-flash-0731 | off | metered | metered | v3 | 56.4% of input reported as cache reads; explicit request off | 56.4 | API |
| DeepSeek | 4.06 | 33.47 | deepseek-v4.1-flash | off | metered | metered | v3 | 68.2% of input reported as cache reads; explicit request off | 68.2 | API |
| DeepSeek | 1.75 | 22.78 | deepseek-v4.1-flash-1017 | off | metered | metered | v3 | 68.8% of input reported as cache reads; explicit request off | 68.8 | API |
| 41.41 | 78.57 | gemini-4-argon | off | metered | metered | v3 | 25.9% of input reported as cache reads; explicit request off | 25.9 | API | |
| 64.26 | 78.29 | gemini-4-carbon | off | metered | metered | v3 | 42.2% of input reported as cache reads; explicit request off | 42.2 | API | |
| 26.48 | 77.2 | gemini-3.8-flash | off | metered | metered | v3 | 5.7% of input reported as cache reads; explicit request off | 5.7 | API | |
| 22 | 73.51 | gemini-3.6-flash | off | metered | metered | v3 | 20.5% of input reported as cache reads; explicit request off | 20.5 | API | |
| 20.82 | 72.46 | gemini-3.7-flash | off | metered | metered | v3 | 7.5% of input reported as cache reads; explicit request off | 7.5 | API | |
| 40.49 | 70.24 | gemini-4-hydrogen | off | metered | metered | v3 | 40.9% of input reported as cache reads; explicit request off | 40.9 | API | |
| 7.67 | 67.68 | gemini-3-flash-preview | off | metered | metered | v3 | Cache reads unreported | — | API | |
| 79.81 | 66.95 | gemini-3.1-pro-preview | off | metered | metered | v3 | Cache reads unreported | — | API | |
| 7 | 57.43 | gemini-3.5-flash-lite | off | metered | metered | pre_v3 | Cache reads unreported | — | API | |
| 5.45 | 56.99 | gemini-3.1-flash-lite | off | metered | metered | pre_v3 | Cache reads unreported | — | API | |
| MiniMax | 3.95 | 42.08 | minimax-m3 | off | metered | metered | pre_v3 | Cache reads unreported | — | API |
| MiniMax | 2.75 | 41.29 | minimax-m2.5 | off | metered | metered | v3 | Cache reads unreported | — | API |
| MiniMax | 2.3 | 36.49 | minimax-m3.1-flash | off | metered | metered | v3 | 75.1% of input reported as cache reads; explicit request off | 75.1 | API |
| Moonshot | 27.14 | 52.34 | kimi-k3.1-pro | off | metered | metered | v3 | 62.3% of input reported as cache reads; explicit request off | 62.3 | API |
| Moonshot | 15.64 | 51.12 | kimi-k2.6 | off | metered | metered | v3 | Cache reads unreported | — | API |
| Moonshot | 40.34 | 48.17 | kimi-k3 | off | metered | metered | pre_v3 | Cache reads unreported | — | API |
| OpenAI | 46.5 | 67.59 | gpt-6.2-astra | off | metered | metered | v3 | 65.6% of input reported as cache reads; explicit request off | 65.6 | API |
| OpenAI | 13.48 | 65.91 | gpt-6.2-sol | off | metered | metered | v3 | 69.3% of input reported as cache reads; explicit request off | 69.3 | API |
| OpenAI | 270.78 | 65.73 | gpt-6-astra | off | estimated_openrouter_equivalent | unreported | codex_cli_transcript_v1 | Recorded cache reads; assumes zero writes | 55 | Codex CLI |
| OpenAI | 12.75 | 65.11 | gpt-6.1-sol | off | metered | metered | v3 | 66.4% of input reported as cache reads; explicit request off | 66.4 | API |
| OpenAI | 35.19 | 63.62 | gpt-6.1-sol-pro | off | metered | metered | v3 | 58.2% of input reported as cache reads; explicit request off | 58.2 | API |
| OpenAI | 7.19 | 56.57 | gpt-6.1-terra | off | metered | metered | v3 | 69.4% of input reported as cache reads; explicit request off | 69.4 | API |
| OpenAI | 48.84 | 54.49 | gpt-5.6-sol | off | metered | metered | v3 | Cache reads unreported | — | API |
| OpenAI | 17.57 | 53.77 | gpt-6-sol | off | metered | metered | v3 | 71.2% of input reported as cache reads; explicit request off | 71.2 | API |
| OpenAI | 47.48 | 53.64 | gpt-6-sol-pro | off | metered | metered | v3 | 63.0% of input reported as cache reads; explicit request off | 63 | API |
| OpenAI | 61.26 | 48.96 | gpt-5.5 | off | metered | metered | v3 | Cache reads unreported | — | API |
| OpenAI | 1.05 | 45.41 | gpt-6-luna | off | metered | metered | v3 | 69.8% of input reported as cache reads; explicit request off | 69.8 | API |
| OpenAI | 24.48 | 44.69 | gpt-5.6-terra | off | metered | metered | pre_v3 | Cache reads unreported | — | API |
| OpenAI | 3.1 | 44.25 | gpt-6-luna-pro | off | metered | metered | v3 | 62.2% of input reported as cache reads; explicit request off | 62.2 | API |
| OpenAI | 0.47 | 39.69 | gpt-oss-120b | off | metered | metered | pre_v3 | Cache reads unreported | — | API |
| OpenAI | 11.04 | 39.15 | gpt-5.6-luna | off | metered | metered | pre_v3 | Cache reads unreported | — | API |
| OpenAI | 5.51 | 39.08 | gpt-5.4-mini | off | metered | metered | v3 | Cache reads unreported | — | API |
| OpenAI | 24.03 | 36.7 | gpt-5.2 | off | metered | metered | v3 | 58.8% of input reported as cache reads; explicit request off | 58.8 | API |
| OpenAI | 2.21 | 34.59 | gpt-5.4-nano | off | metered | metered | pre_v3 | Cache reads unreported | — | API |
| Other | 77.44 | 56.44 | muse-wonder | off | metered | metered | v3 | 43.1% of input reported as cache reads; explicit request off | 43.1 | API |
| Other | 30.93 | 53.69 | muse-spark-1.2 | off | metered | metered | v3 | 45.2% of input reported as cache reads; explicit request off | 45.2 | API |
| Other | 1.88 | 49.45 | hy3 | off | metered | metered | v3 | 71.7% of input reported as cache reads; explicit request off | 71.7 | API |
| Other | 30.74 | 49.25 | muse-spark-1.3 | off | metered | metered | v3 | 35.4% of input reported as cache reads; explicit request off | 35.4 | API |
| Other | 10.79 | 47.97 | hy4-preview | off | metered | metered | v3 | 65.7% of input reported as cache reads; explicit request off | 65.7 | API |
| Other | 22.22 | 47.78 | muse-spark-1.1 | off | metered | metered | v3 | 59.0% of input reported as cache reads; explicit request off | 59 | API |
| Other | 7.22 | 46.33 | command-a-plus | off | metered | metered | v3 | 0.0% of input reported as cache reads; explicit request off | 0 | API |
| Other | 22.03 | 44.88 | muse-spark-open | off | metered | metered | v3 | 76.9% of input reported as cache reads; explicit request off | 76.9 | API |
| Other | 4.77 | 41.88 | llama-4-maverick | off | metered | metered | v3 | 0.2% of input reported as cache reads; explicit request off | 0.2 | API |
| Other | 19.79 | 41.75 | nemotron-3-ultra | off | metered | metered | v3 | Cache reads unreported | — | API |
| Other | 4.17 | 41.51 | mimo-v2.6-pro | off | metered | metered | v3 | 58.3% of input reported as cache reads; explicit request off | 58.3 | API |
| Other | 2.41 | 41.26 | muse-ember | off | metered | metered | v3 | 45.9% of input reported as cache reads; explicit request off | 45.9 | API |
| Other | 5.02 | 38.26 | muse-glimmer-30b | off | metered | metered | v3 | 79.9% of input reported as cache reads; explicit request off | 79.9 | API |
| Other | 1.68 | 36.86 | solar-pro4 | off | metered | metered | v3 | 22.9% of input reported as cache reads; explicit request off | 22.9 | API |
| Other | 1.37 | 33.42 | mistral-small | off | metered | metered | pre_v3 | Cache reads unreported | — | API |
| Other | 15.86 | 29.79 | mistral-large-4-0 | off | metered | metered | v3 | 51.1% of input reported as cache reads; explicit request off | 51.1 | API |
| Other | 1.38 | 23.47 | nova-lite | off | metered | metered | pre_v3 | Cache reads unreported | — | API |
| Qwen | 17.22 | 60.21 | qwen4-max | off | metered | metered | v3 | 39.8% of input reported as cache reads; explicit request off | 39.8 | API |
| Qwen | 15.28 | 58.96 | qwen3.6-27b | off | metered | metered | v3 | Cache reads unreported | — | API |
| Qwen | 26.72 | 53.12 | qwen3.8-2.4t-a95b | off | metered | metered | v3 | 57.6% of input reported as cache reads; explicit request off | 57.6 | API |
| Qwen | 25.14 | 50.52 | qwen3.8-max | on | metered | metered | v3 | 68.2% of input reported as cache reads; explicit request on | 68.2 | API |
| Qwen | 10.23 | 49.49 | qwen3.5-27b | off | metered | metered | v3 | Cache reads unreported | — | API |
| Qwen | 11.78 | 49.35 | qwen3.8-27b | off | metered | metered | v3 | 34.9% of input reported as cache reads; explicit request off | 34.9 | API |
| Qwen | 7.22 | 48.25 | qwen3.6-flash | off | metered | metered | pre_v3 | Cache reads unreported | — | API |
| Qwen | 6.92 | 47.71 | qwen3.7-plus | off | metered | metered | pre_v3 | Cache reads unreported | — | API |
| Qwen | 2.08 | 44.95 | qwen3.8-flash | off | metered | metered | v3 | 70.2% of input reported as cache reads; explicit request off | 70.2 | API |
| Qwen | 26.62 | 38.15 | qwen3.8-max-0902 | off | metered | metered | v3 | 59.4% of input reported as cache reads; explicit request off | 59.4 | API |
| Qwen | 52.68 | 36.67 | qwen3.8-max-prime | off | metered | metered | v3 | 58.3% of input reported as cache reads; explicit request off | 58.3 | API |
| xAI | 33.55 | 64.21 | grok-4.6 | off | metered | metered | v3 | 67.9% of input reported as cache reads; explicit request off | 67.9 | API |
| xAI | 20.94 | 55.95 | grok-4.5 | off | metered | metered | pre_v3 | Cache reads unreported | — | API |
| xAI | 29.99 | 53.83 | grok-4.7 | off | metered | metered | v3 | 62.4% of input reported as cache reads; explicit request off | 62.4 | API |
| xAI | 12.55 | 50.93 | grok-4.3 | off | metered | metered | v3 | Cache reads unreported | — | API |
| Z-AI | 5.74 | 45.96 | glm-5.2 | off | metered | metered | pre_v3 | Cache reads unreported | — | API |
| Z-AI | 10.58 | 45.37 | glm-5.1 | off | metered | metered | v3 | Cache reads unreported | — | API |
| Z-AI | 23.52 | 42.62 | glm-5.3 | off | metered | metered | v3 | 64.8% of input reported as cache reads; explicit request off | 64.8 | API |
| Z-AI | 3.35 | 41.09 | glm-5.3-flash | off | metered | metered | v3 | 48.7% of input reported as cache reads; explicit request off | 48.7 | API |
| Z-AI | 8.71 | 39.34 | glm-4.7 | off | metered | metered | v3 | Cache reads unreported | — | API |
| Z-AI | 63.58 | 38.82 | glm-5.3-prime | off | metered | metered | v3 | 62.7% of input reported as cache reads; explicit request off | 62.7 | API |
Die Laufkosten decken die gespeicherten Routing- und SQL-Antworten aus dem Benchmark-Lauf jedes Modells ab. Ziel waren 759 Fragen. Sieben Läufe haben weniger gespeicherte Antworten. Separate Smoke-Tests, verworfene Wiederholungsversuche und Jury-Aufrufe sind ausgeschlossen. Die SQL-Genauigkeit verwendet die korrekt weitergeleiteten Fragen jedes Modells, nachdem als fehlerhaft markierte Referenzen ausgeschlossen wurden.
Gemini 3 Flash Preview erreichte 67,7 % SQL-Genauigkeit bei 7,67 USD. Die gemessenen Läufe kosteten 13,48 USD für GPT-6.2 Sol (65,9 %) und 46,50 USD für GPT-6.2 Astra (67,6 %).
Die 85 API-Modelle verwenden gemessene Kosten. Opus 5.5, Fable 5.1 und GPT-6 Astra haben separat gekennzeichnete Schätzungen, die auf ihren aufgezeichneten CLI-Tokens und den am 1. Oktober 2026 geprüften OpenRouter-Preisen basieren, wobei die aufgezeichnete Cache-Nutzung erhalten bleibt.
Die Kosten umfassen die Datenbankexploration, und die SQL-Ergebnisse decken unterschiedliche Frageteilmengen ab. Dieser Vergleich beschreibt daher die Kosten und die Genauigkeit des kombinierten Benchmark-Workflows. Isolierte SQL-Generierungskosten wurden nicht gemessen. Der Agentic-RAG-Benchmark weist die Datenbankauswahl separat aus.
SQL-Genauigkeitsergebnisse
Die Spalte „Vor der Referenzprüfung“ misst die exakte Ergebnisübereinstimmung bei allen korrekt weitergeleiteten Fragen. Die Spalte „Nach der Antwortprüfung“ vergibt zusätzliche Punkte für Antworten, die von der Jury akzeptiert wurden. Beide Vergleichsspalten verwenden den ursprünglichen Nenner, während die SQL-Genauigkeit markierte Referenzen ausschließt.
Wie Modelle dieselbe SQL-Frage beantworteten
Dieselbe Frage führte zu exakten Übereinstimmungen, zu korrekten Antworten mit zusätzlichen Spalten und zu einer nicht verwandten Einrichtung. Alle acht Modelle wählten die richtige Datenbank, college_completion. Die Tabelle institution_details speichert Einrichtungsnamen in chronname, Städte in city und Bundesstaaten in state. Diese Antworten stammen aus gespeicherten Benchmark-Läufen. Sieben Modelle verwendeten OpenRouter, während Opus 5.5 Claude Code verwendete.
GPT-6.1 Terra, Kimi K3.1 Pro, Gemini 4 Argon und Opus 5.5 gaben Georgia zurück und bestanden den Ausführungsabgleich. Muse Spark Open und DeepSeek V4.1 Flash 1017 identifizierten ebenfalls Georgia, enthielten jedoch Namens- und Ortsspalten. Sie scheiterten am strikten Ergebnisvergleich. Alle drei Jurymitglieder der Antwortprüfung akzeptierten jede Antwort.
MiniMax M3.1 Flash und GLM 5.3 verwendeten LIKE '%Mercer%', das ebenfalls das Mercer County Community College in New Jersey zurückgab. Alle drei Jurymitglieder stuften jede Antwort als Modellfehler ein. Die Referenz bestand die separate Validitätsprüfung.
Wir haben diesen Fall ausgewählt, um zu zeigen, wie Filterung und Ausgabespalten die Bewertung beeinflussen. Er veranschaulicht einzelne Antworten. Die vollständigen Benchmark-Ergebnisse oben liefern den Gesamtmodellvergleich.
Bedingungen, die SQL-Genauigkeit beeinflussen
BIRD-Hinweise erhöhten bei Gemini Flash die SQL-Genauigkeit um 8.7 Punkte
Wir wiederholten gemini-3-flash-preview mit den ergänzenden BIRD-Hinweisen. Bei Fragen, die unter beiden Bedingungen korrekt weitergeleitet wurden, stieg die SQL-Genauigkeit von 67,5 % auf 76,2 %. Die strikte Genauigkeit vor der Referenzprüfung stieg von 55,0 % auf 61,6 %.
Dies war ein Experiment mit einem einzelnen Modell. Es begründet keinen allgemeinen Anstieg für das Panel mit 88 Modellen. Das Hauptpanel hält die Hinweise zurück, da sie auch verraten können, welche Datenbank auszuwählen ist.
Modelle erreichten unterschiedliche Mengen an SQL-Fragen
Die Datenbankentscheidungen jedes Modells bestimmen, welche Fragen in die SQL-Bewertung gelangen. Bei claude-opus-5 enthält der strikte Nenner 717 Fragen, darunter 156 aus der schwierigsten Routing-Gruppe. Bei nova-lite-v1 enthält er 285 Fragen, darunter 22 aus dieser Gruppe. Die Anteile betragen 21,8 % und 7,7 %.
Ihre SQL-Prozentsätze kombinieren daher die Abfrageerstellungsleistung mit der Schwierigkeit der bewerteten Fälle. Ein kontrollierter SQL-Vergleich würde jedem Modell die richtige Datenbank für dieselben Fragen bereitstellen. Dieses Experiment wurde nicht durchgeführt.
Die Fragenauswahl ist auch beim Vergleich von KI-Benchmarks von Bedeutung, die unterschiedliche Schemas, Hinweise oder Tool-Budgets bereitstellen.
Ergebnisse aus der Referenz- und Antwortprüfung
Die Referenzprüfung markierte 236 von 759 Abfragen
Fünf Modelle bewerteten jede Referenzabfrage anhand ihrer Frage und der verfügbaren Schemainformationen. Sie sahen keine Kandidatenantwort des Modells. Eine Mehrheit von mindestens drei markierte 236 Referenzen als fehlerhaft, das sind 31,1 % des Datensatzes.
Nach der Prüfung überprüfte der Benchmark-Eigentümer die Markierungen. Unabhängige menschliche Annotatoren haben diese Prüfung nicht wiederholt. Diese Prozentsätze beschreiben die geprüfte Teilmenge. Sie sollten nicht auf den gesamten BIRD-Datensatz verallgemeinert werden.
Äquivalente Antworten fügten 22.7 Punkte zur Punktzahl von claude-sonnet-5 hinzu
claude-sonnet-5 bestand 211 von 679 strikt bewerteten Fragen, das sind 31,1 %. Eine Jury akzeptierte weitere 154 Antworten als äquivalent zur Referenz. Diese trugen 22.7 Prozentpunkte bei.
Weitere 117 Antworten erhielten Punkte, weil die Jury die Abfrage des Modells akzeptierte und die Referenz ablehnte. Diese trugen 17.2 Punkte bei. Zusammen erhöhten die beiden Kategorien die Punktzahl auf 71,0 %, ein Anstieg von 39.9 Punkten.
Äquivalente Antworten können die angeforderte Information mit einer zusätzlichen Spalte oder einer anderen Projektion zurückgeben. Der strikte Vergleich kann dieses Ergebnis ablehnen, selbst wenn ein Prüfer es als Antwort auf die Frage akzeptiert. Von dem Anstieg stammen 22.7 Punkte aus den Entscheidungen der Jury zu diesen Fällen. Referenzfehler machen die verbleibenden 17.2 Punkte aus.
 Als bevorzugte Quelle hinzufügen
Methodik des Text-zu-SQL-Benchmarks
Questions and execution
BIRD-SQL liefert natürlichsprachliche Fragen, SQL-Referenzen und Datenbankinhalte.1 Wir verwendeten eine fixierte Auswahl von 759 Fragen aus 11 Datenbanken, die 560 Trainings- und 199 Entwicklungsbeispiele abdeckt.
Die Modelle erhielten kurze Datenbankbeschreibungen und Werkzeuge zum Auflisten von Tabellen, Lesen von Spaltendefinitionen und Ausführen von SQL. Pro Frage waren bis zu neun Aufrufe mit Werkzeugen und eine abschließende Antwort mit der gewählten Datenbank und SQL erlaubt. Das Limit für die Schema-Vorschau lag bei 4.000 Zeichen, und Abfragevorschauen wurden auf 50 Zeilen begrenzt.
Die endgültige Kandidatenabfrage und die Referenz wurden gegen dieselbe Datenbankdatei ausgeführt. Die strikte Bewertung verglich ihre Ergebnisse, einschließlich eines reihenfolgesensitiven Modus für Fragen, die eine geordnete Antwort verlangen. Fehlende, fehlerhafte und bei der Ausführung gescheiterte Kandidatenabfragen erhielten keine strikte Anerkennung bei ansonsten geeigneten, korrekt weitergeleiteten Fragen.
Für die 85 OpenRouter-Läufe forderten wir Temperatur 0 an. Davon nutzten 68 die v3-Wiederherstellungsschicht für Tool-Aufrufe, 15 lagen davor, und zwei kombinierten Datensätze aus beiden Versionen. GPT-6 Astra lief über Codex CLI. Opus 5.5 und Fable 5.1 verwendeten Claude Code. Alle drei CLI-Läufe verwendeten mittleren Reasoning-Aufwand. Die Läufe für GPT-6 Luna, Luna Pro, Sol und Sol Pro sowie GPT-5.2 verwendeten OpenRouter. Diese Ausführungsunterschiede verhindern, dass eine Punktlücke allein dem Modell zugeschrieben wird.
Sieben Läufe absolvierten weniger als 759 Fragen. Fehlende Datensätze fehlen in den Bewertungsnennern. Die Tabelle gibt die tatsächlichen Stichprobengrößen für die Haupt- und Zusatzergebnisse an. GPT-6.1 Terra, MiniMax M3.1 Flash und Kimi K3.1 Pro absolvierten jeweils alle 759 Fragen über OpenRouter am 27. Oktober. Frühere erfolgreiche Antworten blieben über die Messphasen hinweg erhalten. DeepSeek V4.1 Flash 1017 und Muse Spark Open absolvierten jeweils alle 759 Fragen über OpenRouter am 30. Oktober. Fable 5.2 und Muse Ember absolvierten jeweils alle 759 Fragen über OpenRouter am 10. November. Gemini 4 Carbon absolvierte alle 759 Fragen über OpenRouter am 12. November. Gemini 4 Carbon wechselte nach Provider-Ratenlimits von Google KI Studio zu Google Vertex US. Erfolgreiche Antworten blieben über den Wechsel hinweg erhalten.
SQL-Bewertung
Die Hauptwertung schließt markierte Fragen sowohl aus dem Zähler als auch aus dem Nenner aus. Drei als unsicher markierte Referenzen bleiben in der Berechnung enthalten. Die Ergebnisdateien bezeichnen diese Metrik als ex_gold_clean.
Zwei ergänzende Werte zeigen, wie die Prüfung das Ergebnis verändert:
Vor der Referenzprüfung misst die strikte Wertung die exakte Ausführungsübereinstimmung bei allen korrekt weitergeleiteten Fragen. Sie umfasst auch Fragen mit markierten Referenzen.
Nach der Antwortprüfung vergibt die Wertung zusätzliche Punkte, wenn eine separate Jury eine geeignete verpasste Antwort akzeptiert. Sie verwendet denselben Nenner wie die strikte Wertung. Die Ergebnisdateien bezeichnen dies als adjudizierte Genauigkeit.
Die Stichprobengröße (n) ist die Anzahl der bewerteten Fragen. Die Hauptwertung verwendet eine kleinere Teilmenge als die beiden ergänzenden Wertungen.
Bei claude-sonnet-5 reduzierte der Ausschluss markierter Referenzen die akzeptierten Antworten von 211 auf 180 und die bewerteten Fragen von 679 auf 468. Die SQL-Genauigkeit betrug 38,5 %.
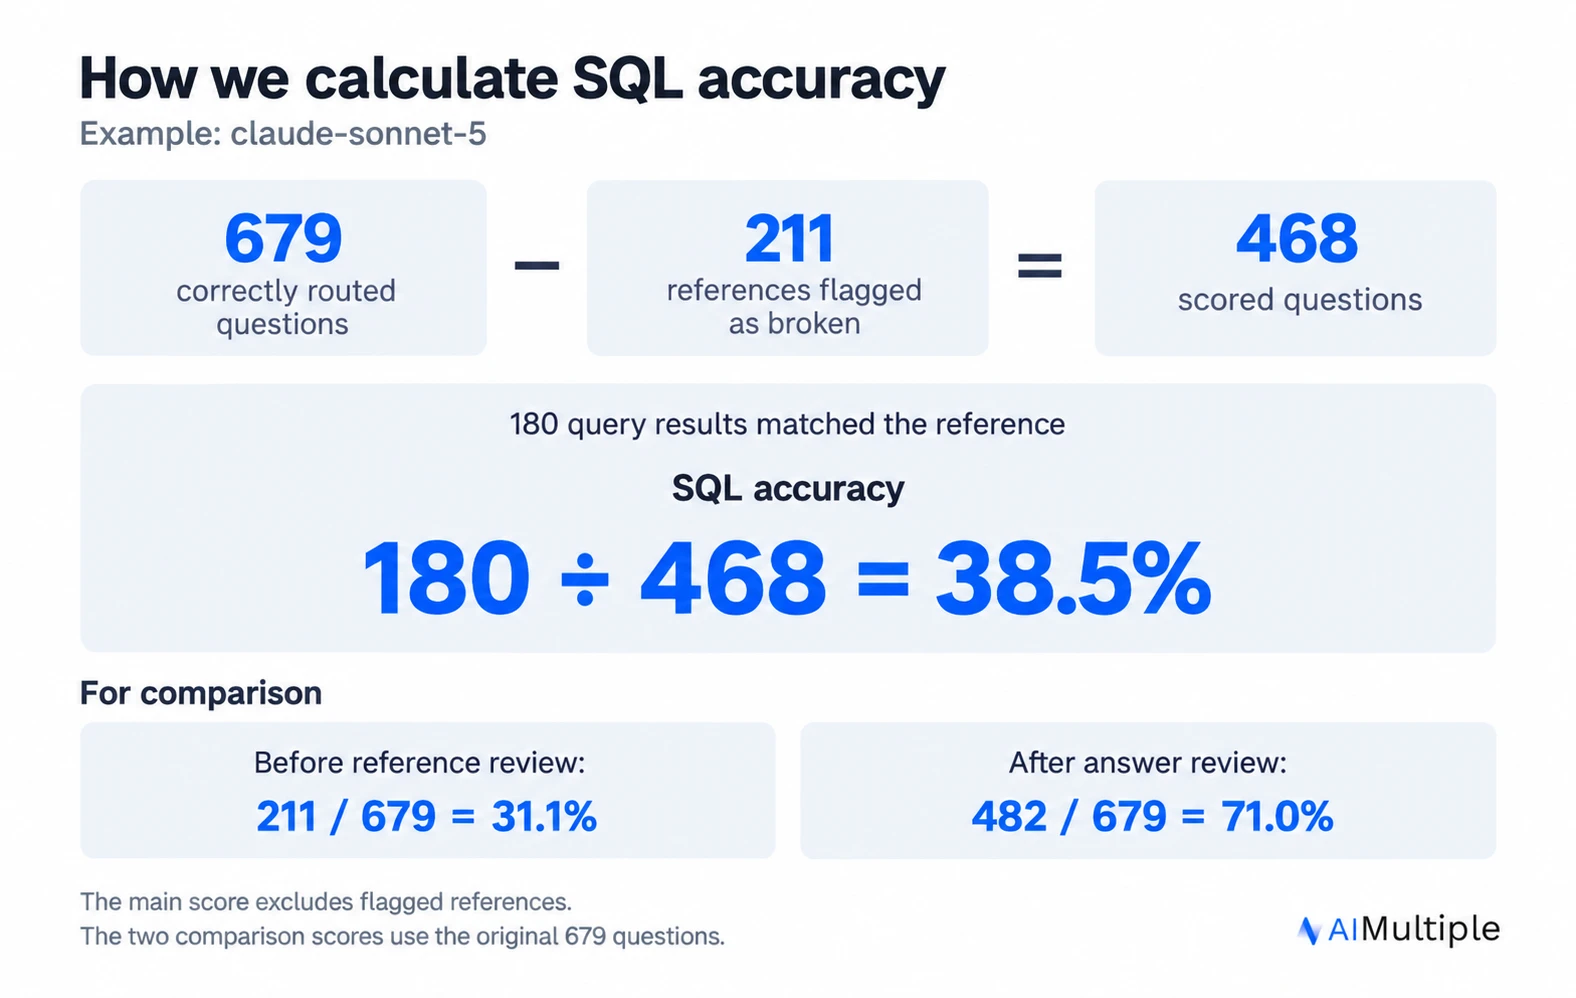
Der Ausschluss verändert beide Zählungen. Die Antwortprüfung behält stattdessen den ursprünglichen Nenner bei und vergibt Punkte für akzeptierte verpasste Antworten.
Referenz- und Antwortprüfung
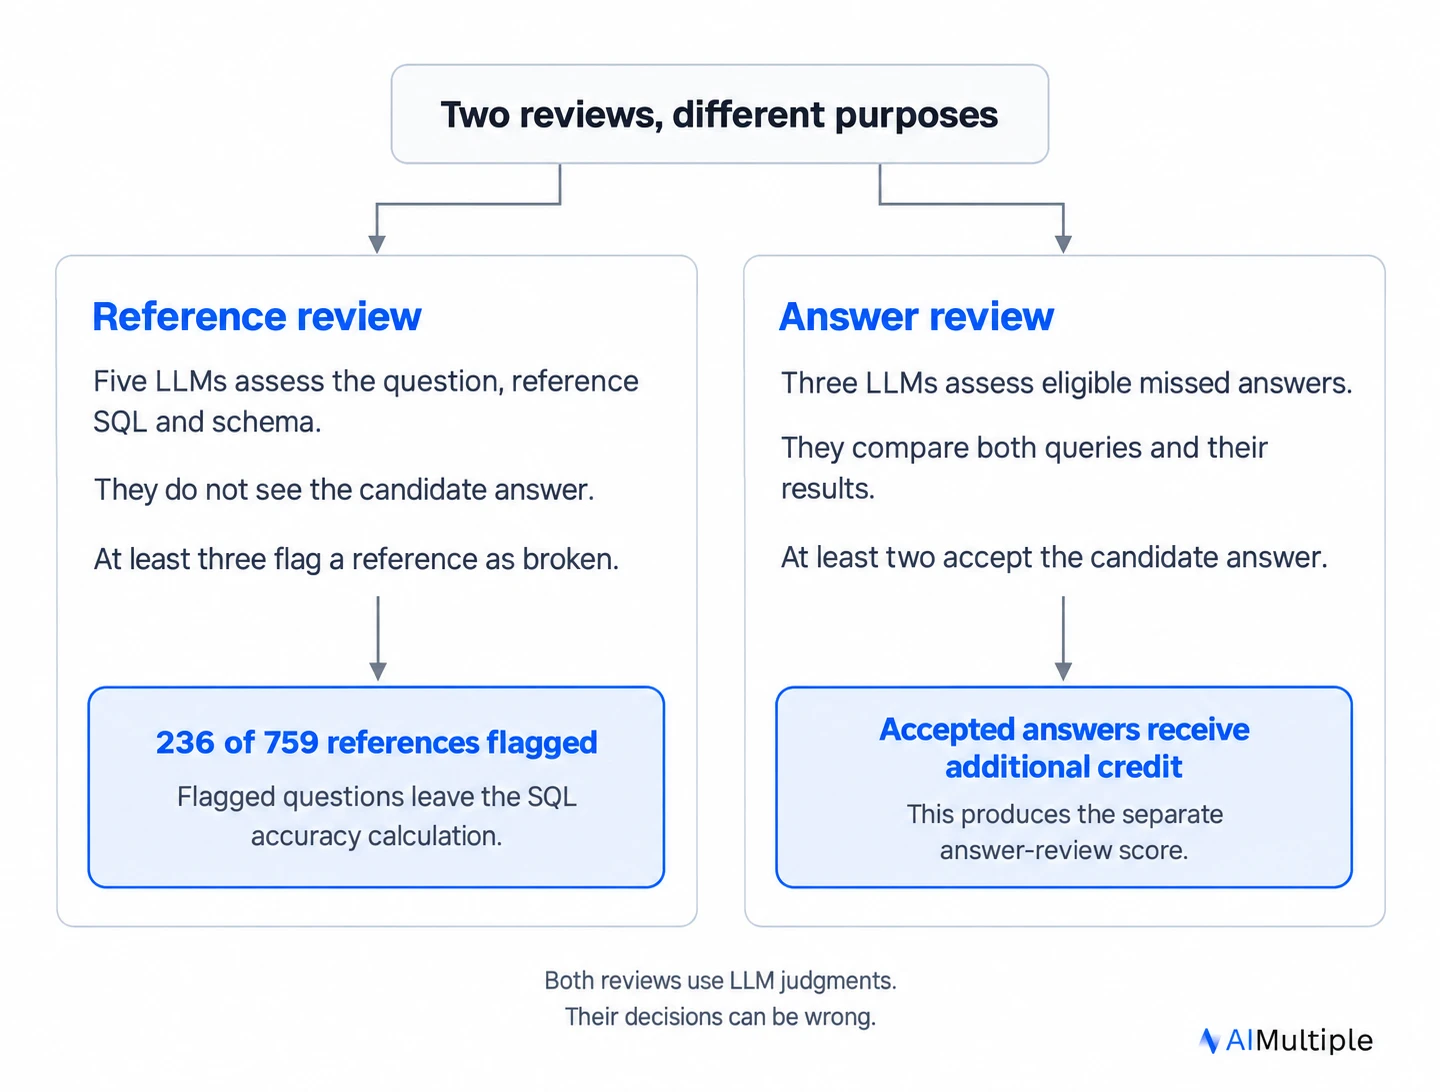
Die Prüfung von Referenzen und die Überprüfung von Kandidatenantworten erfordern unterschiedliche Eingaben.
Die Referenzprüfer waren claude-opus-4.8, gpt-5.6-sol, gemini-3.1-pro-preview, grok-4.5 und deepseek-v4-pro. Die Kandidatenantworten wurden zurückgehalten, damit die Markierungen unabhängig vom bewerteten Modell bleiben.
Die Antwort-Adjudikation verwendete drei Juroren aus Modellfamilien, die sich von der des Kandidaten unterscheiden. Die Referenz- und Kandidatenabfragen erschienen in randomisierten A/B-Positionen ohne Labels, die ihre Rollen verraten. Mehrdeutige Fälle und Fälle mit unzureichenden gültigen Stimmen erhielten keine zusätzlichen Punkte. GPT-6.1 Terra, MiniMax M3.1 Flash und Kimi K3.1 Pro hatten für jeden geeigneten Fall mindestens zwei gültige Jurystimmen. Einzelne fehlgeschlagene Stimmen bleiben in den Prüfprotokollen erhalten. Eine abgeschnittene Juryantwort von GPT-6.1 Terra wurde mit einem Ausgabelimit von 4.000 Token abgeschlossen, erhöht von 1.200. Jurymodell, Prompt und Bewertungsregeln blieben unverändert. DeepSeek V4.1 Flash 1017 und Muse Spark Open hatten für jeden geeigneten Fall mindestens zwei gültige Jurystimmen. Fable 5.2 und Muse Ember hatten für jeden geeigneten Fall mindestens zwei gültige Jurystimmen. Gemini 4 Carbon hatte für jeden geeigneten Fall mindestens zwei gültige Jurystimmen. Qwen4 Max, Gemini 4 Hydrogen, GPT-6.2 Astra und GPT-6.2 Sol hatten jeweils mindestens zwei gültige Jurystimmen pro geeignetem Fall.
Die Prüfabdeckung ist asymmetrisch. Strikte bestandene Antworten bleiben akzeptiert, während geeignete verpasste Antworten eine erneute Bewertung erhalten. Folglich kann die Adjudikation falsch positive Ergebnisse aus der strikten Bewertung beibehalten und eigene falsch positive hinzufügen. Sie ist eine ergänzende Schätzung, die weder garantierte Korrektheit noch eine garantierte Obergrenze für die tatsächliche Genauigkeit bietet.
Eine verpasste Antwort qualifizierte sich für die Adjudikation, wenn die Kandidatenabfrage ausgeführt wurde und die F1-Überlappung zwischen ihren Ergebniszeilen und der Referenz unter 0.5 lag. F1 kombiniert den Anteil der in der Referenz gefundenen Kandidatenzeilen mit dem Anteil der vom Kandidaten wiederhergestellten Referenzzeilen.
Zum Beispiel hatte gemini-3.5-flash-lite 346 strikte Fehlversuche. Davon kamen 314 für die Prüfung infrage. Die Jury akzeptierte den Kandidaten in 144 Fällen: 92 mit einer abgelehnten Referenz und 52 mit beiden akzeptierten Antworten. Sie stufte 105 als Modellfehler ein und ließ 65 mehrdeutig. Die anderen 32 Fehlversuche umfassten 27 mit höherer Ergebnisüberlappung und fünf Ausführungsfehler.
Die Jury akzeptierte 45,9 % der 314 geprüften Fehlversuche.
Einschränkungen
Referenzfehler bleiben unsicher. Die Prüfung mit fünf Modellen untersuchte Spalten aus Tabellen, die von jeder Referenzabfrage verwendet wurden, und kann daher eine Antwort übersehen, die sich in einer anderen Tabelle befindet. Die Prüfung kann auch eine gültige Referenz ablehnen. Eine Wiederholungsprüfung durch unabhängige menschliche Annotatoren ist erforderlich, um beide Fehlerarten abzuschätzen.
Die Urteile der Jury hängen von der LLM-Interpretation ab. Keine unabhängige menschliche Prüfung verifizierte alle Adjudikationsurteile. In der nova-lite-v1-Kontrolle stieg die Genauigkeit von 18,9 % unter strikter Bewertung auf 31,6 % nach der Adjudikation, was zeigt, dass die Prüfung nicht automatisch zu einer hohen Punktzahl führte. Diese Kontrolle allein kann die Genauigkeit der Jury nicht belegen.
Der strikte Vergleich kann in beide Richtungen fehlschlagen. Zusätzliche Spalten oder eine andere Spaltenreihenfolge können eine nützliche Antwort ablehnen. Die Normalisierung der Groß-/Kleinschreibung und das Runden von Gleitkommawerten auf sechs signifikante Stellen können Unterschiede akzeptieren, die von Bedeutung sind.
Fragenstichprobenintervalle sind für strikte Ergebnisse und die SQL-Genauigkeit im Ergebnisexport verfügbar. Sie lassen die Unsicherheit der Referenzkennzeichnung, Jurorenfehler und die Variation zwischen wiederholten SQL-Läufen aus. Eine SQL-Wiederholungsanalyse wird hier nicht berichtet.
Dies sind Ergebnisse für eine ausgewählte, hint-free-Arbeitslast mit einer Datenbankrouting-Anforderung. Sie sind nicht direkt mit der BIRD-Bestenliste vergleichbar. Die öffentlichen Trainingsdaten bergen zudem das Risiko einer Überlappung mit Trainingsdaten, wie im Routing-Artikel erörtert.
Fazit
Opus 5.5 führte die SQL-Genauigkeit mit 87,8 % an, gefolgt von Fable 5.2 mit 86,4 % und Gemini 4 Argon mit 78,6 %.
Jeder SQL-Wert spiegelt die Fragen wider, die das Modell korrekt weitergeleitet hat, sowie die nach der Prüfung beibehaltenen Referenzen. Ein kontrollierter SQL-Vergleich würde jedem Modell dieselben Fragen und Datenbankinformationen geben, mit unabhängigen Prüfungen der Referenzkennzeichnungen und Juryentscheidungen.
Weiterführende Informationen
- Agentic-RAG-Benchmark: Multi-Datenbank-Routing
- 800+ führende KI-Benchmarks
- HALC-Bench: LLM-Halluzination beim Langkontext-Retrieval-Benchmark
Zitieren Sie diesen Benchmark
Wählen Sie das Format, das zu Ihrem Veröffentlichungsort passt. Wenn Sie die Link-Version in Ihr CMS einfügen, bleibt der Backlink erhalten.
@misc{sari2026,
  author = {Sarı, Ekrem},
  title  = {{AIM-Text-to-SQL-Benchmark: SQL-Genauigkeit bei über 70 LLMs}},
  year   = {2026},
  month  = nov,
  howpublished    = {\url{https://aimultiple.com/text-to-sql}},
  note   = {AIMultiple. Abgerufen am 17. November 2026}
}Ergebnisse und Zeitstempel von 1.6 Tausend Datenpunkten. Laden Sie die Zusammenfassungsdaten aus den Diagrammen und Tabellen dieses Artikels als ZIP-Datei herunter, die 5 CSV-Dateien und eine README enthält.
Möchten Sie die granularen Daten dahinter? Premium beitreten
Änderungsprotokoll
9 AktualisierungenText-to-SQL-Benchmarkergebnisse durch ein 36-Modell-Panel mit strict-, gold-clean- und adjudicated-Execution-Match-Bewertung ersetzt.
Ein Änderungsprotokoll wurde zum Abschnitt „Agentic RAG Benchmark: Multi-Datenbank-Routing und Abfragegenerierung“ hinzugefügt.
Der Methodik-Abschnitt wurde durch eine Zusammenfassung und einen Verweis auf einen anderen Artikel ersetzt.
Referenzlinks





Kommentare 1
Teilen Sie Ihre Gedanken
Ihre E-Mail-Adresse wird nicht veröffentlicht. Alle Felder sind erforderlich. Kommentare werden in ihrer Originalsprache belassen.
Curious, how much of the context engineering and specific prompting did you apply in your benchmarks. Or, was it to review the models only? I have found much higher return of correct and consistent responses. A higher fidelity. To do that, I needed to provide a most sophisticated prompt that fed the context window as the question was being asked. Not perfect, but better than those scores represented in this article when using the Grok 4.x .
Great point. This benchmark intentionally uses zero-shot, minimal prompting with temperature=0. No few-shot examples, no domain-specific instructions, no iterative refinement. The goal was to measure each model's baseline text-to-SQL capability. So your experience with Grok 4 getting higher fidelity through sophisticated context engineering is completely expected. A well-crafted prompt with detailed schema descriptions, few-shot examples, and domain-specific rules will improve any model's performance significantly. What this benchmark isolates is how well the model performs out-of-the-box when given only the raw question and retrieved schema, which helps compare the models' inherent SQL reasoning abilities on a level playing field. We'll make this clearer in the methodology section. Thanks for raising it.