


L'avenir des grands modèles de langage

Découvrez l'avenir des grands modèles de langage en comparant des approches, telles que l'auto-entraînement, la vérification des faits et l'expertise parcimonieuse, qui pourraient remédier aux limites des LLM.
Tendances futures des grands modèles de langage
1- Vérification des faits en temps réel avec des données en direct
LLMs accèdent à des sources externes pendant les conversations au lieu de s'appuyer sur les données d'entraînement. Le modèle interroge des bases de données externes, récupère les informations actuelles et fournit des citations.
Limite : Fait encore des erreurs. Les citations ne garantissent pas l'exactitude ; les modèles citent parfois les sources de manière incorrecte ou interprètent mal le contenu cité.
Microsoft Copilot : Microsoft et OpenAI ont annoncé que GPT-6 Astra est disponible dans Copilot Cowork et Copilot Studio, ainsi que dans Microsoft Foundry et GitHub Copilot. L'agent Researcher combine GPT pour la recherche initiale avec Anthropic et Claude vérifiant les résultats pour l'exactitude et la qualité des citations avant la livraison, soit une amélioration de 13,8 % sur le benchmark de recherche approfondie DRACO par rapport aux systèmes autonomes.1
- ChatGPT : Recherche sur le web lorsqu'on l'interroge sur des événements récents. Cite des sources dans ses réponses.
- Perplexity : Conçu spécifiquement pour la recherche citée. Chaque réponse inclut des liens sources.
2- Données d'entraînement synthétiques
Les modèles génèrent leurs propres datasets d'entraînement au lieu de nécessiter des données étiquetées par des humains.
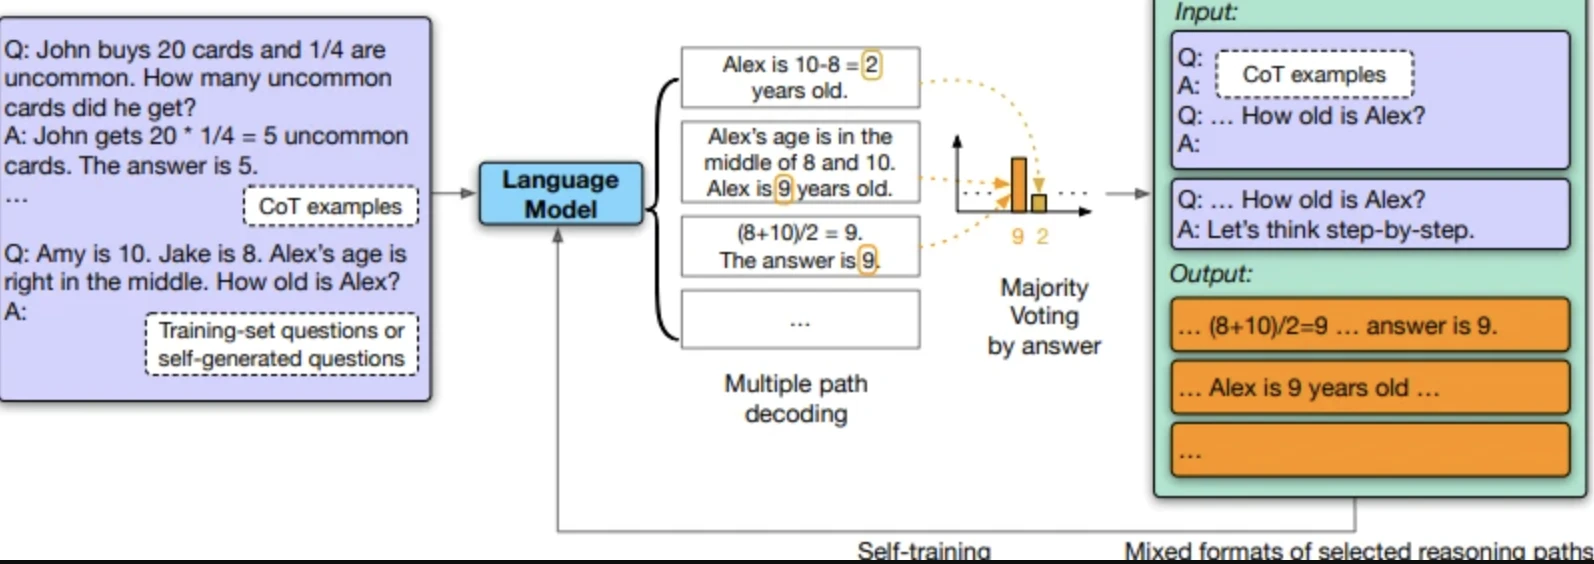
Le modèle auto-améliorant de Google (recherche de 2023) :
- Le modèle crée des questions
- Organise les réponses
- Se fine-tune lui-même sur les données générées
Performance améliorée : de 74,2 % à 82,1 % sur les problèmes mathématiques GSM8K, de 78,2 % à 83,0 % en compréhension de lecture DROP.
OpenAI, Anthropic et Google utilisent tous des données synthétiques pour compléter les datasets étiquetés par des humains. Cela réduit les coûts d'étiquetage des données mais introduit de nouveaux risques de biais ; les modèles peuvent amplifier leurs propres erreurs.
Source : « Les grands modèles de langage peuvent s'auto-améliorer »
Un sondage de mars 2026 a révélé que 76 % des chercheurs en IA estiment que les gains issus de l'augmentation de la puissance de calcul et des données ont atteint un plateau, les grands laboratoires signalant des rendements décroissants malgré des investissements massifs. La conclusion suggère que le prochain bond des capacités des LLM viendra plus probablement de l'innovation architecturale, telle qu'une meilleure efficacité d'entraînement, des architectures parcimonieuses ou des améliorations du raisonnement, plutôt que de l'extension des approches existantes.2
3- Modèles experts parcimonieux (Mixture of Experts)
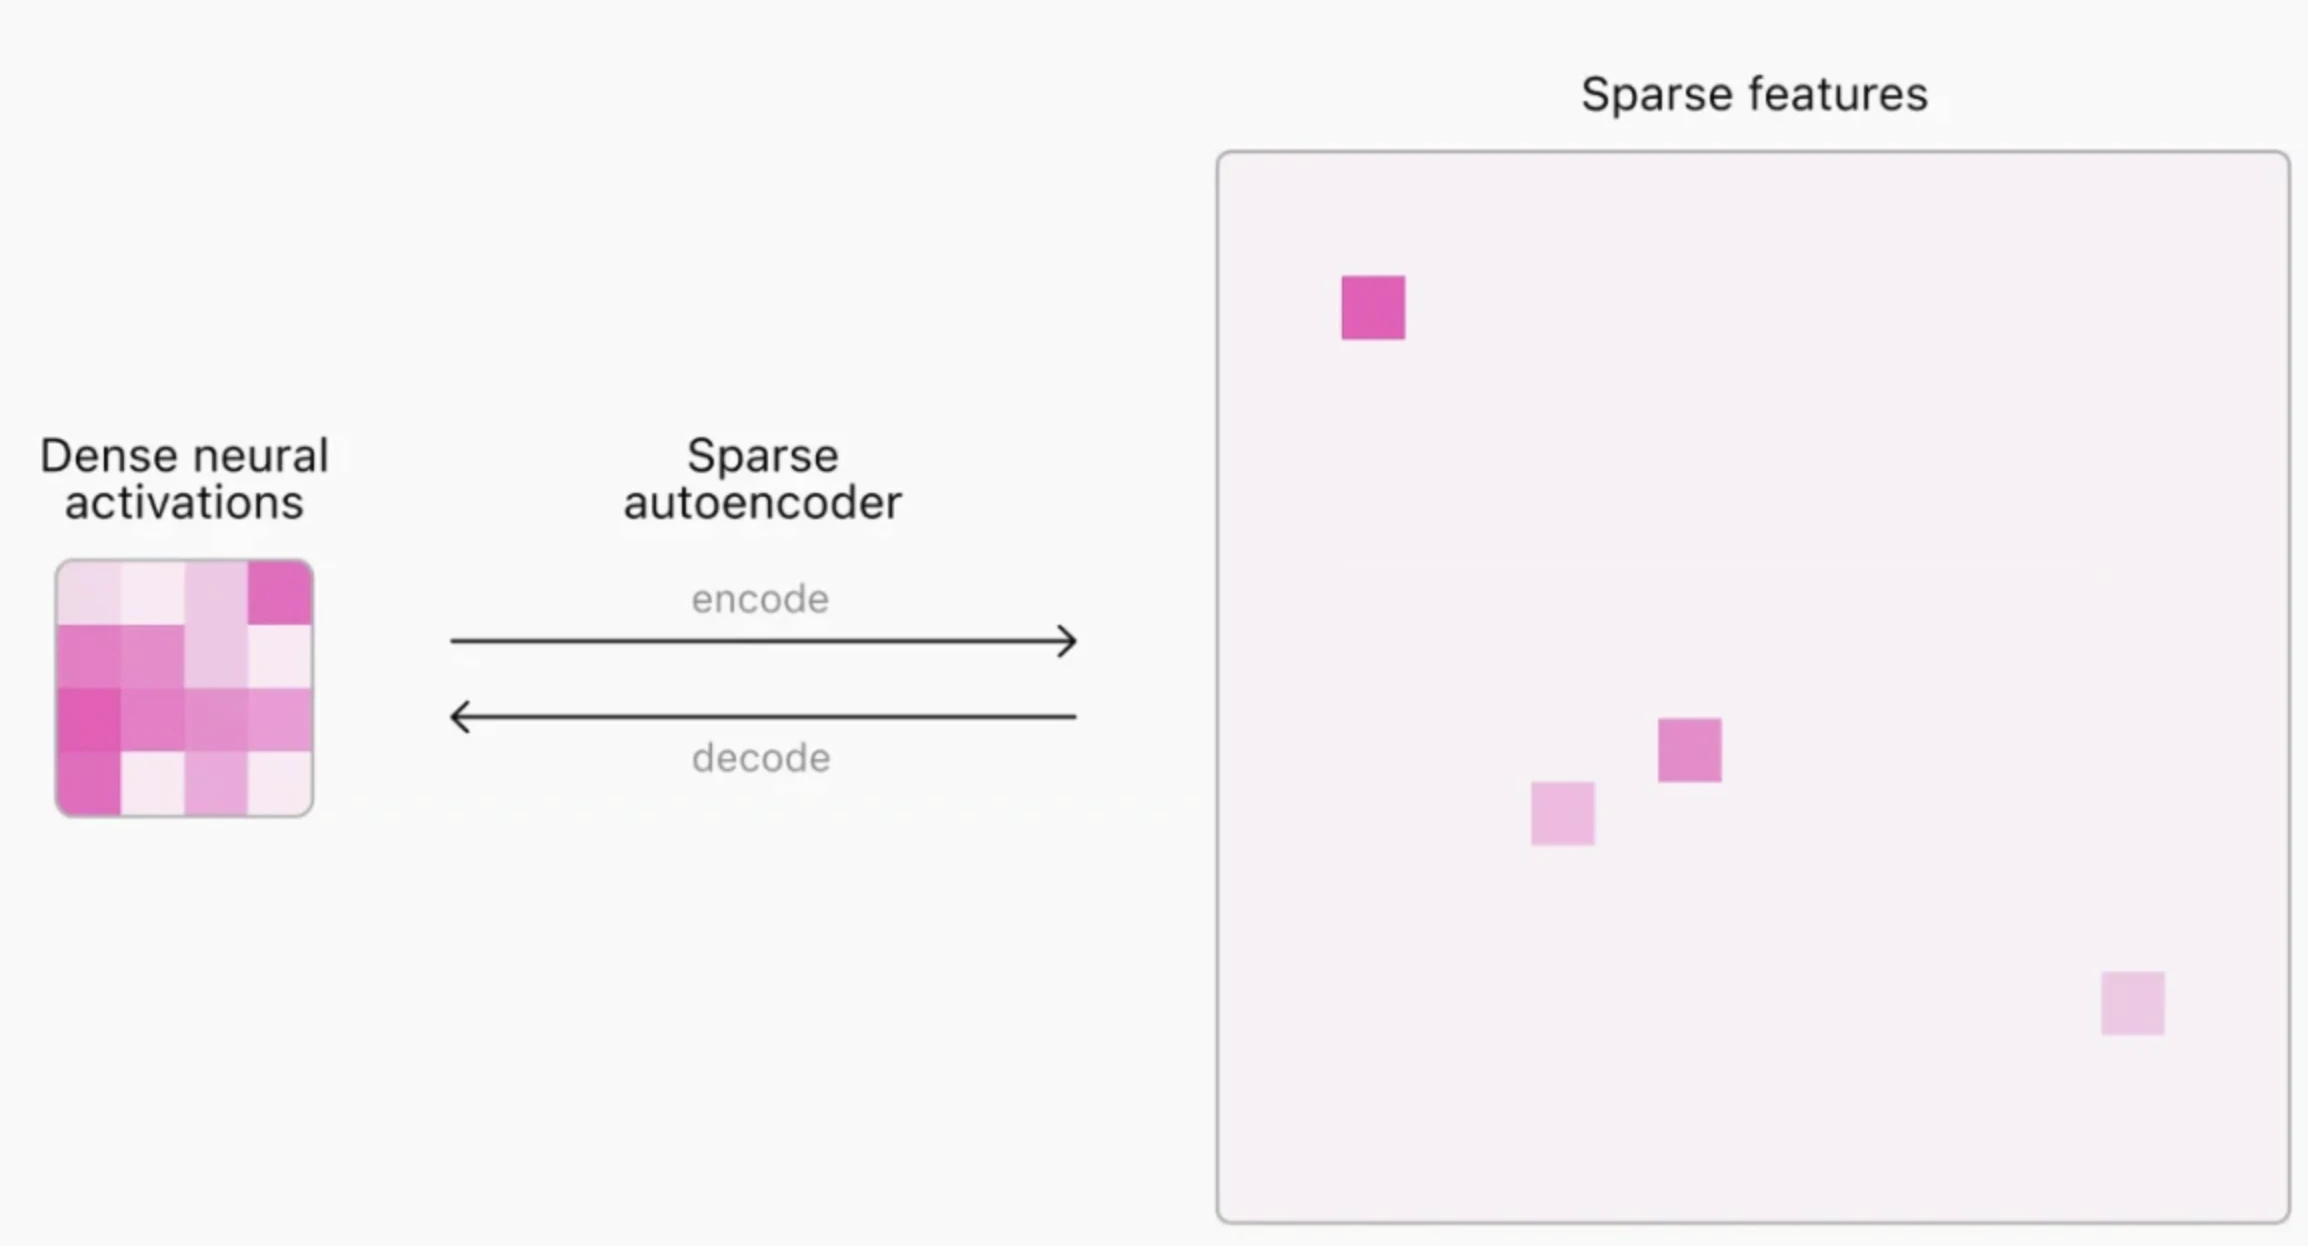
Au lieu d'activer l'ensemble du réseau de neurones pour chaque entrée, un sous-ensemble pertinent de paramètres s'active selon la tâche. Le modèle achemine l'entrée vers des « experts » spécialisés au sein du réseau. Seuls les experts activés traitent la requête.
Exemples concrets :
- DeepSeek V4-Pro : Un modèle Mixture-of-Experts avec 1.6T paramètres au total et 49B activés, aux côtés du plus petit DeepSeek-V4-Flash à 284B paramètres (13B activés), tous deux prenant en charge un contexte d'un million de tokens.3
- Qwen3.8-Max (Alibaba) : Construit sur l'architecture Qwen 3.5, il monte jusqu'à 2.4 billions de paramètres avec 95B actifs, et c'est le premier modèle Qwen de classe Max dont Alibaba s'est engagé à ouvrir les poids.
- Mistral Devstral 2 : Spécialement conçu pour l'ingénierie logicielle. 123B paramètres, fenêtre de contexte de 256K tokens, 72,2 % sur SWE-bench.4Une variante plus petite, Devstral Small 2 (24B paramètres), s'exécute localement sous Apache 2.0. Le modèle plus récent de Mistral est Mistral Large 4, un modèle MoE multimodal à poids ouverts avec une fenêtre de contexte de 1M, lancé en avant-première publique le 6 octobre 2026, les poids devant être publiés plus tard ce mois-ci.
4- Intégration aux flux de travail d'entreprise
LLMs sont intégrés directement dans les processus métier plutôt que d'être utilisés comme des outils autonomes.
Exemples concrets :
- Salesforce Agentforce (anciennement Einstein Copilot) : Intègre les LLMs dans les opérations CRM. Répond aux requêtes des clients, génère du contenu et exécute des actions dans Salesforce, en s'appuyant sur les données et métadonnées CRM de l'organisation via la couche de confiance Einstein.5
- Microsoft 365 Copilot : Intégré dans Word, Excel, PowerPoint et Outlook. Rédige des documents, analyse des feuilles de calcul, génère des présentations et résume des fils de discussion e-mail, en s'appuyant sur les données de l'entreprise via Microsoft Graph pour ancrer les réponses dans le contexte organisationnel.6 L'agent Researcher utilise une architecture multi-modèles où GPT gère la recherche initiale et Claude vérifie les résultats avant la livraison, premier déploiement commercial confirmé de fournisseurs d'IA concurrents au sein d'un même produit d'entreprise.
- Anthropic Claude pour entreprise : La séparation de la mémoire par projet maintient des contextes de travail distincts entre les équipes. Claude Opus 4.6 a introduit des équipes d'agents, permettant à plusieurs agents Claude de diviser les tâches plus importantes en flux de travail parallèles, et a intégré Claude dans PowerPoint en tant que panneau latéral natif. La recommandation d'Anthropic est de commencer avec Claude Opus 5.5 pour la plupart des charges de travail, et d'utiliser Claude Fable 5.1 pour le raisonnement exigeant et les tâches agentiques de longue haleine.7
5- LLMs hybrides dotés de capacités multimodales
Les grands modèles multimodaux intègrent plusieurs formes de données, comme le texte, les images et l'audio, ce qui leur permet de comprendre et de générer du contenu sur différents types de médias.
- Gemini 3.8 Flash : Google le décrit comme son modèle Flash le plus intelligent, conçu pour l'ingénierie logicielle de longue haleine, les agents autonomes et les flux de travail complexes en entreprise. Le prix de lancement est de $0,75 par million de tokens d'entrée et $3,75 par million de tokens de sortie jusqu'au 31 décembre 2026 ; le tarif standard de $1,50 et $7,50 commencera le 1er janvier 2027. Google a restreint les anciens modèles Gemini 2.5 aux utilisateurs qui les ont déjà utilisés, et oriente les nouveaux projets vers 3.5 Flash-Lite ou 3.8 Flash.8
- Meta Muse Spark 1.3 et Muse Glimmer : Muse Spark, lancé le 8 avril 2026, a remplacé la gamme Llama de Meta. Muse Spark 1.3 possède une fenêtre de contexte de 1M tokens, et ses poids restent fermés, bien que Meta mentionne une sortie à poids ouverts sur sa feuille de route.9Pour les poids ouverts, Muse Glimmer est un modèle de 30 milliards de paramètres doté d'un encodeur de perception dédié, distillé à partir de Muse Spark et conçu pour des tâches agentiques sur du matériel grand public, publié sous Apache 2.0.10
La capacité multimodale est standard parmi les modèles de pointe. Le défi restant est la cohérence : les modèles obtiennent de bons résultats sur les combinaisons image-texte courantes, mais se dégradent dans les contextes visuels rares, les entrées à basse résolution et le raisonnement intermodal qui exige de relier des preuves visuelles et textuelles.
6- Modèles de raisonnement
Des modèles qui réfléchissent aux problèmes étape par étape plutôt que de générer des réponses immédiates.
Ce passage de la prédiction au raisonnement est essentiel pour permettre :
- Un comportement agentique, où les modèles planifient, exécutent et adaptent les tâches de manière autonome.
- Une IA interprétable, où les sorties sont étape par étape et logiquement solides.
- Famille Claude 5.5 et Fable 5.1 (Anthropic) : Les quatre modèles offrent une fenêtre de contexte de 1M tokens, une sortie maximale de 128K, une réflexion adaptative et une date de connaissance fiable de juin 2026. Tarification API par million de tokens : Fable 5.1 à $10 en entrée / $50 en sortie, Opus 5.5 à $4 / $20, Sonnet 5.5 à $2 / $10, et Haiku 5.5 à $0,10 / $0,50 pour les prompts jusqu'à 100 000 tokens.11
- GPT-6 Astra (OpenAI) : La tarification API standard est de $10 par million de tokens d'entrée et $50 par million de tokens de sortie ; un mode rapide est jusqu'à 2x plus rapide pour 2x le prix.12
7- Modèles spécialisés par domaine et fine-tunés
Des modèles entraînés sur des données spécialisées pour des secteurs spécifiques au lieu d'un entraînement généraliste.
Google, Microsoft et Meta ont tous publié d'importants modèles propriétaires spécialisés par domaine et fine-tunés ciblant des cas d'usage spécifiques aux entreprises, en plus de leurs offres généralistes.
Ces LLMs spécialisés peuvent entraîner moins d'hallucinations et une plus grande précision en exploitant le pré-entraînement spécifique au domaine, l'alignement des modèles et le fine-tuning supervisé.
GitHub Copilot : Fine-tuné sur des dépôts de code. En juillet 2025, 20 millions de développeurs utilisent GitHub Copilot, soit une augmentation de 400 % d'une année sur l'autre, et 90 % des entreprises du Fortune 100 l'utilisent. Il complète automatiquement le code, génère des fonctions et suggère des corrections de bugs.13
BloombergGPT : 50 milliards de paramètres LLM entraîné sur un dataset de 363 milliards de tokens de documents financiers Bloomberg, surpassant les modèles de taille comparable sur les benchmarks NLP financiers, notamment l'analyse de sentiment, la reconnaissance d'entités nommées et la réponse à des questions.14
Google Med-PaLM 2 : Fine-tuné sur des datasets médicaux, a atteint une précision de 85 %+ sur des questions de type Examen d'autorisation médicale des États-Unis (USMLE), le premier LLM à atteindre des performances de niveau expert sur ce benchmark. Il alimente MedLM, la famille de modèles de base de santé de Google Cloud.15
ChatLAW : Un modèle de langage open source spécialement entraîné sur des datasets du domaine juridique chinois.16
8- IA éthique et atténuation des biais
- Anthropic et OpenAI ont mené une évaluation mutuelle de l'alignement à la mi-2025, en testant les modèles publics de l'autre pour la flatterie, les tendances à lancer des alertes éthiques et les comportements d'auto-préservation. L'exercice a révélé de la flatterie dans tous les modèles testés, y compris des cas où les modèles validaient des décisions nuisibles émanant d'utilisateurs simulés présentant des croyances délirantes. Anthropic a ensuite développé le framework de test Bloom spécifiquement pour benchmarker ce comportement dans les nouveaux modèles.
- Anthropic a également publié Claude Mythos Preview (Project Glasswing), un modèle sur invitation mis à la disposition d'un petit nombre d'organisations spécifiquement pour trouver et corriger des vulnérabilités de cybersécurité dans les principaux systèmes d'exploitation et navigateurs web. Anthropic a déclaré qu'il ne prévoyait pas de rendre ce modèle disponible. L'approche à accès contrôlé représente un nouveau framework pour déployer des modèles spécialisés très performants lorsque le profil de risque exige un déploiement restreint. La page de tarification Anthropic API liste également Claude Mythos 5.1 parmi ses modèles supplémentaires, à $10 en entrée / $50 en sortie par million de tokens.
- Google DeepMind : A publié « The Ethics of Advanced IA Assistants », offrant le premier traitement systématique des questions éthiques et sociétales soulevées par les agents d'IA, couvrant l'alignement des valeurs, les risques de manipulation, l'anthropomorphisme, la vie privée et l'équité. L'évaluation de l'IA responsable de l'entreprise comprenait plus de 350 exercices contradictoires de red team et a introduit un nouveau niveau de capacité critique spécifiquement pour la manipulation nuisible, le traitant comme un risque de niveau frontière aux côtés des cyberattaques et des menaces CBRN.
Limites des grands modèles de langage (LLMs)
1- Hallucinations
Les modèles génèrent des informations plausibles mais incorrectes.
Le classement des hallucinations Vectara est le benchmark de résumé ancré le plus largement référencé de l'industrie. Sur le dataset Vectara d'origine, les modèles Google Gemini occupent régulièrement les premières positions, les variantes Gemini Flash atteignant des taux d'hallucination inférieurs à 1 %. La famille GPT d'OpenAI se situe entre 0,8 % et 2,0 %.
Vectara a lancé un benchmark nettement plus difficile fin 2025 : 7 700 articles (contre 1 000), des documents plus longs jusqu'à 32K tokens, et un contenu couvrant le droit, la médecine, la finance et la technologie. Les résultats sur le nouveau dataset révèlent un schéma contre-intuitif : les modèles de raisonnement et de réflexion qui excellent dans les tâches complexes hallucinent souvent davantage en résumé ancré que les modèles plus petits et plus rapides. La plupart des modèles de classe réflexion affichent des taux d'hallucination supérieurs à 10 % sur le dataset plus difficile, tandis que des modèles plus légers comme les variantes Gemini Flash maintiennent des taux plus faibles.17
Remarque : Aucun benchmark unique ne donne un « taux d'hallucination » définitif pour un modèle. Une évaluation responsable croise au moins deux benchmarks mesurant des choses différentes : une tâche ancrée (Vectara), une tâche de connaissance ouverte, et précise la version exacte du modèle et les conditions d'appel.
Tous les modèles hallucinent. La fréquence a considérablement diminué, passant d'environ 21 % en 2021 à moins de 5 % pour les meilleurs sur les benchmarks standard, mais elle n'est pas éliminée. Les applications critiques nécessitent toujours une vérification humaine.
2- Biais
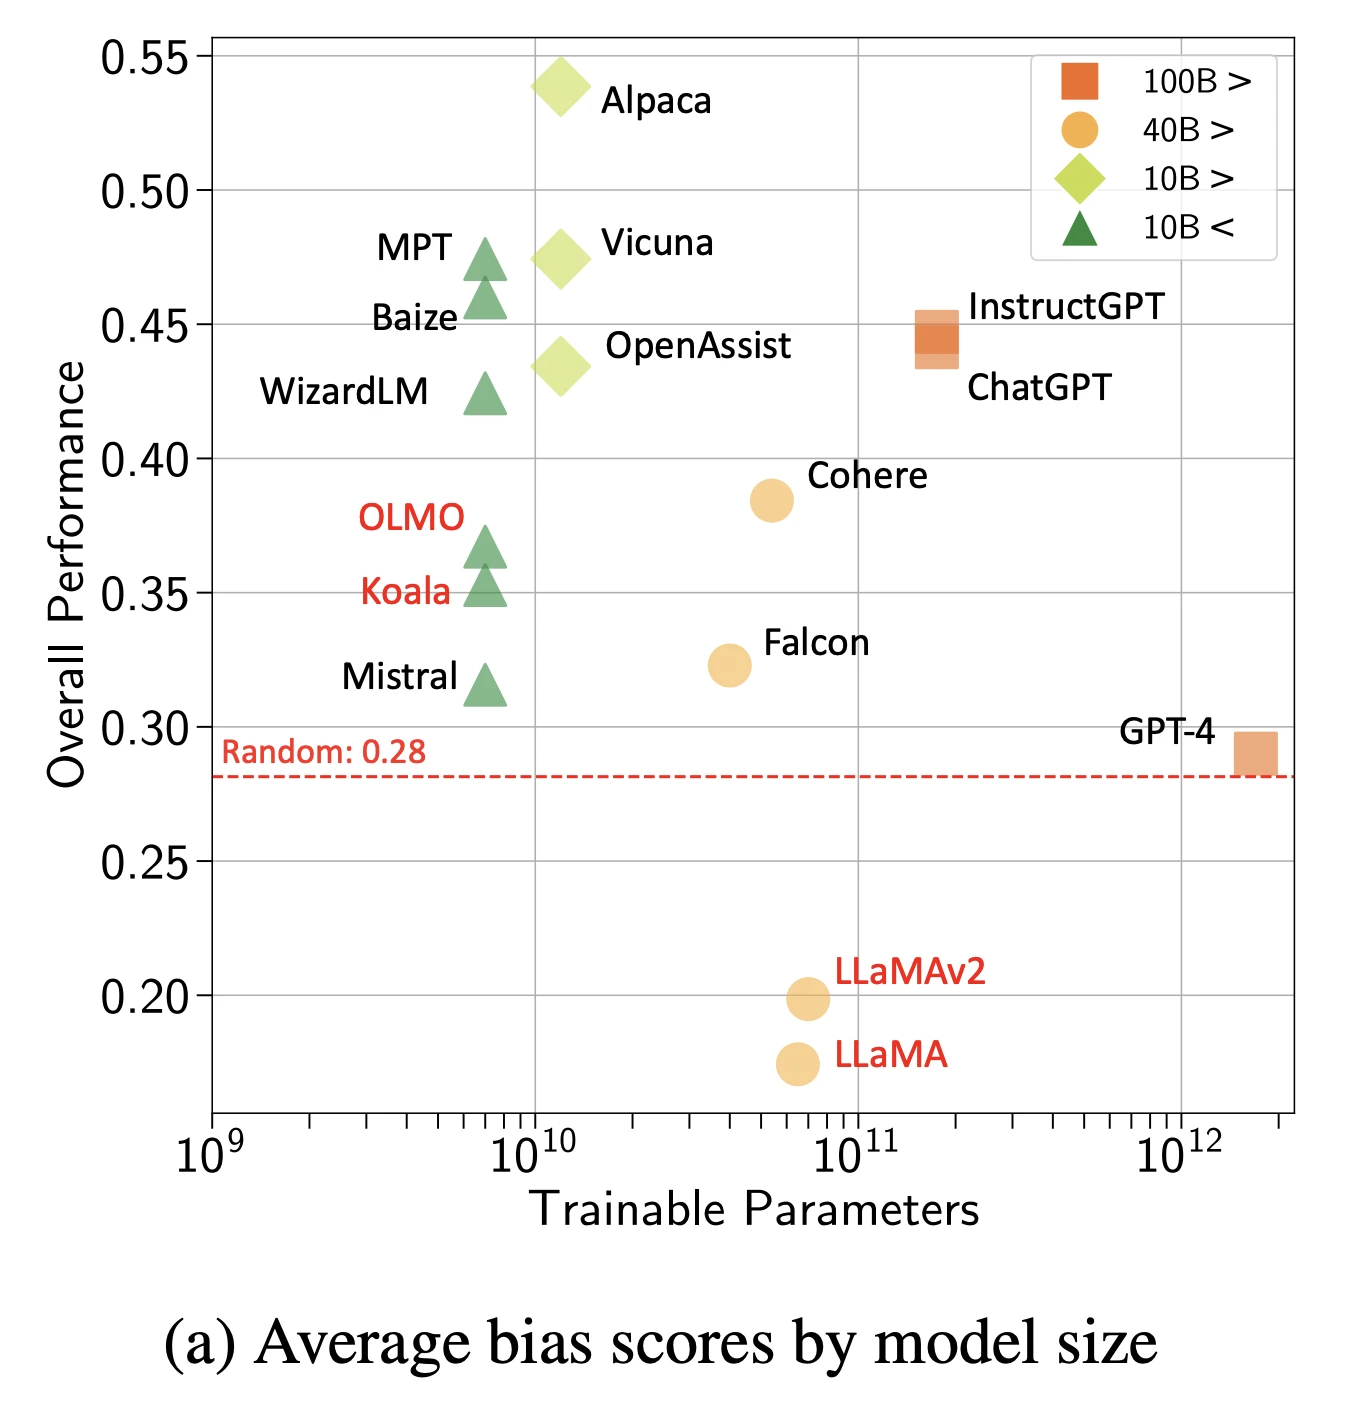
Les modèles absorbent et amplifient les biais sociaux issus des données d'entraînement.
Source : Scores globaux de biais par modèles et taille.18
Types de biais observés :
- Biais de genre dans les suggestions de profession
- Biais racial dans les simulations de tri de CV
- Biais d'âge dans les recommandations de santé
- Biais socio-économique dans le contenu éducatif
3- Toxicité
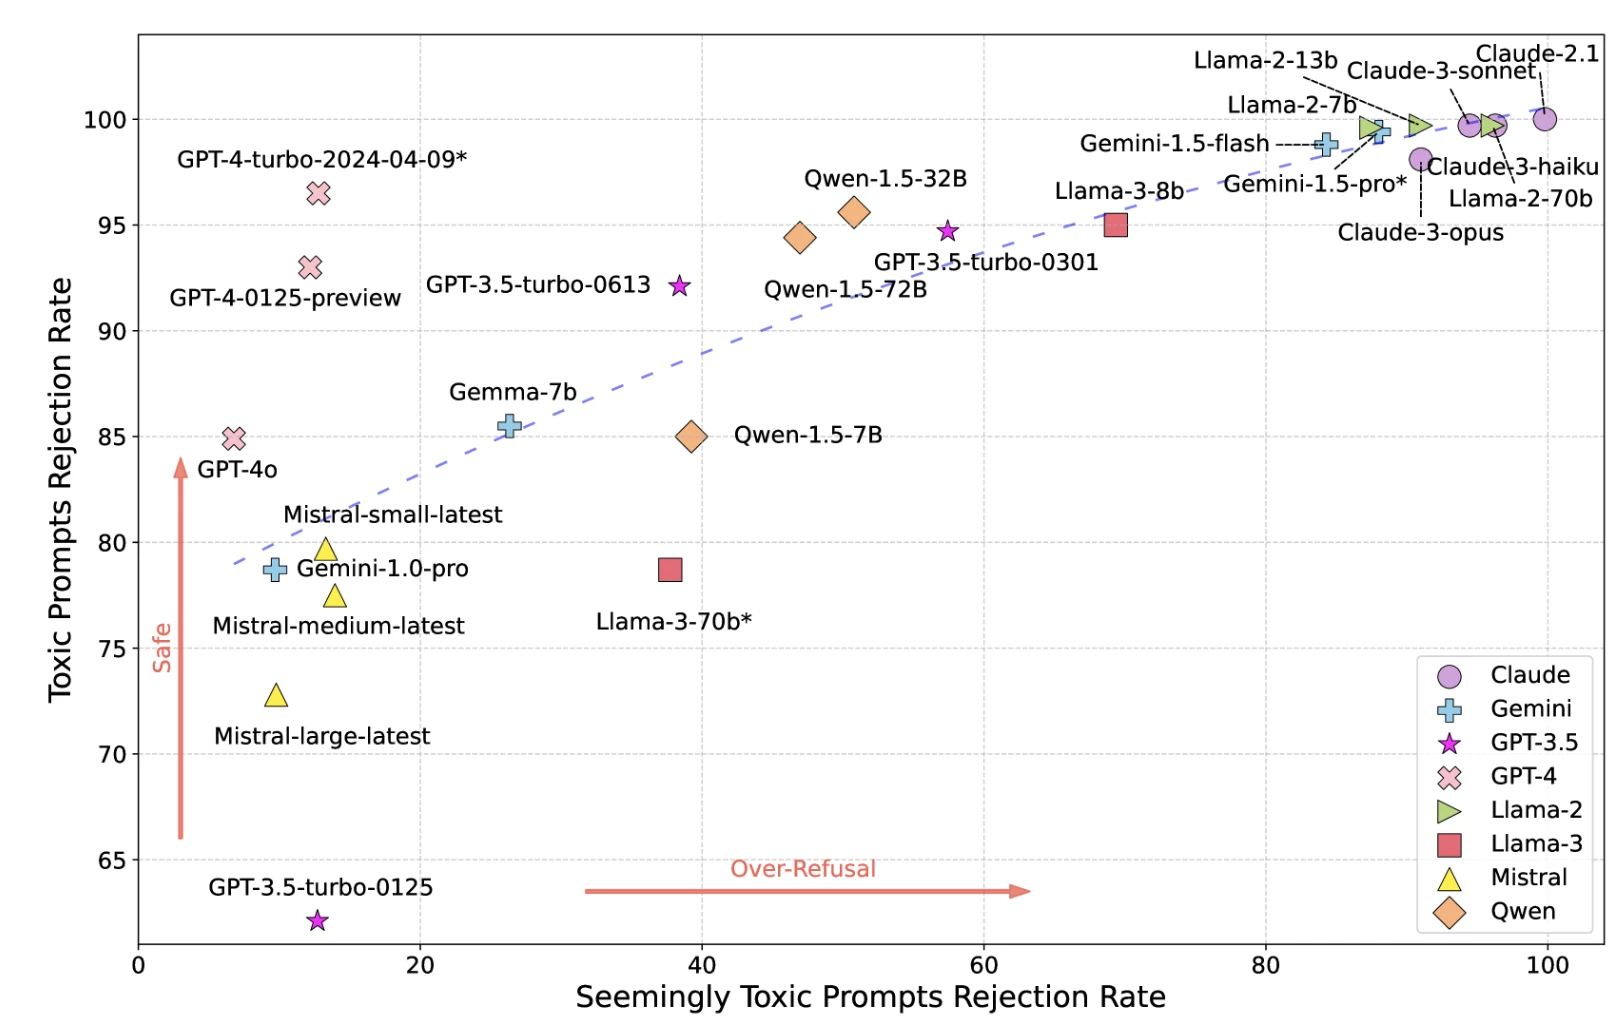
Les modèles peuvent générer du contenu nuisible, offensant ou toxique malgré les mesures de sécurité.
Source : Carte de toxicité des LLMs par des chercheurs de l'UCLA et de UC Berkeley19
*GPT-4-turbo-2024-04-09*, Llama-3-70b* et Gemini-1.5-pro* sont utilisés comme modérateur, les résultats pourraient être biaisés sur ces 3 modèles.
Des mesures de sécurité strictes réduisent la toxicité mais augmentent les faux positifs (refus de requêtes inoffensives). Des mesures laxistes laissent passer la toxicité.
4- Fenêtre de contexte : limites
Chaque modèle a une capacité de mémoire fixe, le nombre de tokens qu'il peut traiter en une seule session. Au-delà de cette limite, le modèle tronque le contenu précédent ou refuse la requête. L'écart pratique entre les modèles est suffisamment large pour avoir de l'importance pour les charges de travail réelles.
- Llama 4 Scout (Meta) : 10M tokens, la plus grande fenêtre de contexte parmi les principales sorties à poids ouverts. Meta a depuis orienté ses travaux de pointe vers la gamme Muse, si bien que Scout n'est plus mis à jour.
- Claude Opus 5.5, Sonnet 5.5, Haiku 5.5, Fable 5.1 : fenêtre de contexte de 1M tokens et sortie maximale de 128K pour les quatre. Claude 4.6 et les modèles ultérieurs (à l'exception de Haiku 5.5) facturent la fenêtre complète de 1M aux tarifs standard.
- GPT-6.1 Sol : fenêtre de contexte de 1 050 000 tokens. OpenAI facture des tarifs plus élevés pour les requêtes à contexte long sur ses modèles phares.20
- Gemini 4 Argon : Google a relevé la limite de tokens de sortie à 1M tokens, contre 64K auparavant.21
- DeepSeek V4.1 Flash et V4-Pro : contexte de 1M, jusqu'à 384K en sortie.22
Une grande fenêtre de contexte ne signifie pas automatiquement de meilleures performances sur toute sa longueur. Le rappel se dégrade vers le milieu des contextes longs sur la plupart des modèles, et les coûts augmentent avec la longueur d'entrée : traiter 1M tokens coûte nettement plus cher que traiter 10K tokens sur le même modèle. Pour la plupart des charges de production, la question pratique n'est pas de savoir quel modèle a la plus grande fenêtre, mais quel modèle récupère de manière fiable aux longueurs de contexte que votre cas d'usage exige réellement.
5- Date de connaissances statique
Les modèles s'appuient sur des connaissances pré-entraînées avec une date de coupure spécifique. Ils n'ont pas accès aux informations postérieures à l'entraînement, sauf s'ils sont connectés à des sources externes.
Problèmes :
- Informations obsolètes sur l'actualité
- Incapacité à gérer les évolutions récentes
- Moins de pertinence dans les domaines dynamiques (technologie, finance, médecine)
Solution : Intégration de la recherche web. ChatGPT, Claude et Perplexity proposent tous une recherche en temps réel. Mais la recherche n'élimine pas les hallucinations ; les modèles interprètent parfois mal les résultats de recherche.
Principales plateformes de LLM
GPT-6
GPT-6 Astra est devenu disponible pour le grand public le 4 septembre 2026 ; GPT-6 Sol et GPT-6 Luna ont suivi le 22 septembre 2026.
Ses plus grandes améliorations concernent la programmation, l'utilisation de l'ordinateur, le raisonnement scientifique et la cybersécurité, avec des gains particulièrement importants sur les benchmarks difficiles de résolution de problèmes. Il suit également les instructions de manière plus fiable et fait moins d'erreurs.
GPT-6.1 Sol est disponible pour les utilisateurs Plus, Pro, Business, Enterprise et Edu via ChatGPT Work et Codex, mais pas encore dans les conversations ChatGPT classiques ; les développeurs y accèdent sous le nom gpt-6.1-sol.
Tarification API (standard, par million de tokens) : gpt-6-astra $10 en entrée / $50 en sortie ; gpt-6.1-sol $2 / $10 ; gpt-6-luna $0,10 / $0.50.
Limites : Astra partage le prix de base le plus élevé de cette liste avec Claude Fable 5.1, à $10/$50 par million de tokens. OpenAI indique qu'Astra atteint le seuil critique de cybersécurité dans le cadre de son Preparedness Framework, et la version de lancement refuse les tâches cyber avancées telles que l'écriture d'exploits de preuve de concept. Il hallucine toujours et nécessite toujours une recherche web pour tout ce qui suit sa date de coupure d'entraînement.12
Claude Fable 5.1 / Opus 5.5 / Sonnet 5.5 / Haiku 5.5
Anthropic positionne Fable 5.1 pour le raisonnement exigeant et les tâches agentiques de longue haleine, Opus 5.5 pour le codage agentique de longue durée et le travail de connaissance, Sonnet 5.5 comme l'équilibre vitesse-intelligence, et Haiku 5.5 pour les tâches à volume élevé et sensibles à la latence comme la classification et le routage.
Tarification par million de tokens : Fable 5.1 $10/$50, Opus 5.5 $4/$20, Sonnet 5.5 $2/$10, Haiku 5.5 à partir de $0,10/$0.50.
Limites : Claude 4.7 et les modèles ultérieurs utilisent un tokenizer plus récent qui produit environ 30 % de tokens en plus pour le même texte, ce qui augmente le coût effectif par rapport aux prix catalogue.
Gemini 3.8 Flash / Gemini 4 Argon
Google a présenté Gemini 3.8 Flash, un modèle plus rapide et moins coûteux axé sur le codage complexe, les flux de travail autonomes et le raisonnement, aux côtés de Flash Cyber, un modèle spécialisé en cybersécurité.
Flash obtient 54,9 % sur HLE-Verified et coûte $0,75 par million de tokens d'entrée et $3,75 par million de tokens de sortie jusqu'à fin 2026, bien que les tâches complexes puissent consommer davantage de tokens.
Flash Cyber atteint plus de 70 % de réussite sur le benchmark interne de découverte de vulnérabilités de Google et 47,2 % sur un benchmark externe de correctifs, avec un accès restreint aux défenseurs de confiance.
Tarification : $0,75 par million de tokens d'entrée et $3,75 par million de sortie tokens.23
Google a conçu Gemini 4 Argon pour les tâches complexes et de longue durée en ingénierie logicielle, finance, droit et cybersécurité. Il prend en charge jusqu'à 1 million de tokens de sortie, obtient 77,9 % sur DeepSWE et 51,3 % sur AutomationBench, et peut découvrir et corriger de manière autonome des vulnérabilités de sécurité. Google indique l'utiliser en interne pour des migrations de code à grande échelle et des optimisations de centres de données.
Tarification à partir de $2 par million de tokens d'entrée et $10 par million de tokens de sortie, doublant après la période de lancement. L'accès est actuellement restreint aux testeurs de confiance et aux défenseurs de la cybersécurité.21
Meta Muse Spark 1.3 / Muse Glimmer
Meta concentre Muse Spark 1.3 sur l'amélioration des agents d'IA pour les flux de travail longs et complexes et les tâches de codage. Par rapport à la version 1.2, les tests d'ingénierie internes de Meta montrent 20 % d'appels d'outils en moins et 25 % de tokens en moins pour les tâches de codage. Meta signale également une meilleure résistance aux injections de prompts et un meilleur discernement concernant les actions irréversibles.
Le modèle est disponible via Muse Code et, la Meta Model API, avec des poids ouverts prévus pour une future version.24
Poids ouverts : Muse Glimmer est un modèle ouvert de 30B paramètres, sous licence Apache 2.0, qui fonctionne sur un seul GPU et est optimisé pour l'utilisation d'outils, les tâches longues et la récupération après échec.
Qui l'utilise : Muse Spark convient aux équipes déjà dans l'écosystème de Meta qui souhaitent un accès API. Muse Glimmer convient aux déploiements sur site et locaux, et aux développeurs qui évitent la dépendance à un fournisseur.
Limites : Les poids de Muse Spark sont fermés. Les modèles Llama 4 restent téléchargeables mais ne constituent plus la gamme de pointe de Meta.
DeepSeek V4
V4-Pro est un modèle Mixture-of-Experts avec 1.6T paramètres au total et 49B activés, avec un contexte d'un million de tokens.
Le 10 septembre 2026, DeepSeek a publié V4.1-Flash, le plus petit modèle de sa famille d'architectures, avec une compréhension visuelle multimodale native. V4.1 Flash prend en charge la vision, mais pas V4-Pro.25
Tarification API (par million de tokens, heures pleines) : V4.1 Flash coûte $0,30 en entrée (cache miss) et $1,20 en sortie ; V4-Pro coûte $1,32 en entrée et $3,96 en sortie. Les tarifs hors heures pleines sont la moitié des tarifs de pointe.22
Citer cette recherche
Choisissez le format qui correspond à votre lieu de publication. Coller la version avec lien dans votre CMS préserve le lien retour.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Ermut, Sıla},
  title  = {{L'avenir des grands modèles de langage}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/future-of-large-language-models}},
  note   = {AIMultiple. Consulté le 25 juin 2026}
}
Journal des modifications
12 mises à jourSupprimé le graphique de référence des hallucinations pour les LLM populaires.
Ajout d'une section méthodologie de benchmark détaillant les modèles testés et la notation.
Remplacement de GPT-5.2, Gemini 3.1 Pro et DeepSeek V3.2 par GPT-5.5, Gemini 2.5 Pro, DeepSeek V4 et Claude Opus 4.7.
Mis à jour les données des 'Exemples concrets' dans la section 'Domain-Specific Fine-Tuned Models'.
Mise à jour de la section "Tendances futures des grands modèles linguistiques" avec de nouveaux exemples de vérification des faits en temps réel.
Liens de référence
Le travail de Cem chez AIMultiple a été cité par des publications mondiales de premier plan, notamment Business Insider, Forbes, Morning Brew et Washington Post, par des entreprises mondiales comme Deloitte et HPE, par des ONG comme World Economic Forum et par des organisations supranationales comme European Commission. [1], [2], [3], [4], [5]
Tout au long de sa carrière, Cem a été consultant en technologies, acheteur de technologies et entrepreneur technologique. Il a conseillé des entreprises sur leurs décisions technologiques chez McKinsey & Company et Altman Solon pendant plus de dix ans. Il a également publié un rapport McKinsey sur la digitalisation.
Il a dirigé la stratégie technologique et les achats d'un opérateur télécom, sous la responsabilité du PDG. Il a également dirigé la croissance commerciale de l'entreprise de technologie profonde Hypatos, qui a atteint un revenu récurrent annuel à 7 chiffres et une valorisation à 9 chiffres, passant de 0 à ce résultat en deux ans. Le travail de Cem chez Hypatos a été couvert par des publications technologiques de premier plan comme TechCrunch et Business Insider.
Cem intervient régulièrement lors de conférences technologiques internationales. Il est diplômé de Bogazici University en tant qu'ingénieur informatique et titulaire d'un MBA de la Columbia Business School.

Elle a précédemment travaillé comme recruteuse dans des cabinets de gestion de projet et de conseil. Sıla est titulaire d’un master en psychologie sociale et d’une licence en relations internationales.




Commentaires 1
Partagez vos idées
Votre adresse courriel ne sera pas publiée. Tous les champs sont obligatoires. Les commentaires sont laissés dans leur langue d'origine.
Insightful read! The future of large language models looks incredibly promising. It’s exciting to see how they’ll keep transforming the way we work and communicate. Loved the detailed explanation in the article.