


Grands models multimodaux (LMM) vs LLMs

Évaluez les LLMs et les LMM en comparant leurs scores de benchmark et leur latence en conditions réelles en cliquant sur le nom du model dans le tableau ci-dessous. Vous pouvez également peser leur tarification d’entrée et de sortie pour juger de l’efficacité et de la valeur globales.
Grands models multimodaux à poids ouverts
*L’audio est natif sur les models E2B, E4B et 12B uniquement.
Gemma 4 (Google DeepMind)
Disponible en cinq tailles : E2B, E4B, 12B, 26B A4B et 31B. La famille traite le texte et les images avec des rapports d’aspect et des résolutions variables sur tous les models. Elle prend également en charge la vidéo et l’audio, l’audio étant natif sur les models E2B, E4B et 12B.1
La variante 12B est la plus remarquable sur le plan architectural. Google a remplacé l’encodeur de vision par un module d’embedding léger et a entièrement supprimé l’encodeur audio, projetant le signal audio brut dans le même espace dimensionnel que les tokens de texte. Sans encodeurs multimodaux dans le pipeline, la latence diminue et le model devient suffisamment petit pour fonctionner sur un GPU d’ordinateur portable avec 16GB de mémoire.
Kimi K3 (Moonshot IA)
Un model de 2.8T paramètres construit sur Kimi Delta Attention et Attention Residuals, avec des capacités de vision natives et une fenêtre de contexte de 1 million de tokens. Moonshot le décrit comme le premier model ouvert de la classe des 3 billions de paramètres.
Son encodeur de vision, MoonViT-V2, a été entraîné de bout en bout via l’objectif de prédiction du token suivant du model, et n’a pas été initialisé à partir d’un model de vision pré-entraîné de manière contrastive tel que SigLIP.2
MiniMax M3
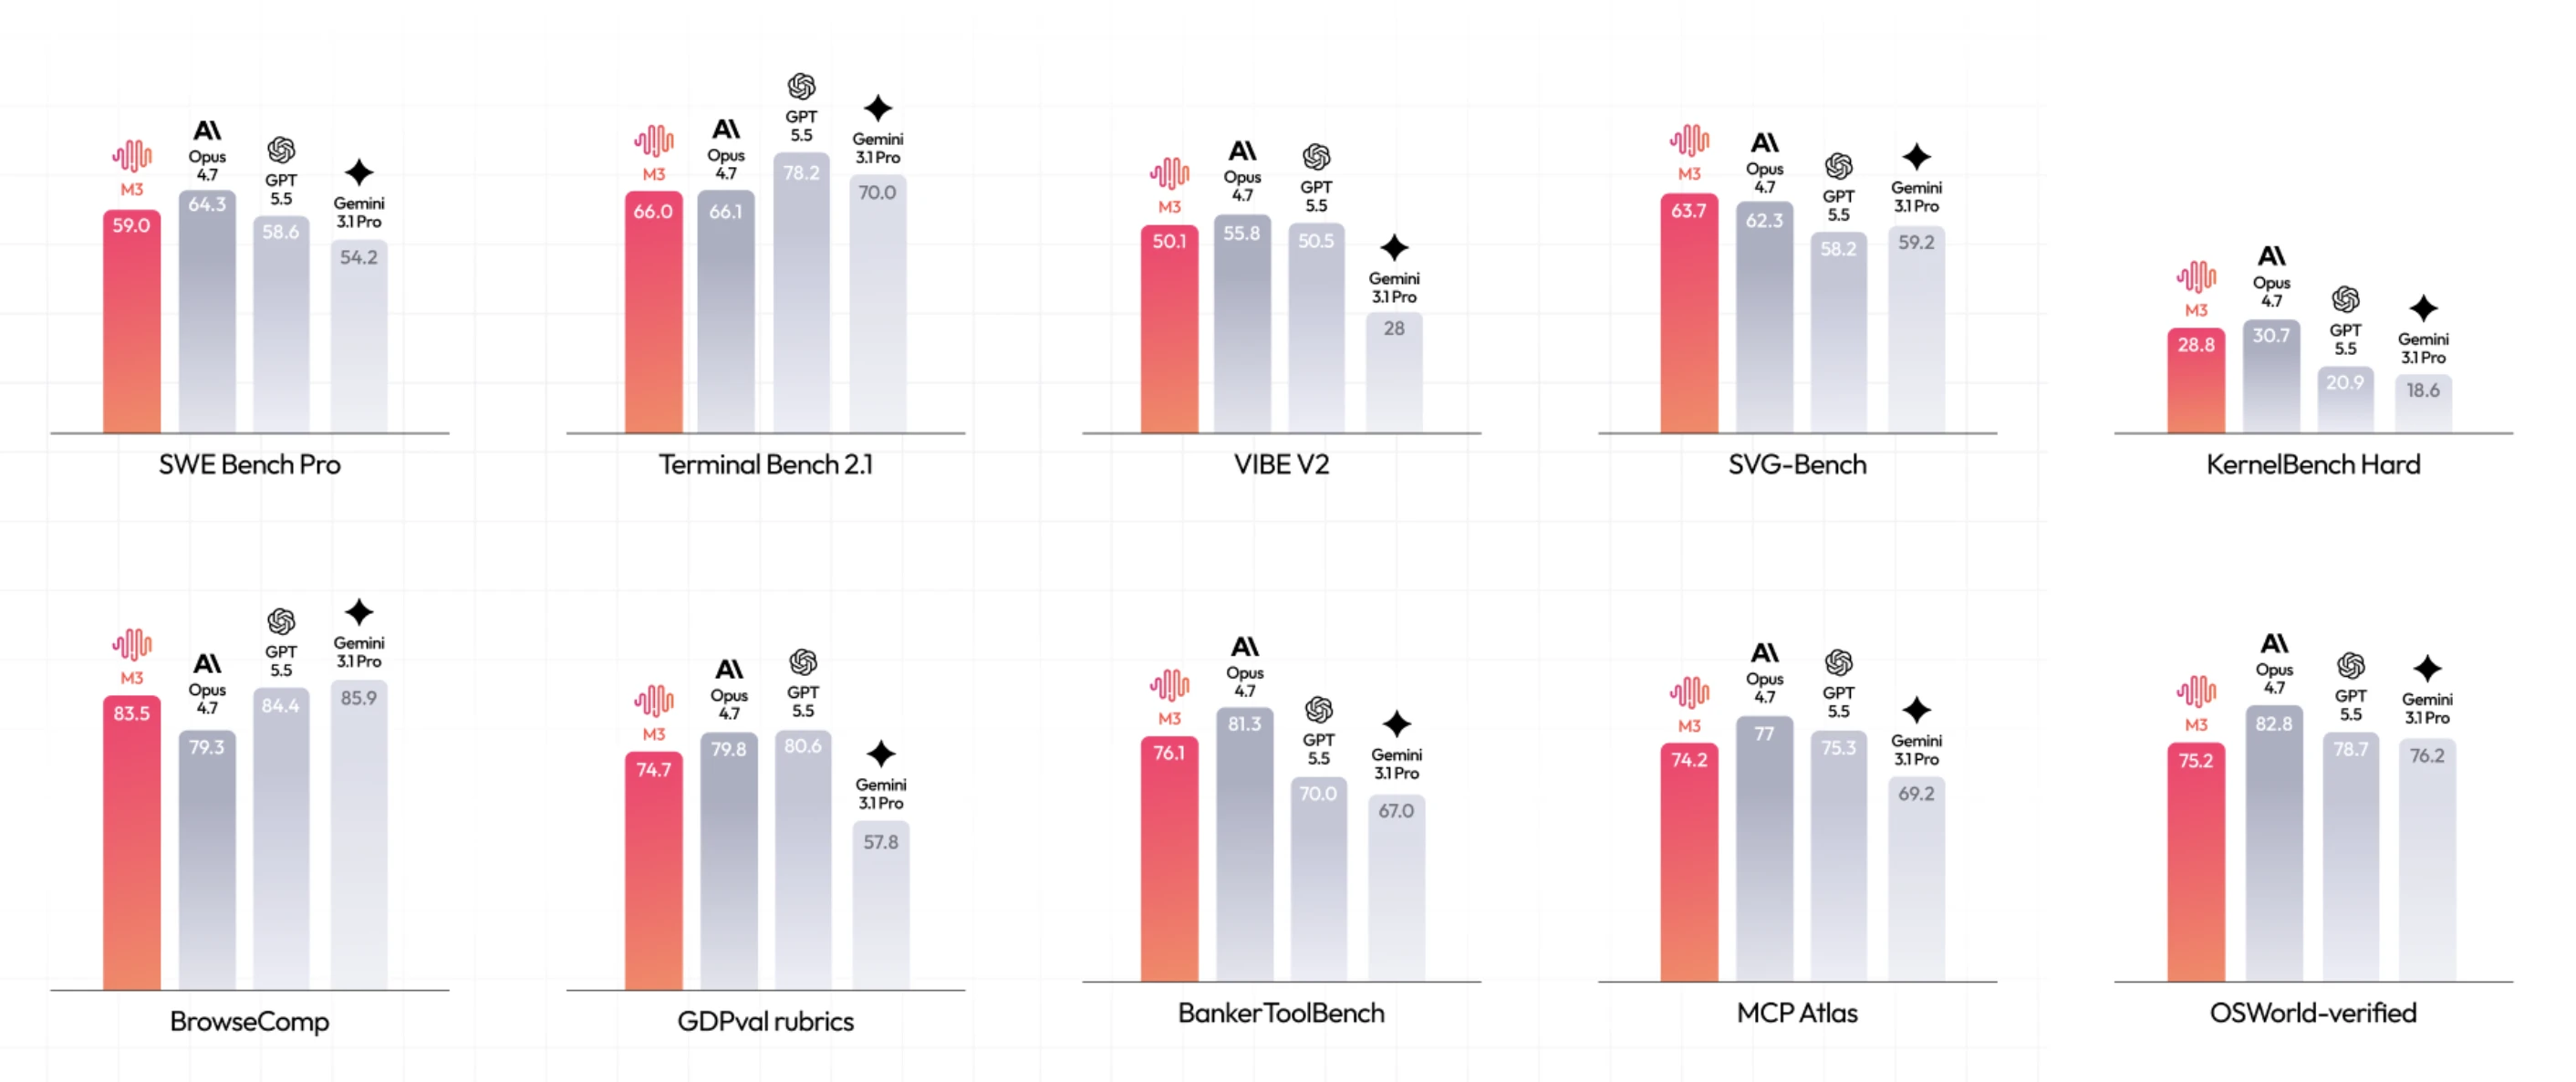
Un model multimodal natif avec environ 428B paramètres et 23B activés, entraîné sur des modalités mixtes (texte, image et vidéo). MiniMax le présente comme le premier model à poids ouverts à combiner des performances de codage de pointe, une fenêtre de contexte de 1M tokens et une multimodalité native dans un seul système. Il peut également piloter un ordinateur de bureau à partir de captures d’écran.
Figure 1 : Résultats de benchmark de Minimax M3.3
GLM-5.3-Flash (Z.ai)
Le premier model multimodal natif de la série GLM-5, avec 320B paramètres au total et 18B activés, et le premier model open source de pointe à combiner l’attention sparse et linéaire.
Z.ai rapporte que la conception hybride réduit le calcul d’attention et le cache KV de 3.01x et 4.44x par rapport à GLM-5.3.4
DeepSeek-V4.1-Flash
DeepSeek-V4.1-Flash est le plus petit model de la famille d’architecture de DeepSeek et le premier de la gamme à prendre en charge la compréhension visuelle native.
Il utilise une conception Mixture of Experts de 552 milliards de paramètres avec une architecture Encoder-Decoder causale, mobilisant huit milliards de paramètres actifs pour l’entrée et 16 milliards pour la sortie. Il a remplacé à la fois V4 Flash et le V4 Flash Vision Expérimental, dont les noms de model pointent désormais vers le nouvel endpoint pour des raisons de compatibilité.5
Grands models multimodaux propriétaires
GPT-6 Astra (OpenAI)
OpenAI positionne Astra comme l’état de l’art en matière d’utilisation d’un ordinateur, de navigation, d’ingénierie logicielle, de cybersécurité, de science et de travail professionnel, avec un score de 98 % sur FrontierMath Tier 4 et de 99,9 % sur ARC-AGI-3.6
C’est le premier model de l’entreprise à atteindre le niveau Critical de capacité en cybersécurité dans le cadre de son Preparedness Framework, et la version accessible au public refuse par conséquent les travaux cyber avancés. Le model accepte du texte et des images et renvoie du texte.
Gemini Omni (Google DeepMind)
Gemini Omni est la famille de models génératifs nativement multimodaux de Google, et sa première version est Gemini Omni Flash.
Google le décrit comme un model capable de créer n’importe quoi à partir de n’importe quelle entrée, en commençant par la vidéo : les utilisateurs fournissent n’importe quelle combinaison d’images, d’audio, de vidéo et de texte, et reçoivent une vidéo fondée sur les connaissances du monde réel de Gemini, qu’ils peuvent ensuite réviser par la conversation plutôt qu’en régénérant à partir de zéro.7
Qwen3.8-Omni-Flash (Alibaba)
Qwen3.8-Omni-Flash accepte le texte, l’image, l’audio et la vidéo dans un contexte unique de 1M tokens, prend en charge jusqu’à une heure d’audio et de vidéo en continu par appel, et renvoie du texte.
À partir d’une vidéo et d’une question, il identifie ce qui mérite une investigation plus poussée, recherche des sources multimodales sur le web et produit un rapport de recherche illustré. Les utilisateurs ne peuvent y accéder que via l’API hébergée, sans poids ouverts au lancement.
Claude Opus 5 (Anthropic)
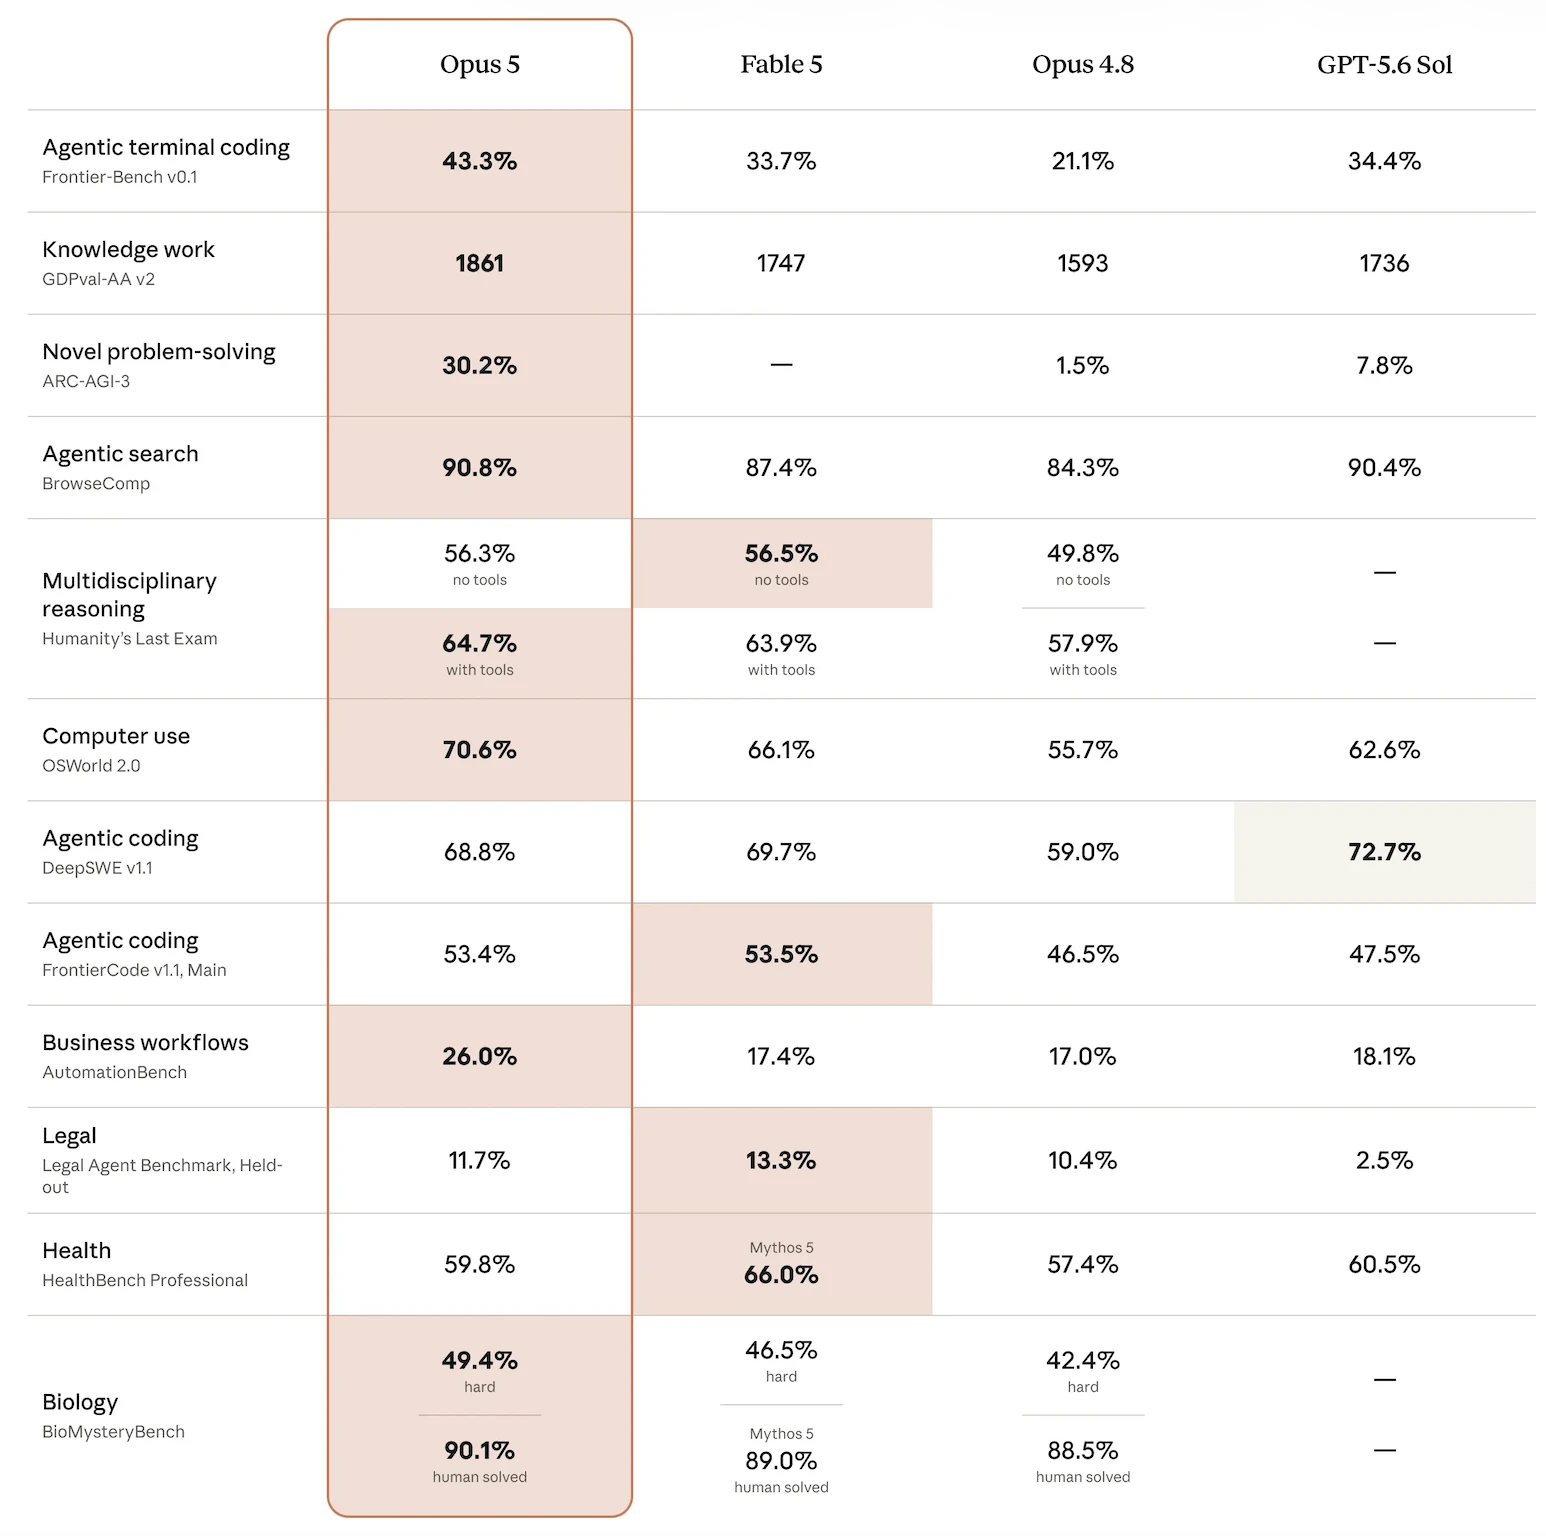
Le model Opus 5 d’Anthropic est positionné comme approchant l’intelligence de pointe de Claude Fable 5 à la moitié du coût. Sur les évaluations de codage et de travail de connaissances, notamment Frontier-Bench et GDPval-AA, Anthropic le présente comme l’état de l’art, tout en notant qu’il est devancé par Mythos 5 sur les tâches de cybersécurité.
La tarification est de 5 $ par million de tokens d’entrée et de 25 $ par million de tokens de sortie, comme pour Opus 4.8, avec un mode Fast fonctionnant à environ deux fois et demie la vitesse par défaut pour le double du tarif de base.
Figure 2 : Résultats de benchmark de Claude Opus 5.8
Grok 4.6 (xAI)
Construit sur Grok 4.5, il se concentre sur les agents de longue durée et sur des travaux interactifs et visuels plus ambitieux, en maintenant une tâche sur de nombreuses étapes, qu’il s’agisse de rechercher un sujet, de travailler sur une base de code ou de transformer une idée en application finie.
Sur les évaluations publiées de xAI, Grok 4.6 atteint 69,9 % sur CursorBench v3.2, devant GPT-5.6 Sol Max à 67,2 % et juste derrière Fable 5 Max à 70,5 %, et affiche le score le plus élevé des quatre models comparés sur Harvey LAB à 15,8 %. La tarification démarre à 2 $ par million de tokens d’entrée et 6 $ par million de tokens de sortie, avec une variante rapide à deux fois ce tarif.9
Muse Spark (Meta)
Muse Spark est le premier model de la famille Muse de Meta Superintelligence Labs. Meta le décrit comme un model de raisonnement nativement multimodal qui prend en charge l’utilisation d’outils, la chaîne de pensée visuelle et l’orchestration multi-agents.
Le model intègre des informations visuelles dans différents domaines et outils et obtient de bons résultats sur les questions STEM visuelles, la reconnaissance d’entités et la localisation. Les cas d’usage incluent la création de petits jeux ou le dépannage d’un appareil électroménager avec des annotations dessinées sur ce que voit la caméra.
Pour la santé, Meta a travaillé avec plus d’un millier de médecins pour organiser les données d’entraînement, et le model produit des affichages interactifs expliquant des informations telles que le contenu nutritionnel des aliments ou les muscles sollicités pendant un exercice donné.
Amazon Nova 2 Omni
Amazon Nova 2 Omni traite des entrées de texte, d’images, de vidéo et de parole tout en générant à la fois du texte et des images, prenant en charge jusqu’à 750 000 mots, des heures d’audio, de longues vidéos et des documents de cent pages en un seul passage.
Depuis fin juillet, le model est en accès anticipé pour les clients de Nova Forge.10
Quelles sont les différences entre les LMM et les LLMs ?
Comment fonctionnent les LMM ?
Les grands models multimodaux partagent des similitudes avec les grands models de langage en matière d’entraînement, de conception et de fonctionnement. Ils utilisent la même architecture transformer et les mêmes stratégies d’entraînement. Les grands models multimodaux sont entraînés sur :
- Données textuelles
- Des millions ou des milliards d’images avec des descriptions textuelles
- Des clips vidéo
- Des extraits audio
- D’autres données d’entrée, comme du code
Cet entraînement implique l’apprentissage simultané de plusieurs modalités de données, permettant au model de :
- Reconnaître une photo de chat
- Identifier un mot dans un extrait audio
- Comprendre des concepts et des détails sensoriels au-delà du texte
Ainsi, les utilisateurs peuvent téléverser :
- Une image pour :
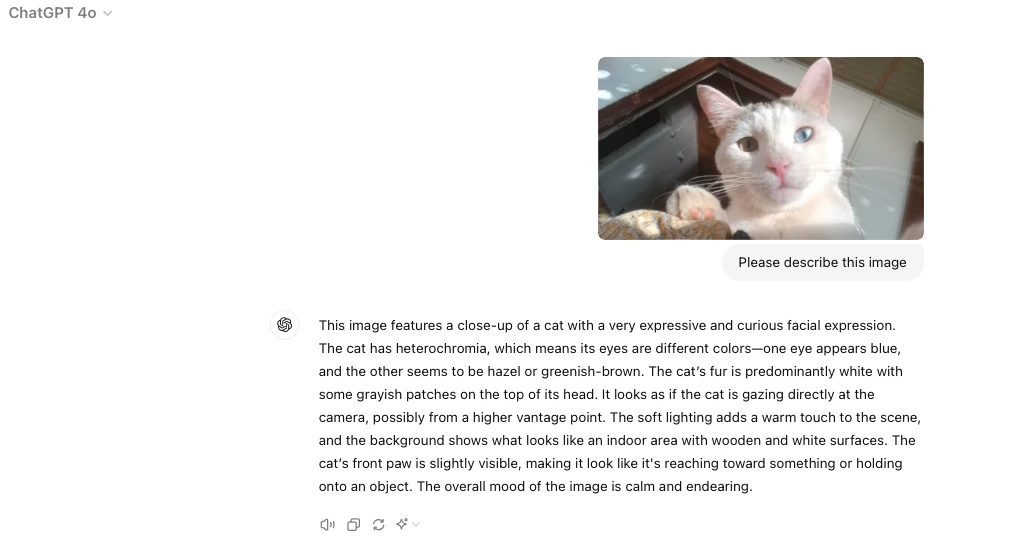
- Obtenir une description de ce qui se passe
- Utiliser l’image comme partie d’un prompt pour générer du texte ou des images
- Poser des questions de suivi sur des éléments spécifiques de l’image
- Traduire le texte de l’image dans une autre langue (par exemple, Menu)
Figure 3 : Téléversement d’une image de chat sur ChatGPT pour la décrire.
- Des graphiques et des diagrammes pour :
- Poser des questions de suivi complexes sur ce qu’ils montrent
- Une maquette de conception pour :
- Obtenir le code HTML et CSS nécessaire pour la créer.
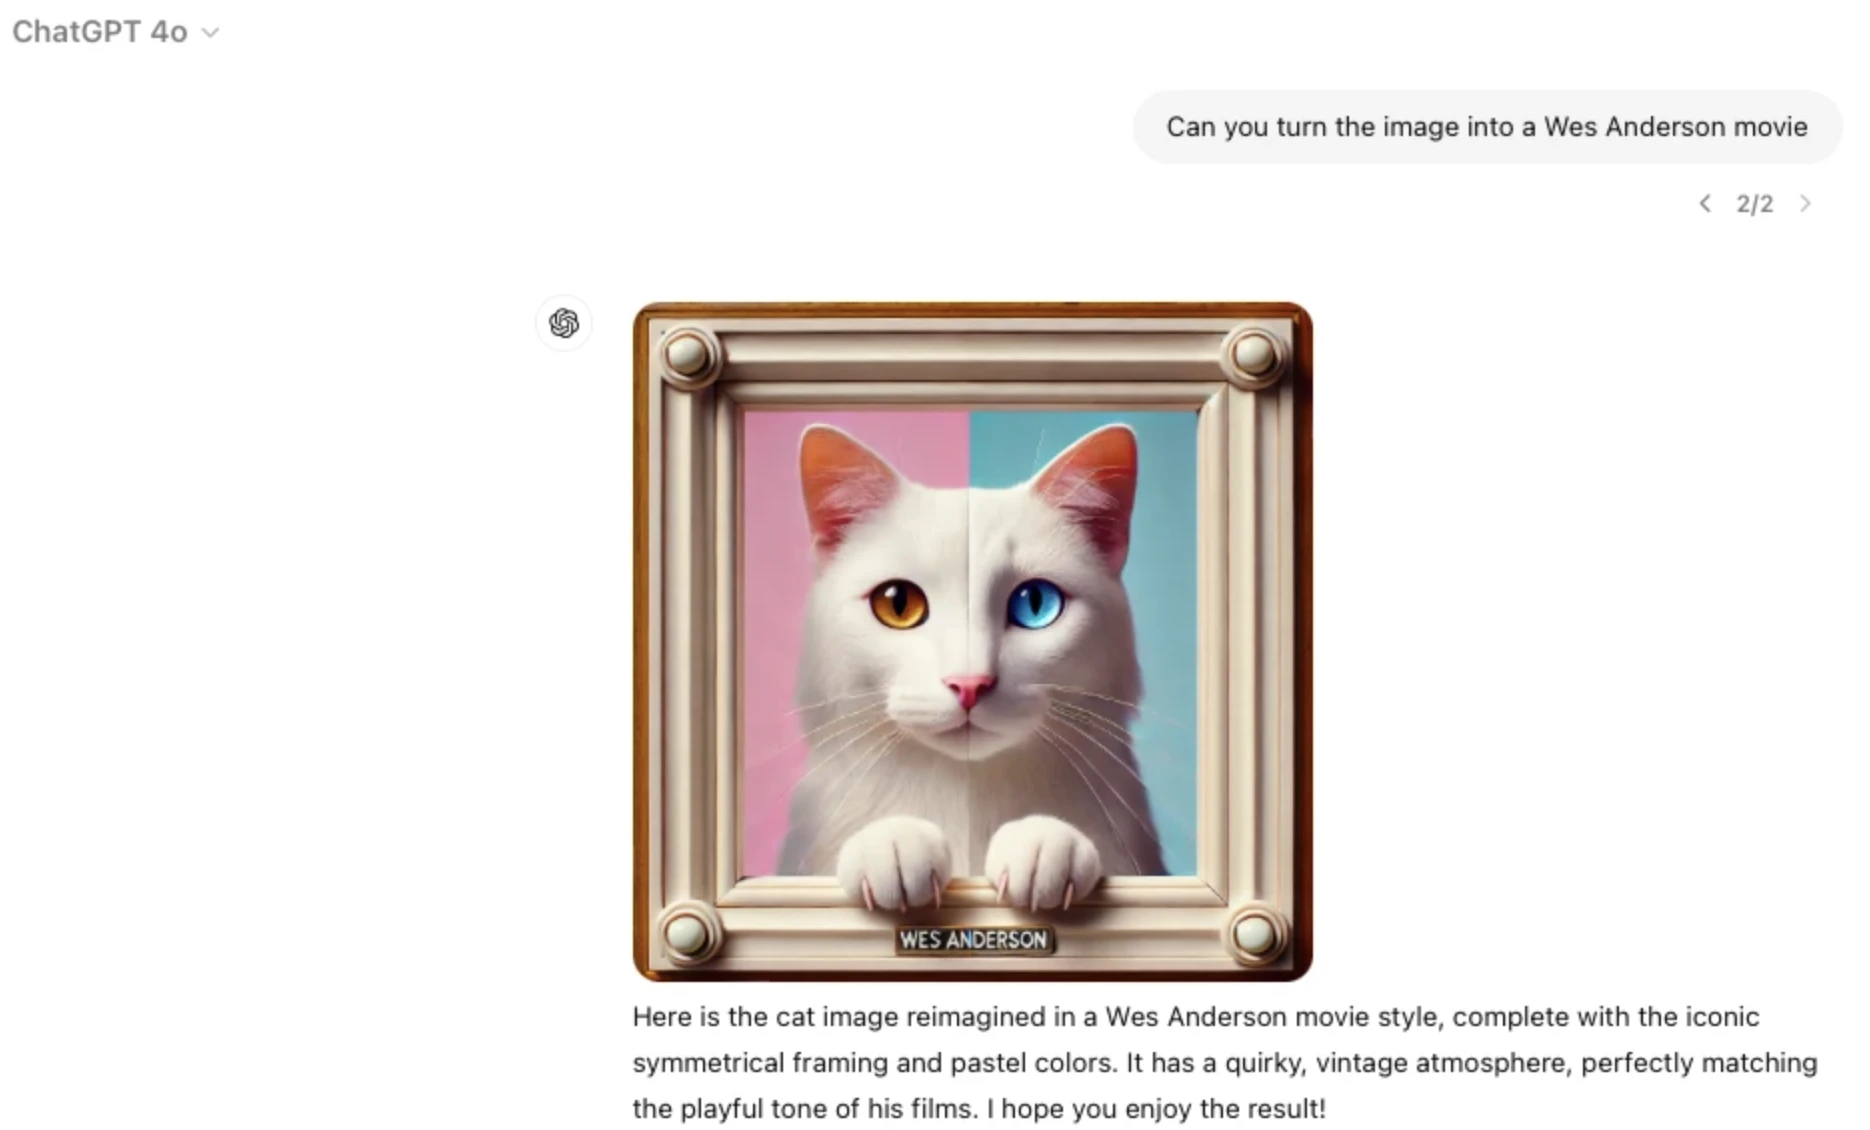
Figure 4 : Création d’un prompt d’image dans le style du film Wes Anderson. ChatGPT transmet le prompt à un model de génération d’images (comme DALL·E), qui interprète la demande et produit l’image stylisée.
Après l’entraînement, les models peuvent intégrer des stéréotypes malsains et des idées toxiques. Pour les affiner, des techniques telles que :
- Apprentissage par renforcement avec rétroaction humaine (RLHF)
- Models d’IA supervisés
- Red teaming (tester la robustesse du model) peut être utilisé.
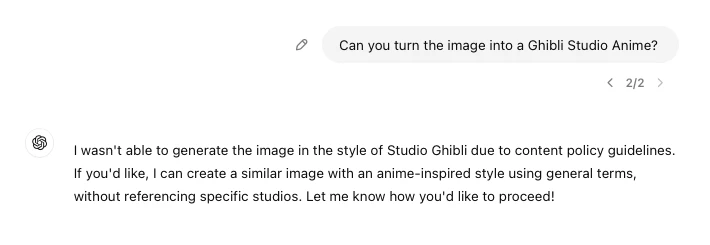
Figure 5 : ChatGPT rejette ma demande en raison des règles de la politique de contenu visant à protéger les droits d’auteur.
L’objectif est de développer un système multimodal fonctionnel capable de prendre en charge :
- Synthèse texte-image
- Sous-titrage d’images
- Récupération d’images à partir de texte
- Réponse à des questions visuelles.
 Ajouter comme source préférée
Citer cette recherche
Choisissez le format qui correspond à votre lieu de publication. Coller la version avec lien dans votre CMS préserve le lien retour.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Ermut, Sıla},
  title  = {{Grands models multimodaux (LMM) vs LLMs}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/large-multimodal-models}},
  note   = {AIMultiple. Consulté le 21 septembre 2026}
}Résultats et horodatages de 50 points de données. Téléchargez les données de synthèse présentées dans les graphiques et les tableaux de cet article sous forme de fichier ZIP contenant 4 fichiers CSV.
Vous voulez les données détaillées derrière ? Rejoindre Premium
Journal des modifications
22 mises à jourRemplacement de l'entrée du modèle Qwen3-VL par Qwen2.5-VL dans la section produits.
Ajout d'une section Gemini 3 et remplacement des entrées Qwen2.5-VL par des descriptions du modèle Qwen3-VL.
Ajout des modèles fondamentaux multimodaux "Video-first", de la version "Mistral 3 multimodal frontier" et des modèles de vision-langage MoE open source à la section sur les avancées récentes des modèles multimodaux.
Liens de référence
Le travail de Cem chez AIMultiple a été cité par des publications mondiales de premier plan, notamment Business Insider, Forbes, Morning Brew et Washington Post, par des entreprises mondiales comme Deloitte et HPE, par des ONG comme World Economic Forum et par des organisations supranationales comme European Commission. [1], [2], [3], [4], [5]
Tout au long de sa carrière, Cem a été consultant en technologies, acheteur de technologies et entrepreneur technologique. Il a conseillé des entreprises sur leurs décisions technologiques chez McKinsey & Company et Altman Solon pendant plus de dix ans. Il a également publié un rapport McKinsey sur la digitalisation.
Il a dirigé la stratégie technologique et les achats d'un opérateur télécom, sous la responsabilité du PDG. Il a également dirigé la croissance commerciale de l'entreprise de technologie profonde Hypatos, qui a atteint un revenu récurrent annuel à 7 chiffres et une valorisation à 9 chiffres, passant de 0 à ce résultat en deux ans. Le travail de Cem chez Hypatos a été couvert par des publications technologiques de premier plan comme TechCrunch et Business Insider.
Cem intervient régulièrement lors de conférences technologiques internationales. Il est diplômé de Bogazici University en tant qu'ingénieur informatique et titulaire d'un MBA de la Columbia Business School.

Elle a précédemment travaillé comme recruteuse dans des cabinets de gestion de projet et de conseil. Sıla est titulaire d’un master en psychologie sociale et d’une licence en relations internationales.




Soyez le premier à commenter
Votre adresse courriel ne sera pas publiée. Tous les champs sont obligatoires. Les commentaires sont laissés dans leur langue d'origine.