


Qualité des données d'IA: défis et bonnes pratiques

Une mauvaise qualité des données retarde le déploiement réussi des projets d’IA et de ML. 1 Même les algorithmes d’IA les plus avancés peuvent produire des résultats erronés si les données sous-jacentes sont de mauvaise qualité.
Découvrez l’importance de la qualité des données dans l’IA, les défis rencontrés par les organisations et les bonnes pratiques pour garantir des données de haute qualité :
Quelle est l’importance de la qualité des données dans l’IA ?
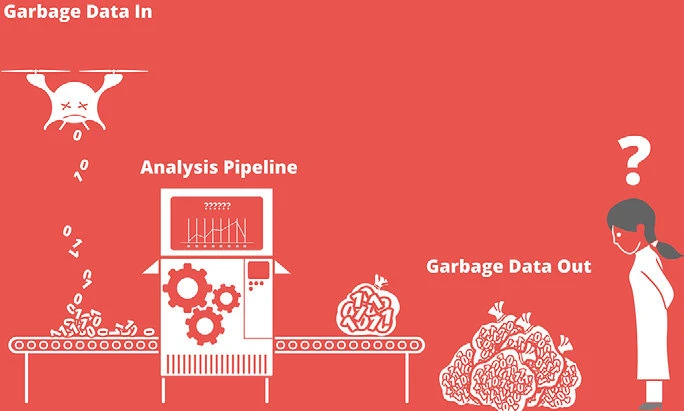
La qualité des données est essentielle pour l’intelligence artificielle, car elle influence directement les performances, l’exactitude et la fiabilité des models d’IA. Des données de haute qualité permettent aux models de faire de meilleures prédictions et de produire des résultats plus fiables. L’impact d’une mauvaise qualité des données dans l’IA est illustré dans la figure 1.
Figure 1 : Impact d’une mauvaise qualité des données et des analyses
Source : SnapLogic2
La prise en compte des biais dans les données est cruciale pour garantir la qualité des données. Cela évite la perpétuation et l’amplification des biais dans les résultats générés par l’IA, contribuant ainsi à minimiser le traitement injuste de groupes ou d’individus spécifiques.
En outre, un dataset diversifié et représentatif améliore la capacité d’un model d’IA à bien généraliser à travers différentes situations et entrées, garantissant ses performances et sa pertinence dans divers contextes et groupes d’utilisateurs.
Comme le déclare Andrew Ng, professeur d’IA à l’université Stanford et fondateur de DeepLearning.IA : « Si 80 % de notre travail consiste à préparer les données, alors garantir la qualité des données est la tâche la plus critique pour une équipe de machine learning. »
Pourquoi est-il crucial d’éviter le problème « garbage in, garbage out » pour la qualité des données ?
« Garbage in, garbage out » (GIGO) est un principe simple mais efficace qui souligne l’importance de la qualité des entrées pour la qualité des données. Cela signifie que si les données d’entrée d’un système, comme un model ou un algorithme d’IA, sont de mauvaise qualité, inexactes ou non pertinentes, la sortie du système sera également de mauvaise qualité, inexacte ou non pertinente.
Figure 2 : Qualité des données et normes : données « garbage in », résultats « garbage out ».
Source : Shakoor et al. 3
Ce concept est particulièrement important dans le contexte de l’IA, car les models d’IA, y compris les models de machine learning et de deep learning, dépendent fortement des données utilisées pour l’entraînement et la validation. Le model d’IA produira probablement des résultats peu fiables ou biaisés si les données d’entraînement sont biaisées, incomplètes ou contiennent des erreurs.
Pour éviter le problème GIGO, il est crucial de garantir que les données utilisées dans les systèmes d’IA sont exactes, représentatives et de haute qualité. Cela implique souvent le nettoyage des données, le prétraitement et l’augmentation, ainsi que l’utilisation de métriques d’évaluation robustes pour évaluer les performances des models d’IA.
Quels sont les éléments clés de données de qualité dans l’IA ?
Exactitude : Des données exactes sont cruciales pour les algorithmes d’IA, leur permettant de produire des résultats corrects et fiables. Les erreurs dans la saisie des données peuvent conduire à des décisions incorrectes ou à des idées erronées, nuisant potentiellement aux organisations et aux individus.
Cohérence : Garantit que les données suivent un format et une structure standard, facilitant un traitement et une analyse efficaces. Des données incohérentes peuvent entraîner de la confusion et des interprétations erronées, nuisant aux performances des systèmes d’IA.
Complétude : Des jeux de données incomplets peuvent amener les algorithmes d’IA à manquer des motifs et corrélations essentiels, conduisant à des résultats incomplets ou biaisés. Garantir la complétude des données est essentiel pour entraîner les models d’IA de manière précise et complète.
Actualité : La fraîcheur des données joue un rôle important dans les performances de l’IA. Des données obsolètes peuvent ne pas refléter l’environnement ou les tendances actuels, conduisant à des résultats non pertinents ou trompeurs.
Pertinence : Des données pertinentes contribuent directement au problème traité, aidant les systèmes d’IA à se concentrer sur les variables et relations les plus importantes. Des données non pertinentes peuvent encombrer les models et entraîner des inefficacités.
Quels sont les défis pour garantir la qualité des données dans l’IA ?
1-Collecte des données
À mesure que les développements de l’IA profitent à des secteurs tels que la finance, la santé, l’industrie manufacturière et le divertissement, les organisations sont confrontées au défi de la collecte de données à partir de diverses sources tout en maintenant la qualité. Nombre d’entre elles se tournent vers les scrapers web pour automatiser et garantir que tous les points de données respectent les mêmes normes.
2-Étiquetage des données
Les algorithmes d’IA s’appuient sur des données étiquetées pour l’entraînement, mais l’étiquetage manuel est à la fois chronophage et sujet aux erreurs. Obtenir des étiquettes exactes qui reflètent les conditions du monde réel est souvent difficile.
3-Stockage et sécurité des données
Garantir la qualité des données implique de les protéger contre les accès non autorisés et la corruption potentielle. Il est essentiel pour les organisations de disposer d’un stockage de données sécurisé et fiable, mais cela peut être difficile.
4-Gouvernance des données
Les organisations ont souvent du mal à mettre en œuvre des cadres de gouvernance des données qui traitent efficacement les problèmes de qualité des données. Un manque de gouvernance des données adéquate peut conduire à des données cloisonnées, à des incohérences et à des erreurs.
5- Empoisonnement des données
L’empoisonnement des données est une attaque ciblée contre les systèmes d’IA dans laquelle les attaquants introduisent des informations malveillantes ou trompeuses dans le dataset. Ces données empoisonnées peuvent fausser l’entraînement du model, conduisant à des résultats peu fiables, voire nuisibles. Pour atténuer ce risque, il est crucial de maintenir l’intégrité des données grâce à des audits réguliers et à la détection d’anomalies.
6-Boucles de rétroaction des données synthétiques
Réintroduire des données générées par l’IA dans les models d’IA peut créer des boucles de rétroaction qui dégradent la qualité des models. Par exemple, lorsque des données synthétiques sont utilisées de manière répétée, le model peut apprendre des motifs trop artificiels qui s’écartent des conditions du monde réel. Cela peut amener les models à obtenir de mauvaises performances sur les données réelles, amplifiant potentiellement les biais ou les erreurs. Équilibrer les données synthétiques et réelles est essentiel pour maintenir la robustesse des models.
Études de cas réelles
Étude de cas 1 : Mayo Clinic – Gestion des données avant l’IA
Mayo Clinic, avec environ 76 000 employés répartis sur trois campus, considère la préparation des données comme la première étape de tout projet d’IA.4
Le défi : La responsabilité des données est répartie entre de nombreuses unités cliniques et commerciales. Ajai Sehgal, directeur des données et de l’analytique, déclare que lorsque personne n’est responsable de la gestion des données, les problèmes de données s’ensuivent, et l’IA dans le domaine de la santé ne peut pas se permettre des résultats de mauvaise qualité.
La solution : Mayo a fait des équipes cliniques et commerciales qui connaissent le mieux les données ses gestionnaires, chargés de préparer leurs données pour l’analyse. Une équipe centrale tient à jour une bibliothèque de données qui relie chaque élément de données à ses métadonnées et aux règles cliniques associées. La pratique chirurgicale de Mayo, par exemple, commence son travail d’IA en préparant ses données et a proposé une équipe données et analytique autofinancée.
Étude de cas 2 : JPMorgan Chase – Détection de la fraude sur des données internes vérifiées
JPMorgan Chase utilise des large language models pour détecter la fraude, comme la compromission d’e-mails professionnels.5
Le défi : Ryan Schmiedl, qui dirige la détection de la fraude, le filtrage des sanctions et les contrôles de connaissance client de la banque, a averti en 2023 que les models entraînés sur des données issues de tout Internet, comme l’est ChatGPT, peuvent présenter des affirmations non vérifiées comme des faits.
La solution : La banque entraîne ses LLMs uniquement sur des données issues de son propre écosystème et s’assure d’abord que ces données ont été auditées et validées. Elle utilise également l’IA pour extract les noms d’entreprises et de personnes à partir de données non structurées et les vérifier quant au risque de fraude.
Étude de cas 3 : Walmart – Nettoyage des données du catalogue produits avec des LLMs
Walmart a utilisé l’IA générative pour améliorer les données du catalogue produits derrière ses pages de recherche et de produits.6
Le défi : Maintenir des données de catalogue complètes et exactes à l’échelle de Walmart demande beaucoup de main-d’œuvre. Le PDG Doug McMillon a déclaré que sans l’IA générative, le travail aurait nécessité « près de 100 fois l’effectif actuel ».
La solution : Walmart a utilisé plusieurs large language models pour créer ou améliorer plus de 850 millions d’éléments de données de catalogue, a déclaré McMillon lors de la conférence téléphonique sur les résultats du 15 août 2024. John Furner, PDG de Walmart U.S., a déclaré que les données améliorées aident l’entreprise à faire correspondre le catalogue à ce que recherchent les clients.
Bonnes pratiques pour garantir la qualité des données dans l’IA
1-Mettre en œuvre des politiques de gouvernance des données
Un cadre de gouvernance des données doit définir des normes, des processus et des rôles en matière de qualité des données. Cela contribuera à créer une culture de la qualité des données et à garantir que les pratiques de gestion des données s’alignent sur les objectifs organisationnels.
Exemple concret : Airbnb
Airbnb a lancé « Data University » pour améliorer la maîtrise des données dans l’ensemble de son personnel en proposant des cours personnalisés qui intègrent les données et outils spécifiques d’Airbnb. Depuis sa création au troisième trimestre 2016, Data University a accru l’engagement avec les outils internes de science des données d’Airbnb, faisant passer les utilisateurs actifs hebdomadaires de 30 % à 45 %.
Avec plus de 500 employés participants, l’initiative souligne l’importance d’aligner les efforts de gouvernance des données sur les objectifs organisationnels, en promouvant une culture de la qualité des données et de la prise de décision éclairée à l’échelle de l’entreprise. Le programme illustre comment des cadres de gouvernance des données personnalisés peuvent renforcer les compétences en matière de données et favoriser l’alignement sur les objectifs commerciaux.
2-Utiliser des outils de qualité des données
Les outils de qualité des données peuvent automatiser les processus de nettoyage, de validation et de surveillance des données, garantissant aux models d’IA un accès cohérent à des données de haute qualité.
Exemple concret : General Electric
General Electric (GE) offre un exemple concret pertinent de l’utilisation d’outils de qualité des données avec la mise en œuvre de sa stratégie de gouvernance des données et de gestion de la qualité, en particulier au sein de sa plateforme Predix pour l’analyse de données industrielles. Pour soutenir sa transformation numérique et ses initiatives d’IA, GE a investi dans un ensemble robuste d’outils de qualité des données afin de maintenir des normes de données élevées dans l’ensemble de son écosystème IoT industriel.
GE a déployé des outils automatisés de nettoyage, de validation et de surveillance continue des données pour gérer les volumes massifs de données générés par ses équipements industriels, tels que les turbines et les moteurs à réaction. Ces outils ont aidé GE à garantir que les données alimentant ses models d’IA étaient exactes, cohérentes et fiables, réduisant ainsi le besoin d’intervention manuelle et permettant des informations en temps réel fondées sur les données.
Exemples de solutions de qualité des données
Pandada IA, lancée début 2026, est une plateforme pilotée par l’IA pour le nettoyage et l’analyse automatisés des données. Elle peut ingérer des fichiers de données (CSV, feuilles de calcul Excel, PDF et même des images) et générer des rapports et présentations d’analyse structurés et partageables.7 La plateforme comprend des fonctionnalités intelligentes de nettoyage des données (suppression des doublons, normalisation des formats, détection des valeurs manquantes) qui corrigent automatiquement les problèmes de données, réduisant ainsi le travail manuel de préparation des données.8
Sieve est une plateforme de nettoyage des données issue d’une startup de la promotion Spring 2025 de Y Combinator, qui combine un traitement piloté par l’IA avec une révision humaine facultative.9 Elle fournit une API et un complément Excel pour le nettoyage automatisé des données, en envoyant automatiquement les problèmes signalés à des opérateurs humains pour validation.9
3-Constituer une équipe de qualité des données
Constituer une équipe dédiée responsable de la qualité des données garantira une surveillance et une amélioration continues des processus liés aux données. L’équipe peut également former et sensibiliser les autres employés à l’importance de la qualité des données.
4-Collaborer avec les fournisseurs de données
Établir des relations solides avec les fournisseurs de données et garantir leur engagement en faveur de la qualité des données peut minimiser le risque de recevoir des données de mauvaise qualité.
5-Surveiller en continu les indicateurs de qualité des données
Mesurer et surveiller régulièrement les indicateurs de qualité des données peut aider les organisations à identifier et à traiter les problèmes potentiels avant qu’ils n’aient un impact sur les performances de l’IA.
 Ajouter comme source préférée
Qu’est-ce que les données d’IA ?
Les données d’IA désignent de manière générale toute donnée utilisée dans le développement ou le fonctionnement de systèmes d’intelligence artificielle. Par conséquent, cela inclut, sans s’y limiter, les datasets utilisés pour entraîner les models, les données d’entrée en temps réel utilisées pour les prédictions et les données synthétiques générées pour enrichir des exemples du monde réel, entre autres. Bien qu’il ne s’agisse pas d’un terme technique formel, « IA data » est couramment utilisé pour décrire les informations qui alimentent les systèmes de machine learning et de deep learning.
FAQ
Selon une étude de Gartner, une mauvaise qualité des données coûte aux organisations en moyenne 12.9 millions de dollars par an. Cependant, le coût réel va au-delà de l’impact financier direct. Une mauvaise qualité des données conduit à des échecs de projets d’IA ; des rapports sectoriels suggèrent que jusqu’à 85 % des projets d’IA et de ML ne tiennent pas leur promesse initiale, souvent en raison de problèmes de qualité des données. Les coûts supplémentaires incluent le temps perdu, car les data scientists passent 60-80 % de leur temps au nettoyage des données plutôt qu’au développement des models, la perte d’opportunités de revenus due à des prédictions inexactes et à de mauvaises expériences clients, et les risques de non-conformité, en particulier dans les secteurs réglementés où les défaillances de qualité des données peuvent entraîner des amendes importantes.
Des recherches issues de sources sectorielles indiquent que 70-85 % des échecs de projets d’IA sont dus à des problèmes liés aux données, la qualité des données étant le principal coupable. L’analyse des implémentations d’IA par VentureBeat a révélé que 87 % des projets de science des données n’atteignent jamais la production, une qualité de données inadéquate ou médiocre en étant la cause principale. Une enquête de Dimensional Research a révélé que 96 % des organisations rencontrent des problèmes de qualité des données lors de l’entraînement des models d’IA. Ces échecs se manifestent de plusieurs manières, notamment des models qui obtiennent de bons résultats en phase de test mais échouent en production en raison de la dérive des données, des résultats biaisés dus à des données d’entraînement non représentatives et l’incapacité à passer à l’échelle parce que les pipelines de données ne peuvent pas maintenir la qualité aux volumes de production.
Bien que étroitement liées, la qualité des données et la gouvernance des données ont des objectifs différents. La qualité des données fait référence aux caractéristiques des données elles-mêmes, en se concentrant sur le fait que les données sont exactes, complètes, cohérentes, actualisées et pertinentes. Elle concerne l’état et l’utilisabilité des données pour l’usage auquel elles sont destinées. La qualité des données est généralement mesurée à l’aide d’indicateurs tels que les taux d’erreur, les pourcentages de complétude et le nombre de doublons.
La gouvernance des données, quant à elle, est le cadre de politiques, de procédures, de rôles et de responsabilités qui garantit une gestion appropriée des données dans l’ensemble d’une organisation. La gouvernance définit qui possède les données, qui peut y accéder, comment elles doivent être utilisées, quelles normes elles doivent respecter et comment la qualité doit être maintenue.
Considérez la gouvernance des données comme la structure organisationnelle et le règlement, tandis que la qualité des données est le résultat que vous essayez d’atteindre. Une bonne gouvernance permet une bonne qualité, mais vous avez besoin des deux pour réussir dans les initiatives d’IA. La gouvernance fournit la structure durable qui garantit que la qualité des données n’est pas un nettoyage ponctuel, mais une pratique continue.
Citer cette recherche
Choisissez le format qui correspond à votre lieu de publication. Coller la version avec lien dans votre CMS préserve le lien retour.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Arslan, Ezgi},
  title  = {{Qualité des données d'IA: défis et bonnes pratiques}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/data-quality-ai}},
  note   = {AIMultiple. Consulté le 23 octobre 2026}
}
Journal des modifications
6 mises à jourPandada AI et Sieve ont été ajoutés à la section « Exemples de solutions de qualité des données ».
Ajout de la section FAQ.
Liens de référence
Le travail de Cem chez AIMultiple a été cité par des publications mondiales de premier plan, notamment Business Insider, Forbes, Morning Brew et Washington Post, par des entreprises mondiales comme Deloitte et HPE, par des ONG comme World Economic Forum et par des organisations supranationales comme European Commission. [1], [2], [3], [4], [5]
Tout au long de sa carrière, Cem a été consultant en technologies, acheteur de technologies et entrepreneur technologique. Il a conseillé des entreprises sur leurs décisions technologiques chez McKinsey & Company et Altman Solon pendant plus de dix ans. Il a également publié un rapport McKinsey sur la digitalisation.
Il a dirigé la stratégie technologique et les achats d'un opérateur télécom, sous la responsabilité du PDG. Il a également dirigé la croissance commerciale de l'entreprise de technologie profonde Hypatos, qui a atteint un revenu récurrent annuel à 7 chiffres et une valorisation à 9 chiffres, passant de 0 à ce résultat en deux ans. Le travail de Cem chez Hypatos a été couvert par des publications technologiques de premier plan comme TechCrunch et Business Insider.
Cem intervient régulièrement lors de conférences technologiques internationales. Il est diplômé de Bogazici University en tant qu'ingénieur informatique et titulaire d'un MBA de la Columbia Business School.





Soyez le premier à commenter
Votre adresse courriel ne sera pas publiée. Tous les champs sont obligatoires. Les commentaires sont laissés dans leur langue d'origine.