


Droit d'auteur et IA générative: droit et contentieux

Nous avons examiné des décisions de justice, des mesures réglementaires et des accords de licence pour répondre à trois questions clés sur l’IA générative et le droit d’auteur.
- Les données protégées par le droit d’auteur peuvent-elles être utilisées pour entraîner l’IA ? Il n’existe pas d’approche juridique uniforme. Aux États-Unis, les tribunaux appliquent l’usage loyal au cas par cas. Les tribunaux de district sont parvenus à des résultats différents selon la finalité de l’utilisation, la manière dont le matériel a été obtenu et son effet sur les marchés existants.
- Les œuvres générées par l’IA sont-elles éligibles à la protection du droit d’auteur ? La réponse dépend de la juridiction. Le droit d’auteur américain exige une paternité humaine. Certains autres pays ont des règles spécifiques pour les œuvres générées par ordinateur.
- Qui détient le droit d’auteur sur une œuvre générée par l’IA ? La titularité dépend de l’existence du droit d’auteur et de la personne que la loi reconnaît comme auteur. Aucun tribunal n’a reconnu un système d’IA lui-même comme auteur d’une œuvre protégée.
1. Les données protégées par le droit d’auteur peuvent-elles être utilisées comme données d’entraînement ?
États-Unis
Sony Music Publishing et Warner Chappell poursuivent Anthropic
En août 2026, Anthropic a fait face à un nouveau contentieux en matière de droit d’auteur intenté par de grands éditeurs de musique. Sony Music Publishing et Warner Chappell ont intenté une action en justice le 28 août, après une action engagée en août par Round Hill Music.1
Concord et UMG réclament plus de 3 milliards de dollars à Anthropic
En janvier 2026, BMG et un groupe mené par Concord Music Group et Universal Music Group ont également poursuivi Anthropic.2
La plainte menée par Concord/UMG allègue qu’Anthropic a obtenu illégalement plus de 20 000 chansons, paroles, compositions et partitions protégées par le droit d’auteur. Les plaignants réclament des dommages-intérêts légaux potentiels dépassant 3 milliards de dollars.
Bartz c. Anthropic sur l’usage loyal en matière d’entraînement de l’IA
Dans l’affaire Bartz c. Anthropic, le tribunal de district du nord de la Californie a jugé que l’utilisation de livres par Anthropic pour entraîner ses models constituait un usage loyal. Le tribunal a par ailleurs jugé que l’acquisition et la conservation de millions de livres piratés pour une bibliothèque centrale n’étaient pas protégées par l’usage loyal.
En juillet 2026, la juge Araceli Martínez-Olguín a accordé l’approbation finale de l’accord de 1.5 milliard de dollars dans l’affaire Bartz c. Anthropic et a rendu un jugement définitif. L’avocat du groupe a signalé des réclamations couvrant au moins 91,3 % des œuvres admissibles, tandis que 350 exclusions volontaires valides couvraient 1 802 œuvres. Le tribunal a rejeté la somme demandée de 187.5 millions de dollars au titre des honoraires d’avocat et a approuvé environ 101.56 millions de dollars.3
L’accord règle certaines réclamations portant sur des œuvres incluses dans le groupe visé par l’accord. Il n’autorise pas de futurs entraînements et ne règle pas les réclamations distinctes concernant les résultats des models ou d’autres œuvres protégées par le droit d’auteur.
Le troisième circuit réexamine l’usage loyal en matière d’entraînement de l’IA
En juin 2026, le troisième circuit a entendu les plaidoiries dans l’affaire Thomson Reuters c. Ross Intelligence. C’est la première procédure d’appel fédérale à examiner si l’utilisation de matériel protégé par le droit d’auteur pour développer un système d’IA constitue un usage loyal. La formation de jugement s’est concentrée sur le caractère transformateur et le préjudice commercial. En septembre 2026, aucune décision d’appel n’avait été rendue.4
La loi californienne AB 2013 exige la divulgation des données d’entraînement
La loi californienne AB 2013 est entrée en vigueur en janvier 2026. Les développeurs doivent publier des informations sur les datasets utilisés pour entraîner les systèmes d’IA générative. Les divulgations requises comprennent les sources des datasets, les types de données, l’inclusion éventuelle de matériel protégé par le droit d’auteur, le fait que les datasets aient été concédés sous licence ou achetés, et la présence éventuelle de données personnelles.5
Kadrey c. Meta concernant l’entraînement de l’IA
Dans l’affaire Kadrey c. Meta, un autre tribunal fédéral a rejeté les demandes des plaignants pour contrefaçon sur la base des preuves présentées, notamment parce qu’ils n’ont pas établi un préjudice commercial suffisant.6
Ces décisions n’établissent pas de règle générale selon laquelle tout entraînement d’IA constitue un usage loyal.
France
L’autorité française de la concurrence (Autorité de la concurrence) a infligé à Google une amende de 250 millions d’euros pour avoir utilisé des articles de presse sans autorisation pour entraîner Gemini. Il s’agissait d’une mesure de mise en œuvre réglementaire, et non d’une décision relative au droit d’auteur.7
Royaume-Uni
Le gouvernement britannique envisage de supprimer la protection des œuvres générées par ordinateur
En mars 2026, le gouvernement britannique a publié son rapport sur le droit d’auteur et l’intelligence artificielle.
Le rapport propose de supprimer la protection spéciale par le droit d’auteur des œuvres générées par ordinateur au titre de l’article 9(3) de la loi sur le droit d’auteur, les dessins et modèles et les brevets (Copyright, Designs and Patents Act). La disposition reste en vigueur tant que le Parlement ne modifie pas la loi.8
Getty c. Stability IA concernant l’allégation de contrefaçon liée aux poids du model
Dans l’affaire Getty Images c. Stability IA, la Haute Cour du Royaume-Uni a rejeté la demande de Getty pour contrefaçon secondaire du droit d’auteur concernant les poids du model Stable Diffusion. Le tribunal n’a pas considéré le model lui-même comme une copie contrefaisante pour cette demande.9
Union européenne
La CJUE et sa première affaire de droit d’auteur liée à l’IA générative
La Cour de justice de l’Union européenne examine l’affaire Like Company c. Google Ireland, affaire C-250/25. La grande chambre a tenu des audiences en mars 2026.
Cette affaire porte sur la question de savoir si l’entraînement d’un LLM implique une reproduction relevant du droit d’auteur, si l’exception européenne de fouille de textes et de données peut s’appliquer, et dans quels cas les résultats d’un chatbot contenant du matériel protégé peuvent porter atteinte au droit d’auteur. En septembre 2026, l’affaire est toujours en instance.10
Conformité au droit d’auteur des GPAI au titre de l’article 53
L’article 53 du règlement européen sur l’IA impose aux fournisseurs de models d’IA à usage général de maintenir une politique de conformité au droit d’auteur de l’UE.
Les fournisseurs doivent également publier un résumé suffisamment détaillé du contenu utilisé pour l’entraînement et répondre aux réserves de droits formulées au titre de l’article 4(3) de la directive sur le marché unique numérique.11
Allemagne
La GEMA gagne un procès en droit d’auteur contre Suno
En juillet 2026, le tribunal régional de Munich a jugé que la société de musique par IA Suno avait enfreint les droits d’auteur sur des chansons représentées par la société allemande de gestion collective GEMA.
Le tribunal a estimé que Suno n’avait pas l’autorisation de traiter les chansons protégées et a ordonné à la société de divulguer les revenus liés à la contrefaçon.12
La GEMA gagne un procès sur les paroles contre OpenAI
La décision Suno est intervenue après le jugement de novembre 2025 de la GEMA contre OpenAI concernant des paroles de chansons protégées par le droit d’auteur reproduites par ChatGPT. OpenAI a fait appel de cette décision devant le tribunal régional supérieur de Munich.13
Japon
Le Japon adopte un code de principes de transparence pour l’IA générative
En août 2026, le quartier général japonais de la stratégie de propriété intellectuelle a publié son code de principes pour la protection de la propriété intellectuelle et la transparence en vue d’une utilisation appropriée de l’IA générative.14
Le code de principes n’est pas contraignant et suit une approche « appliquer ou expliquer ». Il encourage les entreprises d’IA à communiquer des informations sur les processus d’entraînement, les catégories de datasets et les méthodes de collecte de données.
La loi japonaise sur le droit d’auteur contient une exception qui peut permettre l’utilisation d’œuvres protégées à des fins d’analyse d’informations, y compris certains entraînements d’IA.
Cette exception est soumise à des limites légales, notamment la question de savoir si l’utilisation permet de jouir du contenu expressif de l’œuvre et si elle nuit de manière déraisonnable aux intérêts du titulaire du droit d’auteur.
Singapour
Singapour : IA et droit d’auteur
En août 2026, le ministère du Droit et l’Office de la propriété intellectuelle de Singapour ont lancé une consultation publique sur l’IA et la propriété intellectuelle.
La consultation porte sur l’exception d’analyse computationnelle des données, la gestion des risques liés au droit d’auteur lors du déploiement de systèmes d’IA et le rôle de la créativité humaine dans les œuvres assistées par l’IA.15
2. Les œuvres générées par l’IA sont-elles éligibles à la protection du droit d’auteur ?
L’Inde refuse de reconnaître DABUS comme auteur
En août 2026, le Bureau indien du droit d’auteur a rejeté la demande de Stephen Thaler visant à enregistrer l’image générée par DABUS « A Recent Entrance to Paradise ». 16
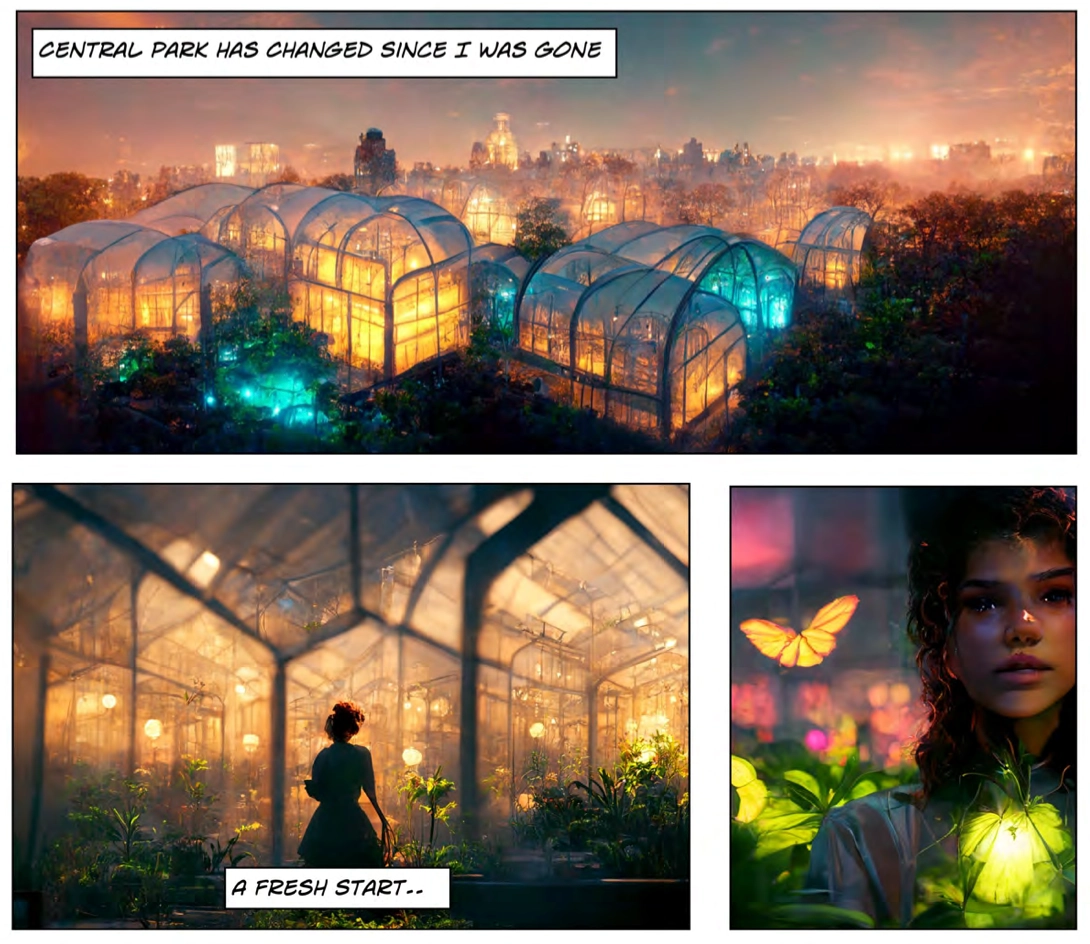
L’autrice a précisé que l’œuvre était assistée par l’IA, et non uniquement générée par l’IA. Elle a structuré l’histoire, conçu la mise en page et pris des décisions artistiques pour agencer les éléments parallèlement aux images générées par l’IA.
Figure 1 : Dessins de la dernière page de la bande dessinée générée par IA Zarya of the Dawn.
L’image primée générée par Midjourney s’est vu refuser la protection du droit d’auteur
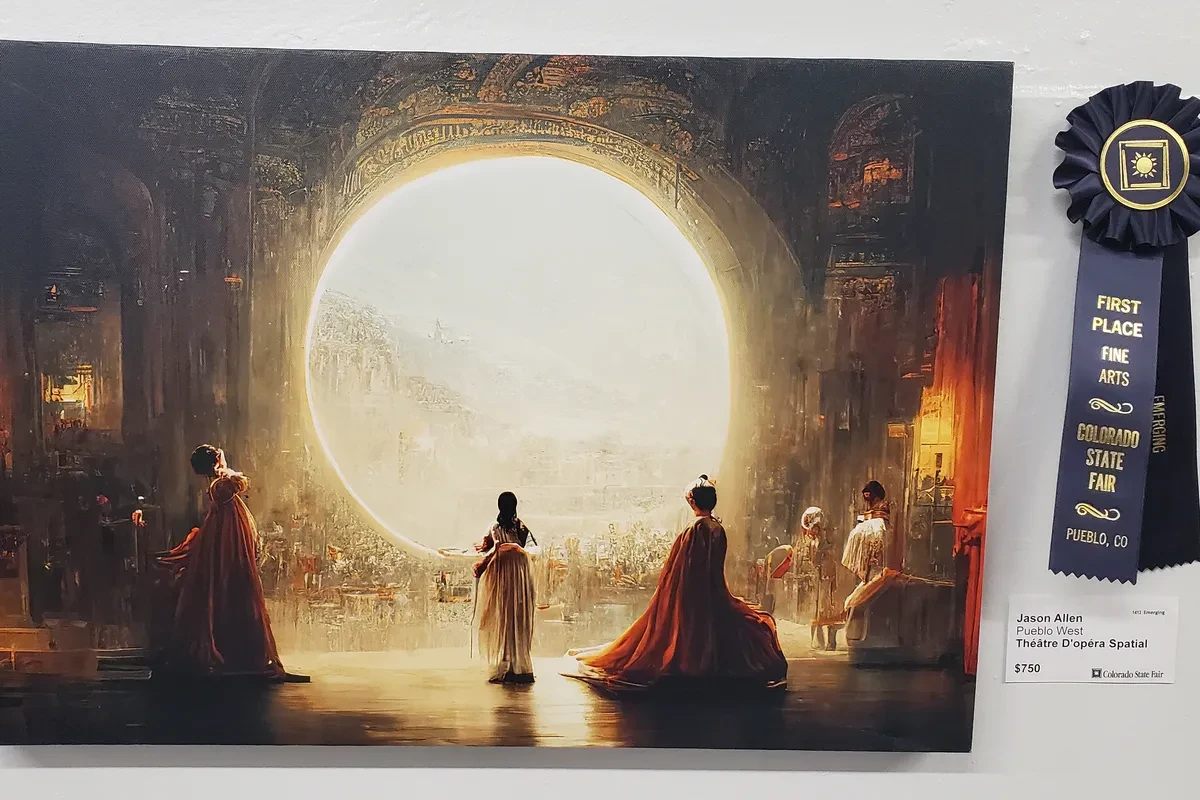
En 2022, Jason Allen a remporté la première place dans la catégorie des arts numériques de la foire d’État du Colorado avec Théâtre D’opéra Spatial, une image créée avec Midjourney.
Allen a utilisé des prompts textuels pour générer l’image, puis a effectué d’autres retouches avant de l’imprimer et de la soumettre. Le prix a suscité des critiques d’artistes qui estimaient que les œuvres générées par l’IA ne devraient pas concourir dans les mêmes conditions que l’art créé de manière traditionnelle.
Figure 2 : L’impression primée générée par IA Theatre d’Opera Spatial.17
En septembre 2023, le Bureau américain du droit d’auteur a refusé d’enregistrer l’œuvre de Jason Allen comme œuvre protégée par le droit d’auteur, car l’image contenait plus qu’une quantité minimale de matériel généré par l’IA.
Allen a fait valoir qu’il avait utilisé des centaines de prompts et qu’il avait ensuite retouché l’image dans Photoshop. Le Bureau du droit d’auteur a conclu que les éléments générés par Midjourney n’étaient pas le produit d’une paternité humaine.18
3. Qui détient le droit d’auteur sur une œuvre générée par l’IA ?
Dans la plupart des pays, le droit d’auteur attribue la titularité au créateur d’une œuvre. Lorsque l’IA produit l’œuvre, la question de savoir qui en est le créateur et, par conséquent, qui la détient n’a pas de réponse universelle établie.
- Royaume-Uni : La loi sur le droit d’auteur, les dessins et modèles et les brevets dispose que, pour une œuvre admissible générée par ordinateur, l’auteur est la personne qui prend les dispositions nécessaires à sa création.
- Inde : Pour une œuvre générée par ordinateur, l’auteur légal est la personne qui provoque la création de l’œuvre.
- États-Unis : Le matériel généré par l’IA sans paternité humaine suffisante n’est pas protégé par le droit d’auteur. Lorsqu’une œuvre assistée par l’IA contient des contributions humaines protégeables, la titularité suit les règles applicables à ces auteurs humains.
Pour en savoir plus sur l’IA générative
- L’IA générative dans la santé : avantages, défis et potentiels
- L’IA générative dans la mode : 5 cas d’usage avec études de cas
- Top 5 des cas d’usage de l’IA générative dans l’éducation
 Ajouter comme source préférée
Citer cette recherche
Choisissez le format qui correspond à votre lieu de publication. Coller la version avec lien dans votre CMS préserve le lien retour.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Ermut, Sıla},
  title  = {{Droit d'auteur et IA générative: droit et contentieux}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/generative-ai-copyright}},
  note   = {AIMultiple. Consulté le 3 septembre 2026}
}
Journal des modifications
14 mises à jourSuppression des sections sur les accords de licence IA, les bonnes pratiques et le glossaire.
La section USA a été mise à jour avec de nouvelles décisions et des détails sur les litiges.
Mise à jour de la section « Les données protégées par le droit d'auteur peuvent-elles être utilisées comme données d'entraînement ? » avec de nouvelles informations sur l'utilisation équitable aux États-Unis.
Liens de référence
Le travail de Cem chez AIMultiple a été cité par des publications mondiales de premier plan, notamment Business Insider, Forbes, Morning Brew et Washington Post, par des entreprises mondiales comme Deloitte et HPE, par des ONG comme World Economic Forum et par des organisations supranationales comme European Commission. [1], [2], [3], [4], [5]
Tout au long de sa carrière, Cem a été consultant en technologies, acheteur de technologies et entrepreneur technologique. Il a conseillé des entreprises sur leurs décisions technologiques chez McKinsey & Company et Altman Solon pendant plus de dix ans. Il a également publié un rapport McKinsey sur la digitalisation.
Il a dirigé la stratégie technologique et les achats d'un opérateur télécom, sous la responsabilité du PDG. Il a également dirigé la croissance commerciale de l'entreprise de technologie profonde Hypatos, qui a atteint un revenu récurrent annuel à 7 chiffres et une valorisation à 9 chiffres, passant de 0 à ce résultat en deux ans. Le travail de Cem chez Hypatos a été couvert par des publications technologiques de premier plan comme TechCrunch et Business Insider.
Cem intervient régulièrement lors de conférences technologiques internationales. Il est diplômé de Bogazici University en tant qu'ingénieur informatique et titulaire d'un MBA de la Columbia Business School.

Elle a précédemment travaillé comme recruteuse dans des cabinets de gestion de projet et de conseil. Sıla est titulaire d’un master en psychologie sociale et d’une licence en relations internationales.



Soyez le premier à commenter
Votre adresse courriel ne sera pas publiée. Tous les champs sont obligatoires. Les commentaires sont laissés dans leur langue d'origine.