


Top 6 des outils open source d'analyse de logs: Wazuh, Graylog et plus encore
En tant que RSSI dans un secteur très réglementé avec environ 2 décennies d'expertise en cybersécurité, j'ai travaillé avec plusieurs plateformes d'analyse de logs de type SIEM. Parmi celles-ci, j'ai sélectionné le top 6 des outils open source d'analyse de logs. Pour évaluer ces outils, je me suis concentré sur des facteurs clés tels que la flexibilité de la collecte de logs, la détection d'événements en temps réel, l'évolutivité et la prise en charge de divers formats de logs.
Fonctionnalités de gestion et de détection des logs
Fonctionnalités d'intégrité et de non-répudiation
Tarification des outils d'analyse de logs
Wazuh
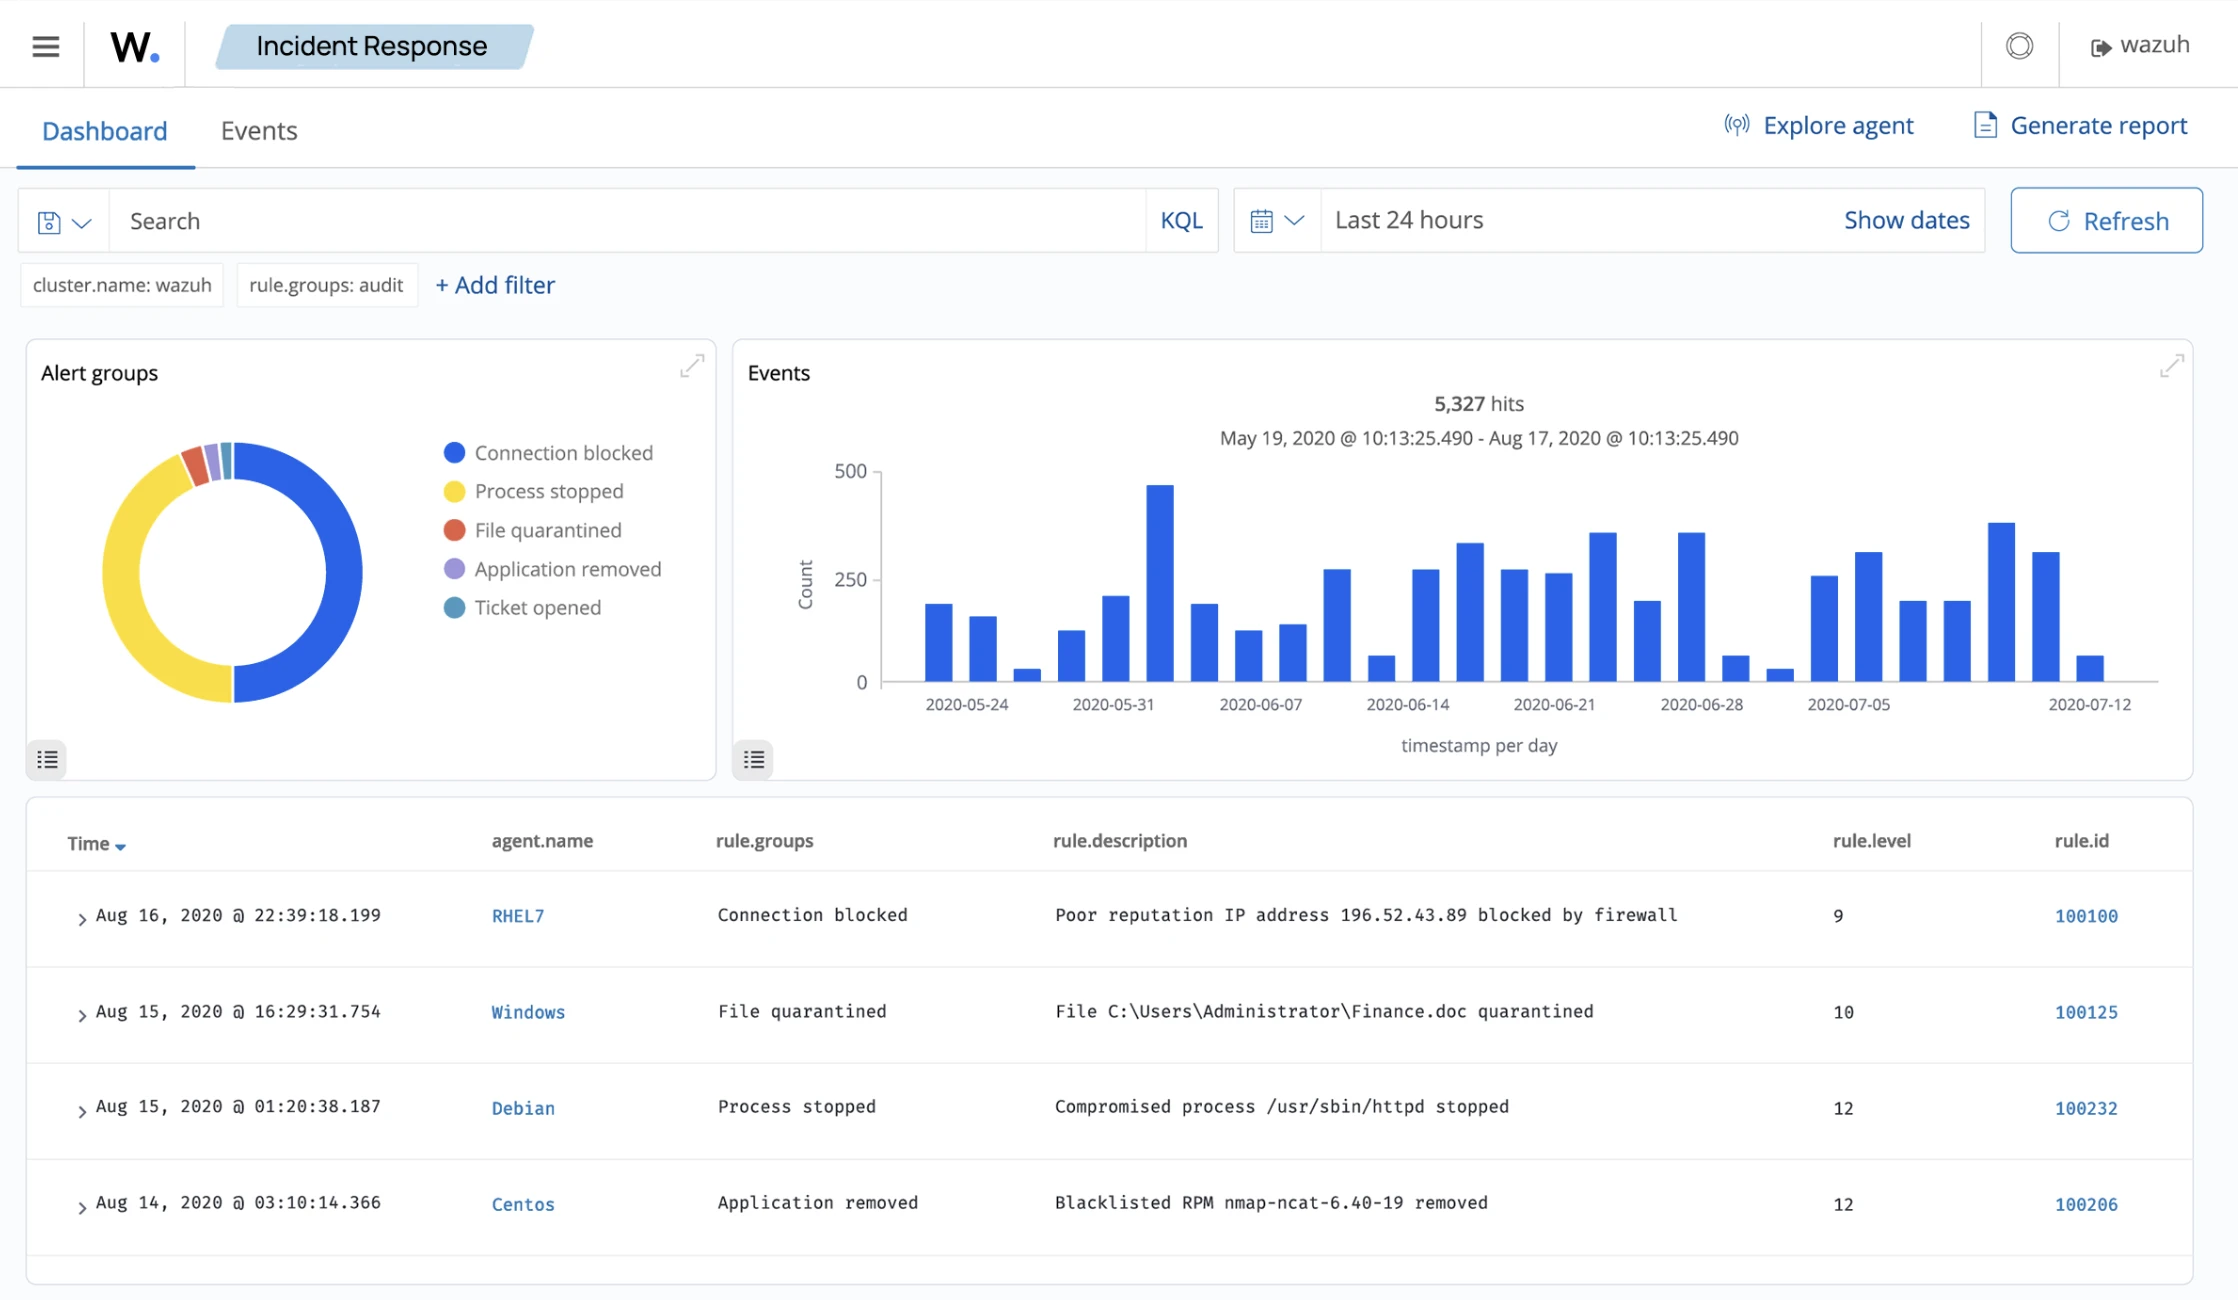
Wazuh est un SIEM open source qui va plus loin que la plupart des outils de cette catégorie. Il combine la surveillance des logs, la sécurité des terminaux, la surveillance de l'intégrité des fichiers, la détection des vulnérabilités et la détection des événements de sécurité en temps réel dans une plateforme unique basée sur des agents.
Comment fonctionne la gestion des logs dans Wazuh
Un agent de terminal déployé sur chaque système surveillé collecte les logs localement et les transmet au serveur de gestion Wazuh pour traitement et analyse. L'agent gère localement la collecte des logs, la surveillance de l'intégrité et la réponse active. Wazuh s'intègre nativement à l'Elastic Stack, en utilisant Elasticsearch pour le stockage et la recherche des logs, et Kibana (via le plugin Wazuh) pour les tableaux de bord et les investigations.
Le moteur de règles s'exécute sur le gestionnaire et évalue les événements de logs entrants par rapport à un ensemble de règles qui comprend des règles par défaut, des CIS benchmarks, des mappages MITRE ATT&CK et toutes les règles personnalisées que vous écrivez. Lorsqu'une règle se déclenche, Wazuh génère une alerte et, si vous avez configuré une réponse active, peut prendre une action automatisée sur le terminal : bloquer une adresse IP, tuer un processus ou mettre un fichier en quarantaine.
Options d'hébergement :
- Auto-hébergé : La plateforme est gratuit à télécharger et à utiliser. Le support annuel optionnel est tarifé en fonction du nombre de terminaux surveillés (serveurs, postes de travail et équipements réseau). Dans ce modèle, l'organisation est responsable de la maintenance du matériel et des ressources.
- Hébergé dans le cloud : Le fournisseur d'hébergement gère le serveur Wazuh et l'Elastic Stack ; vous devez déployer les agents. La tarification dépend des données indexées (anciennement appelées stockage chaud) et de la période de rétention choisie.
Fonctionnalités remarquables :
- Collecte de logs flexible : Wazuh ingère les logs depuis l'Observateur d'événements Windows, les messages système Linux, les logs d'application au format JSON et un large éventail de types de sources sans plugins supplémentaires. La couverture prête à l'emploi est plus large que celle de Graylog ou Logstash, qui nécessitent davantage de configuration pour atteindre la même étendue.
- Mappage MITRE ATT&CK : Les règles correspondent aux techniques MITRE ATT&CK par défaut, de sorte que les alertes vous indiquent non seulement ce qui s'est passé, mais aussi où cela se situe dans une chaîne d'attaque. C'est important pour le triage ; vous pouvez faire la différence entre un échec d'authentification bruyant et une tentative de credential stuffing sans écrire de corrélation personnalisée.
- Intégrations tierces : Intégrations natives avec Office 365, AWS, GCP, Azure et Rapid7. Une bibliothèque Python intégrée prend en charge les intégrations personnalisées sans la configuration de plugins requise par Syslog-ng ou Fluentd.
- API et réponse active : Une API RESTful couvre les requêtes de logs, la gestion des règles et des décodeurs, les requêtes d'alertes et les interactions avec les agents. La fonctionnalité de réponse active exécute des scripts sur le terminal surveillé lors d'une alerte : blocage d'adresses IP, arrêt de processus, isolation d'hôtes. Cela n'est pas disponible dans l'Elastic Stack sans outillage supplémentaire.
Graylog
Graylog est une plateforme de gestion des logs avec un cœur disponible en source (Graylog Open) et des éditions payantes qui s'étendent aux opérations de sécurité. Cette distinction compte plus que ne le laissent entendre la plupart des descriptions des fournisseurs : Graylog Open vous offre la collecte de logs, la recherche, les pipelines de traitement, les tableaux de bord et les alertes basées sur les flux, ce qui est suffisant pour les cas d'utilisation opérationnels. Les règles Sigma, l'alignement MITRE ATT&CK, l'UEBA, la détection d'anomalies et la gestion des cas sont des fonctionnalités payantes de Graylog Security et Enterprise. Si votre principal cas d'utilisation est les opérations de sécurité plutôt que la surveillance de l'infrastructure, tenez-en compte dans le calcul des coûts.
Comment fonctionne Graylog
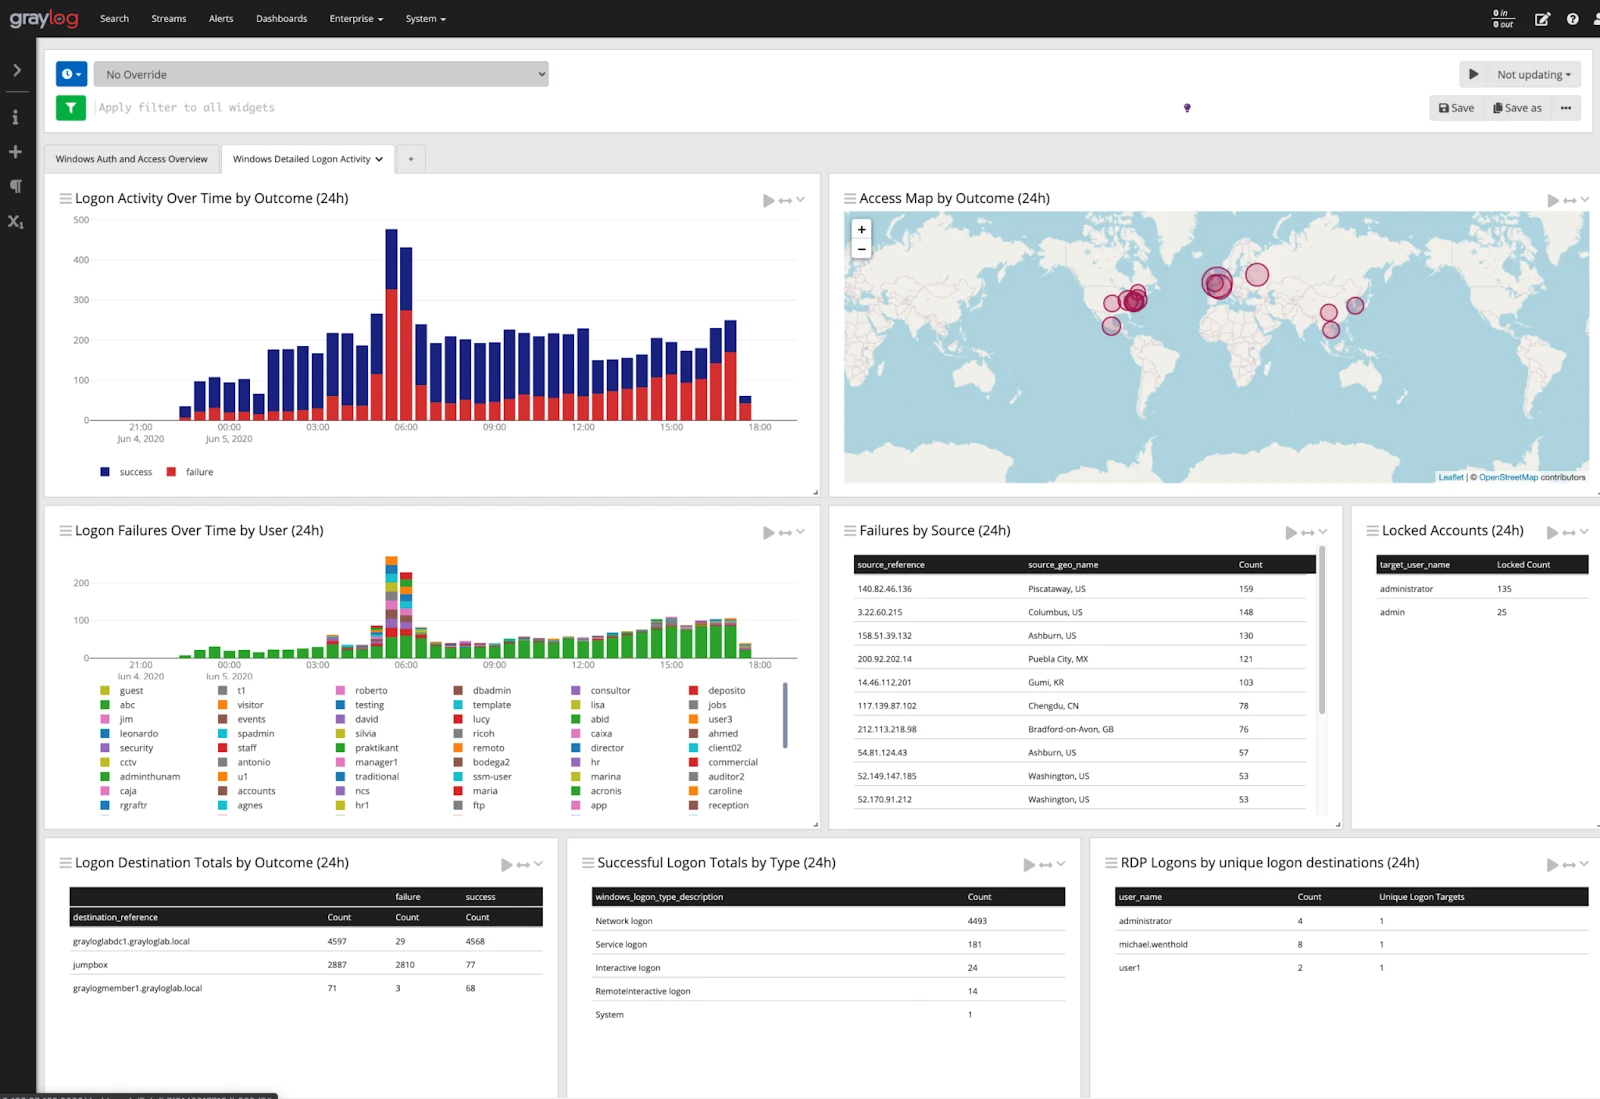
Graylog reçoit les données de logs via GELF (Graylog Extended Log Format), syslog, Beats ou des entrées HTTP, les stocke dans Elasticsearch ou OpenSearch (via le Graylog Data Node) et les rend consultables via une interface web. Le système de flux est central dans le fonctionnement de Graylog : les messages entrants sont acheminés vers des flux en fonction de règles, et les alertes, les pipelines et les contrôles d'accès sont tous attachés aux flux plutôt qu'à la couche de stockage. Cela signifie que vous pouvez avoir un flux pour les erreurs d'application acheminé vers une équipe et un flux distinct pour les événements d'authentification acheminé vers la sécurité, avec des politiques de rétention et des autorisations différentes pour chacun.
Les pipelines de traitement vous permettent d'analyser, d'enrichir, de supprimer ou de réécrire les messages avant le stockage. Si les logs de votre application arrivent sous forme de texte non structuré, vous écrivez une règle de pipeline pour extraire des champs en données structurées. Graylog Illuminate (inclus dans les éditions payantes, disponible pour Open avec des limitations) fournit des analyseurs et des tableaux de bord prédéfinis pour les sources courantes : Windows Event Logs, Cisco, Palo Alto, AWS CloudTrail et autres.
- Le broker Kafka minimum est 2.1. Toute entrée Kafka connectée à un broker plus ancien échouera après la mise à niveau.
- Les tokens API expirent désormais après 30 jours par défaut. Toute automatisation, intégration de surveillance ou script qui utilise un token API à longue durée de vie cessera de fonctionner à moins que vous n'ayez mis en place une politique de rotation des tokens. Ce problème a tendance à se manifester comme un incident de fin de nuit, lorsque quelque chose cesse de signaler, plutôt que pendant la mise à niveau elle-même.
Fonctionnalités remarquables :
- Routage et traitement basés sur les flux : Le modèle de flux vous permet de segmenter les données de logs par source, application ou niveau de sensibilité au moment de l'ingestion, puis d'appliquer différents pipelines, politiques de rétention et contrôles d'accès par flux. C'est plus flexible sur le plan opérationnel que les modèles d'index par source d'Elasticsearch.
- Extraction et analyse des logs : Les extracteurs extraient des champs spécifiques des messages de logs à l'ingestion. Les pipelines de traitement gèrent des transformations plus complexes, la logique conditionnelle, les recherches, le renommage des champs et la suppression de messages. Together, ils vous donnent un contrôle précis sur ce qui finit dans le stockage. Graylog Illuminate a également livré des corrections d'analyseurs dans la version 7.0.3, notamment une correction de l'analyse des horodatages Apache HTTPD qui produisait des valeurs temporelles incorrectes.
- Recherche et investigation : La syntaxe de recherche de Graylog est plus simple que Lucene/KQL pour les requêtes de base, ce qui compte lorsque vous avez besoin qu'un ingénieur d'astreinte recherche des logs à minuit sans documentation de référence. Les recherches enregistrées, les plages temporelles relatives et les superpositions d'histogrammes sont toutes disponibles sans modules complémentaires payants.
- Gestion des utilisateurs avec intégration AD/LDAP : L'authentification Active Directory et LDAP est prise en charge dans Graylog Open. Les contrôles d'accès basés sur les rôles vous permettent de restreindre les flux et les tableaux de bord que chaque équipe peut voir.
Les difficultés de Graylog
Le niveau gratuit de Graylog présente des lacunes importantes si les opérations de sécurité sont votre cas d'utilisation : la prise en charge des règles Sigma, la détection d'anomalies et la gestion des cas sont toutes payantes. La dépendance à Elasticsearch/OpenSearch ajoute une complexité opérationnelle similaire à celle de l'ELK Stack. À grande échelle, le traitement par pipelines peut créer des goulots d'étranglement de performance qui nécessitent un réglage minutieux de l'ordre des étapes des pipelines et de l'allocation des threads de travail.
Elastic Stack (ELK Stack) – Logstash
Elastic Stack est un ensemble de produits open source ; ses composants essentiels sont Elasticsearch, Kibana et Logstash.
Comment fonctionne l'analyse de logs ELK
Logstash est un pipeline de traitement de données côté serveur. Il reçoit les données de logs depuis des entrées (fichiers, Beats, syslog, Kafka, HTTP et des dizaines d'autres), applique des plugins de filtre pour analyser et enrichir les données, puis route la sortie vers une ou plusieurs destinations. La plupart des déploiements envoient la sortie vers Elasticsearch, mais Logstash peut également écrire simultanément vers S3, un SIEM, une file de messages ou un autre cluster Elasticsearch.
Elasticsearch stocke les données de logs traitées et les rend consultables à l'aide d'un index inversé. C'est la raison pour laquelle ELK s'étend à des pétaoctets tout en renvoyant des résultats de recherche en moins d'une seconde sur des requêtes ciblées, mais cette performance provient de la structure de l'index, ce qui signifie que les charges de travail à forte écriture nécessitent une gestion minutieuse du cycle de vie des index. Kibana repose sur Elasticsearch et fournit la couche visuelle : les tableaux de bord, la vue Discover pour la recherche de logs ad hoc, Canvas pour les rapports personnalisés et Lens pour les visualisations par glisser-déposer.
- Recherche en texte intégral à grande échelle : L'architecture d'index inversé d'Elasticsearch prend en charge une recherche en moins d'une seconde sur des milliards d'entrées de logs. KQL (Kibana Query Language) et ES|QL (le langage de requête basé sur les pipes, plus récent, de la version 9.x) offrent aux analystes deux interfaces de requête différentes selon leur préférence de travail. Pour les investigations complexes de logs sur de grands ensembles de données, rien dans l'espace open source n'égale la profondeur de recherche d'ELK.
- Ingestion et filtrage multi-sources : Logstash dispose d'environ 200 plugins d'entrée et 200 plugins de filtre. Le filtre grok traite le texte non structuré à l'aide de modèles de capture nommés ; le filtre json traite les logs structurés au format JSON ; le filtre csv traite les données tabulaires. Plusieurs étapes de filtre s'exécutent en séquence, de sorte que vous pouvez analyser une ligne syslog brute, extraire des champs, rechercher une adresse IP dans une base de données GeoIP et supprimer les messages de niveau débogage avant que l'événement n'atteigne Elasticsearch, le tout dans un seul pipeline.
- Détection d'anomalies par apprentissage automatique : Les fonctionnalités ML de Kibana (payantes) identifient des modèles inhabituels dans les données de logs sans que vous ayez à définir des seuils. Utile pour détecter les attaques lentes ou la dégradation progressive des performances que les alertes à seuil fixe ne détectent pas.
- Tableaux de bord Kibana : Les options de visualisation de Kibana sont vastes : séries temporelles, cartes, cartes thermiques, tableaux de données, jauges, etc. Les recherches enregistrées et les modèles d'index permettent aux analystes de partager les contextes d'investigation entre les équipes.
- Routage de sortie extensible : Un seul pipeline Logstash peut écrire simultanément vers Elasticsearch, un compartiment S3, un second cluster Elasticsearch pour la reprise après sinistre et un sujet Kafka pour le traitement en aval.
Les difficultés d'ELK
La charge opérationnelle est réelle. Les clusters Elasticsearch nécessitent une planification de la mémoire (le tas de la JVM doit être dimensionné avec soin), la gestion des shards (trop de petits shards ou trop peu de gros nuisent tous deux aux performances) et la configuration de la politique de cycle de vie des index pour contrôler les coûts de rétention.
La plupart des équipes qui exécutent ELK à grande échelle finissent par avoir un ingénieur plateforme dédié dont la responsabilité principale est Elasticsearch. Il est également important de comprendre la situation des licences : les composants de l'Elastic Stack sont sous la licence Elastic 2.0, pas sous une licence open source approuvée par l'OSI. L'utilisation auto-hébergée est gratuit, mais proposer Elasticsearch comme service géré à des tiers n'est pas autorisé dans la version gratuit.
Fluentd
Fluentd est un collecteur de données open source sous licence Apache 2.0, conçu pour unifier l'ingestion et le routage des logs sur une infrastructure hétérogène. La tâche principale est simple : accepter les événements de logs provenant de sources, appliquer un traitement optionnel et les router vers des destinations. Fluentd ne stocke ni n'analyse pas lui-même les logs ; c'est un collecteur et un routeur, pas une plateforme d'analyse de logs1
Cette distinction compte lors de l'évaluation face à Wazuh ou Graylog. Fluentd est généralement la première couche d'un pipeline plus vaste. Une architecture courante : les agents Fluentd sur chaque serveur collectent les logs d'application, les logs système et les logs de conteneurs, les mettent en tampon localement (afin que rien ne soit perdu si la destination en aval est temporairement indisponible), appliquent l'analyse et le filtrage, puis transmettent le résultat à Elasticsearch, Splunk, un SIEM cloud ou un autre backend de stockage. L'analyse se produit dans ce qui reçoit les données.
Fluentd vs. Fluent Bit
Les équipes qui évaluent Fluentd pour les environnements Kubernetes finissent souvent par choisir Fluent Bit à la place, et il est utile de comprendre pourquoi. Fluent Bit est un forwarder léger dans le même écosystème CNCF, un binaire d'environ 4 Mo contre le processus Ruby de Fluentd qui est nettement plus lourd. Pour les déploiements Kubernetes où vous souhaitez un collecteur de logs exécuté comme un DaemonSet sur chaque nœud, la différence d'empreinte de ressources est significative à grande échelle. Fluent Bit prend également en charge l'analyse de logs multilignes, l'injection dynamique de métadonnées à partir des libellés et annotations des pods Kubernetes, et la gestion intégrée de la contre-pression pour empêcher la perte de données lorsque les destinations en aval ralentissent.
Fluentd est le meilleur choix lorsque vous avez besoin de l'écosystème complet de plus de 500 plugins ou d'une logique de routage complexe que la bibliothèque de plugins plus réduite de Fluent Bit ne peut pas couvrir. Pour la plupart des déploiements Kubernetes natifs qui effectuent un transfert de logs simple, Fluent Bit est le choix pratique. Les projets partagent des concepts de configuration, de sorte que passer de l'un à l'autre n'est pas une réécriture complète.
Comment Fluentd gère les données de logs
Fluentd modélise les données de logs comme un flux d'événements étiquetés. Chaque événement possède une étiquette (une chaîne séparée par des points comme app.web ou system.syslog), un horodatage et un enregistrement. Les étiquettes pilotent le routage : les directives match dans la configuration spécifient quelles étiquettes sont envoyées où, quels filtres s'appliquent et dans quel ordre. Plusieurs sorties peuvent correspondre à la même étiquette, de sorte que vous pouvez envoyer les mêmes événements à la fois vers Elasticsearch et une archive S3 simultanément.
Le système de tampon est ce qui rend Fluentd fiable en production. Plutôt que d'écrire directement dans la destination, les événements s'accumulent dans un tampon et sont évacués par blocs à des intervalles configurables ou lorsque le tampon atteint un seuil de taille. Si la destination est inaccessible, les événements restent dans le tampon et sont réessayés avec un délai exponentiel.
Fonctionnalités remarquables :
- 500+ plugins communautaires : Couvre les intégrations avec la plupart des grandes destinations de logs et sources de données sans développement personnalisé.
- Routage flexible des données : Les événements peuvent être acheminés vers plusieurs destinations simultanées, telles que les fichiers, les SGBDR, NoSQL, IaaS, SaaS, et Hadoop, en fonction de règles de routage basées sur les étiquettes.
- Focus sur le traitement des logs : Fluentd est optimisé pour le traitement et le transfert de logs à grande échelle, ce qui le rend bien adapté comme couche de collecte et de routage devant Elasticsearch ou d'autres backends de stockage plutôt que comme plateforme d'analyse autonome.
 Ajouter comme source préférée
Syslog-ng
Syslog-ng est un programme de gestion des logs open source qui collecte, classifie, transforme et route les données de logs de multiples sources vers le stockage ou des plateformes en aval. Sa capacité distinctive est le traitement structuré : les logs peuvent être normalisés dans un format cohérent avant d'être transmis à des systèmes tels qu'Apache Kafka ou Elasticsearch.
Capacités :
- Classer et structurer les logs à l'aide d'analyseurs intégrés comme csv-parser
- Stocker les logs dans des fichiers, des files de messages (AMQP) ou des bases de données (PostgreSQL, MongoDB)
- Transmettre vers des plateformes de big data, notamment Elasticsearch, Apache Kafka ou Hadoop
Fonctionnalités distinctives :
- Archivage automatisé des logs : Syslog-ng gère nativement la rotation et l'archivage des logs, y compris la compression et la dénomination des fichiers avec horodatage. Pour les environnements avec des exigences de conformité en matière de rétention, cela réduit le besoin d'outils externes comme logrotate superposés.
- Prise en charge de plusieurs formats de messages : RFC3164 (syslog traditionnel), RFC5424 (syslog structuré), JSON et les formats clé-valeur sont tous analysés nativement. Syslog-ng peut recevoir un message RFC3164 et le produire en RFC5424 avec des champs de données structurées ajoutés, ce qui est utile lors de l'alimentation de systèmes qui attendent un format syslog moderne.
- Transport chiffré : Le transport syslog chiffré par TLS est pris en charge nativement pour la réception et le transfert. Cela compte dans les environnements où les données de logs transitent par des segments de réseau non fiables.
- Routage conditionnel : Les expressions de filtre vous permettent de router en fonction de n'importe quel champ analysé : gravité, équipement, hôte ou champs personnalisés extraits par les analyseurs. Une seule instance de syslog-ng peut router les échecs d'authentification vers le flux de l'équipe de sécurité, les erreurs d'application vers le flux de l'équipe de développement et les messages de débogage vers /dev/null.
Où syslog-ng convient (et où il ne convient pas)
Syslog-ng est le bon choix lorsque vos sources de logs sont principalement des équipements réseau et des serveurs qui parlent syslog, et lorsque vous avez besoin d'une collecte fiable à haut débit avec extraction de champs structurés avant le transfert vers un backend de stockage. Ce n'est pas une plateforme d'analyse de logs ; il n'y a pas d'interface de requête, pas de tableaux de bord et pas d'alerte intégrée. Il fonctionne comme couche de collecte et de routage devant Elasticsearch ou Graylog, pas comme un outil autonome.
Nagios
Une clarification nécessaire avant d'aller plus loin : Nagios Core est le projet de surveillance open source sous licence GPL, et il se concentre sur la surveillance des hôtes, des services et du réseau plutôt que sur l'analyse des logs.[15] Le produit décrit ici est Nagios Log Server, un produit commercial distinct de Nagios Enterprises. Si vous recherchez spécifiquement un outil d'analyse de logs open source et gratuit, Nagios Log Server n'est pas celui-ci. Ce qu'il offre est une plateforme de gestion des logs avec support commercial d'un fournisseur ayant une longue expérience dans la surveillance de l'infrastructure.
Nagios Log Server collecte les données de logs en temps réel et les alimente vers une interface de recherche. Il est compatible avec les serveurs Windows, Linux et Unix et comprend un assistant de configuration pour intégrer de nouveaux terminaux ou applications.2
Fonctionnalités remarquables :
- Surveillance des services réseau : Couvre SMTP, POP3, HTTP, PING et d'autres services réseau avec un accent sur la santé de l'infrastructure.
- Surveillance des ressources des hôtes : Suit la charge du processeur, l'utilisation du disque et la santé du système sur les hôtes surveillés.
- Rotation et archivage des fichiers de logs : Rotation automatisée et archivage à long terme sans intervention manuelle.
- Filtrage géographique des logs : Filtre les données de logs par origine géographique et génère des cartes de flux de trafic.
- Interface web : Interface optionnelle pour afficher l'état actuel du réseau et les fichiers de logs.
FAQ
Les outils open source d'analyse de logs permettent aux utilisateurs de collecter, traiter, stocker, rechercher et analyser les données de logs provenant de diverses sources, telles que les serveurs, les applications et les équipements réseau. Ces outils peuvent aider les équipes SecOps, ITOps et DevOps à :
-Effectuer le dépannage du système en surveillant les fichiers de logs de transaction.
-Exploiter la réponse aux incidents de sécurité et l'investigation pour maintenir des performances optimales de la base de données ou exécuter l'analyse du comportement des utilisateurs et des entités (UEBA).
-Maintenir la conformité avec les audits, la législation et les règles de sécurité spéciales (RGPD).
Citer cette recherche
Choisissez le format qui correspond à votre lieu de publication. Coller la version avec lien dans votre CMS préserve le lien retour.
@misc{hafa2026,
  author = {Hafa, Adil and PhD., Ezgi Arslan,},
  title  = {{Top 6 des outils open source d'analyse de logs: Wazuh, Graylog et plus encore}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/open-source-log-analysis-tools}},
  note   = {AIMultiple. Consulté le 14 septembre 2026}
}Résultats et horodatages de 18 points de données. Téléchargez les données de synthèse présentées dans les graphiques et les tableaux de cet article sous forme de fichier ZIP contenant 3 fichiers CSV.
Vous voulez les données détaillées derrière ? Rejoindre Premium
Journal des modifications
6 mises à jourAjout de sections sur le fonctionnement et les limites pour Graylog, la suite ELK, Fluentd et syslog-ng.
Mise à jour du produit Wazuh avec de nouvelles capacités de détection et une politique SCA.
Liens de référence

À lire ensuite
Top 10 des logiciels de découverte de médicaments

Top 5 des garde-fous de l'IA: Xnode Cortx & Weights and Biases

Créer des agents IA personnels + 18 plateformes et outils d'agents
Utilisateurs synthétiques expliqués: Top 7 des outils de recherche utilisateur IA

Meilleures extensions proxy Chrome: gratuites et premium

Les 12 meilleurs logiciels de gestion des appareils mobiles



Soyez le premier à commenter
Votre adresse courriel ne sera pas publiée. Tous les champs sont obligatoires. Les commentaires sont laissés dans leur langue d'origine.