


Las 6 mejores herramientas de análisis de registros de código abierto: Wazuh, Graylog y más
Como CISO en una industria altamente regulada con ~2 décadas de experiencia en ciberseguridad, he trabajado con múltiples plataformas de análisis de registros similares a SIEM. De ellas, elegí las 6 mejores herramientas de análisis de registros de código abierto. Al evaluar estas herramientas, me centré en factores clave como la flexibilidad de recopilación de registros, la detección de eventos en tiempo real, la escalabilidad y el soporte para varios formatos de registro.
Funciones de gestión y detección de registros
Funciones de integridad y no repudio
Precios de las herramientas de análisis de registros
Wazuh
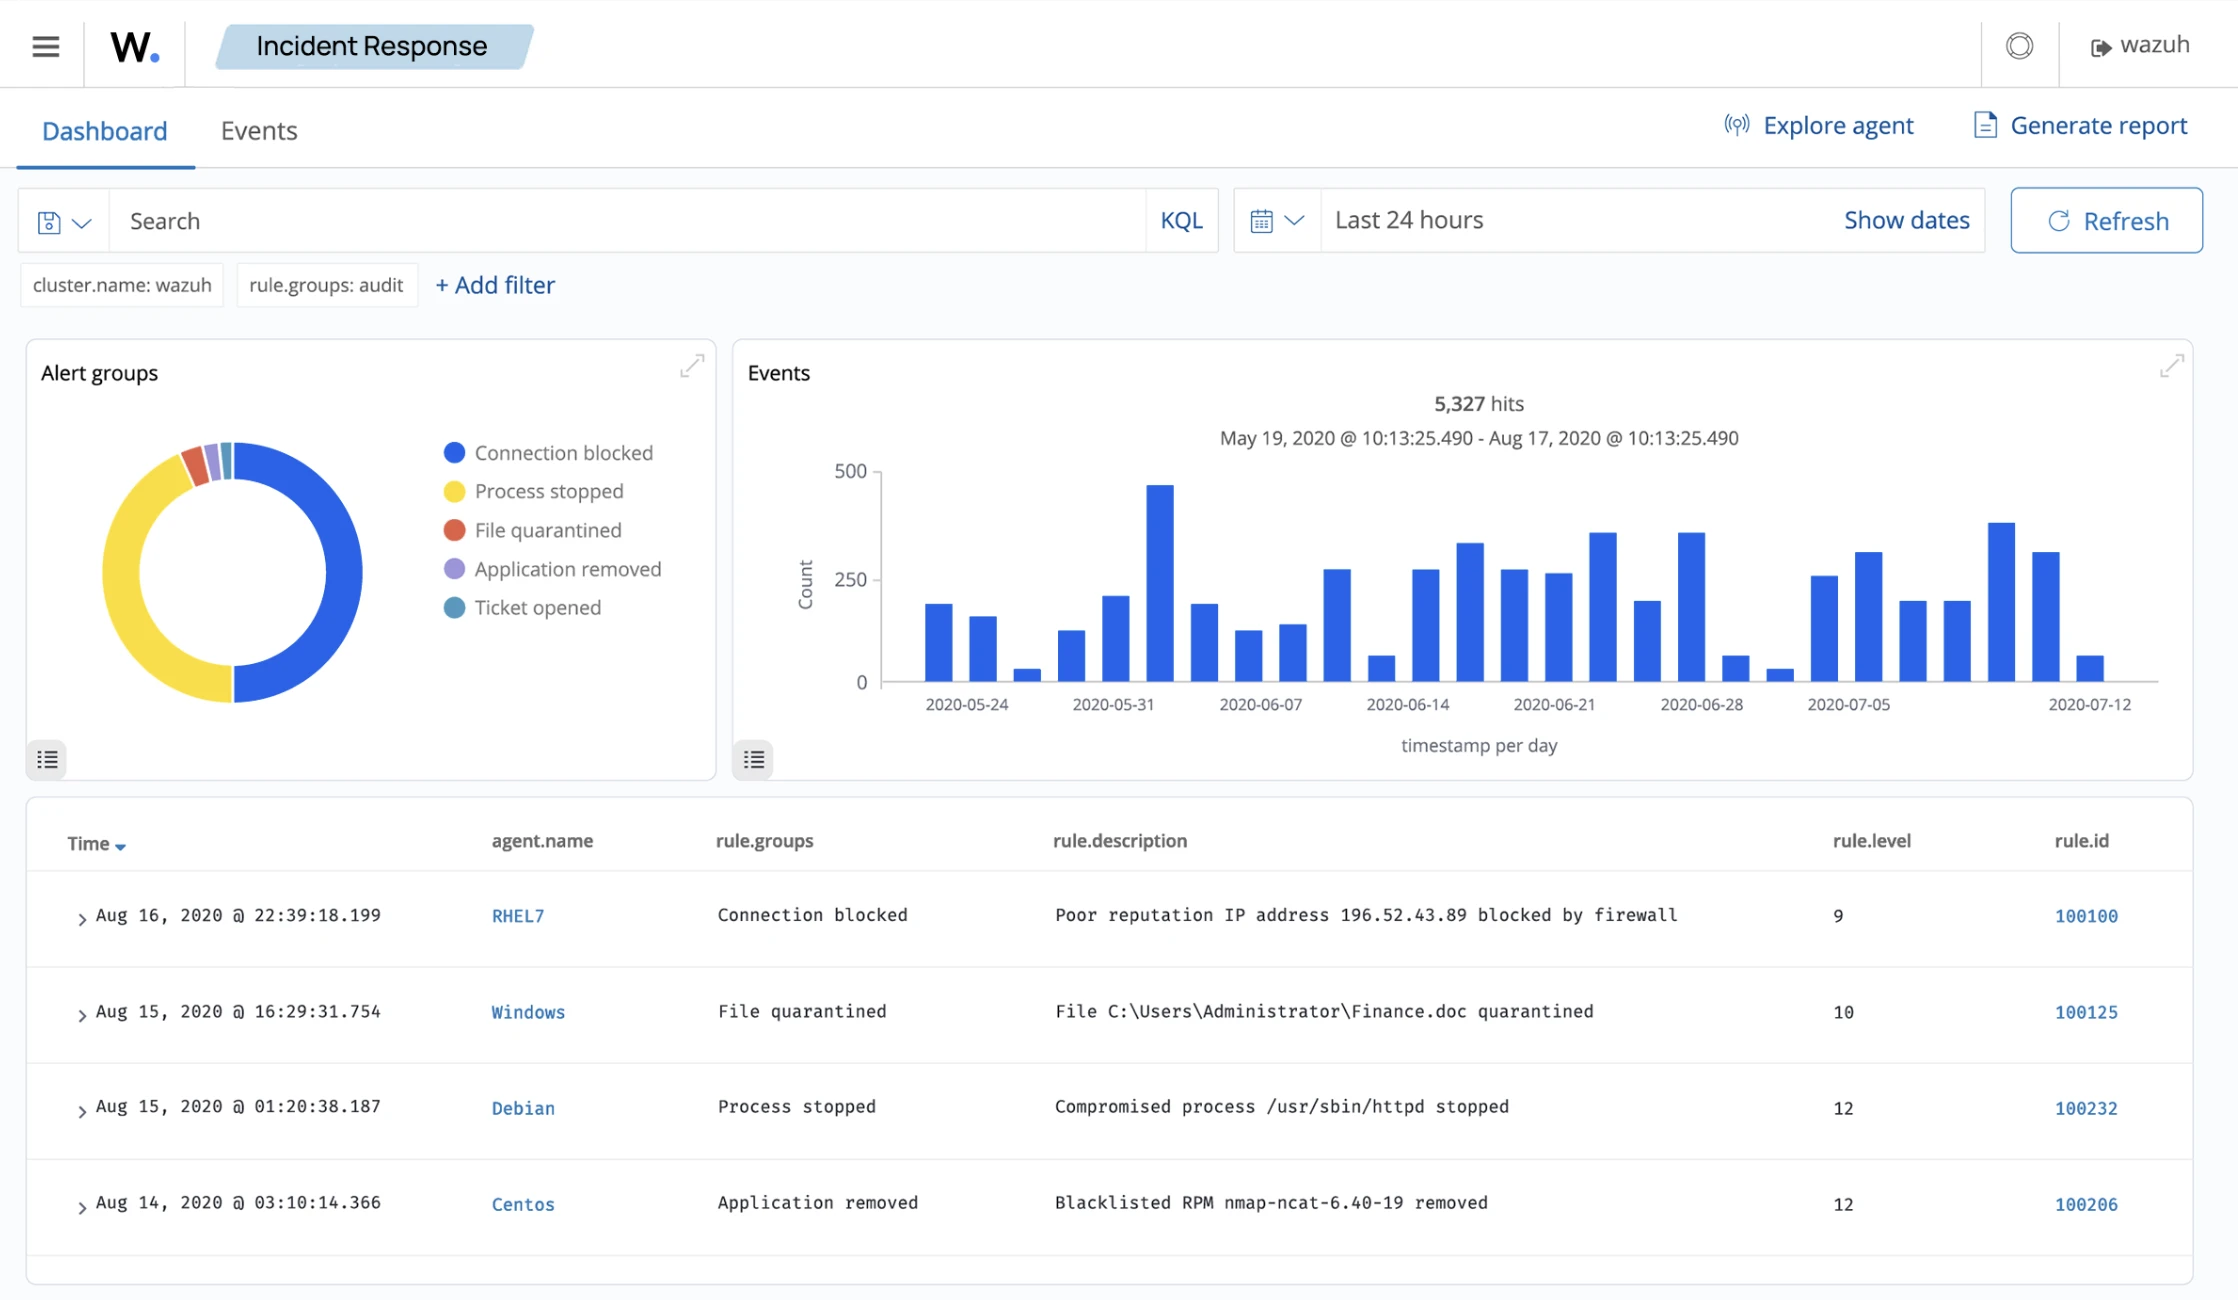
Wazuh es un SIEM de código abierto que va más allá que la mayoría de las herramientas de esta categoría. Combina monitoreo de registros, seguridad de endpoints, monitoreo de integridad de archivos, detección de vulnerabilidades y detección de eventos de seguridad en tiempo real en una única plataforma basada en agentes.
Cómo funciona la gestión de registros en Wazuh
Un agente de endpoint desplegado en cada sistema monitoreado recopila los registros localmente y los reenvía al servidor de gestión de Wazuh para su procesamiento y análisis. El agente gestiona localmente la recopilación de registros, el monitoreo de integridad y la respuesta activa. Wazuh se integra de forma nativa con Elastic Stack, utilizando Elasticsearch para el almacenamiento y la búsqueda de registros, y Kibana (mediante el plugin de Wazuh) para paneles e investigación.
El motor de reglas se ejecuta en el gestor y evalúa los eventos de registro entrantes frente a un conjunto de reglas que incluye reglas predeterminadas, benchmarks CIS, mapeos de MITRE ATT&CK y cualquier regla personalizada que escriba. Cuando se activa una regla, Wazuh genera una alerta y, si tiene configurada una respuesta activa, puede tomar medidas automáticas en el endpoint: bloquear una IP, terminar un proceso o poner en cuarentena un archivo.
Opciones de alojamiento:
- Autohospedado: La plataforma es gratis para descargar y usar. El soporte anual opcional tiene un precio basado en la cantidad de endpoints monitoreados (servidores, estaciones de trabajo y dispositivos de red). En este modelo, la organización es responsable del mantenimiento del hardware y los recursos.
- Alojado en la nube: El proveedor de alojamiento gestiona el servidor Wazuh y Elastic Stack; usted debe implementar los agentes. El precio depende de los datos indexados (anteriormente denominado almacenamiento en caliente) y del período de retención elegido.
Características destacadas:
- Recopilación flexible de registros: Wazuh ingiere registros del Visor de eventos de Windows, mensajes del sistema Linux, registros de aplicaciones en formato JSON y una amplia variedad de tipos de origen sin plugins adicionales. La cobertura lista para usar es más amplia que la de Graylog o Logstash, que requieren más configuración para alcanzar la misma amplitud.
- Mapeo MITRE ATT&CK: Las reglas se asignan a las técnicas de MITRE ATT&CK de forma predeterminada, por lo que las alertas no solo le dicen qué sucedió, sino dónde encaja en una cadena de ataque. Esto es importante para la clasificación; puede distinguir entre un fallo de autenticación ruidoso y un intento de relleno de credenciales sin escribir correlación personalizada.
- Integraciones de terceros: Integraciones nativas con Office 365, AWS, GCP, Azure y Rapid7. Una biblioteca de Python integrada admite integraciones personalizadas sin la configuración de plugins que requieren Syslog-ng o Fluentd.
- API y respuesta activa: Una RESTful API cubre consultas de registros, gestión de reglas y decodificadores, consultas de alertas e interacciones con agentes. La función de respuesta activa ejecuta scripts en el endpoint monitoreado al bloquear direcciones IP, terminar procesos y aislar hosts. Esto no está disponible en Elastic Stack sin herramientas adicionales.
Graylog
Graylog es una plataforma de gestión de registros con un núcleo de código disponible (Graylog Open) y ediciones de pago que se extienden a las operaciones de seguridad. Esa distinción importa más de lo que la mayoría de las descripciones de los proveedores dejan ver: Graylog Open ofrece recopilación de registros, búsqueda, pipelines de procesamiento, paneles y alertas basadas en flujos, lo que es suficiente para casos de uso operativos. Las reglas Sigma, la alineación con MITRE ATT&CK, UEBA, la detección de anomalías y la gestión de casos son funciones de pago de Graylog Security y Enterprise. Si su caso de uso principal son las operaciones de seguridad en lugar del monitoreo de infraestructura, téngalo en cuenta en el cálculo de costes.
Cómo funciona Graylog
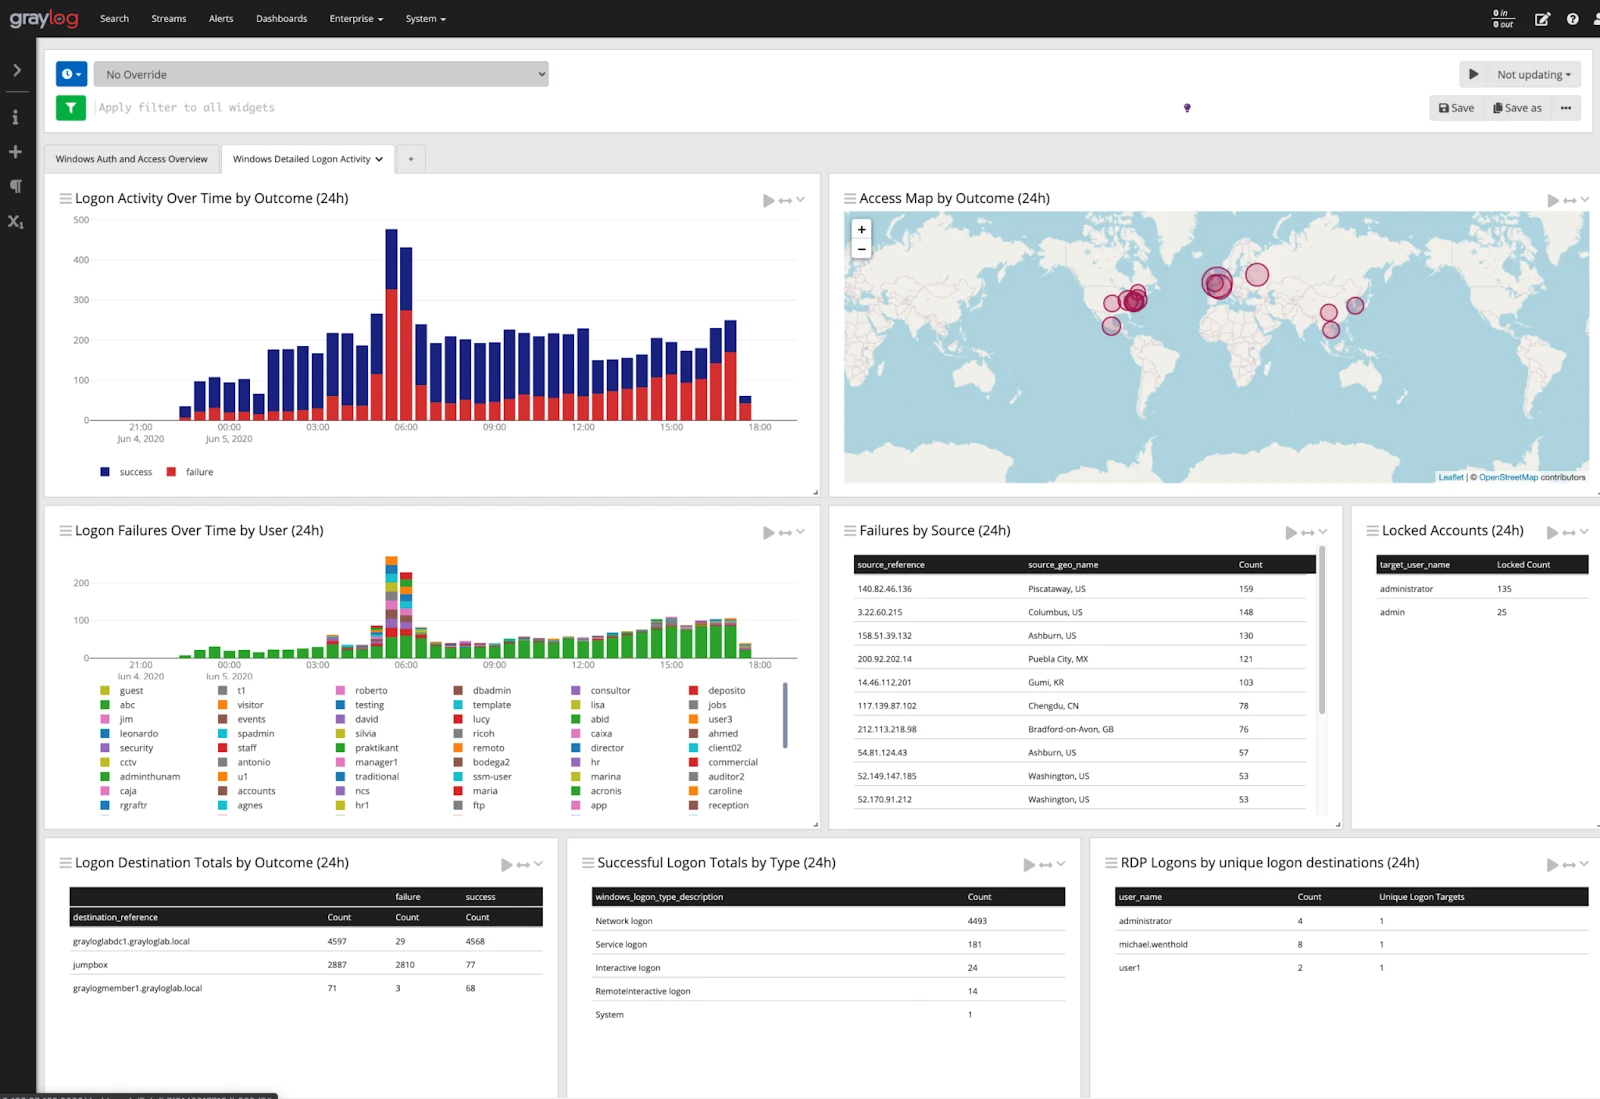
Graylog recibe datos de registros a través de entradas GELF (Graylog Extended Log Format), syslog, Beats o HTTP, los almacena en Elasticsearch u OpenSearch (mediante el nodo de datos de Graylog) y los hace buscables a través de una interfaz web. El sistema de flujos es fundamental para el funcionamiento de Graylog: los mensajes entrantes se enrutan a flujos según reglas, y las alertas, los pipelines y los controles de acceso se asocian a los flujos en lugar de a la capa de almacenamiento. Esto significa que puede tener un flujo para errores de aplicaciones enrutado a un equipo y un flujo separado para eventos de autenticación enrutado a seguridad, con diferentes políticas de retención y permisos en cada uno.
Los pipelines de procesamiento le permiten analizar, enriquecer, descartar o reescribir mensajes antes del almacenamiento. Si los registros de su aplicación llegan como texto no estructurado, escribe una regla de pipeline para extraer campos en datos estructurados. Graylog Illuminate (incluido en las ediciones de pago, disponible para Open con limitaciones) proporciona analizadores y paneles prediseñados para fuentes comunes: registros de eventos de Windows, Cisco, Palo Alto, AWS CloudTrail y otras.
- El mínimo del broker de Kafka es 2.1. Cualquier entrada de Kafka conectada a un broker más antiguo fallará después de la actualización.
- Los tokens de API ahora caducan después de 30 días de forma predeterminada. Cualquier automatización, integración de monitoreo o script que utilice un token de API de larga duración dejará de funcionar a menos que tenga una política de rotación de tokens. Esto suele aparecer como un incidente nocturno cuando algo deja de informar, en lugar de durante la propia actualización.
Características destacadas:
- Enrutamiento y procesamiento basados en flujos: El modelo de flujos le permite segmentar los datos de registros por origen, aplicación o nivel de sensibilidad en el momento de la ingesta, y luego aplicar diferentes pipelines, políticas de retención y controles de acceso por flujo. Esto es operativamente más flexible que los patrones de índice por origen de Elasticsearch.
- Extracción y análisis de registros: Los extractores extraen campos específicos de los mensajes de registro en la ingesta. Los pipelines de procesamiento manejan transformaciones más complejas, lógica condicional, búsquedas, cambio de nombre de campos y descarte de mensajes. Together le brindan un control detallado sobre lo que termina almacenado. Graylog Illuminate también incluyó correcciones de analizadores en 7.0.3, incluida una corrección en el análisis de marcas de tiempo de Apache HTTPD que producía valores de tiempo incorrectos.
- Búsqueda e investigación: La sintaxis de búsqueda de Graylog es más sencilla que Lucene/KQL para consultas básicas, lo que importa cuando necesita que un ingeniero de guardia busque registros a medianoche sin documentación de referencia. Las búsquedas guardadas, los rangos de tiempo relativos y las superposiciones de histogramas están disponibles sin complementos de pago.
- Gestión de usuarios con integración de AD/LDAP: La autenticación de Active Directory y LDAP es compatible con Graylog Open. Los controles de acceso basados en roles le permiten restringir qué flujos y paneles puede ver cada equipo.
Dónde tiene dificultades Graylog
El nivel gratis de Graylog tiene brechas significativas si su caso de uso son las operaciones de seguridad: el soporte de reglas Sigma, la detección de anomalías y la gestión de casos son de pago. La dependencia de Elasticsearch/OpenSearch añade una complejidad operativa similar a la del ELK Stack. A gran escala, el procesamiento de pipelines puede crear cuellos de botella de rendimiento que requieren un ajuste cuidadoso del orden de las etapas del pipeline y de la asignación de hilos de trabajo.
Elastic Stack (ELK Stack) – Logstash
Elastic Stack es un conjunto de productos de código abierto; sus componentes principales son Elasticsearch, Kibana y Logstash.
Cómo funciona el análisis de registros de ELK
Logstash es un pipeline de procesamiento de datos del lado del servidor. Recibe datos de registros de entradas (archivos, Beats, syslog, Kafka, HTTP y docenas de otros), aplica plugins de filtro para analizar y enriquecer los datos, y enruta la salida a uno o más destinos. La mayoría de las implementaciones envían la salida a Elasticsearch, pero Logstash puede escribir simultáneamente en S3, un SIEM, una cola de mensajes u otro clúster de Elasticsearch.
Elasticsearch almacena los datos de registro procesados y los hace buscables mediante un índice invertido. Es la razón por la que ELK escala a petabytes y aun así devuelve resultados de búsqueda inferiores a un segundo en consultas específicas, pero ese rendimiento proviene de la estructura del índice, lo que significa que las cargas de trabajo con mucha escritura requieren una gestión cuidadosa del ciclo de vida del índice. Kibana se sitúa sobre Elasticsearch y proporciona la capa visual: paneles, la vista Discover para búsquedas de registros ad hoc, Canvas para informes personalizados y Lens para visualizaciones de arrastrar y soltar.
- Búsqueda de texto completo a escala: La arquitectura de índice invertido de Elasticsearch admite búsquedas inferiores a un segundo en miles de millones de entradas de registro. KQL (Kibana Query Language) y ES|QL (el lenguaje de consulta basado en tuberías más nuevo en 9.x) ofrecen a los analistas dos interfaces de consulta diferentes según cómo prefieran trabajar. Para investigaciones de registros complejas en grandes datasets, nada en el espacio de código abierto iguala la profundidad de búsqueda de ELK.
- Ingesta y filtrado de múltiples fuentes: Logstash tiene alrededor de 200 plugins de entrada y 200 plugins de filtro. El filtro grok maneja texto no estructurado mediante patrones de captura con nombre; el filtro json maneja registros JSON estructurados; el filtro csv maneja datos tabulares. Varias etapas de filtro se ejecutan en secuencia, por lo que puede analizar una línea syslog sin procesar, extraer campos, buscar una IP en una base de datos GeoIP y descartar mensajes de nivel de depuración antes de que el evento llegue a Elasticsearch, todo en un único pipeline.
- Detección de anomalías de aprendizaje automático: Las funciones de ML de Kibana (de pago) identifican patrones inusuales en los datos de registro sin necesidad de definir umbrales. Son útiles para detectar ataques de evolución lenta o una degradación gradual del rendimiento que las alertas de umbral fijo pasan por alto.
- Paneles de Kibana: Las opciones de visualización de Kibana son amplias: series temporales, mapas, mapas de calor, tablas de datos, medidores y más. Las búsquedas guardadas y los patrones de índice permiten a los analistas compartir contextos de investigación entre equipos.
- Enrutamiento de salida extensible: Un único pipeline de Logstash puede escribir simultáneamente en Elasticsearch, un bucket de S3, un segundo clúster de Elasticsearch para recuperación ante desastres y un tema de Kafka para procesamiento posterior.
Dónde tiene dificultades ELK
La sobrecarga operativa es real. Los clústeres de Elasticsearch requieren planificación de memoria (el heap de la JVM necesita un dimensionamiento cuidadoso), gestión de shards (demasiados shards pequeños o muy pocos grandes perjudican el rendimiento) y configuración de políticas del ciclo de vida del índice para controlar los costes de retención.
La mayoría de los equipos que ejecutan ELK a escala terminan con un ingeniero de plataforma dedicado cuya responsabilidad principal es Elasticsearch. También vale la pena entender la situación de la licencia: los componentes de Elastic Stack están bajo la Elastic License 2.0, no bajo código abierto aprobado por OSI. El uso autohospedado es gratis, pero ofrecer Elasticsearch como servicio gestionado a terceros no está permitido en el nivel gratis.
Fluentd
Fluentd es un recopilador de datos de código abierto bajo la Apache License 2.0, diseñado para unificar la ingesta y el enrutamiento de registros en infraestructuras heterogéneas. Su tarea principal es sencilla: aceptar eventos de registro de los orígenes, aplicar un procesamiento opcional y enrutarlos a los destinos. Fluentd no almacena ni analiza registros por sí mismo; es un recopilador y enrutador, no una plataforma de análisis de registros1
Esa distinción importa al evaluarlo frente a Wazuh o Graylog. Fluentd suele ser la primera capa en un pipeline más grande. Una arquitectura común: los agentes de Fluentd en cada servidor recopilan registros de aplicaciones, del sistema y de contenedores, los almacenan en búfer localmente (para que no se pierda nada si el destino posterior no está disponible temporalmente), aplican análisis y filtrado, y reenvían el resultado a Elasticsearch, Splunk, un SIEM en la nube u otro backend de almacenamiento. El análisis ocurre en lo que recibe los datos.
Fluentd vs. Fluent Bit
Los equipos que evalúan Fluentd para entornos Kubernetes a menudo terminan eligiendo Fluent Bit, y vale la pena entender por qué. Fluent Bit es un forwarder ligero en el mismo ecosistema CNCF, aproximadamente un binario de 4 MB frente al proceso basado en Ruby de Fluentd que se ejecuta notablemente más pesado. Para implementaciones de Kubernetes donde se desea un recopilador de registros ejecutándose como DaemonSet en cada nodo, la diferencia en la huella de recursos es significativa a escala. Fluent Bit también admite el análisis de registros multilínea, la inyección dinámica de metadatos de etiquetas y anotaciones de pods de Kubernetes, y el manejo integrado de contrapresión para evitar la pérdida de datos cuando los destinos posteriores se ralentizan.
Fluentd es la mejor opción cuando necesita todo el ecosistema de 500+ plugins o una lógica de enrutamiento compleja que la biblioteca de plugins más pequeña de Fluent Bit no puede cubrir. Para la mayoría de las implementaciones nativas de Kubernetes que realizan un envío de registros sencillo, Fluent Bit es la opción práctica. Los proyectos comparten conceptos de configuración, por lo que cambiar entre ellos no es una reescritura completa.
Cómo maneja Fluentd los datos de registro
Fluentd modela los datos de registro como un flujo de eventos etiquetados. Cada evento tiene una etiqueta (una cadena separada por puntos como app.web o system.syslog), una marca de tiempo y un registro. Las etiquetas impulsan el enrutamiento: las directivas match de la configuración especifican qué etiquetas se envían a dónde, qué filtros se aplican y en qué orden. Varias salidas pueden coincidir con la misma etiqueta, por lo que puede enviar los mismos eventos a Elasticsearch y a un archivo de S3 simultáneamente.
El sistema de búfer es lo que hace que Fluentd sea confiable en producción. En lugar de escribir directamente en el destino, los eventos se acumulan en un búfer y se vacían en fragmentos a intervalos configurables o cuando el búfer alcanza un umbral de tamaño. Si el destino es inalcanzable, los eventos permanecen en el búfer y se reintentan con retroceso exponencial.
Características destacadas:
- 500+ plugins de la comunidad: Cubre integraciones con la mayoría de los principales destinos de registro y fuentes de datos sin desarrollo personalizado.
- Enrutamiento de datos flexible: Los eventos pueden enrutarse a múltiples destinos simultáneos, como archivos, RDBMS, NoSQL, IaaS, SaaS, y Hadoop, según reglas de enrutamiento basadas en etiquetas.
- Enfoque en procesamiento de registros: Fluentd está optimizado para el procesamiento y reenvío de registros a escala, lo que lo hace adecuado como capa de recopilación y enrutamiento delante de Elasticsearch u otros backends de almacenamiento, en lugar de como plataforma de análisis independiente.
 Añadir como fuente preferida
Syslog-ng
Syslog-ng es un programa de gestión de registros de código abierto que recopila, clasifica, transforma y enruta datos de registro de múltiples fuentes al almacenamiento o a plataformas posteriores. Su capacidad distintiva es el procesamiento estructurado: los registros pueden normalizarse a un formato consistente antes de reenviarse a sistemas como Apache Kafka o Elasticsearch.
Capacidades:
- Clasificar y estructurar registros mediante analizadores integrados como csv-parser
- Almacenar registros en archivos, colas de mensajes (AMQP) o bases de datos (PostgreSQL, MongoDB)
- Reenviar a plataformas de big data, incluyendo Elasticsearch, Apache Kafka o Hadoop
Características distintivas:
- Archivado automático de registros: Syslog-ng gestiona la rotación y el archivado de registros de forma nativa, incluida la compresión y la denominación de archivos con marca de tiempo. Para entornos con requisitos de cumplimiento de retención, esto reduce la necesidad de herramientas externas como logrotate superpuestas.
- Soporte de múltiples formatos de mensaje: RFC3164 (syslog tradicional), RFC5424 (syslog estructurado), JSON y formatos clave-valor se analizan de forma nativa. Syslog-ng puede recibir un mensaje RFC3164 y emitirlo como RFC5424 con campos de datos estructurados añadidos, lo que resulta útil al alimentar sistemas que esperan un formato syslog moderno.
- Transporte cifrado: El transporte syslog cifrado con TLS es compatible de forma nativa tanto para recepción como para reenvío. Esto es importante en entornos donde los datos de registro transitan por segmentos de red no confiables.
- Enrutamiento condicional: Las expresiones de filtro le permiten enrutar según cualquier campo analizado: gravedad, facility, host o campos personalizados extraídos por los analizadores. Una única instancia de syslog-ng puede enrutar fallos de autenticación al flujo del equipo de seguridad, errores de aplicaciones al flujo del equipo de desarrollo y mensajes de depuración a /dev/null.
Dónde encaja syslog-ng (y dónde no)
Syslog-ng es la opción correcta cuando sus fuentes de registro son principalmente dispositivos de red y servidores que hablan syslog, y cuando necesita una recopilación confiable y de alto rendimiento con extracción de campos estructurados antes de reenviar a un backend de almacenamiento. No es una plataforma de análisis de registros; no tiene interfaz de consulta, ni paneles, ni alertas integradas. Funciona como la capa de recopilación y enrutamiento delante de Elasticsearch o Graylog, no como una herramienta independiente.
Nagios
Una aclaración necesaria antes de continuar: Nagios Core es el proyecto de monitoreo de código abierto con licencia GPL, y se centra en el monitoreo de hosts, servicios y redes más que en el análisis de registros.[15] El producto descrito aquí es Nagios Log Server, un producto comercial independiente de Nagios Enterprises. Si busca específicamente una herramienta de análisis de registros de código abierto y sin costo, Nagios Log Server no lo es. Lo que ofrece es una plataforma de gestión de registros con soporte comercial de un proveedor con una larga trayectoria en monitoreo de infraestructura.
Nagios Log Server recopila datos de registro en tiempo real y los envía a una interfaz de búsqueda. Es compatible con servidores Windows, Linux y Unix e incluye un asistente de configuración para integrar nuevos endpoints o aplicaciones.2
Características destacadas:
- Monitoreo de servicios de red: Cubre SMTP, POP3, HTTP, PING y otros servicios de red con un enfoque en la salud de la infraestructura.
- Monitoreo de recursos del host: Rastrea la carga del procesador, la utilización del disco y la salud del sistema en los hosts monitoreados.
- Rotación y archivado de archivos de registro: Rotación automatizada y archivado a largo plazo sin intervención manual.
- Filtrado geográfico de registros: Filtra los datos de registro por origen geográfico y genera mapas de flujo de tráfico.
- Interfaz web: Interfaz opcional para ver el estado actual de la red y los archivos de registro.
Preguntas frecuentes
Las herramientas de análisis de registros de código abierto permiten a los usuarios recopilar, procesar, almacenar, buscar y analizar datos de registro de diversas fuentes, como servidores, aplicaciones y dispositivos de red. Estas herramientas pueden ayudar a SecOps, ITOps y DevOps a:
-Realizar resolución de problemas del sistema mediante el monitoreo de archivos de registro de transacciones.
-Aprovechar la respuesta e investigación de incidentes de seguridad para mantener un rendimiento óptimo de la base de datos o ejecutar análisis de comportamiento de usuarios y entidades (UEBA).
-Mantener el cumplimiento de auditorías, legislación y normas de seguridad especiales (GDPR).
Cita esta investigación
Elige el formato que se ajuste al lugar donde vas a publicar. Pegar la versión con enlace en tu CMS conserva el enlace de retroceso.
@misc{hafa2026,
  author = {Hafa, Adil and PhD., Ezgi Arslan,},
  title  = {{Las 6 mejores herramientas de análisis de registros de código abierto: Wazuh, Graylog y más}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/open-source-log-analysis-tools}},
  note   = {AIMultiple. Recuperado el 14 de septiembre de 2026}
}Resultados y marcas de tiempo de 18 puntos de datos. Descargue los datos resumidos que se muestran en los gráficos y las tablas de este artículo como un archivo ZIP que contiene 3 archivos CSV.
¿Quieres los datos granulares que hay detrás? Únete a Premium
Registro de cambios
6 actualizacionesAñadidas secciones de funcionamiento y limitaciones para Graylog, el ELK Stack, Fluentd y syslog-ng.
Actualizado el producto Wazuh con nuevas capacidades de detección y una política SCA.
Enlaces de referencia

Siguiente para leer
Mejores proveedores de LLM API de tarifa plana

Comparativa de proveedores de proxy IPv6 por precio y rendimiento

Top 20 Software y Tecnologías de GRC de IA

Las mejores 10 SaaS soluciones de copia de seguridad

Mejores herramientas de monitoreo de rendimiento de bases de datos: Comparación de las 5 mejores plataformas
Mejores 30+ agentes web de código abierto



Sé el primero en comentar
Tu dirección de correo electrónico no será publicada. Todos los campos son obligatorios. Los comentarios se dejan en su idioma original.