


Comparer les models d'IA multimodaux sur le raisonnement visuel

Nous avons réalisé un benchmark de 40 principaux models d'IA multimodaux sur le raisonnement visuel à l'aide de 200 questions basées sur des visuels. L'évaluation comprenait deux volets : 100 questions de compréhension de graphiques testant l'interprétation de visualisations de données, et 100 questions de logique visuelle évaluant la reconnaissance de motifs et le raisonnement spatial.
Benchmark de raisonnement visuel
Consultez notre méthodologie de benchmark pour connaître nos procédures de test.
Chaque model obtient un score plus faible en logique visuelle qu'en compréhension de graphiques. L'écart est le plus faible pour qwen3.8-flash (58 % contre 78 %) et le plus important pour claude-sonnet-4.5 (35 % contre 77 %).
- gemini-4-argon obtient le score le plus élevé dans les deux catégories : 62 % en logique visuelle et 87 % en compréhension de graphiques. Il se classe également premier au classement général avec 74,5 %, 1 point devant gemini-3.7-flash et claude-opus-5.5 (73,5 % chacun). Cela représente une différence de 2 questions sur 200, si bien que les trois premiers se tiennent à quelques questions près.
- gemini-3.5-flash-lite (36,5 %) et llama-4-maverick (38,5 %) sont derniers au classement général à cause de la logique visuelle. Ils répondent correctement à 22 % et 19 % de ces questions, et claude-haiku-4.5 répond à 20 %. Tous les trois se situent près des 20 % que donne une réponse au hasard avec cinq options. Sur les graphiques, ces trois mêmes models se classent également derniers, entre 51 % et 61 %.
Comparaison coût et latence
Questions du benchmark sur les domaines où les LLM excellent et rencontrent le plus de difficultés
Question de graphique avec le plus faible taux de réussite des LLM
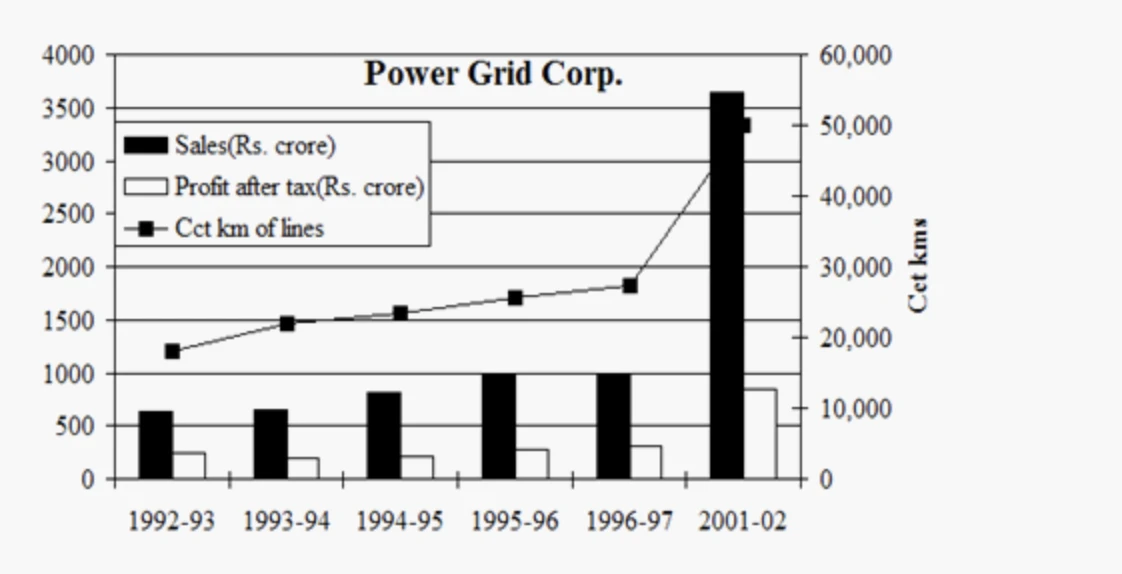
Figure 1 : Diagramme à barres de Power Grid Corp. montrant les ventes (barres noires) et le bénéfice après impôt (barres blanches) pour 1992-93 à 1996-97 et 2001-02, avec une ligne pour les kilomètres de circuit de lignes sur un second axe des ordonnées.
Remarque : Tous les graphiques proviennent de Hitbullseye.1
Question : La rentabilité (bénéfice / ventes) est la plus élevée en : A. 1992-93 B. 1993-94 C. 2001-02 D. 1996-97
Aucun des 40 models n'a répondu correctement (la réponse est D, 1996-97), et 38 d'entre eux ont choisi 1992-93. Le calcul se limite à une seule division par année, la difficulté réside donc dans la lecture du graphique.
Les barres de bénéfice sont petites et blanches, seulement quelques centaines de crore sur un axe allant de 0 à 4 000 avec des lignes de grille tous les 500. Les différences entre les années se réduisent à quelques pixels. Le second axe des ordonnées et la ligne superposée ajoutent du bruit visuel. Les models devaient comparer ces courtes barres blanches à des barres noires beaucoup plus hautes, et une petite erreur de lecture de la hauteur des barres suffisait à changer la réponse.
Question de graphique avec le plus haut taux de réussite des LLM
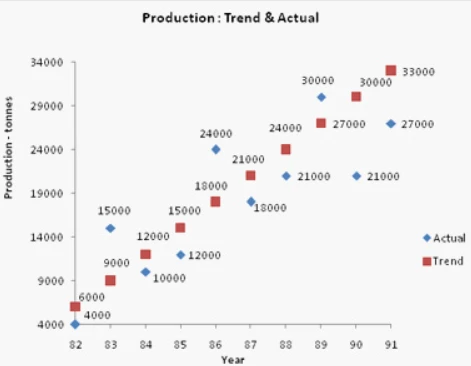
Figure 2 : Nuage de points montrant la production réelle et tendancielle (en tonnes) de 1982 à 1991. Les losanges bleus marquent les valeurs réelles, les carrés rouges marquent les valeurs de tendance, et chaque point est étiqueté avec sa valeur.
Question : La tendance a été établie comme suit : A. La production de cette année est une fois et demie celle de l'année dernière. B. La production de cette année est le double de celle de l'année dernière. C. La production de cette année est supérieure de trois mille tonnes à celle de l'année dernière. D. La production de cette année est supérieure de quatre mille cinq cents tonnes à celle de l'année dernière.
Tous les models ont répondu correctement à cette question. Les points de tendance augmentent du même montant chaque année (6 000, 9 000, 12 000, et ainsi de suite jusqu'à 33 000). Comme chaque point porte sa valeur sous forme d'étiquette, les models pouvaient lire les nombres directement au lieu d'estimer les positions par rapport à l'axe.
Le graphique de Power Grid nécessitait de comparer la hauteur de petites barres. Ici, aucune estimation de hauteur n'est nécessaire : les étiquettes donnent des valeurs exactes, et la seule étape restante est une simple soustraction.
Question de logique visuelle avec le plus haut taux de réussite des LLM
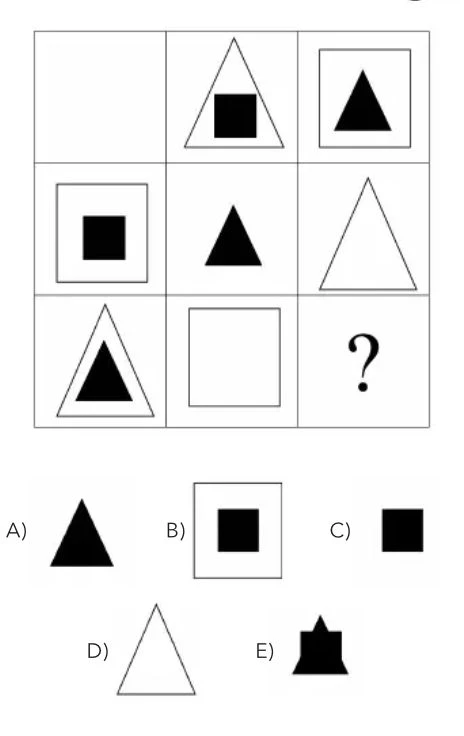
Figure 4 : Une grille 3×3 dans laquelle chaque cellule contient un triangle ou un carré blanc ou noir, seul ou imbriqué l'un dans l'autre. La cellule en bas à droite est manquante, et cinq options sont proposées.
Question : Quelle option complète la grille ?
38 des 40 models ont répondu correctement (la réponse est C, un carré noir). Seuls claude-haiku-4.5 et llama-4-maverick l'ont manquée. Chaque ligne et chaque colonne contient exactement une fois un triangle blanc, un carré blanc, un triangle noir et un carré noir. La pièce manquante peut donc être trouvée en listant ce qui est déjà présent.
Dans la grille d'hexagones, la règle dépendait de la manière dont les formes étaient divisées en régions. Ici, chaque élément est une forme distincte et clairement dessinée que les models peuvent identifier et compter.
Question de logique visuelle avec le plus faible taux de réussite des LLM
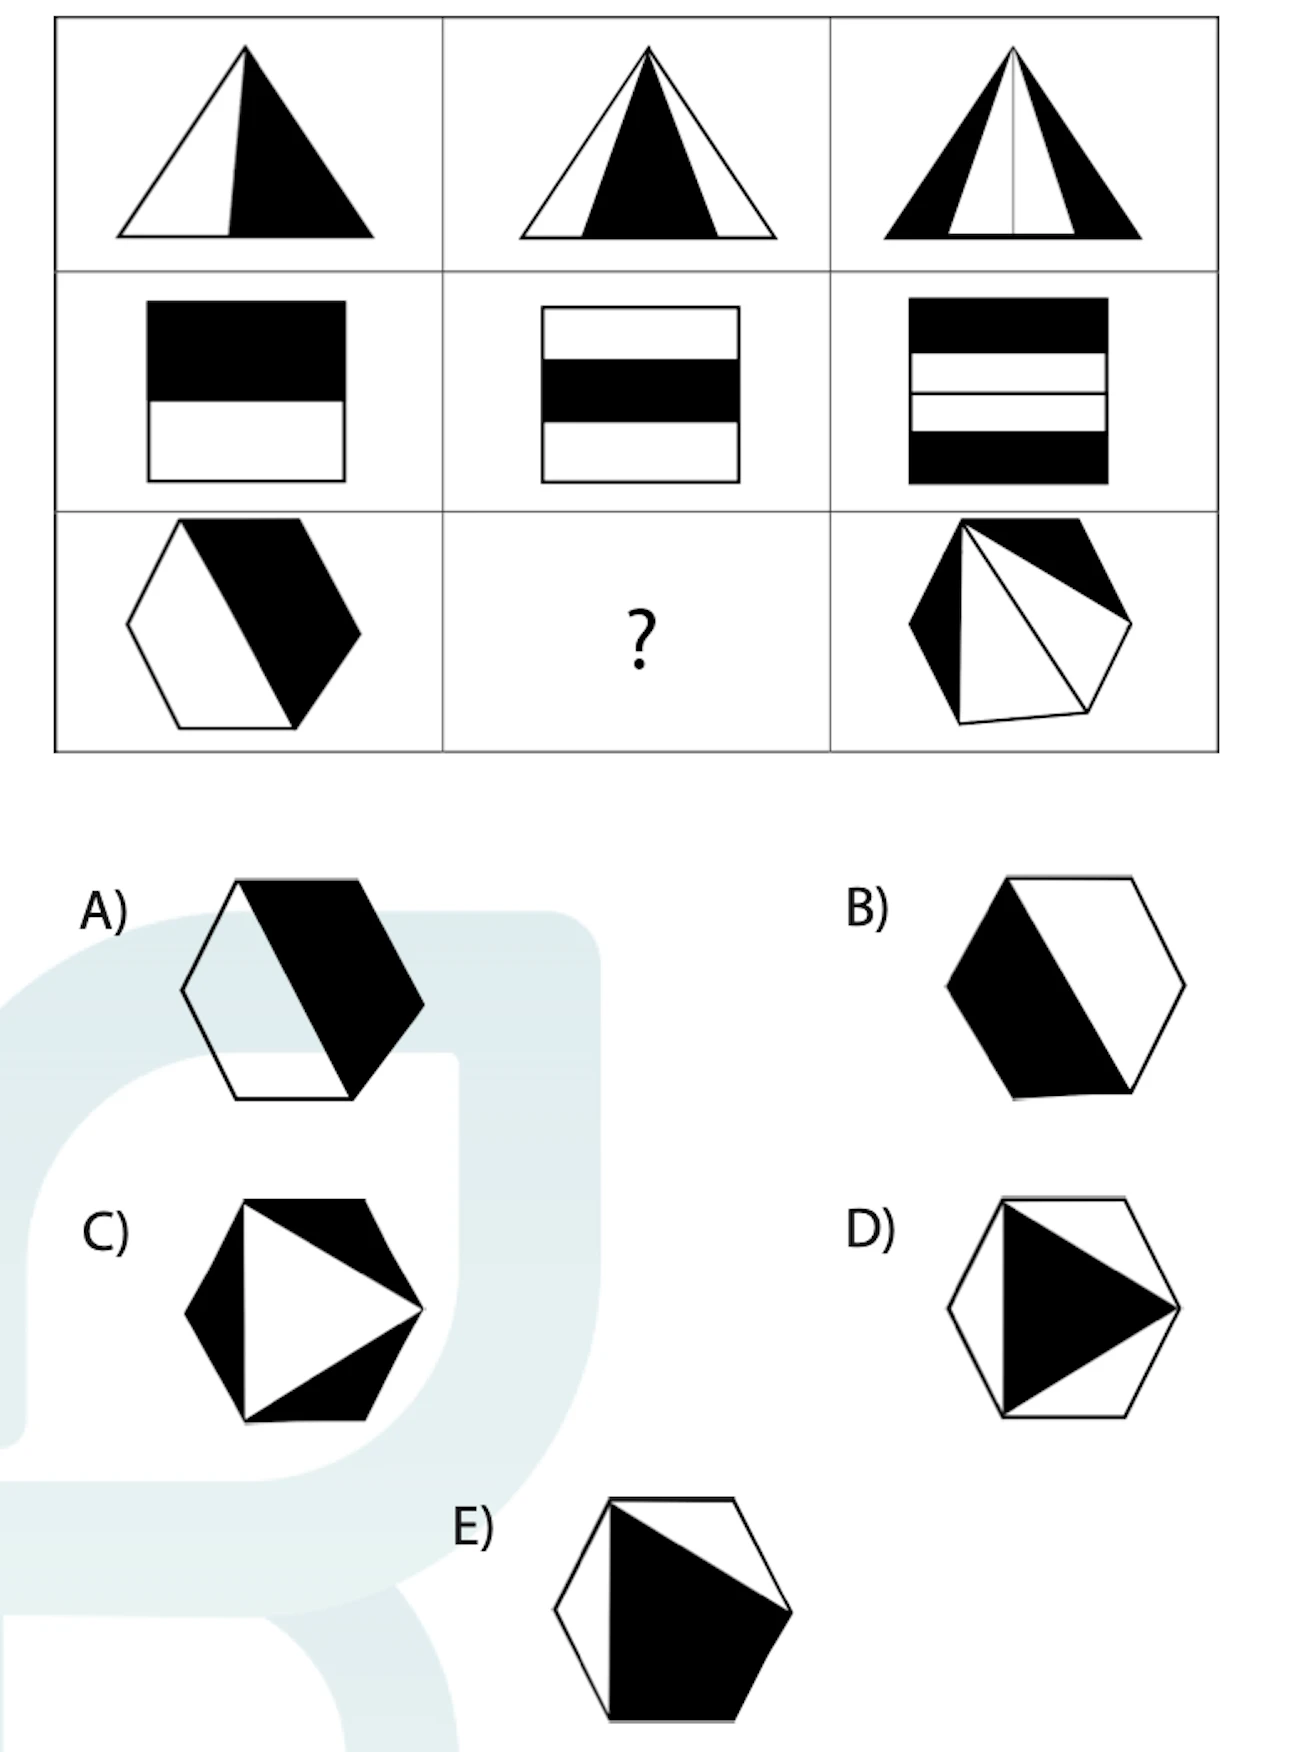
Figure 3 : Une grille 3×3 de formes : des triangles dans la première ligne, des rectangles dans la deuxième et des hexagones dans la troisième. Chaque forme est divisée en régions noires et blanches, et l'hexagone central est manquant. Cinq hexagones sont proposés en options.
Question : Quelle option complète la grille ?
Aucun des 40 models n'a répondu correctement. La question ne comporte ni nombres ni calculs ; la seule tâche consiste à observer comment les régions noires et blanches changent d'une ligne à l'autre.
Méthodologie du benchmark
Nous avons évalué 40 models capables de vision sur 200 questions à choix multiples basées sur des images.
- Raisonnement : Chaque model a été réglé sur l'effort de raisonnement le plus élevé qu'il prend en charge (max, xhigh ou high, selon le model). Pour certains models, aucun paramètre d'effort de raisonnement n'était accepté, donc la valeur par défaut du fournisseur s'appliquait :
- gemini-3.1-pro-preview, gemini-3.6-flash, gemini-3.7-flash, gemini-3.8-flash, gpt-5.2-pro et qwen3.8-flash raisonnaient encore par défaut.claude-haiku-4.5 et gemini-3.5-flash-lite n'ont produit aucun token de raisonnement.kimi-k2.5 n'a raisonné que sur 34 de ses 200 appels.
- Température : Non définie, donc la valeur par défaut de chaque fournisseur s'appliquait.
- Max tokens : Défini à 1 000 000 afin que la longueur de sortie ne limite pas le raisonnement. Si un fournisseur rejetait cette valeur, la limite de sortie maximale du model était utilisée.
- Exécutions : Chaque question a été exécutée une fois par model, pour un total de 7 600 appels.
- Nouvelles tentatives : Les appels échoués ont été relancés jusqu'à 3 fois, à 60 secondes d'intervalle. Sur 4 questions de logique visuelle, muse-wonder n'a jamais renvoyé de réponse : son fournisseur a fermé la connexion après environ 6.5 minutes à chaque tentative. Ces 4 questions comptent comme erronées, aucune question n'a donc été exclue.
- Coût et latence : Le coût est le montant facturé rapporté par la passerelle pour chaque appel. La latence est la durée de l'appel réussi, hors attentes liées aux nouvelles tentatives.
Le benchmark comprenait 200 questions réparties en deux catégories : compréhension de graphiques (100 questions) et logique visuelle (100 questions). Les questions de graphique envoient le graphique sous forme d'image, avec la question et les options sous forme de texte. Les questions de logique visuelle placent l'intégralité de la question, y compris les options, dans l'image. La plupart des questions de graphique ont quatre options (89 sur 100), et les autres en ont cinq ou moins. Les questions de logique visuelle ont cinq options (A-E).
Questions :
- Compréhension de graphiques (100 questions). Nous avons évalué les models sur leur capacité à extract, interpréter et analyser des informations issues de visualisations de données :
- Diagrammes à barres (40) : diagrammes à barres simples, groupés et à deux axes
- Nuages de points (26) : lecture de valeurs et de tendances à partir de points étiquetés
- Diagrammes circulaires (14) : répartitions en pourcentage et raisonnement proportionnel
- Graphiques linéaires (10) : tendances à une ou plusieurs séries dans le temps
- Affichages combinés (10) : un graphique présenté avec un second graphique ou un tableau de données
- Logique visuelle (100 questions). Nous avons évalué le raisonnement abstrait et l'intelligence spatiale à travers :
- Reconnaissance de motifs : identifier des séquences et compléter des motifs visuels
- Raisonnement spatial : transformations de formes et superposition de figures
- Logique mathématique : motifs numériques, raisonnement algébrique et combinatoire
- Pensée abstraite : manipulation de symboles, déduction logique et inférence de règles
 Ajouter comme source préférée
Citez ce benchmark
Choisissez le format qui correspond à votre lieu de publication. Coller la version avec lien dans votre CMS préserve le lien retour.
@misc{sipi2026,
  author = {Şipi, Nazlı},
  title  = {{Comparer les models d'IA multimodaux sur le raisonnement visuel}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/visual-reasoning}},
  note   = {AIMultiple. Consulté le 10 juin 2026}
}Résultats et horodatages de 22.9 mille points de données. Téléchargez les données de synthèse présentées dans les graphiques et les tableaux de cet article sous forme de fichier ZIP contenant 4 fichiers CSV et un README.
Vous voulez les données détaillées derrière ? Rejoindre Premium
Journal des modifications
6 mises à jourMise à jour du nombre de modèles évalués dans la section de référence du raisonnement visuel.
Remplacement du paramètre max tokens dans la méthodologie de benchmark.
Liens de référence






Soyez le premier à commenter
Votre adresse courriel ne sera pas publiée. Tous les champs sont obligatoires. Les commentaires sont laissés dans leur langue d'origine.