


El futuro de los grandes modelos de lenguaje

Vea el futuro de los grandes modelos de lenguaje comparando enfoques, como el autoentrenamiento, la verificación de hechos y la especialización dispersa, que podrían abordar las limitaciones de los LLM.
Tendencias futuras de los grandes modelos de lenguaje
1- Verificación de hechos en tiempo real con datos en vivo
Los LLM acceden a fuentes externas durante las conversaciones en lugar de depender de los datos de entrenamiento. El modelo consulta bases de datos externas, recupera información actualizada y proporciona citas.
Limitación: Sigue cometiendo errores. Las citas no garantizan la exactitud; los modelos a veces citan fuentes de forma incorrecta o malinterpretan el contenido citado.
Microsoft Copilot: Microsoft y OpenAI anunciaron que GPT-6 Astra está disponible en Copilot Cowork y Copilot Studio, así como en Microsoft Foundry y GitHub Copilot. El agente Researcher combina GPT para la investigación inicial con Anthropic y su modelo Claude, que revisa los resultados para garantizar la precisión y la calidad de las citas antes de la entrega, lo que supone una mejora del 13,8 % en el benchmark de investigación profunda DRACO con respecto a los sistemas independientes.1
- ChatGPT: Busca en la web cuando se le pregunta por acontecimientos recientes. Cita fuentes en sus respuestas.
- Perplexity: Creado específicamente para búsquedas con citas. Cada respuesta incluye enlaces a las fuentes.
2- Sintéticos datos de entrenamiento
Los modelos generan sus propios datasets de entrenamiento en lugar de requerir datos etiquetados por humanos.
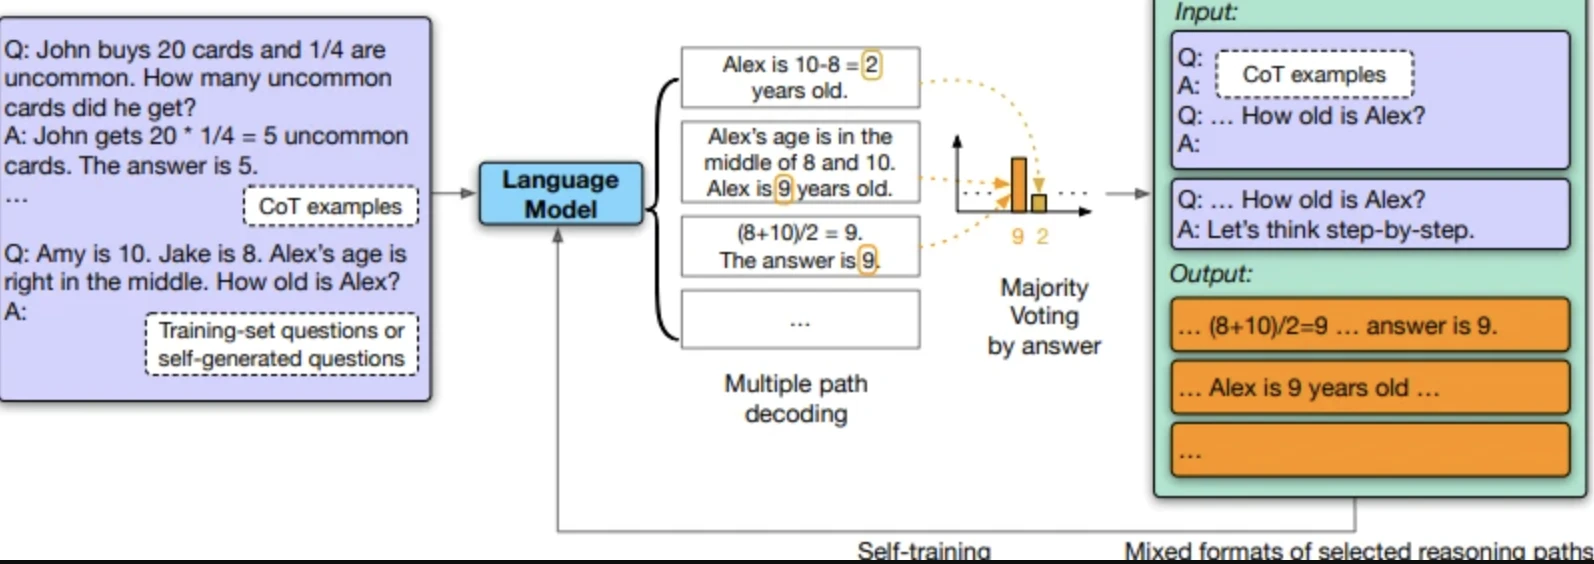
Modelo automejorable de Google (investigación de 2023):
- El modelo crea preguntas
- Selecciona respuestas
- Se afina a sí mismo con los datos generados
Rendimiento mejorado: del 74,2 % al 82,1 % en problemas de matemáticas GSM8K, y del 78,2 % al 83,0 % en comprensión lectora DROP.
OpenAI, Anthropic y Google están usando datos sintéticos para complementar los datasets etiquetados por humanos. Esto reduce los costes de etiquetado de datos, pero introduce nuevos riesgos de sesgo; los modelos pueden amplificar sus propios errores.
Fuente: “Los grandes modelos de lenguaje pueden automejorarse”
Una encuesta de marzo de 2026 reveló que el 76 % de los investigadores de IA cree que las ganancias derivadas de escalar la computación y los datos se han estancado, y los principales laboratorios informan de rendimientos decrecientes a pesar de las enormes inversiones. El hallazgo sugiere que el próximo salto en las capacidades de los LLM probablemente provenga de la innovación arquitectónica, como una mayor eficiencia del entrenamiento, arquitecturas dispersas o mejoras en el razonamiento, más que de seguir escalando los enfoques existentes.2
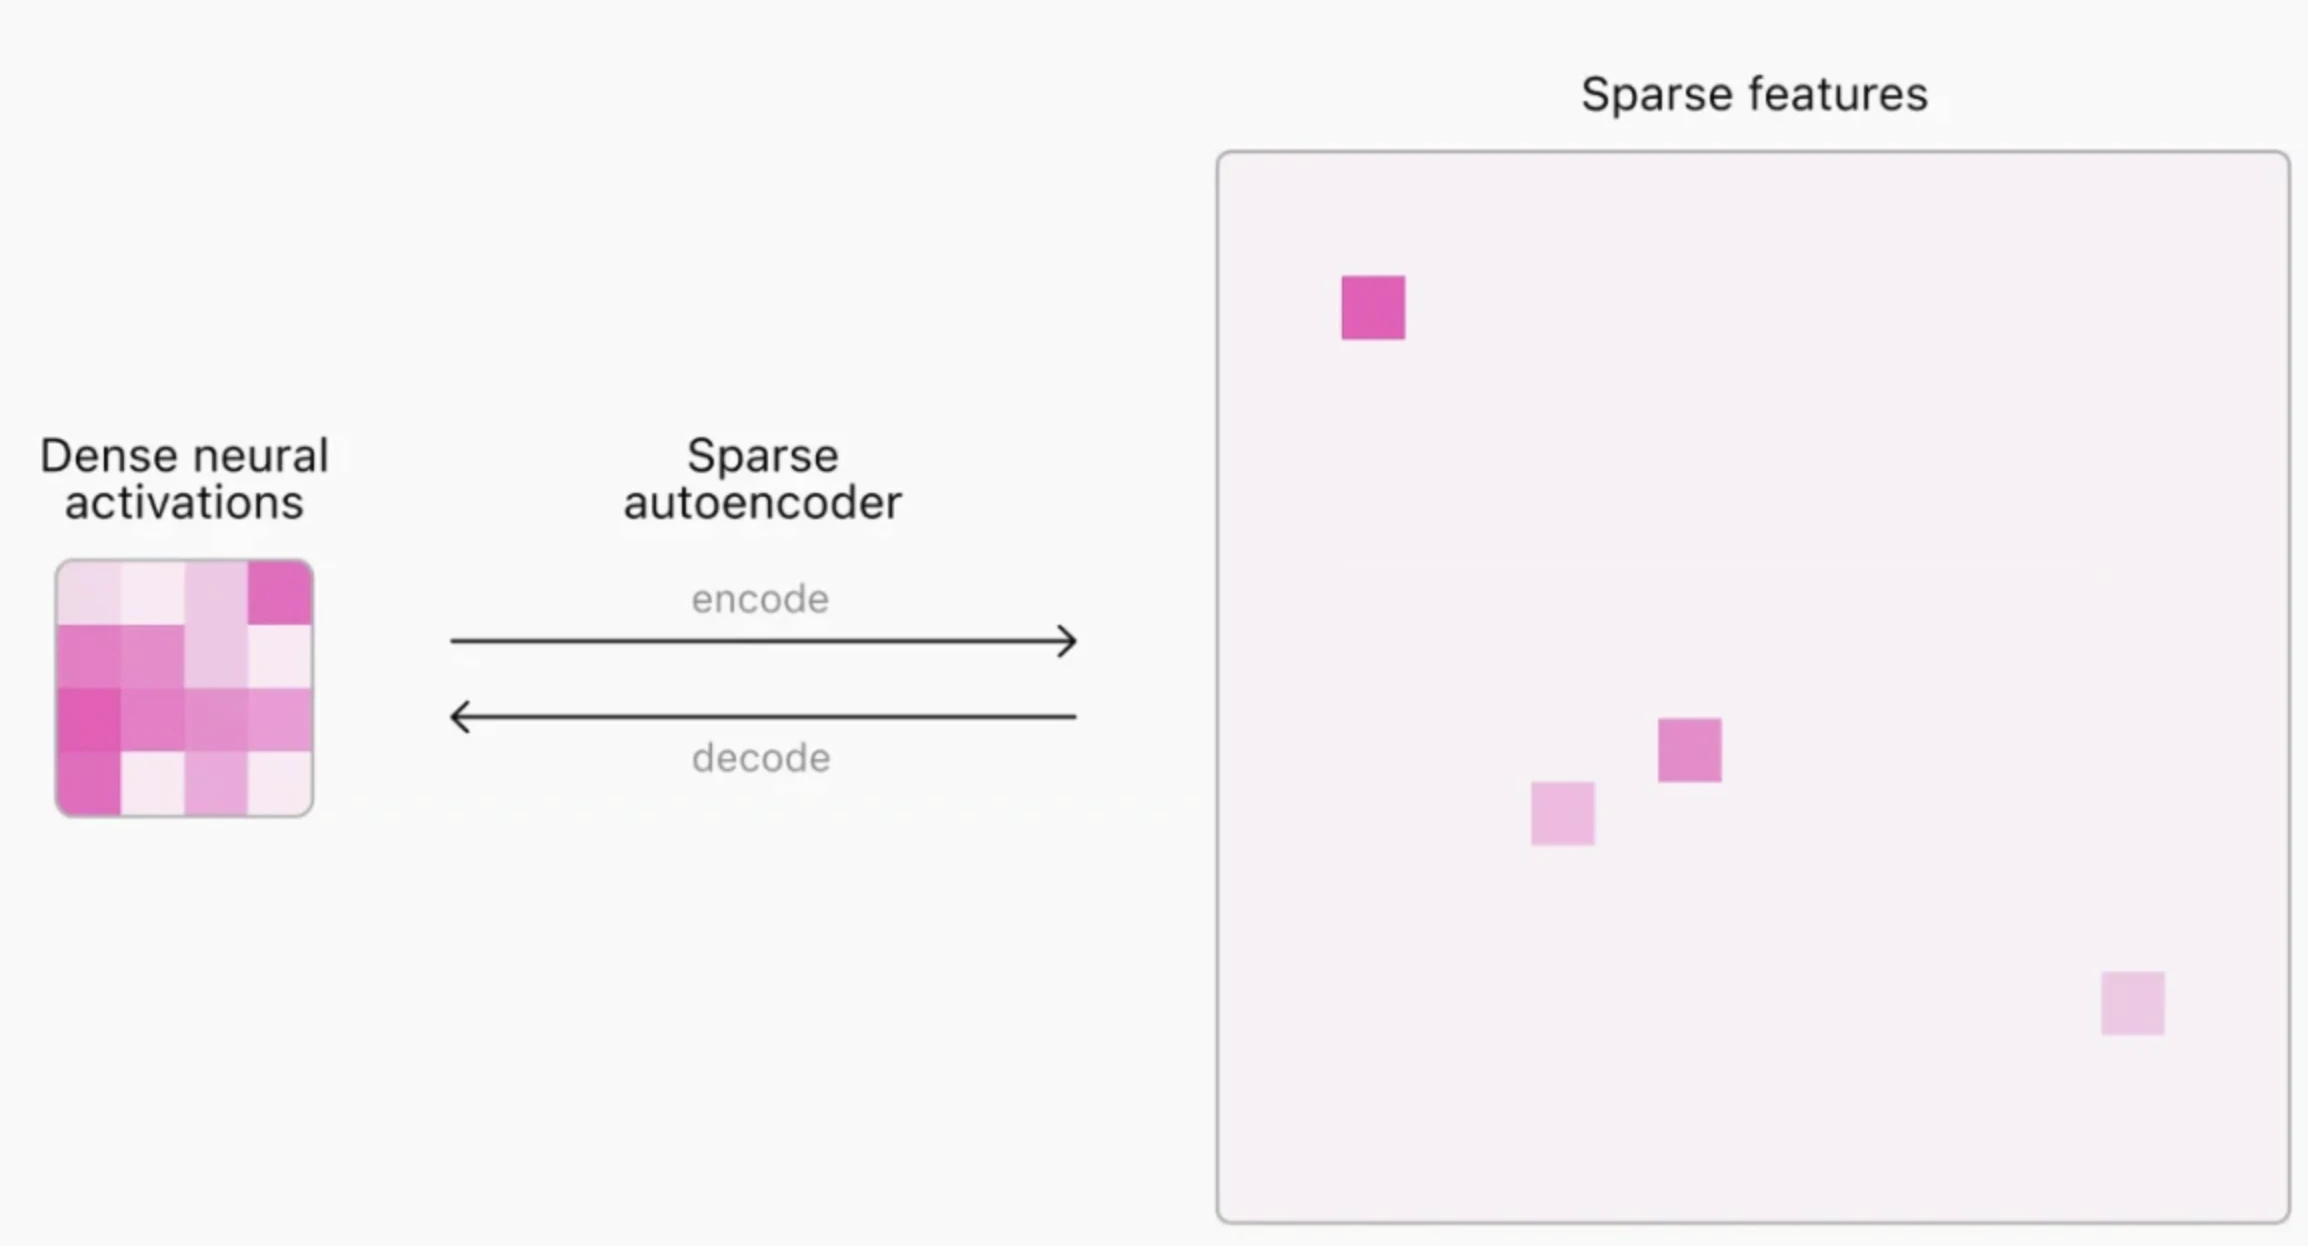
3- Modelos de expertos dispersos (mezcla de expertos)
En lugar de activar toda la red neuronal para cada entrada, se activa un subconjunto relevante de parámetros según la tarea. El modelo dirige la entrada a “expertos” especializados dentro de la red. Solo los expertos activados procesan la consulta.
Ejemplos reales:
- DeepSeek V4-Pro: Un modelo de mezcla de expertos con 1.6T parámetros totales y 49B activados, junto con el más pequeño DeepSeek-V4-Flash con 284B parámetros (13B activados), ambos con soporte para un contexto de un millón de tokens.3
- Qwen3.8-Max (Alibaba): Construido sobre la arquitectura Qwen 3.5, escala hasta 2.4 billones de parámetros con 95B activos, y es el primer modelo de clase Max de Qwen cuyos pesos Alibaba se comprometió a liberar en código abierto.
- Mistral Devstral 2: Diseñado específicamente para la ingeniería de software. 123B parámetros, ventana de contexto de 256K tokens, 72,2 % en SWE-bench.4Una variante más pequeña, Devstral Small 2 (24B parámetros), se ejecuta localmente bajo Apache 2.0. El modelo más reciente de Mistral es Mistral Large 4, un modelo multimodal de mezcla de expertos (MoE) de pesos abiertos con una ventana de contexto de 1M, lanzado en vista previa pública el 6 de octubre de 2026, con pesos previstos para finales de este mes.
4- Integración en flujos de trabajo empresariales
Los LLM se integran directamente en los procesos de negocio en lugar de utilizarse como herramientas independientes.
Ejemplos reales:
- Salesforce Agentforce (antes Einstein Copilot): Integra LLMs en las operaciones de CRM. Responde preguntas de los clientes, genera contenido y ejecuta acciones en Salesforce, fundamentado en los datos y metadatos de CRM de la organización a través de Einstein Trust Layer.5
- Microsoft 365 Copilot: Integrado en Word, Excel, PowerPoint y Outlook. Redacta documentos, analiza hojas de cálculo, genera presentaciones y resume hilos de correo electrónico, aprovechando los datos de la empresa a través de Microsoft Graph para fundamentar las respuestas en el contexto organizativo.6 El agente Researcher utiliza una arquitectura multimodelo en la que GPT se encarga de la investigación inicial y Claude revisa los resultados antes de la entrega: el primer despliegue comercial confirmado de proveedores de IA competidores dentro de un solo producto empresarial.
- Anthropic Claude para empresas: La separación de memoria basada en proyectos mantiene los contextos de trabajo diferenciados entre equipos. Claude Opus 4.6 introdujo equipos de agentes, lo que permite que varios agentes de Claude dividan tareas más grandes en flujos de trabajo paralelos, e integró Claude en PowerPoint como panel lateral nativo. La recomendación de Anthropic es comenzar con Claude Opus 5.5 para la mayoría de las cargas de trabajo y usar Claude Fable 5.1 para razonamiento exigente y trabajo agéntico de horizonte largo.7
5- Híbridos LLMs con capacidades multimodales
Los grandes modelos multimodales integran múltiples formas de datos, como texto, imágenes y audio, lo que les permite comprender y generar contenido en distintos tipos de medios.
- Gemini 3.8 Flash: Google lo describe como su modelo Flash más inteligente, diseñado para ingeniería de software de horizonte largo, agentes autónomos y flujos de trabajo empresariales complejos. El precio introductorio es de $0,75 por cada millón de tokens de entrada y $3,75 por cada millón de tokens de salida hasta el 31 de diciembre de 2026; el precio estándar de $1,50 y $7,50 comienza el 1 de enero de 2027. Google ha restringido los modelos más antiguos Gemini 2.5 a los usuarios que ya los usaban y dirige los proyectos nuevos a 3.5 Flash-Lite o 3.8 Flash.8
- Meta Muse Spark 1.3 y Muse Glimmer: Muse Spark, presentado el 8 de abril de 2026, sustituyó a la línea Llama de Meta. Muse Spark 1.3 tiene una ventana de contexto de 1M tokens y sus pesos permanecen cerrados, aunque Meta incluye una publicación de pesos abiertos en su hoja de ruta.9Para pesos abiertos, Muse Glimmer es un modelo de 30 mil millones de parámetros con un codificador de percepción dedicado, destilado de Muse Spark y diseñado para tareas agénticas en hardware de consumo, publicado bajo Apache 2.0.10
La capacidad multimodal es estándar en los modelos de frontera. El desafío restante es la coherencia: los modelos rinden bien en combinaciones habituales de imagen y texto, pero se degradan en contextos visuales poco frecuentes, entradas de baja resolución y razonamiento intermodal que requiere conectar evidencias visuales y textuales.
6- Modelos de razonamiento
Modelos que piensan los problemas paso a paso en lugar de generar respuestas inmediatas.
Este cambio de la predicción al razonamiento es fundamental para permitir:
- Comportamiento agéntico, donde los modelos planifican, ejecutan y adaptan tareas de forma autónoma.
- IA interpretable, donde los resultados son paso a paso y lógicamente sólidos.
- Claude familia 5.5 y Fable 5.1 (Anthropic): Los cuatro modelos ofrecen una ventana de contexto de 1M tokens, salida máxima de 128K, pensamiento adaptativo y un corte de conocimiento fiable de junio de 2026. Precio de la API por cada millón de tokens: Fable 5.1 a $10 de entrada / $50 de salida; Opus 5.5 a $4 / $20; Sonnet 5.5 a $2 / $10; y Haiku 5.5 a $0,10 / $0,50 para prompts de hasta 100.000 tokens.11
- GPT-6 Astra (OpenAI): El precio estándar de la API es de $10 por cada millón de tokens de entrada y $50 por cada millón de tokens de salida; un modo rápido se ejecuta hasta 2x más rápido a 2x el precio.12
7- Modelos específicos de dominio con fine-tuning
Modelos entrenados con datos especializados para industrias específicas en lugar de un entrenamiento de propósito general.
Google, Microsoft y Meta han publicado importantes modelos propietarios específicos de dominio y con fine-tuning dirigidos a casos de uso empresariales, además de sus ofertas de propósito general.
Estos LLM especializados pueden generar menos alucinaciones y una mayor precisión al aprovechar el preentrenamiento específico del dominio, la alineación del modelo y el fine-tuning supervisado.
GitHub Copilot: Ajustado con fine-tuning en repositorios de código. A julio de 2025, 20 millones de desarrolladores usan GitHub Copilot, un aumento interanual del 400 %, y el 90 % de las empresas Fortune 100 lo utiliza. Autocompleta código, genera funciones y sugiere correcciones de errores.13
BloombergGPT: 50 mil millones de parámetros LLM entrenado con un dataset de 363 mil millones de tokens de documentos financieros de Bloomberg, que supera a modelos de tamaño comparable en benchmarks de PLN financiero, incluyendo análisis de sentimiento, reconocimiento de entidades nombradas y respuesta a preguntas.14
Google y su Med-PaLM 2: Ajustado con fine-tuning en datasets médicos, alcanzó más del 85 % de precisión en preguntas tipo Examen de Licencia Médica de EE. UU. (USMLE), el primer LLM en alcanzar un rendimiento de nivel experto en este benchmark. Impulsa MedLM, la familia de modelos fundacionales de salud de Google Cloud.15
ChatLAW: Un modelo de lenguaje de código abierto entrenado específicamente con datasets del ámbito jurídico chino.16
8- IA ética y mitigación de sesgos
- Anthropic y OpenAI realizaron una evaluación mutua de alineación a mediados de 2025, probando los modelos públicos de cada uno en busca de adulación, tendencias a la denuncia y comportamientos de autopreservación. El ejercicio encontró adulación en todos los modelos evaluados, incluidos casos en los que los modelos validaron decisiones perjudiciales de usuarios simulados con creencias delirantes. Posteriormente, Anthropic desarrolló el framework de pruebas Bloom específicamente para evaluar este comportamiento en modelos nuevos.
- Anthropic también publicó Claude Mythos Preview (Project Glasswing), un modelo solo por invitación disponible para un pequeño conjunto de organizaciones específicamente para encontrar y corregir vulnerabilidades de ciberseguridad en los principales sistemas operativos y navegadores web. Anthropic ha declarado que no tiene previsto hacer público este modelo. El enfoque de acceso controlado representa un nuevo framework para desplegar modelos especializados de alta capacidad cuando el perfil de riesgo exige un despliegue restringido. La página de precios de la API de Anthropic también incluye Claude Mythos 5.1 entre sus modelos adicionales, a $10 de entrada / $50 de salida por cada millón de tokens.
- Google DeepMind: Publicó “La ética de los asistentes de IA avanzados”, ofreciendo el primer tratamiento sistemático de las cuestiones éticas y sociales que plantean los agentes de IA, y que abarca la alineación de valores, los riesgos de manipulación, el antropomorfismo, la privacidad y la equidad. La evaluación de IA responsable de la compañía incluyó más de 350 ejercicios adversarios de red team y presentó un nuevo Nivel de Capacidad Crítica específicamente para la manipulación perjudicial, tratándola como un riesgo de nivel frontera junto a los ciberataques y las amenazas NRBQ.
Limitaciones de los grandes modelos de lenguaje (LLMs)
1- Alucinaciones
Los modelos generan información que suena plausible pero es incorrecta.
El leaderboard de alucinaciones de Vectara es el benchmark de resumen fundamentado más citado de la industria. En el dataset original de Vectara, los modelos Gemini de Google ocupan sistemáticamente los primeros puestos, y las variantes Gemini Flash logran tasas de alucinación inferiores al 1 %. La familia GPT de OpenAI se sitúa entre el 0,8 % y el 2,0 %.
Vectara lanzó un benchmark significativamente más difícil a finales de 2025: 7.700 artículos (frente a 1.000), documentos más largos de hasta 32K tokens y contenido que abarca derecho, medicina, finanzas y tecnología. Los hallazgos en el nuevo dataset revelan un patrón contraintuitivo: los modelos de razonamiento y pensamiento que destacan en tareas complejas a menudo alucinan más en el resumen fundamentado que los modelos más pequeños y rápidos. La mayoría de los modelos de clase pensante muestran tasas de alucinación superiores al 10 % en el dataset más difícil, mientras que modelos más ligeros como las variantes Gemini Flash mantienen tasas más bajas.17
Nota: Ningún benchmark aislado ofrece una “tasa de alucinación” definitiva para ningún modelo. Una evaluación responsable cruza al menos dos benchmarks que miden cosas diferentes: una tarea fundamentada (Vectara) y una tarea de conocimiento abierto, y especifica la versión exacta del modelo y las condiciones de llamada.
Todos los modelos alucinan. La frecuencia se ha reducido sustancialmente, de aproximadamente el 21 % en 2021 a menos del 5 % para los mejores en benchmarks estándar, pero no se ha eliminado. Las aplicaciones críticas aún requieren verificación humana.
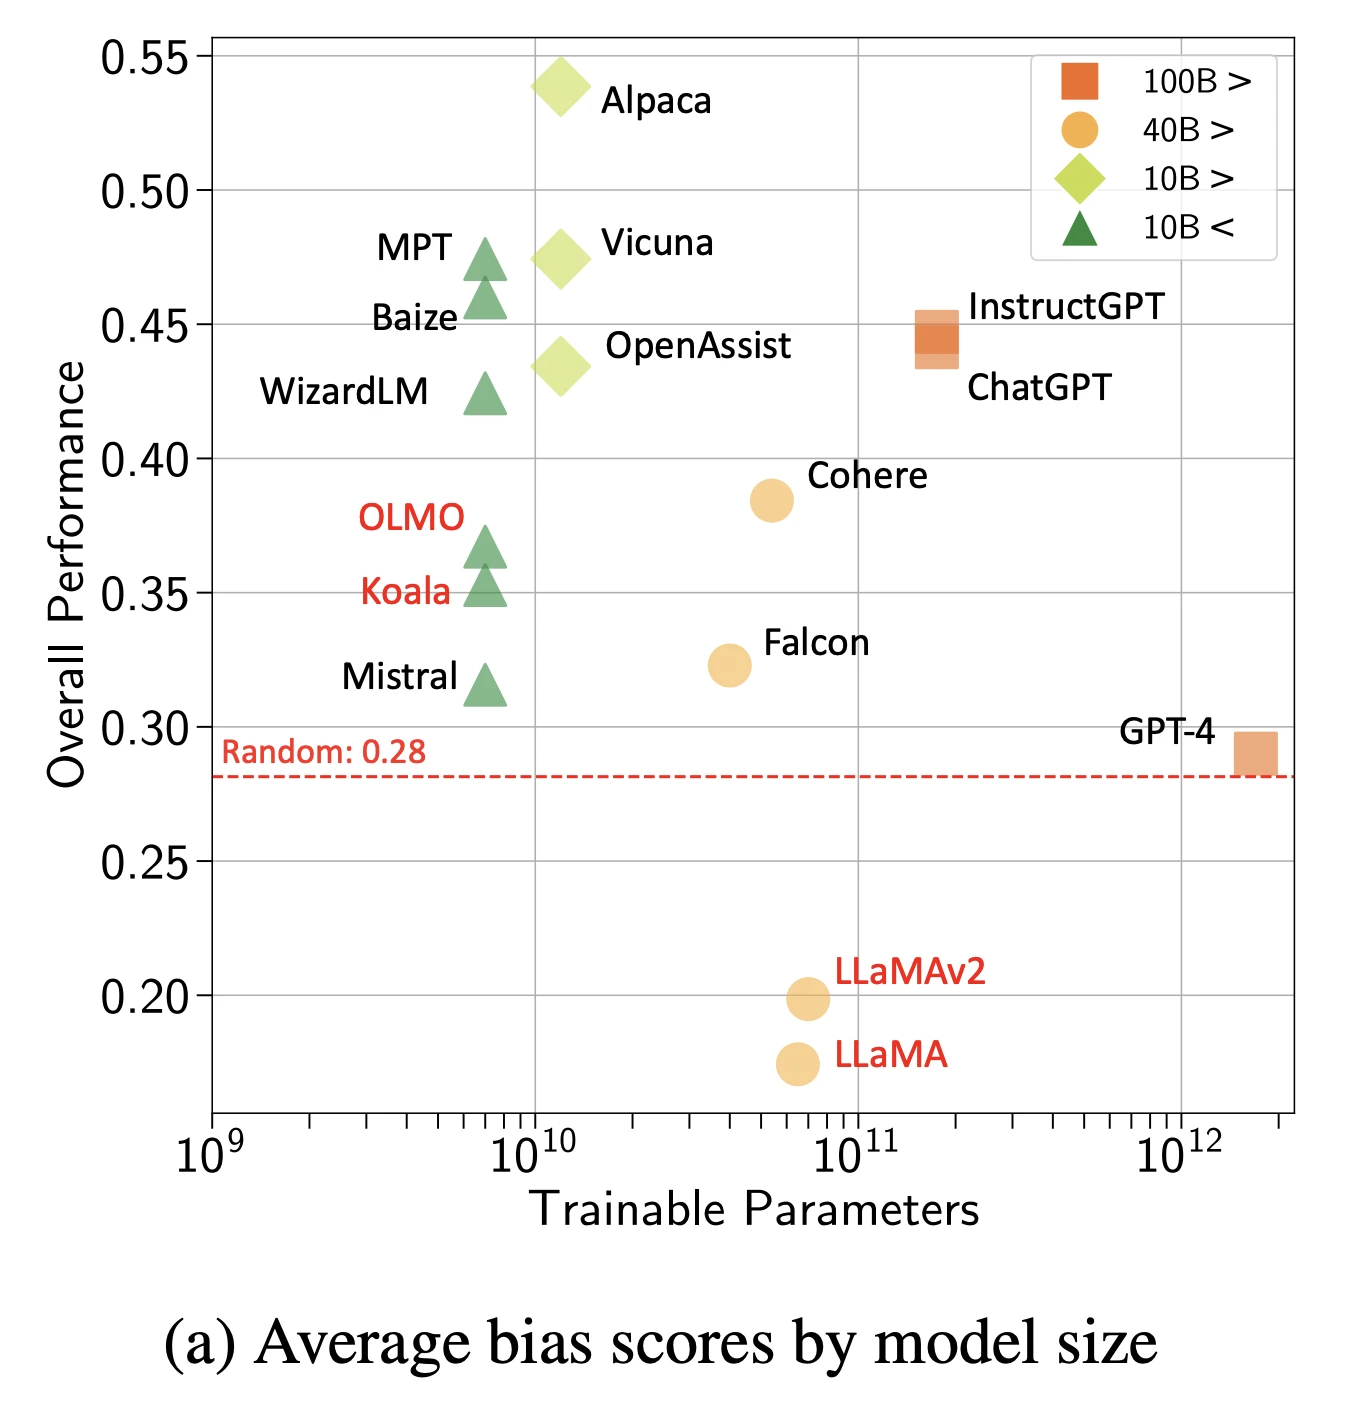
2- Sesgo
Los modelos absorben y amplifican los sesgos sociales de los datos de entrenamiento.
Fuente: Puntuaciones generales de sesgo por modelos y tamaño.18
Tipos de sesgo observados:
- Sesgo de género en las sugerencias de ocupaciones
- Sesgo racial en las simulaciones de selección de currículums
- Sesgo de edad en las recomendaciones sanitarias
- Sesgo socioeconómico en el contenido educativo
3- Toxicidad
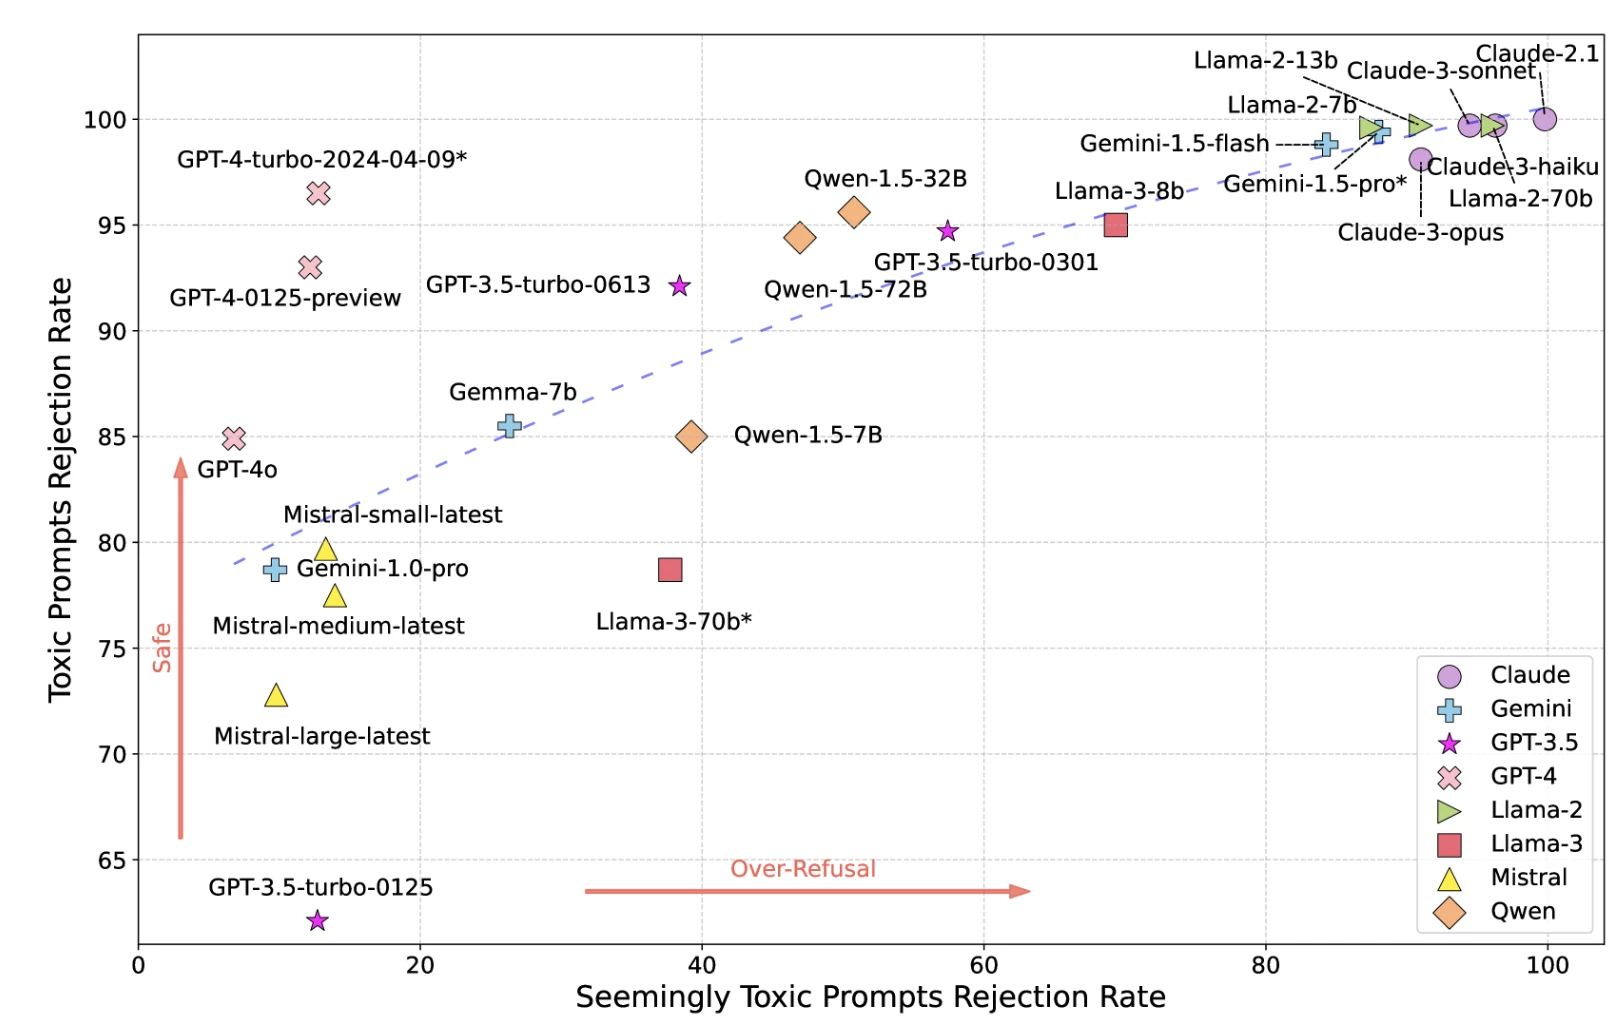
Los modelos pueden generar contenido dañino, ofensivo o tóxico a pesar de las medidas de seguridad.
Fuente: LLMs: mapa de toxicidad de investigadores de UCLA y UC Berkeley19
*GPT-4-turbo-2024-04-09*, Llama-3-70b* y Gemini-1.5-pro* se utilizan como moderador, por lo que los resultados podrían estar sesgados en estos 3 modelos.
Las medidas de seguridad estrictas reducen la toxicidad, pero aumentan los falsos positivos (rechazar solicitudes inofensivas). Las medidas laxas dejan pasar la toxicidad.
4- Limitaciones de la ventana de contexto
Cada modelo tiene una capacidad de memoria fija: el número de tokens que puede procesar en una sola sesión. Si se supera ese límite, el modelo trunca el contenido anterior o rechaza la solicitud. La diferencia práctica entre modelos es lo bastante amplia como para importar en cargas de trabajo reales.
- Llama 4 Scout (Meta): 10M tokens, la mayor ventana de contexto entre los principales lanzamientos de pesos abiertos. Meta ha trasladado desde entonces su trabajo de frontera a la línea Muse, por lo que Scout ya no recibe actualizaciones.
- Claude Opus 5.5, Sonnet 5.5, Haiku 5.5, Fable 5.1: Ventana de contexto de 1M tokens y salida máxima de 128K en los cuatro modelos. Claude 4.6 y los modelos posteriores (excepto Haiku 5.5) facturan la ventana completa de 1M a tarifas estándar.
- GPT-6.1 Sol: Ventana de contexto de 1.050.000 tokens. OpenAI cobra tarifas más altas por las solicitudes de contexto largo en sus modelos estrella.20
- Gemini 4 Argon: Google aumentó el límite de tokens de salida a 1M tokens, frente a 64K.21
- DeepSeek V4.1 Flash y V4-Pro: Contexto de 1M, salida de hasta 384K.22
Una ventana de contexto grande no implica automáticamente un mejor rendimiento en toda ella. La recuperación se degrada hacia la mitad de contextos largos en la mayoría de los modelos, y los costes escalan con la longitud de entrada: procesar 1M tokens cuesta significativamente más que procesar 10K tokens en el mismo modelo. Para la mayoría de las cargas de trabajo de producción, la cuestión práctica no es qué modelo tiene la ventana más grande, sino qué modelo recupera de forma fiable en las longitudes de contexto que realmente requiere tu caso de uso.
5- Corte estático de conocimiento
Los modelos dependen de conocimiento preentrenado con una fecha de corte específica. No tienen acceso a información posterior al entrenamiento salvo que estén conectados a fuentes externas.
Problemas:
- Información desactualizada sobre acontecimientos actuales
- Incapacidad para manejar novedades recientes
- Menor relevancia en ámbitos dinámicos (tecnología, finanzas, medicina)
Solución: Integración con búsqueda web. ChatGPT, Claude y Perplexity ofrecen búsqueda en tiempo real. Pero la búsqueda no elimina las alucinaciones; los modelos a veces malinterpretan los resultados de búsqueda.
Principales plataformas de LLM
GPT-6
GPT-6 Astra estuvo disponible para el público general el 4 de septiembre de 2026; GPT-6 Sol y GPT-6 Luna le siguieron el 22 de septiembre de 2026.
Sus mayores mejoras están en la programación, el uso de ordenadores, el razonamiento científico y la ciberseguridad, con avances especialmente grandes en benchmarks difíciles de resolución de problemas. También sigue las instrucciones de forma más fiable y comete menos errores.
GPT-6.1 Sol está disponible para usuarios Plus, Pro, Business, Enterprise y Edu a través de ChatGPT Work y Codex, pero aún no en las conversaciones habituales de ChatGPT; los desarrolladores acceden a él como gpt-6.1-sol.
Precios de la API (estándar, por cada millón de tokens): gpt-6-astra $10 de entrada / $50 de salida; gpt-6.1-sol $2 / $10; gpt-6-luna $0,10 / $0.50.
Limitaciones: Astra comparte el precio base más alto de esta lista con Claude Fable 5.1, de $10/$50 por cada millón de tokens. OpenAI afirma que Astra alcanza el umbral crítico de ciberseguridad de su Preparedness Framework, y la versión de lanzamiento rechaza tareas cibernéticas avanzadas, como escribir exploits de prueba de concepto. Sigue alucinando y sigue necesitando búsqueda web para cualquier cosa posterior a su corte de entrenamiento.12
Claude Fable 5.1 / Opus 5.5 / Sonnet 5.5 / Haiku 5.5
Anthropic posiciona Fable 5.1 para el razonamiento exigente y el trabajo agéntico de horizonte largo; Opus 5.5 para el coding agéntico de larga duración y el trabajo del conocimiento; Sonnet 5.5 como el equilibrio entre velocidad e inteligencia, y Haiku 5.5 para tareas de gran volumen y sensibles a la latencia, como la clasificación y el enrutamiento.
Precios por cada millón de tokens: Fable 5.1 $10/$50, Opus 5.5 $4/$20, Sonnet 5.5 $2/$10, Haiku 5.5 desde $0,10/$0.50.
Limitaciones: Claude 4.7 y los modelos posteriores utilizan un tokenizador más nuevo que produce aproximadamente un 30 % más de tokens para el mismo texto, lo que aumenta el coste efectivo en comparación con los precios de lista.
Gemini 3.8 Flash / Gemini 4 Argon
Google presentó Gemini 3.8 Flash, un modelo más rápido y de menor coste centrado en coding complejo, flujos de trabajo autónomos y razonamiento, junto con Flash Cyber, un modelo especializado en ciberseguridad.
Flash obtiene un 54,9 % en HLE-Verified y cuesta $0,75 por cada millón de tokens de entrada y $3,75 por cada millón de tokens de salida hasta finales de 2026, aunque las tareas complejas pueden consumir más tokens.
Flash Cyber logra más del 70 % de éxito en el benchmark interno de descubrimiento de vulnerabilidades de Google y un 47,2 % en un benchmark externo de parcheo, con acceso restringido a defensores de confianza.
Precios: $0,75 por cada millón de tokens de entrada y $3,75 por cada millón de tokens de salida tokens.23
El modelo Gemini 4 Argon de Google se centra en tareas complejas y de larga duración de ingeniería de software, finanzas, trabajo jurídico y ciberseguridad. Admite hasta 1 millón de tokens de salida, obtiene un 77,9 % en DeepSWE y un 51,3 % en AutomationBench, y puede descubrir y parchear vulnerabilidades de seguridad de forma autónoma. Google informa de que lo utiliza internamente para migraciones de código a gran escala y optimizaciones de centros de datos.
Precios desde $2 por cada millón de tokens de entrada y $10 por cada millón de tokens de salida, el doble tras el período introductorio. El acceso está actualmente restringido a evaluadores de confianza y defensores de ciberseguridad.21
Meta Muse Spark 1.3 / Muse Glimmer
Meta y su modelo Muse Spark 1.3 se centran en mejorar los agentes de IA para flujos de trabajo largos y complejos y tareas de coding. En comparación con la versión 1.2, las pruebas internas de ingeniería de Meta muestran un 20 % menos de llamadas a herramientas y un 25 % menos de tokens para tareas de coding. Meta también informa de una mayor resistencia a las inyecciones de prompts y un mejor criterio ante acciones irreversibles.
El modelo está disponible a través de Muse Code y la Meta Model API, con pesos abiertos previstos para una futura publicación.24
Pesos abiertos: Muse Glimmer es un modelo abierto de 30B parámetros, con licencia Apache 2.0, que se ejecuta en una sola GPU y está ajustado para el uso de herramientas, tareas largas y recuperación de fallos.
Quién lo usa: Muse Spark se adapta a equipos que ya están en el ecosistema de Meta y desean acceso a la API. Muse Glimmer se adapta a despliegues locales y on-premise, y a desarrolladores que evitan la dependencia de un proveedor.
Limitaciones: Los pesos de Muse Spark están cerrados. Los modelos Llama 4 siguen siendo descargables, pero ya no son la línea de frontera de Meta.
DeepSeek V4
V4-Pro es un modelo de mezcla de expertos con 1.6T parámetros totales y 49B activados, con un contexto de un millón de tokens.
El 10 de septiembre de 2026, DeepSeek lanzó V4.1-Flash, el modelo más pequeño de su familia de arquitecturas, con comprensión visual multimodal nativa. V4.1 Flash admite visión, pero V4-Pro no.25
Precios de la API (por cada millón de tokens, horas punta): V4.1 Flash cuesta $0,30 de entrada (fallo de caché) y $1,20 de salida; V4-Pro cuesta $1,32 de entrada y $3,96 de salida. Las tarifas fuera de horas punta son la mitad.22
Cita esta investigación
Elige el formato que se ajuste al lugar donde vas a publicar. Pegar la versión con enlace en tu CMS conserva el enlace de retroceso.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Ermut, Sıla},
  title  = {{El futuro de los grandes modelos de lenguaje}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/future-of-large-language-models}},
  note   = {AIMultiple. Recuperado el 25 de junio de 2026}
}
Registro de cambios
12 actualizacionesEliminado el gráfico de referencia de alucinaciones para LLMs populares.
Se añadió una sección de metodología de referencia que detalla los modelos evaluados y la puntuación.
Reemplazados GPT-5.2, Gemini 3.1 Pro y DeepSeek V3.2 por GPT-5.5, Gemini 2.5 Pro, DeepSeek V4 y Claude Opus 4.7.
Actualizados los datos de 'Ejemplos de la vida real' en la sección 'Domain-Specific Fine-Tuned Models'.
Actualizada la sección "Tendencias futuras de los grandes modelos de lenguaje" con nuevos ejemplos de verificación de hechos en tiempo real.
Enlaces de referencia
El trabajo de Cem en AIMultiple ha sido citado por publicaciones líderes mundiales como Business Insider, Forbes, Morning Brew y Washington Post, empresas globales como Deloitte y HPE, ONG como World Economic Forum y organizaciones supranacionales como European Commission. [1], [2], [3], [4], [5]
A lo largo de su carrera, Cem trabajó como consultor tecnológico, comprador de tecnología y emprendedor tecnológico. Asesoró a empresas en sus decisiones tecnológicas en McKinsey & Company y Altman Solon durante más de una década. También publicó un informe de McKinsey sobre digitalización.
Dirigió la estrategia tecnológica y las adquisiciones de una empresa de telecomunicaciones reportando al CEO. También lideró el crecimiento comercial de la empresa de deep tech Hypatos, que alcanzó unos ingresos recurrentes anuales de 7 dígitos y una valoración de 9 dígitos desde 0 en 2 años. El trabajo de Cem en Hypatos fue cubierto por publicaciones tecnológicas líderes como TechCrunch y Business Insider.
Cem participa habitualmente en conferencias internacionales de tecnología. Se graduó en Bogazici University como ingeniero informático y tiene un MBA de Columbia Business School.

Anteriormente trabajó como reclutadora en empresas de gestión de proyectos y consultoría. Sıla tiene un máster en Psicología Social y una licenciatura en Relaciones Internacionales.




Comentarios 1
Comparte tus ideas
Tu dirección de correo electrónico no será publicada. Todos los campos son obligatorios. Los comentarios se dejan en su idioma original.
Insightful read! The future of large language models looks incredibly promising. It’s exciting to see how they’ll keep transforming the way we work and communicate. Loved the detailed explanation in the article.