


Grandes models multimodales (LMMs) vs LLMs

Evalúa LLMs y LMMs comparando sus puntuaciones de benchmark y la latencia en el mundo real haciendo clic en el nombre del model en la tabla siguiente. También puedes sopesar sus precios de entrada y salida para juzgar la eficiencia y el valor generales.
Grandes models multimodales de pesos abiertos
*Audio es nativo solo en los models E2B, E4B y 12B.
Gemma 4 (Google DeepMind)
Disponible en cinco tamaños: E2B, E4B, 12B, 26B A4B y 31B. La familia procesa texto e imágenes con relaciones de aspecto y resoluciones variables en todos los models. También admite vídeo y audio, con audio nativo en los models E2B, E4B y 12B.1
La variante 12B es la más notable desde el punto de vista arquitectónico. Google sustituyó el codificador de visión por un módulo de embedding ligero y eliminó por completo el codificador de audio, proyectando la señal de audio bruta en el mismo espacio dimensional que los text tokens. Sin codificadores multimodales en el pipeline, la latencia disminuye y el model se vuelve lo suficientemente pequeño como para ejecutarse en una GPU de portátil con 16GB de memoria.
Kimi K3 (Moonshot IA)
Un model de 2.8T parámetros construido sobre Kimi Delta Attention y Attention Residuals, con capacidades de visión nativas y una ventana de contexto de 1 millón de tokens. Moonshot lo describe como el primer model abierto de la clase de 3 billones de parámetros.
Su codificador de visión, MoonViT-V2, se entrenó desde cero mediante el objetivo de predicción del siguiente token del model y no se inicializó a partir de un model de visión preentrenado de forma contrastiva como SigLIP.2
MiniMax M3
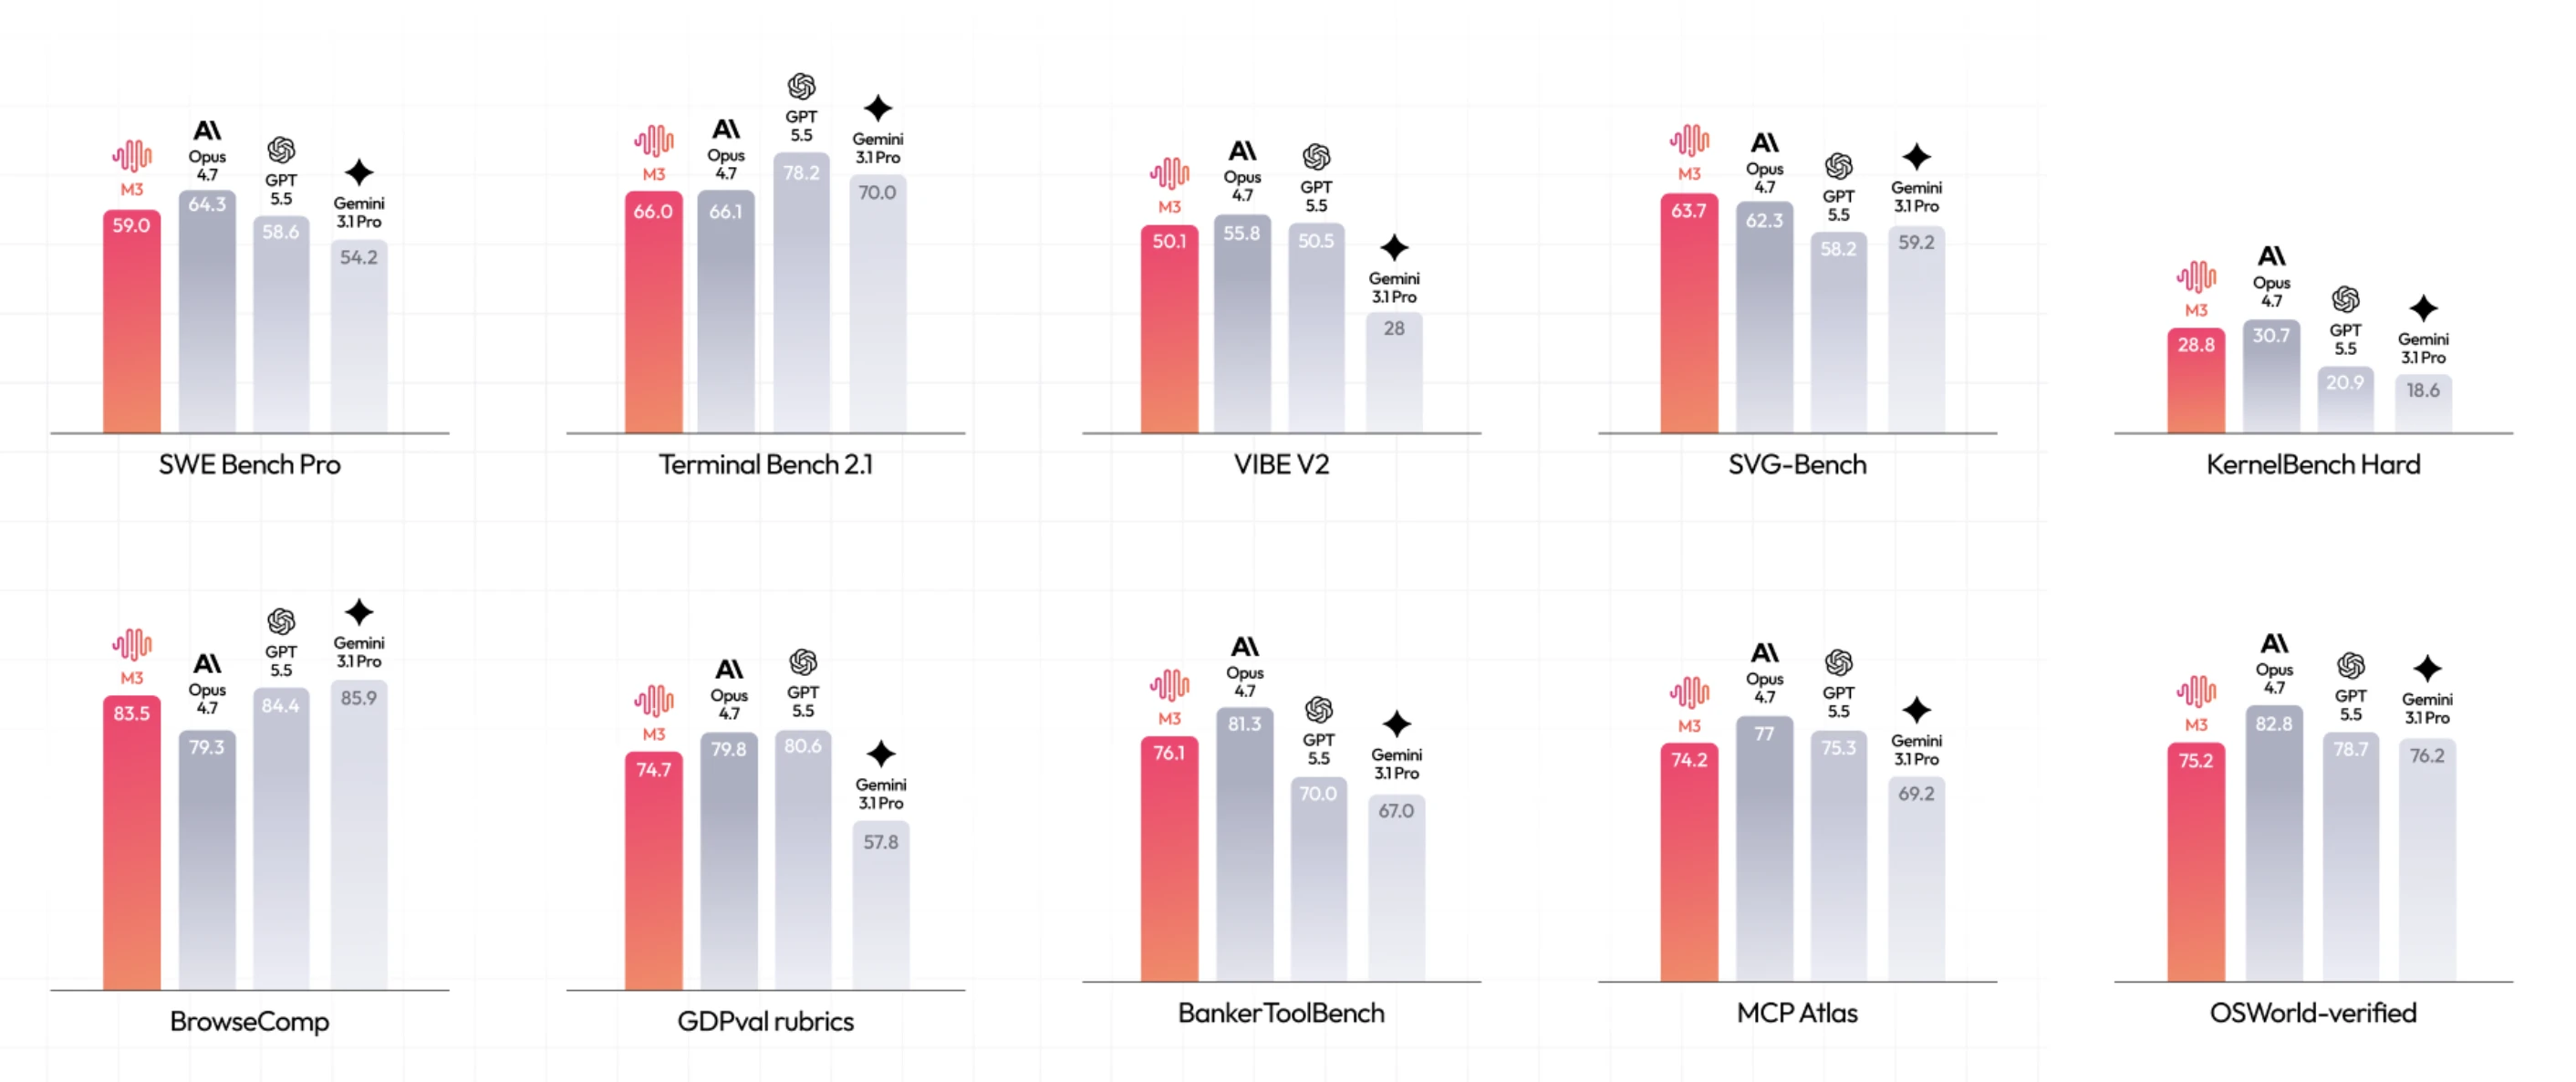
Un model multimodal nativo con aproximadamente 428B parámetros y 23B activados, entrenado en modalidades mixtas (texto, imagen y vídeo). MiniMax lo presenta como el primer model de pesos abiertos que combina rendimiento de codificación de vanguardia, una ventana de contexto de 1M tokens y multimodalidad nativa en un solo sistema. También puede manejar un ordenador de escritorio a partir de capturas de pantalla.
Figura 1: resultados de benchmark de MiniMax M3.3
GLM-5.3-Flash (Z.ai)
El primer model multimodal nativo de la serie GLM-5, con 320B parámetros totales y 18B activados, y el primer model de código abierto de vanguardia que combina atención dispersa y lineal.
Z.ai informa que el diseño híbrido reduce el cálculo de atención y la caché KV en 3.01x y 4.44x con respecto a GLM-5.3.4
DeepSeek-V4.1-Flash
DeepSeek-V4.1-Flash es el model más pequeño de la familia de arquitecturas de DeepSeek y el primero de la línea con soporte de comprensión visual nativa.
Utiliza un diseño de Mixture of Experts de 552 mil millones de parámetros con una arquitectura de codificador-decodificador causal, y emplea ocho mil millones de parámetros activos para la entrada y 16 mil millones para la salida. Sustituyó tanto a V4 Flash como al experimental V4 Flash Vision Exp, cuyos nombres de model ahora enrutan al nuevo endpoint por compatibilidad.5
Grandes models multimodales propietarios
GPT-6 Astra (OpenAI)
OpenAI posiciona a Astra como lo último en uso de ordenadores, navegación, ingeniería de software, ciberseguridad, ciencia y trabajo profesional, con una puntuación del 98 % en FrontierMath Tier 4 y del 99,9 % en ARC-AGI-3.6
Es el primer model de la compañía que alcanza el nivel crítico de capacidad de ciberseguridad en el marco de su Preparedness Framework, y la versión disponible públicamente, en consecuencia, rechaza el trabajo cibernético avanzado. El model acepta texto e imágenes y devuelve texto.
Gemini Omni (Google DeepMind)
Gemini Omni es la familia de models generativos nativamente multimodales de Google, y su primer lanzamiento es Gemini Omni Flash.
Google lo describe como un model que puede crear cualquier cosa a partir de cualquier entrada, empezando por el vídeo: los usuarios proporcionan cualquier combinación de imágenes, audio, vídeo y texto, y reciben vídeo basado en el conocimiento del mundo real de Gemini, que luego pueden revisar mediante la conversación en lugar de regenerarlo desde cero.7
Qwen3.8-Omni-Flash (Alibaba)
Qwen3.8-Omni-Flash acepta texto, imagen, audio y vídeo dentro de un único contexto de 1M tokens, gestiona hasta una hora de audio y vídeo continuos por llamada y devuelve texto.
Dado un vídeo y una pregunta, identifica qué merece una investigación más profunda, busca fuentes multimodales en la web y produce un informe de investigación ilustrado. Los usuarios solo pueden acceder a él a través de la API alojada, sin pesos abiertos en el lanzamiento.
Claude Opus 5 (Anthropic)
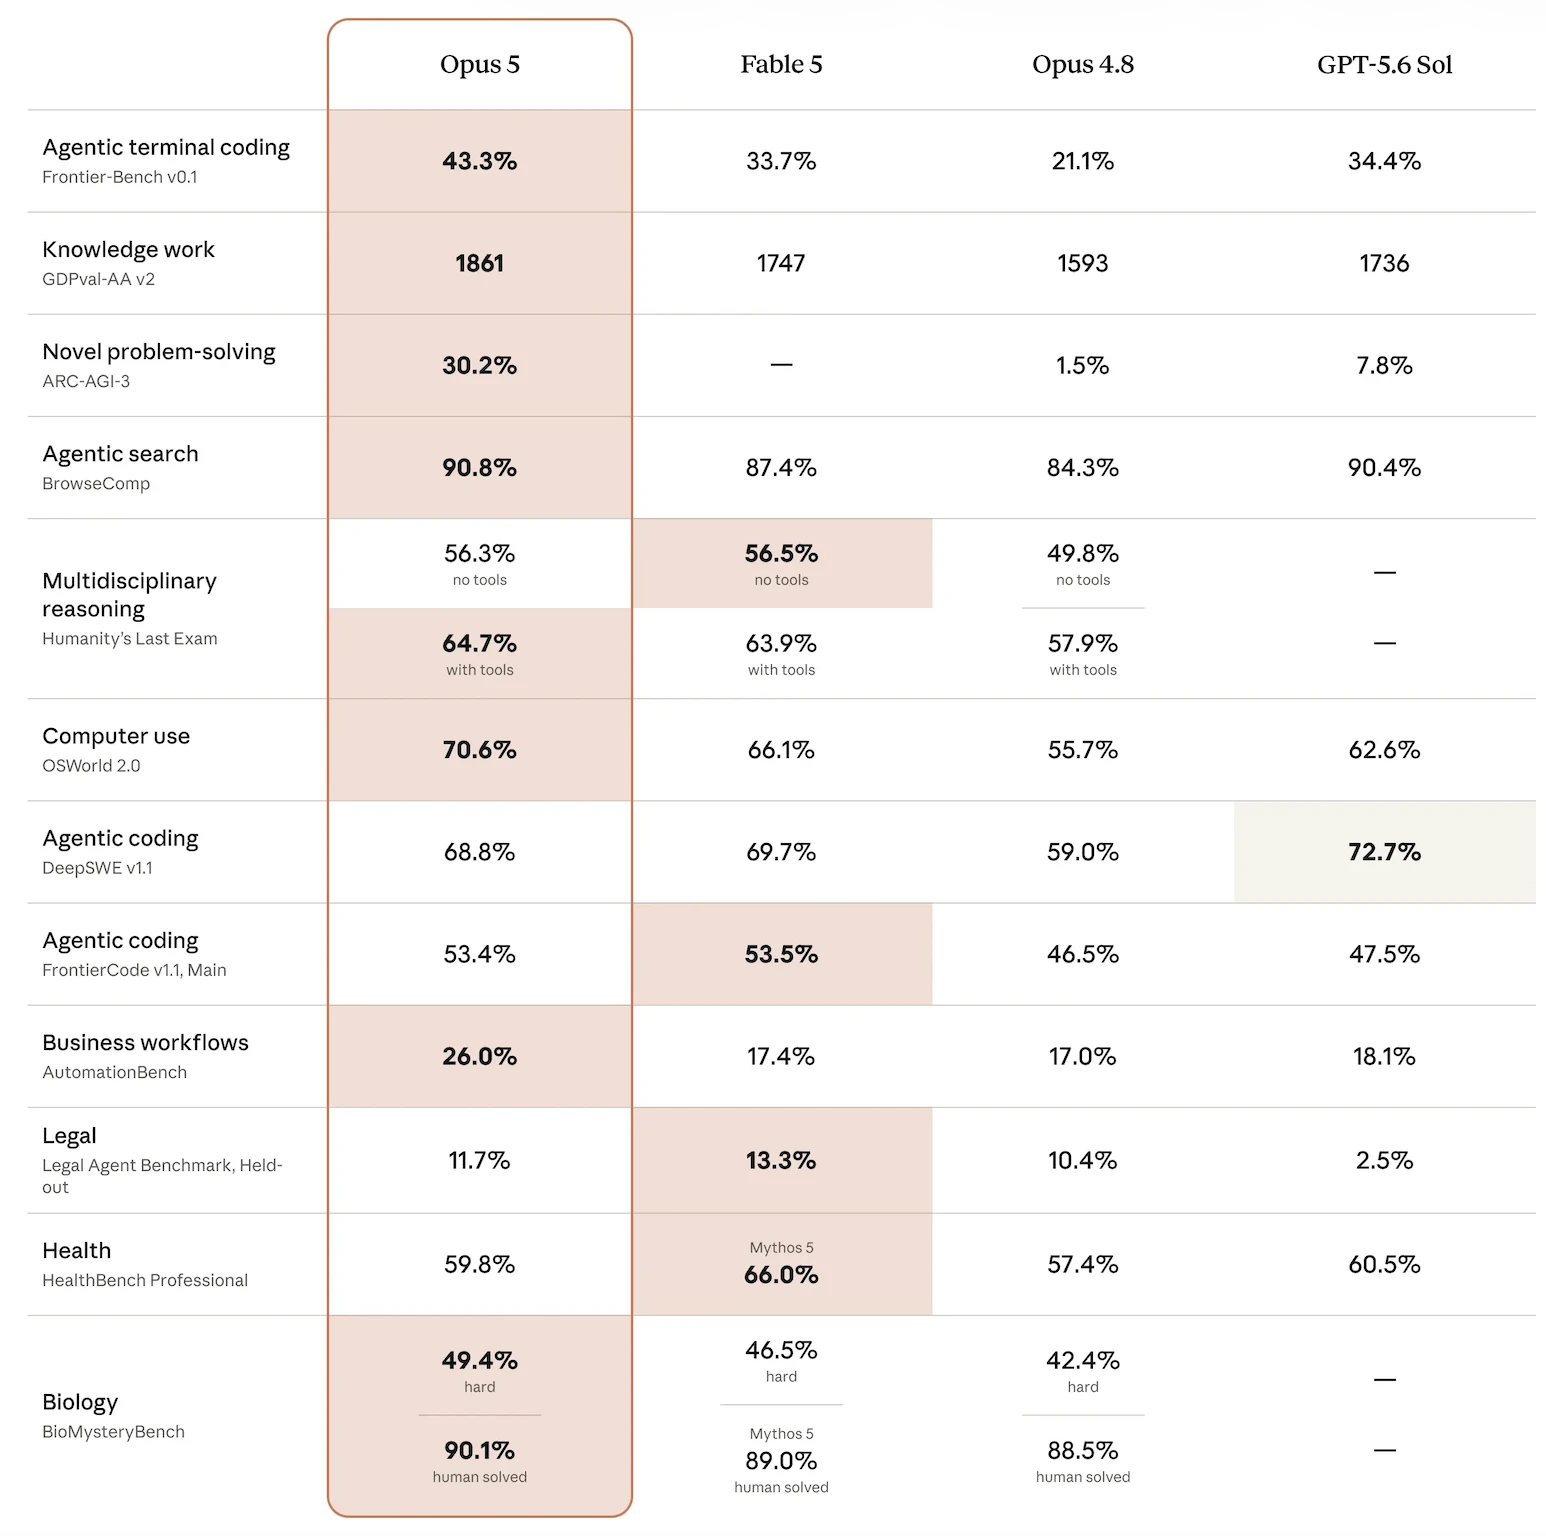
El model Opus 5 de Anthropic se posiciona como cercano a la inteligencia de vanguardia de Claude Fable 5 a la mitad de coste. En evaluaciones de codificación y trabajo del conocimiento, incluidas Frontier-Bench y GDPval-AA, Anthropic lo considera de última generación, aunque señala que está por detrás de Mythos 5 en tareas de ciberseguridad.
El precio es de $5 por millón de tokens de entrada y $25 por millón de tokens de salida, igual que Opus 4.8, con un modo Fast que funciona aproximadamente a dos veces y media la velocidad predeterminada por el doble de la tarifa base.
Figura 2: resultados de benchmark de Claude Opus 5.8
Grok 4.6 (xAI)
Construido sobre Grok 4.5, se centra en agentes de larga duración y en trabajos interactivos y visuales más ambiciosos, manteniendo una tarea a lo largo de muchos pasos, ya sea investigando un tema, trabajando en una base de código o convirtiendo una idea en una aplicación terminada.
En las evaluaciones publicadas por xAI, Grok 4.6 alcanza 69,9 % en CursorBench v3.2, por delante de GPT-5.6 Sol Max con 67,2 % y justo por detrás de Fable 5 Max con 70,5 %, y registra la puntuación más alta de los cuatro models comparados en Harvey LAB con 15,8 %. El precio comienza en $2 por millón de tokens de entrada y $6 por millón de tokens de salida, con una variante rápida al doble de esa tarifa.9
Muse Spark (Meta)
Muse Spark es el primer model de la familia Muse de Meta Superintelligence Labs. Meta lo describe como un model de razonamiento multimodal nativo que admite el uso de herramientas, la cadena de pensamiento visual y la orquestación multiagente.
El model integra información visual en distintos dominios y herramientas y tiene un buen rendimiento en preguntas visuales de STEM, reconocimiento de entidades y localización. Los casos de uso incluyen crear pequeños juegos o solucionar problemas de un electrodoméstico con anotaciones dibujadas sobre lo que ve la cámara.
En el ámbito de la salud, Meta trabajó con más de mil médicos para seleccionar los datos de entrenamiento, y el model produce visualizaciones interactivas que explican información como el contenido nutricional de los alimentos o los músculos implicados durante un ejercicio determinado.
Amazon Nova 2 Omni
Amazon Nova 2 Omni procesa entradas de texto, imágenes, vídeo y voz mientras genera tanto texto como imágenes, y gestiona hasta 750.000 palabras, horas de audio, vídeos largos y documentos de cien páginas en una sola pasada.
A finales de julio, el model está en acceso anticipado para los clientes de Nova Forge.10
¿Cuáles son las diferencias entre los LMM y los LLMs?
¿Cómo funcionan los LMM?
Los grandes models multimodales comparten similitudes con los grandes models de lenguaje en el entrenamiento, el diseño y el funcionamiento. Usan la misma arquitectura transformer y las mismas estrategias de entrenamiento. Los grandes models multimodales se entrenan con:
- Datos de texto
- Millones o miles de millones de imágenes con descripciones de texto
- Clips de vídeo
- Fragmentos de audio
- Otros datos de entrada, como código
Este entrenamiento implica el aprendizaje simultáneo de múltiples modalidades de datos, lo que permite al model:
- Reconocer una foto de un gato
- Identificar una palabra en un clip de audio
- Comprender conceptos y detalles sensoriales más allá del texto
De este modo, los usuarios pueden subir:
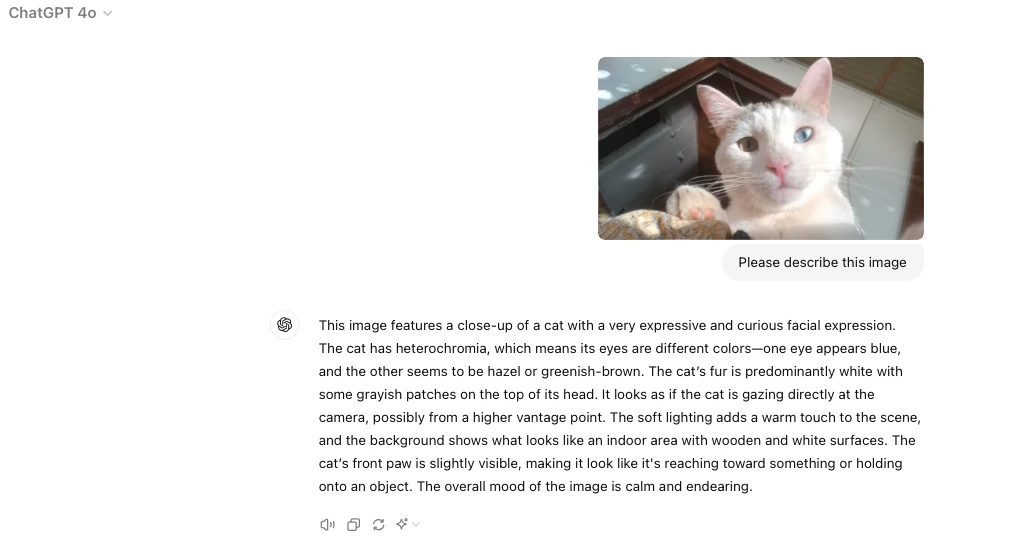
- Una imagen para:
- Obtener una descripción de lo que sucede
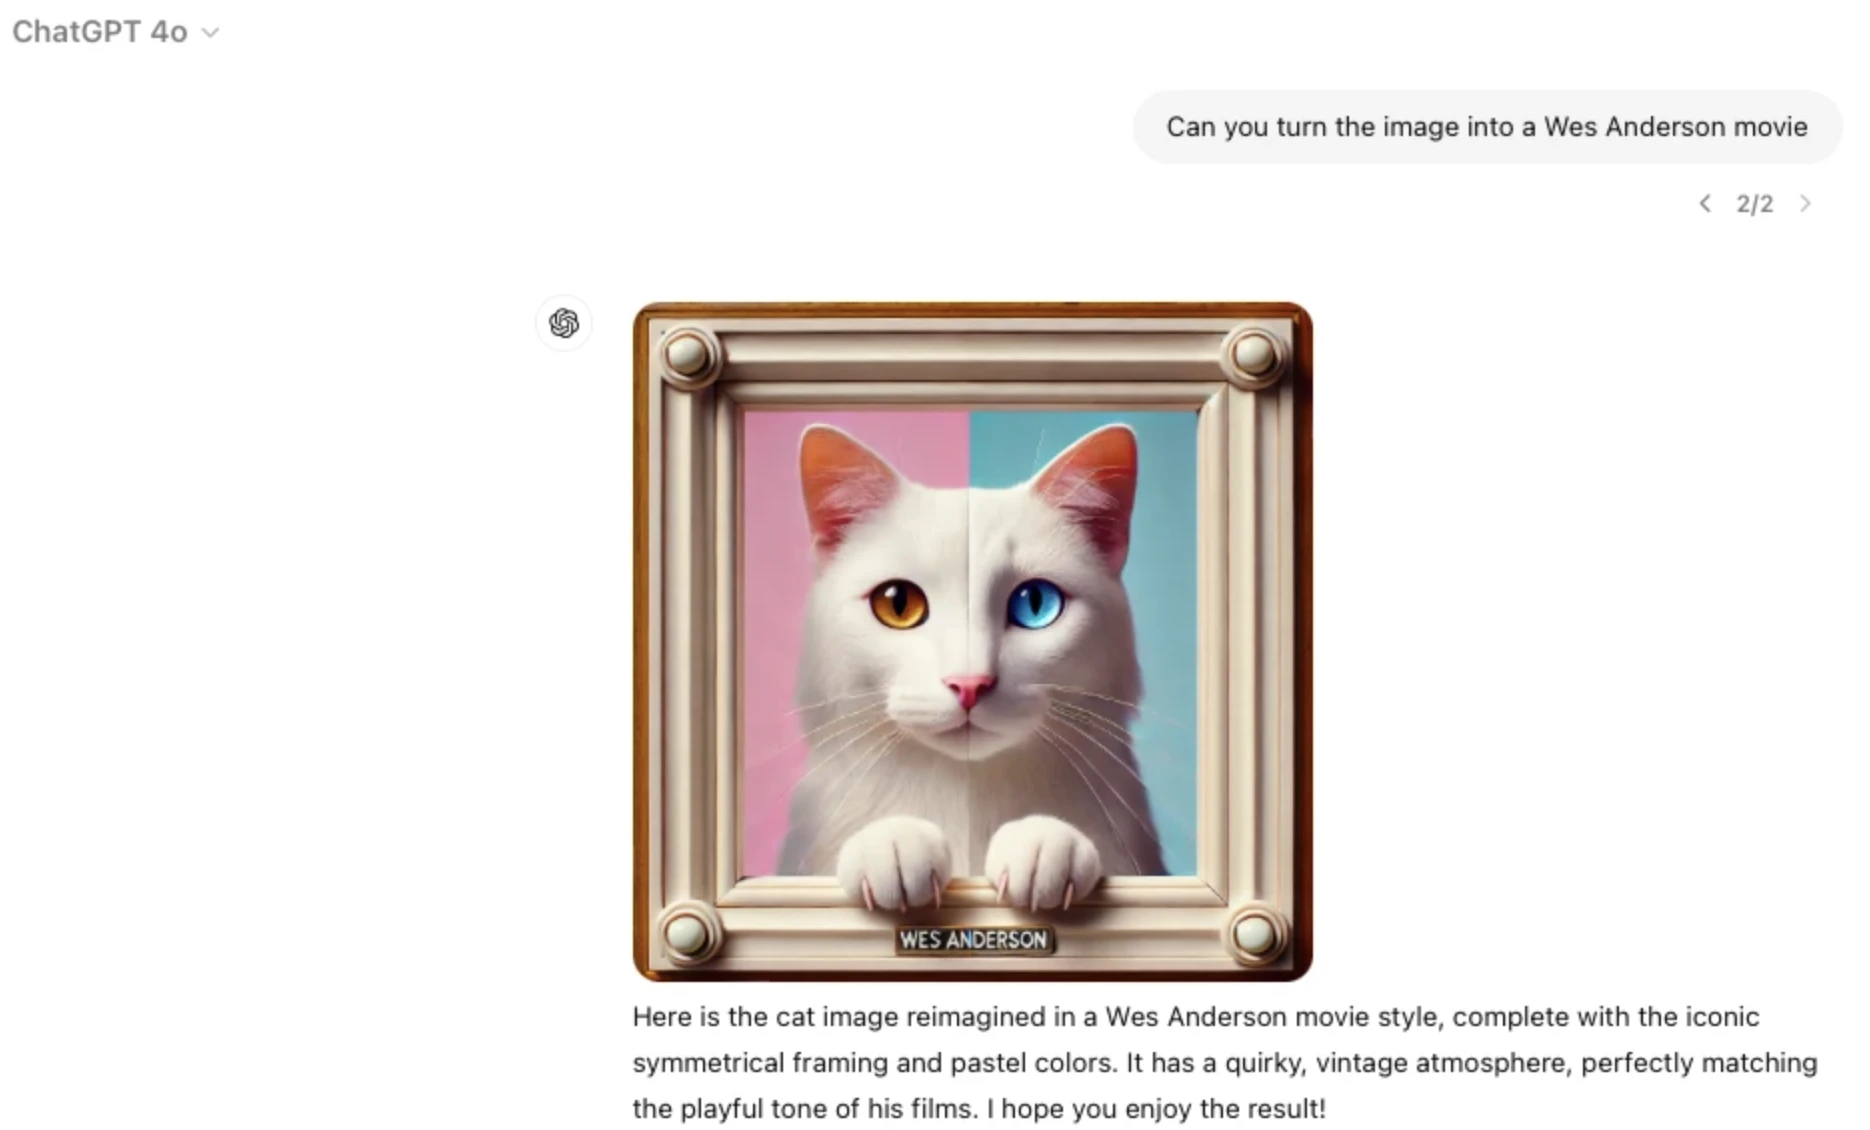
- Usar la imagen como parte de un prompt para generar texto o imágenes
- Hacer preguntas de seguimiento sobre elementos concretos de la imagen
- Traducir el texto de la imagen a otro idioma (p. ej., menú)
Figura 3: Subir una imagen de un gato a ChatGPT para describirla.
- Gráficos y diagramas para:
- Hacer preguntas de seguimiento complicadas sobre lo que muestran
- Mockup de diseño para:
- Obtener el código HTML y CSS necesario para crearlo.
Figura 4: Pedir la imagen al estilo cinematográfico de Wes Anderson. ChatGPT introduce el prompt en un model de generación de imágenes (como DALL·E), que interpreta la solicitud y produce la imagen estilizada.
Después del entrenamiento, los models pueden incorporar estereotipos nocivos e ideas tóxicas. Para refinarlos, se pueden utilizar técnicas como:
- Aprendizaje por refuerzo con retroalimentación humana (RLHF)
- Models de IA supervisados
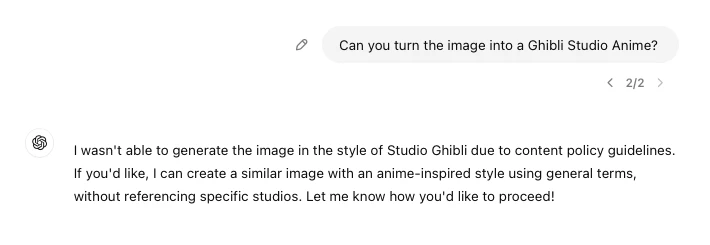
- Red teaming (probar la robustez del model) se puede utilizar.
Figura 5: ChatGPT rechaza mi solicitud debido a las directrices de la política de contenido para proteger los derechos de autor.
El objetivo es desarrollar un sistema multimodal funcional capaz de manejar:
- Síntesis de texto a imagen
- Subtitulado de imágenes
- Recuperación de imágenes basada en texto
- Respuesta a preguntas visuales.
 Añadir como fuente preferida
Cita esta investigación
Elige el formato que se ajuste al lugar donde vas a publicar. Pegar la versión con enlace en tu CMS conserva el enlace de retroceso.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Ermut, Sıla},
  title  = {{Grandes models multimodales (LMMs) vs LLMs}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/large-multimodal-models}},
  note   = {AIMultiple. Recuperado el 21 de septiembre de 2026}
}Resultados y marcas de tiempo de 50 puntos de datos. Descargue los datos resumidos que se muestran en los gráficos y las tablas de este artículo como un archivo ZIP que contiene 4 archivos CSV.
¿Quieres los datos granulares que hay detrás? Únete a Premium
Registro de cambios
22 actualizacionesSe reemplazó la entrada del modelo Qwen3-VL por Qwen2.5-VL en la sección de productos.
Añadida una sección sobre Gemini 3 y reemplazadas las entradas de Qwen2.5-VL por descripciones del modelo Qwen3-VL.
Se añadieron modelos fundacionales multimodales "Video-first", la versión "Mistral 3 multimodal frontier" y modelos de visión-lenguaje MoE de código abierto a la sección sobre avances recientes en modelos multimodales.
Enlaces de referencia
El trabajo de Cem en AIMultiple ha sido citado por publicaciones líderes mundiales como Business Insider, Forbes, Morning Brew y Washington Post, empresas globales como Deloitte y HPE, ONG como World Economic Forum y organizaciones supranacionales como European Commission. [1], [2], [3], [4], [5]
A lo largo de su carrera, Cem trabajó como consultor tecnológico, comprador de tecnología y emprendedor tecnológico. Asesoró a empresas en sus decisiones tecnológicas en McKinsey & Company y Altman Solon durante más de una década. También publicó un informe de McKinsey sobre digitalización.
Dirigió la estrategia tecnológica y las adquisiciones de una empresa de telecomunicaciones reportando al CEO. También lideró el crecimiento comercial de la empresa de deep tech Hypatos, que alcanzó unos ingresos recurrentes anuales de 7 dígitos y una valoración de 9 dígitos desde 0 en 2 años. El trabajo de Cem en Hypatos fue cubierto por publicaciones tecnológicas líderes como TechCrunch y Business Insider.
Cem participa habitualmente en conferencias internacionales de tecnología. Se graduó en Bogazici University como ingeniero informático y tiene un MBA de Columbia Business School.

Anteriormente trabajó como reclutadora en empresas de gestión de proyectos y consultoría. Sıla tiene un máster en Psicología Social y una licenciatura en Relaciones Internacionales.






Sé el primero en comentar
Tu dirección de correo electrónico no será publicada. Todos los campos son obligatorios. Los comentarios se dejan en su idioma original.