


LLM Guía de fine-tuning para empresas
Sigue los enlaces para conocer las soluciones específicas a los desafíos de salida de tu LLM. Si tu LLM:
- No tiene acceso a los hechos necesarios en tu dominio: entrena un nuevo LLM, cambia a uno específico del dominio o utiliza RAG para recuperar hechos
- Tiene los hechos relevantes, pero necesita responder con un estilo y un tono diferentes, seguir ciertos formatos de salida o utilizar ciertas herramientas; entonces:
- Primero, aprovecha la ingeniería de prompts o el encadenamiento de prompts para mejorar los resultados.
- Si no funcionan, LLM fine-tuning es el enfoque adecuado. Puedes utilizar el servicio LLM de tu proveedor o hacer fine-tuning de LLMs de código abierto en local.
La adopción generalizada de los large language models (LLMs) ha mejorado nuestra capacidad de procesar el lenguaje humano. Sin embargo, su entrenamiento genérico a menudo produce un rendimiento subóptimo en tareas específicas.
Para superar esta limitación, se emplean métodos de fine-tuning para adaptar los LLMs a los requisitos únicos de diferentes áreas de aplicación.
¿Qué es el LLM fine-tuning?
El fine-tuning de un large language model ajusta un model preentrenado para realizar tareas específicas o atender a un dominio particular de manera más eficaz. El proceso implica entrenar aún más el model con un dataset más pequeño y específico que sea relevante para la tarea o el tema deseado.
El large language model original se entrena previamente con grandes cantidades de datos de texto diversos, lo que le ayuda a aprender la comprensión general del lenguaje, la gramática y el contexto. El fine-tuning aprovecha este conocimiento general y perfecciona el model para lograr un mejor rendimiento y comprensión en un dominio específico.
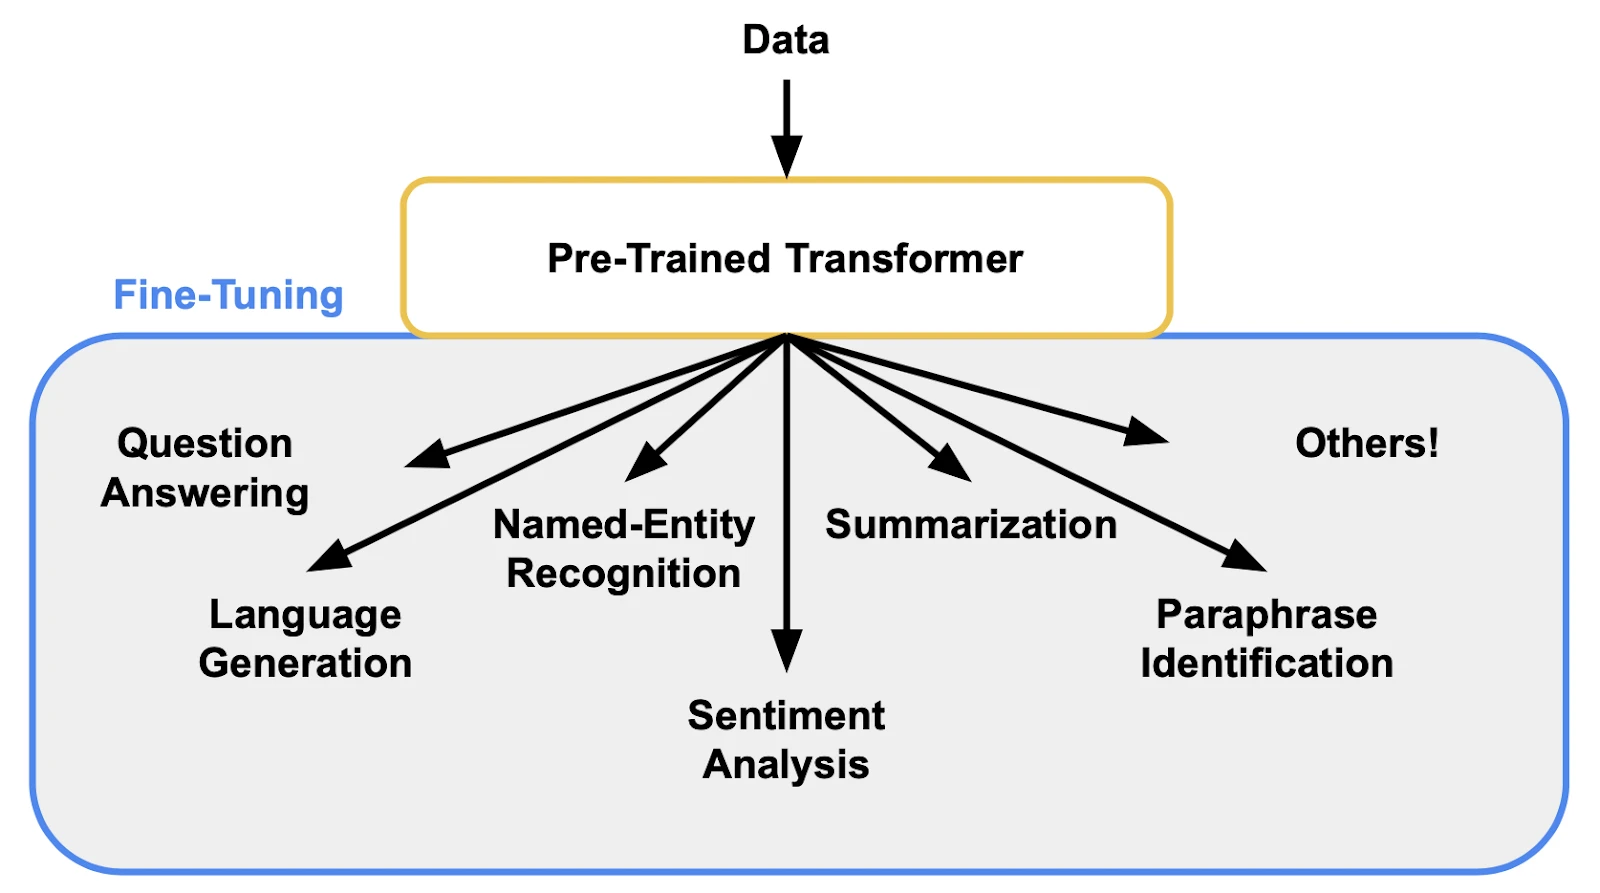
Figura 2: Capacidades de un LLM después del fine-tuning.1
Por ejemplo, un large language model puede recibir fine-tuning para tareas como el análisis de sentimiento en reseñas de productos, la predicción de precios de acciones a partir de noticias financieras o la identificación de síntomas de enfermedades en textos médicos.
Este proceso personaliza el comportamiento del model, lo que le permite generar resultados más precisos y contextualmente relevantes para tareas como:
- Análisis de sentimiento.
- Desarrollo de chatbot.
- Respuesta a preguntas.
Cómo hacer fine-tuning de LLMs
1. Preparación del dataset
Dado que los LLMs se entrenan previamente con un dataset fijo, no están al tanto de los eventos en tiempo real. Para mantener estos models actualizados y mejorar su rendimiento en temas específicos y en evolución, las empresas utilizan datos web en tiempo real. Estos datos son fundamentales por dos razones principales: ayudan con la alineación del dominio y reducen la alucinación.
1.1. Alineación y relevancia con el dominio:
El uso de datos obtenidos de la web permite a las empresas hacer fine-tuning de LLMs con la información más actual y relevante para su industria. Por ejemplo, una empresa de tecnología legal podría utilizar rastreadores web para recopilar sentencias judiciales y blogs legales recientes.
Estos datos específicos del dominio garantizan que el model fine-tuned comprenda la terminología y el contexto actualizados del sector, que a menudo faltan en los datasets públicos estáticos. Este proceso es clave para convertir un model preentrenado de propósito general en un experto en un campo específico.
1.2. Reducción de la alucinación:
La alucinación ocurre cuando un LLM genera información plausible pero factualmente incorrecta. Al hacer fine-tuning de un LLM con datos reales de alta calidad procedentes de la web, le proporcionas una fuente fiable de verdad.
Esto hace que el model sea menos propenso a inventar información durante la inference y le ayuda a generar respuestas más precisas y fiables.
Las empresas utilizan herramientas de web scraping internas o proveedores externos para recopilar datos de sitios web. Estos datos de entrenamiento recopilados se preparan y se utilizan para hacer fine-tuning del LLM.
Al incorporar de forma continua datos web frescos, las empresas pueden asegurarse de que sus models fine-tuned sigan siendo relevantes y precisos, lo que proporciona una ventaja competitiva significativa.
2. Elección de un foundation model y un método de fine-tuning
La selección del model base y del método de fine-tuning adecuados depende de la tarea específica y de los datos disponibles. Hay varios proveedores de LLM entre los que elegir, como Alphabet y Meta, cada uno con sus propias fortalezas y debilidades. El método de fine-tuning también puede variar según la tarea y los datos, como el transfer learning, el fine-tuning secuencial o el fine-tuning específico de la tarea.
Al elegir el model base, debes tener en cuenta:
- Si la infraestructura técnica es adecuada para la potencia de cómputo necesaria para el fine-tuning
- Si el model se ajusta a tu tarea específica
- El tamaño de entrada y salida del model
- El tamaño de tu dataset
3. Fine-tuning
El fine-tuning adapta los LLMs preentrenados a tareas específicas o necesidades organizativas, ya sea mediante servicios gestionados ofrecidos por los proveedores de models o modificando directamente models de código abierto con datos específicos de la tarea y herramientas de MLOps.
Fine-tuning como servicio para models de código cerrado
Los principales proveedores de LLM ofrecen fine-tuning gestionado, aunque el panorama cambió en 2026. Google (Gemini a través de Vertex AI) y Anthropic (Claude a través de Amazon Bedrock) siguen siendo las principales opciones de código cerrado para nuevas cargas de trabajo de fine-tuning. OpenAI, que históricamente ofrecía fine-tuning en models GPT, está retirando su plataforma de fine-tuning, lo que significa que está cerrada para nuevos usuarios y los usuarios existentes disponen de un tiempo limitado para crear nuevos trabajos de entrenamiento.2
Por ejemplo, Vertex AI admite múltiples enfoques de tuning de model, lo que permite a los desarrolladores flexibilidad a la hora de personalizar el comportamiento del model más allá del fine-tuning básico:
- Fine-tuning supervisado: Entrena un model con ejemplos etiquetados para que aprenda a producir los resultados deseados en tareas específicas.
- Tuning de preferencias: Un enfoque de tuning distinto que se basa en el fine-tuning supervisado y utiliza datos de preferencias humanas para enseñar a los models a generar resultados más preferidos a partir de retroalimentación por pares, en lugar de etiquetas explícitas.
- Checkpoints de tuning y tuning continuo: Herramientas para guardar el progreso o ampliar un model ya tuneado con más datos o pasadas de entrenamiento.3
Precios: El fine-tuning gestionado suele facturarse por token de entrenamiento, y la inference se factura por separado con un sobrecoste sobre el model base.
Fine-tuning de models de código abierto
Dado que los pesos del model están disponibles en los models de código abierto, las empresas pueden hacer fine-tuning de models de código abierto en sus instalaciones sin exponer sus datasets a los proveedores de LLM.
Los pasos para hacer fine-tuning de models de código abierto incluyen:
- Carga del model preentrenado: Una vez seleccionados el LLM y el método de fine-tuning, el model preentrenado debe cargarse en memoria.
- Este paso inicializa los pesos del model a partir de los valores preentrenados, lo que acelera el proceso de fine-tuning y garantiza que el model haya aprendido la comprensión general del lenguaje.
- Fine-tuning implica entrenar el LLM preentrenado con el dataset específico de la tarea. El proceso de entrenamiento implica optimizar los pesos y parámetros del model para minimizar la función de pérdida y mejorar su rendimiento en la tarea.
El proceso de fine-tuning suele implicar rondas iterativas de entrenamiento. Para optimizar el rendimiento, los desarrolladores deben ajustar configuraciones como la tasa de aprendizaje o el tamaño del lote. Herramientas como Weights & Biases (Sweeps) automatizan esta búsqueda de hiperparámetros, visualizando cómo diferentes variables afectan la convergencia del model para que los equipos puedan seleccionar la mejor configuración sin ensayo y error manual.
Por ejemplo, los models Llama pueden recibir fine-tuning de manera económica con enfoques de Parameter Efficient Fine Tuning (PEFT).4
Las empresas pueden aprovechar sus plataformas de MLOps o plataformas de LLMOps para hacer fine-tuning de models.
Por ejemplo, el uso de una plataforma que actúa como sistema de registro (como Weights & Biases) permite a las empresas realizar un seguimiento de cada ejecución de entrenamiento, registrar métricas del sistema (uso de GPU) y versionar los checkpoints del model resultantes en un registro central. Esto garantiza que, incluso al entrenar models de código abierto en las instalaciones, el flujo de trabajo siga siendo reproducible y colaborativo.
Fine-tuning de models de pesos abiertos
Los models de pesos abiertos están disponibles públicamente para que los usuarios los descarguen y ejecuten localmente (o en su infraestructura en la nube) sin depender de una API.
Se diferencian de los models de código abierto porque el código abierto suele implicar que el código de entrenamiento completo, los detalles de los datos y los términos de licencia permiten la modificación y la redistribución. Los models de pesos abiertos pueden liberar los pesos, pero mantienen restringidas partes del pipeline de entrenamiento, el dataset o los derechos de uso.
Dado que los pesos son accesibles, los models de pesos abiertos pueden recibir fine-tuning directamente continuando el entrenamiento con datasets personalizados (por ejemplo, fine-tuning supervisado, métodos LoRA/PEFT), lo que permite a las organizaciones personalizar el comportamiento manteniendo los datos y el despliegue totalmente bajo su control.
Por ejemplo, la familia LFM2.5 de Liquid IA sirve como un conjunto de foundation models de pesos abiertos. Se lanzan para implementaciones de IA en el dispositivo y en el edge, con checkpoints disponibles en Hugging Face y en la plataforma Liquid IA LEAP.
La serie incluye variantes como LFM2.5-1.2B-Base (un model base preentrenado) y LFM2.5-1.2B-Instruct, que ha recibido fine-tuning supervisado y aprendizaje por refuerzo en su pipeline de post-entrenamiento.
Como los pesos son de acceso público, los desarrolladores pueden tomar el checkpoint base y realizar su propio fine-tuning: entrenar el model con datasets propietarios, adaptarlo a tareas específicas de idioma o de dominio, o experimentar con otros métodos de entrenamiento (como el fine-tuning supervisado con adaptadores o la alineación de preferencias).
LFM2.5 es muy adecuado para la personalización de tareas específicas en hardware local o dispositivos edge, donde controlar el flujo de trabajo de entrenamiento e inference es importante.5
Otro ejemplo es Tinker, del laboratorio Thinking Machines, que es una API diseñada para hacer más accesible el fine-tuning de language models de pesos abiertos para investigadores y desarrolladores.
Tinker permite a los usuarios adaptar una amplia gama de models de pesos abiertos, desde arquitecturas más pequeñas hasta grandes models de mezcla de expertos como Qwen-235B-A22B. Los usuarios pueden aplicar fine-tuning basado en LoRA u otros métodos de post-entrenamiento para adaptar models a tareas específicas, ya sea mediante aprendizaje supervisado o enfoques de tipo refuerzo.
Después del tuning, los desarrolladores pueden descargar los checkpoints resultantes y utilizarlos de forma independiente, lo que permite controlar tanto el model como el comportamiento personalizado.6
4. Evaluación de models fine-tuned
Una vez completado el proceso de fine-tuning, es necesario evaluar el rendimiento del model en el conjunto de prueba. Este paso ayuda a garantizar que el model generalice bien a datos nuevos y que tenga un buen rendimiento en la tarea específica. Las métricas comunes utilizadas para la evaluación incluyen exactitud, precisión, exhaustividad y puntuación F1.
Sin embargo, para las tareas generativas, las métricas tradicionales suelen ser insuficientes. La evaluación moderna requiere trazar el razonamiento del model y verificar la calidad del texto generado. Herramientas como W&B Weave lo permiten, ya que posibilitan a los desarrolladores rastrear entradas y salidas, depurar prompts y ejecutar evaluaciones sistemáticas (utilizando un LLM-como-juez) para puntuar el model fine-tuned en matices como el tono, la fidelidad y la seguridad.
5. Despliegue
Una vez evaluado el model fine-tuned, se puede desplegar en entornos de producción. El proceso de despliegue puede implicar la integración del model en un sistema más grande, la configuración de la infraestructura necesaria y la supervisión del rendimiento del model en escenarios del mundo real.
¿Cuáles son los métodos utilizados en el proceso de fine-tuning de LLMs?
Métodos de fine-tuning
El fine-tuning es un proceso que implica adaptar un model preentrenado a una tarea o dominio específico entrenándolo más con un dataset más pequeño y específico de la tarea. Se pueden utilizar varios métodos de fine-tuning para ajustar los pesos y parámetros de un model preentrenado y mejorar su rendimiento en la tarea objetivo:
- Transfer learning implica reutilizar los pesos y la arquitectura de un model preentrenado para una nueva tarea o dominio. El model preentrenado suele entrenarse con un dataset grande y general, y el enfoque de transfer learning permite una adaptación eficiente y eficaz a tareas o dominios específicos.
- Fine-tuning secuencial: El model preentrenado se somete a fine-tuning en varias tareas o dominios relacionados de forma secuencial. Esto permite que el model aprenda patrones de lenguaje más matizados y complejos en diferentes tareas, lo que conduce a una mejor generalización y rendimiento.
- Fine-tuning específico de la tarea: El model preentrenado se somete a fine-tuning en una tarea o dominio específico utilizando un dataset específico de la tarea. Este método requiere más datos y tiempo que el transfer learning, pero puede dar como resultado un mayor rendimiento en la tarea específica.
- Aprendizaje multitarea: El model preentrenado se somete a fine-tuning en varias tareas simultáneamente. Este enfoque permite que el model aprenda y aproveche las representaciones compartidas entre diferentes tareas, lo que conduce a una mejor generalización y rendimiento.
- Entrenamiento de adaptadores implica entrenar módulos ligeros que se conectan al model preentrenado, lo que permite el fine-tuning en una tarea específica sin afectar el rendimiento del model original en otras tareas.
Reinforcement Fine-Tuning (RFT)
Reinforcement Fine-Tuning (RFT) es una técnica de personalización de models que adapta un language model preentrenado mediante retroalimentación guiada por recompensas, en lugar de utilizar ejemplos de entrenamiento etiquetados tradicionales.
En lugar de entrenarse con salidas fijas/correctas, RFT utiliza una señal de recompensa o una función evaluadora para evaluar las respuestas del model y optimizarlo de forma iterativa para maximizar esas recompensas.
Este enfoque tiene sus raíces en los principios del aprendizaje por refuerzo, donde el model se comporta como un agente que aprende qué tipos de salidas generan puntuaciones de recompensa más altas y ajusta sus parámetros en consecuencia. A diferencia del fine-tuning supervisado, RFT destaca en escenarios en los que es difícil definir salidas precisas y correctas, pero la calidad puede juzgarse o puntuarse.
Por ejemplo, la capacidad de Reinforcement Fine-Tuning de Amazon Bedrock automatiza este proceso para que los desarrolladores personalicen models a partir de señales de retroalimentación (funciones de recompensa).
En Bedrock, los usuarios definen qué hace que una respuesta sea precisa mediante funciones de recompensa basadas en reglas o en IA, y el model se entrena para maximizar estas recompensas.7
Otro ejemplo es el RFT de OpenAI. Permite a los desarrolladores adaptar models de razonamiento definiendo un evaluador programable que puntúa las respuestas candidatas. Durante el entrenamiento, el model se actualiza para que las salidas con puntuaciones altas sean más probables en generaciones futuras.
Esto hace que RFT sea especialmente útil para tareas en las que la calidad de la salida es subjetiva o se juzga mejor mediante puntuación que por respuestas de referencia exactas.8
Método de few-shot learning
El few-shot learning (FSL) implica mejorar el rendimiento del model sin cambiar los pesos del model. En este enfoque, se proporciona al model un número limitado de ejemplos (es decir, "few shots") de la nueva tarea, y utiliza esta información para adaptarse y rendir mejor en esa tarea. Puede considerarse como un
- Alternativa de menor coste al fine-tuning. El coste son los tokens de entrada de unos pocos ejemplos.
- Problema de Meta-aprendizaje donde el model aprende a aprender a resolver el problema dado.
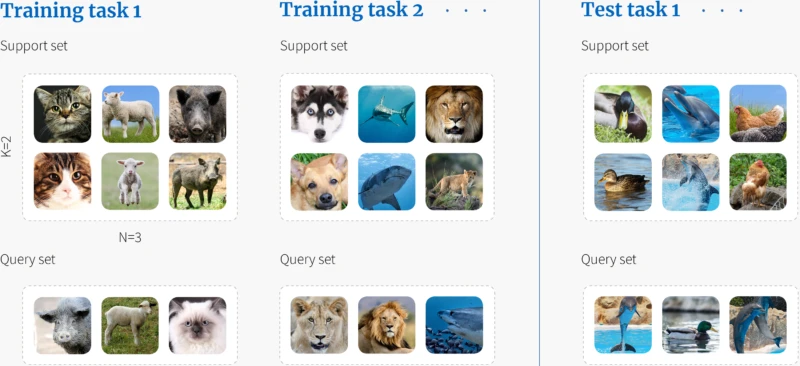
Figura 3: Escenario de few-shot learning donde el model aprende a clasificar un conjunto de imágenes a partir de las tareas con las que fue entrenado.9
Esto es especialmente útil cuando no hay suficientes datos disponibles para el aprendizaje supervisado tradicional. En el contexto de los LLMs, el fine-tuning con un dataset pequeño relacionado con la nueva tarea es un ejemplo de few-shot learning.
Diferencias entre few-shot learning y fine-tuning
La diferencia principal es la cantidad de datos específicos de la tarea que el model necesita para adaptarse a una nueva tarea o dominio. Los métodos de fine-tuning requieren una cantidad moderada de datos específicos de la tarea para optimizar el rendimiento del model, mientras que los métodos de few-shot learning pueden adaptar models a nuevas tareas o dominios con unos pocos ejemplos etiquetados.
Ejemplos de fine-tuning
El fine-tuning logró aumentos significativos del rendimiento en finanzas
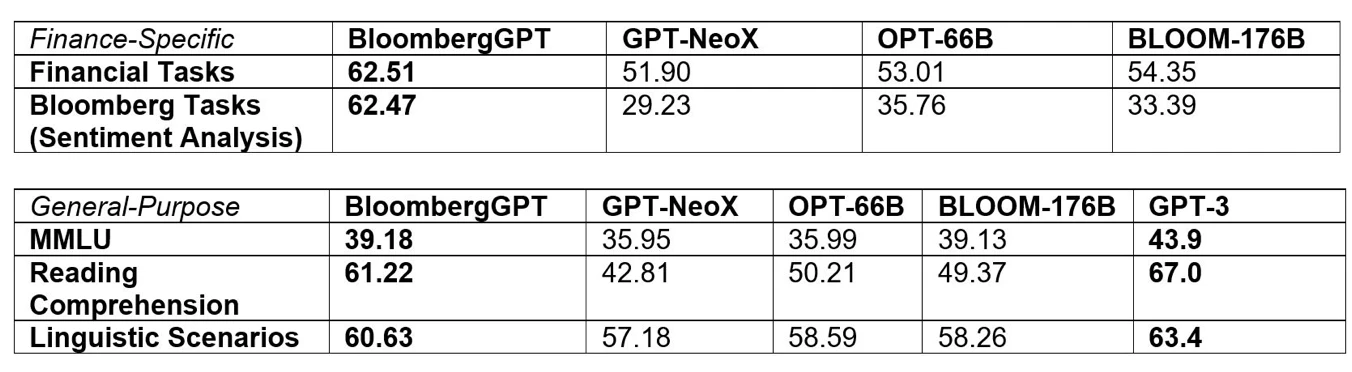
Bloomberg ha desarrollado BloombergGPT, un large-scale language model adaptado a la industria financiera. Este model se centra en tareas de procesamiento del lenguaje natural financiero, como el análisis de sentimiento, el reconocimiento de entidades nombradas y la clasificación de noticias.
BloombergGPT se creó utilizando una combinación de datasets financieros y de propósito general, y logró puntuaciones altas en pruebas de benchmark (Figura 4).
Figura 4: Imagen que muestra cómo BloombergGPT se desempeña en dos grandes categorías de tareas de PLN: específicas de finanzas y de propósito general.10
¿Por qué o cuándo necesita tu empresa un LLM fine-tuned?
Las empresas pueden necesitar large language models fine-tuned por varias razones, según sus requisitos específicos, su sector y sus objetivos. Estas son algunas razones comunes:
1. Personalización
Las empresas suelen tener necesidades y objetivos únicos que un language model genérico puede no abordar. El fine-tuning les permite adaptar el comportamiento del model a sus objetivos específicos, como generar contenido de marketing personalizado o comprender el contenido generado por los usuarios en su plataforma.
Descubre cómo el fine-tuning de LLMs permite la creación de productos y estrategias de marketing personalizados, mejorando en última instancia la experiencia de IA generativa en comercio minorista, marketing y seguros.
2. Sensibilidad de los datos y cumplimiento normativo
Las empresas que manejan datos sensibles u operan en entornos normativos estrictos pueden necesitar hacer fine-tuning del model para asegurarse de que respeta los requisitos de privacidad, cumple las directrices de contenido y genera respuestas adecuadas que cumplen con las normativas del sector.
3. Lenguaje específico del dominio
Muchos sectores utilizan jerga, términos técnicos y vocabulario especializado que puede no estar bien representado en los datos de entrenamiento generales de un large language model. El fine-tuning del model con datos específicos del dominio le permite comprender y generar respuestas precisas dentro del contexto del sector de la empresa.
4. Rendimiento mejorado
El fine-tuning mejora el rendimiento del model en tareas o aplicaciones específicas relevantes para el negocio, como:
- Análisis de sentimiento
- Clasificación de documentos
- Extracción de información
Esto puede conducir a una mejor toma de decisiones, mayor eficiencia y mejores resultados.
5. Habilitación de capacidades de IA agéntica
El fine-tuning es fundamental para desarrollar sistemas de IA agéntica, diseñados para actuar de forma autónoma, tomar decisiones e interactuar con herramientas o entornos externos para lograr objetivos específicos.
Mediante el fine-tuning de un LLM, las empresas pueden mejorar su capacidad de realizar function calling, lo que permite al model seleccionar y ejecutar las herramientas adecuadas (por ejemplo, APIs, bases de datos) con parámetros precisos.
Por ejemplo, un LLM fine-tuned puede impulsar una IA agéntica que gestione de forma autónoma las consultas de los clientes integrándose con un sistema CRM o recupere datos en tiempo real a través de APIs web. Esta personalización garantiza que el model comprenda los contextos específicos del dominio y las interacciones con las herramientas, lo que hace que la IA agéntica sea más eficaz y fiable en aplicaciones empresariales.
6. Mejora de la experiencia del usuario
Un model fine-tuned puede ofrecer una mejor experiencia de usuario generando respuestas más precisas, relevantes y conscientes del contexto, lo que se traduce en una mayor satisfacción del cliente, en aplicaciones como:
- Chatbots
- Asistentes virtuales
- Sistemas de atención al cliente
 Añadir como fuente preferida
¿Qué es un large language model (LLM)?
Un large language model es un sistema avanzado de inteligencia artificial (IA), más concretamente un IA generativa empresarial model, diseñado para procesar, comprender y generar texto similar al humano a partir de cantidades masivas de datos. Estos models se construyen normalmente utilizando aprendizaje profundo técnicas, como las redes neuronales. Se entrenan con datasets extensos que incluyen texto de una amplia variedad, como libros y sitios web, para el procesamiento del lenguaje natural.
Uno de los aspectos clave de un large language model es su capacidad para comprender el contexto y generar respuestas coherentes y relevantes a partir de la entrada proporcionada. El tamaño del model, en términos de número de parámetros y capas, le permite capturar relaciones y patrones intrincados dentro del texto. Esto le permite realizar diversas tareas, como:
- Responder preguntas
- Generación de texto
- Resumen de texto
- Traducción
- Escritura creativa
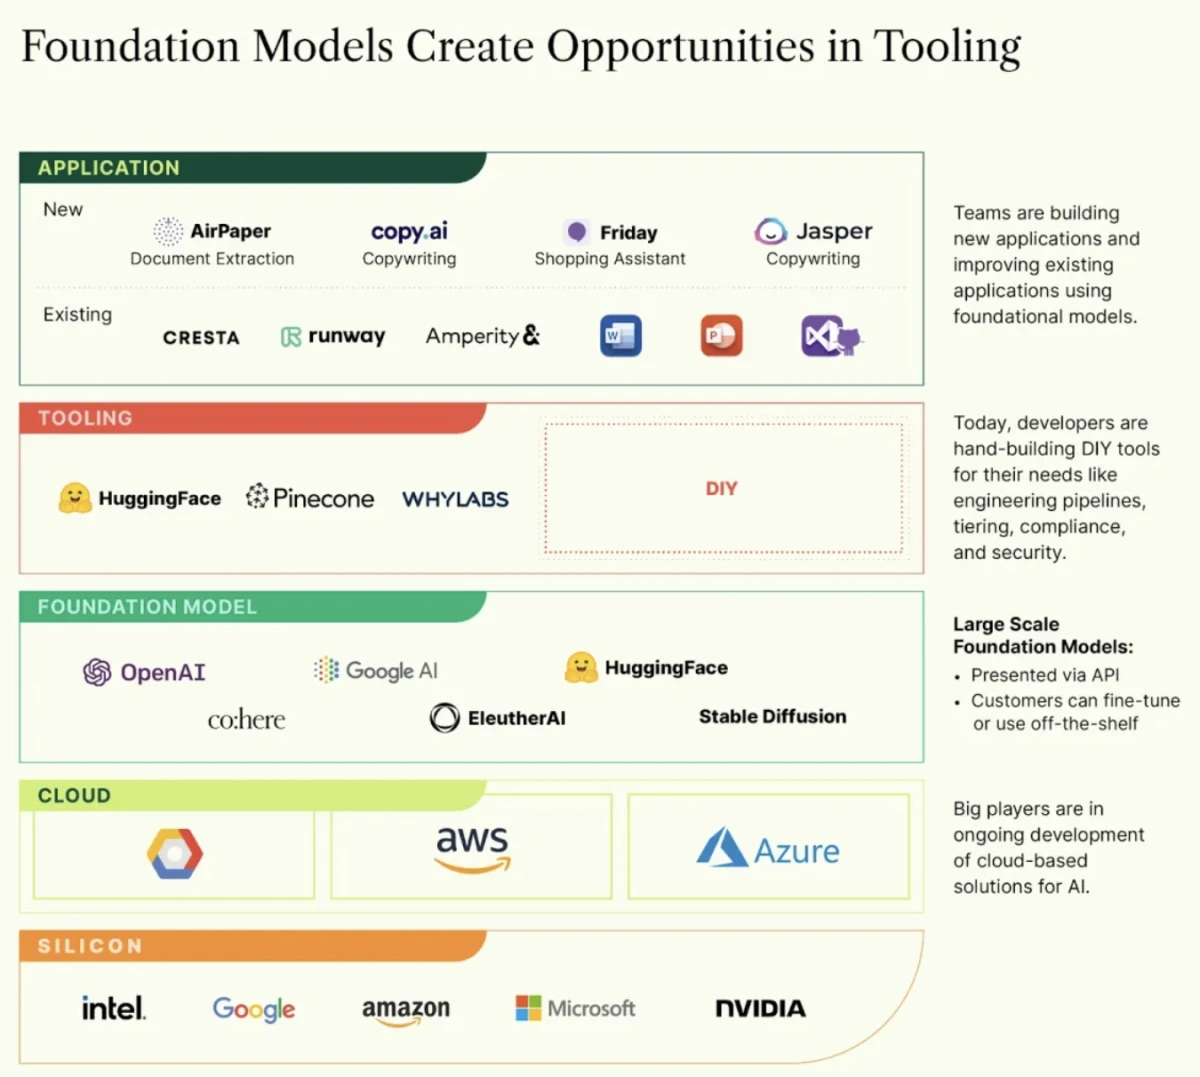
Los foundation models, como los large language models, son un componente central de la investigación y las aplicaciones de IA. Proporcionan una base para construir models más especializados y fine-tuned para tareas o dominios específicos.
Figura 5: Ejemplos de foundation models.11
Lectura adicional
- Aunque el fine-tuning mejora la eficacia de los large language models, es esencial abordar los riesgos de la IA generativa.
- El fine-tuning de large language models conlleva consideraciones legales. Explora el panorama legal que rodea a estos sistemas avanzados de IA en derechos de autor de la IA generativa.
Cita esta investigación
Elige el formato que se ajuste al lugar donde vas a publicar. Pegar la versión con enlace en tu CMS conserva el enlace de retroceso.
@misc{dilmegani2026,
  author = {Dilmegani, Cem},
  title  = {{LLM Guía de fine-tuning para empresas}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/llm-fine-tuning}},
  note   = {AIMultiple. Recuperado el 22 de junio de 2026}
}
Registro de cambios
10 actualizacionesEliminado OpenAI de la sección de servicios de ajuste fino de código cerrado, dejando Google Vertex AI y Anthropic en Bedrock.
Eliminada la Figura 1 de la sección Introducción.
Enlaces de referencia
El trabajo de Cem en AIMultiple ha sido citado por publicaciones líderes mundiales como Business Insider, Forbes, Morning Brew y Washington Post, empresas globales como Deloitte y HPE, ONG como World Economic Forum y organizaciones supranacionales como European Commission. [1], [2], [3], [4], [5]
A lo largo de su carrera, Cem trabajó como consultor tecnológico, comprador de tecnología y emprendedor tecnológico. Asesoró a empresas en sus decisiones tecnológicas en McKinsey & Company y Altman Solon durante más de una década. También publicó un informe de McKinsey sobre digitalización.
Dirigió la estrategia tecnológica y las adquisiciones de una empresa de telecomunicaciones reportando al CEO. También lideró el crecimiento comercial de la empresa de deep tech Hypatos, que alcanzó unos ingresos recurrentes anuales de 7 dígitos y una valoración de 9 dígitos desde 0 en 2 años. El trabajo de Cem en Hypatos fue cubierto por publicaciones tecnológicas líderes como TechCrunch y Business Insider.
Cem participa habitualmente en conferencias internacionales de tecnología. Se graduó en Bogazici University como ingeniero informático y tiene un MBA de Columbia Business School.





Sé el primero en comentar
Tu dirección de correo electrónico no será publicada. Todos los campos son obligatorios. Los comentarios se dejan en su idioma original.