


Agentes de IA locales: Goose, Observer IA, AnythingLLM

Los agentes de IA locales suelen describirse como sin conexión, en el dispositivo o totalmente locales. Pasamos tres días mapeando el ecosistema de agentes de IA locales que se ejecutan de forma autónoma en hardware personal sin depender de APIs externas ni de servicios en la nube.
Nuestro análisis clasifica las soluciones líderes en tres áreas clave, basado en pruebas prácticas con agentes de desarrollo, herramientas de automatización y asistentes de productividad.
Categorización de agentes de IA locales
Categoría | Herramientas/Frameworks | Casos de uso principales (local / sin conexión) |
|---|---|---|
Agentes de desarrollo y de sistema | Goose, Localforge, Devika, Roo Code (modo Boomerang), Continue.dev, Cursor, CodeGenie, SuperCoder, Aider, Cline, Kilo Code | Codificación local, depuración, automatización de archivos/procesos, tareas de DevOps locales |
Agentes locales de automatización y control | Observer IA, Browser-Use, DeepBrowser | Control local del navegador, automatización de archivos, interacción con aplicaciones, flujos de trabajo en el dispositivo |
Agentes de conocimiento y productividad | AnythingLLM (Desktop), LocalGPT (Single-User), PrivateGPT | Preguntas y respuestas de documentos sin conexión, resumen, búsqueda local/RAG |
Ver descripciones de categorías.
1. Agentes de desarrollo y de sistema
*Tipos de ejecución:
- Totalmente local: La herramienta se ejecuta de forma nativa en hardware personal mediante tiempos de ejecución locales. Herramientas capaces de funcionar completamente sin conexión.
- Híbrido local: El modelo principal o la ejecución de tareas se realiza localmente, pero algunas funciones, como la integración con el IDE, la indexación de contexto, la sincronización o el razonamiento, siguen dependiendo de servicios en la nube o APIs.
** Explicación de la columna En la máquina:
- Totalmente en el dispositivo: La operación completa sin conexión —inferencia, razonamiento y ejecución— se ejecuta localmente.
- Inferencia local, asistida por la nube: El modelo principal se ejecuta localmente, pero el IDE o las funciones de gestión utilizan servicios en línea.
- Ejecución local, razonamiento remoto: El código se ejecuta localmente, pero APIs externas impulsan el razonamiento o los pasos de planificación.
Goose
Goose es un agente de desarrollo de código abierto diseñado para funcionar totalmente en hardware local.1
Capacidades principales:
- Utiliza tiempos de ejecución locales de LLM para el razonamiento y la generación de código
- Ejecuta tareas de varios pasos, como escribir, probar y depurar código
- Interactúa directamente con el sistema de archivos local y las herramientas de desarrollo
- No requiere conectividad de red cuando se configura con modelos locales.
Goose cumple con una definición estricta de agente autónomo local, ya que la observación, el razonamiento y la acción ocurren en el dispositivo.
Roo Code(modo Boomerang)
Roo Code es un asistente de programación integrado en el IDE que hace hincapié en el refinamiento iterativo.
- El modo Boomerang permite la ejecución local de acciones
- El razonamiento normalmente depende de modelos basados en la nube
- Las funciones de coordinación y gestión del IDE no son totalmente locales
Como resultado, Roo Code debe clasificarse como un agente de desarrollo híbrido con intervención humana, en lugar de un sistema totalmente local.
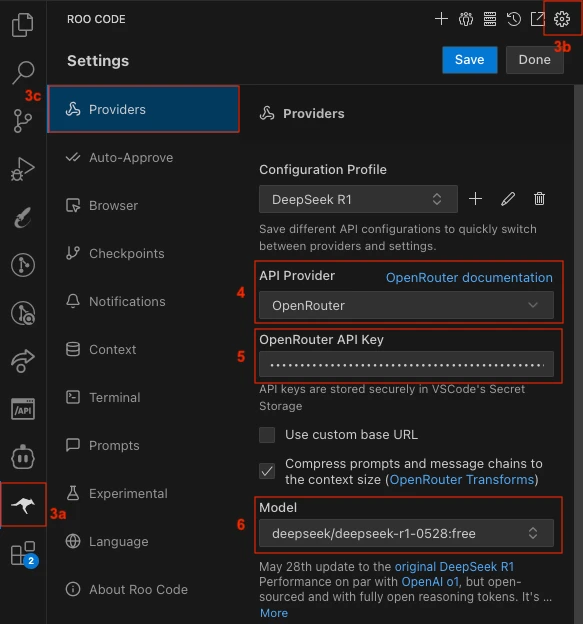
Configuración de un agente de IA local en Roo Code:
Roo Code permite a los desarrolladores crear perfiles de configuración personalizados que definen cómo se conecta a diferentes modelos de IA, incluidos los LLM alojados localmente.
Desde Configuración → Proveedores, puedes añadir perfiles a través de OpenRouter u otros proveedores compatibles y luego elegir un modelo local que se ejecute mediante Ollama o LM Studio.
Cada perfil de configuración puede almacenar sus propios parámetros, incluidos la temperatura, la profundidad de razonamiento y los límites de tokens. Esto permite alternar entre modelos ligeros en la nube y tiempos de ejecución totalmente locales para la inferencia en el dispositivo.
Cursor
Cursor permite el uso de LLM locales para la inferencia, pero sigue dependiendo de los servicios en la nube para:
- Indexación de código
- Edición de aplicaciones
- Coordinación de flujos de trabajo
Por lo tanto, Cursor admite la inferencia local, pero no un bucle de agente totalmente local y no puede funcionar sin conexión.
Cómo usar un LLM local en Cursor:
Fuente:Logan Hallucinates2
Aider
Aider es un asistente de programación de IA de código abierto, basado en línea de comandos, diseñado para trabajar directamente con repositorios Git locales. Modifica el código generando parches y confirmaciones en lugar de operar mediante una interfaz IDE.
Aider se usa a menudo con modelos alojados en la nube, pero:
- La herramienta en sí se ejecuta localmente
- Cuando se combina con un tiempo de ejecución de modelo local, puede funcionar completamente en el dispositivo
Por lo tanto, la capacidad sin conexión depende de la elección del modelo, no es intrínseca a la herramienta.
2. Agentes locales de automatización y control
Observer IA
Observer IA es un framework de agente de automatización local de código abierto.
Características principales:
- Ejecuta agentes utilizando LLM locales
- Observa el estado de la pantalla mediante OCR o capturas de pantalla
- Ejecuta código Python a través de un entorno de ejecución integrado
- No requiere conectividad en la nube
Observer IA proporciona la infraestructura para el comportamiento de los agentes en lugar de una política fija de agente, y se describe mejor como un framework de bucle de control local.
Browser-Use
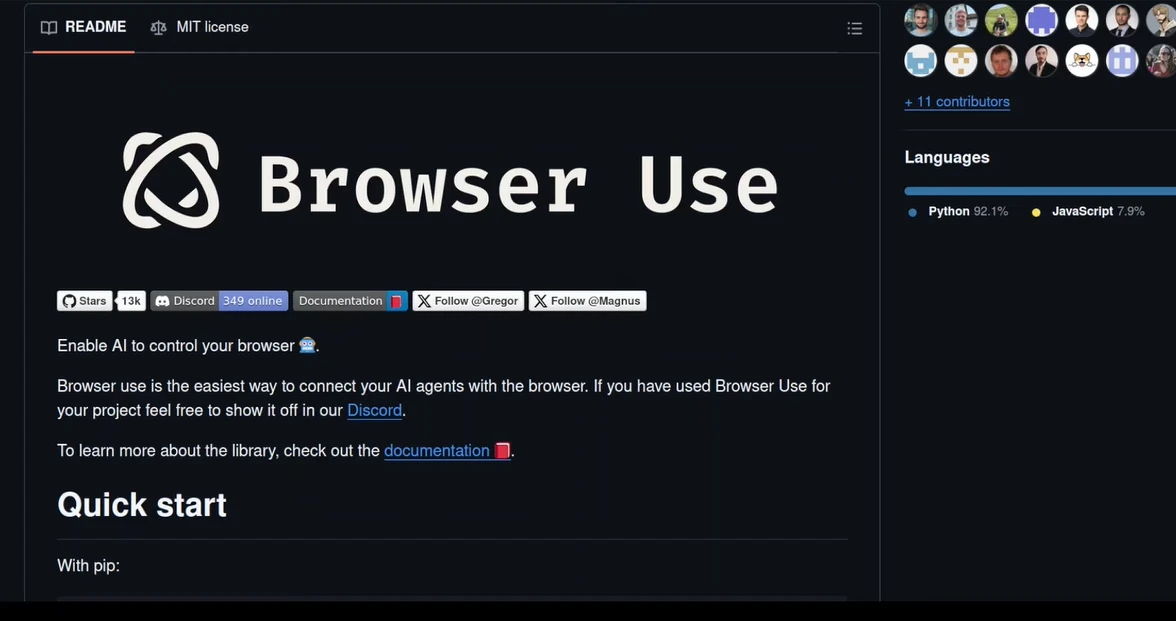
Browser-Use permite la interacción con el navegador impulsada por IA a través de Playwright.
- Las acciones del navegador se ejecutan localmente
- El razonamiento puede realizarse con modelos locales o remotos
- El funcionamiento sin conexión es posible cuando se combina con inferencia local
Esto sitúa a Browser-Use firmemente en la categoría de automatización híbrida de forma predeterminada.
Cómo usar un LLM local en Browser-Use:
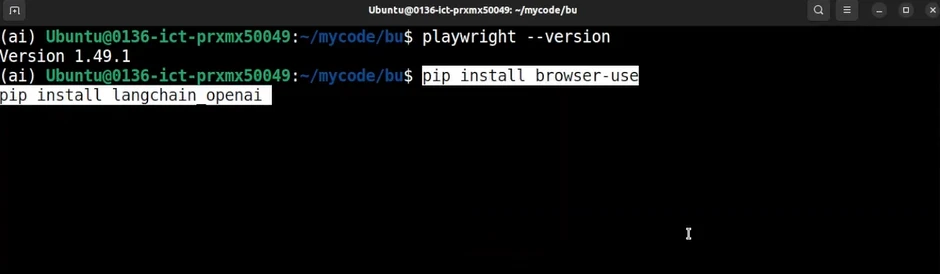
Un método para instalarlo es usar el comando pip install browser-use, que configura tanto la interfaz de Python como el control local del navegador en la misma máquina.
Cuando se ejecute posteriormente (por ejemplo, con python -m browser_use), abrirá y controlará una instancia del navegador localmente, ejecutando acciones y razonamiento ya sea a través de un LLM local (por ejemplo, mediante Ollama) o a través de APIs conectadas:
Configurar Browser-Use localmente3
Para quienes quieran ver la configuración completa en acción, aquí hay una guía en video paso a paso que muestra cómo instalar y ejecutar Browser-Use en una máquina local:
El tutorial cubre todo, desde la instalación de dependencias como Playwright y LangChain hasta la conexión de Browser-Use con un modelo local mediante Ollama.3
3. Agentes de conocimiento y productividad
AnythingLLM (escritorio)
Cuando se configura con modelos locales, AnythingLLM Desktop:
- Realiza la indexación de documentos localmente
- Ejecuta el razonamiento del agente en el dispositivo
- Admite capacidades de acción limitadas (p. ej., escritura de archivos)
- No requiere conectividad en la nube
Aunque su autonomía es limitada en comparación con los agentes de sistema, califica como agente de productividad local bajo una definición de tarea restringida.
Un uso ejemplar de un agente de IA local
Probamos AnythingLLM Desktop para ver cómo funciona un agente local en el dispositivo desde la configuración hasta la salida final.
1. Configuración del espacio de trabajo
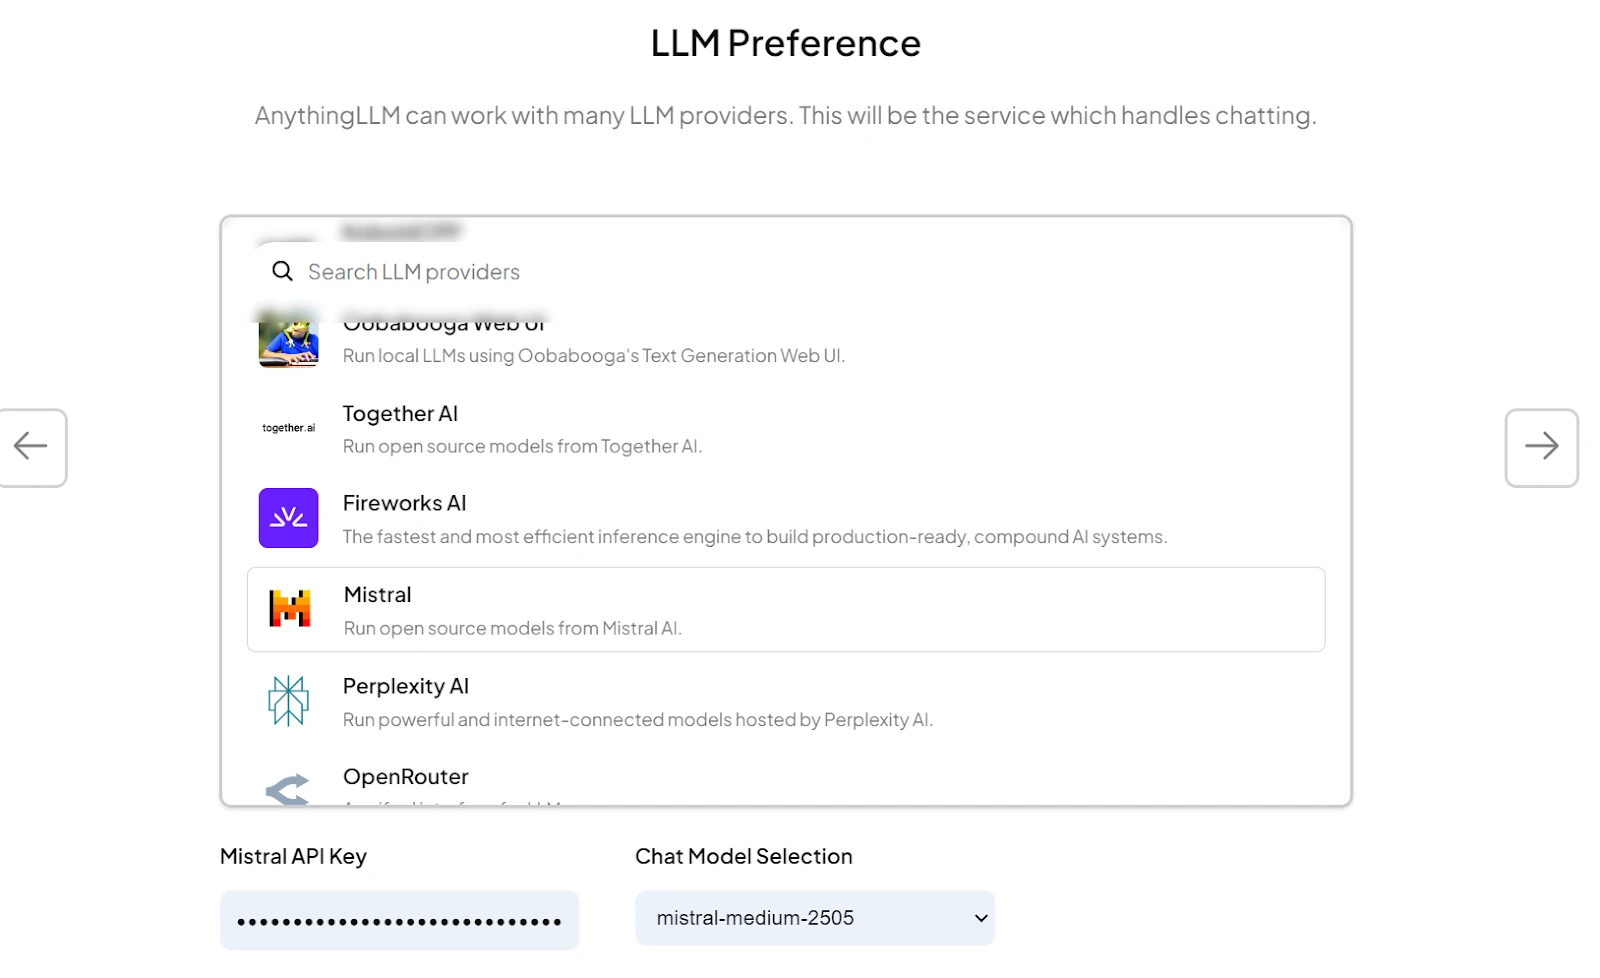
Abrimos la configuración del espacio de trabajo y fuimos a Configuración del agente.
Allí, elegimos un proveedor de LLM y seleccionamos el modelo mistral-medium-2505.
Después de hacer clic en Actualizar agente del espacio de trabajo, el espacio de trabajo confirmó que la configuración estaba completa.
2. Activación de las habilidades del agente
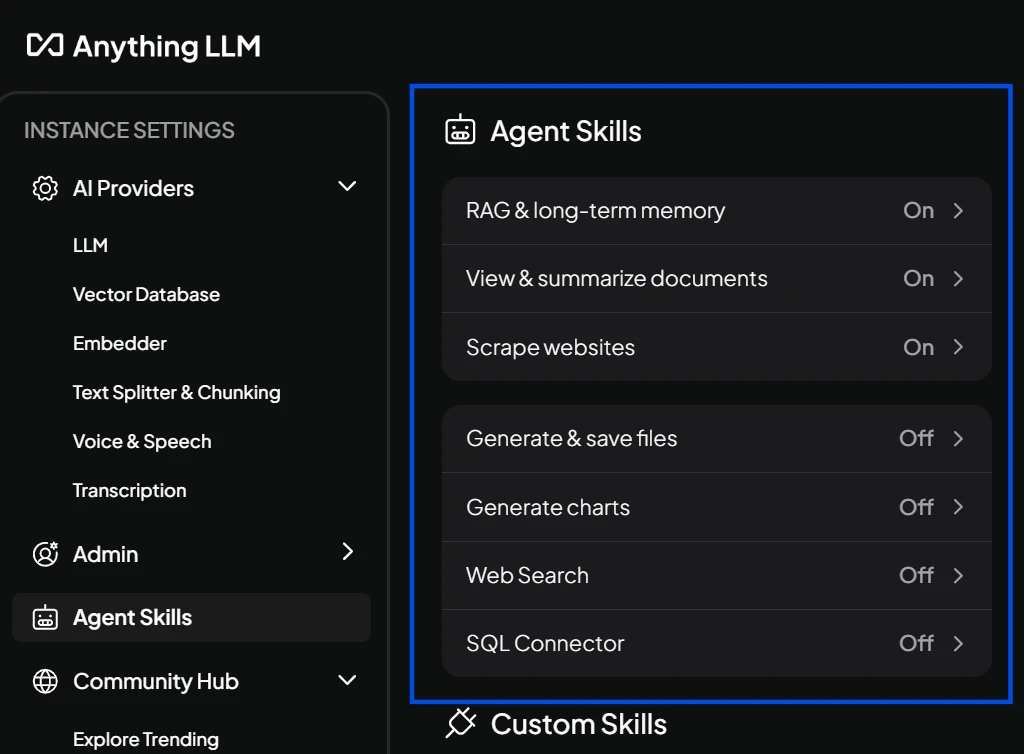
A continuación, abrimos el panel Configurar habilidades del agente.
Este menú permite activar las capacidades integradas del agente con un solo clic. No se requiere programación.
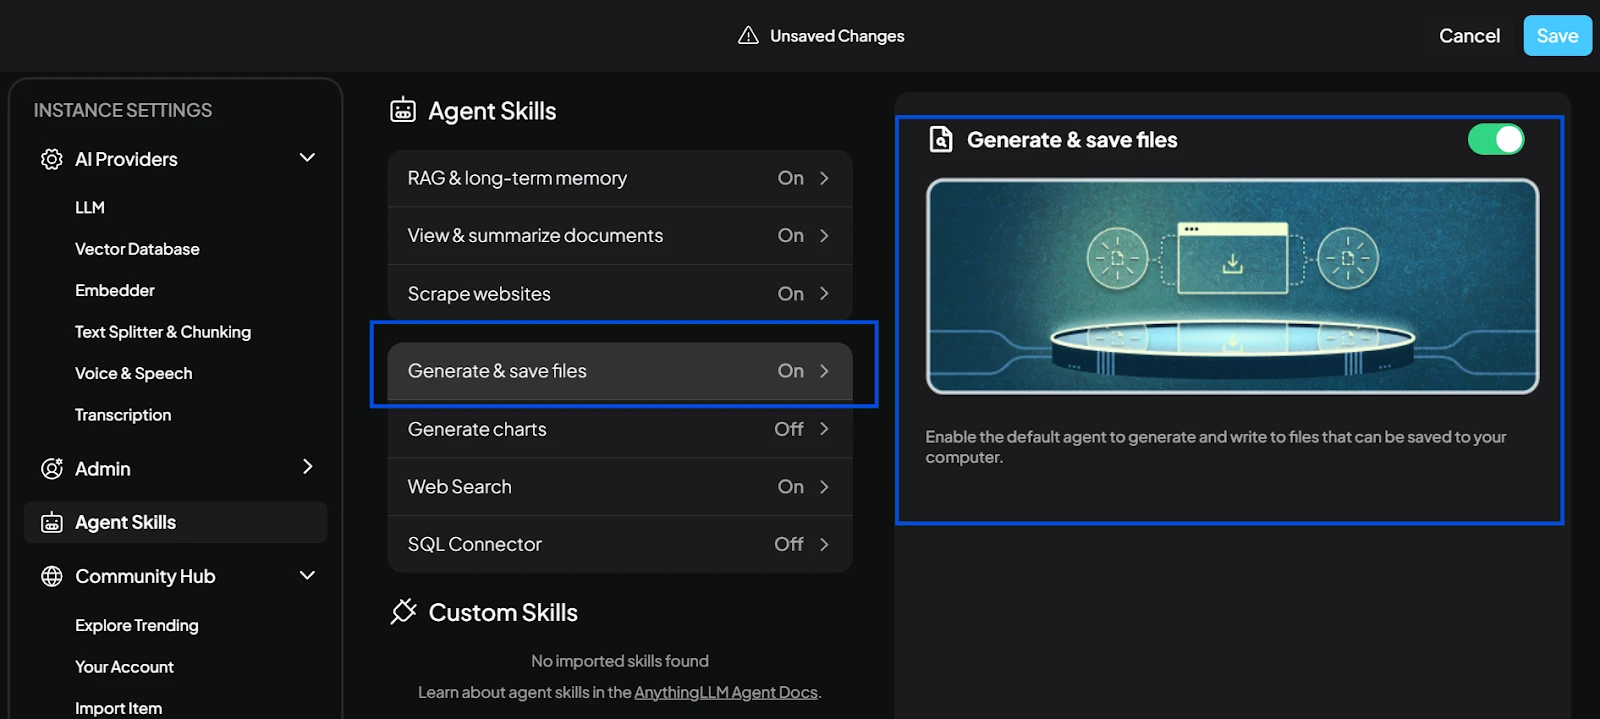
3. Prueba de la habilidad “Guardar Files”
Activamos la habilidad Guardar Files, lo que permite al agente escribir resultados directamente en la máquina local.
Después de activarla y guardar el cambio, el agente estaba listo.
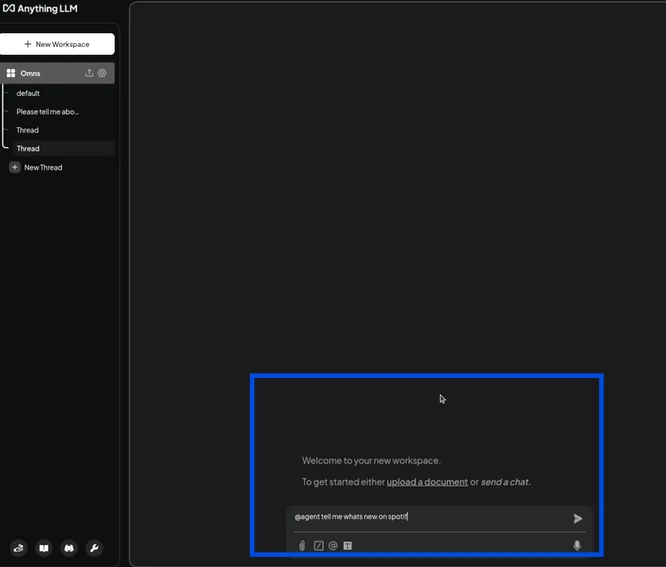
Para probarla, volvimos a la ventana de chat y usamos uno de los prompts de ejemplo de la documentación.
Esto confirmó que el agente podía generar un archivo y prepararlo para guardarlo localmente.
4. Ejecución del agente en el chat
Le pedimos al agente que summarize un tema histórico y lo invocamos usando @agent.
Modificamos el comando para guardar la salida como un archivo de texto simple en lugar de un PDF.
El sistema confirmó que el modo de chat del agente estaba activo y mostró cómo salir del bucle.
El agente generó el resumen y preparó el archivo para guardarlo.
5. Guardado del archivo localmente
Para guardar la salida, usamos el comando de ejemplo de la documentación de AnythingLLM:
“¿@agent puede guardar esta información como PDF en mi carpeta del escritorio?”
Ejecutamos la misma estructura en el chat, pero para un archivo de texto.
Se abrió una ventana del explorador de archivos y guardamos la salida en el dispositivo.
El archivo apareció en la carpeta Descargas, lo que indica que todo el proceso —razonamiento, ejecución y guardado— se realizó completamente en el dispositivo.
Descripciones de las categorías de agentes de IA locales
- Agentes de desarrollo y de sistema (capa de acción): Agentes que se ejecutan directamente en tu dispositivo para realizar tareas de codificación, sistema y automatización de flujos de trabajo localmente.
- Agentes locales de automatización y control: Agentes que automatizan acciones del mundo real en tu máquina controlando el navegador, la interfaz de usuario o el sistema operativo.
- Agentes de conocimiento y productividad: Asistentes locales para chat, resumen y manejo de documentos sin enviar datos a la nube.
Capas arquitectónicas en la pila del agente local
- Capa de acción (agentes): Sistemas que observan el estado, invocan herramientas y actúan sobre el entorno local.
- Capa de razonamiento y orquestación (frameworks): Bibliotecas como LangGraph o LlamaIndex que admiten planificación, memoria y coordinación. Estas no son agentes en sí mismas.
- Capa de ejecución (tiempos de ejecución locales): Tiempos de ejecución de modelos, como Ollama o LM Studio, que permiten la inferencia local.
Hardware: qué necesitan realmente los agentes locales
El modelo y el framework son la mitad de la historia. El hardware decide lo que es realmente posible. Para ejecutar modelos de lenguaje localmente, dos cifras son las más importantes: cuánta memoria tienes y qué tan rápida es esa memoria.
RAM (o VRAM) establece el límite máximo del tamaño del modelo
Un modelo debe caber en la memoria antes de poder ejecutarse. Una guía aproximada para modelos cuantizados de 4 bits: un modelo de 3B necesita alrededor de 2 GB, un modelo de 7–8B necesita alrededor de 5–6 GB, un modelo de 13B necesita alrededor de 8–10 GB y un modelo de 70B necesita alrededor de 40–48 GB. Añade margen para el contexto, el sistema operativo y cualquier otra aplicación en ejecución. En la práctica, la memoria es el cuello de botella con más frecuencia que la computación y, en los PC Copilot+, el objetivo recomendado para un uso local cómodo de LLM es de al menos 32 GB de RAM.4
El ancho de banda de memoria establece la velocidad
Una vez que un modelo cabe, la rapidez con la que genera tokens depende sobre todo de la rapidez con la que el sistema puede leer los pesos del modelo desde la memoria. Por eso el alto ancho de banda de memoria de Apple Silicon (hasta 800 GB/s en el M4 Max) es la ventaja práctica para la inferencia de LLM, no el número de motores neuronales.5
Los TOPS de la NPU importan menos de lo que sugiere el marketing
Una unidad de procesamiento neuronal es un chip diseñado para cálculos de IA, y su clasificación se expresa en TOPS (billones de operaciones por segundo). La certificación Copilot+ PC de Microsoft requiere al menos 40 TOPS. Ese umbral está orientado a las funciones propias en el dispositivo de Microsoft (subtítulos en vivo, efectos de imagen, Recall) en lugar de ejecutar un LLM de estilo chat. Para cargas de trabajo de LLM, dominan la RAM y el ancho de banda. El rendimiento de la NPU es un criterio de desempate útil, no la cifra principal.
Una regla práctica:
- Para modelos de asistentes de clase 3B, un portátil actual con 16 GB de memoria unificada o RAM es suficiente.
- Para modelos de 7–8B con velocidad cómoda, apunta a 32 GB de RAM y un ancho de banda de memoria alto. Apple Silicon, la serie Snapdragon X y los PC Copilot+ actuales con Intel/AMD funcionan todos; las diferencias se notan en tokens por segundo, no en si el modelo se ejecuta.
- Para modelos más grandes (30B en adelante), las opciones se dividen. Apple Silicon de alta memoria (configuraciones de Mac Studio o MacBook Pro con 64–192 GB de memoria unificada) puede ejecutar modelos grandes que ninguna GPU discreta de consumo puede alojar. La alternativa es una estación de trabajo con una o más GPUs discretas de alta VRAM. Ambas vías funcionan; tienen perfiles de coste y consumo diferentes.
 Añadir como fuente preferida
Guía práctica
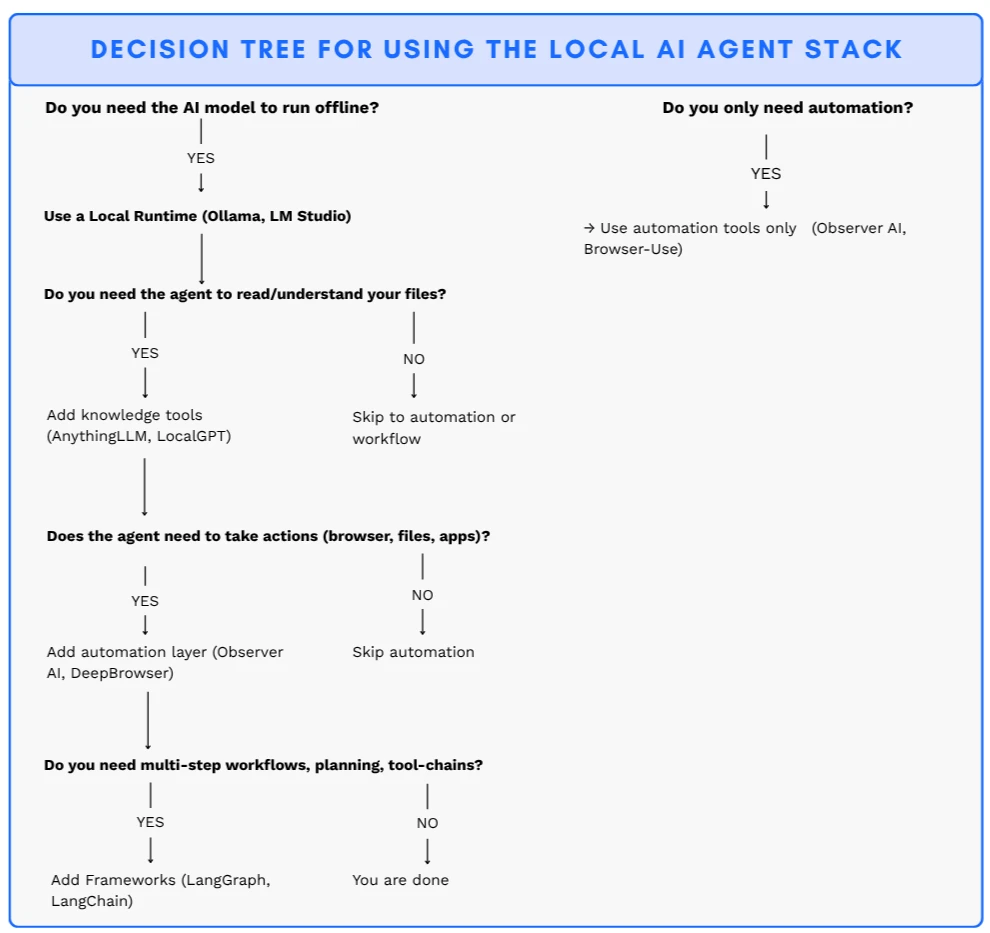
Los sistemas de IA locales deben ensamblarse de forma incremental:
- Comienza con un tiempo de ejecución local si se requiere inferencia sin conexión.
- Añade una capa de conocimiento cuando se necesite comprensión de documentos.
- Introduce agentes de automatización o control cuando se requieran acciones en el mundo real.
- Usa frameworks de orquestación para flujos de trabajo complejos de varios pasos.
En la mayoría de los casos, no es necesaria una pila completamente por capas.
Cómo abordar la pila de agentes de IA locales
Comienza con el conjunto más pequeño de capas que requiera tu caso de uso. Si tu agente necesita razonamiento sin conexión, empieza con un tiempo de ejecución local como Ollama o LM Studio. Si necesita comprender tus archivos, añade una capa de conocimiento como AnythingLLM o LocalGPT. Para los agentes que deben realizar acciones (abrir aplicaciones, controlar el navegador, gestionar archivos) añade una capa de automatización local. Usa frameworks como LangGraph o LlamaIndex cuando necesites flujos de trabajo de varios pasos, bucles de planificación o cadenas de herramientas complejas.
Por qué ejecutar un agente localmente
La privacidad es una cuestión legal, no una preferencia
En virtud de la Ley Ómnibus Digital, las obligaciones de alto riesgo de la Ley de IA de la UE se aplican ahora desde el 2 de diciembre de 2027 para los sistemas independientes (anexo III) y desde el 2 de agosto de 2028 para la IA en productos regulados; las obligaciones de transparencia en virtud del artículo 50 se aplican desde el 2 de agosto de 2026.6 Las sanciones pueden alcanzar €15 millones o el 3 % del volumen de negocios anual mundial. Un modelo que se ejecuta en tu propio hardware procesa los datos en tu entorno, sin transmitirlos a un proveedor de nube. El riesgo de transferencia transfronteriza de datos desaparece.7
Latencia
Las llamadas a la API en la nube añaden 200–500ms de retardo de red antes de que aparezca el primer token. La inferencia en el dispositivo lo reduce a menos de 20ms. Para los agentes de voz, la finalización de código y cualquier cosa que interactúe con una interfaz de usuario en tiempo real, esta es la diferencia entre fluidez y retraso
Coste en volumen
Las llamadas a la nube son baratas por solicitud y caras en grandes volúmenes. Un modelo local tiene un coste de hardware fijo y no hay factura por token. La compensación sigue siendo real: los agentes locales están limitados por el modelo que cabe en la memoria y por el hardware disponible. Las siguientes secciones cubren ambos aspectos.
Preguntas frecuentes
Los agentes de IA locales operan de forma autónoma en hardware personal sin depender de APIs externas ni de infraestructura en la nube.
Cita esta investigación
Elige el formato que se ajuste al lugar donde vas a publicar. Pegar la versión con enlace en tu CMS conserva el enlace de retroceso.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Arslan, Ezgi},
  title  = {{Agentes de IA locales: Goose, Observer IA, AnythingLLM}},
  year   = {2026},
  month  = jul,
  howpublished    = {\url{https://aimultiple.com/local-ai-agent}},
  note   = {AIMultiple. Recuperado el 30 de julio de 2026}
}Resultados y marcas de tiempo de 19 puntos de datos. Descargue los datos resumidos que se muestran en los gráficos y las tablas de este artículo como un archivo ZIP que contiene 4 archivos CSV.
¿Quieres los datos granulares que hay detrás? Únete a Premium
Registro de cambios
3 actualizacionesAñadidas las secciones "Por qué ejecutar un agente localmente" y requisitos de hardware local.
Se eliminaron las secciones 'Frameworks' y 'Local runtimes & infrastructure'.
Enlaces de referencia
El trabajo de Cem en AIMultiple ha sido citado por publicaciones líderes mundiales como Business Insider, Forbes, Morning Brew y Washington Post, empresas globales como Deloitte y HPE, ONG como World Economic Forum y organizaciones supranacionales como European Commission. [1], [2], [3], [4], [5]
A lo largo de su carrera, Cem trabajó como consultor tecnológico, comprador de tecnología y emprendedor tecnológico. Asesoró a empresas en sus decisiones tecnológicas en McKinsey & Company y Altman Solon durante más de una década. También publicó un informe de McKinsey sobre digitalización.
Dirigió la estrategia tecnológica y las adquisiciones de una empresa de telecomunicaciones reportando al CEO. También lideró el crecimiento comercial de la empresa de deep tech Hypatos, que alcanzó unos ingresos recurrentes anuales de 7 dígitos y una valoración de 9 dígitos desde 0 en 2 años. El trabajo de Cem en Hypatos fue cubierto por publicaciones tecnológicas líderes como TechCrunch y Business Insider.
Cem participa habitualmente en conferencias internacionales de tecnología. Se graduó en Bogazici University como ingeniero informático y tiene un MBA de Columbia Business School.

Siguiente para leer
Comparativa de plataformas de agentes de IA: Claude Managed Agents frente a Google Vertex Agent Engine

Creación de agentes personales de IA + 18 plataformas y herramientas de agentes

Construcción de agentes de IA con patrones componibles


Sé el primero en comentar
Tu dirección de correo electrónico no será publicada. Todos los campos son obligatorios. Los comentarios se dejan en su idioma original.