


Reranker Benchmark: Top 8 Models comparados
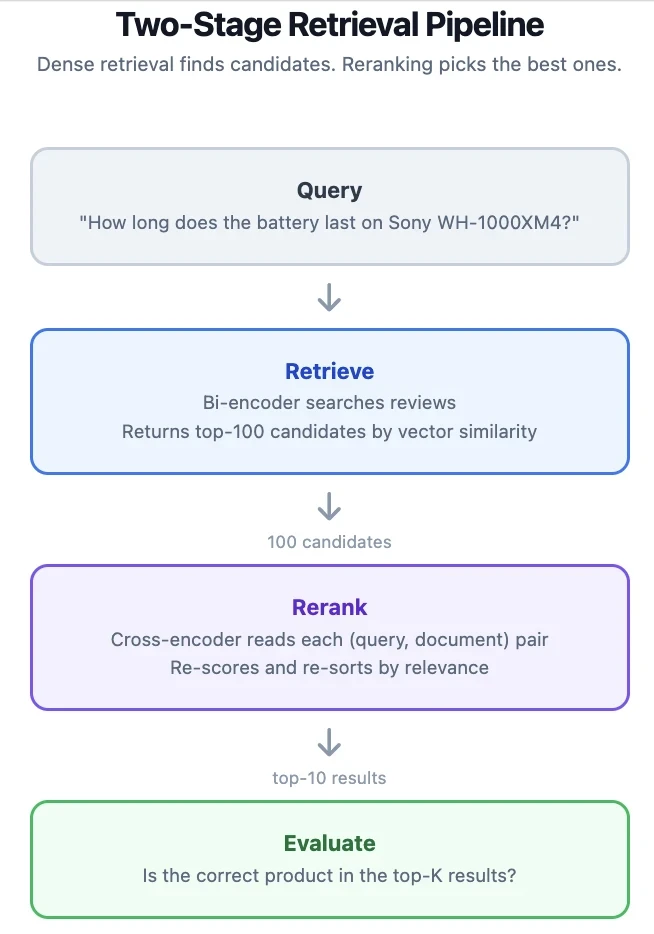
Evaluamos 8 models de reranker en ~145k reseñas en inglés de Amazon para medir cuánto mejora la recuperación densa una etapa de reranking. Recuperamos los 100 principales candidatos con multilingual-e5-base, los rerankeamos con cada model y evaluamos los 10 primeros resultados frente a 300 consultas, cada una referenciando detalles concretos de su reseña de origen. El mejor reranker elevó Hit@1 del 62,67 % al 83,00 % (+20.33pp).
Resultados del benchmark de reranking
Métricas explicadas:
ΔHit@1 / ΔHit@10 muestra la mejora sobre la línea base (sin reranker) en puntos porcentuales (pp). Por ejemplo, +20.33pp significa que el reranker mejoró Hit@1 en 20.33 puntos porcentuales en comparación con el 62,67 % de la línea base.
Hit@K mide si alguna reseña con el product_id correcto aparece en los primeros K resultados. La verdad de referencia es el product_id de la reseña que generó la consulta. Si una reseña diferente del mismo producto entra en el top-K, eso cuenta como un acierto. Hit@1 es la prueba más estricta: ¿es el primer resultado del producto correcto? Hit@10 es más indulgente: ¿está el producto correcto en algún lugar entre los primeros 10 resultados?
MRR@10 (rango recíproco medio) promedia 1/rango del primer resultado correcto en todas las consultas. Si el primer product_id coincidente está en el rango 1, la puntuación es 1.0. En el rango 2, es 0.5. En el rango 10, es 0.1. Esto premia a los models que colocan el producto correcto lo más alto posible.
nDCG@10 (ganancia acumulada descontada normalizada) evalúa las posiciones de todas las reseñas coincidentes en el top-10, no solo la primera. Si el mismo producto tiene varias reseñas en el conjunto de candidatos y varias entran en el top-10, nDCG acredita cada una según su posición. En la práctica, la mayoría de los productos tienen solo 1-2 reseñas en los 100 principales candidatos, por lo que nDCG y MRR se siguen de cerca.
Recall@10 mide la fracción de reseñas coincidentes (mismo product_id) en el top-10 sobre todas las reseñas coincidentes en el conjunto completo de candidatos (top-100). Si un producto tiene 3 reseñas en el top-100 y el reranker coloca 2 de ellas en el top-10, Recall@10 es 2/3 para esa consulta. Como la mayoría de los productos tienen pocas reseñas duplicadas en el conjunto de candidatos, Recall@10 y Hit@10 son casi idénticos en este benchmark.
Desglose de latencia
La latencia de reranking mide el tiempo que tarda cada cross-encoder en puntuar 100 documentos candidatos frente a la consulta. El tiempo de búsqueda vectorial (~20ms) se excluye porque se mantiene constante en todas las ejecuciones y es independiente del reranker.
Métricas de latencia explicadas:
Rerank es el tiempo que tarda el cross-encoder en puntuar los 100 documentos candidatos frente a la consulta. Aquí es donde los models difieren: una sola pasada hacia adelante es rápida, mientras que la decodificación autorregresiva es lenta.
P95 es el percentil 95 de latencia total. Algunas consultas tienen textos de reseña más largos, lo que aumenta el tiempo de tokenización y puntuación. P95 muestra el peor caso que deberías esperar para el 95 % de las consultas.
Hallazgos clave
Un model de 149M iguala a un model de 1.2B
gte-reranker-modernbert-base tiene 149M parámetros, nemotron-rerank-1b tiene 1.2B. Ambos alcanzan un 83,00 % de Hit@1 en inglés. La arquitectura ModernBERT es 8x más pequeña y ofrece una precisión de primer nivel idéntica.
Esto no significa que el tamaño del model sea irrelevante. nemotron se adelanta en MRR@10 (0.8514 vs 0.8483) y Hit@10 (88,33 % vs 88,00 %), lo que significa que clasifica los documentos relevantes ligeramente mejor en todo el top-10. Pero para la mayoría de las aplicaciones donde lo que importa es acertar el primer resultado, el model de 149M es suficiente.
El model más grande no es el mejor
qwen3_reranker_4b tiene 4B parámetros y tarda más de un segundo por consulta. Alcanza un 77,67 % de Hit@1, en cuarto lugar detrás de nemotron (1.2B), gte_modernbert (149M) y jina (560M). Pagas 4.5x la latencia de nemotron por 5.3 puntos porcentuales menos de precisión.
La arquitectura de qwen3 utiliza modelado de lenguaje causal con un enfoque logit de sí/no. El model lee el par consulta-documento y produce la probabilidad de “sí, esto es relevante”. Esto es conceptualmente limpio, pero la inference es costosa debido a la sobrecarga de decodificación autorregresiva. Los models SequenceClassification (gte_modernbert, bge) y el enfoque de plantilla de prompt de nemotron procesan el par en una sola pasada hacia adelante, lo que es fundamentalmente más rápido.
Jina ofrece el mejor equilibrio entre velocidad y precisión
jina_reranker_v3 alcanza un 81,33 % de Hit@1 a 188ms. nemotron alcanza un 83,00 % a 243ms. Si necesitas una latencia total por consulta inferior a 200ms, Jina es el único model de la categoría superior que lo logra. La brecha de 1.67 puntos porcentuales puede no justificar los 55ms adicionales en un sistema de producción que sirve miles de solicitudes por segundo.
Un reranker empeora los resultados
mxbai_rerank_xsmall (70M params) obtiene un 64,67 % de Hit@1. La línea base sin ningún reranker obtiene un 62,67 %. La mejora es de solo 2 puntos porcentuales, lo que está dentro del ruido para 300 consultas. Con 70M parámetros, el model carece de capacidad para juzgar de forma fiable la relevancia consulta-documento en textos más largos o con más matices.
Un reranker no es automáticamente beneficioso. Pruébalo con tus datos reales antes de desplegarlo.
El retriever marca el techo
Todos los mejores rerankers convergen en torno a un 87-88 % de Hit@10. Este techo proviene del retriever. Si multilingual-e5-base no coloca el documento correcto entre los 100 principales candidatos, ningún reranker puede recuperarlo. El 12 % restante de consultas en las que todos los rerankers fallan representa casos en los que el retriever denso simplemente omitió por completo el documento relevante.
Mejorar más allá de este techo requiere un mejor retriever, un grupo de candidatos más grande o ambos. Probamos los 250 principales candidatos y encontramos casi ninguna mejora respecto a los 100 principales, lo que significa que e5_base agota sus candidatos útiles mucho antes del rango 250.
Cómo funcionan los rerankers
Un retriever denso (bi-encoder) codifica consultas y documentos de forma independiente en vectores. La recuperación es una búsqueda de vecinos más cercanos sobre estos vectores. Esto es rápido porque solo codificas la consulta en el momento de la búsqueda, pero el model nunca ve la consulta y el documento juntos, por lo que puede omitir señales de relevancia matizadas.
Un reranker (cross-encoder) toma un par consulta-documento como una única entrada. El model atiende a ambos textos de forma conjunta, captando relaciones que la codificación independiente pasa por alto. El coste es que debes ejecutar el model una vez por candidato, por lo que solo puedes permitirte puntuar un grupo pequeño.
Arquitecturas en este benchmark
Probamos cuatro arquitecturas de cross-encoder diferentes:
Los models SequenceClassification (bge_base, bge_v2_m3, mxbai_xsmall, gte_modernbert) toman un par [query, document] como entrada y producen una única puntuación logit. Este es el enfoque más simple y común.
Nemotron utiliza un formato de plantilla de prompt: “question:{q} passage:{p}”. La entrada parece texto plano en lugar de un par estructurado, pero el model sigue produciendo una única puntuación de relevancia mediante SequenceClassification. El preentrenamiento de LLM (basado en Llama) le otorga una sólida comprensión del lenguaje.
Los rerankers Qwen3 utilizan modelado de lenguaje causal. El model lee el par y genera un juicio de sí/no. La puntuación es log P(yes) / (P(yes) + P(no)). Esto requiere toda la maquinaria autorregresiva, lo que explica la mayor latencia.
Jina v3 utiliza una API personalizada (model.rerank()) que gestiona la tokenización y la puntuación internamente. La arquitectura subyacente utiliza atención cruzada, pero la interfaz abstrae los detalles.
Metodología del benchmark de reranker
- GPU: NVIDIA H100 PCIe 80GB vía Runpod
- Base de datos vectorial: Qdrant 1.12.0 (binario local), distancia coseno
- Retriever: multilingual-e5-base (768 dimensiones). Prefijo de consulta:
"query: ", prefijo de documento:"passage: " - Software: transformers 5.2.0, PyTorch 2.8.0, CUDA 12.8.1
- Dataset: subconjunto en inglés de Amazon Reviews Multi (Kaggle).1 ~145k reseñas después de filtrar por un mínimo de 100 caracteres. Cada reseña tiene un product_id, texto de reseña y valoración por estrellas.
- Generación de consultas: Claude Sonnet 4.6 vía OpenRouter. 300 consultas en inglés (5 tipos: factual, opinión, uso, resolución de problemas, comparación de características). Cada consulta debe hacer referencia a detalles específicos de su reseña de origen; las preguntas genéricas (puntuación de especificidad < 4/5) se filtran.
- Formato de documento:
"Review Title: {title}\nReview: {body}" - Pipeline: recupera los 100 principales candidatos con multilingual-e5-base, rerankea con un cross-encoder y devuelve los 10 primeros. La línea base omite el reranking y devuelve directamente los 10 primeros del retriever.
- Ground truth: solo coincidencia exacta de product_id. Sin respaldo por similitud coseno. Sin crédito parcial por productos semánticamente similares.
- Variable controlada: solo cambia el model de reranker entre experimentos. El retriever, el número de candidatos, el conjunto de consultas y los criterios de evaluación son idénticos en todas las ejecuciones.
- Sin fine-tuning: todos los models se evalúan en zero-shot con los pesos predeterminados de HuggingFace.
- Latencia: reranking (puntuación del cross-encoder de 100 candidatos). Medida por consulta en GPU.
Models probados
 Añadir como fuente preferida
Limitaciones
Este benchmark utiliza un único retriever (multilingual-e5-base). Un retriever diferente produciría conjuntos de candidatos distintos y podría cambiar la clasificación de los rerankers. Los resultados reflejan qué tan bien funciona cada reranker con este retriever específico, no la calidad del reranker de forma aislada.
Probamos con reseñas de productos en inglés de Amazon. El rendimiento en otros dominios (artículos científicos, documentos legales, código) u otros idiomas será diferente.
El número de candidatos está fijado en 100. Algunos rerankers podrían clasificar de forma diferente con 20 o 200 candidatos. Probamos 250 candidatos y encontramos una mejora insignificante, lo que sugiere que 100 es suficiente para e5_base, pero otros retrievers pueden comportarse de manera diferente.
300 consultas es un tamaño de muestra moderado. Los tres mejores models (nemotron, gte_modernbert, jina) están separados por menos de 2 puntos porcentuales. Con un conjunto de consultas más grande, estas clasificaciones podrían cambiar. La brecha entre el nivel superior y el nivel inferior (20+ puntos porcentuales) es robusta.
Conclusión
Los rerankers funcionan. El mejor model en este benchmark eleva Hit@1 del 62,67 % al 83,00 % (+20.33pp), lo que significa que 20 de cada 100 consultas que antes devolvían primero el documento incorrecto ahora devuelven el correcto. Es una ganancia significativa para un componente que añade menos de 250ms de latencia.
El hallazgo más útil es que el tamaño del model no determina la calidad del reranker. gte-reranker-modernbert-base con 149M parámetros iguala a nemotron-rerank-1b con 1.2B en Hit@1. El model Qwen3 de 4B parámetros termina cuarto. Si estás eligiendo un reranker para un sistema de producción, empieza por los models más pequeños. Puede que nunca necesites los más grandes.
Para aplicaciones sensibles a la latencia, jina-reranker-v3 es la opción más sólida por debajo de 200ms. Para máxima precisión sin restricción de latencia, nemotron-rerank-1b y gte-reranker-modernbert-base comparten el primer puesto. Para equipos con presupuesto de GPU, gte-modernbert es el claro ganador: la misma precisión que el model de 1.2B con una fracción de la huella de memoria.
Un patrón se mantuvo en todos los experimentos: el retriever establece el techo. Ningún reranker elevó Hit@10 por encima del 88 %, porque el 12 % restante de documentos correctos nunca apareció entre los 100 principales candidatos. Invertir en un mejor retriever probablemente producirá mayores ganancias que cambiar entre los tres mejores rerankers.
Lecturas adicionales
Explora otros benchmarks de RAG, como:
- Embedding Models: OpenAI vs Gemini vs Cohere
- Top 16 Embedding Models de código abierto para RAG
- La mejor base de datos vectorial para RAG: Qdrant vs Weaviate vs Pinecone
- Benchmark de RAG agéntico: enrutamiento entre múltiples bases de datos y generación de consultas
- Embedding Models multimodales: Apple vs Meta vs OpenAI
- Top 10 Embedding Models multilingües para RAG
Cita este benchmark
Elige el formato que se ajuste al lugar donde vas a publicar. Pegar la versión con enlace en tu CMS conserva el enlace de retroceso.
@misc{sari2026,
  author = {Sarı, Ekrem},
  title  = {{Reranker Benchmark: Top 8 Models comparados}},
  year   = {2026},
  month  = feb,
  howpublished    = {\url{https://aimultiple.com/rerankers}},
  note   = {AIMultiple. Recuperado el 26 de febrero de 2026}
}Resultados y marcas de tiempo de 17 puntos de datos. Descargue los datos resumidos que se muestran en los gráficos y las tablas de este artículo como un archivo ZIP que contiene 2 archivos CSV y un README.
¿Quieres los datos granulares que hay detrás? Únete a Premium
Enlaces de referencia




Sé el primero en comentar
Tu dirección de correo electrónico no será publicada. Todos los campos son obligatorios. Los comentarios se dejan en su idioma original.