


Outils de détection d'hallucinations IA: W&B Weave & Comet
Nous avons évalué trois outils de détection d'hallucinations : W&B Weave HallucinationFree Scorer (partie de CoreWeave Forge, anciennement Weights & Biases), Arize Phoenix HallucinationEvaluator et Comet Opik Hallucination Metric, sur 100 cas de test.
Chaque outil a été évalué sur l'exactitude, la précision, le rappel et la latence.
Benchmark des outils de détection d'hallucinations IA
Nous avons testé 100 réponses (50 correctes, 50 hallucinées) issues de scénarios de questions-réponses factuels, par rapport à leur contexte source.
Comparaison de l'exactitude et de la latence
Consultez la section méthodologie du benchmark. pour plus de détails sur le processus de test.
W&B Weave et Arize Phoenix ont obtenu une exactitude quasi identique, respectivement 91 % et 90 %. Les deux outils ont montré des performances fiables sur l'ensemble du dataset. Comet Opik a pris du retard avec une exactitude de 72 %, ne classant correctement que 72 des 100 tests, un écart significatif dû à son approche conservatrice.
En termes de vitesse, Arize Phoenix a été le gagnant avec 2 secondes par test, ce qui le rend adapté aux applications en temps réel. W&B Weave a traité les tests en 4 secondes, ce qui est raisonnable pour la plupart des cas d'usage en production. Comet Opik a été nettement plus lent à 8,5 secondes par test, ce qui pourrait affecter l'expérience utilisateur dans les applications sensibles à la latence.
Score F1, précision et rappel
Les scores F1 (moyenne harmonique de la précision et du rappel) ont confirmé ces tendances : W&B Weave à 90,5 % et Phoenix à 89,4 % ont tous deux atteint des performances solides et équilibrées. En comparaison, le 61,1 % d'Opik reflète le compromis entre une précision parfaite et un rappel faible. L'absence de faux positifs d'Opik s'est faite au prix de 28 faux négatifs, ce qui le rend adapté uniquement aux scénarios où les fausses alertes coûtent plus cher que les détections manquées.
Le rappel (capacité à détecter les hallucinations réelles) a révélé des stratégies distinctes. W&B Weave a dominé avec un rappel de 86 %, détectant 43 des 50 hallucinations et n'en manquant que 7. Phoenix a suivi de près à 84 %, détectant 42 hallucinations et en manquant 8. Le rappel de Comet Opik était nettement inférieur à 44 %, ne détectant que 22 hallucinations tout en manquant 28 ; plus de la moitié des hallucinations réelles sont passées inaperçues.
La précision (fiabilité des alertes) a montré une variation significative. Comet Opik a atteint une précision parfaite de 100 % avec zéro faux positif : lorsqu'il signalait quelque chose comme une hallucination, c'était toujours correct. Phoenix (95,5 %) et Weave (95,6 %) ont montré une précision quasi identique, chacun ne produisant que 2 faux positifs sur 50 réponses légitimes, démontrant une grande fiabilité sans être trop conservateur.
Facteurs susceptibles d'influencer les différences de performance
Les différences de performance observées sont probablement dues à la philosophie de conception, au choix des seuils et à l'interprétation du grounding.
Différences de stratégie de détection et d'objectifs d'optimisation
- Les outils semblent être optimisés pour différents compromis d'erreurs plutôt que pour le même objectif.
- W&B Weave et Arize Phoenix visent des performances équilibrées, en maintenant une précision élevée tout en capturant la plupart des hallucinations.
- Comet Opik adopte une stratégie très conservatrice, privilégiant zéro faux positif même si de nombreuses hallucinations sont manquées.
- Ce choix stratégique explique directement la précision parfaite d'Opik et son rappel nettement inférieur.
Compromis précision-rappel intégrés dans la conception des outils
- L'absence de faux positifs de Comet Opik indique un seuil de décision strict, ne signalant les hallucinations que lorsque la confiance est très élevée.
- W&B Weave et Phoenix utilisent des seuils moins restrictifs, autorisant certains faux positifs en échange d'un rappel beaucoup plus élevé.
- Ces différences de seuils peuvent conduire à :
- Une précision similaire entre Weave et Phoenix
- De grands écarts de rappel entre Opik et les deux autres outils
- Des différences correspondantes dans le score F1 et l'exactitude globale
Variations dans l'implémentation du LLM-as-a-judge
- Bien que les trois outils utilisent une approche LLM-as-a-judge, leurs implémentations diffèrent.
- W&B Weave met l'accent sur le raisonnement par chaîne de pensée, ce qui peut améliorer la sensibilité aux affirmations non étayées subtiles.
- Arize Phoenix intègre des sorties basées sur des étiquettes avec des scores de confiance, permettant des jugements plus nuancés.
- Comet Opik se concentre sur des décisions binaires à haute confiance, ce qui réduit les fausses alarmes mais limite la sensibilité aux hallucinations limites.
Différences de latence dues à la profondeur d'évaluation
- La latence plus faible d'Arize Phoenix suggère un pipeline d'évaluation plus léger ou plus rationalisé, adapté à une utilisation en temps réel.
- La latence modérée de W&B Weave est cohérente avec un raisonnement plus riche et la journalisation des traces.
- La latence plus élevée de Comet Opik reflète probablement un raisonnement interne ou des étapes de vérification plus étendus, renforçant sa conception conservatrice.
Outils de détection d'hallucinations IA
HallucinationFree Scorer de W&B Weave
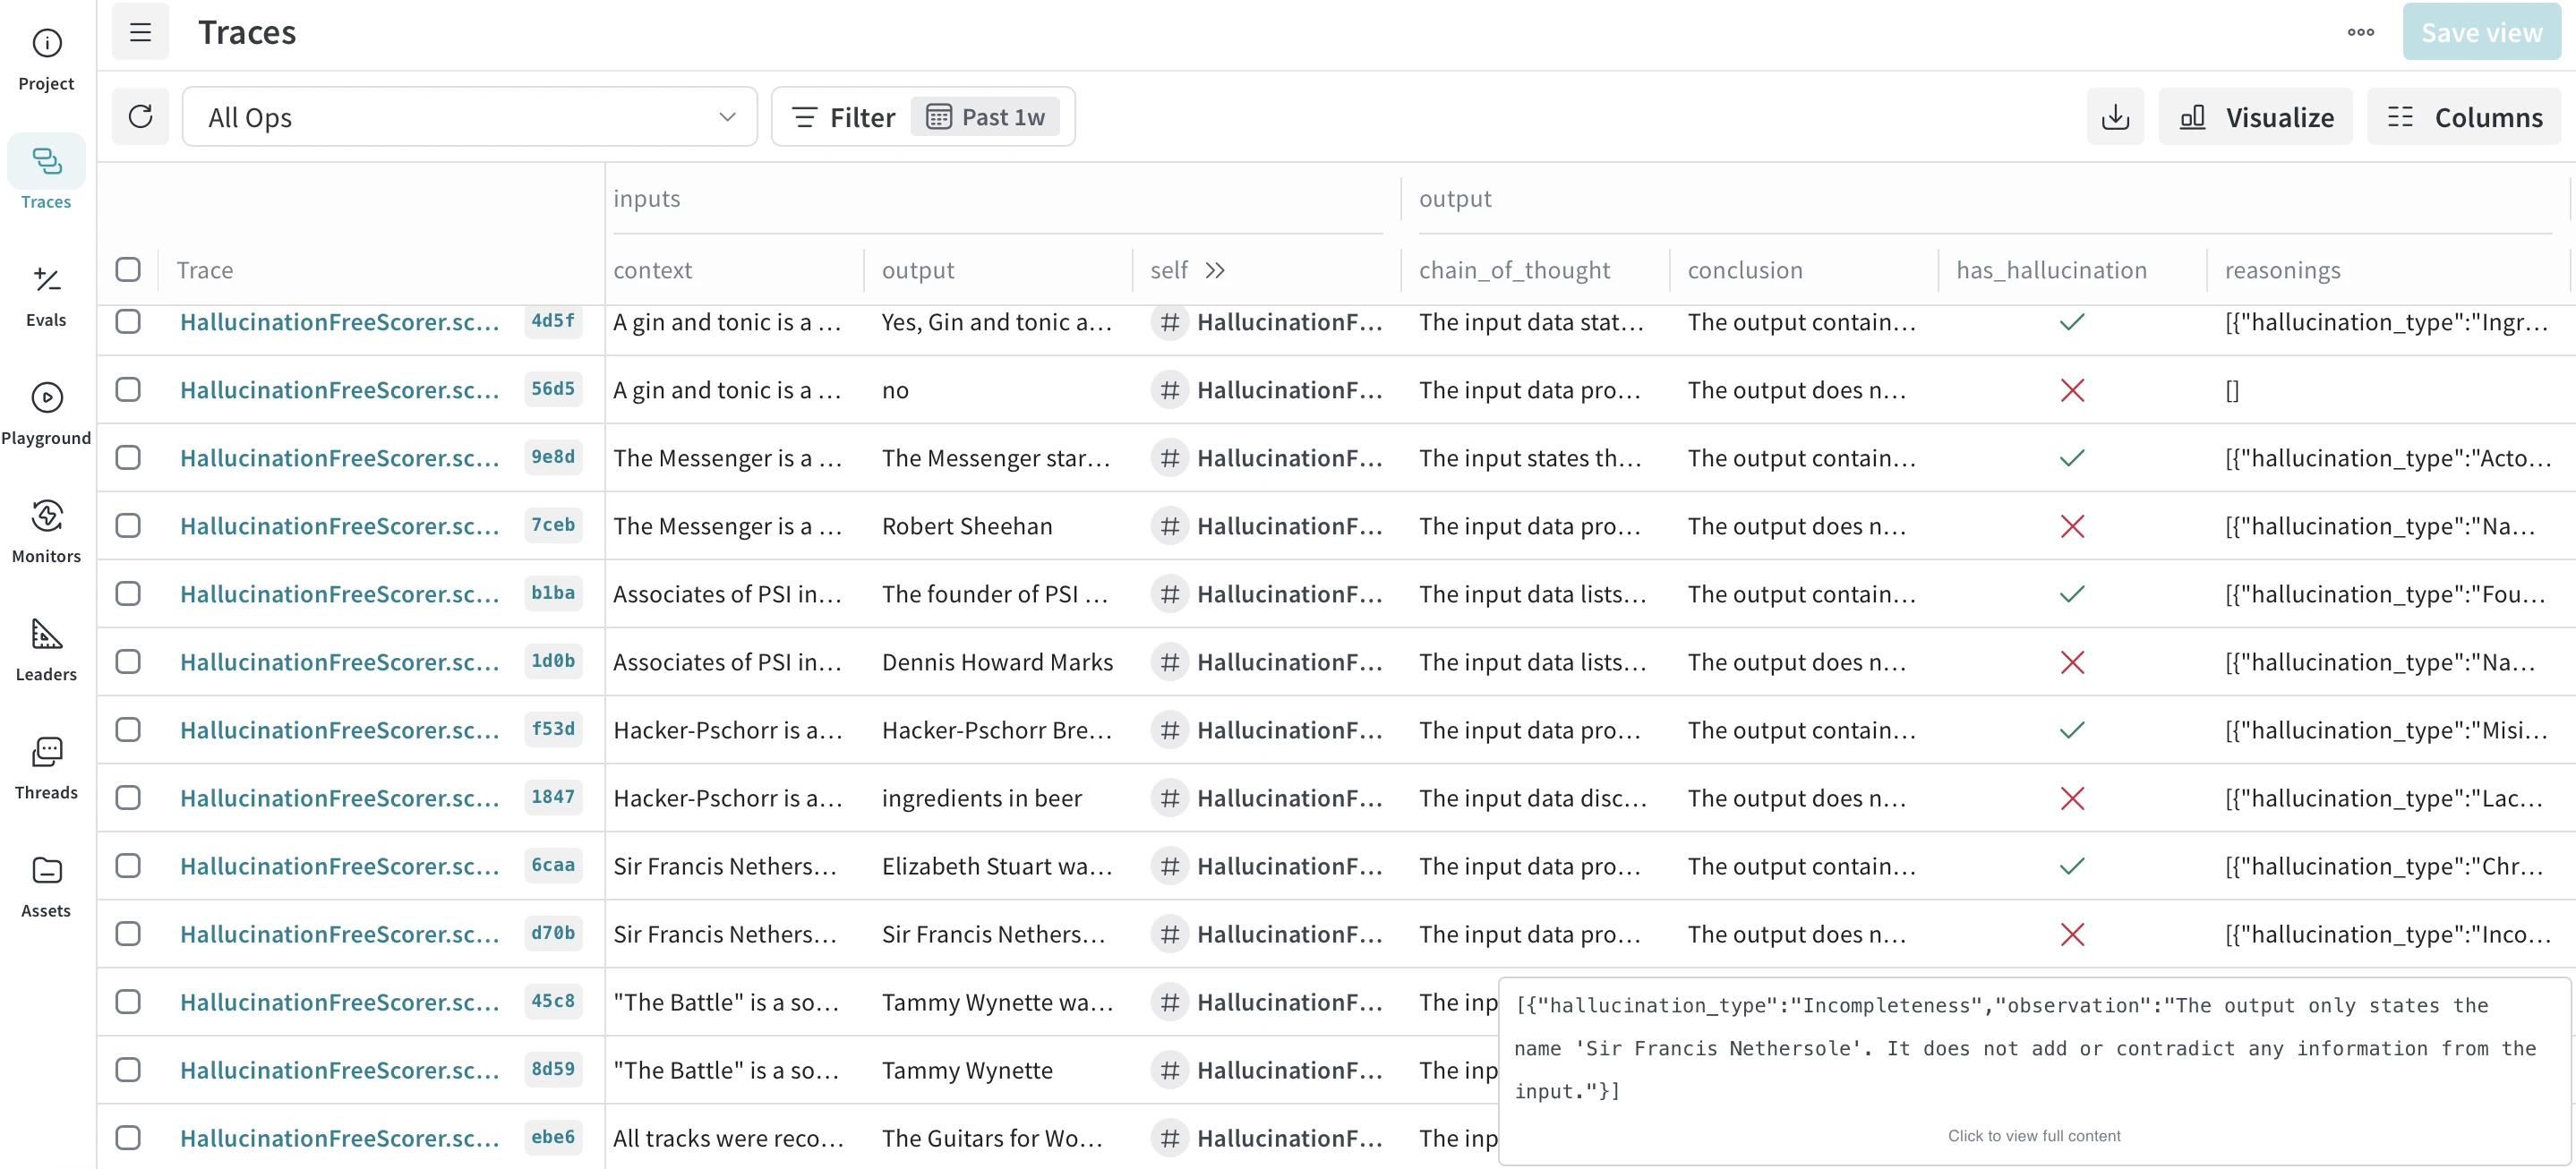
Figure 1 : tableau de bord des traces de W&B Weave.
CoreWeave Forge est livré avec un HallucinationFree Scorer qui signale les sorties LLM introduisant des affirmations absentes du contexte source. Il exécute un juge LLM sur chaque réponse et renvoie un verdict ancré/non ancré accompagné du raisonnement qui le sous-tend.
Le scorer prend deux entrées : le contexte (matériau source) et la sortie (réponse générée par LLM). Il utilise ensuite un modèle de langage pour analyser si la sortie introduit des informations absentes du contexte. Le résultat inclut un indicateur booléen has_hallucination et le raisonnement expliquant la décision.
Principales caractéristiques :
- Raisonnement par chaîne de pensée : chaque évaluation comprend une explication de la raison pour laquelle la sortie a été signalée comme hallucination ou non.
- Classification binaire : renvoie des décisions claires vrai/faux avec des preuves à l'appui.
- Intégration avec le traçage Weave : les résultats sont automatiquement journalisés dans le tableau de bord Weave pour visualisation.
- Modèle personnalisable : prend en charge différents juges LLM, notamment OpenAI, Anthropic et d'autres fournisseurs.
HallucinationEvaluator d'Arize Phoenix
Arize Phoenix intègre un HallucinationEvaluator qui signale les réponses s'écartant de leur matériau de référence. Pour chaque sortie, un juge LLM décide si la réponse est ancrée dans le contexte fourni et associe un score de confiance à son verdict.
L'évaluateur prend trois entrées : la requête de l'utilisateur (entrée), le texte de référence (contexte) et la réponse du modèle (sortie). Il analyse si la réponse contient des informations qui ne peuvent pas être dérivées du contexte, en renvoyant un résultat étiqueté (« factuel » ou « halluciné ») accompagné d'une explication et d'un score de confiance.
Principales caractéristiques :
- Performances équilibrées : donne des résultats sur les métriques de précision et de rappel
- Sortie basée sur des étiquettes : renvoie des étiquettes catégorielles (« factuel » ou « halluciné ») plutôt que de simples scores numériques
- Explications détaillées : fournit un raisonnement pour chaque décision d'évaluation
Hallucination Metric de Comet Opik
Hallucination Metric de Comet Opik évalue chaque réponse LLM par rapport à son contexte source et renvoie un jugement binaire indiquant si la sortie est fidèle à ce contexte. Le contrôle passe par un juge LLM réglé pour ne signaler que les cas à haute confiance d'affirmations non étayées.
La métrique accepte trois entrées : la requête de l'utilisateur (entrée), le matériau source (contexte) et la réponse du modèle (sortie). Elle évalue si la sortie introduit des affirmations non étayées par le contexte.
Le résultat inclut un score binaire (0 pour absence d'hallucination, 1 pour hallucination détectée) et un raisonnement détaillé expliquant l'évaluation.
Principales caractéristiques :
- Explications détaillées : chaque évaluation fournit un raisonnement complet sur les raisons pour lesquelles le contenu a été signalé ou approuvé
- Analyse à trois entrées : prend en compte la requête, le contexte et la réponse ensemble pour l'évaluation
- Suivi des expériences : les résultats sont automatiquement journalisés dans le système de suivi des expériences d'Opik
- Approche conservatrice : conçue pour minimiser les faux positifs en ne signalant que les hallucinations à haute confiance
Galileo Luna-2
Galileo Luna-2 est une couche de détection d'hallucinations et de garde-fous d'exécution intégrée à la plateforme d'observabilité IA plus large de Galileo. 1
Le système est conçu pour s'exécuter en ligne sur les chemins d'inférence de production, bloquant le contenu non ancré avant qu'il n'atteigne l'utilisateur, tandis que Signals, la couche d'analyse automatique des défaillances de Galileo, fait remonter les causes profondes des erreurs de production sans examen manuel des journaux.
Principales caractéristiques :
Détection multi-méthodes : combine la similarité d'embeddings, l'analyse par chaîne de pensée et la notation de factualité G-Eval plutôt que de dépendre d'une seule stratégie de jugement.
Garde-fous d'exécution : Luna-2 peut bloquer ou réécrire les sorties non ancrées en ligne sur le chemin d'inférence, et pas seulement les signaler après coup.
Observabilité de bout en bout : capture les entrées, les sorties et les traces de raisonnement internes sur les workflows d'agents multi-étapes, avec Signals automatisant l'analyse des causes profondes.
DeepEval
DeepEval est un framework d'évaluation LLM open source de Confident IA, conçu pour ressembler à Pytest mais pour les applications LLM. Sa métrique HallucinationMetric utilise un LLM-as-a-judge pour décider si la sortie du modèle est factuellement cohérente avec le contexte fourni, et le framework est conçu pour s'exécuter dans n'importe quel pipeline CI/CD.23
La métrique prend trois entrées obligatoires : la requête de l'utilisateur (input), la réponse du modèle (actual_output) et le matériau de référence (context). Elle note chaque sortie à l'aide de la formule Hallucination = (Nombre de contextes contredits) / (Nombre total de contextes), où des scores plus faibles indiquent un meilleur ancrage. Une sortie est considérée comme réussie lorsque son score est inférieur ou égal au seuil configuré.
Principales caractéristiques :
- Workflow de test familier : les vérifications d'hallucination sont écrites et exécutées comme des tests unitaires classiques, de sorte que les équipes utilisant déjà Pytest n'ont pas besoin d'apprendre un nouvel outil.
- Strictesse ajustable : les équipes peuvent assouplir ou resserrer le seuil de réussite, ou passer à un mode strict réussite/échec pour le contenu à enjeux élevés.
- Explications pour chaque résultat : chaque verdict est accompagné d'une raison, de sorte qu'il est clair pourquoi une sortie a été signalée.
Qu'est-ce qu'une hallucination IA ?
Les hallucinations d'IA sont des sorties qui semblent cohérentes mais ne sont pas factuelles. Le modèle produit ces affirmations avec assurance même lorsque le contexte source ou les données d'entraînement ne les étayent pas. Une étude sur le sujet attribue cela au fait que les modèles s'appuient sur des a priori linguistiques plutôt que sur des preuves vérifiables issues du contexte fourni.4 Le problème apparaît dans des domaines à enjeux élevés tels que la santé, les services juridiques, la recherche d'entreprise et le support client, ce qui explique pourquoi la détection de sorties ancrées est devenue une partie standard du déploiement de LLM.
Sources et taxonomie des hallucinations
Les hallucinations proviennent de deux grandes sources. Les facteurs internes au modèle comprennent une dépendance excessive aux schémas statistiques, des lacunes dans les données d'entraînement et la nature probabiliste de la génération de séquences ; une analyse sur la détection et l'atténuation des hallucinations note que les LLMs infèrent souvent des continuations probables plutôt que de récupérer des preuves vérifiables, ce qui produit des sorties confiantes mais incorrectes.5
Les facteurs contextuels couvrent les échecs de récupération dans les systèmes RAG, les prompts ambigus, un ancrage incomplet et, dans les modèles multimodaux, les confusions d'objets ou les détails de scène inventés.
Détection d'hallucinations dans les workflows agentiques
Les agents multi-étapes introduisent des risques d'hallucination que les LLMs à un seul tour n'ont pas : une affirmation fabriquée lors d'une étape précoce se propage dans les appels d'outils, les récupérations et les sorties finales ultérieurs.
Principaux défis de la détection d'hallucinations agentiques :
- Propagation des erreurs : un fait fabriqué lors de la phase de planification peut influencer la sélection des outils, la récupération des données et les réponses finales
- Hallucinations d'appels d'outils : les agents peuvent invoquer des outils avec des paramètres incorrects ou mal interpréter les sorties des outils
- Corruption d'état : les informations hallucinées stockées dans la mémoire de l'agent affectent les étapes de raisonnement futures
- Complexité d'attribution : identifier quelle étape a introduit l'hallucination nécessite un traçage de bout en bout
Approches de détection pour les systèmes agentiques :
- Vérification au niveau des étapes : valider chaque sortie intermédiaire avant que l'agent ne passe à l'action suivante
- Validation des sorties d'outils : vérifier par recoupement les réponses des outils par rapport aux formats attendus et aux contraintes connues
- Analyse de trajectoire : examiner la séquence complète des décisions de l'agent pour identifier où le raisonnement a divergé des informations ancrées
- Vérifications de cohérence entre les étapes : comparer les affirmations faites à différentes étapes pour détecter les contradictions
HallucinationFree Scorer de W&B Weave et HallucinationEvaluator d'Arize Phoenix peuvent être appliqués à chaque étape de l'agent, tandis que leurs tableaux de bord intégrés affichent la trace d'exécution complète pour l'analyse des causes profondes.
 Ajouter comme source préférée
Prévention des hallucinations en temps réel
La détection après génération fait remonter les problèmes mais n'empêche pas les mauvaises sorties d'atteindre les utilisateurs. La prévention en temps réel exécute le contrôle en ligne, avant que la réponse ne soit délivrée.
Mécanismes de prévention :
- Garde-fous de sortie : filtres qui analysent le contenu généré par rapport à des critères de factualité avant de le renvoyer à l'utilisateur.
- Seuils de confiance : bloquer ou signaler les réponses lorsque la confiance interne du modèle tombe en dessous de niveaux acceptables.
- Portes de validation de récupération : vérifier que les affirmations générées sont étayées par les documents récupérés avant de finaliser la réponse.
- Stratégies de repli : renvoyer une réponse par défaut sécurisée ou escalader vers des files d'examen lorsque le risque d'hallucination est élevé.
Capacités des outils pour la prévention en temps réel :
- W&B Weave intègre la notation d'hallucination dans les pipelines de production, permettant des contrôles automatisés avant que les réponses ne soient servies.
- Arize Phoenix fournit une surveillance en temps réel avec des capacités d'alerte qui signalent les sorties à haut risque pour examen immédiat.
- Comet Opik propose un suivi des expériences avec évaluation automatisée, permettant aux équipes de définir des portes de qualité qui bloquent les réponses dépassant les seuils d'hallucination.
Approches de détection d'hallucinations
Trois approches sont directement pertinentes pour la manière dont Weave, Phoenix et Opik fonctionnent :
1. Méthodes basées sur la cohérence
Les méthodes basées sur la cohérence évaluent une réponse en la comparant à plusieurs générations alternatives à l'aide de la similarité sémantique, du chevauchement de n-grammes ou de la vérification question-réponse. Lorsque les réponses se contredisent ou contiennent des incohérences logiques, la probabilité d'hallucination augmente. Une technique connexe, l'entropie sémantique, regroupe les réponses par sens plutôt que par formulation et utilise l'instabilité conceptuelle comme signal d'hallucination.
2. Détection basée sur les probabilités et la confiance
Les probabilités au niveau des tokens, les valeurs d'entropie, les courbes de calibration et les estimations de confiance basées sur la marge révèlent la croyance interne du modèle à propos de sa propre sortie. Les segments à faible confiance sont souvent corrélés à des taux d'hallucination plus élevés. L'entropie brute peut être trompeuse en raison de la variabilité de la formulation, mais les signaux de confiance restent utiles lorsqu'ils sont combinés à des indicateurs basés sur la cohérence. Arize Phoenix expose un score de confiance à côté de son étiquette, ce qui correspond à cette catégorie.
3. Détection basée sur la référence ou le contexte
L'évaluation basée sur la référence compare la sortie du modèle au contexte fourni ou à des sources externes, et constitue le mécanisme central des contrôles de qualité RAG. Les techniques typiques incluent les modèles d'implication qui vérifient si les documents récupérés étayent la réponse, les méthodes d'alignement et d'ancrage qui valident le soutien des preuves, et les métriques de factualité qui mesurent si les affirmations correspondent au texte de soutien. Les trois outils évalués fonctionnent principalement dans ce mode : ils prennent une entrée de contexte et jugent si la sortie reste dans ses limites.
Techniques et algorithmes de détection d'hallucinations IA
Les méthodes de détection opèrent à trois niveaux de granularité :
- Niveau token : marque les segments suspects dans une sortie. Utilise des datasets d'hallucinations annotés par des humains, la divergence entre les probabilités a priori et a posteriori des tokens étant donné le contexte, ou des classifieurs d'étiquetage de séquences.
- Niveau phrase : juge des énoncés entiers. Les vérifications d'auto-cohérence basées sur l'échantillonnage comparent plusieurs générations pour détecter l'instabilité, l'entropie sémantique signale l'incertitude conceptuelle sans étiquettes, et les classifieurs d'implication détectent les affirmations non étayées ou contradictoires.
- Niveau workflow : suit les pipelines multi-étapes à l'aide de graphes de provenance, de vérifications d'implication au niveau des étapes, de validation du raisonnement intermédiaire et de traçage des dépendances pour les tâches multi-sauts.
Les trois outils que nous avons évalués opèrent principalement au niveau de la phrase, Weave et Phoenix s'étendant au niveau workflow via leurs tableaux de bord de traçage.
Pratiques industrielles et bonnes pratiques
Les équipes de production s'appuient rarement sur une seule méthode. Les schémas courants incluent :
- Détection en couches : les vérifications de cohérence, la notation de probabilité et la validation d'implication s'exécutent dans le même pipeline.
- Surveillance en temps réel : les tableaux de bord suivent la dérive et les changements de confiance au fil du temps.
- Ajustement des prompts : les prompts sont affinés pour réduire l'ambiguïté qui conduit à des sorties non ancrées.
- Examen par des experts : réservé au contenu juridique, médical ou financier où les erreurs ont un coût réel.
- Intégration CI/CD : des contrôles de qualité automatisés s'exécutent avant le déploiement afin que les régressions apparaissent tôt.
- Surveillance des agents : des plugins observent les appels d'outils et les étapes de raisonnement intermédiaires pour détecter les anomalies dès leur apparition.
Méthodologie du benchmark des outils de détection d'hallucinations IA
Le benchmark a utilisé un dataset contrôlé de 50 éléments de connaissance tirés de scénarios de questions-réponses factuels. Chaque élément comprenait un contexte source, une question, une réponse correcte ancrée dans ce contexte et une réponse hallucinée contenant des informations fabriquées. Par exemple, un test portait sur le lieu du siège social de The Oberoi Group, où la réponse correcte « Delhi » a été testée contre la réponse hallucinée « Mumbai ».
Chaque élément de connaissance a généré deux cas de test : un utilisant la réponse correcte (attendu : absence d'hallucination) et un utilisant la réponse hallucinée (attendu : hallucination détectée). Cela a créé une répartition équilibrée 50/50 totalisant 100 cas de test. Les trois outils ont traité les mêmes cas de test séquentiellement, chacun recevant des entrées identiques (contexte, question et sortie).
Nous avons mesuré la latence pour chaque cas de test individuellement afin de garantir une comparaison équitable, en évitant les pièges du traitement parallèle ou de l'évaluation par lots qui pourraient fausser les résultats. Les étiquettes de vérité terrain ont été vérifiées manuellement pour garantir l'exactitude du calcul des vrais positifs, des faux positifs, des vrais négatifs et des faux négatifs.
Citez ce benchmark
Choisissez le format qui correspond à votre lieu de publication. Coller la version avec lien dans votre CMS préserve le lien retour.
@misc{ermut2026,
  author = {Ermut, Sıla and Şipi, Nazlı},
  title  = {{Outils de détection d'hallucinations IA: W&B Weave & Comet}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/ai-hallucination-detection}},
  note   = {AIMultiple. Consulté le 18 juin 2026}
}Résultats et horodatages de 12 points de données. Téléchargez les données de synthèse présentées dans les graphiques et les tableaux de cet article sous forme de fichier ZIP contenant 4 fichiers CSV.
Vous voulez les données détaillées derrière ? Rejoindre Premium
Journal des modifications
3 mises à jourAjout de Galileo Luna-2 et DeepEval comme nouvelles sections d'outils à côté des outils de détection d'hallucinations testés.
Ajout de « Hallucination detection in agentic workflows » à la section « What is AI hallucination? ».
Liens de référence
Elle a précédemment travaillé comme recruteuse dans des cabinets de gestion de projet et de conseil. Sıla est titulaire d’un master en psychologie sociale et d’une licence en relations internationales.
À lire ensuite
Navigateurs Web IA: Guide de sélection
Comparatif des 20 meilleurs détecteurs de texte généré par l'IA

Comparatif des 7 meilleurs détecteurs d'images IA

HALC-Bench: LLM Hallucination sur le benchmark de récupération en contexte long


Top 14 des outils de détection et de prévention des intrusions (IDPS/IPS)
Top 20 des entreprises de technologie de déception

Soyez le premier à commenter
Votre adresse courriel ne sera pas publiée. Tous les champs sont obligatoires. Les commentaires sont laissés dans leur langue d'origine.