


LLM Orchestration: 21 frameworks et passerelles

L'optimisation de l'orchestration LLM est essentielle pour améliorer les performances tout en maîtrisant l'utilisation des ressources. Pour évaluer les performances de différentes approches d'orchestration en pratique, nous avons réalisé des benchmarks :
- Frameworks d'orchestration agentique : en utilisant un workflow de planification de voyage à cinq agents identiques, exécuté 100 fois chacun, mesurant la latence des pipelines, la consommation de tokens, les transitions entre agents et les écarts d'exécution entre agents et outils.
- Passerelles IA : OpenRouter, SambaNova, TogetherAI, Groq et IA/ML API testés sur la latence du premier token, la latence totale et le nombre de tokens de sortie avec 300 tests de prompts courts (≈18 tokens) et longs (≈203 tokens).
Découvrez une sélection d'outils d'orchestration LLM, notamment les frameworks développeur et les passerelles d'entreprise :
Qu'est-ce que l'orchestration en LLM ?
L'orchestration LLM consiste à gérer et à intégrer plusieurs grands modèles de langage (LLMs) pour effectuer des tâches complexes efficacement. Elle assure l'interaction entre les modèles, les workflows, les sources de données et les pipelines, en optimisant les performances en tant que système unifié. Les organisations utilisent l'orchestration LLM pour des tâches telles que la génération de langage naturel, la traduction automatique, la prise de décision et les chatbots.
Bien que les LLMs possèdent de solides capacités fondamentales, ils sont limités dans l'apprentissage en temps réel, la rétention du contexte et la résolution de problèmes en plusieurs étapes. De plus, la gestion de plusieurs LLMs à travers différentes APIs de fournisseurs ajoute une complexité d'orchestration.
Les frameworks d'orchestration LLM répondent à ces défis en rationalisant l'ingénierie des prompts, les interactions avec les API, la récupération de données et la gestion d'état. Ces frameworks permettent aux LLMs de collaborer efficacement, améliorant ainsi leur capacité à générer des résultats précis et contextuels.
Quelle est la meilleure plateforme pour l'orchestration LLM ?
Les frameworks d'orchestration LLM peuvent gérer, coordonner et optimiser l'utilisation des grands modèles de langage (LLMs) dans diverses applications. Un système d'orchestration LLM permet l'intégration avec différents composants d'IA, facilite l'ingénierie des prompts, gère les workflows et améliore le suivi des performances.
Ils sont particulièrement utiles pour les applications impliquant des systèmes multi-agents, la génération augmentée par récupération (RAG), l'IA conversationnelle et la prise de décision autonome.
Pour faciliter la navigation, les outils sont divisés en deux catégories :
1. Plateformes basées sur les passerelles
Les plateformes de passerelles sont des solutions orientées entreprise qui centralisent l'accès aux LLMs, appliquent les politiques de sécurité, gèrent la conformité et fournissent un suivi de l'utilisation. Ces plateformes sont idéales pour les organisations qui ont besoin d'un déploiement LLM contrôlé, évolutif et gouverné.
Voici quelques-unes des passerelles d'IA et leurs scores GitHub :
Résultats du benchmark des passerelles d'IA
Notre benchmark a utilisé la latence du premier token (FTL) et la latence totale avec la sortie de tokens pour évaluer l'efficacité avec laquelle les passerelles sélectionnent les fournisseurs et fournissent les réponses. Voici quelques-uns de nos résultats :
- Meilleurs performeurs :
- Groq : FTL la plus rapide pour les prompts longs (0.14 s) et latence totale faible (2.7 s) avec 1 900 tokens
- SambaNova : à égalité pour la FTL la plus rapide sur les prompts courts (0.13 s) et deuxième latence totale la plus basse (3 s) tout en produisant le nombre de tokens le plus élevé (1 997)
- Performeurs modérés :
- OpenRouter : FTL 0.40–0.45 s, latence totale 25 s pour les prompts longs, sortie de tokens modérée
- TogetherAI : FTL 0.43–0.45 s, latence totale 11 s avec 1 812 tokens
- Moins performant : IA/ML API, FTL la plus élevée (0.84–0.90 s) et latence totale (13 s), malgré une sortie de tokens modérée.
Pour plus de détails et de méthodologie, veuillez consulter notre article de benchmark sur les passerelles d'IA.
Voici une liste de plateformes basées sur des passerelles pour l'orchestration LLM, triées par ordre alphabétique :
Bifrost par Maxim IA
Bifrost est une passerelle d'IA qui unifie l'accès à 15+ fournisseurs LLM via une API unique compatible OpenAI, prenant en charge le basculement automatique, l'équilibrage de charge et les politiques de gouvernance centralisées.
Fonctionnalité unique : intégration du Model Context Protocol (MCP), permettant le streaming, la surveillance basée sur des plugins et l'analytique pour les LLMs multi-fournisseurs.
Passerelle Cloudflare IA
La passerelle Cloudflare IA est une plateforme d'inférence IA et d'orchestration proxy qui donne accès à plusieurs grands modèles de langage, offrant une facturation unifiée, un suivi des coûts et des fonctionnalités de résilience automatisées pour les charges de travail d'IA techniques.
Fonctionnalité unique : basculement multi-fournisseurs et mise en mémoire tampon des flux en périphérie, qui protège les réponses de streaming des applications longues contre les déconnexions en mettant en cache la sortie d'inférence directement sur le réseau mondial de Cloudflare.
Kong
La passerelle Kong IA est une passerelle d'IA sémantique qui centralise et sécurise le trafic LLM, permettant aux organisations d'intégrer, de gouverner et de surveiller plusieurs modèles d'IA pour la conformité et le suivi des ressources.
Fonctionnalité unique : sécurité sémantique des prompts, y compris l'assainissement des PII et des modèles de prompts avancés pour protéger les informations sensibles.
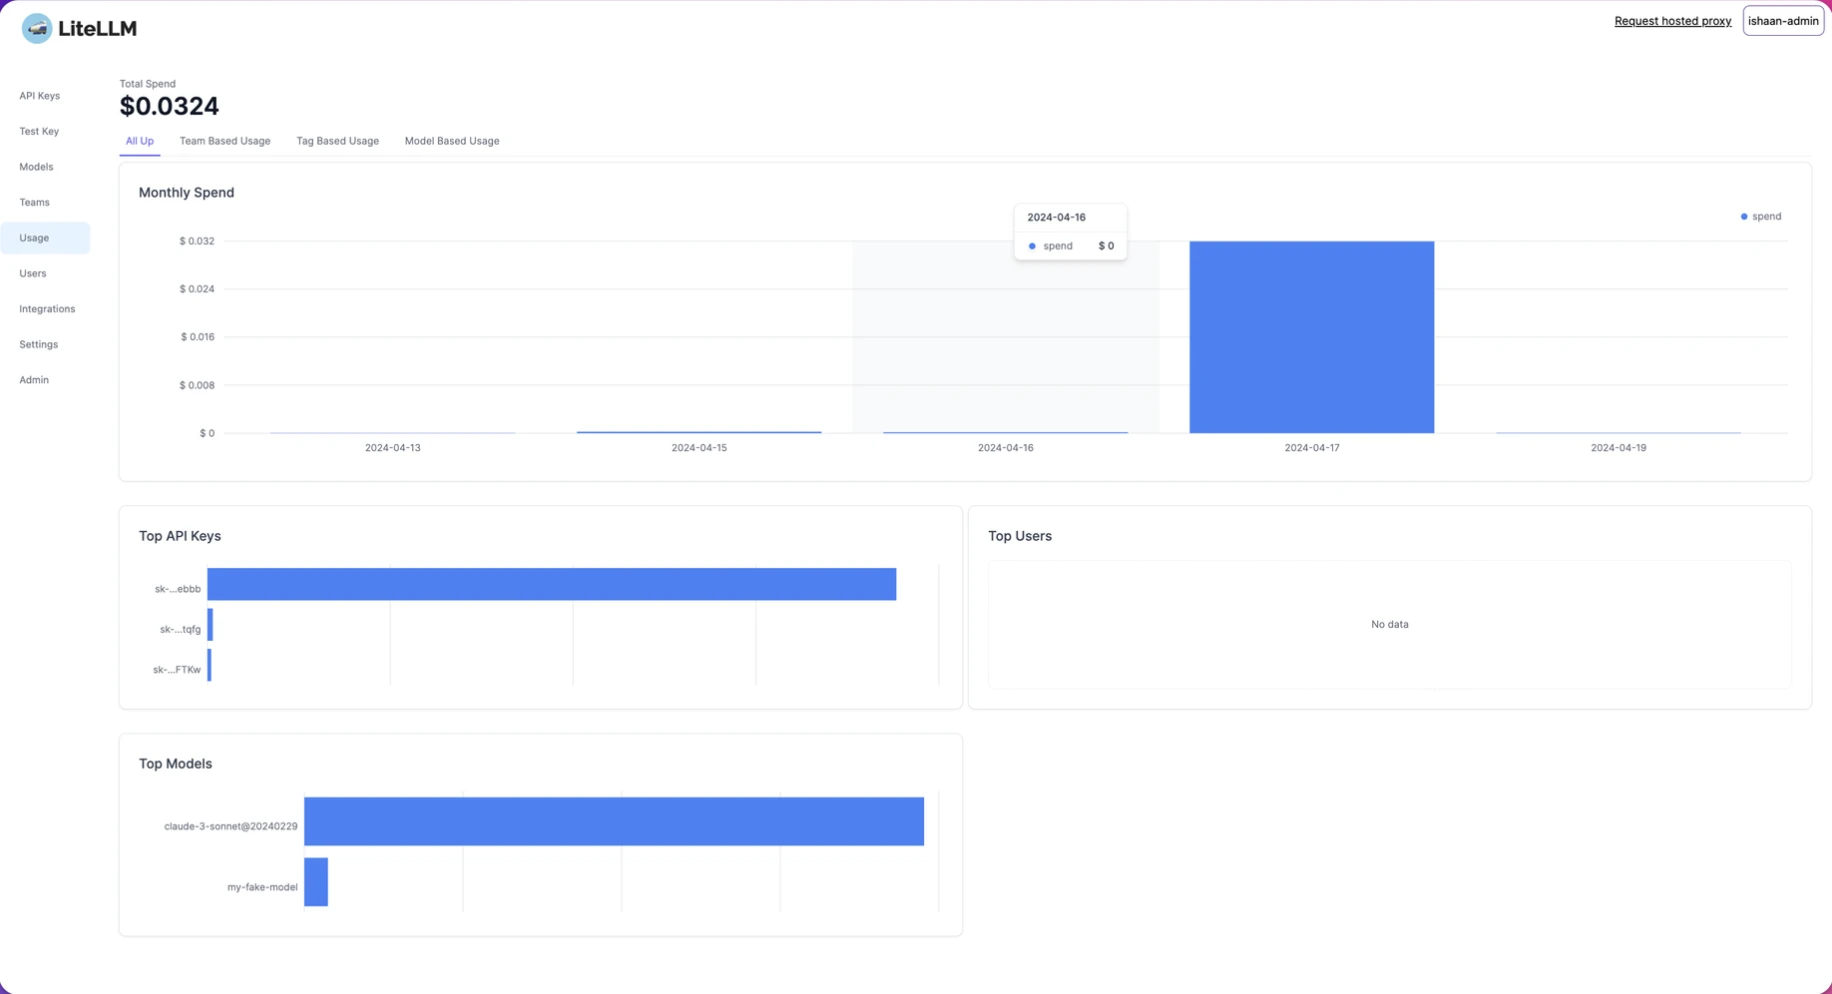
LiteLLM
LiteLLM donne accès à plusieurs LLMs via une interface unifiée, offrant à la fois un serveur proxy (passerelle LLM) et un SDK Python pour la gestion centralisée et l'observabilité du système.
Fonctionnalité unique : intégration du SDK Python pour la gestion et l'observabilité programmatiques des LLM, permettant aux développeurs d'intégrer des contrôles d'IA centralisés directement dans le code.
Passerelle IA Prisma AIRS (anciennement Portkey)
Prisma AIRS IA est une passerelle d'IA et une plateforme d'orchestration qui connecte les développeurs à plusieurs LLMs, prenant en charge le routage programmatique, le basculement, le suivi des coûts et les fonctionnalités de déploiement pour les équipes d'IA techniques.
Fonctionnalité unique : Prise en charge LLM multimodale, incluant les modèles de texte, d'image, audio et de vision avec des capacités de fine-tuning pour une cohérence de sortie améliorée.
2. Frameworks pour développeurs
Les frameworks pour développeurs sont conçus pour les ingénieurs et les développeurs d'IA qui souhaitent un contrôle total sur la création et l'orchestration des workflows LLM. Ils fournissent des SDK, des API et des modules prêts à l'emploi pour enchaîner les modèles, gérer les prompts et traiter les interactions multi-LLM.
Voici la liste complète des outils d'orchestration LLM pour les développeurs et leurs étoiles GitHub par ordre alphabétique :
Résultats du benchmark
Principaux enseignements du benchmark des frameworks d'orchestration :
- LangGraph : s'exécute le plus rapidement avec la gestion d'état la plus efficace
- LangChain : consomme plus de tokens en raison d'une gestion plus lourde de la mémoire et de l'historique
- AutoGen : affiche des performances modérées avec un comportement de coordination cohérent
- CrewAI : subit les délais les plus longs en raison de la délibération autonome avant les appels d'outils.
Pour la méthodologie et une analyse plus détaillée du benchmark, veuillez consulter le benchmark d'orchestration agentique.
Les outils expliqués ci-dessous sont listés par ordre alphabétique :
Agency Swarm
Agency Swarm est un framework de système multi-agents (MAS) qui fournit des outils pour créer, orchestrer et gérer des essaims d'agents d'IA, en utilisant le SDK d'agents OpenAI.
Fonctionnalités clés :
- Prend en charge la coordination multi-agents, permettant à plusieurs agents d'IA d'échanger des données et d'exécuter des workflows simultanément.
- Comprend des outils de simulation et de visualisation qui aident à tester et à surveiller les interactions des agents dans un environnement simulé.
- Permet des interactions d'IA basées sur l'environnement car les agents d'IA peuvent répondre dynamiquement à des conditions changeantes.
AutoGen
AutoGen, développé par Microsoft, est un framework d'orchestration multi-agents open source qui simplifie l'automatisation des tâches d'IA à l'aide d'agents conversationnels.
Fonctionnalités clés :
- Framework de conversation multi-agents qui permet aux agents d'IA de communiquer et de coordonner leurs tâches.
- Fonctionne avec plusieurs fournisseurs de modèles, notamment OpenAI et Azure
- Architecture modulaire et configurable, une configuration personnalisable pour diverses applications d'IA.
crewAI
crewAI est un framework multi-agents open source. Il permet à des agents d'IA jouant des rôles de collaborer sur des tâches structurées.
Fonctionnalités clés :
- Automatisation des workflows basée sur les agents qui attribue aux agents d'IA des rôles spécifiques dans l'exécution des tâches.
- Prend en charge les utilisateurs techniques et non techniques
- Version entreprise (crewAI+) disponible
Haystack
Haystack est un framework Python open source qui permet la création flexible de pipelines d'IA à l'aide d'une approche basée sur les composants. Il prend en charge la recherche d'informations et les applications de questions-réponses.
Fonctionnalités clés :
- Conception de systèmes d'IA basée sur les composants, une approche modulaire pour assembler les fonctions d'IA.
- Intégration avec des bases de données vectorielles et des fournisseurs de LLM, lui permettant de fonctionner avec divers stockages de données et modèles d'IA.
- Prend en charge la recherche sémantique et l'extraction d'informations, permettant une recherche avancée et la récupération de connaissances.
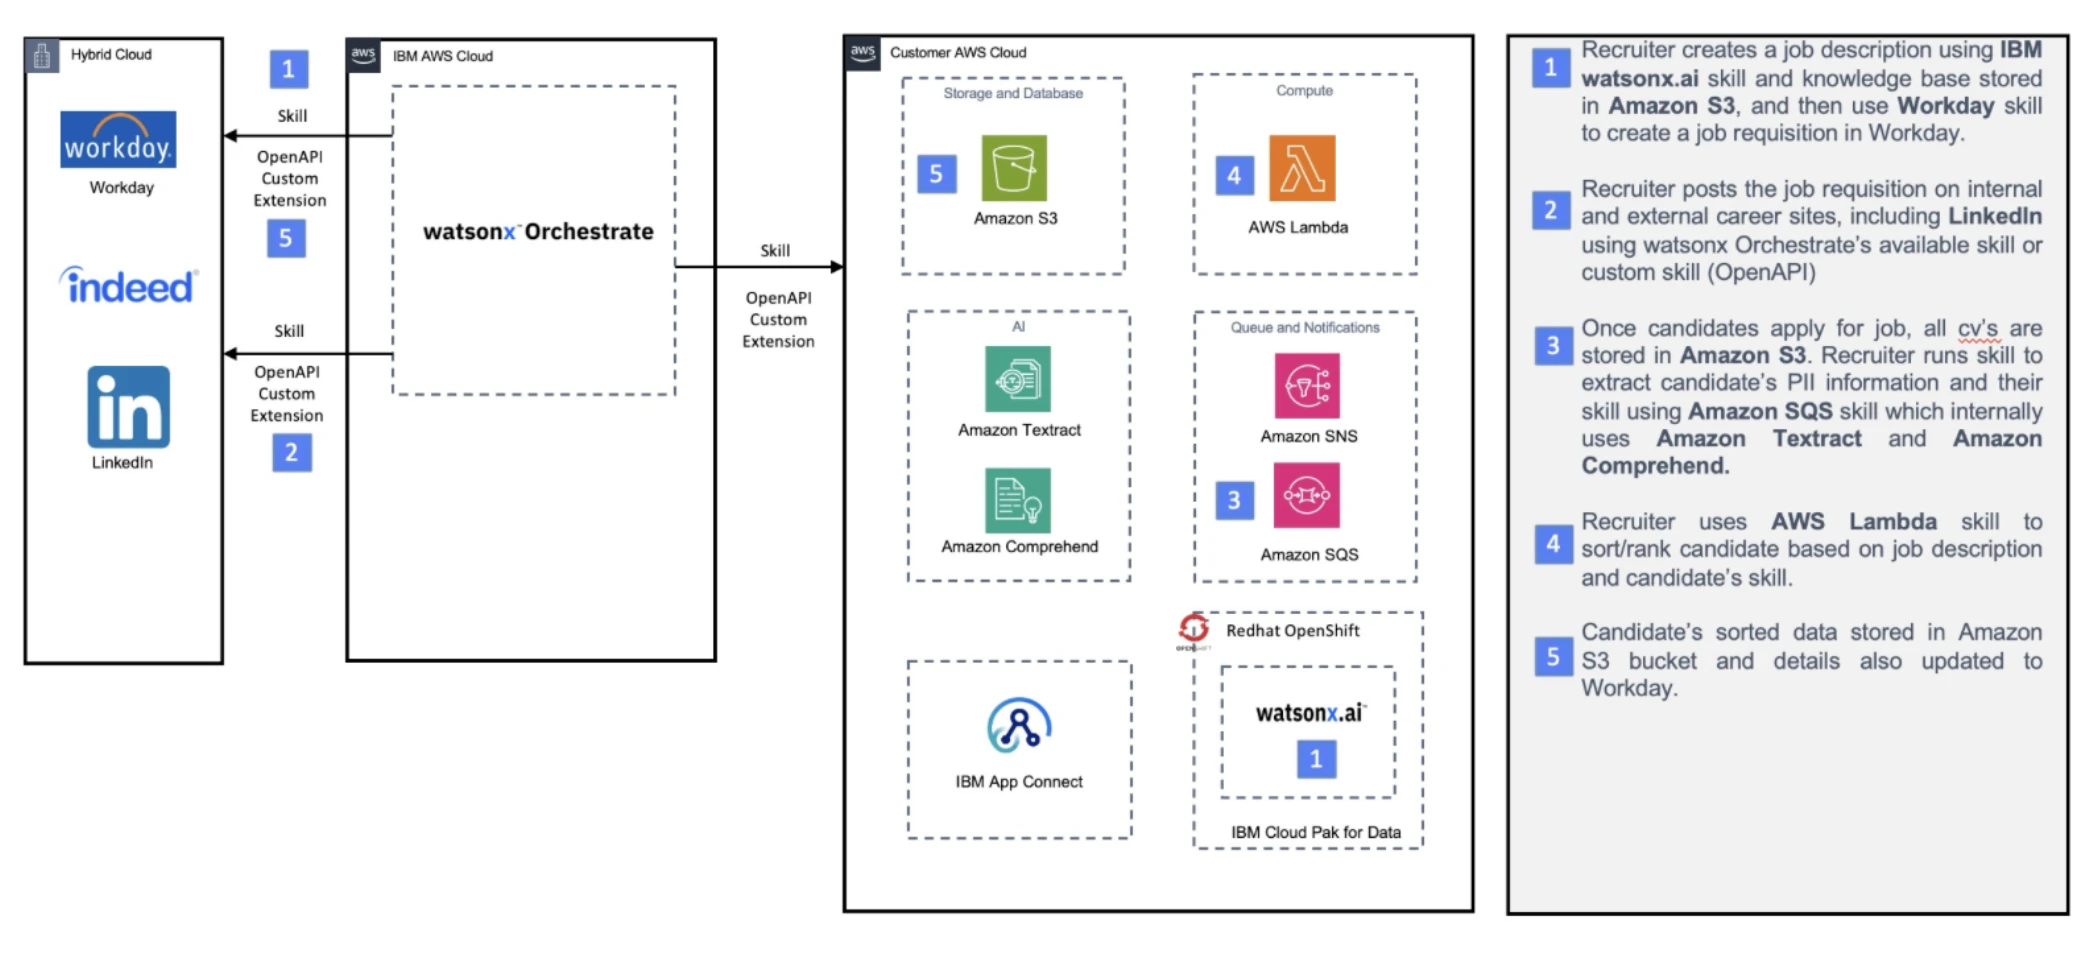
IBM watsonx orchestrate
IBM watsonx orchestrate est un framework d'orchestration d'IA propriétaire qui utilise le traitement du langage naturel (NLP) pour automatiser les workflows d'entreprise.
Fonctionnalités clés :
- Automatisation des workflows basée sur l'IA qui peut automatiser les processus métier répétitifs à l'aide de l'IA.
- Applications et ensembles de compétences prédéfinis, fournissant des outils d'IA prêts à l'emploi pour différents secteurs.
- Intégration axée sur l'entreprise, se connectant aux logiciels et workflows d'entreprise existants.
LangChain
LangChain est un framework Python open source pour créer des applications LLM, axé sur l'augmentation par des outils et l'orchestration d'agents. Il fournit des interfaces pour les modèles d'embedding, les LLMs et les bases vectorielles.
Fonctionnalités clés :
- RAG prise en charge
- Intégration avec plusieurs composants LLM
- Framework ReAct pour le raisonnement et l'action
LlamaIndex
LlamaIndex est un framework d'intégration de données open source conçu pour créer des applications LLM augmentées par le contexte. Il permet une récupération facile des données à partir de sources multiples.
Fonctionnalités clés :
- Connecteurs de données pour plus de 160 sources, permettant à l'IA d'accéder à des données structurées et non structurées diverses.
- Prise en charge de la génération augmentée par récupération (RAG)
- Suite de modules d'évaluation pour le suivi des performances
LOFT
LOFT, développé par Master of Code Global, est un framework orchestration de grands modèles de langage conçu pour optimiser les interactions clients pilotées par l'IA. Il utilise une architecture basée sur des files d'attente conçue pour gérer les requêtes simultanées et les déploiements multi-utilisateurs.
Fonctionnalités clés :
- Agnostique au framework : s'intègre dans tout système backend sans dépendre des frameworks HTTP.
- Prompts calculés dynamiquement : prend en charge les prompts générés sur mesure pour des interactions utilisateur personnalisées.
- Détection et gestion des événements : dispose de mécanismes intégrés pour détecter et gérer les événements de chat, y compris le filtrage des hallucinations.
Microchain
Microchain est un framework d'orchestration LLM léger et open source, connu pour sa simplicité mais qui n'est pas activement maintenu.
Fonctionnalités clés :
- Prise en charge du raisonnement par chaîne de pensée qui aide l'IA à décomposer des problèmes complexes étape par étape.
- Approche minimaliste de l'orchestration de l'IA.
Orq IA
Orq est une plateforme collaborative d'IA générative et un outil LLMOps conçu pour gérer le cycle de vie de déploiement des applications LLM. Il fournit des fonctionnalités permettant aux équipes techniques et non techniques de créer, déployer et surveiller les fonctionnalités d'IA.
Fonctionnalités clés :
- Orchestration LLM serverless : fournit une infrastructure de déploiement utilisant une API unifiée, avec routage intégré, contrôle de version, solutions de repli et nouvelles tentatives.
- Observabilité et évaluation : offre une surveillance en temps réel, des traces, des journaux et des évaluateurs personnalisés pour garantir les performances des LLM et la qualité des résultats.
- Passerelle d'IA et RAG : accorde un point d'accès unique à plusieurs modèles et outils d'IA pour créer des pipelines de génération augmentée par récupération (RAG).
Semantic Kernel
Semantic Kernel (SK) est un framework d'orchestration d'IA open source de Microsoft. Il aide les développeurs à intégrer de grands modèles de langage (LLMs) comme le GPT d'OpenAI avec la programmation traditionnelle pour créer des applications pilotées par l'IA.
Fonctionnalités clés :
- Gestion de la mémoire et du contexte : SK permet le stockage et la récupération des interactions passées, aidant à maintenir le contexte au fil des conversations.
- Embeddings et recherche vectorielle : prend en charge les recherches basées sur les embeddings, ce qui le rend compatible avec les cas d'utilisation de génération augmentée par récupération (RAG).
- Prise en charge multimodale : fonctionne avec du texte, du code, des images et plus encore.
Comment choisir le bon framework d'orchestration LLM ?
Le nombre d'étoiles GitHub peut indiquer la popularité, mais le choix idéal dépend de plusieurs facteurs, notamment l'expertise technique de votre équipe, l'échelle du projet, le budget et les intégrations souhaitées.
Tenez compte de l'expertise technique de l'équipe :
- Pour les équipes très techniques, comme les développeurs et les data scientists qui ont besoin d'un contrôle granulaire et de flexibilité, des frameworks comme LangChain, AutoGen et LlamaIndex sont d'excellents choix. Ils sont orientés code et exigent une bonne compréhension de Python et des principes de l'IA.
- Pour les utilisateurs métier ou les équipes préférant le low-code/no-code, les plateformes axées sur les interfaces déclaratives sont plus adaptées. Loft et crewAI offrent des workflows simplifiés, permettant un prototypage rapide sans codage approfondi.
Examinez l'échelle du projet :
- Pour les systèmes multi-agents complexes, les frameworks spécialement conçus à cet effet, tels qu'AutoGen, crewAI ou Agency Swarm, fournissent l'architecture nécessaire pour que les agents communiquent et collaborent.
- Pour les applications d'entreprise critiques à grande échelle nécessitant un débit élevé, une sécurité et un support dédié, les solutions propriétaires comme IBM watsonx orchestrate sont souvent l'option privilégiée.
- Pour les applications légères et de preuve de concept (POC), un framework minimaliste peut suffire, car sa simplicité réduit les frais généraux.
Pensez aux contraintes budgétaires :
- Les frameworks open source comme LangChain et Haystack sont gratuit à utiliser, mais ils s'accompagnent de « coûts cachés » liés à l'infrastructure cloud, à la maintenance et à une équipe spécialisée.
- Les solutions propriétaires peuvent offrir une structure tarifaire prévisible incluant le support et peuvent être plus rentables pour les organisations ne disposant pas d'une équipe MLOps dédiée.
Tenez compte de votre pile technologique existante.
- Si votre entreprise est investie dans un écosystème spécifique, éliminer les frameworks qui ne peuvent pas fonctionner avec cet écosystème est une étape utile. Par exemple, Semantic Kernel pour les environnements Microsoft ou Haystack pour les applications axées sur la récupération de documents peuvent fournir une intégration.
Comment fonctionnent les outils d'orchestration LLM ?
Les frameworks d'orchestration LLM gèrent l'interaction entre les différents composants des applications pilotées par LLM, en garantissant des workflows structurés et une exécution efficace. La couche d'orchestration joue un rôle central dans la coordination de processus tels que la gestion des prompts, l'allocation des ressources, le prétraitement des données et les interactions entre modèles.
Couche d'orchestration
La couche d'orchestration agit comme le système de contrôle central au sein d'une application propulsée par LLM. Elle gère les interactions entre divers composants, notamment les LLMs, les modèles de prompts, les bases de données vectorielles et les agents d'IA. En supervisant ces éléments, l'orchestration garantit une performance cohérente dans différentes tâches et environnements.
Tâches clés de l'orchestration
Gestion des chaînes de prompts
- Le framework structure et gère les entrées LLM (prompts) pour optimiser la sortie.
- Il fournit un référentiel de modèles de prompts, permettant une sélection dynamique en fonction du contexte et des entrées utilisateur.
- Il séquence les prompts de manière logique pour maintenir des flux de conversation structurés.
- Il évalue les réponses pour affiner la qualité de la sortie, détecter les incohérences et garantir le respect des consignes.
- Des mécanismes de vérification des faits peuvent être mis en œuvre pour réduire les inexactitudes, les réponses signalées étant dirigées vers une révision humaine.
Gestion des ressources et des performances des LLM
- Les frameworks d'orchestration surveillent les performances des LLM via des tests de benchmark et des tableaux de bord en temps réel.
- Ils fournissent des outils de diagnostic pour l'analyse des causes racines (RCA) afin de faciliter le débogage.
- Ils allouent efficacement les ressources de calcul pour optimiser les performances.
Gestion et prétraitement des données
- L'orchestrateur récupère les données à partir de sources spécifiées à l'aide de connecteurs ou d'APIs.
- Le prétraitement convertit les données brutes dans un format compatible avec les LLMs, garantissant la qualité et la pertinence des données.
- Il affine et structure les données pour améliorer leur aptitude à être traitées par différents algorithmes.
Intégration et interaction des LLM
- L'orchestrateur lance les opérations LLM, traite la sortie générée et l'achemine vers la destination appropriée.
- Il maintient des mémoires qui améliorent la compréhension contextuelle en préservant les interactions précédentes.
- Les mécanismes de rétroaction évaluent la qualité de la sortie et affinent les réponses en fonction des données historiques.
Mesures d'observabilité et de sécurité
- L'orchestrateur prend en charge des outils de surveillance pour suivre le comportement des modèles et garantir la fiabilité de la sortie.
- Il met en œuvre des frameworks de sécurité pour atténuer les risques associés aux sorties non vérifiées ou inexactes.
Améliorations supplémentaires
Intégration des workflows
- Intègre des outils, des technologies ou des processus dans les systèmes opérationnels existants pour améliorer l'efficacité, la cohérence et la productivité.
- Assure des transitions fluides entre différents fournisseurs de modèles tout en maintenant la qualité des prompts et de la sortie.
Changer de fournisseurs de modèles
- Certains frameworks permettent de changer de fournisseurs de modèles avec des modifications minimales, réduisant les frictions opérationnelles.
- La mise à jour des imports de fournisseur, l'ajustement des paramètres du modèle et la modification des références de classe facilitent les transitions.
Gestion des prompts
- Maintient la cohérence des prompts tout en aidant les utilisateurs à itérer et à expérimenter de manière plus productive.
- S'intègre aux pipelines CI/CD pour rationaliser la collaboration et automatiser le suivi des modifications.
- Certains systèmes suivent automatiquement les modifications des prompts, aidant à détecter les impacts inattendus sur la qualité des prompts.
Modèle émergent : l'ingénierie du contexte
À mesure que l'orchestration LLM évolue, une nouvelle discipline a émergé : l'ingénierie du contexte. Elle se concentre sur l'optimisation des informations incluses dans l'entrée d'un LLM, en particulier lors de la combinaison de la récupération en temps réel, des interactions passées et de la mémoire pour améliorer la qualité et l'efficacité des réponses.
Cette pratique peut être considérée comme un modèle d'orchestration, où le contexte devient une ressource gérée qui est récupérée, filtrée et précisément façonnée pour correspondre à l'intention de l'utilisateur et aux limites de tokens.
Les éléments clés de ce modèle d'orchestration incluent :
- Courtier de contexte : une unité centralisée de la couche d'orchestration qui collecte et normalise les entrées provenant de la mémoire, des modules de récupération et des interactions récentes. Il garantit la cohérence de tous les workflows sensibles au contexte.
- Modules et voies : des composants spécialisés (tels que les résumeurs, les moteurs de récupération ou les recherches en mémoire) sont activés sélectivement par des mécanismes dynamiques de répartition des outils en fonction de la nature de la requête utilisateur ou de l'état du système.
- Empaquetage du contexte : le contenu récupéré et mémorisé est classé, compressé et organisé en prompts structurés. Cet empaquetage sélectif garantit que les informations à forte valeur ajoutée tiennent dans la fenêtre d'entrée du LLM sans dépasser les contraintes de tokens.
- Garde-fous et adaptation : des contraintes intégrées peuvent imposer des réponses basées uniquement sur la récupération, et les mises à jour de la mémoire à long terme garantissent que le système affine la sélection du contexte.
Ce modèle est de plus en plus essentiel dans les systèmes utilisant la génération augmentée par récupération (RAG), la collaboration multi-agents et les copilotes propulsés par LLM, où chaque requête doit déclencher les bons modules et faire remonter les informations les plus pertinentes.
 Ajouter comme source préférée
4 bonnes pratiques d'orchestration LLM
1-Commencer par une architecture modulaire et solide
- Décomposition des tâches : définissez clairement votre workflow et décomposez le problème en petites étapes distinctes et testables. Concevez votre pipeline de manière à ce que les fonctions clés (par exemple, la création de prompts, l'accès à la mémoire, la logique avancée) soient isolées dans leurs propres modules.
- Conception itérative : commencez par le prototype fonctionnel le plus simple (un « produit minimal viable ») et ajoutez progressivement de la complexité. Validez que chaque étape, de la récupération des données à la sortie finale, fonctionne de manière isolée avant de l'intégrer dans une chaîne complexe.
2-Routage et sélection dynamiques des modèles
- Optimisez le coût et la vitesse : évitez d'utiliser le LLM le plus coûteux et le plus grand pour chaque tâche. Implémentez une logique dans l'orchestrateur pour router les requêtes simples (comme la classification ou la synthèse) vers des modèles moins chers et plus petits, et réservez les modèles haut de gamme au raisonnement complexe ou à l'analyse en plusieurs étapes.
- Agnosticisme vis-à-vis des fournisseurs : structurez votre couche d'orchestration pour permettre un changement facile entre les fournisseurs de modèles (par exemple, OpenAI, Anthropic, Google) afin d'atténuer la dépendance vis-à-vis d'un fournisseur, de gérer les limites de débit des API et de tirer parti des modèles plus performants à mesure que le marché évolue.
3-Mettre en œuvre une observabilité et une surveillance robustes
- Journalisez tout : journalisez les entrées et sorties de chaque étape de la chaîne, et non le résultat final. C'est essentiel pour déboguer les flux conversationnels en plusieurs étapes et effectuer une analyse des causes racines (RCA) sur les erreurs.
- Suivez les indicateurs clés : surveillez la latence, le débit, la consommation de tokens (pour le contrôle des coûts) et les taux d'erreur des modèles en temps réel. Des alertes automatisées doivent être configurées pour signaler immédiatement les pics d'hallucinations ou de défaillances.
4-Vérifier les garde-fous de gouvernance et de sécurité
- Contrôles de pré-traitement et de post-traitement : enveloppez tous les appels LLM de garde-fous. Utilisez des contrôles de pré-traitement (par exemple, le filtrage du contenu, la mise sur liste noire des sujets interdits) sur les entrées utilisateur et des contrôles de post-traitement (par exemple, la vérification du format de sortie structuré, les contrôles de sécurité) sur la réponse du modèle avant la livraison.
- Conformité : pour les données sensibles, mettez en œuvre des couches de permission, l'anonymisation et le chiffrement dès le début du processus de conception afin de maintenir la conformité (par exemple, HIPAA, RGPD).
4 défis de l'orchestration LLM et stratégies d'atténuation
Voici quelques problèmes associés à l'orchestration LLM et les méthodes pour les résoudre : défis fondamentaux de l'orchestration multi-LLM
1.Coordination et blocages des workflows
En raison de la nature non déterministe des LLM, définir des transitions claires entre des rôles LLM spécialisés est difficile. Cela entraîne un chevauchement des tâches (utilisation redondante de tokens) ou des blocages de workflow (une instance LLM attend indéfiniment une sortie ambiguë d'une autre).
Atténuez avec un workflow structuré et une communication claire
- Utilisez un contrôleur de workflow pour décomposer l'objectif en un graphe acyclique dirigé (DAG) de sous-tâches.
- Imposez un protocole de communication Pydantic/JSON pour tous les transferts de tâches. Cela oblige le LLM à produire des données lisibles par machine et validées par schéma, rendant les signaux de progression non ambigus et empêchant les cycles.
2. Dérive contextuelle et incohérence de la mémoire
La fenêtre de contexte fixe du LLM et son absence d'état inhérente le rendent sujet à la dérive contextuelle, où un rôle LLM oublie l'objectif global ou des faits antérieurs cruciaux. Dans une configuration multi-LLM, cela crée des décisions conflictuelles et des sorties globales incohérentes.
Atténuez à l'aide d'une base de connaissances externalisée avec RAG
- Implémentez un système de mémoire externe (base de données vectorielles ou graphe de connaissances). Les rôles LLM spécialisés enregistrent les faits clés, les décisions et les sorties sous forme de données structurées. Lorsqu'une instance LLM a besoin de contexte, elle utilise la génération augmentée par récupération (RAG) pour interroger cette source externe, s'assurant ainsi de récupérer les informations les plus pertinentes et non redondantes.
3. Sortie non déterministe et hallucination en cascade
La sortie probabiliste du LLM signifie que les réponses ne sont pas fiables. Lorsqu'une instance LLM (le producteur) fabrique des informations (hallucine), une instance LLM en aval (le consommateur) les considère comme des faits, entraînant une défaillance en cascade complète du workflow multi-LLM.
Atténuez avec des mécanismes de consensus et de validation
- Utilisez un modèle de consensus pour les sorties critiques. Le contrôleur de workflow achemine la sortie initiale vers un rôle de validation LLM secondaire ou vers une base de données/API externe pour vérification des faits. Le workflow se poursuit si la sortie est vérifiée avec succès, atténuant ainsi efficacement le risque d'erreurs non déterministes du modèle.
4. Contention des ressources et dépassement des coûts
La mise à l'échelle des workflows multi-LLM crée une forte demande pour l'API LLM (une ressource coûteuse et limitée en débit). Cela entraîne des défaillances de limite de débit (limitation de l'API) et une consommation massive de tokens (dépassement des coûts) due à un travail redondant ou à des boucles.
Atténuez avec une file d'attente asynchrone et des garde-fous budgétaires
- Utilisez une file d'attente de tâches asynchrone (par exemple, Celery) avec un limiteur de débit pour contrôler la concurrence d'exécution des appels d'API.
- Implémentez des outils d'observabilité pour suivre l'utilisation des tokens par tâche et définir des budgets de tokens automatisés (coupe-circuits) qui terminent ou mettent en pause toute instance LLM incontrôlée, en gérant le coût opérationnel en temps réel.
L'orchestration est-elle un composant clé des LLM ?
Oui. L'orchestration est un composant clé des systèmes basés sur les LLM, mais ce n'est pas un composant central du modèle comme les poids du modèle ou le tokenizer. Il s'agit plutôt d'une capacité au niveau du système qui rend les LLMs utilisables dans des applications réelles.
Parmi les composants essentiels, l'orchestration se situe généralement aux côtés de :
- Modèle LLM : un LLM (LLM) traite de vastes quantités de données pour comprendre et générer un texte semblable à celui des humains. Les modèles open source offrent de la flexibilité, tandis que les modèles closed source offrent une facilité d'utilisation et un support. Les LLMs à usage général gèrent diverses tâches, tandis que les modèles spécialisés par domaine s'adressent à des secteurs spécialisés.
- Prompts : des prompts efficaces guident les réponses des LLM.
- Prompts zero-shot : génèrent des réponses sans exemples préalables.
- Prompts few-shot : utilisent quelques échantillons pour affiner la précision. Apprenez-en plus sur l'apprentissage par quelques exemples et les autres méthodes de fine-tuning des LLM.
- Prompts de chaîne de pensée : encouragent le raisonnement logique pour de meilleures réponses.
- Base de données vectorielles : stocke des données structurées sous forme de vecteurs numériques. Les LLMs utilisent des recherches de similarité pour récupérer le contexte pertinent, améliorant la précision et empêchant les réponses obsolètes.
- Agents et outils : étendent les capacités des LLM en exécutant des recherches web, en exécutant du code ou en interrogeant des bases de données. Ils améliorent l'automatisation pilotée par l'IA et les solutions métiers.
- Orchestrateur (couche de contrôle) : intègre les LLMs, les prompts, les bases de données vectorielles et les agents dans un système cohérent. Assure une coordination fluide pour des applications efficaces propulsées par l'IA.
- Surveillance : suit les performances, détecte les anomalies et journalise les interactions. Garantit des réponses de haute qualité et aide à atténuer les erreurs dans les sorties des LLM.
Citer cette recherche
Choisissez le format qui correspond à votre lieu de publication. Coller la version avec lien dans votre CMS préserve le lien retour.
@misc{simsek2026,
  author = {Şimşek, Hazal},
  title  = {{LLM Orchestration: 21 frameworks et passerelles}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/llm-orchestration}},
  note   = {AIMultiple. Consulté le 21 octobre 2026}
}Résultats et horodatages de 212 points de données. Téléchargez les données de synthèse présentées dans les graphiques et les tableaux de cet article sous forme de fichier ZIP contenant 5 fichiers CSV.
Vous voulez les données détaillées derrière ? Rejoindre Premium
Journal des modifications
9 mises à jourSuppression de la section FAQ et de l'entrée Nexos.ai de la liste des passerelles d'IA.
Ajout des résultats de benchmark à l'introduction et à une nouvelle section.
La section "Outils d'orchestration LLM" a été étendue avec une nouvelle catégorisation des outils en "Plateformes basées sur des passerelles" et "Frameworks de développement."
Liens de référence










Soyez le premier à commenter
Votre adresse courriel ne sera pas publiée. Tous les champs sont obligatoires. Les commentaires sont laissés dans leur langue d'origine.