


Agents IA locaux: Goose, Observer IA, AnythingLLM

Les agents IA locaux sont souvent décrits comme hors ligne, sur l’appareil ou entièrement locaux. Nous avons passé trois jours à cartographier l’écosystème des agents IA locaux qui fonctionnent de manière autonome sur du matériel personnel sans dépendre d'APIs externes ni de services cloud.
Notre analyse classe les principales solutions en trois domaines clés, sur la base de tests pratiques sur les agents développeurs, les outils d’automatisation et les assistants de productivité.
Catégorisation des agents IA locaux
Catégorie | Outils/Frameworks | Cas d’utilisation principaux (local / hors ligne) |
|---|---|---|
Agents développeurs et système | Goose, Localforge, Devika, Roo Code (Boomerang Mode), Continue.dev, Cursor, CodeGenie, SuperCoder, Aider, Cline, Kilo Code | Codage local, débogage, automatisation de fichiers/processus, tâches DevOps locales |
Agents locaux d’automatisation et de contrôle | Observer IA, Browser-Use, DeepBrowser | Contrôle local du navigateur, automatisation de fichiers, interaction avec les applications, flux de travail sur appareil |
Agents de connaissance et de productivité | AnythingLLM (Desktop), LocalGPT (Single-User), PrivateGPT | Questions-réponses sur documents hors ligne, synthèse, recherche locale/RAG |
Voir les descriptions des catégories.
1. Agents développeurs et système
*Types d’exécution :
- Entièrement local : L’outil s’exécute nativement sur le matériel personnel en utilisant des runtimes locaux. Outils capables de fonctionner entièrement hors ligne.
- Local hybride : Le modèle central ou l’exécution des tâches se fait localement, mais certaines fonctionnalités, comme l’intégration IDE, l’indexation du contexte, la synchronisation ou le raisonnement, dépendent encore de services cloud ou d'APIs.
** Explication de la colonne sur la machine :
- Entièrement sur l’appareil : Inférence, raisonnement et exécution hors ligne complets, tous exécutés localement.
- Inférence locale, assistée par le cloud : Le modèle central s’exécute localement, mais les fonctionnalités IDE ou de gestion utilisent des services en ligne.
- Exécution locale, raisonnement distant : Le code s’exécute localement, mais des APIs externes assurent le raisonnement ou la planification.
Goose
Goose est un agent de développement open source conçu pour fonctionner entièrement sur du matériel local.1
Fonctionnalités principales :
- Utilise des runtimes LLM locaux pour le raisonnement et la génération de code
- Exécute des tâches en plusieurs étapes telles que l’écriture, le test et le débogage de code
- Interagit directement avec le système de fichiers local et les outils de développement
- Ne nécessite pas de connectivité réseau lorsqu’il est configuré avec des modèles locaux.
Goose satisfait une définition stricte d’agent local autonome, car l’observation, le raisonnement et l’action se produisent sur l’appareil.
Roo Code(Boomerang Mode)
Roo Code est un assistant de codage intégré à l’IDE qui met l’accent sur l’amélioration itérative.
- Le mode Boomerang permet l’exécution locale des actions
- Le raisonnement repose généralement sur des modèles basés sur le cloud
- Les fonctions de coordination et de gestion de l’IDE ne sont pas entièrement locales
Par conséquent, Roo Code doit être classé comme un agent développeur hybride avec intervention humaine, plutôt que comme un système entièrement local.
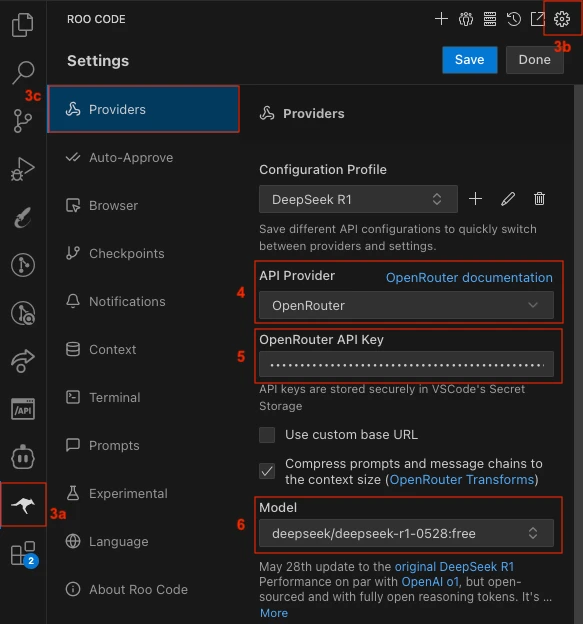
Configuration d’un agent IA local dans Roo Code :
Roo Code permet aux développeurs de créer des profils de configuration personnalisés qui définissent la manière dont il se connecte à différents modèles d’IA, y compris des LLM hébergés localement.
Depuis Settings → Providers, vous pouvez ajouter des profils via OpenRouter ou d’autres fournisseurs pris en charge, puis choisir un modèle local exécuté via Ollama ou LM Studio.
Chaque profil de configuration peut stocker ses propres paramètres, notamment la température, la profondeur de raisonnement et les limites de tokens. Cela vous permet de basculer entre des modèles cloud légers et des runtimes entièrement locaux pour l’inférence sur appareil.
Cursor
Cursor permet d’utiliser des LLM locaux pour l’inférence, mais reste dépendant des services cloud pour :
- L’indexation du code
- L’application des modifications
- La coordination du flux de travail
Par conséquent, Cursor prend en charge l’inférence locale, mais pas une boucle d’agent entièrement locale, et ne peut pas fonctionner hors ligne.
Comment utiliser un LLM local dans Cursor :
Source : Logan Hallucinates2
Aider
Aider est un assistant de codage IA open source, basé sur la ligne de commande, conçu pour travailler directement avec les dépôts Git locaux. Il modifie le code en générant des correctifs et des commits plutôt qu’en passant par une interface IDE.
Aider est souvent utilisé avec des modèles hébergés dans le cloud, mais :
- L’outil lui-même s’exécute localement
- Lorsqu’il est associé à un runtime de modèle local, il peut fonctionner entièrement sur l’appareil
La capacité hors ligne dépend donc du choix du modèle, et non de l’outil lui-même.
2. Agents locaux d’automatisation et de contrôle
Observer IA
Observer IA est un framework d’agent d’automatisation locale open source.
Fonctionnalités principales :
- Exécute des agents à l’aide de LLM locaux
- Observe l’état de l’écran via OCR ou des captures d’écran
- Exécute du code Python dans un environnement d’exécution embarqué
- Ne nécessite aucune connectivité cloud
Observer IA fournit l’infrastructure nécessaire au comportement des agents plutôt qu’une politique d’agent fixe, et se décrit le mieux comme un framework de boucle de contrôle locale.
Browser-Use
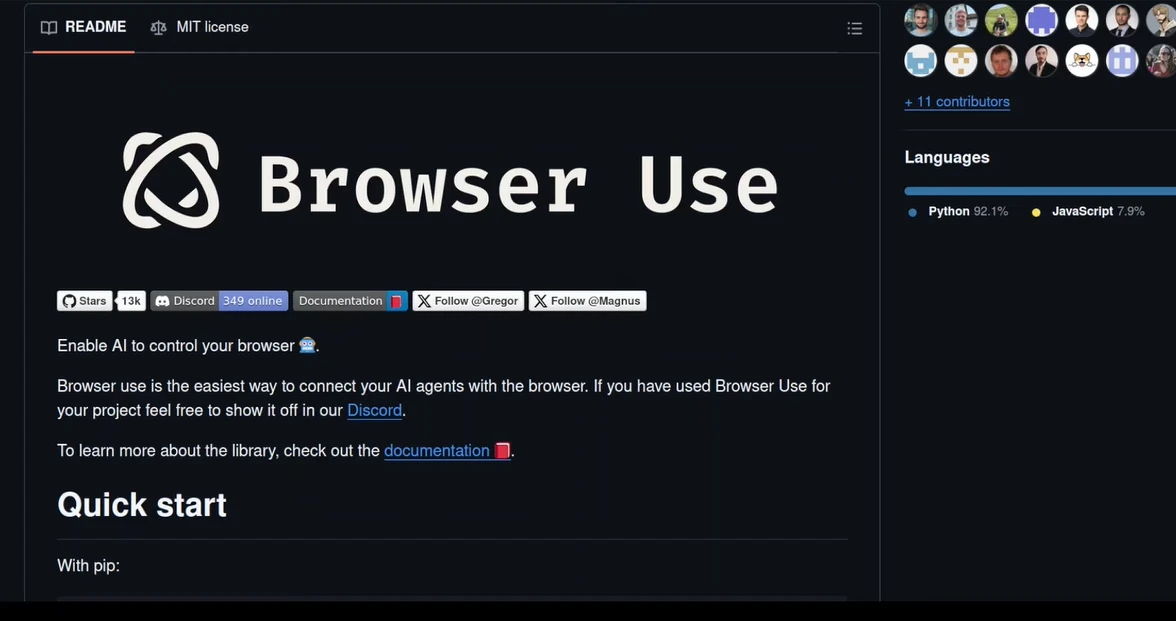
Browser-Use permet une interaction avec le navigateur pilotée par l’IA via Playwright.
- Les actions du navigateur sont exécutées localement
- Le raisonnement peut être effectué à l’aide de modèles locaux ou distants
- Un fonctionnement hors ligne est possible lorsqu’il est associé à une inférence locale
Cela place Browser-Use par défaut dans la catégorie de l’automatisation hybride.
Comment utiliser un LLM local dans Browser-Use :
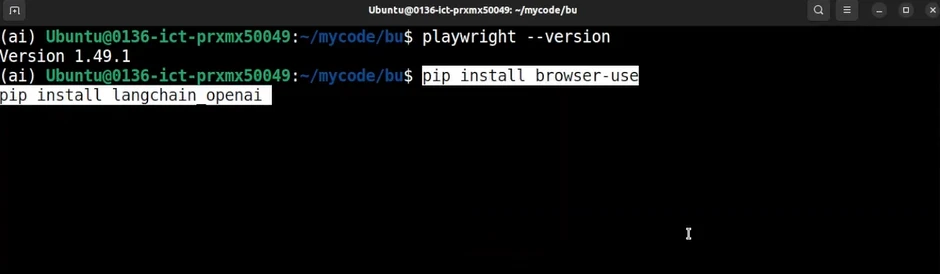
Une méthode pour l’installer consiste à utiliser la commande pip install browser-use, qui met en place à la fois l’interface Python et le contrôle local du navigateur sur la même machine.
Lorsqu’on l’exécute plus tard (par exemple avec python -m browser_use), il ouvrira et contrôlera une instance de navigateur localement, en exécutant les actions et le raisonnement soit via un LLM local (par ex. via Ollama), soit via des API connectées :
Installation locale de Browser-Use3
Pour ceux qui souhaitent voir la configuration complète en action, voici un guide vidéo étape par étape montrant comment installer et exécuter Browser-Use sur une machine locale :
Le tutoriel couvre tout, de l’installation de dépendances comme Playwright et LangChain jusqu’à la connexion de Browser-Use à un modèle local via Ollama.3
3. Agents de connaissance et de productivité
AnythingLLM (Desktop)
Lorsqu’il est configuré avec des modèles locaux, AnythingLLM Desktop :
- Effectue l’indexation des documents localement
- Exécute le raisonnement de l’agent sur l’appareil
- Prend en charge des capacités d’action limitées (par ex., l’écriture de fichiers)
- Ne nécessite pas de connectivité cloud
Bien que son autonomie soit limitée par rapport aux agents système, il se qualifie comme agent local de productivité dans le cadre d’une définition de tâche étroite.
Un cas d’utilisation exemplaire d’un agent IA local
Nous avons testé AnythingLLM Desktop pour voir comment un agent local sur appareil fonctionne, de la configuration initiale à la sortie finale.
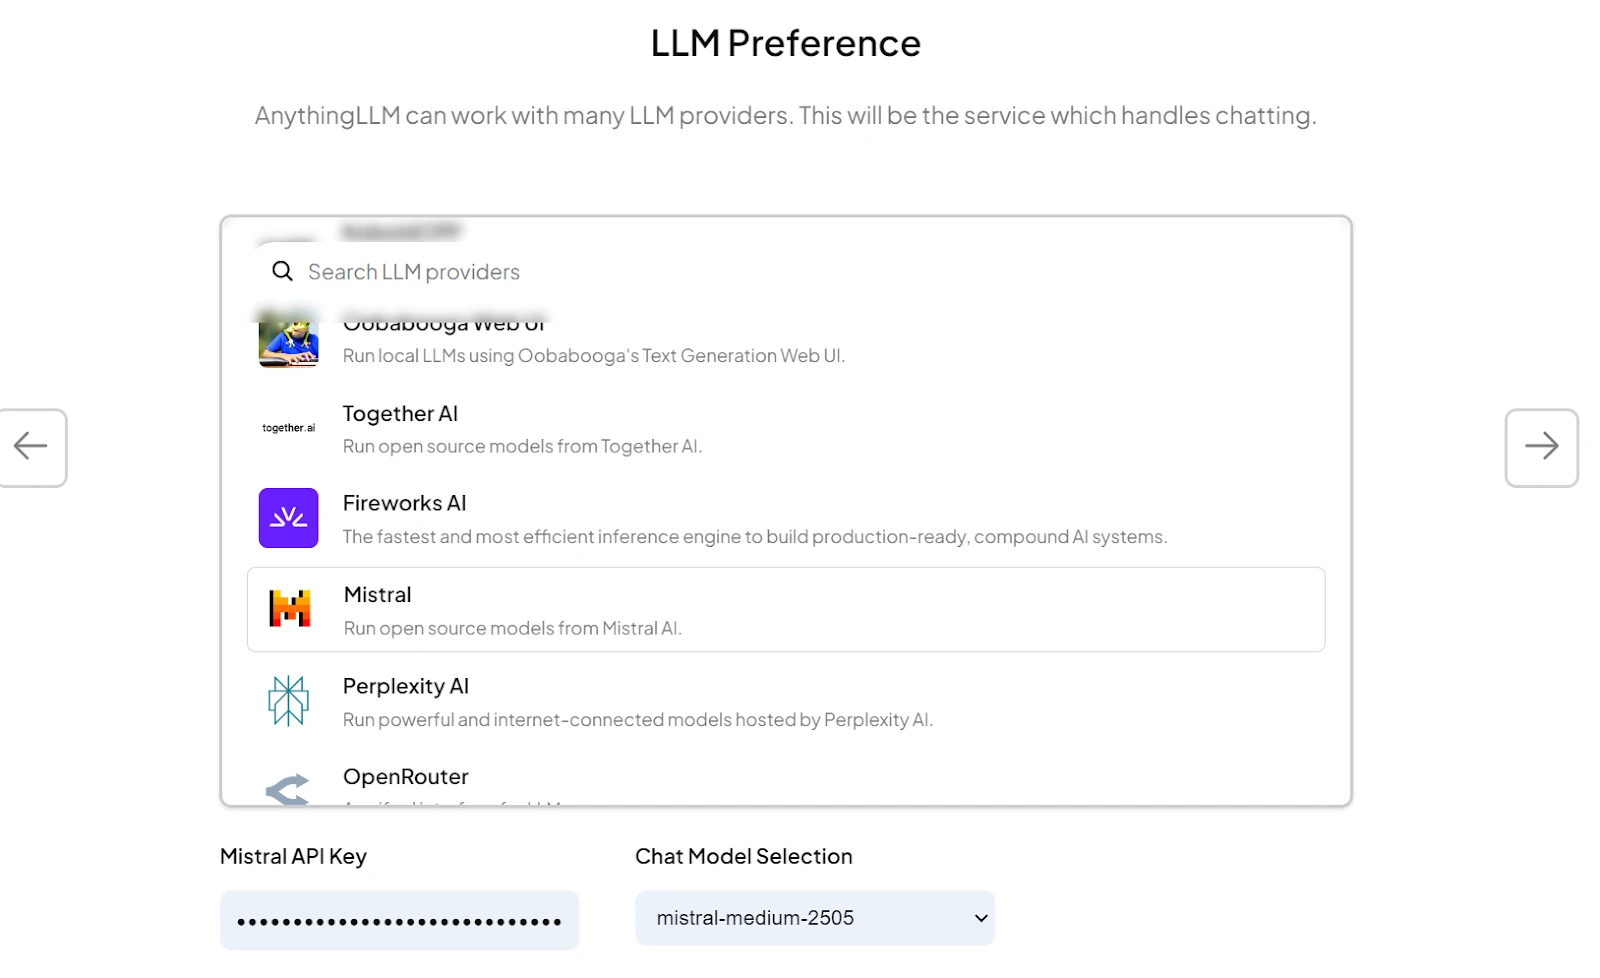
1. Configuration de l’espace de travail
Nous avons ouvert les paramètres de l’espace de travail et sommes allés dans Configuration de l’agent.
Là, nous avons choisi un fournisseur de LLM et sélectionné le modèle mistral-medium-2505.
Après avoir cliqué sur Mettre à jour l’agent de l’espace de travail, l’espace de travail a confirmé que la configuration était terminée.
2. Activation des compétences de l’agent
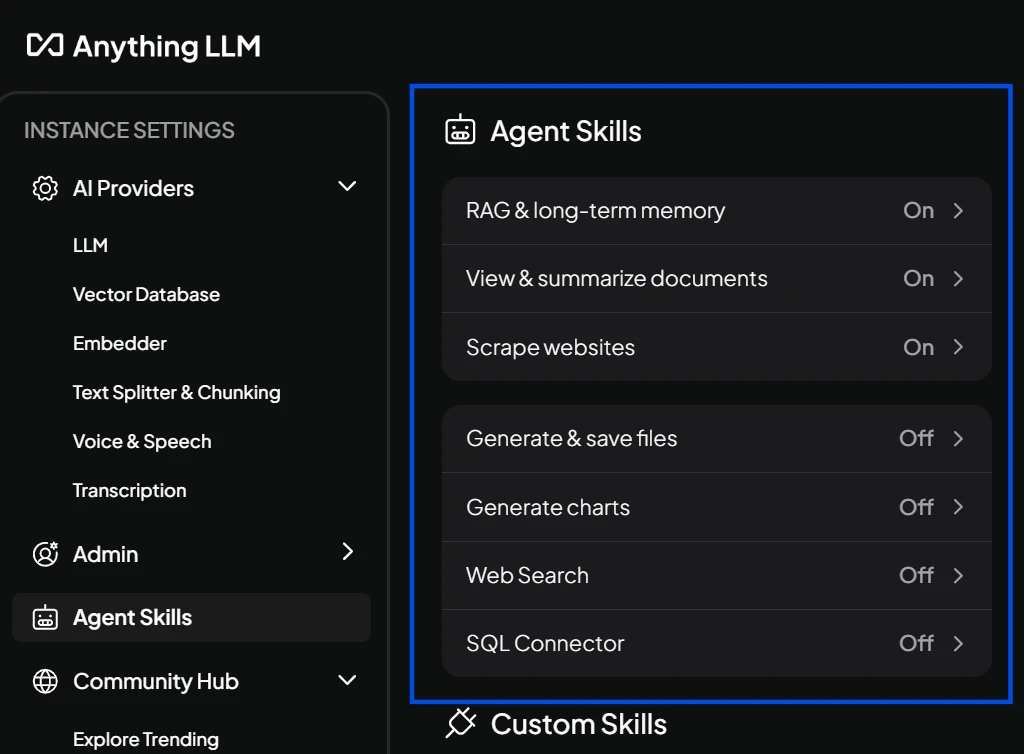
Ensuite, nous avons ouvert le panneau Configurer les compétences de l’agent.
Ce menu vous permet d’activer les capacités intégrées de l’agent en un seul clic. Aucun codage n’est requis.
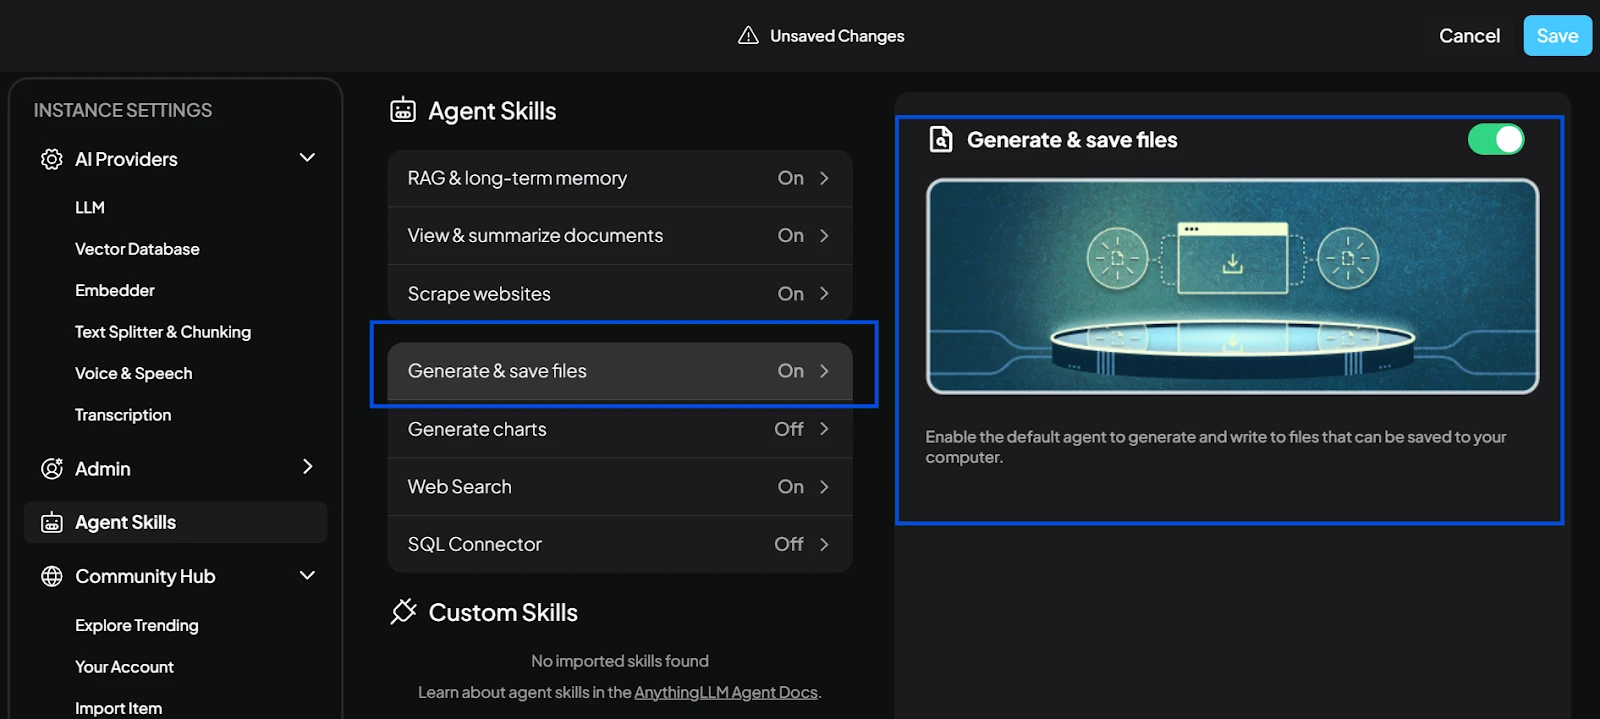
3. Test de la compétence « Save Files »
Nous avons activé la compétence Save Files, permettant à l’agent d’écrire les sorties directement sur la machine locale.
Après l’avoir activée et après avoir enregistré la modification, l’agent était prêt.
Pour la tester, nous sommes revenus à la fenêtre de chat et avons utilisé l’une des invites d’exemple de la documentation.
Cela a confirmé que l’agent pouvait générer un fichier et le préparer à l’enregistrement local.
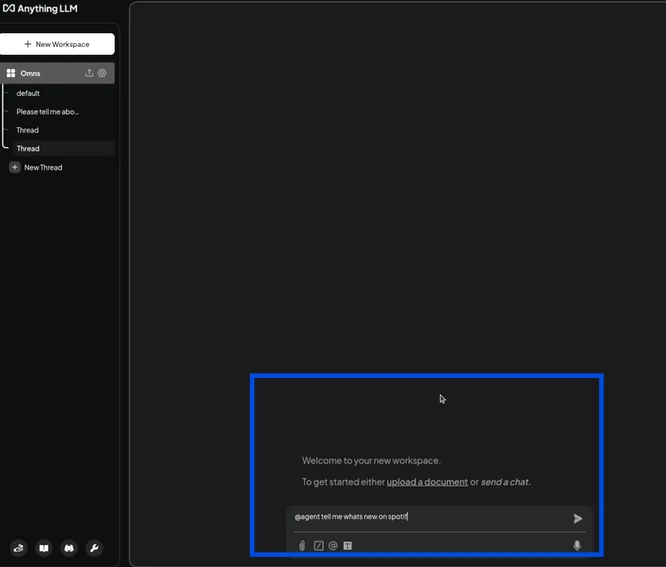
4. Exécution de l’agent dans le chat
Nous avons demandé à l’agent de summarize un sujet historique et l’avons invoqué en utilisant @agent.
Nous avons modifié la commande pour enregistrer la sortie sous forme de simple fichier texte au lieu d’un PDF.
Le système a confirmé que le mode Agent Chat était actif et a montré comment quitter la boucle.
L’agent a produit le résumé et préparé le fichier à l’enregistrement.
5. Enregistrement du fichier localement
Pour enregistrer la sortie, nous avons utilisé la commande d’exemple de la documentation d’AnythingLLM :
« @agent peut-il enregistrer ces informations en PDF sur mon dossier de bureau ? »
Nous avons exécuté la même structure dans le chat, mais pour un fichier texte.
Une fenêtre de navigateur de fichiers s’est ouverte, et nous avons enregistré la sortie sur l’appareil.
Le fichier est apparu dans le dossier Téléchargements, ce qui indique que l’ensemble du processus, le raisonnement, l’exécution et l’enregistrement ont tous été effectués entièrement sur l’appareil.
Descriptions des catégories d’agents IA locaux
- Agents développeurs et système (couche d’action) : Agents qui s’exécutent directement sur votre appareil pour effectuer localement des tâches de codage, de système et d’automatisation des flux de travail.
- Agents locaux d’automatisation et de contrôle : Agents qui automatisent des actions réelles sur votre machine en contrôlant le navigateur, l’interface utilisateur ou le système d’exploitation.
- Agents de connaissance et de productivité : Assistants locaux pour le chat, la synthèse et la gestion de documents sans envoyer de données vers le cloud.
Couches architecturales dans la pile d’agents locale
- Couche d’action (agents) : Systèmes qui observent l’état, invoquent des outils et agissent sur l’environnement local.
- Couche de raisonnement et d’orchestration (frameworks) : Bibliothèques telles que LangGraph ou LlamaIndex qui prennent en charge la planification, la mémoire et la coordination. Ce ne sont pas des agents par eux-mêmes.
- Couche d’exécution (runtimes locaux) : Runtimes de modèles tels qu’Ollama ou LM Studio qui permettent l’inférence locale.
Matériel : ce dont les agents locaux ont réellement besoin
Le modèle et le framework ne représentent que la moitié de l’histoire. Le matériel détermine ce qui est réellement possible. Pour exécuter des modèles de langage localement, deux chiffres comptent le plus : la quantité de mémoire dont vous disposez et la vitesse de cette mémoire.
RAM (ou VRAM) fixe la limite de la taille du modèle
Un modèle doit tenir en mémoire avant de pouvoir s’exécuter. Un guide approximatif pour les modèles quantisés en 4 bits : un modèle 3B nécessite environ 2 Go, un modèle 7–8B nécessite environ 5 à 6 Go, un modèle 13B nécessite environ 8 à 10 Go, et un modèle 70B nécessite environ 40 à 48 Go. Ajoutez de la marge pour le contexte, le système d’exploitation et toute autre application en cours d’exécution. En pratique, la mémoire est plus souvent le goulot d’étranglement que le calcul, et sur les PC Copilot+, la cible recommandée pour une utilisation confortable d’un LLM local est d’au moins 32 Go de RAM.4
La bande passante mémoire détermine la vitesse
Une fois qu’un modèle tient en mémoire, la vitesse à laquelle il génère des tokens dépend surtout de la rapidité avec laquelle le système peut lire les poids du modèle depuis la mémoire. C’est pourquoi la bande passante mémoire élevée d’Apple Silicon (jusqu’à 800 Go/s sur le M4 Max) constitue l’avantage pratique pour l’inférence de LLM, et non le nombre de moteurs neuronaux.5
Les TOPS du NPU importent moins que ce que le marketing suggère
Un processeur neuronal est une puce conçue pour les mathématiques de l’IA, et sa puissance est exprimée en TOPS (milliards d’opérations par seconde). La certification Copilot+ PC de Microsoft exige au moins 40 TOPS. Ce seuil vise les fonctionnalités sur appareil de Microsoft (sous-titres en direct, effets d’image, Recall) plutôt que l’exécution d’un LLM de type chat. Pour les charges de travail LLM, la RAM et la bande passante dominent. La performance du NPU est un facteur de départage utile, pas le chiffre principal.
Une règle pratique :
- Pour les modèles d’assistant de classe 3B, un ordinateur portable actuel avec 16 Go de mémoire unifiée ou de RAM suffit.
- Pour les modèles 7–8B avec une vitesse confortable, visez 32 Go de RAM et une bande passante mémoire élevée. Apple Silicon, la série Snapdragon X et les PC Copilot+ Intel/AMD actuels fonctionnent tous ; les différences se manifestent en tokens par seconde, pas dans la capacité du modèle à s’exécuter.
- Pour les modèles plus grands (30B et plus), les options se divisent. Les Apple Silicon à mémoire élevée (configurations Mac Studio ou MacBook Pro avec 64 à 192 Go de mémoire unifiée) peuvent exécuter de grands modèles qu’aucun GPU grand public discret ne peut contenir. L’alternative est une station de travail équipée d’un ou plusieurs GPU discrets à haute VRAM. Les deux approches fonctionnent ; elles présentent des profils de coût et de consommation différents.
 Ajouter comme source préférée
Conseils pratiques
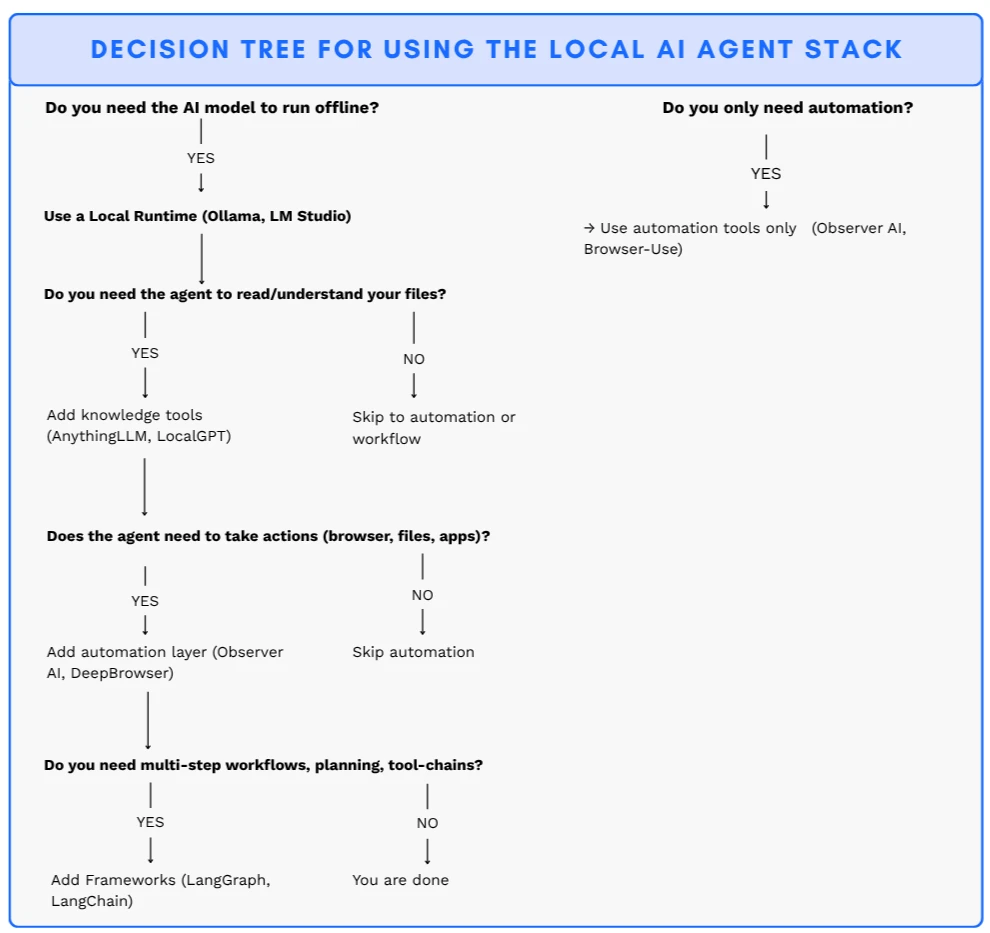
Les systèmes d’IA locaux doivent être assemblés progressivement :
- Commencez par un runtime local si une inférence hors ligne est requise.
- Ajoutez une couche de connaissance lorsque la compréhension de documents est nécessaire.
- Introduisez des agents d’automatisation ou de contrôle lorsque des actions réelles sont requises.
- Utilisez des frameworks d’orchestration pour les flux de travail complexes en plusieurs étapes.
Dans la plupart des cas, une pile entièrement en couches n’est pas nécessaire.
Comment aborder la pile d’agents IA locale
Commencez par le plus petit ensemble de couches requis par votre cas d’utilisation. Si votre agent a besoin d’un raisonnement hors ligne, commencez par un runtime local comme Ollama ou LM Studio. S’il doit comprendre vos fichiers, ajoutez une couche de connaissance comme AnythingLLM ou LocalGPT. Pour les agents qui doivent agir (ouvrir des applications, contrôler le navigateur, gérer des fichiers), ajoutez une couche d’automatisation locale. Utilisez des frameworks comme LangGraph ou LlamaIndex lorsque vous avez besoin de flux de travail en plusieurs étapes, de boucles de planification ou de chaînes d’outils complexes.
Pourquoi exécuter un agent localement
La confidentialité est une question juridique, pas une préférence
En vertu du Digital Omnibus, les obligations à haut risque de la loi européenne sur l’IA s’appliquent désormais à partir du 2 décembre 2027 pour les systèmes autonomes (Annexe III) et à partir du 2 août 2028 pour l’IA dans les produits réglementés ; les obligations de transparence au titre de l’article 50 s’appliquent depuis le 2 août 2026.6 Les sanctions peuvent atteindre €15 millions ou 3 % du chiffre d’affaires annuel mondial. Un modèle exécuté sur votre propre matériel traite les données dans votre environnement, sans les transmettre à un fournisseur cloud. Le risque de transfert transfrontalier de données disparaît.7
Latence
Les appels API cloud ajoutent de 200 à 500ms de délai réseau avant l’apparition du premier token. L’inférence sur appareil le réduit à moins de 20ms. Pour les agents vocaux, la complétion de code et tout ce qui touche une interface utilisateur en temps réel, c’est la différence entre fluidité et latence.
Coût en volume
Les appels cloud sont bon marché par requête et coûteux en masse. Un modèle local a un coût matériel fixe et aucune facture par token. Le compromis reste réel : les agents locaux sont limités par le modèle qui tient en mémoire et par le matériel sur le bureau. Les sections suivantes couvrent les deux aspects.
FAQ
Les agents IA locaux fonctionnent de manière autonome sur du matériel personnel sans dépendre d'APIs externes ni d’une infrastructure cloud.
Citer cette recherche
Choisissez le format qui correspond à votre lieu de publication. Coller la version avec lien dans votre CMS préserve le lien retour.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Arslan, Ezgi},
  title  = {{Agents IA locaux: Goose, Observer IA, AnythingLLM}},
  year   = {2026},
  month  = jul,
  howpublished    = {\url{https://aimultiple.com/local-ai-agent}},
  note   = {AIMultiple. Consulté le 30 juillet 2026}
}Résultats et horodatages de 19 points de données. Téléchargez les données de synthèse présentées dans les graphiques et les tableaux de cet article sous forme de fichier ZIP contenant 4 fichiers CSV.
Vous voulez les données détaillées derrière ? Rejoindre Premium
Journal des modifications
3 mises à jourAjout des sections « Pourquoi exécuter un agent localement » et exigences matérielles locales.
Les sections « Frameworks » et « Local runtimes & infrastructure » ont été supprimées.
Liens de référence
Le travail de Cem chez AIMultiple a été cité par des publications mondiales de premier plan, notamment Business Insider, Forbes, Morning Brew et Washington Post, par des entreprises mondiales comme Deloitte et HPE, par des ONG comme World Economic Forum et par des organisations supranationales comme European Commission. [1], [2], [3], [4], [5]
Tout au long de sa carrière, Cem a été consultant en technologies, acheteur de technologies et entrepreneur technologique. Il a conseillé des entreprises sur leurs décisions technologiques chez McKinsey & Company et Altman Solon pendant plus de dix ans. Il a également publié un rapport McKinsey sur la digitalisation.
Il a dirigé la stratégie technologique et les achats d'un opérateur télécom, sous la responsabilité du PDG. Il a également dirigé la croissance commerciale de l'entreprise de technologie profonde Hypatos, qui a atteint un revenu récurrent annuel à 7 chiffres et une valorisation à 9 chiffres, passant de 0 à ce résultat en deux ans. Le travail de Cem chez Hypatos a été couvert par des publications technologiques de premier plan comme TechCrunch et Business Insider.
Cem intervient régulièrement lors de conférences technologiques internationales. Il est diplômé de Bogazici University en tant qu'ingénieur informatique et titulaire d'un MBA de la Columbia Business School.




Soyez le premier à commenter
Votre adresse courriel ne sera pas publiée. Tous les champs sont obligatoires. Les commentaires sont laissés dans leur langue d'origine.