


15 Yapay Zeka Ajanı Gözlemlenebilirlik Araçları: AgentOps & Langfuse

15 gözlemlenebilirlik platformunu LLM uygulamaları ve yapay zeka ajanları için test ettik. Her platform; iş akışları kurma, entegrasyonları yapılandırma ve test senaryoları çalıştırma yoluyla uygulamalı olarak hayata geçirildi. Üretim pipeline'larına ek yük getirip getirmediklerini ölçmek için 4 gözlemlenebilirlik aracını kıyasladık. Ayrıca LangChain gözlemlenebilirliğini Langfuse kullanarak gösterdik.
Ajanik izleme araçları ek yük kıyaslaması
Her gözlemlenebilirlik platformunu çok ajanlı seyahat planlama sistemimize entegre ettik ve enstrümantasyon olmadan taban çizgisine kıyasla performans ek yüklerini ölçmek için 100 özdeş sorgu çalıştırdık. Kıyaslama metodolojimizi okuyun.
- LangSmith neredeyse hiç ölçülebilir ek yük olmadan olağanüstü verimlilik gösterdi; bu da onu performans açısından kritik üretim ortamları için ideal hale getiriyor.
- Laminar %5 gibi minimum ek yük getirdi; bu da onu performansın kritik olduğu üretim ortamları için oldukça uygun hale getiriyor.
- AgentOps ve Langfuse sırasıyla %12 ve %15 oranında orta düzeyde ek yük gösterdi; bu da gözlemlenebilirlik özellikleri ile performans etkisi arasında makul bir dengeyi temsil ediyor. Bu platformlar çoğu üretim kullanım durumu için hâlâ kabul edilebilir gecikme süresini koruyor.
Performans farklılıklarının ardındaki olası nedenler
Kıyaslamamız, gecikme farklılıklarının enstrümantasyon derinliği ve yürütme yolundaki katılımdan kaynaklandığını gösteriyor; bu durum özellikle çok ajanlı iş akışlarında belirgindir. Daha derin, adım düzeyinde gözlemlenebilirlik sunan araçlar daha yüksek ek yük sergilerken daha hafif izleme yaklaşımları taban çizgisine daha yakın kaldı.
1. Yürütme yolundaki enstrümantasyon derinliği
Gözlemlenebilirlik araçları, izleri ve metadata'yı yakalamak için ajanın yürütme akışına mantık ekler. Bu mantık istek işlenirken eşzamanlı olarak çalıştığında, ajan yanıt döndürmeden önce bu ek işi tamamlamak zorunda olduğundan uçtan uca gecikmeyi doğrudan artırır.
Örneğin:
- LangSmith sanal olarak hiç ölçülebilir ek yük eklemedi (~%0); bu da çok az eşzamanlı çalışma olduğunu gösteriyor.
- Langfuse'un daha derin adım düzeyindeki enstrümantasyonu daha yüksek ek yüke (~%15) katkıda bulundu.
2. Çok adımlı pipeline'larda olay çoğaltılması
Çok ajanlı sistemlerde tek bir kullanıcı isteği birden fazla ajan eylemini tetikler. Bir araç her adımda ayrıntılı veri kaydettiğinde toplam olay sayısı hızla artar; iş akışı derinleştikçe işleme ve iz yönetimi ek yükü yükselir.
Kıyaslama sonuçlarında:
- Langfuse ve AgentOps, çok adımlı seyahat planlama iş akışımızda belirgin şekilde daha yüksek ek yük (%15 ve %12) oluşturdu.
- LangSmith ve Laminar, ajan adımı başına daha az olay yaydı.
3. Satır içi değerlendirme ve doğrulama ek yükü
Bazı platformlar ajan çalışırken ek kontroller veya izleme gerçekleştirir. Her kontrol hafif olsa da bunların tüm ajan adımlarında tekrar uygulanması ölçülebilir gecikme ekler.
Örneğin:
- AgentOps'un yaşam döngüsü düzeyindeki izlemesi %12 ek yükle aynı zamana denk geldi %12
- Laminar, yürütmeyi etkileyen satır içi değerlendirmeye dair kanıt göstermedi; ~%5 seviyesinde kaldı.
4. Serileştirme ve kalıcılık sıklığı
Ayrıntılı gözlemlenebilirlik verilerini yakalamak, izlerin serileştirilmesini ve depolamaya veya harici arka uçlara yazılmasını gerektirir. Daha yüksek iz ayrıntısı bunun ne sıklıkta gerçekleştiğini artırarak her isteğe I/O ek yükü ekler.
Kıyaslamamızda:
- Langfuse'un ayrıntılı prompt, çıktı ve token izlemesi en yüksek ek yükle (~%15) sonuçlandı.
- LangSmith'in daha hafif iz artefaktları taban çizgisine yakın kaldı.
5. Ajan framework'ü ile entegrasyon sıkılığı
Bir aracın ajan framework'üyle ne kadar yakın entegre olduğu performansı etkiler. Daha sıkı entegrasyonlar çeviri ve orkestrasyon adımlarını azaltırken daha genel SDK'lar ekstra işleme katmanları ekler.
Örneğin:
- LangSmith'in ajan yürütmesiyle sıkı uyumu ~%0 ek yükle ilişkilendirildi.
- AgentOps ve Langfuse, daha ayrık entegrasyon yollarıyla tutarlı olarak daha yüksek gecikme etkisi gösterdi.
Yapay zeka ajanı gözlemlenebilirlik platformları
Kademe 1: İnce taneli LLM & prompt / çıktı gözlemlenebilirliği
* Bu sütunlarda listelenen yetenekler, entegrasyonlar veya özelleştirme yoluyla genişletildiğinde her bir aracın neleri izleyebileceğine dair açıklayıcı örneklerdir. Bunlar tek bir platforma özel değildir.
Kademe 2: İş akışı, model ve değerlendirme gözlemlenebilirliği
Kademe 3: Ajan yaşam döngüsü ve operasyon gözlemlenebilirliği
Kademe 4: Sistem ve altyapı izleme (ajan yerel olmayan)
Datadog (LLM Gözlemlenebilirlik modülüyle birlikte) ve Prometheus (dışa aktarıcılar yoluyla), Langfuse/LangSmith ile birlikte giderek daha fazla kullanılıyor.
Ajan geliştirme ve orkestrasyon platformları:
- Flowise, Langflow, SuperAGI ve CrewAI gibi araçlar; no-code/low-code arayüzlerle ajan iş akışları oluşturmayı, orkestrasyonunu ve optimize etmeyi sağlar.
Dağıtım ücretsiz sürümleri ve fiyatlandırma
ücretsiz sürümler; kullanım limitlerine (ör. gözlemler, izler, token'lar veya iş birimleri) göre değişir. Başlangıç fiyatları genellikle özellikler, kullanıcılar veya kullanım limitleri üzerinde kısıtlamalar içerebilen temel bir plan içindir.
CoreWeave Forge (W&B Weave)
Kullanım durumu: Çok ajanlı sistemlerde hataların ajan çağrıları arasında nasıl yayıldığını izleyerek arızaları ayıklama.
W&B Weave, CoreWeave Forge'un bir parçasıdır (eski adıyla Weights & Biases) ve çok ajanlı sistemler için yapılandırılmış yürütme izlerini kaydederek ajan çağrıları arasındaki üst-alt ilişkilerini korur.
Weave izleme özellikleri
- Düz istek günlükleri yerine hiyerarşik ajan izleme
- Maliyet ve gecikme atfı ajan düzeyinde
- Doğrudan izlere uygulanan değerlendirme puanlayıcıları için yerel destek.
Değerlendirme yetenekleri
Weave ayrıca değerlendirme için yerleşik puanlayıcılar sunar; bunlar arasında şunlar yer alır:
- Halüsinasyon tespiti için HallucinationFreeScorer,
- Özet kalitesini değerlendirmek için SummarizationScorer,
- Anlamsal benzerlik için EmbeddingSimilarityScorer,
- Biçim doğrulaması için ValidJSONScorer ve ValidXMLScorer,
- Şema uyumu için PydanticScorer,
- İçerik güvenliği için OpenAIModerationScorer,
- ContextEntityRecallScorer gibi RAGAS puanlayıcıları,
- RAG sistemi değerlendirmesi için ContextRelevancyScorer.
En uygun olduğu durum: Yüzeysel metrikler yerine iz düzeyinde kök neden analizi gerektiren, çok adımlı veya çok ajanlı iş akışları çalıştıran ekipler.
Langfuse
Kullanım durumları: LLM etkileşimlerini izleyin, prompt sürümlerini yönetin ve kullanıcı oturumlarıyla model performansını izleyin.
Langfuse, prompt katmanına derin görünürlük sunar; prompt'ları, yanıtları, maliyetleri ve yürütme izlerini yakalayarak LLM uygulamalarının hata ayıklanmasına, izlenmesine ve optimize edilmesine yardımcı olur.
Ancak Langfuse, kod ve prompt yönetimi için Git tabanlı iş akışlarını tercih eden ekipler için uygun olmayabilir; çünkü harici prompt yönetim sistemi aynı düzeyde sürüm kontrolü ve iş birliği sunmayabilir.
Langfuse izleme özellikleri
- Prompt gelişimi ve kullanım desenlerine görünürlük
- Kullanıcıya dönük uygulamalar için uygun oturum tabanlı analiz
- Filtreleme ve inceleme için pratik metadata ve etiketleme modeli
Kurumsal düzey özellikler:
Bu özelliklerden bazıları şunlardır:
- Günlük düzeyleri: Daha ayrıntılı içgörüler için günlüklerin ayrıntı düzeyini ayarlayın.
- Çok modluluk: Çok modlu LLM uygulamaları için metin, görüntü, ses ve diğer biçimleri destekler.
- Sürümler ve sürümleme: Sürüm geçmişini izleyin ve yeni sürümlerin modelin performansını nasıl etkilediğini görün.
- İz URL'leri: Daha fazla inceleme ve hata ayıklama için benzersiz URL'ler üzerinden ayrıntılı izlere erişin.
- Ajan grafikleri: Ajan davranışını daha iyi anlamak için ajan etkileşimlerini ve bağımlılıklarını görselleştirin.
- Örnekleme: Sistemi aşırı yüklemeden analiz etmek için etkileşimlerden temsili veriler toplayın.
- Token ve maliyet izleme: Her model çağrısı için token kullanımını ve maliyetlerini izleyerek verimli kaynak yönetimi sağlayın.
- Maskeleme: İzlerde maskeleyerek hassas verileri koruyun, gizlilik ve uyumluluk sağlayın.
En uygun olduğu durum: Prompt'lar üzerinde yineleme yapan ve üretimde kullanımı izleyen ekipler; özellikle kullanıcı oturumlarının önemli olduğu durumlar için uygundur.
Galileo
Kullanım durumları: Maliyet/gecikmeyi izleyin, çıktı kalitesini değerlendirin, güvenli olmayan yanıtları engelleyin ve uygulanabilir düzeltmeler sağlayın.
Galileo, gerçek zamanlı güvenlik ve uyumluluk kontrolleri uygularken maliyet, gecikme ve çıktı kalitesi metriklerini izler.
Platform, geleneksel gözlemlenebilirliği (gecikme, maliyet, performans) yapay zeka destekli hata ayıklama ve değerlendirmeyle (halüsinasyon tespiti, olgusal doğruluk, tutarlılık, bağlam uyumu) birleştirir.
Galileo izleme özellikleri
- Yüzeysel hataların ötesinde arıza modu tanımlama (örn. geçersiz araç girdilerine yol açan halüsinasyonlar)
- Önerilen prompt değişiklikleri veya few-shot eklemeleri gibi yol gösterici geri bildirim
- Değerlendirme sonuçları ile önerilen düzeltmeler arasında sıkı bağlantı.
En uygun olduğu durum: Rehberli düzeltmeyle çıktı kalitesine, güvenliğe ve hızlı yineleme döngülerine öncelik veren kuruluşlar.
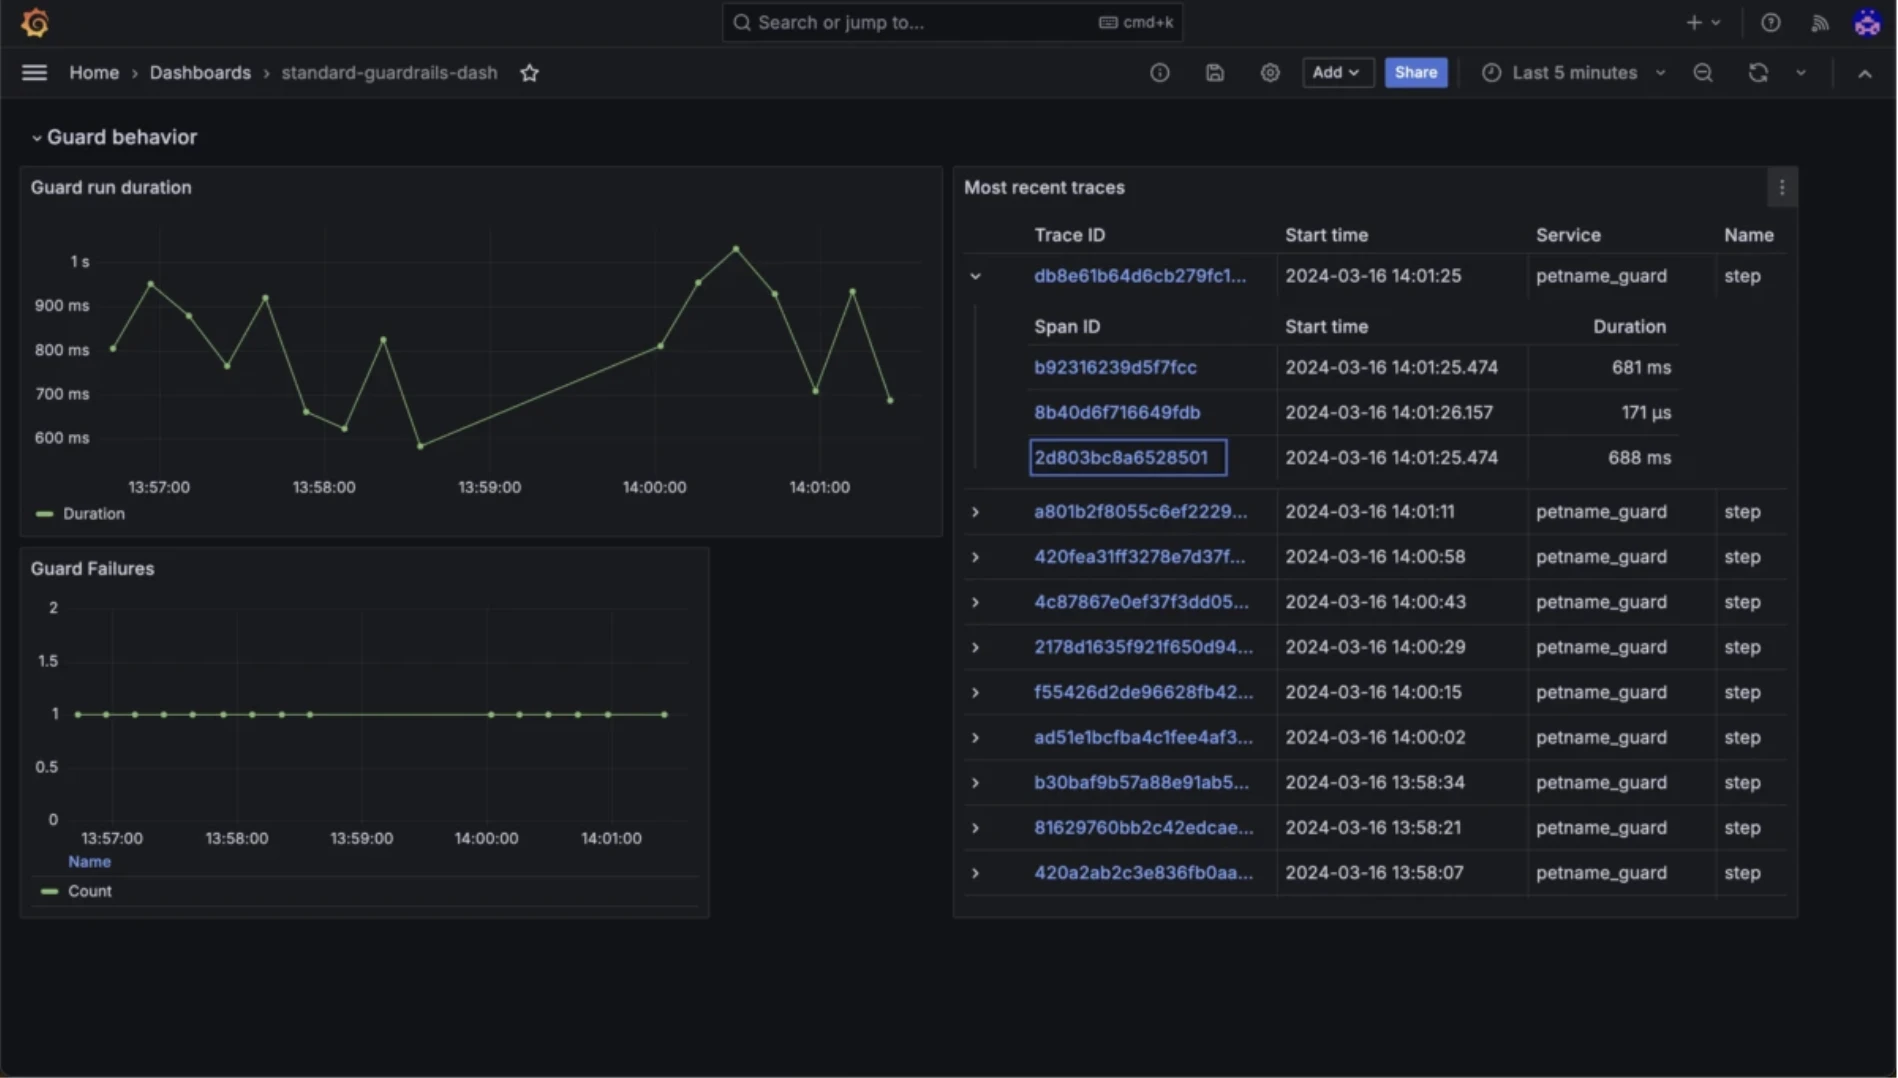
Guardrails AI
Kullanım durumları: Zararlı çıktıları önleyin, LLM yanıtlarını doğrulayın ve güvenlik politikalarıyla uyumu sağlayın.
Guardrails; toksisite, önyargı, PII ifşası, halüsinasyon işaretleme ve biçim uyumu dahil olmak üzere yapılandırılabilir kurallara göre LLM girdilerini ve çıktılarını doğrular.
Guardrails AI izleme özellikleri
- RAIL spesifikasyonlarıyla deterministik doğrulama
- Prompt enjeksiyonu ve jailbreak tespiti için girdi guard'ları
- Doğrulama başarısız olduğunda otomatik yeniden denemeler.
En uygun olduğu durum:
Yanıtlar döndürülmeden önce katı güvenlik, uyumluluk veya biçimlendirme garantilerini zorunlu kılması gereken ekipler.
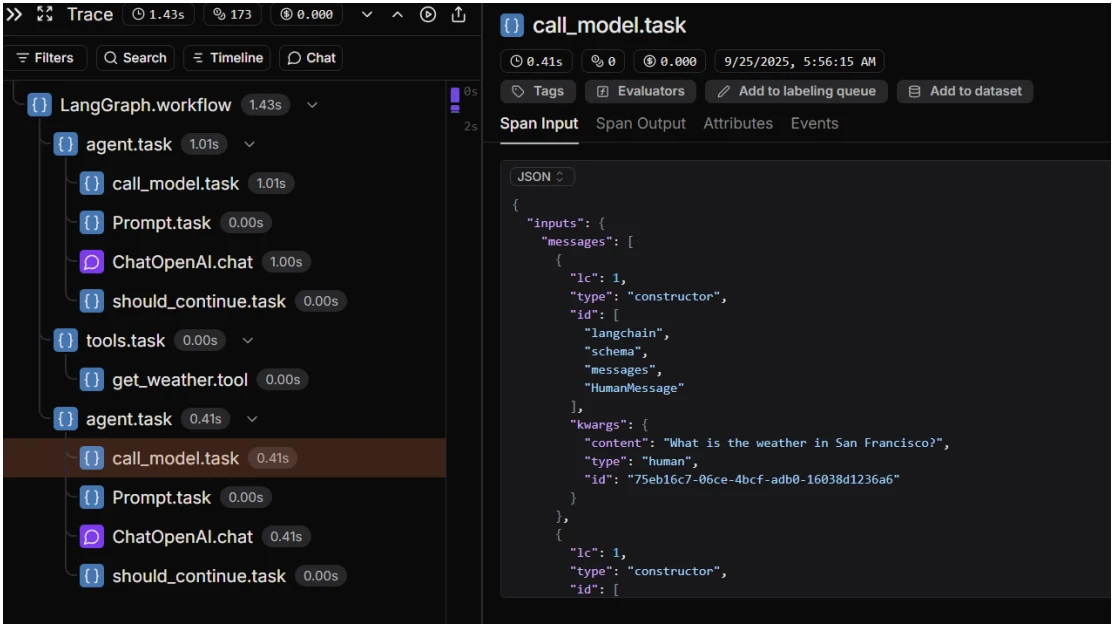
LangSmith
Kullanım durumları: Ajan muhakemesi ve araç çağrısı hata ayıklama (LangChain merkezli)
LangSmith, LangChain tabanlı ajanlar için prompt'lar, getirilen bağlam, araç seçim mantığı, araç girdileri/çıktıları, hatalar ve istisnalar dahil olmak üzere tam muhakeme izlerini yakalar.
LangSmith izleme özellikleri
- Ajan karar yollarının adım adım incelenmesi
- Prompt'lar, modeller veya araçlar arasında çalıştırma tekrarı ve yan yana karşılaştırma
- Callback'ler aracılığıyla LangChain ile sıkı entegrasyon.
En uygun olduğu durum:
LangChain ile geliştirme yapan ve hatalı muhakemeyi veya araç çağrısını ayrıntılı olarak ayıklaması gereken ekipler.
Langtrace AI
Kullanım durumları: LLM uygulamalarında maliyet ve gecikme darboğazlarını belirleme.
Langtrace, OpenTelemetry uyumlu izler kullanarak LLM pipeline'ları genelinde token sayılarını, yürütme süresini, API maliyetlerini ve istek parametrelerini izler.
Langtrace AI izleme özellikleri
- Mevcut arka uçlarla entegrasyon için OpenTelemetry uyumu
- Adım başına maliyet ve gecikme etkenlerine görünürlük
- Hafif prompt sürümleme ve test ortamı.
En uygun olduğu durum: Çıktı kalitesini değerlendirmekten çok LLM iş akışları genelinde performansı ve harcamayı optimize eden ekipler.
Arize (Phoenix)
Kullanım durumları: Kapsamlı puanlama sistemleriyle model sapmasını izleyin, önyargıyı tespit edin ve LLM çıktılarını değerlendirin.
Phoenix; alaka, toksisite ve doğruluk için davranışsal sapma, önyargı tespiti ve LLM-as-a-judge puanlamasına odaklanır.
Ancak hafif proxy'lere kıyasla daha yüksek entegrasyon ek yüküne sahiptir ve prompt sürümlemesini özel araçlar kadar temiz yönetmez.
Phoenix izleme özellikleri
- İsteğe bağlı kurumsal uzantılara sahip açık kaynak çekirdek
- Geliştirme için etkileşimli prompt oyun alanı
- Zamana göre davranışsal değişiklikleri izlemek için sapma tespiti
- Yanıt önyargılarını belirlemek için önyargı kontrolleri,
- Doğruluk, toksisite ve alaka için LLM-as-a-judge puanlaması.
En uygun olduğu durum: Prompt yinelemesinden çok uzun vadeli model davranışını ve regresyon riskini izleyen ekipler.
Agenta
Kullanım durumları: Hangi prompt'un hangi modelde en iyi çalıştığını bulma.
Agenta, paylaşılan girdileri ve kontrollü bağlamı kullanarak model yanıtlarını maliyet, gecikme ve çıktı kalitesi açısından karşılaştırır.
Agenta izleme özellikleri
- Yan yana model değerlendirme
- Üretim öncesi karar desteği.
En uygun olduğu durum: Erken aşama değerlendirme ve model seçimi.
AgentOps.ai
Kullanım durumları: Üretimde ajan muhakemesini izleyin, maliyetleri takip edin ve oturumlarda hata ayıklayın.
AgentOps, dağıtılan ajanlar için muhakeme izlerini, araç/API çağrılarını, oturum durumunu, önbellekleme davranışını ve maliyet metriklerini yakalar.
AgentOps izleme özellikleri
- Üretim hata ayıklaması için oturum yeniden oynatma
- Çevrimdışı değerlendirmeden çok canlı ajan davranışına odaklanma.
En uygun olduğu durum: Üretimde ajan çalıştıran ve operasyonel görünürlüğe ihtiyaç duyan ekipler.
Braintrust
Kullanım durumları: Ayrıntılı değerlendirme ve hata analiziyle hangi prompt'un, dataset'in veya modelin daha iyi performans gösterdiğini bulma.
Braintrust; prompt'ları, dataset'leri ve modelleri beklenen çıktılara göre değerlendirir; gecikme, maliyet, araç hataları ve yürütme metriklerini izler.
Braintrust izleme özellikleri
- Test dataset'lerini girdiler ve beklenen çıktılarla değerlendirin; ardından
{{input}},{{expected}}ve{{metadata}}gibi değişkenleri kullanarak prompt'ları veya modelleri yan yana karşılaştırın. - Araç yürütme kalitesi dahil metrik dökümleri
En uygun olduğu durum: Dağıtımdan önce modelleri ve prompt'ları kıyaslayan ekipler.
AgentNeo
Kullanım durumları: Çok ajanlı etkileşimlerde hata ayıklama, araç kullanımını izleme ve koordinasyon iş akışlarını değerlendirme.
AgentNeo; bir Python SDK aracılığıyla ajan iletişimini, araç kullanımını, yürütme grafiklerini ve ajan başına maliyet ile gecikmeyi izler.
AgentNeo izleme özellikleri
- Açık kaynak ve yerel olarak çalıştırılabilir
- Çok ajanlı iş akışlarının gerçek zamanlı izlenmesi için etkileşimli yerel pano (
localhost:3000). - Decorator'lar kullanarak entegrasyon (örn.
@tracer.trace_agent,@tracer.trace_tool)
En uygun olduğu durum: Çok ajanlı sistemlerle deney yapan mühendislik ekipleri.
 Tercih edilen kaynak olarak ekle
Laminar
Kullanım durumu: Farklı LLM framework'leri ve modelleri genelinde performansı izleyin.
Laminar, LLM framework'leri ve modelleri genelinde yürütme span'lerini, maliyetleri, token kullanımını ve gecikme yüzdeliklerini izler.
Laminar izleme özellikleri
- Framework'ten bağımsız performans analizi
- İnce taneli span incelemesi.
En uygun olduğu durum: Heterojen yığınlar arasında karşılaştırmalı performans analizi.
Helicone
Kullanım durumları: Çok adımlı ajan iş akışlarını izleyin ve kullanıcı oturum desenlerini analiz edin.
Helicone; istek hacimlerini, maliyetleri, hataları, gecikme eğilimlerini ve oturum düzeyinde ajan iş akışlarını yakalar.
Helicone izleme özellikleri
- Kullanıcı yolculuğu görünürlüğü
- Geçmişe dönük eğilim analizi.
En uygun olduğu durum: Kullanım desenlerini ve kullanıcı düzeyindeki davranışı izleyen ürün ekipleri.
Coval
Kullanım durumları: Binlerce ajan konuşmasını simüle edin, ses/sohbet etkileşimlerini test edin ve dağıtımdan önce davranışı doğrulayın.
Coval; görev tamamlamayı, doğruluğu ve araç çağrısı etkinliğini ölçmek için binlerce konuşmayı simüle eder.
Coval izleme özellikleri
- Simülasyon tabanlı ajan testi
- Otomatik regresyon tespiti
- Ses ve metin ajanı desteği.
En uygun olduğu durum: Dağıtım öncesi doğrulama ve regresyon tespiti.
Datadog
Kullanım durumları: LLM sinyal korelasyonuyla altyapı ve uygulama gözlemlenebilirliği.
Datadog; altyapı metrikleri (CPU, bellek, ağ), uygulama performans verileri (gecikme, hata oranları, verim) ve günlükleri toplar. LLM uygulamaları için token kullanımını, istek başına maliyeti, model gecikmesini ve prompt enjeksiyonu girişimleri gibi güvenlikle ilgili sinyalleri alabilir.
Datadog izleme özellikleri
- Altyapı, uygulamalar ve yapay zeka iş yükleri genelinde geniş, sistem çapında gözlemlenebilirlik
- Yapay zeka davranışı ile altyapı sağlığı arasında korelasyon sağlayan geniş entegrasyon ekosistemi (900+ entegrasyon)
En uygun olduğu durum: Ajan muhakemesini veya prompt'u incelemekten çok LLM davranışını temel altyapı ve uygulama performansıyla ilişkilendirmek isteyen kuruluşlar.
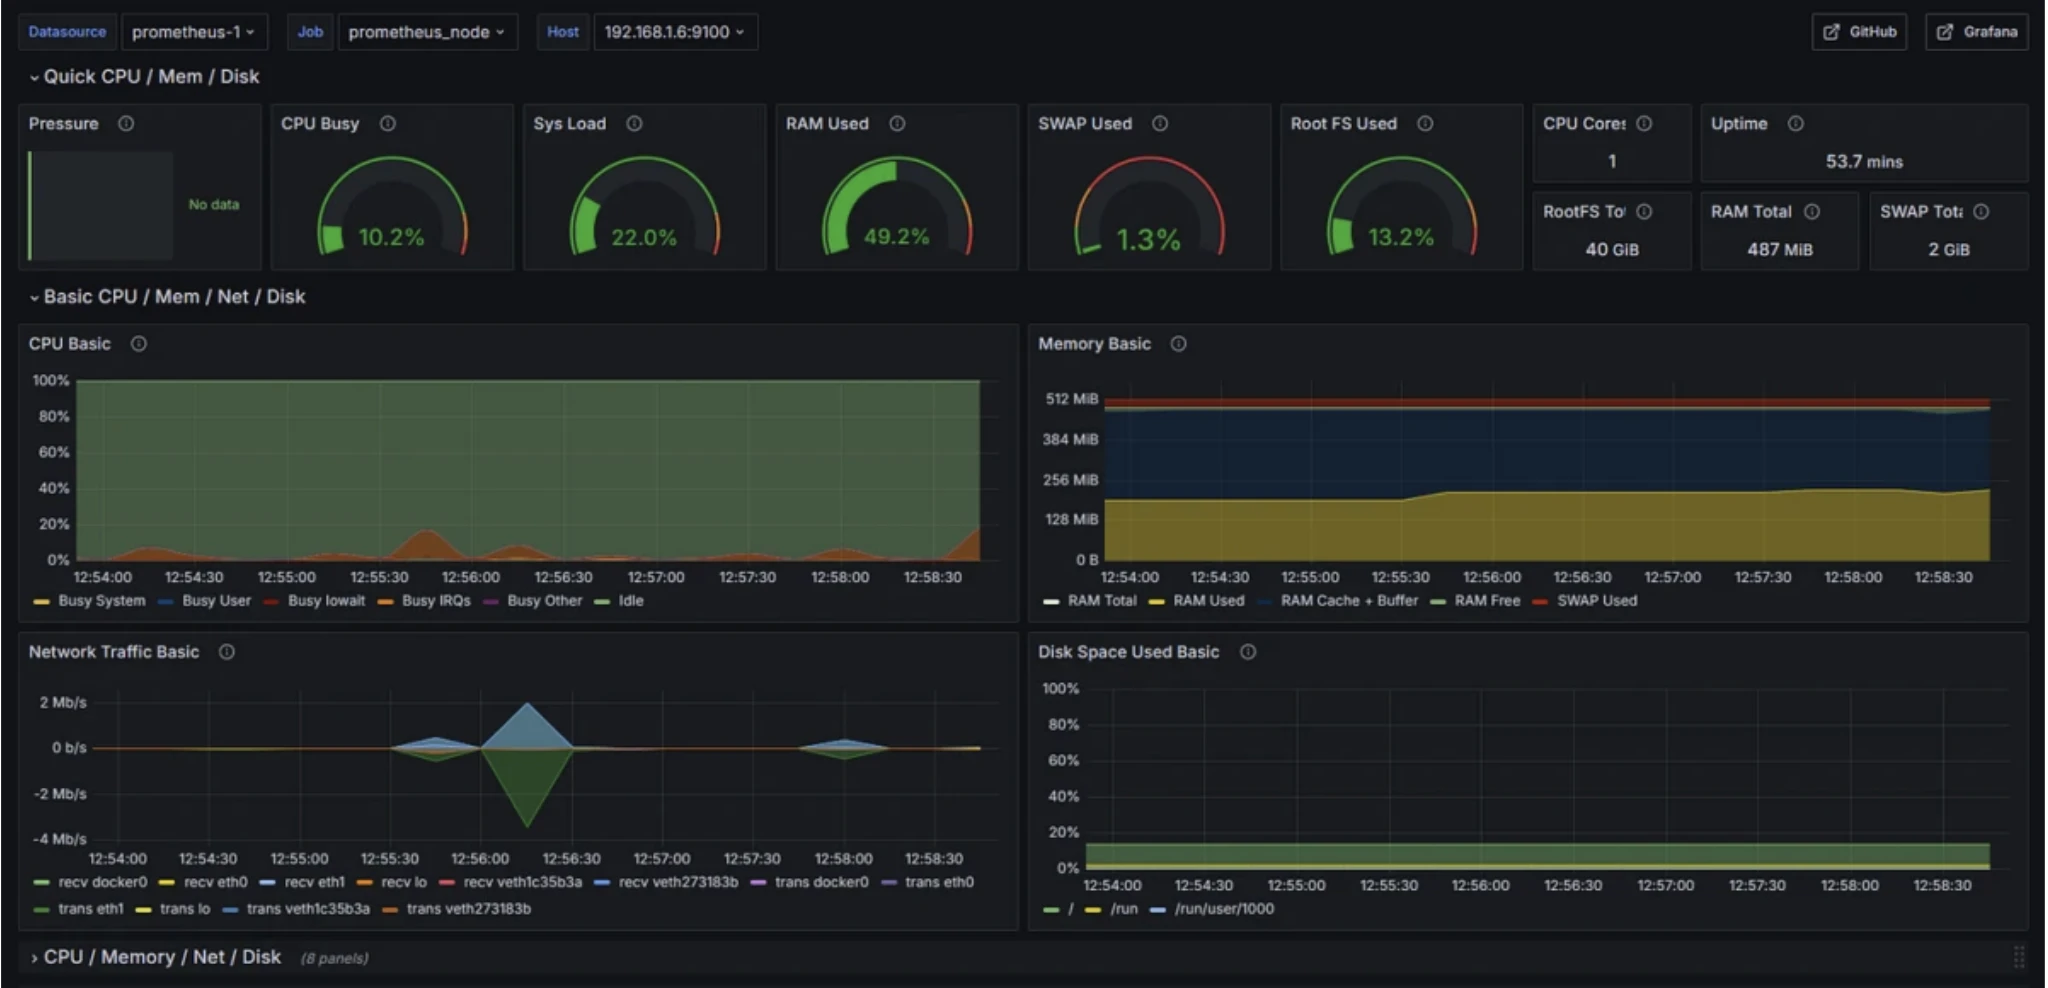
Prometheus
Kullanım durumları: Sistem performansını izleyin, uygulama metriklerini takip edin ve altyapı sorunları için uyarı kurulumu yapın.
Prometheus; altyapı, uygulama, veritabanı, konteyner ve özel iş metriklerini izlemek için düzenli aralıklarla HTTP endpoint'lerinden zaman serisi metriklerini toplayan açık kaynaklı bir izleme sistemidir.
Prometheus izleme özellikleri
- Çekme tabanlı kazıma yoluyla zaman serisi metrik toplama
- Sorgulama, toplama ve uyarı koşulları için PromQL
- Geniş sistem kapsamı için exporter ekosistemi (örn. Node Exporter)
En uygun olduğu durum: Kural tabanlı uyarı ile altyapı ve uygulama izleme.
Grafana
Kullanım durumları: LLM, ajan ve altyapı verileri genelinde metrikleri görselleştirin, panolar oluşturun ve uyarıları yönlendirin.
Grafana; birleşik gözlemlenebilirlik panoları sağlamak için Prometheus, OpenTelemetry ve Datadog gibi veri kaynaklarıyla entegre olan açık kaynaklı bir görselleştirme ve analitik platformudur.
Grafana izleme özellikleri
- Metrikler, günlükler ve izler genelinde panolar
- LLM, ajan ve altyapı sinyalleri için sistemler arası korelasyon
- Uyarı yönlendirme ve bildirim yönetimi.
En uygun olduğu durum: Merkezi gözlemlenebilirlik görselleştirme ve olay müdahalesi.
Eğitim: LangChain gözlemlenebilirliği Langfuse ile
Üç aşamalı çok adımlı bir LangChain pipeline'ı kurduk:
- soru analizi
- yanıt üretimi
- yanıt doğrulama
Pipeline'ı kurduktan sonra yürütmeyi gerçek zamanlı olarak izlemek ve takip etmek için onu Langfuse'a bağladık. Bunu yaparak Langfuse'un yapay zeka uygulama performansı, maliyetleri ve davranışı hakkında ayrıntılı içgörüler toplamamıza nasıl yardımcı olduğunu keşfedebildik.
Langfuse aracılığıyla gözlemlediklerimiz şunlardır:
Pano genel bakışı
Langfuse bize pipeline performansının farklı yönlerine görünürlük sağlayan birkaç pano sundu:
- Maliyet Panosu: Tüm API çağrılarındaki harcamayı model ve zaman dilimi başına ayrıntılı dökümlerle izler.
- Kullanım Yönetimi: Gözlem sayıları ve kaynak tahsisi gibi yürütme metriklerini izler; kaynakların yürütme sırasında nasıl kullanıldığını takip etmemize yardımcı olur.
- Gecikme Panosu: Bu pano yanıt sürelerini analiz etmemize, darboğazları tespit etmemize ve performans eğilimlerini görselleştirmemize yardımcı oldu.
Kullanım metrikleri
Kullanım metrikleri panosu bize sistemin nasıl performans gösterdiğine dair şu içgörüleri verdi:
- Toplam iz sayısı: Her biri pipeline'daki tam bir soru-yanıt döngüsünü temsil eden sekiz iz izledik.
- Toplam gözlem sayısı: Ortalama olarak her iz 16 gözleme sahipti; bu da sürecin çok adımlı doğasını yansıtıyor.
Buna ek olarak Langfuse, son 7 gündeki kullanım desenlerini, kaynak tahsisini ve zirve zamanlarını izlememizi sağlar; sistemin en yoğun ne zaman olduğunu ve kaynakların zamana nasıl dağıldığını anlamamıza yardımcı olur.
İz incelemesi
Tek bir izin ayrıntısına indiğimizde ayrıntılı yürütme bilgilerini görebildik:
- İz satırları: Her satır, benzersiz iz kimliğine sahip bir tam pipeline yürütmesini temsil eder.
- Gecikme metrikleri: Yürütme süresi 0.00s ile 34.08s arasında değişiyordu.
- Token sayıları: Pano, maliyet ve verimlilik yönetimine yardımcı olan girdi/çıktı token kullanımını izledi.
- Ortam filtreleme: İzleri dağıtım ortamlarına (örn. geliştirme, üretim) göre filtreleyebildik.
Bireysel iz ayrıntıları
Yürütme dökümünü anlamak için izi daha ayrıntılı olarak inceledik:
- Sıralı zincir mimarisi: İz, hiyerarşik yapıyla SequentialChain → LLMChain → ChatOpenAI ile başlayan her adımı gösteren görsel bir akış sergiledi.
- Girdi/çıktı izleme: “Yapay zeka ajanı gözlemlenebilirliği için Langfuse kullanmanın faydaları nelerdir?” sorusu her aşamada, yapay zekanın her adımda ürettiği ilgili çıktılarla birlikte izlendi.
- Token analizi: Girdi için 1.203 token, çıktı için 1.516 token kullanıldığını gözlemledik; bu da token kullanımıyla ilgili maliyet etkileri doğurur ve kaynak yönetiminin optimize edilmesine yardımcı olur.
- Zamanlama verileri: Tam iz için toplam gecikme 34.08s idi ve bileşenlere şu şekilde dağılmıştı:
- SequentialChain → 14.02s
- LLMChain → 10.25s
- ChatOpenAI → 9.81s
- Model bilgisi: Langfuse, sıcaklık yapılandırması dahil belirli ayarların ayrıntılarıyla birlikte Anthropic Claude-Sonnet-4 modelinin kullanıldığını doğruladı.
- Biçimlendirilmiş çıktı: Hata ayıklama için hem Önizleme hem de JSON görünümleri sağlandı; bu da modelin yanıtına insan tarafından okunabilir biçimde ve makine tarafından okunabilir formatta içgörüler sundu.
Otomatik analiz
Langfuse ayrıca yanıtlarımızın otomatik değerlendirmelerini sağladı:
- Kalite değerlendirmesi: Sistem, yanıtların yapısını, tutarlılığını ve eksiksizliğini değerlendirdi; iyi organize edilmiş bölümleri vurguladı ancak yanıtların daha öz olabileceğini önerdi.
- İyileştirme önerileri: Gereksiz tekrar içeren bölümleri belirledi, ifadelerin nerede iyileştirilebileceğini önerdi ve yanıtı daha anlaşılır ve daha verimli hale getirmek için ilgili noktaları birleştirdi.
- Performans içgörüleri: Sistem token kullanımı ve yanıt alakası hakkında geri bildirim verdi; çıktının yararlı ve konuyla ilgili kalmasını sağlarken verimliliği optimize etmemize yardımcı oldu.
- Yapılandırılmış geri bildirim: Geri bildirim kategorilere ayrıldı; böylece belirli iyileştirme alanlarını hedefli bir şekilde ele alabildik.
Kullanıcı analitiği
Langfuse, kullanıcılar ile yapay zeka ajanı arasındaki ayrıntılı etkileşimleri izler:
- Kullanıcı etkinlik zaman çizelgesi: Her kullanıcı için ilk ve son etkileşimi gösterir; aktif ve hareketsiz kullanıcıları ayırt etmeye yardımcı olur. Kullanıcıların sistemle ilk ve son kez ne zaman etkileşime geçtiğini görebiliriz.
- Olay hacmi izleme: Her kullanıcının tetiklediği olay sayısını izler. Örneğin bazı kullanıcılar 2.000 olaydan fazlasını üretti; bu da sistemle etkileşim düzeylerini gösterir.
- Token tüketim analizi: Her kullanıcının tükettiği toplam token sayısını izler. Token kullanımı 6.59K ile 357K token arasında değişti; bu da kaynak kullanımına dair içgörüler sağlar.
- Maliyet atfı: Her kullanıcıyla ilişkili maliyetleri dökümlendirir; harcamayı izlemeyi ve kaynak kullanımı için bütçe tahsisini optimize etmeyi kolaylaştırır.
- Kullanıcı tanımlama: Bireysel kullanıcı etkileşimlerini izlerken gizliliği korumak için anonimleştirilmiş kullanıcı kimlikleri kullanır; kullanıcı gizliliğinden ödün vermeden kullanım analizine yardımcı olur.
Oturum görünümü, kullanıcı etkileşimlerinin ayrıntılı detaylarını izlememize olanak tanır:
- Eksiksiz konuşma akışı: Tüm soru-yanıt etkileşimini gösterir; konuşmanın tamamını baştan sona takip etmeyi kolaylaştırır.
- Uygulama görünürlüğü: Oturum sırasında kullanılan gerçek Python kodunu görüntüler; teknik uygulamaya dair içgörü sağlar.
- Girdi/çıktı korelasyonu: Kullanıcı sorularını ilgili sistem yanıtlarıyla ilişkilendirir; konuşmada sorunların nerede ortaya çıkmış olabileceğini gidermemize ve belirlememize yardımcı olur.
- Oturum metadata'sı: Zamanlama, kullanıcı bağlamı ve belirli uygulama verileri gibi teknik ayrıntıları içerir; oturumun yürütülmesine dair kapsamlı bir görünüm sunar.
Gözlemlenebilirlik araçları ne zaman kullanılmamalı
- Erken aşama geliştirme: Hâlâ ürün-pazar uyumunu doğruluyorsanız veya ilk ajan iş akışlarınızı oluşturuyorsanız, odak kapsamlı gözlemlenebilirlikten çok temel işlevsellik üzerinde olmalıdır.
- API darboğazları: Birincil sorunlarınız API maliyetleri, gecikme veya önbellekleme ise acil öncelik, sistem düzeyindeki metrikleri izlemek değil bu alanları optimize etmek olmalıdır.
- Model optimizasyonu: İyileştirmeler esas olarak model seçimi, fine-tuning veya prompt mühendisliği tarafından yönlendiriliyorsa sapma ve önyargı için gözlemlenebilirlik araçları henüz gerekli olmayabilir.
Gözlemlenebilirlik araçları ne zaman kullanılmalı
- Ölçekte üretim: Birden fazla model, ajan veya zincir üzerinde çalışıyorsanız gözlemlenebilirlik araçları performansı izlemek ve sistem sağlığını sağlamak için gereklidir.
- Kurumsal veya müşteriye dönük uygulamalar: Güvenilirlik, güvenlik ve uyumluluğun tartışılmaz olduğu uygulamalar için gözlemlenebilirlik araçları gerekli görünürlüğü ve kontrolü sağlar.
- Sürekli izleme: Temel scriptler veya manuel kontrollerle kolayca yakalanamayan sapma, önyargı, performans ve güvenlik sorunlarını zaman içinde izlemeniz gerektiğinde gözlemlenebilirlik araçları kritik öneme sahiptir.
- Yüksek riskli senaryolar: Başarısızlık maliyetinin (örn. halüsinasyonlar, güvenli olmayan çıktılar) önemli olduğu ortamlarda gözlemlenebilirlik risklerin en aza indirilmesini ve sorunların erken tespit edilmesini sağlar.
Kıyaslama metodolojisi
Üretim LLM uygulamalarındaki gözlemlenebilirlik platformlarının performans ek yükünü değerlendirmek için gerçek dünyaya ait ajanik bir iş akışı kullanan sistematik bir kıyaslama yaklaşımı geliştirdik.
Test uygulaması
LangChain kullanarak doğal dildeki seyahat taleplerini beş aşamada işleyen sıralı çok ajanlı bir seyahat planlama sistemi kurduk:
- Parser ajanı: Kullanıcı girdisinden yapılandırılmış verileri (kalkış noktası, varış noktası, tarihler, süre) çıkarır
- Uçuş bulucu ajanı: Amadeus API aracılığıyla mevcut uçuşları getirir
- Hava durumu raporlayıcı ajanı: WeatherAPI kullanarak varış noktası hava tahminlerini getirir
- Aktivite önerici ajanı: Hava koşullarına göre aktiviteler önerir
- Seyahat planlayıcı ajanı: Tüm çıktıları kapsamlı bir seyahat programına dönüştürür
Sistem, tüm LLM çağrıları için OpenRouter üzerinden Claude 4 Haiku kullanır ve gerçek zamanlı veriler için harici API'leri entegre eder.
Kıyaslama tasarımı
Taban çizgisi oluşturma: Öncelikle herhangi bir gözlemlenebilirlik enstrümantasyonu olmadan uygulamanın performansını ölçtük; karşılaştırma için bir taban çizgisi oluşturmak amacıyla 100 özdeş sorgu çalıştırdık.
Platform entegrasyonu: Ardından beş önde gelen gözlemlenebilirlik platformunu (LangSmith, Laminar, AgentOps, Langfuse) tutarlılık için tüm platformlarda aynı izleme noktalarını enstrümante ederek teker entegre ettik.
Sıralı yürütme: Her platform, bir sonraki platforma geçmeden önce 100 sorgunun tamamı art arda çalıştırılarak bağımsız olarak test edildi. Bu yaklaşım, ağ koşulları veya API hız limitleri gibi dış faktörlerden kaynaklanan değişkenliği en aza indirir.
Kontrollü Ortam: Adil bir karşılaştırma sağlamak için tüm testler aynı sunucu altyapısında, özdeş sorgu setleriyle gerçekleştirildi. LLM kaynaklı gecikme varyasyonlarından ek yükü izole etmek için modeli temperature=0 olarak yapılandırdık ve çalıştırmalar arasındaki yanıt varyasyonunu en aza indirmek için yapılandırılmış prompt'lar kullandık.
Toplanan metrikler
Her platform için ortalama gecikmeyi ölçtük ve taban çizgisine kıyasla getirilen ek gecikme olarak ek yükü hesapladık: ((Platform Latency - Base Latency) / Base Latency) × 100
SSS'ler
Gözlemlenebilirlik; loglar, metrikler ve izler gibi harici sinyalleri inceleyerek bir yapay zeka ajanının iç işleyişini anlama yeteneğidir.
Yapay zeka ajanları için bu; sorunları gidermek ve performansı artırmak amacıyla eylemlerin, araç kullanımının, model etkileşimlerinin ve yanıtların izlenmesini içerir.
Ajan gözlemlenebilirliği, şunları sağlayarak yapay zeka performansını izlemek ve iyileştirmek için çok önemlidir:
Dengeleri anlama: Doğruluk ve maliyet gibi temel metrikleri ölçmeye yardımcı olur; performans ile kaynak kullanımı arasında denge kurmayı kolaylaştırır.
Gecikmeyi ölçme: Gerçek zamanlı gecikme izleme, yanıt sürelerine dair içgörüler sunar ve ajan performansının optimize edilmesine yardımcı olur.
Kötü niyetli girdileri tespit etme: Gözlemlenebilirlik; zararlı dilin ve prompt enjeksiyonlarının belirlenmesine yardımcı olur, sorunları önlemek için hızlı müdahaleye olanak tanır.
Kullanıcı geri bildirimi izleme: Gözlemlenebilirlik, kullanıcı etkileşimlerini ve geri bildirimlerini gözlemleyerek ajanların sürekli iyileştirilmesi ve fine-tuning'i için değerli veriler sağlar.
Temel bileşenler şunlardır:
– Eylemleri izleme: Ajanın attığı her adımı izleme.
– Araç kullanımı: Ajanın kullandığı araçları ve kaynakları gözlemleme.
– Gecikme ölçümü: Performansı optimize etmek için yanıt sürelerini izleme.
– Değerlendirmeler: Ajan davranışını ve model performansını değerlendirme.
– Kötü niyetli girdi tespiti: Zararlı prompt'ları veya saldırıları belirleme.
Bu benchmarkı kaynak gösterin
Yayınlayacağınız yere uygun formatı seçin. Bağlantılı sürümü CMS'inize yapıştırmak, geri bağlantıyı korur.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Şipi, Nazlı},
  title  = {{15 Yapay Zeka Ajanı Gözlemlenebilirlik Araçları: AgentOps & Langfuse}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/agentic-monitoring}},
  note   = {AIMultiple. Erişim tarihi: 3 Haziran 2026}
}39 veri noktasının sonuçları ve zaman damgaları. Bu makaledeki grafik ve tablolarda gösterilen özet verileri, 6 CSV dosyası içeren ZIP dosyası olarak indirin.
Arkasındaki ayrıntılı veriyi ister misiniz? Premium'a katılın
Değişiklik günlüğü
8 güncellemeYeni açıklamalar ve örneklerle "Performans farklılıklarının olası nedenleri" bölümü güncellendi.
Performans farklılıklarının olası nedenleriyle 'AI ajan gözlemlenebilirlik platformları' bölümü genişletildi.





















Yorum yapan ilk kişi olun
E-posta adresiniz yayınlanmayacak. Tüm alanlar gereklidir. Yorumlar orijinal dilinde bırakılır.