


Yapay Zekâ Derin Araştırma: Codex vs Claude vs Grok vs Exa
Bir derin araştırma aracı, bir soruyu bağlantı sayfası yerine yazılı bir raporla yanıtlar. Aynı 20 iş araştırması brifi üzerinde beş üretim yöntemi çalıştırdık ve derin araştırma için en iyi aracı bulmak amacıyla her raporu çalıştırmalardan önce yazılmış kurallara göre puanladık. Beş aracın dördü kodlama ajanıdır; yazılım işleri için üretilmiş, aynı zamanda web'de arama yapıp okuyabilen komut satırı araçlarıdır; beşincisi olan Exa Agent ise araştırma için üretilmiştir.
DR-20 Bench sonuçları
Beş aracın her biri, 20 görevin her biri için birer rapor üretti; toplamda 100 rapor, çalıştırmalardan önce yazılmış kurallara göre kör olarak puanlandı. Daha fazla ayrıntı için metodolojiye bakın.
Amaca yönelik üretilmiş tek derin araştırma ürünü, dört kodlama ajanının üçünün gerisinde kaldı. Exa Agent 0.584 puan aldı ve bu üç farkın her biri, on ikili karşılaştırmanın tamamında Holm düzeltmesinden sonra da varlığını korudu. Bu briflerde Codex CLI, Claude Code ve Grok CLI, iş için üretilmiş ürünün üzerinde puan aldı.
Exa Agent ile Gemini CLI, gereksinim puanlarında istatistiksel olarak anlamlı bir fark göstermedi.
Bu 20 görevde Codex CLI ile Claude Code arasında istatistiksel olarak anlamlı bir fark bulmadık. Fark, 0 ile 1 ölçeğinde 0.015 olup düzeltilmemiş p değeri 0.67 ve Holm düzeltmesinden sonra 0.96 idir. 10.000 bootstrap örneği boyunca her ikisinin de %95 sıralama aralığı 1 ile 2 arasındaydı. Farklı ölçütlerde öne çıkıyorlar: Codex CLI yazılı gereksinimlerde 0.015, Claude Code ise olgu yeniden üretiminde 1.2 yüzde puanı farkla önde.
Birebir yeniden üretilen olgular
Claude Code, gerekli 434 olgu öğesinin 202'sini tam olarak yeniden üretti; Codex CLI 198 ve Exa Agent 89. Hiçbir araç yarıya ulaşamadı. Bir öğe, yalnızca rapor gerekli tüm ayrıntıları doğru şekilde içerdiğinde kredi aldı. Bu kontrol önceden tanımlanmış bir olgu listesini kapsıyordu; raporlardaki her iddiayı denetlemedik.
Maliyet & araştırma kalitesi
Grok CLI, görev başına $1,91 maliyetle 0.699 puan aldı; iki lider ise $13,38 ile $18,35 arasında, yani yedi ila on katı maliyete sahipti. Grok, Claude Code'un 0.076 puan gerisinde kaldı ve Holm düzeltmeli p değeri 0.006 oldu. Codex CLI ile arasındaki 0.091 puanlık fark düzeltmeden sonra 0.072 ile anlamlı değildi.
İki daha ucuz araç da en düşük puanı aldı. Gemini CLI, görev başına $0,58 maliyetle 0.565 puan aldı; Exa Agent $1,00 maliyetle 0.584 puan aldı; bu farkın Holm düzeltmeli p değeri 0.958 oldu.
Codex CLI, Claude Code ve Grok CLI burada aboneliklerle çalıştı; rakamları API liste eşdeğerleridir. Bu aboneliklerin ve API ücretlerinin ne kadara mal olduğu için LLM fiyatlandırmasına bakın. Exa, API kullanımı olarak faturalandırıldı ve $20,00 onun gerçek harcamasıdır. Gemini'nin görev başına $0,58 maliyeti yalnızca token'ları kapsar ve arama zeminlemesini hariç tutar; faturalandırılabilir sorgu sayısı yakalanmamıştır.
Görev süresi & araştırma kalitesi
İki lider aynı zamanda en yavaş ikisidir. Codex CLI'nin medyan görevi 0.790 puan için 42 dakika, Claude Code'un medyan görevi ise 0.775 puan için 36 dakika sürdü; buna karşılık Grok CLI 0.699 puanda 13 dakika sürdü. Çalışma süresi diğerlerini sıralamıyor. Gemini CLI, Exa Agent'tan 1.5 dakika daha uzun sürdü ve 0.019 daha düşük puan aldı.
Rapor uzunluğu & yapılan iş
Daha uzun olmanın daha iyi olduğuna en açık karşı örnek tablonun en üstünde yer alıyor. Medyan raporda Claude Code, karşılanan gereksinim başına 271 kelime harcarken Codex CLI 137 kelime harcıyor ve ikisi birbirinden 0.015 puan farkla puan alıyor. Exa Agent, 0.584 puan için gereksinim başına 91 kelimeyle en ekonomik olanıdır.
Kapsam genişliği ile kaynak kalitesi birbirinden ayrışıyor. Medyan Claude Code raporu, Codex CLI'nin 16 farklı web sitesine karşılık 28 farklı web sitesine atıf yapıyor; buna karşın Codex CLI'nin atıflarının daha yüksek bir payı resmi ve birincil sayfalara işaret ediyor: %34,8'e karşı %25,8. Gemini CLI, 1.000 kelime başına 4.2 bağlantıyla en düşük yoğunlukta atıf yapıyor.
Bazı atıf yapılan bağlantılar kırıktı. 404 veya 410 hatası döndüren ya da geçersiz biçime sahip URL'leri saydık. Araç başına 20 rapor üzerindeki toplamlar şöyleydi:
- Gemini CLI: 63
- Claude Code: 26
- Grok CLI: 16
- Codex CLI: 14
- Exa Agent: 14
Yapay zekâ derin araştırma araçlarındaki gelişmeler
Deep Research, Gemini API'ye ulaştı
Google, Deep Research'i, geliştiricilerin doğrudan çağırdığı bir ajan olarak Gemini API'ye ekledi; bu, Gemini uygulamasında halihazırda bulunan özelliğin yanında yer alıyor.1 Hız için deep-research-preview-04-2026 ve kapsamlılık için deep-research-max-preview-04-2026 olmak üzere iki sürümde sunuluyor.
Google, bunu temel model'ler ve araçlar üzerinden kullandıkça öde esasına göre fiyatlandırıyor ve standart sürüm için tipik bir görevin $1 ila $3, Max için ise $3 ila $7 tutacağını tahmin ediyor. Bir görev arka planda çalışıyor ve 60 dakikayla sınırlandırılıyor; çoğu görev 20 dakika içinde tamamlanıyor.
Exa akademik yayınları dizinledi
Exa, 23 Temmuz 2026'da akademik makaleler üzerinde semantik aramayı başlattı; yaklaşık 350 milyon yayını ve 30 milyon yazarı kapsıyor.2 Amaç, kesin bir başlık yerine bulanık bir anıdan makale bulmaktır.
Exa, kendi retrieval benchmark'ında %86,4 recall bildiriyor; Perplexity için %66,8 ve Google Scholar için %28,0. Bunlar satıcının kendi benchmark'ındaki kendi rakamlarıdır; bu nedenle kesinleşmiş bir sıralama olarak değil, bir yön olarak değerlendirin; aynı yazı iki farklı ortalama gecikme aktarıyor, bu da bağımsız bir kontrolü beklemek için bir nedendir.
Bright Data Deep Lookup farklı bir soruyu yanıtlıyor
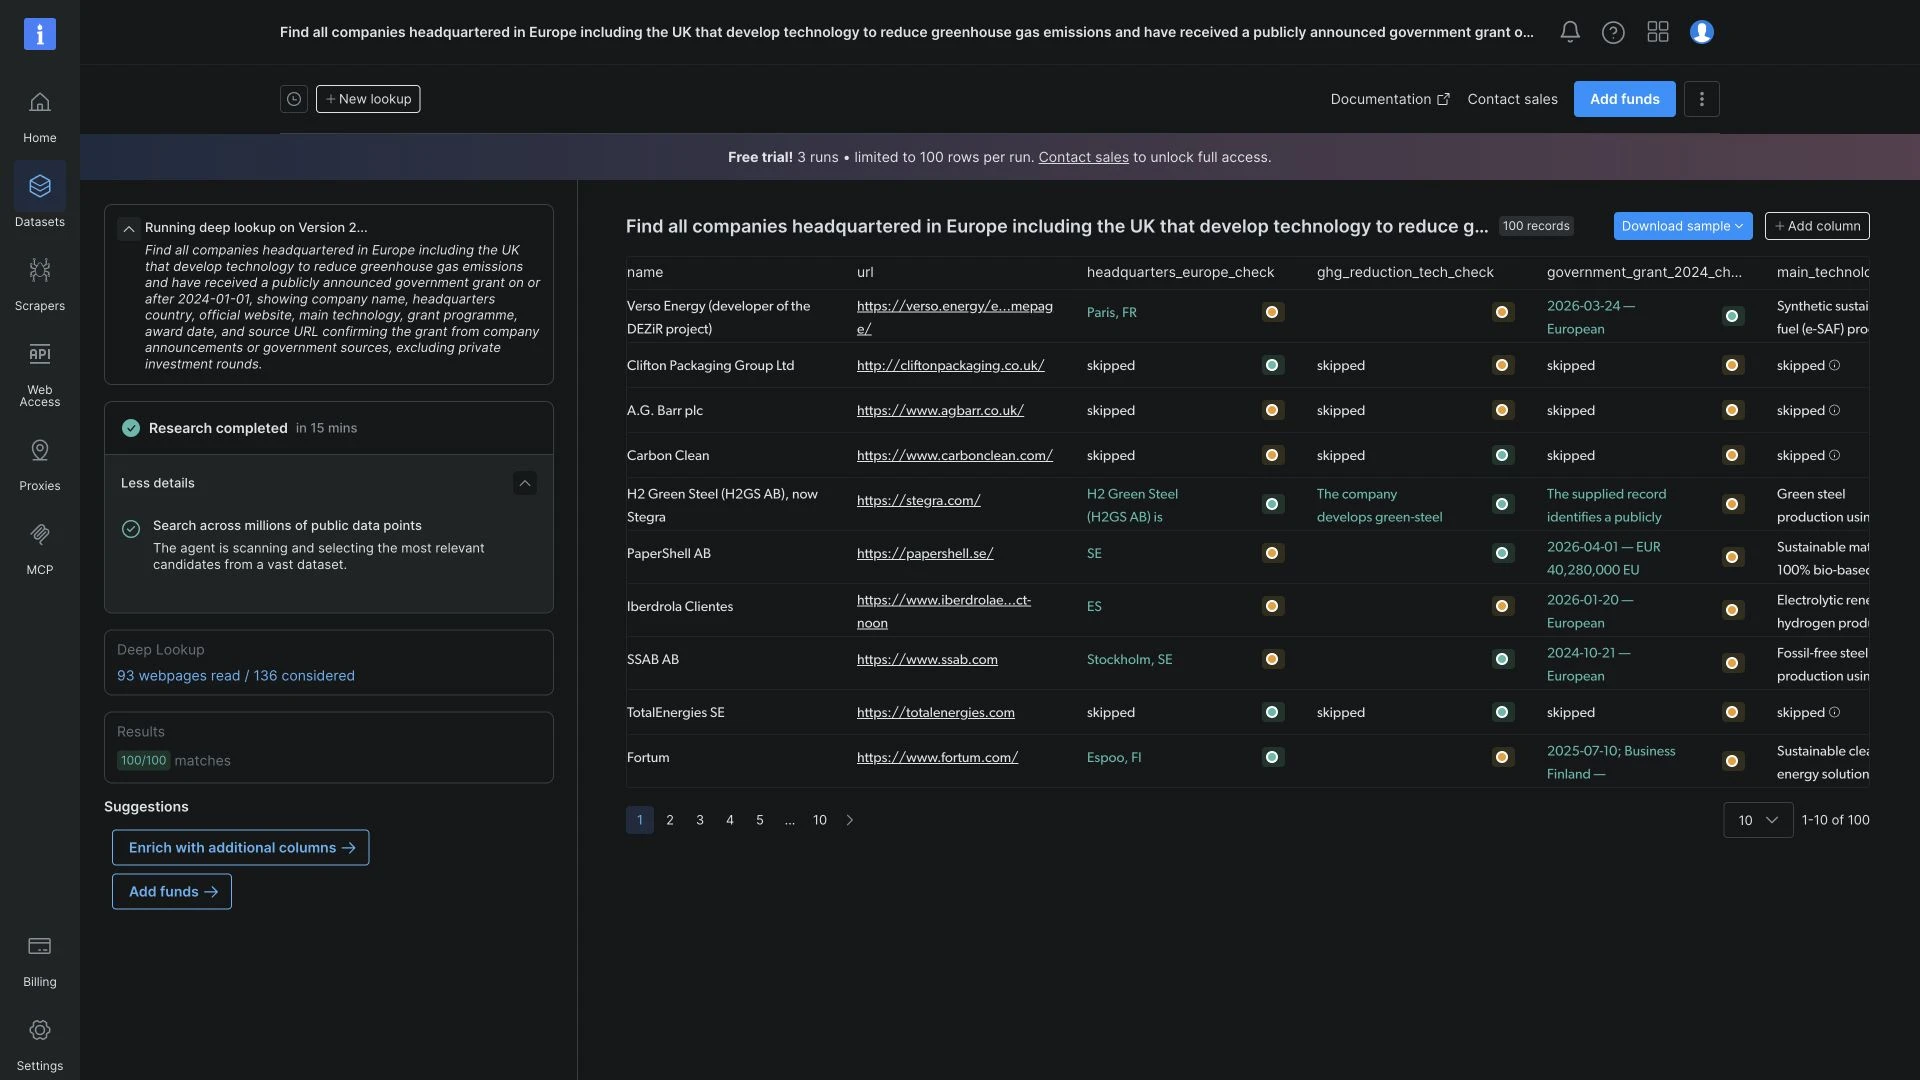
Bright Data'nın Deep Lookup'ı, yazılı bir araştırma raporu değil varlık satırları döndürür. Her satır bir şirketi, kişiyi veya ürünü temsil eder. Kullanıcılar satış araştırması, yatırım araştırması veya işe alım için listeler oluşturabilir.3
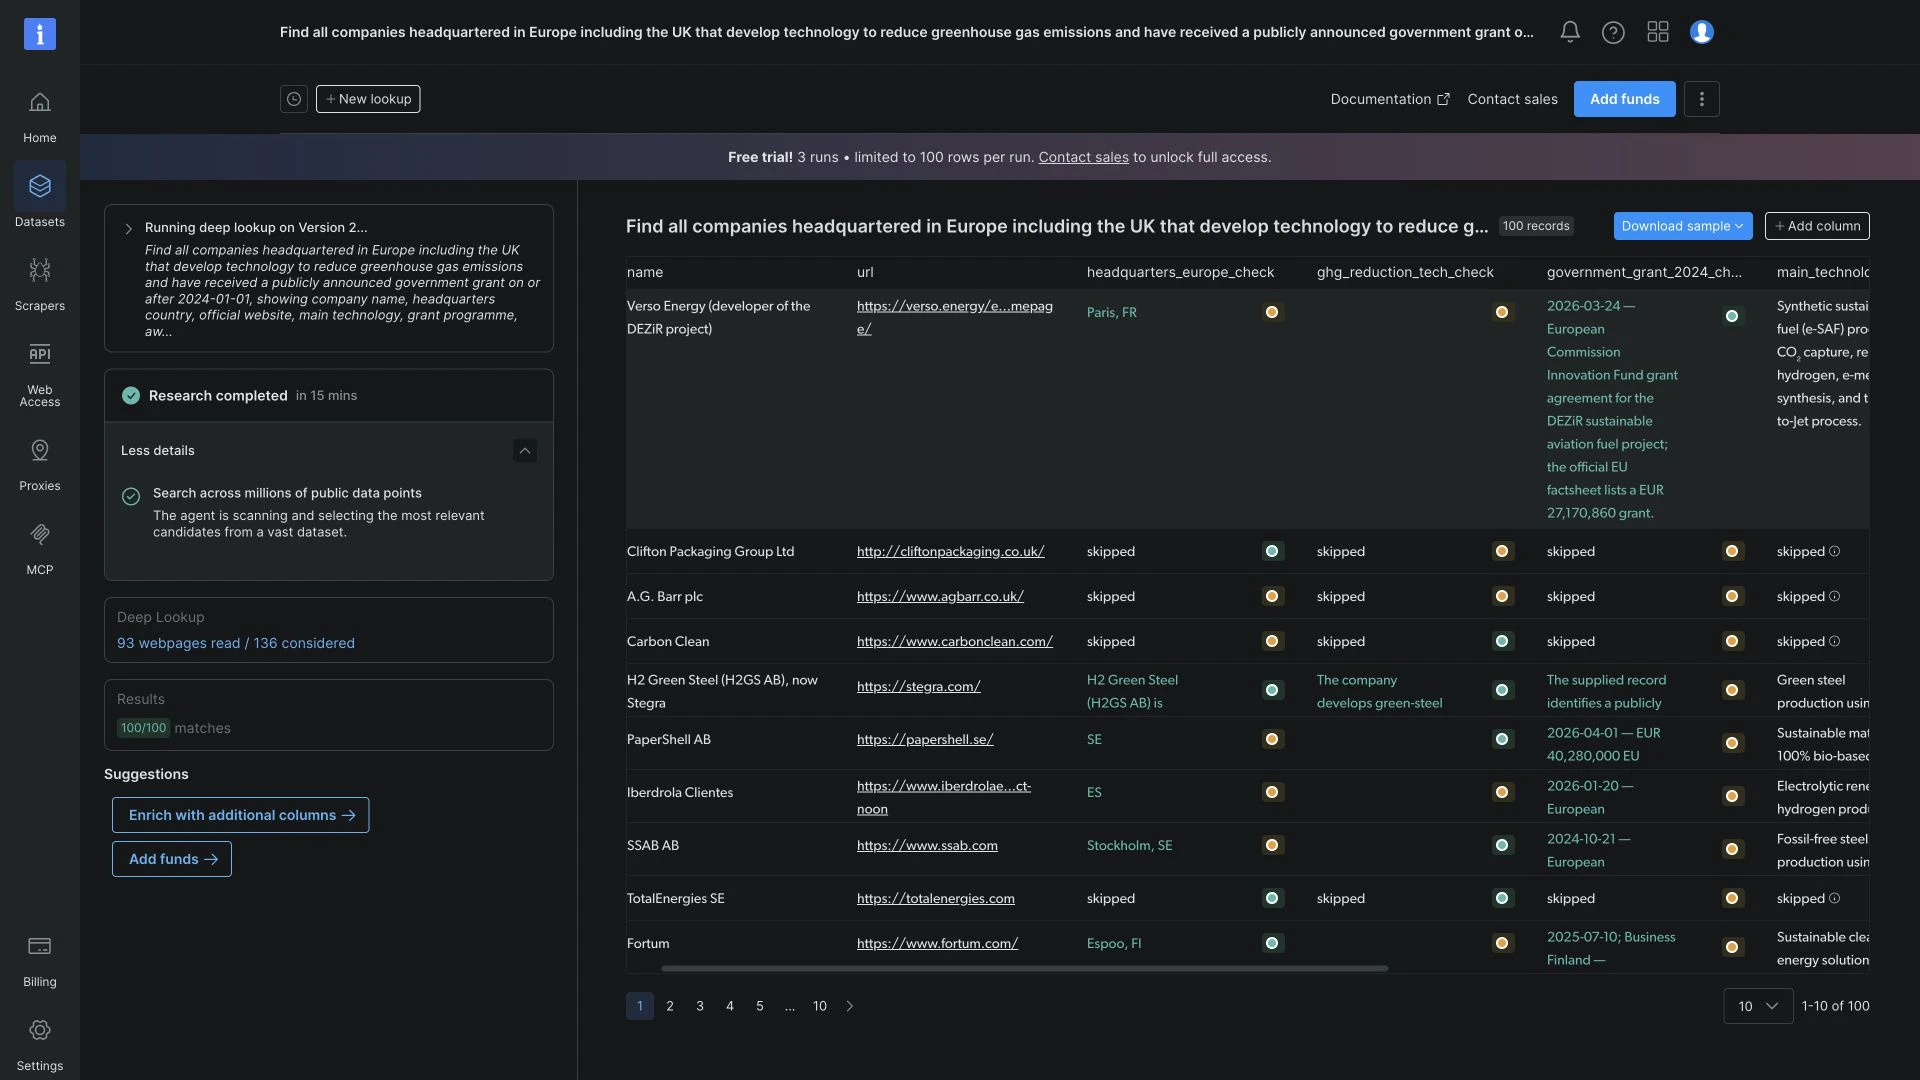
Sera gazı emisyonlarını azaltan teknoloji geliştiren Avrupa şirketlerini aradık. Sorgu Birleşik Krallık'ı kapsadı ve 1 Ocak 2024'ten bu yana kamuya açıklanmış bir devlet hibesi gerektirdi.
Deep Lookup her koşul için ayrı bir sütun oluşturdu. Bir satır genişletildiğinde daha uzun açıklamalar göründü; tek ayrıntıların yanında renkli güven göstergeleri vardı. Arayüz, denemenin 100 kayıt sınırına ulaşan 15 dakikalık bir çalışma bildirdi.
Ek sütunlarda teknoloji açıklamaları, hibe programları, ödül tarihleri ve kaynak bağlantıları yer aldı. Bağlantılar, hibe iddialarını duyurularla karşılaştırmamızı sağladı. İndirme menüsü CSV ve JSON biçimleri sunuyordu.3
Satış ekipleri, hedef sektör ve bölgedeki şirketleri bulmak için Deep Lookup'ı kullanabilir. Yatırımcılar belirli bir teknoloji geliştiren veya kamu fonu alan işletmeleri tespit edebilir. İşe alım uzmanları, ilgili roller ve deneyime sahip profesyonelleri arayabilir.3
Birkaç arama koşulunu özel sonuç sütunlarıyla birleştirmek, ekiplerin kendi ölçütlerine göre listeler oluşturmasını ve ayrıntıları tek bir yerde karşılaştırmasını sağlar.
Azure'ın Deep Research aracı bir veri sınırı uyarısı taşıyor
Microsoft, Azure AI Foundry Agent Service içinde Deep Research sunar; bu hizmete Python, C# ve JavaScript SDK'larından erişilebilir ve artık klasik ajan araçları altında belgelenmiştir.4
Bu sayfayı benimsemeden önce okumanın nedeni sayfanın kendisinde yer alıyor: Microsoft, Bing arama sorgusunun, araç parametrelerinin ve kaynak anahtarının, Azure uyumluluk sınırının dışına Grounding with Bing Search'e aktarıldığını belirtiyor. Hiçbir şeyin sınırın dışına çıkmaması için Azure'u seçen ekipler, bir araştırma çalışmasının hangi bölümlerinin sınırı geçtiğini kontrol etmelidir.
Yapay zekâ derin araştırma araçlarının faydaları
Dakikalar içinde kaynaklı bir araştırma raporu
Benchmark'ımızda medyan görev süreleri araca bağlı olarak 5.5 ile 42 dakika arasında değişti. Her çalıştırma, kaynak bağlantıları içeren bir araştırma raporu üretti. Aynı görevleri bir kişinin ne kadar sürede tamamlayacağını ölçmedik.
Gereksinim puanları, beş araç ve 20 brif genelinde en üstte 0.790'a ulaştı. Gereksinimler, istenen bölümlerden maliyet tablosundaki aritmetiğe kadar raporun tamamını kapsar; bu düzeydeki bir puan, brifin büyük bölümünün istendiği biçimde yanıtlandığı anlamına gelir.
Tek geçişte geniş kapsam
Bir araştırma ajanı; satıcı karşılaştırması, bir endüstri standardındaki değişikliklerin incelenmesi veya alışılmadık bir araştırma konusuna giriş için birden fazla web sitesinden materyal toplayabilir. Ortaya çıkan rapor, okuyucuya başlangıç düzeyinde bir genel bakış ve daha fazla araştırılacak kaynaklar sunar.
Düzenlenebilir bir araştırma taslağı
Çıktı bir belgedir; bu nedenle düzenlenebilir, sorgulanabilir ve yeniden çalıştırılabilir. Bu, arama sonuçları sayfasından farklı bir çalışma biçimidir. Bitmiş gibi görünen bir belge aynı zamanda risktir: bağlantı listesinden daha az kontrol edilmeye davet eder.
 Tercih edilen kaynak olarak ekle
Yapay zekâ derin araştırma araçlarının zorlukları ve sınırlamaları
Zayıf nokta yapı değil, olgulardır
Çoğu kişi bir LLM'in cevap uydurabileceğini bilir ve ürettiği şeyi kontrol eder. Derin araştırma raporu, uzun, kaynaklı ve iyi düzenlenmiş olduğu için zaten doğrulanmış gibi okunduğundan bu kontrolün daha azını davet eder.
Bir rapor, gerekli olguları atlarken veya yanlış aktarırken bölümleri, tabloları ve hesaplamalarıyla ilgili gereksinimleri karşılayabilir.
Bir karar vermek için raporu kullanmadan önce ilgili tarihleri, rakamları ve düzenleyici bulguları orijinal kaynaklarla doğrulayın.
Atıflar, kaynağın bunu söylediği anlamına gelmez
Atıf denetimimiz bağlantıların çalışıp çalışmadığını kontrol etti ve kaynaklarını sınıflandırdı. Her sayfanın kendisine bağlanan iddiayı destekleyip desteklemediğini kontrol etmedi. Resmi bir kaynağa verilen çalışan bir bağlantı bile bu kontrolü gerektirir: sayfa, raporun belirli rakamını veya sonucunu desteklemeden konuyu ele alıyor olabilir.
Uzunluk derinlik değildir
Claude Code'un medyan raporu 11.449 kelime içerirken Codex CLI'nin medyan raporu 5.734 kelime içerdi ve gereksinim puanlarında istatistiksel olarak anlamlı bir fark yoktu.
Okuyucular, aracın çalışma süresi ve fiyatının yanı sıra ne kadar materyali incelemeleri gerekeceğini de göz önünde bulundurmalıdır.
Önyargı, gizlilik ve aşırı bağımlılık
Eğitim verileri, yazılanların önyargılarını taşır ve sentez adımı bunları bir bulgu gibi okunan bir şeye dönüştürebilir. Barındırılan bir araçta, bağlam için yüklenen herhangi bir dahili belge sistemlerinizden çıkar; bu durum rutin hale gelmeden önce satıcının koşullarıyla kontrol edilmeye değer. Ölçülmesi en zor risk sonuncusudur: kimsenin kontrol etmediği cilalı bir rapor, kontrol etme alışkanlığını aşındırır.
Metodoloji
Test ortamı
Dört CLI aracını bir Linux bulut sunucusundan çalıştırdık ve Exa Agent'a API'si aracılığıyla eriştik. Her biri kendi araştırma araçlarını kullandı.
Görevler ve test prosedürü
- Satıcı seçimi, geçiş planlaması, maliyet modelleri ve düzenleyici araştırmayı kapsayan 20 brif yazdık. Her biri bir raporlama kesim tarihi belirtti ve birincil kaynaklardan oluşturulmuş referans yanıtlara sahipti.
- Her araca aynı görev prompt'ları verildi. Araç başına görev başına bir raporu değerlendirdik; beş araç boyunca 100 rapor elde edildi.
- Prompt'ları, model yapılandırmalarını ve puanlama kurallarını üretimden önce sabitledik. Düşük puanı iyileştirmek için hiçbir görev yeniden çalıştırılmadı.
Puanlama ölçütleri
- Gereksinimler: Her görevde 42 ila 74 arasında geçti/kaldı kontrolü vardı. Örneğin, bir maliyet tablosu birim fiyatı ve kaynağını gerektirebilir.
- Cezalar: Önceden tanımlanmış kusurlar puanı düşürdü; örneğin raporun başka bir yerinde çözülmemiş olarak nitelendirdikten sonra bir konuyu çözülmüş gibi ele almak. Puan = maks(0, (geçilen gereksinimler − tetiklenen cezalar) / toplam gereksinim). Her aracın genel puanı, 20 görev puanının ortalamasıdır. Ayrıca, geçilen gereksinim oranından ceza başına 0.1 düşen ve minimum puanı sıfır olan alternatif bir formülü de kontrol ettik. Bu, grafiğin Alternatif ceza seçeneğidir. Beş aracın sıralaması değişmedi.
- Olgu ayrıntıları: Ayrı bir kontrol listesi 434 gerekli olguyu içeriyordu. Bir öğe, yalnızca rapor belirtilen tolerans dahilinde gerekli her ayrıntıyı doğru şekilde içerdiğinde kredi aldı. Kısmi yanıtlar kredi almadı. Bu kontroller gereksinim puanına katkıda bulunmadı. Olgu yüzdeleri her göreve eşit ağırlık verir. Sayılar, tüm 434 öğedeki isabetleri birleştirir.
Model hakemleri
- Notlandırmadan önce tanımlayıcı meta verileri ve yerel dosya yollarını kaldırdık. Her iki hakem de aynı raporu, görev kurallarını, referans olguları ve atıf denetimini aldı.
- GPT-5.6 Sol ve Grok 4.6 her raporu bağımsız olarak notlandırdı. Her gereksinim ve ceza için her hakem, geçti/kaldı kararı vermeden önce rapora bağlı bir gerekçe kaydetti. Ayrıca her olgu öğesini kontrol ettiler.
- Claude Opus 5 aynı kanıtları kullanarak anlaşmazlıkları çözdü. İlk iki hakemin üzerinde anlaştığı kararlar değişmeden kaldı. İlk iki hakem, kural kararlarının %93,3'ünde ve olgu öğesi kararlarının %89,1'inde anlaştı.
İstatistiksel analiz
20 görev boyunca eşleştirilmiş testler kullandık ve on ikili araç karşılaştırmasının tamamında Holm düzeltmesi uyguladık. Görevleri 10.000 kez yeniden örnekleyerek %95 sıralama aralıklarını tahmin ettik.
Sınırlamalar
- Araç başına görev başına tek rapor, aynı aracın yanıtlarının çalıştırmalar arasında ne kadar değiştiğini ölçmez.
- Bağlantı kullanılabilirliğini ve kaynak türünü kontrol ettik, ancak atıf yapılan her sayfanın ekli iddiayı destekleyip desteklemediğini doğrulamadık. Bu doğrulamayı gerektiren kontroller tüm araçlarda kaldı kararı aldı: olumlu kontroller kredi kazanmadı ve olumsuz kontroller ceza tetiklemedi.
- Daha önceki bir pilot çalışmadan sonra sekiz görevi iyileştirdik. Gelecekteki değerlendirmeler için brifleri yayımlamıyoruz.
SSS'ler
Yapay zekâ destekli araştırma; bilgi bulmak, analiz etmek ve özetlemek için yapay zekâ araçlarını kullanır. Bir derin araştırma aracı, sohbet yanıtının ötesine geçer: dakikalar boyunca çalışır, birçok kaynak açar ve atıflar içeren bir rapor üretir.
Kendi ölçümümüze göre iyi olduğu şey yanıtın biçimidir. Zayıf olduğu şey ise ayrıntılardır. Test ettiğimiz beş aracın en güçlüsü, gerekli 434 değer, tarih ve adın 202'sini yeniden üretti; en zayıfı ise 89'unu yeniden üretti.
Bu nedenle derin araştırma raporu, herhangi bir şey yayımlanmadan önce kontrol edilmelidir. Rakamlar yanlış olsa bile rapor bitmiş gibi görünebilir. İlgili benchmark'lar: Yapay zekâ ile kodlama.
Yapay zekâ araçları; ilgili makaleleri belirleme, temel bulguları özetleme ve araştırma temalarını düzenleme dahil olmak üzere literatür taramalarının çeşitli yönlerinde yardımcı olabilir. Bu araçlar büyük miktarda akademik literatürü hızlıca işleyebilir ve araştırmacıların çalışmalar arasındaki boşlukları veya kalıpları belirlemesine yardımcı olabilir. Ancak yapay zekâ, kaynak kalitesini değerlendirmede, karmaşık argümanları sentezlemede veya eleştirel analiz sağlamada insan muhakemesinin yerini tamamen alamaz. Araştırmacılar, doğruluğu sağlamak ve literatür taramalarında akademik titizliği korumak için yapay zekâ tarafından üretilen içeriği yine de gözden geçirmeli, doğrulamalı ve yorumlamalıdır.
Yapay zekâ araçları; dataset'leri temizleyerek, istatistiksel testler yaparak, görselleştirmeler oluşturarak ve büyük dataset'lerdeki kalıpları belirleyerek veri analizi ve istatistiksel çalışmalara yardımcı olabilir. Bu araçlar, veri türüne ve araştırma sorularına dayanarak uygun istatistiksel yöntemler önerebilir. Ancak araştırmacılar veri bağlamını anlamalı ve sonuçları doğrulamalıdır; çünkü yapay zekâ alana özgü incelikleri gözden kaçırabilir veya uygun olmayan varsayımlarda bulunabilir.
Çoğu modern yapay zekâ araştırma aracı, programlama becerisi gerektirmeyen doğal dil arayüzleri kullanır. Bununla birlikte, temel veri okuryazarlığı ve temel araştırma kavramlarını anlamak, kullanıcıların daha iyi sorgular oluşturmasına ve sonuçları daha etkili yorumlamasına yardımcı olur. Gelişmiş uygulamalar, özel analiz veya uzmanlaşmış iş akışları için teknik bilgiden faydalanabilir.
Önemli bir iddia için kullanılan her kaynağı açın ve raporun rakamlarını, tarihlerini ve sonuçlarını desteklediğini kontrol edin. Kaynağın ilgili zaman dilimi ve bağlam için geçerli olduğunu doğrulayın. Benchmark'ımızın olgu kontrol listesi önceden tanımlanmış ayrıntıları kapsıyordu; bu nedenle puanları bir rapordaki her iddianın doğruluğunu belirlemez.
Bu benchmarkı kaynak gösterin
Yayınlayacağınız yere uygun formatı seçin. Bağlantılı sürümü CMS'inize yapıştırmak, geri bağlantıyı korur.
@misc{kalelioglu2026,
  author = {Kalelioğlu, Berk},
  title  = {{Yapay Zekâ Derin Araştırma: Codex vs Claude vs Grok vs Exa}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/ai-deep-research}},
  note   = {AIMultiple. Erişim tarihi: 12 Eylül 2026}
}10 veri noktasının sonuçları ve zaman damgaları. Bu makaledeki grafik ve tablolarda gösterilen özet verileri, 2 CSV dosyası ve bir README içeren ZIP dosyası olarak indirin.
Arkasındaki ayrıntılı veriyi ister misiniz? Premium'a katılın
Değişiklik günlüğü
8 güncellemeAjanlar ile Derin Araştırma Modelleri özeti, ajanların derin araştırma doğruluğunu daha düşük maliyetle yakaladığı bulgusuyla değiştirildi.
Altı aracı beş görevde karşılaştıran Ajanlar ile Derin Araştırma Modelleri karşılaştırma bölümü eklendi.
Beş araştırma görevini, referans kaynaklarını, puanlamayı ve araç arayüzlerini açıklayan bir kıyaslama metodolojisi bölümü eklendi.
AI derin araştırma kıyaslama bölümüne DR-2T (Derin Araştırma 2 Görev) Kıyaslaması eklendi.
Referans Linkleri






Yorum yapan ilk kişi olun
E-posta adresiniz yayınlanmayacak. Tüm alanlar gereklidir. Yorumlar orijinal dilinde bırakılır.