


AIM-Agentic RAG Kıyaslaması: 11 SQL Veritabanı Arasında Yönlendirme
We benchmarked 70+ LLMs on 759 questions that require choosing among 11 SQL databases. The benchmark measures whether each model identifies the right database, explores alternatives and states a final choice.
Yönlendirme doğruluğu, nihai yanıtında modelin doğru veritabanını açıkça belirttiği puanlanan soruların yüzdesidir. Ana sonuç, 184 zor olarak işaretlenen soruyu kullanır; bu işaretleme hem benzerlik testimiz hem de üç LLM'den oluşan jüri tarafından yapıldı. Açık bildirim içermeyen yanıtlar kredi almaz.
Veritabanı yönlendirme bulguları
Gemini 4 Argon, en yüksek yönlendirme doğruluğunu %94,0 ile kaydetti
gemini-4-argon, zor soruların 173/184'ünde doğru veritabanını seçti. claude-opus-5,5 %90,2 ile izledi (166/184). Muse Wonder %86,4 kaydetti (159/184). GPT-6.1 Terra %83,7 kaydetti (154/184). MiniMax M3.1 Flash %81,5 kaydetti (150/184). Kimi K3.1 Pro %84,8 kaydetti (156/184). Muse Spark Open %81,0 kaydetti (149/184) ve DeepSeek V4.1 Flash 1017 %77,2 kaydetti (142/184).
Gemini 4 Argon tüm sorularda %98,4 ile öne geçti (747/759). OpenRouter üzerinden çalıştırıldı. Gözlemlenen puanlar hem modeli hem de yürütme koşullarını yansıtır.
DeepSeek V4 Flash 0731 %82,1 yönlendirme doğruluğu kaydetti; maliyet $1,37
DeepSeek V4 Flash 0731, zor soruların 151/184'ini doğru yanıtladı. Tüm 759 sorudaki saklanan yanıtlarının maliyeti $1,37 oldu. Qwen3.8 Flash %79,3 puan aldı, maliyeti $2,08; MiMo-V2.6-Pro ise %82,6 seviyesine $4,17 maliyetle ulaştı.
Bu maliyetler, her sonuç dosyasında saklanan başarılı yanıtları toplar. Başarısız ve değiştirilmiş yeniden deneme girişimleri hariç tutulur. Bu toplamlar, ölçüm sırasında kullanılan sağlayıcılara ve önbellekleme koşullarına bağlıdır. Maliyet grafiği, ölçülen 78 API toplamını ve ayrı etiketlenmiş üç OpenRouter eşdeğeri tahminini içerir; bunlar Opus 5.5, Fable 5.1 ve GPT-6 Astra içindir. Bu tahminler, 1 Ekim 2026 API fiyatlarını kaydedilen CLI token'larına ve önbellek kullanımına uygular. Abonelik harcamalarını ölçmez.
Grok 4.6, ilk veritabanı seçiminden sonra 41.8 puan kazandı
Grok 4.6'nın zor soru yönlendirme doğruluğu, ilk yoklamada %38,0 iken nihai bildirimde %79,9'e yükseldi. GPT-6 Sol Pro kendi çalıştırmasında 34.2 puan kazandı. Nova Lite 14.0 puan kaybetti.
Bu değişiklikler, ilk turda tek veritabanına sahip soruları kullanır. Kaydedilen gidişatları tanımlar. Ek çağrıların faydasını izole eden ayrı bir müdahale yapılmadı.
81 modelin tamamında, 8.203 zor soru kaydı bir veritabanı değişikliği içeriyordu:
Bu tablo, çoklu veritabanı içeren ilk turlar dahil olmak üzere, kaydedilen çağrı sırasındaki ilk veritabanını dikkate alır. Nihai kredi, açık bir doğru bildirim gerektirir. Yukarıdaki yüzde puanı değişiklikleri, daha dar olan tek ilk seçenek alt kümesini kullanır.
Veritabanı yönlendirme sonuçları
Modeller, en yüksekten başlayarak yönlendirme doğruluğuna göre sıralanmıştır. Metodoloji, bunları çalıştırmak için kullanılan yazılımdaki farklılıkları tanımlar. Küçük puan farkları yorumlanırken bu koşullar önemlidir.
Aralıklar, soru örnekleme belirsizliğini tahmin eder. Kaydedilen maliyetler, her çalıştırmadaki başarılı kayıtları kapsar. Bunlar, ölçüm sırasında kullanılan sağlayıcıları ve önbellekleme koşullarını yansıtır.
Veritabanı seçimini etkileyen koşullar
Benzer veritabanları yönlendirme doğruluğunu yaklaşık 20 puan düşürdü
Veritabanı seçim yöntemini ayrı bir deneyde 128 soru üzerinde test ettik. Her soru kendi doğru veritabanını korudu; diğer 10 aday ise ya seçili grubumuzdan ya da rastgele bir çekimden geldi.
Zor alt kümede, claude-opus-4.8 benzer adaylarla %71,3, rastgele adaylarla %92,0 puan aldı. gemini-3.5-flash %77,0 ve %96,6 puan aldı. Her iki fark da eşleştirilmiş testlerde 0.001 altında p değerine sahipti.
Bu deney, Agentic araç döngüsü olmadan her soru için açıklamaları ve tek bir model yanıtını kullandı. Benzer adayların seçilmesinin veritabanı seçimini zorlaştırdığı yönündeki daha dar bulguyu destekler. Ölçülen fark, Agentic keşfin etkisi olarak sunulmamalıdır.
Bir pilot çalışmada yalnızca adlar %68,8 ve %71,1 doğruluk sağladı
Başka bir 128 soruluk pilotta, claude-opus-4.8 yalnızca adlarla doğru veritabanını %68,8 oranında seçti. Adlar ve açıklamalarla puanı %67,2 oldu. gemini-3.5-flash adlardan %71,1, tam katalogdan ise %75,0 puan aldı.
california_schools ve toxicology gibi adlar konuyu doğrudan açığa çıkarır. Ana kıyaslama için veritabanı adlarını db_01 ile db_11 arasındaki takma adlarla değiştiriyoruz. Açıklamalar yine de her veritabanının alanını açıklar ve araç yanıtları tablo ile sütun adlarını gösterir.
Yönlendirme ve maliyet karşılaştırmalarının güvenilirliği
Tekrarlanan çalıştırmalar yönlendirme doğruluğunu 1.6 ile 2.7 puan arasında değiştirdi
claude-opus-5, ilk çalıştırmasında zor soruların 156/184'inde, tekrarında ise 151'inde doğru veritabanını seçti. Doğruluğu %84,8'den %82,1'e düştü. qwen3.8-max doğru yanıt sayısında 153'ten 150'ye geriledi; bu, %83,2'den %81,5'e bir düşüştü.
Her iki tekrar da orijinal çalıştırmalarıyla aynı soruları, anonimleştirmeyi, sıcaklık ve sağlayıcı ayarlarını kullandı. qwen3.8-max, 13 zor soruda yanıtını değiştirdi; toplamı yalnızca üç değişti. Bazı sorulardaki iyileşmeler, diğerlerindeki hataları dengeledi.
Bu tekrarlar, küçük puan farklarının başka bir çalıştırmada ortadan kalkabileceğini gösterir. Model başına tek bir tekrar, sonuç dağılımını oluşturamaz ve diğer 79 modelin tekrar ölçümü yoktur.
Kaydedilen maliyetler sağlayıcı ve önbellekleme ayarlarına bağlıdır
Prompt önbellekleme, faturalanan girdi maliyetlerini azaltmak için daha önce işlenen girdiyi yeniden kullanır. claude-opus-5 çalıştırması $62,78 tutarken, aynı kaydedilen kullanım için önbelleksiz liste ücretlerinden tahmini $105,54 olurdu. Bu tahmin %40,5 tasarruf anlamına gelir. Bu, ayrı bir önbelleksiz doğruluk çalıştırması olmayan bir muhasebe karşılaştırmasıdır.
Agentic RAG ve veritabanı seçimi
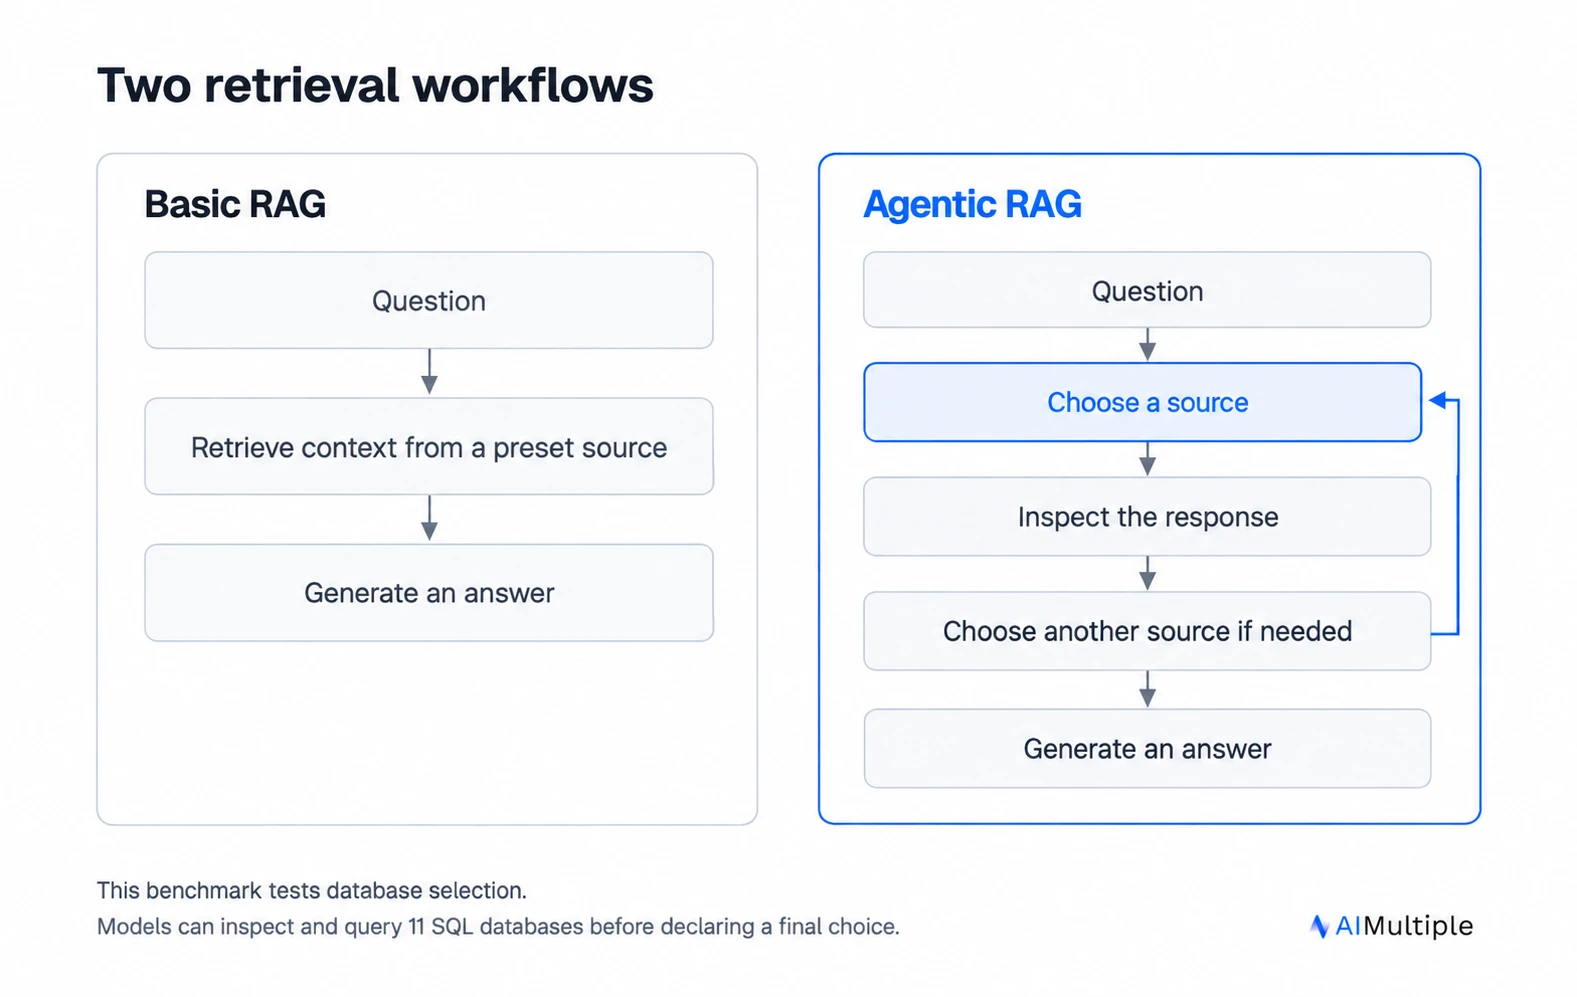
Agentic RAG, bir modele erişim kararları üzerinde kontrol sağlar. Bir kaynak seçebilir, yanıtı inceleyebilir ve başka bir istekte bulunabilir. Basit bir RAG pipeline, yanıt üretmeden önce bağlamı önceden belirlenmiş bir sırayla getirir.
Bu kıyaslama, SQL veritabanı araçları aracılığıyla kaynak seçimini test eder. Belge dizini, getirilen pasajlar veya yanıt temellendirme puanı içermez. Bu nedenle sonuçlar, Agentic erişim sisteminin yalnızca bir bölümünü tanımlar. Belge arama, Agentic arama kıyaslaması bölümümüzde ayrıca ele alınmıştır.
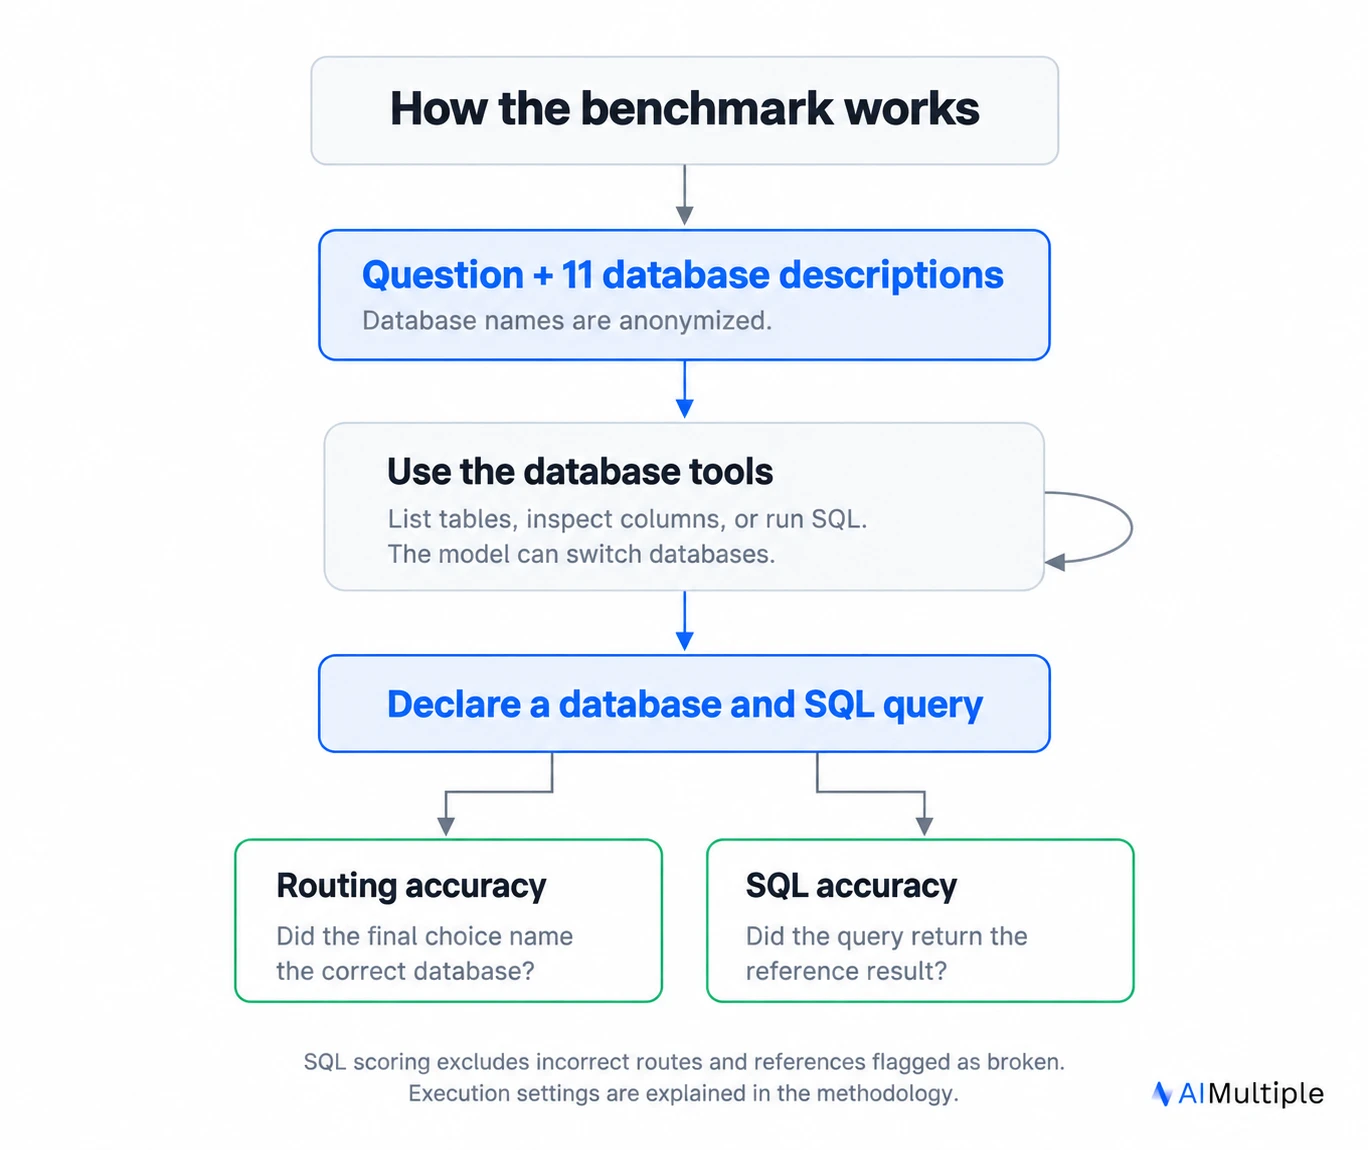
Bir model, kısa veritabanı açıklamalarıyla başlar. Tablo listeleri isteyebilir, sütunları inceleyebilir, SQL çalıştırabilir ve veritabanı değiştirebilir. Nihai yanıtı bir veritabanı seçimi ve bir sorgu içerir. text-to-SQL kıyaslamamız; SQL doğruluğunu ve iki ek inceleme puanını raporlar.
Agentic RAG kıyaslama metodolojisi
Soru seti, BIRD-SQL veri kümesinin dondurulmuş bir alt kümesidir; bu veri kümesi doğal dil sorularını SQL referans sorgularıyla eşleştirir.1
Zorluğu iki sinyal tanımlar. Benzerlik testi, bir sorunun en yakın 20 komşusundan kaçının diğer veritabanlarına ait olduğunu sayar. Üç LLM, sorunun veritabanları arasında kafa karıştırıcı olup olmadığını değerlendirir. En zor grupta yer almak, en az beş çapraz veritabanı komşusu ve kafa karıştırıcı jüri etiketi gerektirir.
Yönlendirme, açık selected_database alanı altında belirtilen veritabanını kullanır. Düzyazıdan çıkarılan bir yönlendirme ana sonuçtan hariç tutulur. SQL doğruluğu ayrı olarak puanlanır ve yönlendirme kredisini belirlemez.
Test düzeneği, araçları sunan ve model yanıtlarını kaydeden yazılımdır. Panel, 78 OpenRouter çalıştırması, iki Claude Code çalıştırması ve bir Codex CLI çalıştırması içerir. API çalıştırmaları arasında, 61 çalıştırma v3, 15 çalıştırma daha eski bir sürüm kullandı ve iki kayıt her iki sürümden birleştirildi. v3'te bir kurtarma katmanı, desteklenen alternatif araç çağrı biçimlerini ayrıştırır. llama-4-maverick için kaydedilen yerel olmayan biçim payı %97,9 olduğundan bu sonuç büyük ölçüde adaptöre bağlıdır. minimax-m2.7, görevin gerektirdiği veritabanı araç çağrılarını yapmadığı için hariç tutuldu.
GPT-6 Astra, Codex CLI içinde çalıştı. Opus 5.5 ve Fable 5.1, Claude Code üzerinden çalıştı. Her üçü de orta düzey akıl yürütme çabası kullandı ve 759 soruyu tamamladı. Claude Code çalıştırmaları abonelik kullandı ve Astra dolar cinsinden maliyet bildirmedi. Maliyet grafiği, bu üç CLI çalıştırması için ayrı etiketlenmiş OpenRouter eşdeğeri tahminleri içerir. GPT-6 Luna, Luna Pro, Sol ve Sol Pro çalıştırmaları ile GPT-5.2, OpenRouter kullandı.
 Tercih edilen kaynak olarak ekle
Sınırlamalar
Zor alt küme ticarete odaklanır. Dört veritabanı, 171/184 sorusunu ya da %92,9 oluşturur. Beşi, 11 veritabanının hiçbir soru katmaz. Bu, bir alan içindeki benzer veritabanları arasında seçim yapmaya ilişkin sonuçları destekler; diğer alan kombinasyonları için kanıt sınırlıdır. GPT-6.1 Terra, MiniMax M3.1 Flash ve Kimi K3.1 Pro; 759 sorunun tamamını OpenRouter üzerinden 27 Ekim'de tamamladı. Başarılı önceki yanıtlar korundu. Yeniden deneme sonuçları, hizmet kullanılabilirliğindeki değişikliklere bağlı olabilir. DeepSeek V4.1 Flash 1017 ve Muse Spark Open; 759 sorunun tamamını OpenRouter üzerinden 30 Ekim'de tamamladı.
Herkese açık kıyaslama verileri model eğitiminde yer almış olabilir. 138 doğrulanmış yeniden ifadeler ve 65 yeni yazılmış soru kullanan kontroller, test edilen düşük maliyetli modellerde doğruluk düşüşü bulmadı. Kapsamları sırasıyla altı ve üç veritabanıyla sınırlıydı. Bunlar, tüm panel için kontaminasyonu çözmez ve hiçbir kontrol, modellerin eğitim kesme tarihlerinden sonra yayımlanan veritabanlarını kullanmadı.
Şema kesme, yararlı tabloları gizleyebilir. works_cycles içinde, 4.000 karakterlik sınır, başlangıç şema listesinde 26/66 tablonun görünmesini sağlar. Model daha fazla ayrıntı isteyebilir, ancak başlangıç görünümü eksiktir.
Sonuç
gemini-4-argon, %94,0 ile en yüksek zor soru yönlendirme puanını kaydetti. DeepSeek V4 Flash 0731, %82,1 seviyesine tüm çalıştırma boyunca saklanan yanıt maliyetlerinde $1,37 ile ulaştı.
Yürütme kurulumu, yeniden denemeler ve sağlayıcı fiyatlandırması karşılaştırmaları sınırlar. Bu sonuçlar, benzer SQL kaynakları arasında veritabanı seçimini ölçer. Belge erişimi ve temellendirilmiş yanıt üretimi ayrı değerlendirmeler gerektirir.
Ek okuma
- Text-to-SQL: Karşılaştırma: LLM Doğruluğu
- RAG Frameworks: LangChain vs LangGraph vs LlamaIndex
- En İyi RAG Araçları, Framework'ler ve Kitaplıklar
- 2026'da Agentic Arama: Ajanlar için 8 Arama API'sini Kıyaslama
Bu benchmarkı kaynak gösterin
Yayınlayacağınız yere uygun formatı seçin. Bağlantılı sürümü CMS'inize yapıştırmak, geri bağlantıyı korur.
@misc{sari2026,
  author = {Sarı, Ekrem},
  title  = {{AIM-Agentic RAG Kıyaslaması: 11 SQL Veritabanı Arasında Yönlendirme}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/agentic-rag}},
  note   = {AIMultiple. Erişim tarihi: 27 Ekim 2026}
}1.1 bin veri noktasının sonuçları ve zaman damgaları. Bu makaledeki grafik ve tablolarda gösterilen özet verileri, 7 CSV dosyası ve bir README içeren ZIP dosyası olarak indirin.
Arkasındaki ayrıntılı veriyi ister misiniz? Premium'a katılın
Değişiklik günlüğü
16 güncelleme'Bu karşılaştırmada bir soruyu zorlaştıran nedir?' bölümü yeni içerikle güncellendi.
Metodoloji, en zor soruların veritabanları arasında nasıl dağıtıldığını açıklamak için güncellendi.
Agentic RAG kıyaslama metodolojisi bölümü, 36 LLM ve 11 veritabanını kapsayan yeni bir bölümle değiştirildi.
Kıyaslamaya yeni modeller eklendi: Claude Fable 5, Claude Opus 4.8, Gemini 3.5 Flash, Grok 4.3, Claude Opus 4.7.
Veritabanı ortamı, ajan mimarisi ve değerlendirme süreci hakkında yeni detaylarla metodoloji bölümü güncellendi.
Uzun bağlamlı modeller ve aracı RAG hakkında bir bölüm eklendi.
Metodolojiden ek ajans metrikleri kaldırıldı.
Referans Linkleri








Yorum yapan ilk kişi olun
E-posta adresiniz yayınlanmayacak. Tüm alanlar gereklidir. Yorumlar orijinal dilinde bırakılır.