


Açık Kaynak Embedding Modelleri: Erişim için 11 Model Benchmark Edildi
We benchmarked 11 open-weight embedding models, 200 questions and 341,040 text passages across four corpora. Finance, legal contract, technical support and medical questions each searched their own domain's corpus.

nDCG@10, kaydedilen ilgili pasajların ilk on arama sonucu içindeki yerleşimini puanlar. 1 puanı, kaydedilen pozitifler için ideal sıralamayı temsil eder. Üste daha yakın pasajlar daha fazla ağırlık alır.
PPLX Embed v1 4B karşılaştırmayı 0.741 nDCG@10 ile önde tamamladı; onu 0.698 ile PPLX Embed v1 0.6B izledi. Multilingual E5 Large 0.628 ile üçüncü oldu. BGE Large ile E5 Large arasındaki küçük fark, üç ondalık yuvarlamada gizleniyor. Yuvarlanmamış puanları sıralamayı belirler.
Model | nDCG@10 | %95 GA | Recall@10 |
|---|---|---|---|
PPLX Embed v1 4B | 0.741 | 0.700–0.782 | %90,46 |
PPLX Embed v1 0.6B | 0.698 | 0.651–0.744 | %86,71 |
Multilingual E5 Large | 0.628 | 0.578–0.680 | %79,38 |
BGE Large EN v1.5 | 0.624 | 0.572–0.676 | %78,21 |
E5 Large v2 | 0.624 | 0.572–0.675 | %78,88 |
BGE-M3 (dense) | 0.614 | 0.562–0.666 | %79,50 |
GTE Large | 0.612 | 0.563–0.660 | %77,71 |
All-MPNet Base v2 | 0.608 | 0.556–0.661 | %77,33 |
GTE Base | 0.596 | 0.547–0.645 | %76,21 |
E5 Base v2 | 0.586 | 0.534–0.640 | %75,21 |
Recall@10, her sorunun kaydedilen ilgili pasajlarının ilk on sonuçta bulunan ortalama oranıdır. Pasaj kapsamını ölçer ve üretilen bir yanıtın doğru olup olmadığını puanlamaz.
%95 güven aralıkları (GA), soru örneklemesinden kaynaklanan ortalama nDCG@10 belirsizliğini tahmin eder. Daha geniş aralıklar daha az kesin tahminlere işaret eder.
Sorular, bu sette sıfır puan alan BM25'i zorlamak için seçildi. Bu taban puanı seçim prosedürüyle birlikte raporluyoruz. Normal arama trafiğindeki performans test edilmedi. Inference, barındırılan endpoint'ler aracılığıyla gerçekleştirildi.
Açık ağırlıklı modellerde getiri bulguları
PPLX Embed v1 4B en yüksek nDCG@10 puanını 0.741 ile kaydetti
PPLX Embed v1 0.6B, 0.698 ile onu izledi. 4B modeli, çoklu karşılaştırmalar için düzeltme yapıldıktan sonra diğer on açık ağırlıklı modelin dokuzundan anlamlı şekilde daha yüksek puan aldı. 0.6B ile arasındaki fark anlamlı değildi. Recall@10 puanları %90,46 ve %86,71 idi; yine anlamlı bir fark yoktu. Bu testler eşit performansı göstermez.
BGE Large, 0.604 ile en yüksek finans puanını kaydetti
PPLX 4B, 0.596 puan aldı aynı 50 finans sorusunda. Bu fark düzeltme sonrasında anlamlı değildi. BGE Large genel sıralamada dördüncü oldu; bu da gözlenen sıranın alanlar arasında nasıl değiştiğini gösterir.
GTE Large, kaydedilen tüm MedRAG pozitiflerini ilk on sonuç içinde getirdi
GTE Large, %100 Recall@10 değerine 50 tıbbi soru genelinde ulaştı. nDCG@10 değeri 0.894 idi; PPLX 4B’in 0.954 değeriyle karşılaştırıldığında. Kaydedilen pozitifleri getirmek ve onları ilk sıraya koymak ayrı sonuçlardır. Bu puanlar pasaj getirimiyle ilgilidir ve tıbbi yanıt doğruluğunu ölçmez.
On bir model için alan karşılaştırmaları
Alan düzeyinde nDCG@10. Finans, CUAD, TechQA ve MedRAG görünümleri on bir modelin tümünü tutar ve bunları seçilen alanın puanına göre sıralar.
BGE-M3, CUAD'da 0.616 ve MedRAG'da 0.743 değerine ulaştı. Bu rakamlar burada kullanılan yoğun vektör yapılandırmasını tanımlar. BGE-M3 ayrıca seyrek ve çok vektörlü getirimi de destekler. Bu modlar ve hibrit kombinasyonlar bu deneyin dışındaydı.1
Dört alanın tümü genel sonuçta eşit ağırlığa sahiptir. Bir modelin güçlü MedRAG performansı, finansal ve tıbbi kullanım durumları farklı kanıtlar gerektirse de bu ortalamada daha zayıf finans getirimini dengeleyebilir.
Embedding temsilleri ve dağıtım seçenekleri
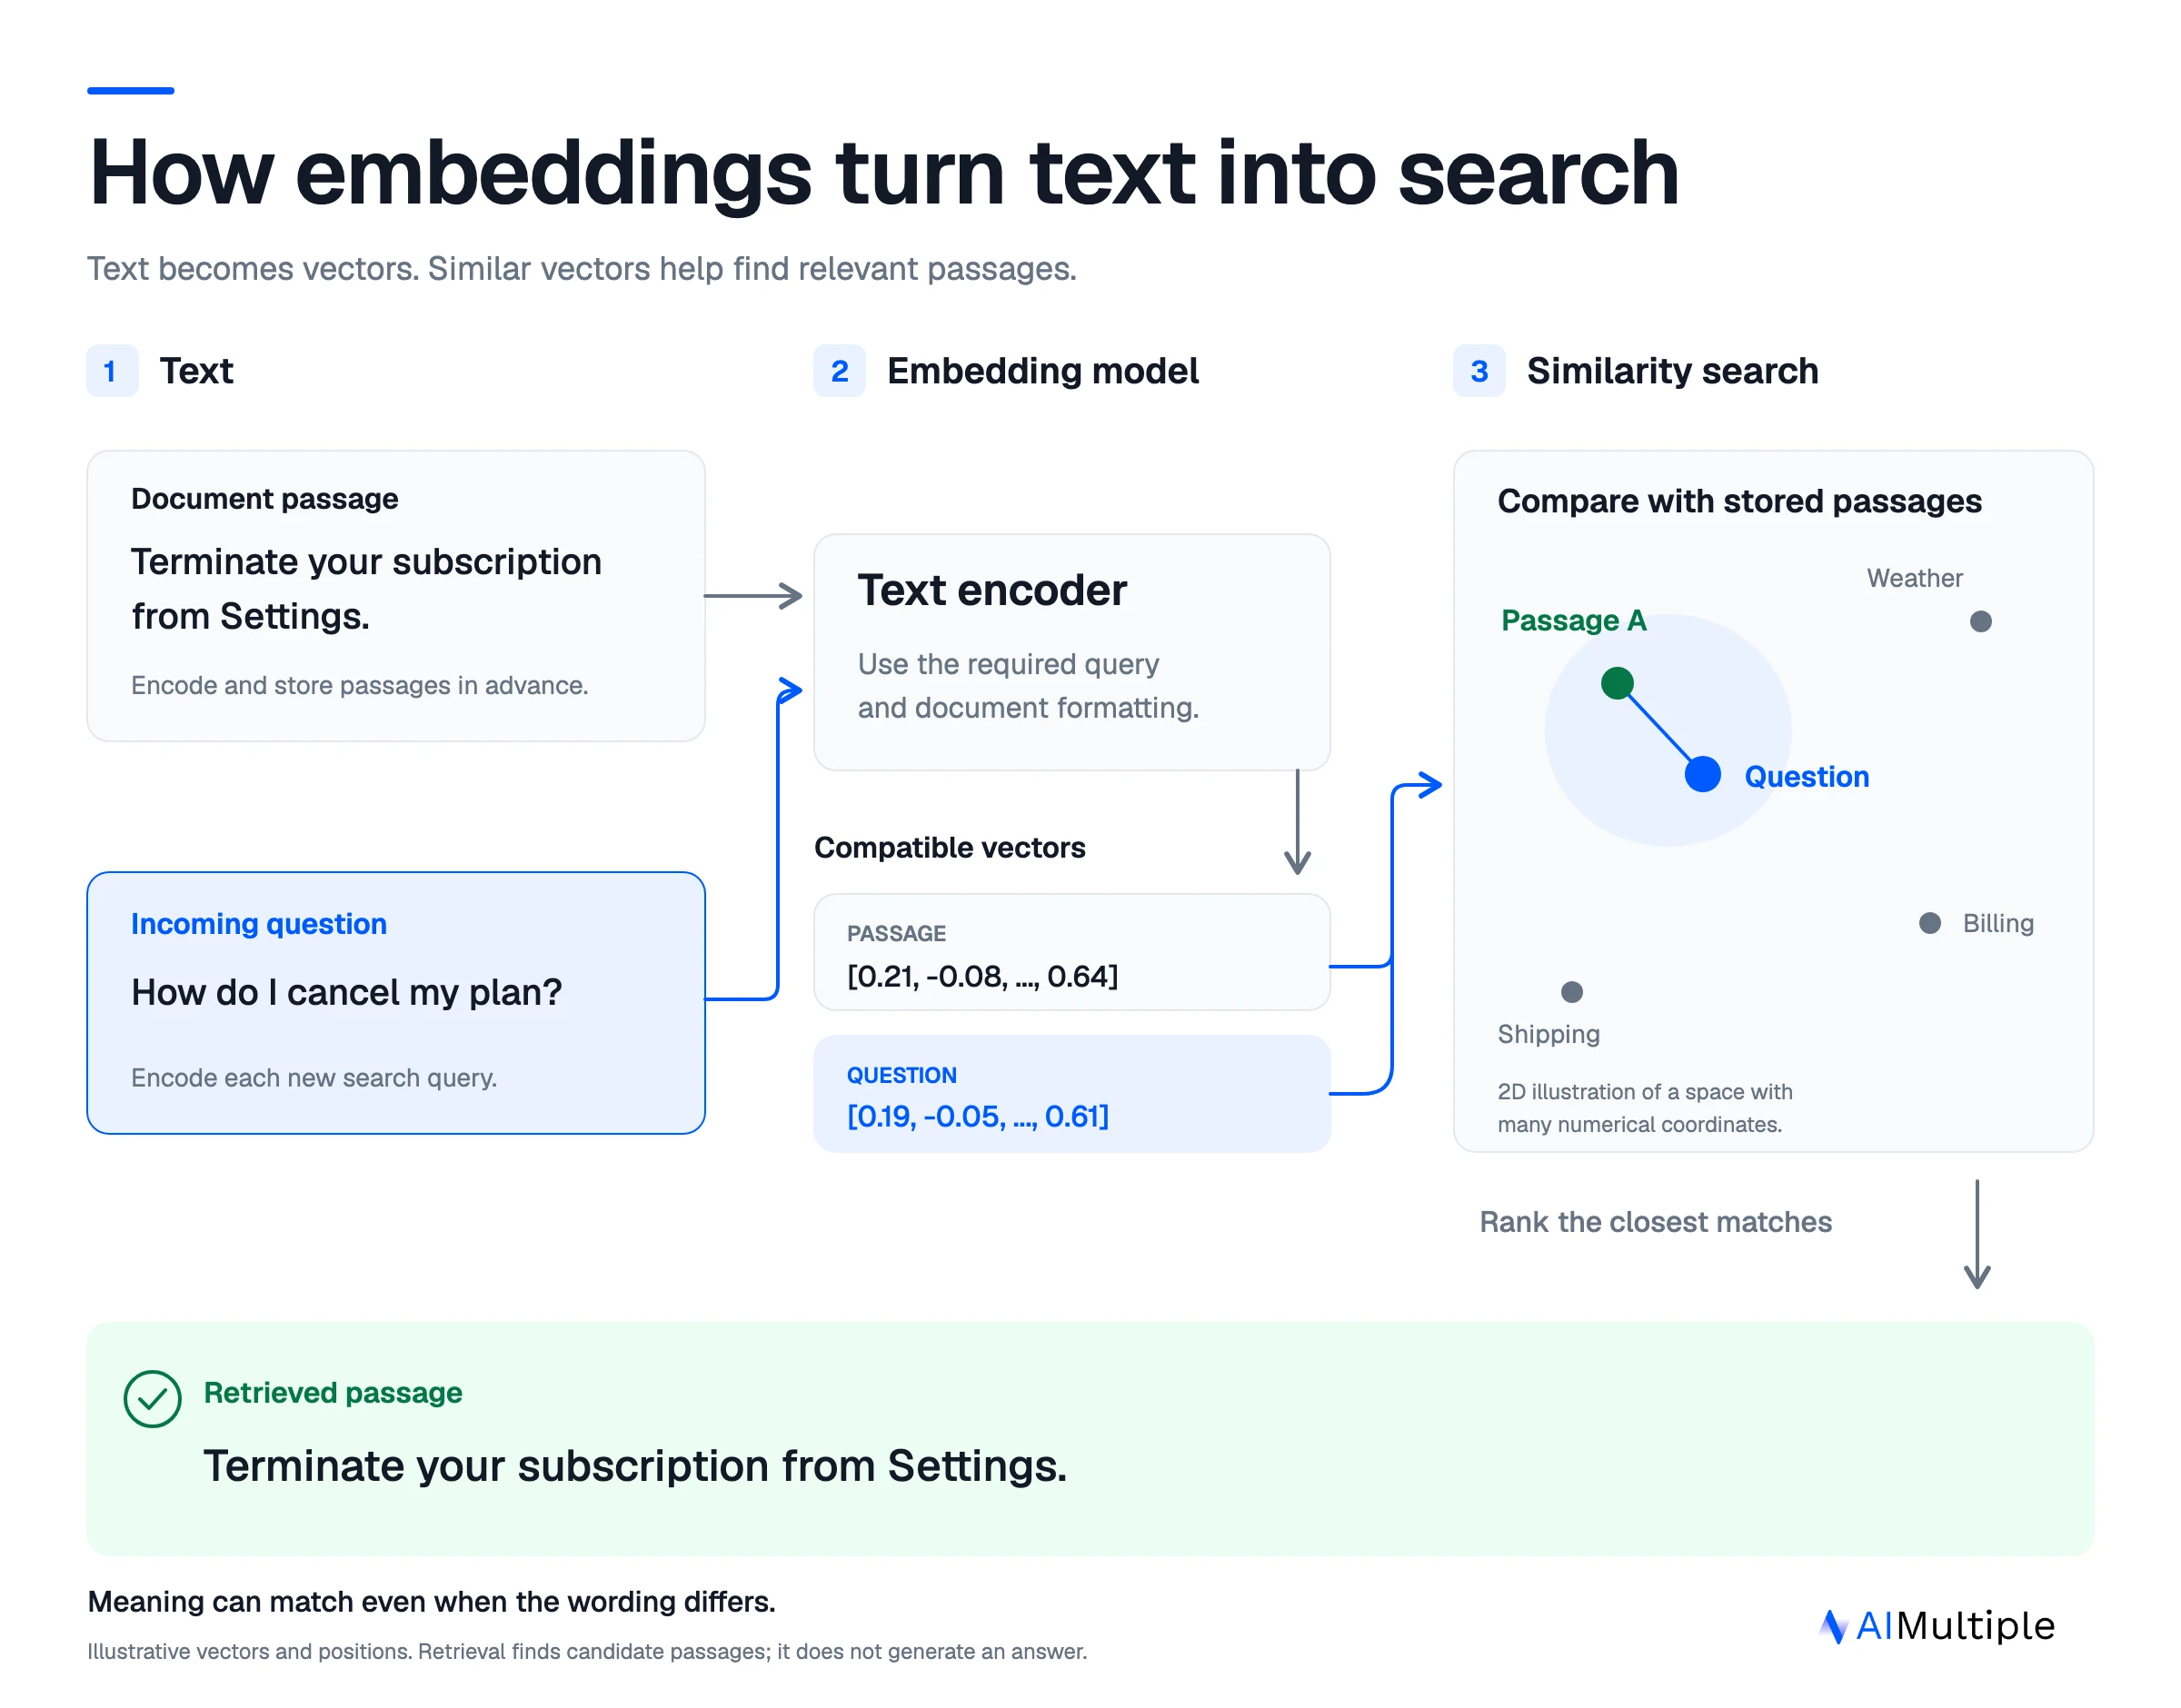
Embedding getirimi, pasajları ve sorguları uyumlu vektörlere kodlar; ardından aday pasajları seçmek için bu vektörleri karşılaştırır. Belgeler aramadan önce kodlanabilir. Gelen her sorgunun kendi temsiline ihtiyacı vardır. Modele özgü sorgu ve belge prompt'ları veya rolleri, modelin getirim yapılandırmasını izlemelidir.2
Depolama ve arama davranışı ayrıca vektör veritabanına ve onun indeks yapılandırmasına bağlıdır. Model seçimi, vektör hassasiyeti, indeks ayarları ve getirim derinliği bir dağıtım planlarken ayrı kararlar olarak kalmalıdır. Daha geniş embedding model benchmark'ı bu on bir girişi ticari API modelleriyle aynı sorular üzerinde yan yana koyar.
Açık kaynak embedding modelleri benchmark metodolojisi
Her model, 200 dondurulmuş soru ve 225 kaydedilmiş ilgili soru-pasaj çiftiyle aynı pasajları aradı. Sorular ve ilgililik etiketleri, embedding puanları karşılaştırılmadan önce sabitlendi. Sorgu girdileri yalnızca orijinal soruyu içeriyordu.
Finans pasajları FinQA yıllık raporlarından, hukuki pasajlar ise CUAD v1 sözleşmelerinden alındı.34 Teknik destekte TechQA teknik notları, tıbbi literatürde ise MedRAG PubMed özetlerinin bir örneği kullanıldı.56
Pasajlar bütün paragraflar, bağlam içeren tablolar, sözleşme maddeleri veya başlıklı özetlerdi. all-MiniLM-L6-v2 tokenizer'ına göre 256 token'dan uzun birimleri hariç tuttuk ve kabul edilen pasajları olduğu gibi koruduk. 512 token'lık modeller pasaj başına en fazla 459 token aldı; bu nedenle bu değerlendirme kısa pasajları kapsar.
Frontier LLM'ler soruları kaynak pasajlardan taslak olarak oluşturdu. Bir ekip üyesi soruların %20'sini doğruladı (40 tanesi 200 sorunun). LLM'ler ayrıca her soru için BM25'in ilk 20 pasajını değerlendirdi, 25 ilgili pasajı orijinal 200 kaynak pasajına ekledi.
Getirim ve istatistiksel analiz
Her sorgu, kendi alanındaki her pasajla karşılaştırıldı. MultiQA, model kartıyla tutarlı olarak dot product kullandı.7 Diğer on model kosinüs benzerliği kullandı. BGE-M3 yoğun vektörlerini kullandı.1 Girdiler, her modelin yapılandırılmış getirim rollerini veya prefix'lerini kullandı.
Her iki metrik de sorular genelindeki ortalamalardır. %95 GA'yı 10.000 bootstrap örneğiyle hesapladık; her alandaki 50 soruyu yeniden örnekleyerek. Anlamlılık, her metrik ve kapsam için 231 çiftin tümünde, 22 model arasında Holm düzeltmesiyle birlikte tam benchmark'ın eşleştirilmiş işaret-çevirme testlerini kullanır. Farklar, 0.05 altındaki düzeltilmiş p-değerinde anlamlıdır.
Test edilen model kimlikleri, boyutlar ve girdi limitleri
Çalıştırmalar OpenRouter üzerinden, model başına sabit bir backend sağlayıcısıyla ve fallback'ler devre dışı bırakılarak yapıldı. Bunlar, bu çalıştırmalarda kullanılan API kimlikleri, çıktı boyutları ve girdi limitleridir.
API kimlikleri değişmez bir model anlık görüntüsünü garanti etmez. Tokenizer revizyonları sabitlendi ve barındırılan model ağırlıkları bağımsız olarak doğrulanmadı. Girdi limitleri benchmark yapılandırmasını tanımlar. Kısa pasajlar uzun bağlamlı getirimi test etmedi.
Karşılaştırmanın sınırları
Sorular, BM25 ile seçilmiş bir geliştirme seti oluşturur. Normal üretim sorgularındaki sonuçlar farklı olabilir. İlgililik değerlendirmeleri kaynak pasajlar ve BM25'in ilk 20 pasajıyla sınırlıydı. Bu on bir model genelinde, ilk onda getirilen farklı soru-pasaj çiftlerinin yaklaşık %85'i değerlendirilmemişti ve ilgililik kredisi almadı.
Her model bir kez çalıştırıldı. GA'lar soru örneklemesini yansıtır ve API çalıştırmaları arasındaki varyasyonu veya eksik etiketlerden kaynaklanan belirsizliği hariç tutar. Eğitim verisi kontaminasyonu test edilmedi.
Değerlendirme İngilizce metin getirimini kapsar. Çok dilli embedding iş yükleri ve çok modlu embedding modelleri ayrı kanıtlar gerektirir. Üretilen yanıt doğruluğu, hibrit getirim, yeniden sıralama, GPU belleği, yerel verim ve sunum maliyeti bu karşılaştırmanın dışındaydı.
Sonuç
PPLX Embed v1 4B ve 0.6B, on bir açık ağırlıklı model arasında en yüksek genel puanlara sahipti. Aralarındaki fark istatistiksel olarak anlamlı değildi. BGE Large en yüksek finans puanını kaydetti ve GTE Large kaydedilen tüm MedRAG pozitiflerini ilk on sonuç içinde getirdi.
Dağıtımdan önce hedeflenen sorgu setini test edin; yerel sunum hızını, bellek kullanımını ve maliyeti ölçün.
 Tercih edilen kaynak olarak ekle
Daha fazla okuma
- Embedding model benchmark'ı
- Çok dilli embedding modelleri, RAG için
- Açık kaynak vektör veritabanı benchmark'ı
- Vektör veritabanı boyutlandırma ve seçimi
Bu benchmarkı kaynak gösterin
Yayınlayacağınız yere uygun formatı seçin. Bağlantılı sürümü CMS'inize yapıştırmak, geri bağlantıyı korur.
@misc{sari2026,
  author = {Sarı, Ekrem},
  title  = {{Açık Kaynak Embedding Modelleri: Erişim için 11 Model Benchmark Edildi}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/open-source-embedding-models}},
  note   = {AIMultiple. Erişim tarihi: 26 Eylül 2026}
}66 veri noktasının sonuçları ve zaman damgaları. Bu makaledeki grafik ve tablolarda gösterilen özet verileri, 5 CSV dosyası ve bir README içeren ZIP dosyası olarak indirin.
Arkasındaki ayrıntılı veriyi ister misiniz? Premium'a katılın
Değişiklik günlüğü
4 güncelleme16 modelli Amazon yorumları Top-K karşılaştırması, 14 modelli CUAD, TechQA ve MedRAG nDCG@3 ve maliyet karşılaştırmasıyla değiştirildi.
Açık kaynak gömme modelleri karşılaştırmasına Lisans ve ticari kullanım eklendi.
Kıyaslama, beş ek açık kaynak modelini içerecek şekilde genişletildi.
Değerlendirme kurulumundaki donanım, toplu iş boyutu ve hassasiyet güncellendi.
Referans Linkleri





Yorum yapan ilk kişi olun
E-posta adresiniz yayınlanmayacak. Tüm alanlar gereklidir. Yorumlar orijinal dilinde bırakılır.