


LLM Fiyatlandırması: En İyi 15+ Sağlayıcı Karşılaştırması

Mart 2023'teki GPT-3.5 Turbo’dan en son sürümlere kadar 160'tan fazla LLM'nin lansman fiyatlarını boyut sınıfına göre gruplandırarak takip ediyoruz. Ayrıca mevcut model'lerin API fiyatlarını benchmark sonuçlarıyla karşılaştırıyor ve büyük sağlayıcıların abonelik planlarını inceliyoruz.
LLM lansman fiyat trendleri
- Claude Opus lansman fiyatları $30,00 (Opus 4.1, Ağustos 2025) seviyesinden $8,00 (Opus 5.5, Eylül 2026) seviyesine düştü.
- Claude Fable 5 Haziran 2026'da $20,00 fiyatla piyasaya sürüldü; bu, iki hafta önce çıkan Claude Opus 4.8’in fiyatının iki katıydı. OpenAI'nin GPT-6 Astra modeli ise Eylül ayında $20,00 ile onu takip etti.
- GPT-6 Sol Eylül 2026'da $4,00 fiyatla piyasaya sürüldü; bu, GPT-5.6 Sol'un Temmuz ayındaki $11,25 fiyatının %64 altındaydı. GPT-6 Luna ise $0,20 fiyatla çıktı; GPT-5.6 Luna için bu değer $2,25'ti.
- Küçük kapalı model'lerin medyan lansman fiyatı 2024'te $0,53 iken 2025'te $0,85'e yükseldi. 2026'da Gemini 3.5 ila 3.8 Flash, $3,00 ila $3,38 fiyatla çıktı.
- 2025'te büyük açık ağırlıklı model'lerin medyan lansman fiyatı, kapalı orta seviye model'lerin medyanının dörtte birinin altındaydı. Moonshot'ın Kimi K3 modeli Temmuz 2026'da $6,00 fiyatla çıktı; bu, Claude Sonnet 5'in $4,00 fiyatının üzerindeydi.
Fiyatlar milyon token başınadır; üç birim girdiye karşılık bir birim çıktı olacak şekilde harmanlanmıştır ve süre sınırlı promosyonları içermez. Açık ağırlıklı model'lerin ağırlıkları herkese açıktır; birinci taraf API'si olmayanlar için fiyat, lansman dönemindeki bir barındırma sağlayıcısının ücretidir. Yeni lansmanlar mevcut çeyreğin ortalamalarını yine değiştirebilir.
LLM API fiyat değerlendirmesi
Bir LLM için ödeme yapmanın iki yolu vardır: büyük sağlayıcıların abonelik planları ile sabit ücretli LLM fiyatlandırması veya token kullanımına göre faturalandırılan kullandıkça öde API modeli.
Benchmark sonuçlarını, gerçek dünya gecikme sürelerini ve fiyatlandırmayı görmek ve her model'in verimliliği ile maliyet etkinliğini değerlendirmek için model adlarına tıklayın.
Sıralama: Model'ler, tüm benchmark'lardaki ortalama konumlarına göre sıralanır.
En iyi LLM'lerin halüsinasyon oranlarını ve akıl yürütme performansını benchmark'larımızda kontrol edebilirsiniz.
LLM abonelik planlarını karşılaştırma
Teknik olmayan kullanıcılar API yerine arayüzü kullanmayı tercih edebilir. 2026'da çoğu sağlayıcının aboneliği bir sohbet arayüzünden çok daha fazlasını içeriyor. Claude Code, Codex, Kimi Code ve Mistral Vibe gibi kodlama ajanları Pro seviyesindeki planlarda sunuluyor. Geliştiriciler ve yoğun kullanıcılar için doğru $10–$200 seviyesindeki bir abonelik, ayrı bir kodlama IDE aboneliğinin, token başına API bütçesinin ve bir video veya araştırma aracının birleşiminin yerini alır.
OpenAI
Ücretsiz plan, GPT-5.6 Luna ile sınırsız günlük metin sohbetlerini, standart ses modunu, sınırlı yüklemeleri ve temel görüntü oluşturmayı içerir. Bağlamsal reklamlar, Ağustos 2026 itibarıyla ABD ve Avrupa'nın çoğu dahil olmak üzere yaklaşık 40 pazara ulaşmıştır ve yalnızca Free ve Go planlarında gösterilir.
- ChatGPT Go ($8/ay), reklam içerebilen düşük maliyetli bir plandır. Metin sohbetleri Free planda olduğu gibi sınırsızdır; yükseltme, dosya yüklemeleri, görüntü oluşturma, ses ve bellek için daha yüksek limitler satın alır ve tüm bunlar GPT-5.6 Luna üzerindedir.
- ChatGPT Plus ($20/ay), genişletilmiş kullanım limitleri, GPT-5.6 Sol, Terra ve Luna'ya erişim, gelişmiş ses modu, Codex ajanı, görüntü oluşturma ve erken erişim özellikleri içerir.
Pro planın Nisan 2026 itibarıyla iki seviyesi vardır:
- ChatGPT Pro ($100/ay) , $200 seviyesiyle aynı model yelpazesini (GPT-5.6 Sol dahil) yaklaşık 5x Plus kullanım limitleriyle sunar.
- ChatGPT Pro ($200/ay), en yüksek bireysel kullanım limitlerini (yaklaşık 20x Plus), maksimum Derin Araştırma hakkını, video ve ekran paylaşımlı gelişmiş sesi, maksimum kullanım artışına sahip Codex'i ve Sora'yı sağlar.
Her iki Pro seviyesi de yoğun saatlerde öncelikli erişim içerir. Plus, Pro ve Business planlarındaki Codex fiyatlandırması Nisan 2026'da mesaj başından API token kullanımına hizalanmış kullanıma geçti.
OpenAI'nin uzun süreli çok adımlı projeler için geliştirdiği ajanı ChatGPT Work (9 Temmuz 2026'da kullanıma sunuldu), ücretli planlara dahildir; Chat, Work ve Codex'i bir araya getiren masaüstü uygulaması, Free dahil her planda kullanılabilir.
- Business planı (yıllık $20/kullanıcı/ay veya aylık $25/kullanıcı/ay) OpenAI'nin küçük ve orta ölçekli ekipler için planıdır (eski adıyla ChatGPT Team, Ağustos 2025'te yeniden adlandırıldı). Daha yüksek mesaj limitleri, yönetici konsolu, SSO, eğitim dışı tutulan ekip verileri ve gelişmiş özellikler için paylaşılan kredi havuzları ekler. Dahil edilen uygulamalar: Paylaşılan çalışma alanı kredilerine sahip Codex. Yalnızca Codex koltukları 24 Haziran 2026'da yeni çalışma alanlarına kapatıldı; OpenAI, 5x Standart kullanımla yıllık $100/kullanıcı/ay (aylık $125) Premium koltuklar duyurdu. Plan en az 2 koltuk gerektirir.
- Enterprise planı (özel fiyatlandırma) yüksek hızlı model erişimi, genişletilmiş bağlam pencereleri, kurumsal düzeyde veri kontrolleri, alan adı doğrulama, analitik ve denetim günlükleri sağlar. Dahil edilen uygulamalar: Paylaşılan kredi havuzuna sahip Codex ve isteğe bağlı yalnızca Codex koltukları.
Anthropic (Claude)
Ücretsiz plan; web ve mobil erişimi, temel analizi, Claude Sonnet 5 ve Haiku'ya erişimi ve belge yüklemeyi içerir. Günlük kullanım sınırlıdır ve Opus ile Fable model'leri kullanılamaz.
- Pro planı ($20/ay veya yıllık faturalandırmada $17/ay) Free'ye kıyasla yaklaşık 5x daha fazla kullanım, proje organizasyonu ve yoğun saatlerde öncelikli erişimle Opus 5, Sonnet 5 ve Haiku'ya erişim sağlar. Fable 5, Pro kullanım limitlerinin bir parçası değildir; kullandıkça öde kullanım kredileri üzerinden API ücretleriyle faturalandırılır. Dahil edilen uygulamalar: Claude Code (Anthropic'in terminal ve IDE'deki kodlama ajanı), Cowork, Claude Design ve Claude for Microsoft 365; bunların tümü sohbetle aynı kullanım havuzunu paylaşır.
- Max 5x planı ($100/ay), Pro planına göre yaklaşık 5x daha fazla kullanım, en yeni özelliklere ve model'lere öncelikli erişim ve daha yüksek Max kullanım seviyesinde tam Claude Code erişimi sağlar.
- Max 20x planı ($200/ay) , Pro planına göre yaklaşık 20x daha fazla kullanım, maksimum öncelikli erişim ve tam Claude Code erişimi sağlar. Claude Code iş yüklerini çalıştıran günlük yoğun kullanıcılar için tasarlanmıştır. Her iki Max seviyesi de Anthropic'in en yüksek fiyatlı modeli olan Fable 5'i içerir; kullanımı planın haftalık kullanım limitinin yarısına kadarını tüketebilir.
Team planı iki koltuk türü sunar ve 2 ila 150 üyeyi destekler:
- Standart koltuk: Yıllık $20/kullanıcı/ay (aylık $25/kullanıcı/ay). Temel özellikleri, standart kullanım limitlerini ve Claude Code erişimini içerir.
- Premium koltuk: Yıllık $100/kullanıcı/ay (aylık $125/kullanıcı/ay). Standart'taki her şeyin yanı sıra daha yoğun Claude Code iş yükleri çalıştıran yoğun kullanıcılar için daha yüksek kullanım limitleri.
Dahil edilen uygulamalar: Claude Code ve Cowork, her Team koltuğuna (Standart ve Premium) dahildir; fark erişimde değil, kullanım hakkında yatmaktadır. Her iki koltuk türü de merkezi faturalandırma, işbirliği araçları ve yönetici kontrolleri içerir.
- Enterprise planı (self-serve seviyesinde $20/koltuk/ay artı API ücretleriyle kullanım; satışla özel fiyatlandırma) genişletilmiş bağlam pencereleri, SSO, alan adı yakalama, rol tabanlı erişim, SCIM, denetim günlükleri ve veri entegrasyonları sağlar. Dahil edilen uygulamalar: yeni ve self-serve Enterprise planlarında, Claude Code ve Cowork her koltuğa dahildir; eski Enterprise sözleşmeleri yalnızca Sohbet koltukları ile kullanıma dayalı faturalandırmaya sahip Sohbet + Claude Code koltukları arasında ayrım yapabilir.
Google (Gemini)
ücretsiz plan, Gemini 3.6 Flash erişimi ve Gemini 3.1 Pro'ya değişen düzeylerde erişim, temel görüntü oluşturma, Derin Araştırma, Gemini Live, Canvas ve Gems sunar. Dahil edilen uygulamalar: Gemini Notebook (eski adıyla NotebookLM) ve sınırlı Nano Banana Pro erişimine sahip Flow.
Google bölgesel fiyatlandırma uygular; bu nedenle fiyatlar bölgeye göre değişebilir.
- Google AI Plus (ABD'de $4,99/ay), 2x Free kullanım limitleriyle giriş seviyesindeki ücretli plandır. Dahil edilen uygulamalar: sohbette daha fazla Gemini 3.1 Pro erişimi, Nano Banana Pro ile görüntü oluşturma, Gemini Omni Flash ile video oluşturma, 200 Flow kredisi, daha fazla Sesli Özet içeren Gemini Notebook, Gmail, Docs ve Vids'te Gemini ve Chrome'da erken erişimli Gemini. 400 GB depolama alanı içerir.
- Google AI Pro (ABD'de $19,99/ay), 4x Free kullanım limitleri ve 5 TB depolama sağlar. Dahil edilen uygulamalar: Jules (asenkron kodlama ajanı), Google Antigravity (ajansal geliştirme platformu), genişletilmiş AI Studio limitleri, Google Cloud kredilerinde $40/ay, 5x Sesli Özet içeren Gemini Notebook, Derin Araştırma, 1.000 Flow kredisi, YouTube Premium Lite ve Google Home Premium (Standart plan).
- Google AI Ultra (ABD) 5x AI Pro kullanım limitleri için $99,99/ay veya 20x için $199,99/ay tutarındadır. Dahil edilen uygulamalar: Deep Think akıl yürütme, Gemini Agent (yalnızca ABD), Gemini Spark, Project Genie (etkileşimli dünya modeli), en yüksek limitlerde Jules, üst düzey Antigravity, 10.000 veya 25.000 Flow kredisi, Google Home Premium (Advanced planı) ve YouTube Premium bireysel aboneliği. Depolama alanı 20 TB'den başlar.
Microsoft Copilot
ücretsiz plan (Copilot Chat), uygun bir Microsoft 365 aboneliğine sahip tüm Microsoft Entra kullanıcıları için ek ücret olmadan kullanılabilir. Microsoft uygulamalarında, daha derin belge içi özellikler olmadan temel Copilot sohbetini içerir.
- Microsoft 365 Premium ($19,99/ay veya $199,99/yıl) artık tüketici Copilot planıdır. Office uygulamalarını, 6 TB'a kadar depolama alanını (altı kişiye kadar her biri için 1 TB) ve en yüksek tüketici Copilot limitlerini bir araya getirir; AI özellikleri yalnızca abonelik sahibi için geçerlidir. Eski Copilot Pro ($20/ay) yeni satın alımlara kapatılmıştır ve mevcut aboneler planı koruyabilir veya Premium'a geçebilir.
- Microsoft 365 Copilot Business (yıllık $21/kullanıcı/ay; 30 Eylül 2026'ya kadar yapılan satın alımlarda ilk yıl için $18/kullanıcı/ay; aylık $25,20/kullanıcı/ay), Microsoft 365 uygulamalarında Copilot, Teams entegrasyonu ve yönetici kontrolleri ekler. Dahil edilen uygulamalar: hafif ajanlar oluşturmak için Copilot Studio Lite, SharePoint'te Copilot ve ortak taslaklar için Copilot Pages. En fazla 300 kullanıcılı kuruluşlarla sınırlıdır.
- Microsoft 365 Copilot Enterprise (yıllık $30/kullanıcı/ay veya aylık faturalandırmada $31,50/kullanıcı/ay; uygun bir Microsoft 365 lisansı gerektirir), Business özelliklerine ek olarak gelişmiş güvenlik, uyumluluk ve analitik sağlar. Dahil edilen uygulamalar: Copilot Studio ile ajan oluşturma (iş verileri ve önceden oluşturulmuş ajanlar kullanıma göre ölçülebilir; bağımsız Copilot Studio ayrı satılır), BT ve güvenlik iş akışları için Microsoft Purview ve Intune'da Copilot ve dağıtılan ajanlar üzerinde yönetişim.
xAI (Grok)
ücretsiz plan, Grok'a sınırlı erişim sunar.
- SuperGrok Lite ($10/ay) giriş seviyesindeki ücretli plandır. 2x daha uzun konuşmalar, artırılmış hız limitleri ve AI görüntü ve video oluşturma içerir. Dahil edilen uygulamalar: Grok Build (xAI'nin uygulama geliştirme ajanı; Ağustos 2026'dan beri web'de ücretsiz) ve görüntü ve video üretimi için Grok Imagine.
- SuperGrok ($30/ay veya $300/yıl), Grok 4.6 ile gelişmiş akıl yürütme, 5x daha uzun konuşmalar, daha uzun dosya yüklemeleri, sesli sohbet için Ses modu ve HD 720p 30 saniyelik video dahil 20x daha fazla Grok Imagine görüntü ve video üretimi içerir.
- SuperGrok Plus ($100/ay), Grok Bot erişimi, 1080p video oluşturma, daha yüksek kullanım limitleri, daha hızlı yanıtlar ve öncelikli erişim ekler.
- SuperGrok Heavy ($300/ay), Plus'taki her şeyin yanı sıra paralel çalışma için bir ajan ekibi, maksimum hız limitleri, yaklaşan xAI özelliklerinin erken önizlemeleri ve bir X Premium+ aboneliği sağlar. Temmuz 2026'da xAI ayrıca Excel, Outlook ve Google Workspace eklentileri ile planlanmış Otomasyonlar yayımladı; Outlook eklentisi ve e-posta tetiklemeli Otomasyonlar ücretli kullanıcılara ayrılmış olmak üzere çoğu ücretsiz.
Grok ayrıca X aboneliklerine de dahildir: X Premium ($8/ay), X uygulamasında Grok'a giden en ucuz ücretli yoldur ve doğrulanmış statü ile azaltılmış reklamlar içerir. X Premium+ ($40/ay), X genelinde reklamları kaldırır ve tam içerik üreticisi para kazanma olanaklarının yanı sıra en yüksek Grok kullanım limitlerini taşır.
Moonshot AI (Kimi)
Kimi'nin tüketici planları, en yavaştan en hızlıya doğru müzikal tempo işaretlerinden adını alır. Uluslararası fiyatlandırma USD cinsindendir; Çinli kullanıcılar daha düşük ücretlerle CNY cinsinden öder. Ağustos 2026 itibarıyla yeni satın alımlar bekleme listesine alınmıştır. Fiyatlandırma sayfası, Kimi ve Kimi Code avantajlarını ayıran yaklaşan planları duyurur; Moonshot'ın Temmuz 20 tarihli duyurusu, K3 sürümünden dört gün sonra geciken lansman için bilgi işlem kapasitesi kısıtlarını gösterir. Mevcut aboneler planlarını korur ve yenileyebilir.
- Adagio (Ücretsiz), 6 ajan kullanımıyla sınırsız temel konuşma, sınırlı Derin Araştırma sorguları ve temel OK Computer ajan görevleri sağlar.
- Moderato ($19/ay), sohbet ve ajan görevlerinde Kimi K3 ile genişletilmiş Derin Araştırma oturumları ekler. Dahil edilen uygulamalar: Kimi Code (terminal öncelikli AI kodlama ajanı; 5 saatlik pencere başına tahmini 300 ila 1.200 istek, paylaşılan kredi havuzundan faturalandırılır) ayrıca Slides ve Websites yazma araçları.
- Allegretto ($39/ay), Moderato'daki her şeyde daha yüksek kullanım sağlar. Dahil edilen uygulamalar: Agent Swarm (paralel alt ajan orkestrasyonu, bu seviyede 4 adede kadar paralel alt görev), heterojen ajan grupları için kalıcı belleğe sahip Kimi Claw bulut dağıtımı ve Moderato'nun 2x ajan kredisi.
- Allegro ($99/ay), 5x ajan kredisi, 8 adede kadar paralel alt göreve sahip Agent Swarm ve 1M token bağlama sahip K3 sohbeti sağlar.
- Vivace ($199/ay), 10x ajan kredisi, 4 eşzamanlı görev, 8 adede kadar paralel alt göreve sahip Agent Swarm ve 1M token bağlama sahip K3 sohbeti sağlar; yoğun araştırma ve ajansal iş yüklerine yöneliktir.
Üyelik, üçüncü taraf kodlama araçlarında kullanılmak üzere Kimi Code API anahtarlarını içerir; ayrı Kimi Open Platform API'si token başına faturalandırılır.
MiniMax
MiniMax, M3 ve M2.7 model'lerinin üzerine tek bir birleşik Token Planı satar. Bu plan, 2026 ortasında daha önceki ayrı Agent kredi planları ile Coding Planının yerini aldı.
MiniMax Token Planı (ajanlar, kodlama ve multimodal çalışmalar için tek kota):
- Plus ($20/ay): 5 saatlik dönüşümlü ve haftalık kota pencereleri; paralel çalışan 3 ila 4 kodlama ajanı için yeterlidir; kişisel projeler ve prototip oluşturma içindir.
- Max ($50/ay): 4 ila 5 paralel ajan için aynı pencereler; ajanlarla günlük kodlama ve multimodal çalışmalar içindir.
- Ultra ($120/ay): 6 ila 7 paralel ajan; yoğun ajan iş akışları ve uzun oturumlar içindir.
- Kredi paketleri: 5.000 kredi için $5, 25.000 için $25, 100.000 için $100 (1.000 kredi = $1, 365 gün geçerli), herhangi bir planın üzerine kullanılabilir.
Token Planı, tüm model yelpazesini (M3, M2.7, görüntü ve konuşma) tek bir kotada kapsar; Cline veya Kilo Code gibi bir CLI ile eşleştirildiğinde, en uç noktadaki bir kodlama modeline giden en ucuz yollardan birini oluşturur.
Mistral AI
Mistral Vibe'ın (eski adıyla Le Chat) ücretsiz planı; web tarama, temel dosya analizi, görüntü oluşturma, sınırlı kodlama oturumları, 100+ bağlayıcı ve $10/ay değerinde API kredisi içerir.
- Pro planı ($14,99/kullanıcı/ay) daha fazla mesaj ve web araması, daha fazla genişletilmiş düşünme ve Derin Araştırma raporu, 15 GB belge depolama, 1.000'e kadar proje, görüntü oluşturma ve $30/ay değerinde API kredisi içerir. Dahil edilen uygulamalar: CLI, IDE veya web'de Mistral Vibe Code modu; dahil edilen kotanın üzerinde kullandıkça öde. Doğrulanmış öğrenciler Pro'yu $5,99/ay karşılığında alır.
- Team planı ($24,99/kullanıcı/ay), Pro'daki her şeyi kullanıcı başına 30 GB'a kadar depolama, merkezi faturalandırma, rol tabanlı erişim kontrolü, alan adı doğrulama ve veri dışa aktarma ile birlikte içerir. Dahil edilen uygulamalar: ekip kullanım seviyesinde Mistral Vibe ve paylaşılan yönetici kontrolleri.
- Enterprise planı (özel fiyatlandırma), self-hosted ve özel bulut dahil güvenli dağıtım seçenekleri, SAML SSO, denetim günlükleri, premium destek ve ayrıntılı analitik sağlar. Dahil edilen uygulamalar: düzenlemeye tabi iş yükleri için şirket içi dağıtım seçeneklerine sahip Mistral Vibe.
DeepSeek
DeepSeek geleneksel abonelik planları sunmaz. En yeni model'lere (şu anda DeepSeek V4-Flash ve V4-Pro) web ve mobil sohbet erişimi, adil kullanım kısıtlamasıyla tüm kullanıcılar için ücretsiz'dir.
API erişimi, 16 Ağustos 2026'dan beri yoğun ve yoğun olmayan saat ücretleriyle token başına ödemelidir. Yoğun olmayan saatlerde V4-Flash, milyon giriş tokeni başına $0,22 (cache miss) ve milyon çıkış tokeni başına $0,66 tutarındadır; yoğun saat ücretleri iki katıdır ($0,44 ve $1,32). V4-Pro yoğun olmayan saatlerde $0,66 ve $1,98 tutarındadır. Cache hit'ler, miss oranının yaklaşık %3'i kadardır ve yoğun saatler hafta içi 01:00-04:00 ile 06:00-10:00 UTC'dir.
DeepSeek ayrıca ajan araçları alanına da girmiştir. AI ajanları oluşturmak ve çalıştırmak için açık kaynaklı, eklenti tabanlı bir araç seti olan DeepSeek Harness, genel kaynak koduyla geliştirici önizlemesindedir. Kendine ait bir fiyatı yoktur ve model-agnostiktir; kullanım, ajanın çağırdığı modelin API'si üzerinden faturalandırılır.
Meta (Muse Spark)
Meta AI, Muse Spark tarafından desteklenerek (8 Nisan 2026'da kullanıma sunuldu, şu an 1.2 sürümünde) WhatsApp, Instagram, Facebook, Messenger, Meta AI uygulaması ve Ray-Ban Meta gözlüklerinde ücretsiz kalmaya devam ediyor. Meta, ücretli Meta One aboneliklerini sınırlı olarak test etmeye başladı. Plus ve Premium planları, aylık AI kullanım hakkını ve Thinking-mode erişimini artırır; bildirilen fiyatlar aylık $7,99 ve $19,99'dur.1
Meta Model API; herkese açık önizlemede olup self-serve ve OpenAI SDK uyumludur. Muse Spark 1.2 kullandıkça öde fiyatlandırması, 1M token bağlam penceresiyle milyon giriş tokeni başına $1,25 ve milyon çıkış tokeni başına $4,25'ten başlar. Bir terminal kodlama ajanı olan Muse Code, 5 Ağustos 2026'da beta olarak yayımlandı.
LLM fiyatlandırmasını anlama
Token'lar: Fiyatlandırmanın Temel Birimi
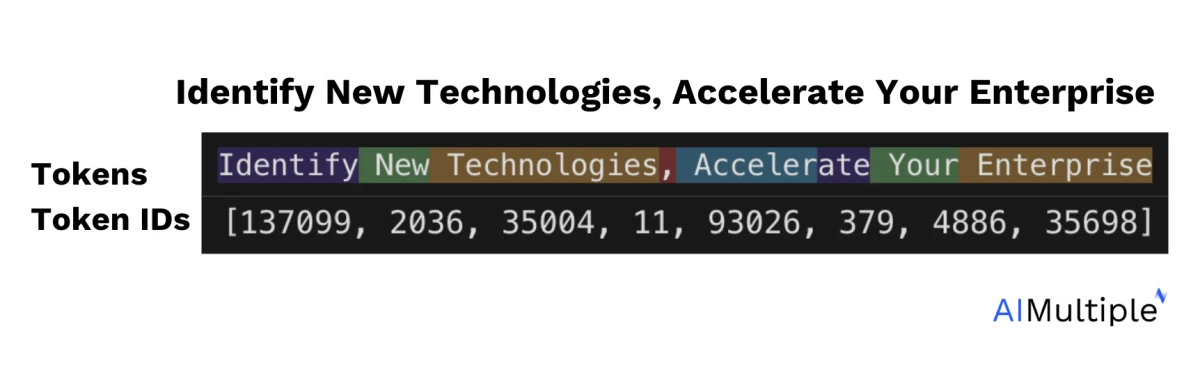
Şekil 1: GPT-4o & GPT-4o mini tokenizer kullanılarak "Identify New Technologies, Accelerate Your Enterprise" cümlesi için tokenleştirme örneği.2
Sağlayıcılar çeşitli fiyatlandırma yapıları sunsa da en yaygın olanı token başına fiyatlandırmadır. Tokenleştirme yöntemleri model'lere göre değişir; örnekler şunlardır:
- Byte-Pair Encoding (BPE): Kelimeleri sık kullanılan alt kelime birimlerine böler; sözcük dağarcığı boyutu ile verimliliği dengeler.3
- Örnek: “unbelievable” → [“un”, “believ”, “able”]
- WordPiece: BPE'ye benzer ancak dil modeli olasılığı için optimize edilmiştir; BERT'te kullanılır.4
- Örnek: “tokenization” → [“token”, “##ization”]. “token” bağımsız bir kelimedir; “##ization” bir sonektir.
- SentencePiece: Metni boşluklara dayanmadan tokenleştirir; T5 gibi çok dilli model'ler için etkilidir.5
- Örnek: “natural language” → [” natural”, ” lan”, “guage”] veya [” natu”, “ral”, ” language”].
Lütfen tam alt kelimelerin eğitim verilerine ve BPE/WordPiece sürecine bağlı olduğunu unutmayın. Bu tokenleştirme yöntemlerini daha iyi anlamak için aşağıdaki videoyu izleyin:
Tokenleştirme kavrandıktan sonra proje token uzunluğuna göre ortalama bir fiyat tahmin edilebilir. Tablo 2; UI prompt'ları, e-posta parçacıkları, pazarlama blogları, ayrıntılı raporlar ve araştırma makaleleri dahil olmak üzere içerik türüne göre token aralıklarını özetler ve token sayılarının model'ler arasında değiştiğini belirtir. Bir model seçildikten sonra içeriğin ortalama token sayısını tahmin etmek için modelin tokenizer'ı kullanılabilir.
Tablo 2: Tipik içerik türleri, boyut aralıkları ve kurumsal hususlar (aralıklar tahminidir ve değişebilir).
Bağlam penceresi etkileri
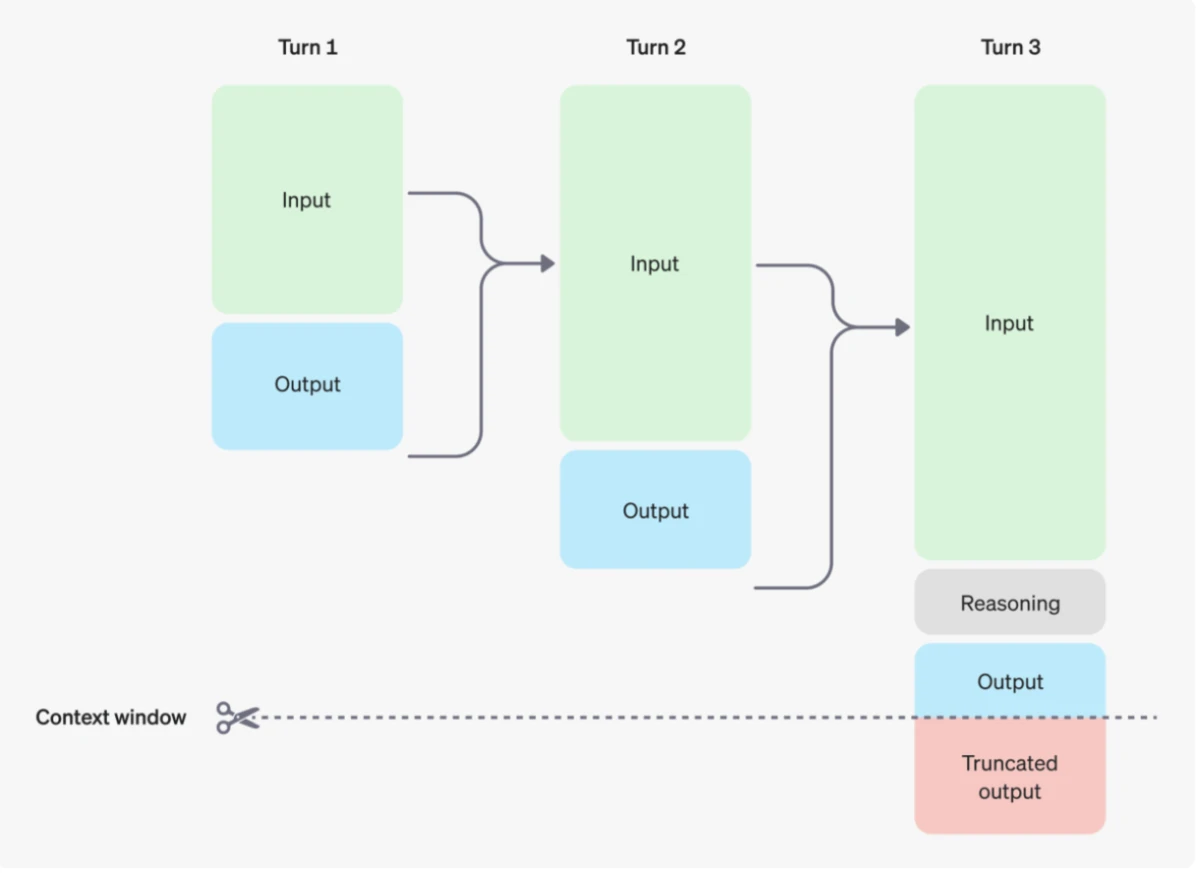
Bağlam penceresi; akıl yürütme model'lerinin düşünce zinciri akıl yürütmesi için kullandığı token'lar da dahil olmak üzere, çağrı başına giriş ve çıkış token'ı sayısına kesin bir sınır koyar. Toplam bu sınırı aşarsa yanıt kesilir veya istek doğrudan başarısız olur.
Şekil 2: Çok turlu bir konuşmada çıktının kesilmesine yol açan bağlam penceresi sınırlamalarının gösterimi.6
Uzun konuşmaları sürdüren uygulamalarda her ek tur, girdiye daha fazla geçmiş ekler. Müdahale edilmezse giriş token'ları konuşma uzunluğuyla doğrusal olarak artar ve faturalar da aynı şekilde büyür. API kullanıcıları bu durumu genellikle üç yoldan biriyle ele alır:
- Prompt caching. OpenAI, Anthropic, Google ve DeepSeek, tekrarlanan prompt öneklerini sunucu tarafında önbelleğe alır ve cache hit'leri standart giriş ücretinin küçük bir bölümü üzerinden faturalandırır; tipik olarak cache-miss fiyatının yüzde 3 ila 10'u kadardır. Uzun bir sistem prompt'unu veya konuşma önekini yeniden kullanan uygulamalarda caching, girdi maliyetini bir mertebe düşürebilir.
- Kayan pencere veya retrieval-augmented generation (RAG). Eşik aşıldığında en eski turları bırakın veya her çağrıda yalnızca ilgili geçmiş mesajları bir vektör deposundan getirin.
- Özetleme. Eski turları kelimesi kelimesine yeniden göndermek yerine düzenli aralıklarla bir özete dönüştürün.
Kodlama oturumları veya derin araştırma gibi ajansal iş yükleri için modern kodlama ajanları bu durumu oturum içinde otomatik olarak yönetir. Örneğin Claude Code, bağlam sıkıştırma ile birlikte gelir: konuşma sınıra yaklaştığında, yakın turları olduğu gibi tutarken eski mesajları özetleyip yoğunlaştırılmış bir sürüme dönüştürür. Sonraki turlar yalnızca özet ile yakın bağlamı modele geri gönderir.
Fiyatlandırma etkisi doğrudandır. Token başına API'lerde sıkıştırma, her çağrının girdisinin ne kadar büyüyeceğini sınırlar; caching ise tekrarlanan önekin fiyatını düşürür, böylece tur başına maliyet uzun oturumlar boyunca öngörülebilir kalır. Claude Pro, ChatGPT Plus veya Kimi Moderato gibi sabit ücretli aboneliklerde sıkıştırma, her çağrı daha az bağlam taşıdığı için günlük ve haftalık kullanım limitlerini genişletir. Aksi takdirde 5 saatlik hız limitini hızla tüketecek bir kodlama oturumu, eski turlar sıkıştırıldığında daha uzun sürebilir.
Buradaki ödünleşim, her tür özetlemenin kayıplı olmasıdır. Özet, daha sonra önemli olduğu ortaya çıkabilecek ayrıntıları atabilir ve kullanıcıyı bunları yeniden sağlamak zorunda bırakabilir
Maksimum çıkış token'ları
Maksimum çıkış token'ları, bir modelin yanıtının uzunluğunu sınırlar. Birçok dokümantasyon `max_tokens` parametresi kullanılarak ayarlanabileceğini belirtse de doğru parametreyi belirlemek için kullanılan API'nin dokümantasyonunu incelemek çok önemlidir. Belirli ihtiyaçlara göre ayarlanmalıdır:
Çok düşük ayarlanırsa, eksik çıktılara yol açarak modelin tam yanıtı vermeden yanıtları kesmesine neden olabilir.
Çok yüksek ayarlanırsa, yanıt yaratıcılığını kontrol eden bir parametre olan sıcaklığa bağlı olarak gereksiz derecede uzun çıktılara, daha uzun yanıt sürelerine ve artan maliyete yol açabilir.
Bu nedenle çıktı kalitesi, maliyet ve performansı dengelerken kaynak kullanımını optimize etmek için dikkatli değerlendirme gerektiren bir parametredir.
Tablo 3: İçerik türü başına örnek giriş prompt'ları ve tahmini token sayıları.
*Bu, her model için giriş ve çıkış token sayısı modelin tokenleştirmesine bağlı olarak değişebilse de her modelin eşit sayıda çıkış token'ı içeren yanıtlar ürettiğini varsayar; sayı burada her model için sabit tutulmuştur.
Tablo 2'deki token aralıklarını bir modelin token başına ücretleriyle birleştirmek, içerik türü başına beklenen maliyeti verir; Tablo 3'teki örnek prompt'lar, bu tahminlerin arkasındaki giriş ve çıkış boyutlarını gösterir.
Birden fazla dil modeli kullanma
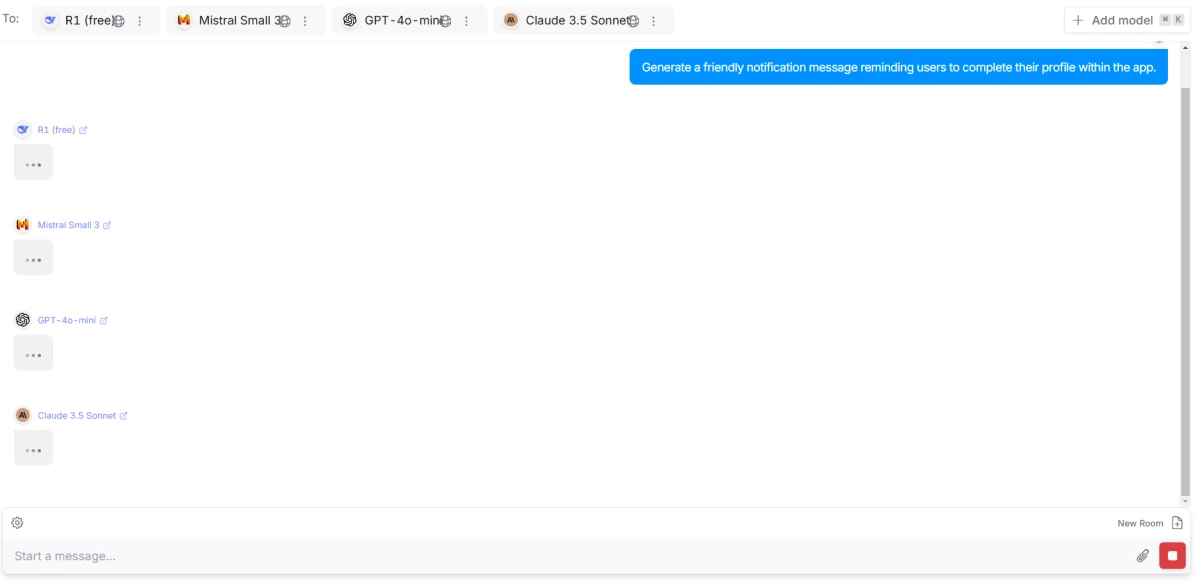
Bir AI gateway, örneğin OpenRouter, aynı prompt'un aynı anda birden fazla modele gönderilmesine olanak tanır. Yanıtlar, token tüketimi, yanıt süresi ve fiyatlandırma daha sonra karşılaştırılarak görev için en uygun modelin hangisi olduğu belirlenebilir.
Şekil 3: OpenRouter aracılığıyla birden fazla Large Language Model'e gönderilen bir prompt'u gösteren arayüz.7
Faydalar ve zorluklar
- Artırılmış uyarlanabilirlik ve verimlilik: Orkestrasyon, yanıt verme yeteneğini artırır; model verimliliğinin gerçek zamanlı değerlendirilmesini sağlar ve maliyet etkin bir model ile potansiyel tasarrufları belirler.
- Prompt duyarlılığı ve optimizasyon: Aynı prompt'lar model'ler arasında büyük ölçüde farklı çıktılar üretebilir; bu da istenen sonuçları elde etmek için her modele göre uyarlanmış prompt engineering gerektirir ve geliştirme ile bakım karmaşıklığını artırır.
Fiyatlandırma mekaniği ve gizli maliyetler
Akıl yürütme token'ları ile çıkış token'ları
Giderek daha fazla sağlayıcı, içsel düşünce zinciri akıl yürütmesi gerçekleştirmek için ek hesaplama harcayan akıl yürütme model'lerini piyasaya sürdü. OpenAI, Anthropic ve Google bu akıl yürütme token'larını modelin standart çıkış ücreti üzerinden çıkış token'ları olarak faturalandırır; bu nedenle maliyet artışı daha yüksek token başına fiyattan değil, hacimden kaynaklanır.
GPT-5.5 Pro, genişletilmiş düşünmeye sahip Claude Opus 5 veya Gemini 3.1 Pro Deep Think gibi model'ler, siz açıkça istemeseniz bile dahili akıl yürütme izleri üretir
Bu dahili token'lar faturanıza yansır ve özellikle hukuki inceleme, veri analizi veya çok adımlı akıl yürütme gibi uzun analitik görevlerde maliyeti önemli ölçüde artırabilir.
Bu nedenle şunlar önemlidir:
- Doğruluk, maliyetten önemli ölçüde ağır bastığında bir akıl yürütme modeli seçin.
- Mümkün olduğunda düşünce zincirini devre dışı bırakın veya daha kısa bir maksimum çıkış token sayısı belirleyin.
- Aynı görevi akıl yürütme içermeyen model'lerde test ederek performansın çok daha düşük bir fiyata karşılaştırılabilir olup olmadığını görün.
Bir akıl yürütme modeli, aynı prompt'un akıl yürütme olmadan üreteceğinden 10 ila 30 kat daha fazla çıkış token'ı üretebileceğinden, maliyet planlaması için bu ayrımı anlamak kritik önem taşır.
Mimari kaynaklı fiyatlandırma farkları
LLM mimarileri model verimliliğini ve dolayısıyla API fiyatlandırmasını doğrudan etkiler. Örneğin:
- Mixture-of-Experts (MoE) model'leri istek başına parametrelerin yalnızca bir alt kümesini etkinleştirir; bu, hesaplama maliyetini düşürür ve sağlayıcıların daha düşük token başına ücretler sunmasına olanak tanır.
- Spekülatif decoding, daha küçük bir taslak modeli daha büyük bir modelle eşleştirir; deterministik görevlerde aktarım hızını artırır ve maliyeti düşürür.
- Nicemlenmiş varyantlar (ör. 4-bit veya 8-bit), daha düşük hassasiyette inference gerçekleştirebilir; yerel dağıtılan veya bulutta barındırılan sürümler için daha düşük fiyatlandırma sağlar.
Bu mimari seçimleri anlamak, kullanıcıların yalnızca fiyatlandırma farklarını değil aynı zamanda gecikme süresini, kaliteyi ve bir modelin üretim iş yükleri altında nasıl ölçeklendiğini tahmin etmesine yardımcı olur.
API ücretlerinin ötesindeki operasyonel maliyetler
Token başına fiyatlandırma birincil maliyet unsuru olsa da birçok üretim dağıtımı API kullanımının ötesinde ek maliyetler doğurur:
- Embedding'ler ve vektör veritabanları: Vektörlerin depolanması ve getirilmesi (ör. Pinecone, Weaviate, ChromaDB) sorgu başına ve GB depolama başına maliyet ekler.
- Yeniden sıralama ve son işleme model'leri: Birçok uygulama, daha büyük modele son isteği göndermeden önce özetleme, filtreleme veya sınıflandırma için daha küçük model'ler kullanır.
- Caching katmanları: OpenAI gibi sağlayıcılar artık prompt düzeyinde caching sunar, ancak yerel caching altyapısı ek hesaplama gerektirebilir.
- Günlük kaydı, izleme ve denetim: Kuruluşlar genellikle token düzeyinde izleme, gecikme takibi ve güvenlik denetimleri için maliyet üstlenir.
Bu gizli maliyetler çoğunlukla toplam LLM operasyonel giderlerinin 20–%40'ını oluşturur ve fiyatlandırma yapıları değerlendirilirken dikkate alınmalıdır.
 Tercih edilen kaynak olarak ekle
Kurumsal fiyatlandırma hususları
Birçok LLM satıcısı, kurumsal düzeyde güvenlik ve uyumluluk özellikleri için ek ücret talep eder; örneğin:
- Tek kiracılı dağıtımlar
- Adanmış GPU kümeleri
- Geliştirilmiş SLA'lar (ör. çalışma süresi, gecikme garantileri)
- Veri ikameti ve bölgesel kontroller
- SOC2, HIPAA veya GDPR uyumluluk modları
Bu teklifler maliyetleri önemli ölçüde artırabilir ancak sağlık, finans, hukuk hizmetleri ve kamu kurumları gibi düzenlemeye tabi sektörler için zorunludur.
LLM fiyatlandırmasında gelecek trendleri
2025 LLM fiyatlandırmasını üç şey tanımladı: genel amaçlı model'ler ucuzladı, neredeyse her büyük sağlayıcı bir sohbet aboneliği başlattı ve akıl yürütme model'leri pahalı kalmaya devam etti. Fark yapısaldır ve muhtemelen açılacaktır: bir milyon çıkış token'ı DeepSeek V4-Flash'te (yoğun olmayan saat) $0,66, GPT-5.5 Pro'da ise $180 tutarındadır. 2026 ve sonrası için ilginç sorular bu tabanın üzerine neyin kayacağıyla ilgilidir.
Token başına faturalandırma, görev başına fiyatlandırmaya dönüşüyor
Ajanlar artık yoğun LLM kullanımının çoğunu yönlendiriyor. Claude Code ile tek bir kodlama görevi, Cowork ile bir araştırma çalışması veya Operator ile otonom bir tarama oturumu yüzlerce sıralı model çağrısı yapabilir. Token faturalandırması hem alıcı hem de satıcı için öngörülemez hale gelir.
Buna karşılık sağlayıcılar token sayaçlarından görev ve oturum kotalarına geçiyor. Moonshot, paylaşılan kredi havuzundan 5 saatlik pencere başına 300 ila 1.200 Kimi Code isteği tahmin ediyor. Claude Code, kullanımı mesaj başına değil 5 saatlik oturum başına sınırlar. MiniMax, Token Planı kotalarını paralel kodlama ajanı sayısına göre boyutlandırılmış 5 saatlik dönüşümlü ve haftalık pencereler olarak belirler. Kimi, paralel Agent Swarm alt ajanları için seviyeye özel sınırlar koyar.
OpenClaw ve MaxHermes gibi sağlayıcılar arası ajan koşumları bunu daha da ileri taşır. Bunlar kullanıcılar ile birden fazla model API'si arasında yer alır ve fiyatlandırmaları milyon token başına değil, giderek daha fazla görev başına aktarım hızını izler. Önümüzdeki yıl içinde daha fazla sağlayıcının görev başına veya oturum başına SKU'lar yayımlamasını bekleyin.
Küçük akıl yürütme model'leri cihaza taşınıyor
Apple Intelligence, rutin sorgular için cihaz üzerinde inference çalıştırır; yalnızca karmaşık isteklerde Private Cloud Compute'a geri döner. Microsoft Copilot+ PC'ler yerel bir model ile birlikte gelir. Pixel cihazlar Gemini Nano'yu çalıştırır. Microsoft'un Phi-4 ve Google'ın Gemma 3 gibi yeni küçük model'ler, bir telefon veya dizüstü bilgisayarın sinirsel işlem birimine sığan boyutlarda akıl yürütme yeteneğine sahiptir.
Fiyatlandırma açısından sonuç iki seviyeli bir tüketici pazarıdır. Rutin işler, cihaz üzerinde marjinal token ile ücretsiz çalışır. Bulut abonelikleri, yerelin yapamadıkları üzerinde rekabet eder: uç noktada akıl yürütme, geniş bağlam, multimodal üretim ve ajan orkestrasyonu. free-yerel taban, yalnızca sohbet içeren abonelikleri sıfıra doğru iter ve ödeme yapmanın asıl nedeni olarak paketlenmiş uygulamaları bırakır.
Uzun bağlam ve bellek, ajansal işi kimin kazanacağını belirler
Uzun vadeli ajansal görevler, model'ler önceki talimatları kaybettiğinde veya hatırlaması gereken olguları halüsinasyon olarak uydurduğunda başarısız olur. Sürdürülebilir ajansal çalışma üç şeye bağlıdır: geniş bir bağlam penceresi, kalıcı bellek ve düşük halüsinasyon oranı.
Bir yıl içinde üç uç yetenek başlangıç seviyesine doğru geriledi. Claude Opus 5, Gemini 3.1 Pro, GPT-5.6 ve Kimi K3, 1M token bağlam pencereleri sunar. OpenAI, Anthropic, Google ve DeepSeek üzerinde cache hit maliyetleri, cache miss'lerin yüzde 3 ila 10'u kadardır. ChatGPT ve Claude artık ücretsiz seviyelerinde kalıcı bellek içeriyor.
Bu pazarın üst ucunda uzmanlaşmış ajansal model'ler ortaya çıkıyor. Haziran 2026'da Anthropic, genel kullanıma açık bir Mythos sınıfı model olan Claude Fable 5'i piyasaya sürdü8; fiyatı milyon token başına giriş için $10, çıkış için $50 olup Opus 5 ücretinin iki katıdır. Fable 5; ajansal kodlama, bilgisayar kullanımı ve uzun vadeli araştırmayı hedefler. Bazı alanlarda koruyucu kısıtlamaları kaldırılmış aynı model olan Claude Mythos 5 ise aynı fiyatla yalnızca onaylı ortaklarla sınırlıdır.
Rekabet sorusu "bağlam penceresi ne kadar büyük" olmaktan çıkıp "model uzun bir ajansal görevi ne kadar ucuza ve güvenilir şekilde sürdürebilir?" sorusuna kayıyor. Bu sorunu iyi çözen sağlayıcılar prim elde edecek. Çözemeyenler, başlıktaki token fiyatına bakılmaksızın ajansal iş yüklerini kaybedecek.
SSS'ler
Large Language Models (LLM'ler)'e bir Application Programming Interface (API) aracılığıyla erişmek, AI model'lerine uzaktan erişim sağlar. Bu erişim, hizmet sağlayıcı tarafından talep edilen ve genellikle "API ücreti" olarak adlandırılan bir ücrete tabidir. Bu ücret, LLM'leri uygulamalarınıza entegre ederken kritik bir husustur.
Sağlayıcının API'si aracılığıyla gerçekleştirilen her sorgu, istek veya görevle ilişkili maliyeti temsil eder. Fiyatlandırma yapıları (token kullanımı, API çağrı hacmi, özellik kullanımı veya abonelik modelleri gibi faktörlere bağlı olarak) büyük ölçüde değişebildiğinden, sağlayıcıların bu maliyetleri nasıl hesapladığını anlamak çok önemlidir.
LLM API fiyatlandırması; token tüketimi, bağlam uzunluğu ve model seçimi gibi faktörler nedeniyle karmaşık olabilir. Tokenleştirme prosedürleri model'lere göre değişir; bazıları Byte-Pair Encoding (BPE), WordPiece veya SentencePiece kullanır ve her biri metnin token'lara nasıl bölündüğünü etkileyerek maliyet verimliliğini değiştirir. Bu farkları anlamak, API kullanımını ve fiyatlandırmasını optimize etmeye yardımcı olur.
LLM maliyetleri öncelikle token kullanımı (hem giriş hem çıkış), API çağrı hacmi ve fiyatlandırma modeli (ör. token başına veya abonelik) tarafından belirlenir.
Giriş ve çıkış token fiyatlarını, bağlam penceresi limitlerini ve ek ücretleri karşılaştırın. OpenRouter gibi araçlar, aynı prompt'u birden fazla modele gönderip sonuçları, token kullanımını, hızı ve fiyatlandırmayı doğrudan karşılaştırmanıza olanak tanır. Genel maliyetleri tahmin etmek için tipik içerik uzunluğunuzu ve kullanım düzenlerinizi göz önünde bulundurun.
Giriş token'ları, LLM'e gönderdiğiniz prompt içindeki token'lardır; çıkış token'ları ise üretilen yanıttaki token'lardır. Akıl yürütme model'lerinde akıl yürütme süreci sırasında üretilen token'lar da çıkış token'ı olarak sayılır ve nihai maliyeti etkiler. Hem giriş hem çıkış, toplam maliyete katkıda bulunur.
Daha büyük metin istekleri daha fazla işlem gerektirir; yanıt süresini ve maliyetleri artırır. Token sayılarını tahmin etmek ve bütçenizi etkili şekilde yönetmek için giriş boyutlarını optimize edin ve bir LLM API fiyatlandırma hesaplayıcısı kullanın.
LLM topluluğu, kullanıcıların LLM fiyatlandırmasını anlamasına ve optimize etmesine yardımcı olmak için çeşitli araçlar ve benchmark'lar geliştirmiştir. Bu kaynaklar genellikle farklı model'lerin gücü ve verimliliği hakkında içgörüler sunan hesaplayıcılar ve karşılaştırma çizelgeleri içerir.
Hugging Face ve GitHub gibi platformlar, topluluk tarafından model performansını ve maliyetleri analiz etmek için geliştirilen araçları ve kodları barındırır. Birçok hizmet, forumlar veya sohbet özellikleri aracılığıyla topluluk desteği sunar.
Bu araştırmayı kaynak gösterin
Yayınlayacağınız yere uygun formatı seçin. Bağlantılı sürümü CMS'inize yapıştırmak, geri bağlantıyı korur.
@misc{dilmegani2026,
  author = {Dilmegani, Cem},
  title  = {{LLM Fiyatlandırması: En İyi 15+ Sağlayıcı Karşılaştırması}},
  year   = {2026},
  month  = aug,
  howpublished    = {\url{https://aimultiple.com/llm-pricing}},
  note   = {AIMultiple. Erişim tarihi: 26 Ağustos 2026}
}284 veri noktasının sonuçları ve zaman damgaları. Bu makaledeki grafik ve tablolarda gösterilen özet verileri, 6 CSV dosyası ve bir README içeren ZIP dosyası olarak indirin.
Arkasındaki ayrıntılı veriyi ister misiniz? Premium'a katılın
Değişiklik günlüğü
8 güncellemeGirişteki grafik açıklamasını güncelledi.
LLM fiyatlandırma türleri bölümüne bir grafik eklendi.
LLM fiyatlandırmasını anlama bölümü kaldırıldı.
Uzun konuşmalarda jeton kullanımını yönetme stratejileriyle "Bağlam penceresi etkileri" bölümü genişletildi.
OpenAI bölümüne ChatGPT Go eklendi.
Referans Linkleri




Yorumlar 1
Düşüncelerinizi Paylaşın
E-posta adresiniz yayınlanmayacak. Tüm alanlar gereklidir. Yorumlar orijinal dilinde bırakılır.
"Really well-written and timely article! Your analysis of how different large language model (LLM) providers compare - based on token pricing, context window, and performance - really helps demystify an often opaque cost structure. I found the detailed breakdown of token-based billing (input vs output tokens), context-window implications, and the built-in “price calculator” particularly useful for anyone trying to realistically estimate LLM usage