


Embedding Models: 25 Model Retrieval için Kıyaslandı

Finans, hukuk sözleşmeleri, teknik destek ve tıbbi literatür genelinde 25 embedding model'ini 200 retrieval sorusu üzerinde kıyasladık. Dört korpus toplamda 341.040 metin pasajı içeriyordu. Her sorgu kendi alanında arama yaptı.
Embedding Models kıyaslama sonuçları
nDCG@10, kaydedilen ilgili pasajların ilk on sonuçta ne kadar üst sırada göründüğünü ölçer. Puanlar 0 ile 1 arasında değişir; daha yüksek değerler daha iyi yerleşimi ödüllendirir.
Recall@10, her sorunun kaydedilen ilgili pasajlarının ilk on sonuç içinde getirilme oranını ölçer ve sorular genelinde ortalaması alınır. Üretilen yanıt doğruluğu bu değerlendirmenin dışındaydı.
%95 güven aralıkları (CI'lar), soru örneklemesinden kaynaklanan ortalama nDCG@10 belirsizliğini tahmin eder. Daha geniş aralıklar daha az kesin tahminleri gösterir.
Sorular, BM25 ilk on sonucunda yanıtlayıcı pasajlarını kaçırdığı için seçildi. Sıfır puanı bu seçimi yansıtır ve olağan trafikte anahtar kelime erişimiyle karşılaştırmaları sınırlar.
25 modelde retrieval bulguları
Voyage 4 Large en yüksek nDCG@10 değerini 0.851 olarak kaydetti
%95 CI'sı 0.817–0.884 idi. Eşleştirilmiş testler, çoklu karşılaştırmalar için düzeltme yapıldıktan sonra Cohere Embed 5 Pro, Cohere Embed 5 Fast, Gemini Embedding 2, Voyage 4 veya Gemini Embedding 001 ile anlamlı bir fark bulmadı. Sıralama belirsizliğini koruyor. Anlamlı olmayan bir sonuç eşit performansı kanıtlamaz.
Cohere Embed 5 Pro ve Fast, Embed v4.0'dan anlamlı ölçüde daha yüksek puan aldı
Pro 0.850, Fast ise 0.839 puan aldı; 0.772 ise Cohere Embed v4.0 içindi. Elde ettikleri 0.078 ve 0.067 nDCG@10 kazanımları, tüm 300 model çifti için düzeltme sonrasında anlamlıydı. Pro ile Fast arasındaki 0.010 fark anlamlı değildi.
Gemini Embedding 2 en yüksek Recall@10 değerini %96,50 olarak kaydetti
Cohere Embed 5 Pro %95,88 ile, Voyage 4 ise %95,83 ile takip etti. Düzeltme sonrasında Gemini Embedding 2'den farkların hiçbiri anlamlı değildi. İlgili bir pasajı beşincilikten birinciliğe taşımak, recall'ı değiştirmeden nDCG'yi iyileştirir.
PPLX Embed v1 4B açık ağırlıklı model'ler arasında 0.741 nDCG@10 ile liderdi
PPLX Embed v1 0.6B 0.698 ile takip etti. 4B modeli, diğer on açık ağırlıklı modelin dokuzundan anlamlı ölçüde daha yüksek puan aldı. 0.6B ile farkı anlamlı değildi. Açık kaynak embedding model karşılaştırması bu alt kümeyi kapsar.
Finans, sözleşmeler, destek ve tıp için alan sonuçları
Her alandaki en yüksek altı nDCG@10 puanı. Her filtre, tamamlanan model'leri o alanın 50 sorusu üzerinde yeniden sıralar.
Her alan genel ortalamaya eşit katkıda bulunur. Cohere Embed 5 Fast 0.762 ile en yüksek CUAD puanını, Pro ise 0.894 ile en yüksek TechQA puanını kaydetti. MedRAG, her modelin en yüksek nDCG@10 puanını üretti. Alan başına 50 soru ile bu puanlardaki küçük farklar belirsizliğini koruyor.
Embedding maliyeti ve retrieval kalitesi
Her model için API üzerinden aynı 341.040 pasajı ve 200 sorguyu embedding yapmanın maliyetini hesapladık.
PPLX Embed v1 0.6B, $0,13 ile en düşük embedding maliyetine sahipti ve 0.698 nDCG@10 puan aldı. Voyage 4 Lite $0,62 maliyete sahipti ve 0.793 puan aldı. $1,87 maliyetle Voyage 4 0.829 puana ulaştı.
Cohere Embed 5 Fast $2,52 maliyete sahipti ve 0.839 puan aldı; Pro ise $3,40 maliyete sahipti ve 0.850 puan aldı. Fast'in embedding maliyeti bu iş yükünde %26 daha düşüktü. Çoklu karşılaştırmalar için düzeltme sonrasında retrieval puanları arasındaki fark istatistiksel olarak anlamlı değildi.
Voyage 4 Large $3,74 maliyete sahipti ve 0.851 ile en yüksek puanı kaydetti. Gemini Embedding 2 $6,68 ile en yüksek maliyete sahipti ve 0.830 puan aldı. Embedding'lere daha fazla harcamak bu testte sürekli olarak daha yüksek retrieval puanı üretmedi.
Maliyetler, değerlendirmede kullanılan başarılı embedding çağrılarını kapsar. Cohere toplamları, kaydedilen tarife ile çarpılan raporlanan girdi token'larını kullanır. Embed v4.0'ın $3,72 maliyeti bir tahmindir çünkü doğrudan API tarifesi doğrulanmamıştır. Yeniden denemeler, tanılama, hesap ücretleri, depolama ve arama hesaplaması hariçtir. Bu tutarlar test edilen iş yükünü ve API rotalarını tanımlar. Üretim maliyetleri metin hacmine, tokenizasyona ve sağlayıcı fiyatlandırmasına bağlı olacaktır.
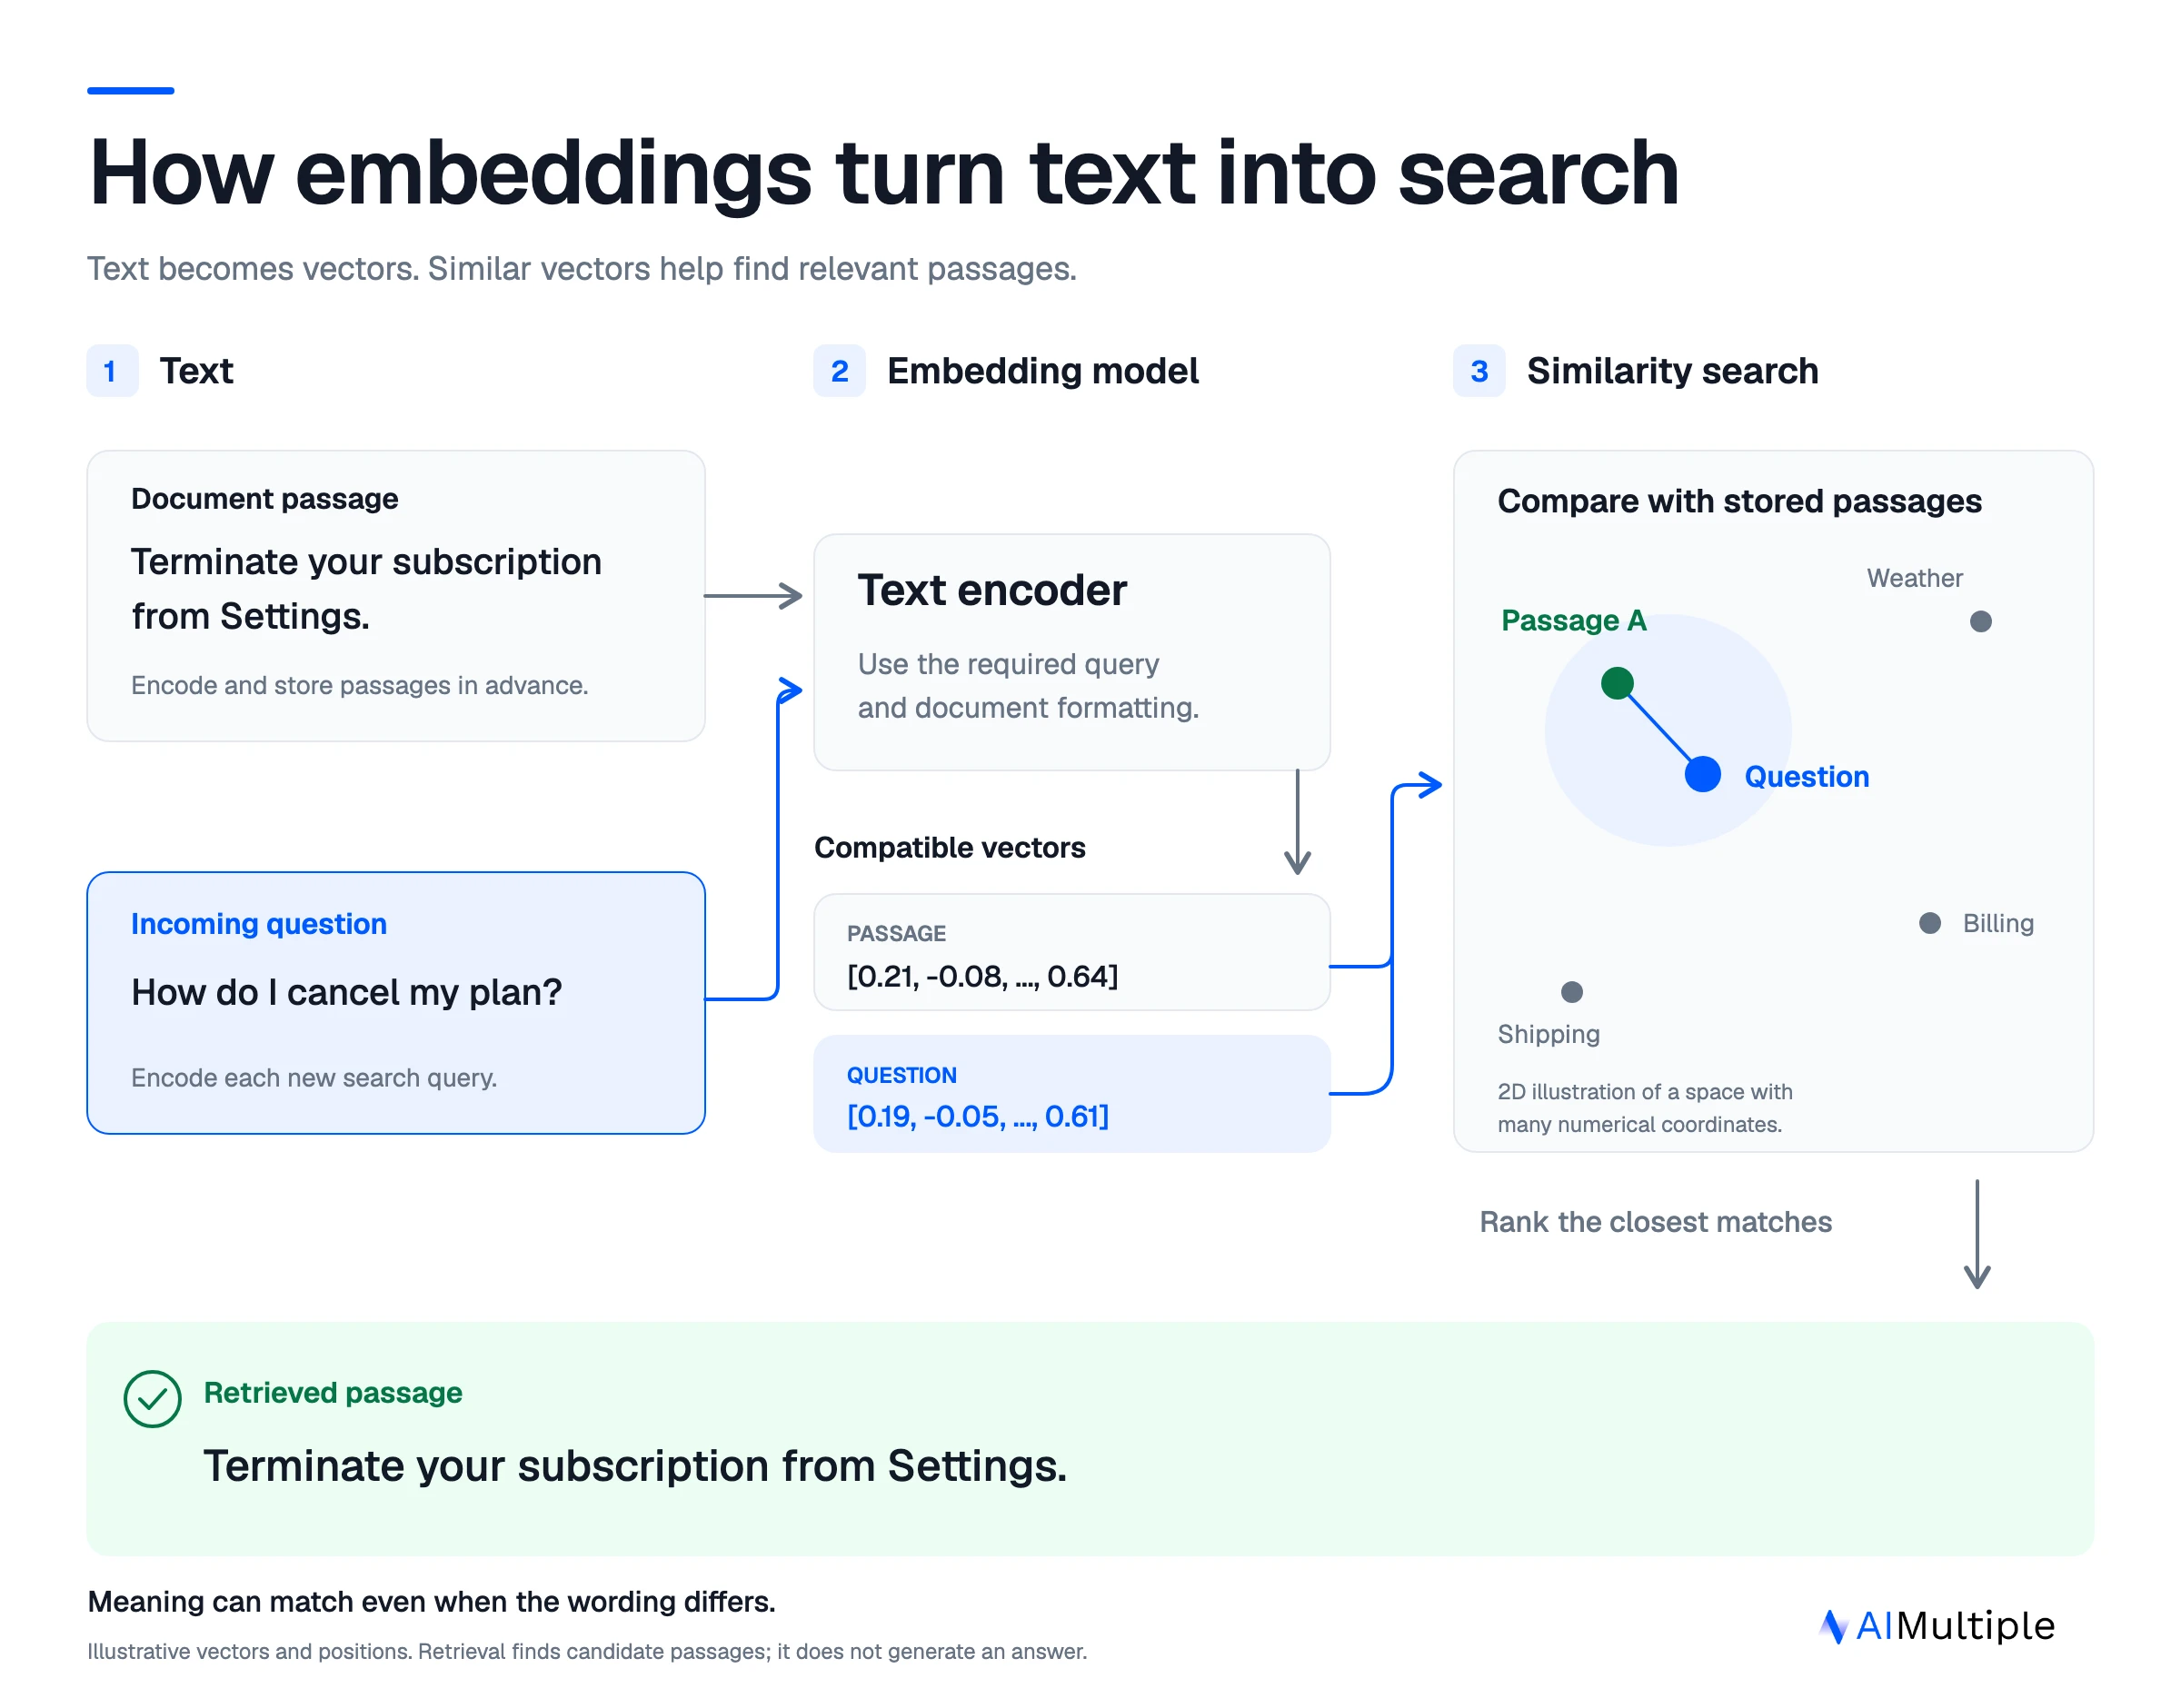
Metin embedding'leri retrieval'ı nasıl destekler?
Bir embedding modeli metni vektöre, uyumlu bir modelden gelen diğer vektörlerle karşılaştırılabilecek sayısal değerler listesine dönüştürür. Semantik retrieval'da belge pasajları önceden kodlanır. Arama sırasında sistem sorguyu kodlar ve depolanan pasajları vektör benzerliğine göre sıralar.1
Örneğin, bir planı iptal etmekle ilgili bir soru, farklı ifadelere rağmen bir aboneliği sonlandırmayla ilgili bir pasaja yakın olabilir. Vektörlerin hangi ilişkileri koruyacağını modelin eğitimi belirler.2 Diyagram bu fikri iki boyuta sıkıştırır. Dağıtılan embedding'ler genellikle çok daha fazla koordinat içerir.
Sorgu ve belge biçimlendirmesi de önemlidir. Bir model, her iki çıktı uyumlu bir vektör uzayında yer alsa bile ayrı retrieval rolleri veya önekleri bekleyebilir. Her modelin gerektirdiği sorgu ve belge biçimlendirmesini uyguladık.
Bir vektör veritabanı vektörleri depolar ve arar; embedding modeli ise aranan temsilleri belirler. Getirilen pasajlar daha sonra bir yanıt üretici için bağlam haline gelebilir. Bu benchmark pasaj retrieval'ında durur ve üretilen yanıtları puanlamaz.
Embedding Models benchmark metodolojisi
Tüm model'ler aynı pasajları, aynı 200 soruyu ve 225 kaydedilmiş ilgili soru-pasaj çiftini kullanarak aradı. Embedding puanları karşılaştırılmadan önce sorular ve etiketler donduruldu. Sorgu girdileri yalnızca orijinal soruyu içeriyordu.
Finans pasajları FinQA yıllık raporlarından, hukuki pasajlar ise CUAD v1 sözleşmelerinden geldi.34 Teknik destek TechQA teknik notlarını kullandı, tıbbi literatür ise MedRAG PubMed özetlerinin bir örneğini kullandı.56
Pasajlar bütün paragraflar, bağlam içeren tablolar, sözleşme maddeleri veya başlıklı özetlerdi. all-MiniLM-L6-v2 tokenizer'ına göre 256 token'dan daha uzun birimleri hariç tuttuk. Kabul edilen pasajlar bütünlüğü bozulmadan tutuldu ve 512 token'lık model'ler pasaj başına en fazla 459 token aldı. Bu nedenle bu benchmark kısa pasajları değerlendirir.
Frontier LLM'ler kaynak pasajlardan soruları hazırladı. Bir ekip üyesi soruların %20'ini (40 / 200) doğruladı. LLM'ler ayrıca her soru için BM25'in en iyi 20 pasajını değerlendirdi ve orijinal 200 kaynak pasaja 25 ilgili pasaj ekledi.
Retrieval ve istatistiksel analiz
Retrieval, her sorguyu kendi alanındaki her pasajla karşılaştırdı. 21 model için kosinüs benzerliği, MultiQA MPNet Base Dot v1 için ise nokta çarpımı kullandık. BGE-M3 yoğun vektörlerini kullandı.7 Sorgu ve belge girdileri, her modelin yapılandırılmış retrieval rolleri veya öneklerini kullandı.
Her iki metrik de sorular genelinde ortalamalardır. Her alanda 50 soruyu yeniden örnekleyerek 10.000 bootstrap örneğiyle %95 CI'ları hesapladık. Her metrik ve kapsam için tüm 231 model çifti genelinde Holm düzeltmeli eşleştirilmiş işaret çevirme testleri kullanıldı. Farkları, düzeltilmiş p değeri 0.05 altındaysa anlamlı olarak değerlendirdik.
Test edilen model kimlikleri, boyutlar ve girdi limitleri
Orijinal 22 model, model başına tek sabit arka uç sağlayıcısı ve devre dışı fallback'ler ile OpenRouter üzerinden çalıştırıldı. Üç Cohere modeli, yerel belge ve sorgu rolleri (search_document ve search_query) kullanılarak Cohere API'si üzerinden çalıştırıldı. Tablo, kullanılan API tanımlayıcılarını, çıktı boyutlarını ve muhafazakâr sınırlar dahil girdi limitlerini kaydeder.
API tanımlayıcıları değişmez bir model anlık görüntüsünü garanti etmez. Tokenizer revizyonları mevcut olduğunda sabitlendi. Barındırılan model ağırlıkları bağımsız olarak doğrulanmadı. Gemini ve Cohere girdi uzunlukları muhafazakâr tahminlerle kontrol edildi. Kısa pasajlar uzun bağlamlı retrieval'ı test etmedi.
 Tercih edilen kaynak olarak ekle
Kapsam ve sınırlamalar
Sorular BM25 ile seçilmiş bir geliştirme seti oluşturur. Olağan üretim sorgularında sonuçlar farklı olabilir. İlgi değerlendirmeleri kaynak pasajlar ve BM25'in ilk 20 pasajıyla sınırlıydı. Tüm 25 model genelinde, ilk onda getirilen farklı soru-pasaj çiftlerinin %87'si değerlendirilmemiştir ve ilgi kredisi almamıştır.
Her model bir kez çalıştırıldı. CI'lar soru örneklemesini yansıtır ve API çalıştırmaları arasındaki varyasyonu veya eksik etiketlerden kaynaklanan belirsizliği hariç tutar. Eğitim verisi kontaminasyonu test edilmedi.
Bu değerlendirme metin retrieval'ını kapsar. Üretilen yanıt doğruluğu, hibrit retrieval, yeniden sıralama, gecikme ve sunum maliyeti kapsam dışındaydı. Reranker benchmark'ı, çok dilli embedding karşılaştırması ve çok modlu embedding karşılaştırması ayrı iş yüklerini kapsar.
Sonuç
Voyage 4 Large en yüksek nDCG@10 değerini kaydetti; Cohere Embed 5 Pro veya Fast ile anlamlı bir fark yoktu. Her iki Cohere modeli de Embed v4.0'dan anlamlı ölçüde daha yüksek puan aldı. Recall'da Gemini Embedding 2, açık ağırlıklı grupta ise PPLX Embed v1 4B liderdi.
Adayları seçmek için alan sonuçlarını kullanın, ardından temsili sorgularda gözden geçirilmiş ilgi etiketleriyle karşılaştırın. Gecikmeyi ve uçtan uca sunum maliyetini ayrıca ölçün.
İleri okuma
- Açık kaynak embedding model benchmark'ı
- RAG için çok dilli embedding model'leri
- Çok modlu embedding model'leri
- Açık kaynak vektör veritabanı benchmark'ı
Bu benchmarkı kaynak gösterin
Yayınlayacağınız yere uygun formatı seçin. Bağlantılı sürümü CMS'inize yapıştırmak, geri bağlantıyı korur.
@misc{sari2026,
  author = {Sarı, Ekrem},
  title  = {{Embedding Models: 25 Model Retrieval için Kıyaslandı}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/embedding-models}},
  note   = {AIMultiple. Erişim tarihi: 1 Ekim 2026}
}132 veri noktasının sonuçları ve zaman damgaları. Bu makaledeki grafik ve tablolarda gösterilen özet verileri, 5 CSV dosyası ve bir README içeren ZIP dosyası olarak indirin.
Arkasındaki ayrıntılı veriyi ister misiniz? Premium'a katılın
Değişiklik günlüğü
5 güncellemeGömme modeli karşılaştırma metodolojisine Top-1 isabet metriği tanımı eklendi.
Kıyaslama, hukuk, müşteri desteği ve sağlık derlemlerinde test edilen 15 model ve bir BM25 temeliyle değiştirildi.
Referans Linkleri





Yorum yapan ilk kişi olun
E-posta adresiniz yayınlanmayacak. Tüm alanlar gereklidir. Yorumlar orijinal dilinde bırakılır.