


AIM-Text-to-SQL Benchmark: SQL Doğruluğu 70+ LLM Genelinde
We evaluated SQL answers from 70+ LLMs on a 759-question BIRD-SQL subset. Each model selected a database from 11 candidates, then produced a query.
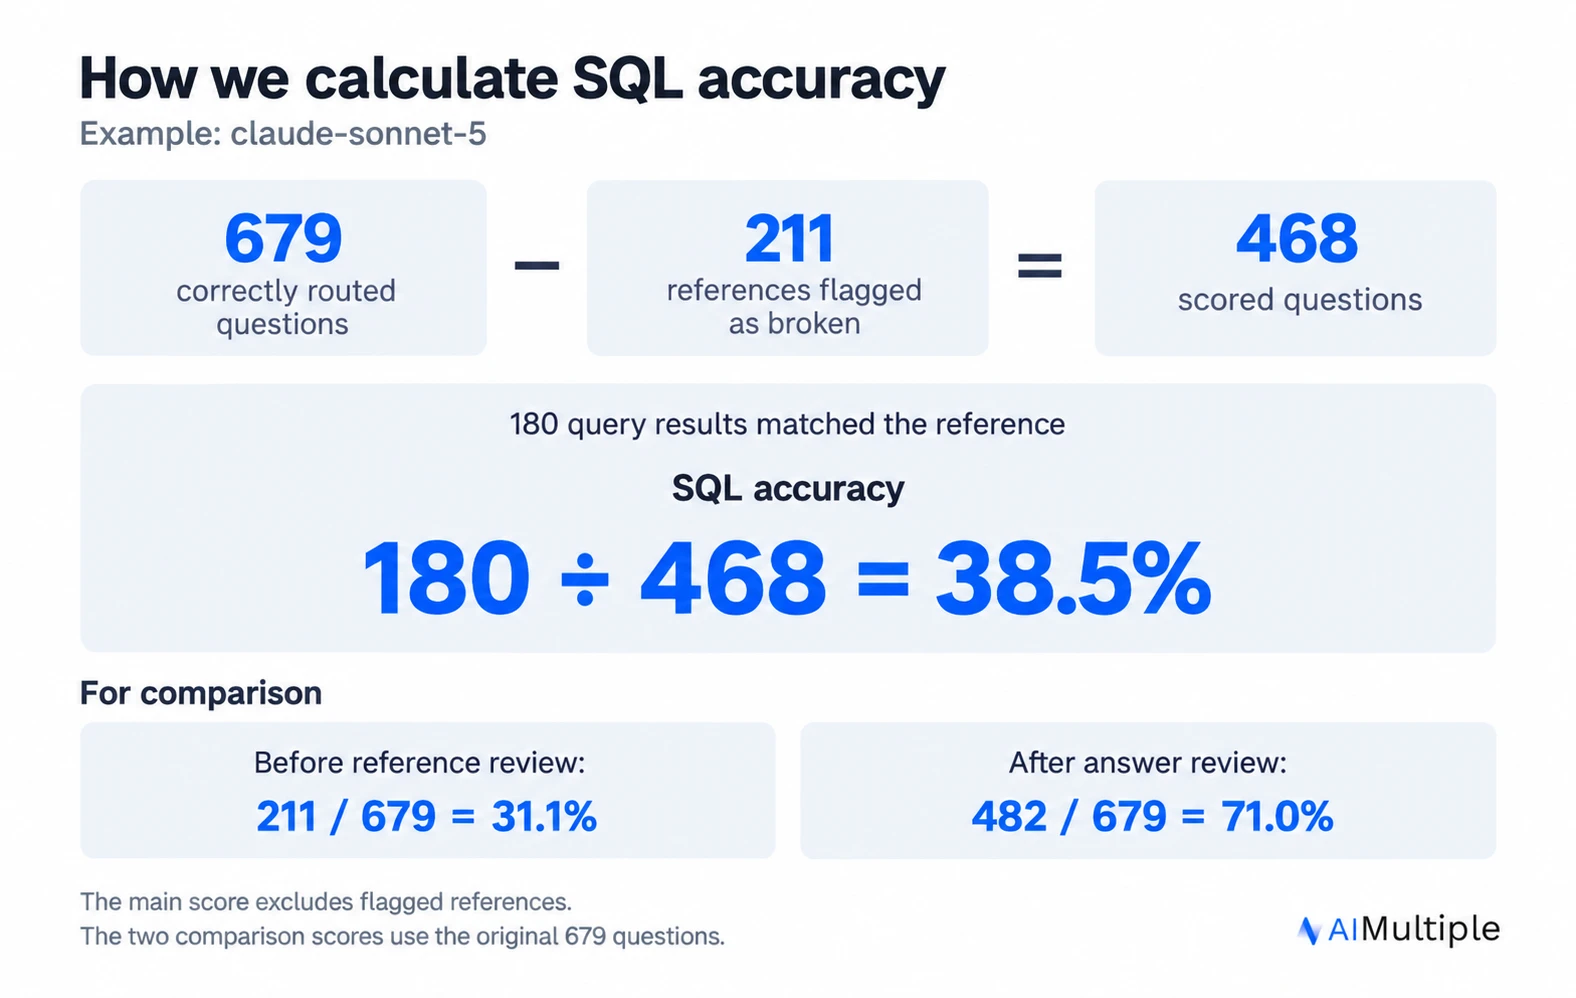
SQL doğruluğu, puanlanan sorgulardan referans sonucu döndürenlerin yüzdesidir. Yanlış rotalar ve bozuk olarak işaretlenen referanslar hariç tutulur. Referans sorgu, beklenen yanıt olarak sağlanan SQL ifadesidir.
Her model, puanlama veritabanı seçimlerine bağlı olduğu için farklı bir SQL soru kümesine ulaşır. Bu alt kümelerdeki ve çalıştırma kurulumundaki farklılıklar karşılaştırmaları sınırlar.
Text-to-SQL bulguları
Opus 5,5 %87,8 SQL doğruluğu kaydetti
claude-opus-5.5 444/506 puanlanan soruda referans sonucu eşleştirdi. gemini-4-argon %78,6 (407/518) ile takip etti, ardından gemini-3.8-flash %77,2 (342/443) ile geldi. Bunlar, 81 modelden oluşan paneldeki en yüksek üç SQL doğruluğu puanıydı. Muse Wonder %56,4 (285/505) kaydetti. GPT-6.1 Terra %56,6 (280/495) kaydetti. MiniMax M3.1 Flash %36,5 (177/485) kaydetti. Kimi K3.1 Pro %52,3 (257/491) kaydetti. Muse Spark Open %44,9 (219/488) kaydetti ve DeepSeek V4.1 Flash 1017 %22,8 (108/474) kaydetti.
Puan, yanlış veritabanı seçimlerini ve bozuk olarak işaretlenen referansları hariç tutar. Opus 5.5 Claude Code kullandı. Gemini 4 Argon ve Gemini 3.8 Flash OpenRouter kullandı. Sıralama, hem çalıştırma koşullarını hem de her modelin doğru yönlendirdiği sorulardaki farklılıkları yansıtır.
Üç Pro varyantı temel modellerinin altında puan aldı
gpt-6.1-sol-pro %63,6 SQL doğruluğu kaydetti; karşılaştırıldığında %65,1 ile gpt-6.1-sol için. gpt-6-sol-pro %53,6 puan aldı; %53,8 ile gpt-6-sol için. gpt-6-luna-pro %44,2 puan aldı; %45,4 ile gpt-6-luna için.
Altı modelin tümü OpenRouter kullandı. Bu puanlar, model başına tek bir çalıştırmadan ve doğru yönlendirilen soruların farklı alt kümelerinden gelir. Küçük farkların sürüp sürmediğini değerlendirmek için aynı SQL sorularında tekrarlanan çalıştırmalar gerekir.
Maliyet ile SQL doğruluğu
Çalıştırma maliyeti, her modelin benchmark çalıştırmasında saklanan yönlendirme ve SQL yanıtlarını kapsar. Hedef 759 soruydu. Yedi çalıştırmada daha az saklanan yanıt vardır. Ayrı duman testleri, atılan yeniden deneme girişimleri ve jüri çağrıları hariçtir. SQL doğruluğu, bozuk olarak işaretlenen referanslar hariç tutulduktan sonra her modelin doğru yönlendirilen sorularını kullanır.
gemini-3-flash-preview %67,7 SQL doğruluğu kaydetti; çalıştırma başına $7.67. gemini-3.8-flash %77,2 değerine $26,48 maliyetle ulaştı. Opus 5.5’in %87,8 puanı, $188,71 tahmini API eşdeğer maliyetiyle eşleştirildi. Gemini 4 Argon %78,6 değerine $41,41 maliyetle ulaştı. Muse Wonder %56,4 değerine $77,44 maliyetle ulaştı. GPT-6.1 Terra %56,6 değerine $7,19 maliyetle ulaştı. MiniMax M3.1 Flash %36,5 değerine $2,30 maliyetle ulaştı. Kimi K3.1 Pro %52,3 değerine $27,14 maliyetle ulaştı. Muse Spark Open $22,03 ve DeepSeek V4.1 Flash 1017 $1,75 tuttu; saklanan yönlendirme-artı-SQL çalıştırmaları için.
78 API modeli ölçümlü maliyetleri kullanır. Opus 5.5, Fable 5.1 ve GPT-6 Astra için, 1 Ekim 2026'da kontrol edilen kayıtlı CLI token'ları ve OpenRouter fiyatlarına dayanan, kayıtlı önbellek kullanımı korunarak ayrı etiketli tahminler vardır.
Maliyetler veritabanı keşfini içerir ve SQL puanları farklı soru alt kümelerini kapsar. Bu karşılaştırma bu nedenle birleşik benchmark iş akışının maliyetini ve doğruluğunu açıklar. Yalıtılmış SQL üretim maliyetleri ölçülmemiştir. Ajanik RAG benchmark veritabanı seçimini ayrıca raporlar.
SQL doğruluğu sonuçları
Referans incelemesinden önce, doğru yönlendirilen tüm sorularda tam sonuç eşleşmesini ölçer. Yanıt incelemesinden sonra, jüri tarafından kabul edilen yanıtlar için kredi eklenir. Her iki karşılaştırma sütunu özgün paydayı kullanırken SQL doğruluğu işaretlenen referansları hariç tutar.
Modeller aynı SQL sorusunu nasıl yanıtladı
Aynı soru tam eşleşmeler, ek sütunlu doğru yanıtlar ve ilgisiz bir kurum üretti. Sekiz modelin tümü doğru veritabanını seçti: college_completion. institution_details tablosu kurum adlarını chronname, şehirleri city ve eyaletleri state içinde saklar. Bu yanıtlar kaydedilmiş benchmark çalıştırmalarından gelir. Yedi model OpenRouter kullandı; Opus 5.5 ise Claude Code kullandı.
GPT-6.1 Terra, Kimi K3.1 Pro, Gemini 4 Argon ve Opus 5.5 Georgia döndürdü ve çalıştırma eşleşmesini geçti. Muse Spark Open ve DeepSeek V4.1 Flash 1017 de Georgia'yı belirledi, ancak ad ve şehir sütunlarını dahil etti. Katı sonuç karşılaştırmasında başarısız oldular. Üç yanıt inceleme jürisi de her yanıtı kabul etti.
MiniMax M3.1 Flash ve GLM 5.3 LIKE '%Mercer%' kullandı; bu, New Jersey'deki Mercer County Community College'ı da döndürdü. Üç jüri de her yanıtı model hatası olarak sınıflandırdı. Referans, ayrı geçerlilik denetiminden geçti.
Bu örneği, filtreleme ve çıktı sütunlarının değerlendirmeyi nasıl etkilediğini göstermek için seçtik. Bireysel yanıtları örnekler. Yukarıdaki tam benchmark sonuçları genel model karşılaştırmasını sağlar.
SQL doğruluğunu etkileyen koşullar
BIRD'ün ipuçları Gemini Flash'ın SQL doğruluğunu 8.7 puan artırdı
gemini-3-flash-preview modelini BIRD'ün tamamlayıcı kanıtlarıyla tekrarladık. Her iki koşulda da doğru yönlendirilen sorularda SQL doğruluğu %67,5 değerinden %76,2 değerine yükseldi. Referans incelemesinden önceki katı doğruluk %55,0 değerinden %61,6 değerine yükseldi.
Bu tek modelli bir deneydi. 81 modelden oluşan panel için ortak bir artış sağlamaz. Ana panel, ipuçlarını gizli tutar çünkü bunlar aynı zamanda hangi veritabanının seçileceğini de ortaya çıkarabilir.
Modeller farklı SQL soru kümelerine ulaştı
Her modelin veritabanı seçimleri, hangi soruların SQL puanlamasına ulaşacağını belirler. claude-opus-5 için katı payda 717 soru içerir; bunların 156 tanesi en zor yönlendirme grubundandır. nova-lite-v1 için 285 soru içerir; bunların 22 tanesi o gruptandır. Paylar %21,8 ve %7,7 şeklindedir.
Bu nedenle SQL yüzdeleri, sorgu yazma performansını puanlamaya ulaşan örneklerin zorluğuyla birleştirir. Kontrollü bir SQL karşılaştırması, aynı sorular için her modele doğru veritabanını sağlar. Bu deney henüz yapılmamıştır.
Farklı şemalar, ipuçları veya araç bütçeleri sağlayan yapay zeka benchmark'ları karşılaştırılırken soru seçimi de önemlidir.
Referans ve yanıt incelemesinden bulgular
Referans denetimi 236/759 sorguyu işaretledi
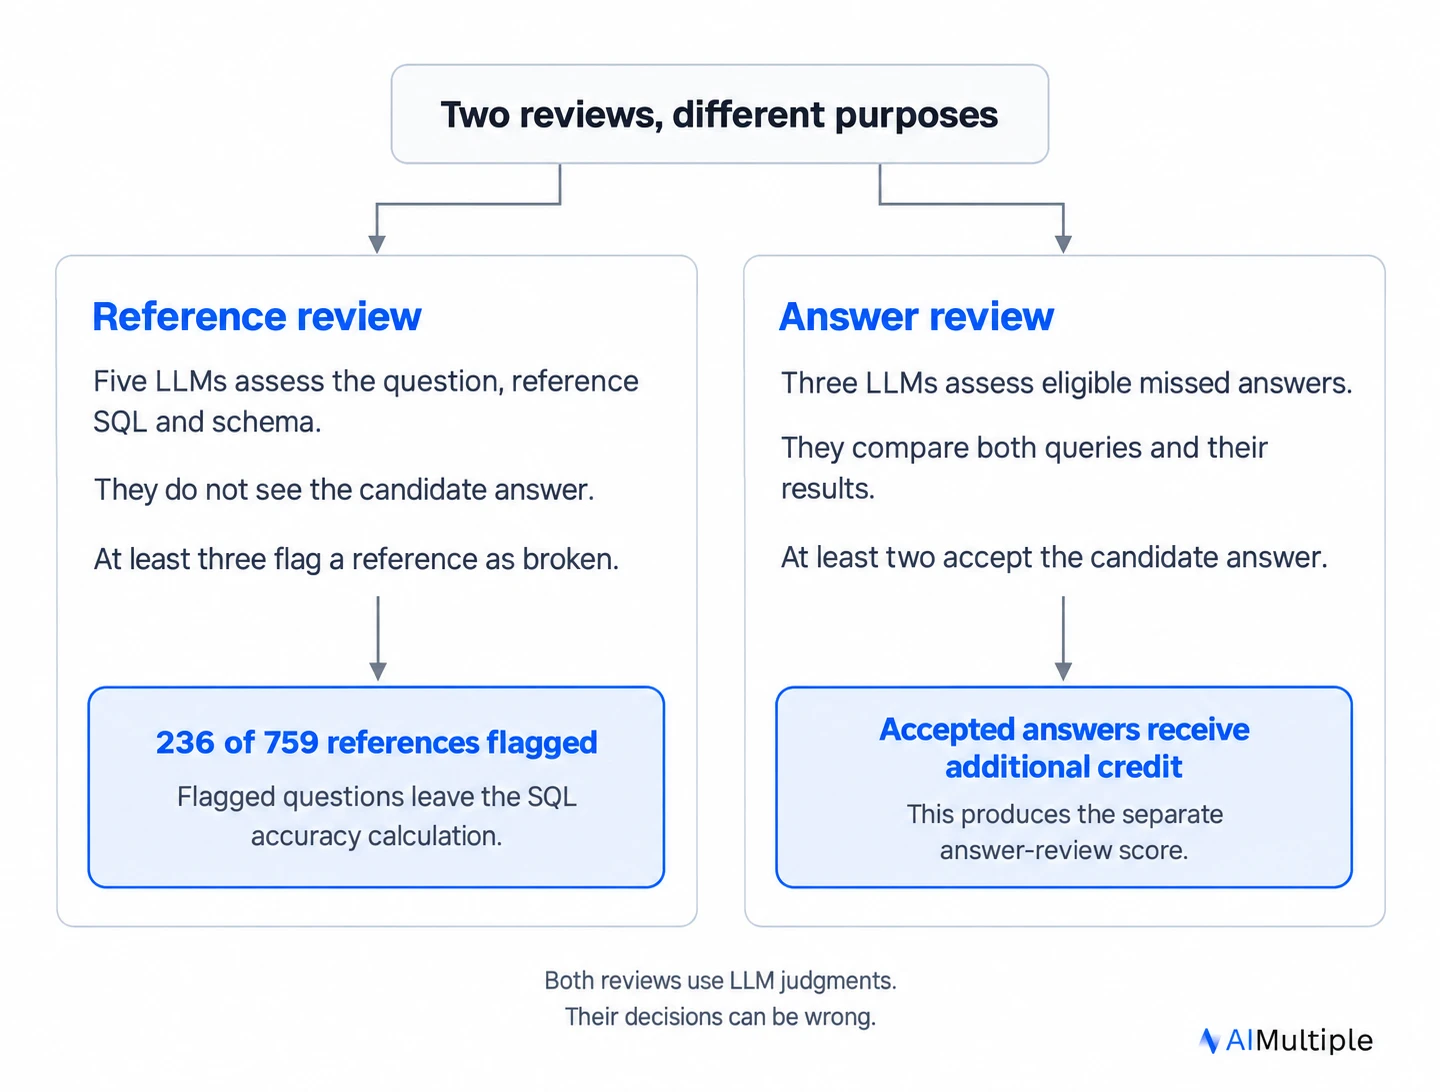
Beş model, her referans sorguyu sorusuna ve mevcut şema bilgisine göre değerlendirdi. Aday model yanıtı görmediler. En az üç çoğunluk 236 referansı bozuk olarak işaretledi; bu, kümenin %31,1 kadarıdır.
Denetimden sonra benchmark sahibi işaretlemeleri inceledi. Bağımsız insan değerlendiriciler bu incelemeyi tekrarlamadı. Bu yüzdeler denetlenen alt kümeyi tanımlar. Tüm BIRD'e genellenmemelidir.
Eşdeğer yanıtlar 22.7 puanı claude-sonnet-5’in puanına ekledi
claude-sonnet-5 211/679 katı puanlanan soruyu geçti; yani %31,1. Jüri, 154 yanıtı daha referansa eşdeğer olarak kabul etti. Bunlar 22.7 yüzde puanı katkı sağladı.
Jüri modelin sorgusunu kabul edip referansı reddettiği için 117 yanıt daha kredi aldı. Bunlar 17.2 puan katkı sağladı. Together, iki kategori puanı %71,0 değerine, 39.9 puanlık bir artışa yükseltti.
Eşdeğer yanıtlar, istenen bilgiyi ek bir sütunla veya farklı bir projeksiyonla döndürebilir. Katı karşılaştırma, bir değerlendirici onu soruya yanıt olarak kabul etse bile bu sonucu reddedebilir. Artışın 22.7 puanı jürinin bu vakalar hakkındaki kararlarından gelir. Kalan 17.2 puan referans hatalarından kaynaklanır.
 Tercih edilen kaynak olarak ekle
Text-to-SQL benchmark metodolojisi
Questions and execution
BIRD-SQL doğal dil soruları, SQL referansları ve veritabanı içeriklerini sağlar.1 759 soruluk dondurulmuş bir seçki kullandık; 11 veritabanından, 560 eğitim ve 199 geliştirme örneğini kapsayan.
Modeller, tabloları listeleme, sütun tanımlarını okuma ve SQL çalıştırma için kısa veritabanı açıklamaları ve araçlar aldı. Her soru, araçlarla en fazla dokuz çağrıya ve seçilen veritabanını ve SQL içeren tek bir nihai yanıta izin verdi. Şema önizleme sınırı 4.000 karakterdi ve sorgu önizlemeleri 50 satırla sınırlandırıldı.
Nihai aday sorgu ve referans aynı veritabanı dosyasında çalıştırıldı. Katı puanlama, sıralı yanıt isteyen sorular için sıraya duyarlı bir mod dahil olmak üzere sonuçları karşılaştırdı. Eksik, hatalı biçimlendirilmiş ve çalıştırma hatası veren aday sorgular, aksi halde uygun ve doğru yönlendirilen sorularda katı kredi almadı.
78 OpenRouter çalıştırması için sıcaklık 0 istendi. Bunların 61 tanesi v3 araç çağrısı kurtarma katmanını kullandı, 15 tanesi bundan önceydi ve iki tanesi her iki sürümden kayıtları birleştirdi. GPT-6 Astra Codex CLI üzerinden çalıştı. Opus 5.5 ve Fable 5.1, Claude Code kullandı. Üç CLI çalıştırmasının tümü orta düzey muhakeme çabası kullandı. GPT-6 Luna, Luna Pro, Sol ve Sol Pro çalıştırmaları ile GPT-5.2 OpenRouter kullandı. Bu çalıştırma farklılıkları, puan farkının yalnızca modele atfedilmesini engeller.
Yedi çalıştırma 759 sorudan daha azını tamamladı. Eksik kayıtlar puanlama paydalarında yoktur. Tablo, ana ve ek puanlar için gerçek örneklem boyutlarını raporlar. GPT-6.1 Terra, MiniMax M3.1 Flash ve Kimi K3.1 Pro 759 sorunun tümünü OpenRouter üzerinden 27 Ekim'de tamamladı. Önceki başarılı yanıtlar ölçüm aşamaları boyunca korundu. DeepSeek V4.1 Flash 1017 ve Muse Spark Open 759 sorunun tümünü OpenRouter üzerinden 30 Ekim'de tamamladı.
SQL puanlaması
Ana puan, işaretlenen soruları hem payından hem paydasından hariç tutar. Belirsiz olarak işaretlenen üç referans hesaplamada kalır. Sonuç dosyaları bu metriği ex_gold_clean olarak adlandırır.
İki ek puan, incelemenin sonucu nasıl değiştirdiğini gösterir:
Referans incelemesinden önce katı puan, doğru yönlendirilen tüm sorularda tam çalıştırma eşleşmesini ölçer. İşaretlenen referansları olan soruları içerir.
Yanıt incelemesinden sonra puan, ayrı bir jüri uygun kaçırılan yanıtı kabul ettiğinde kredi ekler. Katı puanla aynı paydayı kullanır. Sonuç dosyaları bunu değerlendirilmiş doğruluk olarak adlandırır.
Örneklem boyutu (n), puanlanan soru sayısıdır. Ana puan, iki ek puandan daha küçük bir alt küme kullanır.
claude-sonnet-5 için, işaretlenen referansların hariç tutulması kabul edilen yanıtları 211 değerinden 180 değerine ve puanlanan soruları 679 değerinden 468 değerine düşürdü. SQL doğruluğu %38,5 oldu.
Hariç tutma her iki sayımı da değiştirir. Yanıt incelemesi ise özgün paydayı korur ve kabul edilen kaçırmalar için kredi ekler.
Referans ve yanıt incelemesi
Referansları denetlemek ve aday yanıtları incelemek farklı girdiler gerektirir.
Referans denetçileri claude-opus-4.8, gpt-5.6-sol, gemini-3.1-pro-preview, grok-4.5 ve deepseek-v4-pro idi. Puanlanan modelden bağımsız tutmak için aday yanıtları gizlendi.
Yanıt değerlendirmesi, adayınkinden farklı model ailelerinden üç jüri kullandı. Referans ve aday sorguları, rollerini açığa çıkaran etiketler olmaksızın rastgele A/B konumlarında gösterildi. Belirsiz vakalar ve yeterli geçerli oyu olmayan vakalar ek kredi almadı. GPT-6.1 Terra, MiniMax M3.1 Flash ve Kimi K3.1 Pro her uygun vaka için en az iki geçerli jüri oyuna sahipti. Bağımsız başarısız oylar denetim günlüklerinde kalır. Kesilmiş bir GPT-6.1 Terra jüri yanıtı, 4.000-token çıktı sınırıyla, 1.200 değerinden artırılarak tamamlandı. Jüri modeli, prompt ve puanlama kuralları değiştirilmedi. DeepSeek V4.1 Flash 1017 ve Muse Spark Open her uygun vaka için en az iki geçerli jüri oyuna sahipti.
İnceleme kapsamı asimetriktir. Katı geçişler kabul edilmeye devam ederken uygun kaçırmalar başka bir değerlendirme alır. Sonuç olarak değerlendirme, katı puanlamadaki yanlış pozitifleri koruyabilir ve kendi yanlış pozitiflerini ekleyebilir. Doğruluğu garanti etmeyen ve gerçek doğruluk için garantili bir üst sınırı olmayan ek bir tahmindir.
Aday sorgu çalıştığında ve sonuç satırları ile referans arasındaki F1 örtüşmesi 0.5 değerinin altında olduğunda bir kaçırma değerlendirmeye hak kazandı. F1, referansta bulunan aday satır oranını, adayın kurtardığı referans satır oranıyla birleştirir.
Örneğin gemini-3.5-flash-lite 346 katı kaçırmaya sahipti. Bunların 314 tanesi incelemeye hak kazandı. Jüri adayı 144 vakada kabul etti: 92 tanesi reddedilen referansla, 52 tanesi her iki yanıtın kabul edilmesiyle. 105 tanesini model hatası olarak sınıflandırdı ve 65 tanesini belirsiz bıraktı. Diğer 32 kaçırma, 27 yüksek sonuç örtüşmesi ve beş çalıştırma hatasından oluştu.
Jüri %45,9 oranını 314 incelenen kaçırmadan kabul etti.
Sınırlamalar
Referans hataları belirsizliğini korur. Beş model denetimi, her referans sorgusunun kullandığı tablolardaki sütunları inceledi; bu nedenle farklı bir tabloda bulunan bir yanıtı gözden kaçırabilir. Denetim ayrıca geçerli bir referansı da reddedebilir. Her iki hata türünü de tahmin etmek için bağımsız insan değerlendiriciler tarafından tekrarlanan bir inceleme gerekir.
Jüri kararları LLM yorumuna bağlıdır. Tüm değerlendirme hükümlerini bağımsız insan incelemesi doğrulamadı. nova-lite-v1 kontrolünde doğruluk, katı puanlama altında %18,9 değerinden değerlendirme sonrasında %31,6 değerine yükseldi; bu, incelemenin otomatik olarak yüksek puan üretmediğini gösterir. Bu kontrol tek başına jüri doğruluğunu kanıtlayamaz.
Katı karşılaştırma her iki yönde de başarısız olabilir. Ek sütunlar veya farklı sütun sırası yararlı bir yanıtı reddedebilir. Büyük/küçük harf normalleştirme ve kayan nokta değerlerini altı anlamlı basamağa yuvarlama, önemli farkları kabul edebilir.
Soru örnekleme aralıkları, sonuç dışa aktarımında katı puanlar ve SQL doğruluğu için kullanılabilir. Bunlar referans etiketi belirsizliğini, jüri hatasını ve tekrarlanan SQL çalıştırmaları arasındaki varyasyonu atlar. Burada SQL tekrar analizi raporlanmamıştır.
Bunlar, veritabanı yönlendirme gereksinimi olan seçilmiş, ipucu-free bir iş yüküne ilişkin sonuçlardır. BIRD lider tablosuyla doğrudan karşılaştırılamaz. Herkese açık eğitim verileri, yönlendirme makalesinde tartışıldığı gibi eğitim verisi örtüşmesi riski de bırakır.
Sonuç
claude-opus-5.5 SQL doğruluğunda %87,8 ile liderdi; ardından gemini-4-argon %78,6 ile ve gemini-3.8-flash %77,2 ile geldi.
Her SQL puanı, modelin doğru yönlendirdiği soruları ve incelemeden sonra korunan referansları yansıtır. Kontrollü bir SQL karşılaştırması, her modele aynı soruları ve veritabanı bilgilerini verir; referans etiketleri ve jüri kararlarının bağımsız kontrolleriyle.
İleri okuma
- Ajanik RAG Benchmark: Çok Veritabanlı Yönlendirme
- 800+ Önde Gelen Yapay Zeka Benchmark'ları
- HALC-Bench: LLM Uzun Bağlamlı Getirme Benchmark'ında Halüsinasyon
Bu benchmarkı kaynak gösterin
Yayınlayacağınız yere uygun formatı seçin. Bağlantılı sürümü CMS'inize yapıştırmak, geri bağlantıyı korur.
@misc{sari2026,
  author = {Sarı, Ekrem},
  title  = {{AIM-Text-to-SQL Benchmark: SQL Doğruluğu 70+ LLM Genelinde}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/text-to-sql}},
  note   = {AIMultiple. Erişim tarihi: 30 Ekim 2026}
}1.5 bin veri noktasının sonuçları ve zaman damgaları. Bu makaledeki grafik ve tablolarda gösterilen özet verileri, 5 CSV dosyası ve bir README içeren ZIP dosyası olarak indirin.
Arkasındaki ayrıntılı veriyi ister misiniz? Premium'a katılın
Değişiklik günlüğü
9 güncellemeText-to-SQL karşılaştırma sonuçları, strict, gold-clean ve adjudicated execution match ile puanlanan 36 modelli bir panelle değiştirildi.
Agentic RAG karşılaştırması: çoklu veritabanı yönlendirme ve sorgu oluşturma bölümüne bir değişiklik günlüğü eklendi.
Metodoloji bölümü, bir özet ve başka bir makaleye referans ile değiştirildi.
Referans Linkleri





Yorumlar 1
Düşüncelerinizi Paylaşın
E-posta adresiniz yayınlanmayacak. Tüm alanlar gereklidir. Yorumlar orijinal dilinde bırakılır.
Curious, how much of the context engineering and specific prompting did you apply in your benchmarks. Or, was it to review the models only? I have found much higher return of correct and consistent responses. A higher fidelity. To do that, I needed to provide a most sophisticated prompt that fed the context window as the question was being asked. Not perfect, but better than those scores represented in this article when using the Grok 4.x .
Great point. This benchmark intentionally uses zero-shot, minimal prompting with temperature=0. No few-shot examples, no domain-specific instructions, no iterative refinement. The goal was to measure each model's baseline text-to-SQL capability. So your experience with Grok 4 getting higher fidelity through sophisticated context engineering is completely expected. A well-crafted prompt with detailed schema descriptions, few-shot examples, and domain-specific rules will improve any model's performance significantly. What this benchmark isolates is how well the model performs out-of-the-box when given only the raw question and retrieved schema, which helps compare the models' inherent SQL reasoning abilities on a level playing field. We'll make this clearer in the methodology section. Thanks for raising it.