


20 Strategien zur KI-Verbesserung & Beispiele

KI-Modelle erfordern kontinuierliche Verbesserung, da sich Daten, Nutzerverhalten und reale Bedingungen weiterentwickeln. Selbst leistungsstarke Models können abdriften, wenn die gelernten Muster nicht mehr zu den aktuellen Eingaben passen, was zu geringerer Genauigkeit und unzuverlässigen Vorhersagen führt.
Änderungen bei Vorschriften, Produktanforderungen oder Kundenerwartungen können zudem neue Einschränkungen mit sich bringen, für die bestehende Models nicht ausgelegt sind.
Die Aufrechterhaltung der Qualität des Models umfasst daher sowohl die Stärkung der Daten, die das Model unterstützen, als auch der Algorithmen, die sein Verhalten prägen, um sicherzustellen, dass Systeme auf die heutigen Anforderungen und nicht auf veraltete Annahmen ausgerichtet bleiben.
Entdecken Sie zentrale Strategien, darunter Datenfütterung, Daten und Algorithmusverbesserung sowie KI-Skalierungsgesetze, die sicherstellen, dass Ihre KI-Modelle relevant und praxistauglich bleiben.
Die 20 besten Möglichkeiten, Ihr KI-Model zu verbessern
Wir haben Methoden zur Verbesserung Ihres KI-Modelle in 4 verschiedenen Kategorien erläutert:
Methode | Beschreibung | Zentrale Herausforderungen |
|---|---|---|
Mehr Daten zuführen | Hochwertige reale oder synthetische Daten hinzufügen, um Abdeckung und Generalisierung zu verbessern. | Sicherstellung der Datenqualität, Vermeidung von Verzerrungen, Umgang mit Datenschutz- und Zugriffsbeschränkungen. |
Daten verbessern | Kennzeichnung, Vielfalt und Augmentierung verbessern, um Rauschen und Verzerrungen zu reduzieren. | Abwägung von Qualität und Quantität, Reduzierung von Dataset-Bias, Konsistente Annotationen. |
Algorithmus verbessern | Bessere Architekturen, Fine-Tuning-Techniken und Bereitstellungspraktiken verwenden. | Höhere Komplexität und Kosten, unbeabsichtigtes Verhalten, strenge Datenschutzanforderungen. |
Skalierungsgesetze der KI | Skalierung, Rechenleistung, Effizienz sowie Retrieval- oder Multi-Agenten-Techniken erhöhen. | Abnehmende Erträge, Rechenleistungsgrenzen, Umweltauswirkungen, Integrationskomplexität. |
Mehr Daten zuführen
Das Hinzufügen neuer und aktueller Daten ist eine der gängigsten und effektivsten Methoden, um die Genauigkeit Ihres Machine-Learning-Models zu verbessern. Die Forschung hat eine positive Korrelation zwischen der Dataset-Größe und der Genauigkeit von KI-Modelle gezeigt.1
Daher kann die Erweiterung des Datasets, das für das Retraining des Models verwendet wird, ein effektiver Weg sein, um KI/ML-Models zu verbessern. Stellen Sie sicher, dass sich die Daten entsprechend der Umgebung ändern, in der das Model eingesetzt wird. Ebenso wichtig ist die Einhaltung geeigneter Qualitätssicherungspraktiken bei der Datenerfassung.
1. Datenerfassung
Datenerfassung/-sammlung kann genutzt werden, um Ihr Dataset zu erweitern und mehr Daten in das KI/ML-Model einzuspeisen. Bei diesem Prozess werden frische Daten gesammelt, um das Model neu zu trainieren. Diese Daten können mit folgenden Methoden erfasst werden:
- Private Sammlung
- Automatisierte Datenerfassung
- Maßgeschneidertes Crowdsourcing
Um erfolgreich Daten für KI zu sammeln, müssen Unternehmen auf Folgendes achten:
- Ethische und rechtliche Aspekte bei der Datenerfassung müssen beachtet werden, um ethische Probleme zu vermeiden.
- Bias in den Trainingsdaten kann zu unerwünschten KI-Ergebnissen führen.
- Die Vorverarbeitung von Rohdaten ist unerlässlich, um Qualitätsprobleme zu beheben und die Datenintegrität für das KI/ML-Training sicherzustellen.
- Nicht alle Daten sind aufgrund von Einschränkungen im Zusammenhang mit Sensibilität und Datenschutzbestimmungen leicht zugänglich.
Erfahren Sie mehr über Methoden der Datenerfassung.
Es wird außerdem empfohlen, mit einem KI-Datenservice zusammenzuarbeiten, um relevante Datasets ohne den Aufwand der Datenbeschaffung zu erhalten und ethische sowie rechtliche Probleme zu vermeiden.
2. Synthetische Daten mit generativen Models
Generative KI hat die Erstellung synthetischer Daten vorangebracht und hochwertige Datasets erzeugt, die reale Bedingungen nachbilden. Large Language Models und Diffusions-Models können nun strukturierte und unstrukturierte Daten für das Training von Models in Bereichen generieren, in denen reale Daten begrenzt sind.
Beispiele sind:
- Erzeugung seltener medizinischer Fälle zur Verbesserung von Machine-Learning-Models im Gesundheitswesen.
- Generierung realistischer Gesprächsdaten zur Verbesserung von Systemen zur Verarbeitung natürlicher Sprache.
- Erstellung visueller Datasets, um Bildauflösung, Fotoqualität oder Bilderkennung-Models zu testen.
Synthetisches Self-Play und synthetische Trainingsdaten
Synthetisches Self-Play erzeugt neue Trainingsdaten, indem Models oder Agenten mit Aufgaben oder miteinander interagieren dürfen. Diese Ergänzungen verfügen nur über begrenzte hochwertige menschliche Daten.
Diese Methode bietet:
- Skalierbare Erzeugung von Anweisungs-, Argumentations- oder Dialogdaten.
- Abdeckung von Szenarien, die selten oder teuer manuell zu erfassen sind.
- Verbesserte Model-Performance in Bereichen, in denen Datenknappheit eine wesentliche Einschränkung darstellt.
Praxisbeispiel: Mehr Daten für Chatbots
Ein Chatbot für den IT-Support hatte Schwierigkeiten, Nutzerfragen genau zu verstehen und zu klassifizieren. Um seine Performance zu verbessern, wurden 500 IT-Support-Anfragen in mehrere Variationen in sieben Sprachen umgeschrieben.
Diese zusätzlichen Daten halfen dem Chatbot, verschiedene Frageformate zu erkennen, und verbesserten seine Fähigkeit, effektiver zu antworten.
Daten verbessern
Die Verbesserung der vorhandenen Daten kann ebenfalls zu einem verbesserten KI/ML-Model führen.
Da KI-Lösungen heute komplexere Probleme bewältigen, sind bessere und vielfältigere Daten zu ihrer Entwicklung erforderlich. So kommt beispielsweise eine Forschung2 über ein Deep-Learning-Model, das Objekterkennungssystemen hilft, die Interaktionen zwischen zwei Objekten zu verstehen, zu dem Schluss, dass das Model anfällig3 für Dataset-Bias ist und ein vielfältiges Dataset benötigt, um Ergebnisse zu liefern.
Verbesserungen können erreicht werden durch:
3. Anreicherung der Daten
Die Erweiterung des Datasets ist eine Möglichkeit, KI zu verbessern. Eine weitere wichtige Möglichkeit zur Verbesserung von KI/ML-Models ist die Anreicherung der Daten. Das bedeutet, dass die neuen Daten, die zur Erweiterung des Datasets gesammelt werden, verarbeitet werden müssen, bevor sie in das Model eingespeist werden.
Dies kann auch bedeuten, die Annotation des vorhandenen Datasets zu verbessern. Da neue und verbesserte Kennzeichnungstechniken entwickelt wurden, können sie auf das vorhandene oder neu gesammelte Dataset angewendet werden, um die Model-Genauigkeit zu verbessern.
4. Verbesserung der Datenqualität
Die Verbesserung der Datenqualität ist entscheidend, um KI-Systeme voranzubringen und die Performance von KI-Modelle zu steigern. Während Fortschritte in der KI oft bessere Algorithmen und mehr Rechenleistung betonen, bleiben hochwertige Trainingsdaten für eine optimale Performance entscheidend.
Ein datenzentrierter Ansatz trägt dazu bei, den KI-Fortschritt zu beschleunigen, indem sichergestellt wird, dass die für das Training verwendeten Daten reichlich vorhanden und qualitativ hochwertig sind.
Die Erfassung und Kuratierung hochwertiger Daten ermöglicht es Entwicklern, effizientere und effektivere KI-Modelle zu erstellen, die dann zur Lösung komplexer Aufgaben in verschiedenen Branchen eingesetzt werden können. Durch den Fokus auf Datenqualität können Unternehmen genauere Vorhersagen treffen, Verzerrungen reduzieren und die Fähigkeiten von KI-Systemen verbessern.
Die Datenqualität kann während der Datenerfassungsphase erheblich verbessert werden. Dieser Prozess umfasst die Sicherstellung, dass die Daten für die realen Szenarien repräsentativ sind, auf die das Model treffen wird, um Verzerrungen zu beseitigen, Rauschen zu reduzieren und sicherzustellen, dass sie vielfältig genug sind, um alle relevanten Variablen zu erfassen.
Darüber hinaus können die Wahrung der Konsistenz bei der Datenkennzeichnung und die Schließung von Lücken im Dataset dazu beitragen, Fehler im Lernprozess des Models zu reduzieren.
5. Nutzung von Data Augmentation
Manche Menschen verwechseln augmentierte Daten mit synthetischen Daten; die beiden Begriffe unterscheiden sich jedoch. Augmentierte Daten beziehen sich auf das Hinzufügen von Informationen zu einem vorhandenen Dataset, während synthetische Daten künstlich erzeugt werden, um reale Daten zu ersetzen.
Algorithmus verbessern
Manchmal muss der Algorithmus, der ursprünglich für das Model erstellt wurde, verbessert werden. Dies kann unterschiedliche Gründe haben, darunter eine Veränderung der Population, in der das Model eingesetzt wird.
Angenommen, ein eingesetzter KI/ML-Algorithmus, der das Gesundheitsrisiko eines Patienten bewertet und den Parameter Einkommensniveau nicht berücksichtigt, wird plötzlich mit Daten von Patienten mit niedrigerem Einkommen konfrontiert. In diesem Fall dürfte er kaum faire Bewertungen liefern.
Daher kann ein Upgrade des Algorithmus und das Hinzufügen neuer Parameter ein effektiver Weg sein, um die Model-Performance zu verbessern. Der Algorithmus kann auf folgende Weise verbessert werden:
6. Architektur verbessern
Es gibt einige Dinge, die getan werden können, um die Architektur eines Algorithmus zu verbessern. Eine Möglichkeit besteht darin, moderne Hardwarefunktionen wie SIMD-Anweisungen oder GPUs zu nutzen.4
Darüber hinaus können Datenstrukturen und Algorithmen durch den Einsatz cache-freundlicher Datenlayouts und effizienter Algorithmen verbessert werden. Schließlich können Algorithmenentwickler jüngste Fortschritte im maschinellen Lernen und bei Optimierungstechniken nutzen.
Der Transformer ist eine Deep-Learning-Architektur, die natürliche Sprachverarbeitung (NLP) und andere Bereiche verändert hat, indem sie eine effizientere und effektivere Modellierung von Sequenzdaten ermöglicht. Eingeführt in dem Paper „Attention Is All You Need“5, stützt es sich stark auf einen Mechanismus namens Self-Attention und ersetzt rekurrente und konvolutionale Operationen, die in früheren Models wie RNNs und CNNs verwendet wurden.
Ein Transformer besteht aus einem Encoder und einem Decoder, die jeweils aus mehreren gestapelten Schichten aufgebaut sind:
- Der Encoder wandelt Eingabesequenzen mithilfe von Multi-Head-Self-Attention zur Erfassung von Token-Beziehungen, Feedforward-Netzwerken zur Verarbeitung und residuellen Verbindungen mit Layer-Normalisierung zur Stabilität in kontextbewusste Repräsentationen um.
- Der Decoder erzeugt Ausgabesequenzen Token für Token, indem er maskierte Multi-Head-Self-Attention einsetzt, um den Zugriff auf zukünftige Tokens zu verhindern, Cross-Attention zur Integration der Encoder-Ausgaben sowie ähnliche Feedforward- und Normalisierungsmechanismen für effizientes Lernen nutzt.
7. Hybride Model-Architekturen
Hybride Model-Architekturen kombinieren Elemente von Transformers, State-Space-Models und anderen Sequenzverarbeitungsmethoden. Dieser Ansatz unterstützt langlebigen Kontext und reduziert den Rechenaufwand.
Zu den wichtigsten Vorteilen gehören:
- Effizientere Verarbeitung langer Sequenzen.
- Geringerer Speicherbedarf für Training und Inference.
- Kompatibilität sowohl mit Rechenzentrums- als auch mit Edge-Umgebungen.
Praxisbeispiel: Kimi K2.5
Kimi K2.5 ist ein quelloffenes agentisches KI-Model, entwickelt von Moonshot KI, vortrainiert mit etwa 15 Billionen gemischten visuellen und Text-Tokens.
Das Design von Kimi K2.5 integriert Vision und Sprachverständnis mit agentischem Reasoning und bietet sowohl Sofort- als auch „Denk“-Modi und unterstützt konversationale sowie autonome Agenten-Workflows.6
Die wichtigsten Funktionen sind:
- Native Multimodalität: Verarbeitet und schlussfolgert über Text, Bilder und Video in einem einheitlichen Model.
- Visuell unterstütztes Coding: Kann Code aus visuellen Eingaben generieren und Ausgaben an visuellen Spezifikationen ausrichten.
- Agent-Schwarm-Ausführung: Unterstützt koordinierte Aufgabenzerlegung und ermöglicht es agentischen Prozessen, für komplexe Workflows parallel zu laufen.
8. Feature-Re-Engineering
Feature-Re-Engineering eines Algorithmus ist der Prozess der Verbesserung der Features des Algorithmus, um ihn effizienter und effektiver zu machen. Dies kann durch Änderung der Struktur des Algorithmus oder durch Feinabstimmung seiner Parameter erfolgen.
9. Multimodale World Models
Multimodale World Models lernen aus Text, Bildern, Audio, Video, strukturierten Daten und Sensoreingaben. Dadurch entsteht eine einheitliche Repräsentation über alle Modalitäten hinweg.
Wichtige Aspekte sind:
- Bessere Verankerung in realen Informationen.
- Genauere Interpretation von Szenen, Signalen und Eingaben in mehreren Formaten.
- Anwendbarkeit auf Aufgaben, die ein integriertes Verständnis über Modalitäten hinweg erfordern.
Praxisbeispiel: DeepMind
Google DeepMind hat seine KI-Modelle erheblich verbessert, indem es ihre Architektur optimierte und verschiedene Komponenten für eine bessere Performance neu entwickelte. Beispielsweise wurde das Gemini-Model mit einer multimodalen Architektur entwickelt, wodurch es Aufgaben über Text, Audio und Bilder hinweg effektiver bewältigen kann.
Darüber hinaus wurde PaLM 2 mit einem rechenoptimalen Skalierungsansatz und Dataset-Verbesserungen erweitert, um Reasoning-Aufgaben zu verbessern. Diese Architektur-Upgrades ermöglichten eine höhere Genauigkeit und Anpassungsfähigkeit.7
10. KI-Sicherheit, Alignment und Governance
Die Verbesserung von Algorithmen ist nicht mehr auf technische Optimierungen beschränkt. KI-Sicherheit, Alignment und Governance werden immer wichtiger, um sicherzustellen, dass sich KI-Systeme wie beabsichtigt verhalten. Entwickler und Organisationen priorisieren Methoden, die:
- Align KI-Model-Ausgaben mit menschlichen Werten und Geschäftsanforderungen ausrichten.
- Feedback-Schleifen einbauen, um unbeabsichtigtes Verhalten während der Bereitstellung zu verhindern.
- Governance-Frameworks etablieren, die Grenzen für die Tool-Nutzung in verschiedenen Branchen setzen.
Diese Verschiebung verdeutlicht, dass bessere KI-Ergebnisse eine Verbesserung von Genauigkeit und Vertrauenswürdigkeit, die Berücksichtigung ethischer Aspekte und die Sicherstellung langfristiger Nachhaltigkeit erfordern.
Praxisbeispiel: KI-Sandbagging im International KI Safety Report
Der International KI Safety Report hebt ein Problem hervor, das als KI-Sandbagging bekannt ist und bei dem ein Model sich während der Evaluierung anders verhält als im realen Einsatz. Insbesondere können fortgeschrittene Systeme bei formellen Tests sicherer oder weniger leistungsfähig erscheinen, sich aber nach der Bereitstellung anders verhalten.
Dadurch entsteht eine Evaluierungslücke: Herkömmliche Benchmarks und Red-Team-Tests erfassen reale Risiken möglicherweise nicht vollständig, wenn Models ihr Verhalten je nach Kontext anpassen können. Für Unternehmen bedeutet dies, dass einmalige Sicherheitstests nicht ausreichen und durch kontinuierliches Monitoring, Auditing und Governance-Mechanismen ergänzt werden müssen.8
Abbildung 1: Beispiel für das o3-Model von OpenAI, das während der Evaluierungen situatives Bewusstsein zeigt.
11. Verifier-Models und Self-Correction-Pipelines
Verifier-Models bewerten Ausgaben eines Basis-Models und erkennen Fehler oder Inkonsistenzen. Sie unterstützen strukturierte Selbstkorrektur. Zu ihren wichtigsten Beiträgen gehören:
- Höhere Genauigkeit bei Argumentations- und Mathematikaufgaben.
- Geringere Ausfallraten durch systematische Überprüfung.
- Größere Zuverlässigkeit bei risikoreichen oder domänenspezifischen Anwendungen.
12. On-Device- und Edge-KI-Optimierung
Die On-Device- und Edge-KI-Optimierung ist zunehmend entscheidend, um Datenschutz zu verbessern, Latenz zu verringern und Effizienz zu steigern. Statt Daten auf zentralisierten Servern zu verarbeiten, können KI-Systeme direkt auf Geräten wie Smartphones, IoT-Sensoren oder Unternehmenshardware ausgeführt werden.
Zu den Vorteilen gehören:
- Verbesserter Datenschutz, da sensible Daten lokal bleiben.
- Geringere Latenz, die sofortige Echtzeit-Einblicke ermöglicht.
- Geringere Abhängigkeit von ständiger Konnektivität und groß angelegter Cloud-Infrastruktur.
Dieser Trend ist besonders relevant in Branchen wie Gesundheitswesen, Automobilindustrie und Fertigung, wo zeitnahe Reaktionen und Datenschutz entscheidend sind.
Skalierungsgesetze der KI
Skalierungsgesetze beschreiben, wie sich die Model-Performance verändert, wenn Parameter, Daten und Rechenkapazität in ausgewogenem Verhältnis gemeinsam skaliert werden. Die Forschung zeigt, dass der Loss tendenziell vorhersagbaren Potenzgesetz-Mustern folgt, wenn Models mit ausreichend Daten und Rechenressourcen im Verhältnis zu ihrer Größe trainiert werden.
Frühe Arbeiten identifizierten Zusammenhänge zwischen Parametern, Tokens und Trainings-Rechenaufwand, während spätere Studien die optimalen Verhältnisse revidierten und zeigten, dass viele große Models untertrainiert waren und dass Models am besten abschneiden, wenn Parameter und Trainings-Tokens in ähnlicher Größenordnung skaliert werden.
Neuere Analysen beziehen die Inference-Kosten ein und zeigen, dass kleinere Models, die länger trainiert werden, mit der Performance größerer Models mithalten können, wenn die Inference-Workloads hoch sind. Weitere Studien befassen sich damit, wie Fähigkeiten über Benchmarks hinweg skalieren, und zeigen, dass die Model-Effizienz mit besseren Architekturen, Datenqualität und Trainingsmethoden steigt.
Diese Erkenntnisse leiten die Model-Auswahl und Ressourcenplanung, indem sie ausgewogenes Skalieren, angemessene Trainingsdaten und die wachsende Bedeutung von Parameter- und Inference-Effizienz betonen.
Praxisbeispiel: Parallele TTC-Skalierung mit PaCoRe
PaCoRe (Parallel Coordinated Reasoning) ist ein quelloffenes Framework, das einen neuen Ansatz zur Skalierung von Test-Time-Compute (TTC) einführt.
Statt durch das Kontextfenster eines Models eingeschränkt zu sein, startet PaCoRe eine massive parallele Exploration, verdichtet und synthetisiert die Ergebnisse dann über eine Message-Passing-Architektur und ermöglicht so eine effektive Rechenskalierung über mehrere Millionen Tokens während der Inference.
PaCoRe liefert außerdem einen offenen Server, der mit beliebigen LLM-Endpoints verwendet werden kann, sodass Entwickler diesen parallelen Skalierungsansatz über verschiedene Models und Anbieter hinweg anwenden können.9
13. Skalierung der Model-Größe
Die Erhöhung der Anzahl der Parameter in einem Model bedeutet, es größer zu machen, in der Regel durch Hinzufügen weiterer Schichten oder durch Komplexermachen vorhandener Schichten. Größere Models können:
- Komplexere Muster erfassen: Mit mehr Parametern kann das Model komplexere Beziehungen in den Daten abbilden.
- Größere Datasets verarbeiten: Größere Models haben eine größere Kapazität, um umfangreiche Daten zu verarbeiten und daraus zu lernen.
Das Verhältnis zwischen Model-Größe und Performance kann jedoch abnehmende Erträge aufweisen. Eine 10x-Steigerung der Model-Größe führt nicht unbedingt zu einer 10x-Verbesserung der Performance.
Größere Models erfordern außerdem exponentiell mehr Rechen- und Speicherressourcen, was sie kostspielig und schwieriger zu trainieren machen kann. Ab einem bestimmten Punkt kann eine Vergrößerung der Model-Größe vernachlässigbare Gewinne bringen, insbesondere wenn das Dataset oder die Rechenressourcen unzureichend sind.
14. Daten skalieren
Die Verfügbarkeit und Größe des Datasets, das zum Trainieren eines Models verwendet wird, wirken sich erheblich auf dessen Performance aus:
- Größere Datasets verbessern die Generalisierung: Mit vielfältigeren und umfassenderen Daten lernt das Model ein breiteres Spektrum an Mustern und neigt weniger zu Overfitting.
- Besseres Verständnis seltener Ereignisse: Große Datasets helfen dem Model, seltene und vielfältige Muster zu lernen, wodurch es ungewöhnliche Fälle besser bewältigen kann.
Das Skalieren von Daten hat jedoch ebenfalls Grenzen:
- Abflachende Zuwächse: Ab einem bestimmten Punkt bringt das Hinzufügen weiterer Daten abnehmende Performance-Erträge, da das Model die meisten nützlichen Muster bereits gelernt hat.
- Qualität vor Quantität: Schlechte oder verrauschte Daten verbessern die Performance möglicherweise nicht, selbst in großen Mengen.
- Rechenengpass: Größere Datasets erfordern mehr Rechenleistung und Trainingszeit, was prohibitiv sein kann.
15. Retrieval-Augmented Generation (RAG)
Retrieval-Augmented Generation ist zu einer wesentlichen Strategie zur Verbesserung von KI-Modelle geworden, ohne sich ausschließlich auf größere Models oder mehr Rechenressourcen zu stützen. RAG-Systeme integrieren ein Large Language Model mit einer externen Wissensbasis und ermöglichen es dem Model, in Echtzeit auf relevante Informationen zuzugreifen.
Zu den wichtigsten Vorteilen gehören:
- Verringerung der Notwendigkeit, Models neu zu trainieren, wenn neue Informationen entstehen.
- Verbesserung der Performance bei speziellen Geschäftsfunktionen, indem Ausgaben in kuratierten Datenquellen verankert werden.
- Minderung der Risiken veralteter oder halluzinierter Antworten, indem Systeme Hintergrundquellen zitieren können.
Dieser Ansatz ist heute in Enterprise-KI-Lösungen üblich, in denen Trainingsdaten nicht mit sich schnell ändernden Bereichen wie Finanzen, Recht oder Kundenservice Schritt halten können.
16. Memory-Augmented Systems
Memory-Augmented Systems geben Models Zugriff auf persistenten oder sitzungsbezogenen Speicher. Dadurch kann das Model den Kontext über Aufgaben und Interaktionen hinweg aufrechterhalten.
Wichtige Merkmale sind:
- Unterstützung für langfristigen Kontext, der nicht durch die Prompt-Länge begrenzt ist.
- Verbesserte Konsistenz über mehrstufige Workflows hinweg.
- Bessere Ausrichtung auf Anwendungsfälle, die Kontinuität erfordern, wie Projektarbeit oder komplexe Analysen.
17. Compute skalieren
Das Skalieren von Compute umfasst die Erhöhung der während des Trainings oder der Inference verfügbaren Rechenleistung, typischerweise durch:
- Leistungsstärkere Hardware: GPUs, TPUs oder spezialisierte KI-Chips.
- Verteilte Systeme: Training über mehrere Maschinen hinweg parallel, um große Workloads zu bewältigen.
- Längere Trainingsdauern: Dem Model ermöglichen, seine Gewichte über mehr Iterationen zu optimieren.
Das Verhältnis zwischen Compute und Model-Performance ist grundlegend:
- Mehr Compute ermöglicht größere Models: Das Skalieren von Compute ermöglicht das Training von Models mit mehr Parametern.
- Verlängertes Training: Mit ausreichend Compute können Models über längere Zeiträume auf größeren Datasets trainiert werden, was zu einer besseren Optimierung führen würde.
Das Skalieren von Compute bringt jedoch auch Herausforderungen mit sich:
- Abnehmende Erträge: Während sich die Performance mit mehr Compute verbessert, verlangsamt sich die Verbesserungsrate, wenn die Ressourcen steigen.
- Kosten- und Energiebedarf: Das Training fortschrittlicher Models wie GPT-4 erfordert erhebliche finanzielle und ökologische Ressourcen.
Trotz dieser Herausforderungen war das Skalieren von Compute entscheidend für Fortschritte im KI-Machine-Learning.
In der Inference-Phase kann sich die Performance eines KI-Modelle verbessern, insbesondere bei Aufgaben, die Mathematik oder mehrstufiges Reasoning erfordern, indem mehr Rechenzeit zugewiesen wird. Dies wird häufig durch Strategien wie erhöhte Berechnung pro Abfrage oder iterative Verfeinerung erreicht. So funktioniert es:
Was passiert während der Inference?
Inference ist die Phase, in der ein vortrainiertes Model verwendet wird, um auf der Grundlage neuer Eingaben Vorhersagen zu generieren oder Aufgaben auszuführen. Anders als beim Training aktualisiert die Inference die Gewichte des Models nicht, sondern stützt sich auf dessen erlernte Fähigkeiten, um bestimmte Probleme zu lösen.
Warum hilft mehr Rechenzeit?
Bei Aufgaben wie mathematischen Berechnungen oder mehrstufigem Reasoning profitiert das Model von mehr Zeit und Ressourcen pro Abfrage, weil:
- Iterative Verfeinerung: Bei Aufgaben, die mehrere logische Schritte erfordern, kann das Model das Problem in kleinere Teile zerlegen, jeden Teil lösen und seine Lösung iterativ verfeinern. Mehr Compute ermöglicht es dem Model, diese Schritte gründlicher zu verarbeiten.
- Erhöhte Präzision: Bei mathematischen Aufgaben ermöglicht eine längere Inference-Zeit eine tiefere Untersuchung von Mustern oder Trial-and-Error-Mechanismen, um korrekte Lösungen anzunähern.
- Besseres kontextuelles Verständnis: Bei Aufgaben wie mehrstufigem Reasoning kann ein Model mit mehr Rechenzeit den Kontext wiederholt auswerten, um sicherzustellen, dass Zwischenschritte mit dem übergeordneten Problem übereinstimmen.
18. Inference-Time-Compute-Skalierung
Inference-Time-Compute-Skalierung bedeutet, einem Model während der Inference mehr Rechenleistung zuzuweisen. Dieser Ansatz unterstützt längere Reasoning-Spuren und mehrstufige Auswertung, ohne die Parameter des Models zu verändern.
Zu den wichtigsten Punkten gehören:
- Models können Zwischenschritte für Aufgaben, die Reasoning erfordern, iterativ verfeinern.
- Die Genauigkeit steigt, wenn das Model tiefere Inference-Pfade durchlaufen darf.
- Performance-Gewinne werden ohne Retraining erzielt, wodurch sich diese Methode für häufige Aktualisierungen eignet.
Praxisbeispiel: Fähigkeitsgewinne durch Post-Training und Inference-Time
Anthropics Claude Opus 4.6 zeigt, wie sich Frontier-KI-Systeme durch Verbesserungen beim Inference-Time-Reasoning und bei der Tool-Integration weiterentwickeln. Diese Gewinne zeigen sich in leistungsfähigerem agentischem Coding, bei dem das Model mehrstufige Softwareaufgaben planen, große Codebasen navigieren und eigene Fehler iterativ beheben kann.
Sie zeigen sich auch in stärkerer Tool-Nutzung und koordinierten Agenten-Workflows, etwa in Agententeams in Claude Code, die komplexe Aufgaben aufteilen und ausführen.
Darüber hinaus unterstützt Opus 4.6 lange Kontextfenster (in der Beta bis zu ~1 Million Tokens), sodass es die Kohärenz über lange Dokumente, Codebasen und mehrstufige Interaktionen hinweg aufrechterhalten kann.
Together verdeutlichen diese Entwicklungen, wie Systemdesign und Inference-Time-Techniken sinnvolle Fähigkeitsgewinne über das reine Basistraining hinaus vorantreiben.
Abbildung 2: Diagramm, das die Performance von Opus 4.6 im Terminal Bench zeigt. Terminal Bench ist eine Benchmarking-Suite zur Evaluierung von KI-Agents, die in Terminal-Umgebungen arbeiten.10
Praxisbeispiel: Gemini 3 Deep Think
Googles Gemini 3 Deep Think ist darauf ausgelegt, komplexe wissenschaftliche, mathematische und technische Probleme mit tieferer inferenzieller Suche und Multi-Hypothesen-Exploration zu lösen.
Deep Think verbessert die Performance, indem es ändert, wie das Model zur Inference-Zeit schlussfolgert, und schwierigeren Problemen mehr Compute zuweist, statt sich ausschließlich auf eine größere Parameterzahl zu verlassen.
Dies zeigt, dass Reasoning-Modalitäten, bei denen ein Model in einen für schwierigere analytische Aufgaben optimierten Deep-Thinking-Modus wechseln kann, sich neben Parameterzahl und Tooling-/Bereitstellungsverbesserungen als eigenständiges Konzept des KI-Fortschritts herausbilden.
Abbildung 3: Diagramm, das die Performance von Deep Think bei den Benchmarks ARC-AGI 2, Humanity's Last Exam, MMMU-Pro und Codeforces zeigt.11
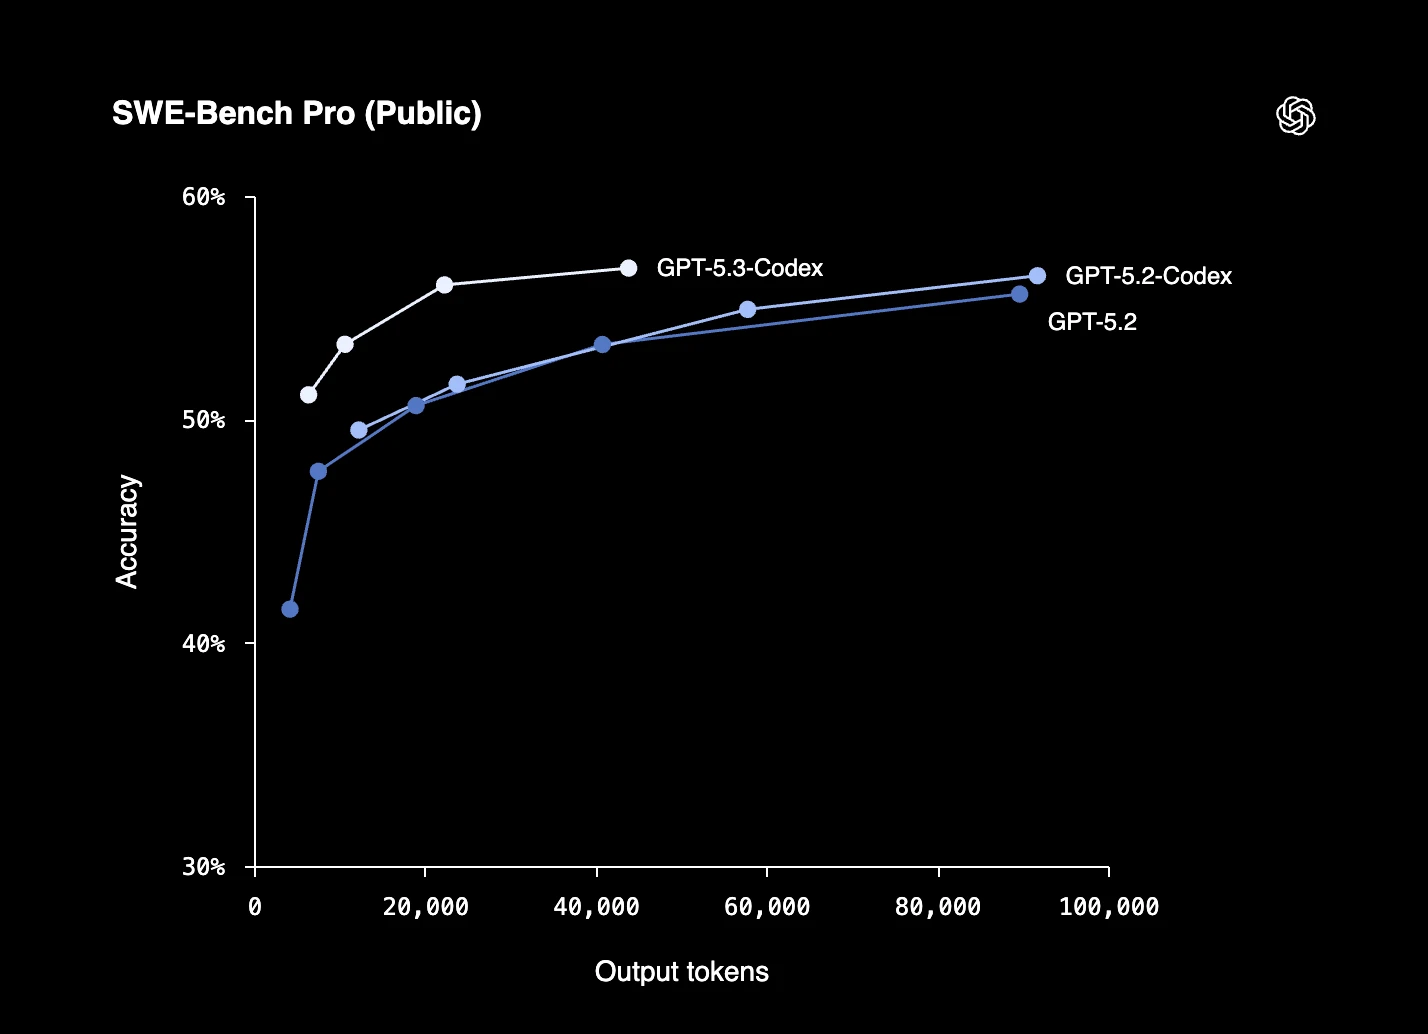
Praxisbeispiel: GPT-5.3-Codex-Spark
OpenAIs GPT-5.3-Codex-Spark ist ein codingorientiertes Model, das als geschwindigkeitsoptimierte Variante von GPT-5.3-Codex positioniert ist und für Echtzeit-Entwickler-Workflows gedacht ist.
Zu den wichtigsten Funktionen gehören:
- High-Throughput-Inference: Konzipiert für latenzarmes Coding-Assistenz, mit gemeldeten Ausgabegeschwindigkeiten von über 1.000 Tokens pro Sekunde in unterstützten Umgebungen.
- Großes Kontextfenster: Unterstützt bis zu 128.000 Tokens Kontext und ermöglicht so die Nutzung mit größeren Codebasen und längeren Sitzungen.
- Interaktive Coding-Workflows: Zielgruppe sind iterative Coding-Aufgaben wie Bearbeiten, Debugging und Code-Verfeinerung in Echtzeit.
- Infrastrukturfokus: Gebaut für den Betrieb auf latenzarmer Inference-Infrastruktur, einschließlich Bereitstellungen auf Cerebras-Hardware.
Abbildung 4: Benchmark-Performance von OpenAIs GPT-5.3-Codex-Spark im SWE-Bench Pro.12
19. Agentische KI
Statt sich auf ein einziges größeres Model zu verlassen, verwenden agentische Systeme verschiedene Models mit definierten Rollen wie Planung, Reasoning und Ausführung.
Zu den Vorteilen gehören:
- Skalierung der Reasoning-Fähigkeiten, ohne die Parameterzahlen endlos zu erhöhen.
- Größere Flexibilität bei der Tool-Nutzung durch Zuweisung von Aufgaben an das fähigste Model.
- Einfachere Einbeziehung von Feedback von Nutzern und Stakeholdern in verschiedenen Phasen eines Prozesses.
Ein Beispiel ist ein Multi-Agenten-System, bei dem ein Model Projektmanagementaufgaben übernimmt, ein anderes Eingaben in natürlicher Sprache interpretiert und ein drittes Datenabruf und -integration verwaltet. Together liefern diese Models bessere Ergebnisse als ein einzelnes Model, das allein arbeitet.
20. Model-Effizienztechniken
Als Reaktion auf die Kosten und Umweltauswirkungen des Trainings größerer Models sind Effizienztechniken in letzter Zeit in den Fokus gerückt. Diese Methoden ermöglichen es Entwicklern, die Performance zu verbessern und dabei weniger Ressourcen zu verbrauchen:
- Quantisierung reduziert den Speicherbedarf, indem sie die Präzision der Model-Parameter senkt, ohne die Qualität der Vorhersagen zu beeinträchtigen.
- Knowledge Distillation überträgt Fähigkeiten von einem großen Model in ein kleineres Model und ermöglicht so schnellere Inference.
- Pruning entfernt redundante Parameter, um die Komplexität zu reduzieren und gleichzeitig die Genauigkeit zu erhalten.
- Low-Rank Adaptation (LoRA) ermöglicht effizientes Fine-Tuning großer Models für domänenspezifische Aufgaben mit begrenzten Ressourcen.
Diese Techniken ermöglichen es KI-Systemen, über verschiedene Models und Geschäftskontexte hinweg skalierbarer zu sein und bessere Ergebnisse zu geringeren Kosten zu erzielen.
Empfehlungen für die Herangehensweise an die KI/ML-Model-Verbesserung
Die Verbesserung eines KI/ML-Models erfordert einen strategischen Ansatz, um Bereiche zu identifizieren, in denen effektive Lösungen umgesetzt werden können. Durch die Kombination von Performance-Monitoring und hypothesenbasierter Entscheidungsfindung können KI/ML-Models verfeinert und für bessere Ergebnisse optimiert werden:
Performance überwachen
Man kann etwas verbessern, indem man die Verbesserungsbereiche kennt. Dies kann durch die Überwachung der Features des KI/ML-Models geschehen. Wenn jedoch nicht alle Model-Features überwacht werden können, kann eine Auswahl wichtiger Features beobachtet werden, um Veränderungen in deren Ausgabe zu untersuchen, die sich auf die Performance des Models auswirken können.
Hypothesengenerierung
Vor der Auswahl der richtigen Methode empfehlen wir die Durchführung einer Hypothesengenerierung. Dies ist ein vorentscheidungsbezogener Prozess, der den Entscheidungsprozess strukturiert und die Optionen eingrenzt.
Dieser Prozess umfasst den Erwerb von Domänenwissen, die Untersuchung des Problems, mit dem das KI/ML-Model konfrontiert ist, und die Eingrenzung der verfügbaren Optionen, die identifizierten Probleme angehen können.
Iterative Verbesserung und Experimentieren
Die KI/ML-Model-Verbesserung ist ein fortlaufender Prozess. Nach der Bildung von Hypothesen und der Auswahl potenzieller Lösungen sind Experimentieren und Iteration der Schlüssel zur Verfeinerung des Models.
A/B-Testing: Testen Sie verschiedene Models oder Änderungen an Teilmengen von Daten, um Ergebnisse zu vergleichen. Dies hilft zu erkennen, welche Verbesserungen am effektivsten sind.
Model-Retraining: Trainieren Sie das Model regelmäßig mit neuen Daten, Feature-Updates oder Algorithmusanpassungen neu, um sicherzustellen, dass es relevant bleibt und sich an veränderte Bedingungen anpasst.
Automatisiertes Monitoring und Feedback-Schleifen: Nutzen Sie automatisierte Systeme für kontinuierliches KI-Feedback, um schnelle Anpassungen und rasche Iterationen bei Verbesserungen zu ermöglichen.
Feedback von Stakeholdern einbeziehen
Ein oft übersehener Teil des Model-Verbesserungsprozesses ist das Einholen von Input von Endnutzern oder Stakeholdern. KI-Feedback von Geschäftsteams, Fachexperten oder Endnutzern liefert wertvollen Kontext, um Vorhersagen zu verfeinern und reale blinde Flecken anzugehen.
Die Integration dieser Feedback-Schleife trägt dazu bei, dass sich das Model kontinuierlich anpasst und auf die betrieblichen Anforderungen abgestimmt bleibt.
Diese Feedback-Schleife stellt sicher, dass das Model weiterhin auf reale Bedürfnisse und Erwartungen abgestimmt bleibt.
Die wirkungsvollsten Änderungen priorisieren
Nicht alle Verbesserungen haben dieselbe Wirkung. Es ist wichtig, Änderungen zu priorisieren, die kritischsten Performance-Probleme direkt angehen.
Beispielsweise kann die Verbesserung der Datenqualität oder die Behebung eines erheblichen Bias im Model substanziellere Auswirkungen haben als geringfügige Anpassungen der Hyperparameter des Algorithmus.
Verbesserungsprozess dokumentieren und standardisieren
Dokumentieren Sie für kontinuierliche Verbesserungen die Methoden, Experimente und Ergebnisse.
Die Standardisierung dieses Prozesses ermöglicht es künftigen Verbesserungen, einem bewährten, strukturierten Ansatz zu folgen, sodass Verbesserungen gemessen, verglichen und nachverfolgt werden können.
 Als bevorzugte Quelle hinzufügen
FAQs
Die Entwicklung der künstlichen Intelligenz hat zu bemerkenswerten Fortschritten in der natürlichen Sprachverarbeitung (NLP) geführt. Heutige KI-Systeme können menschliche Sprache mit beispielloser Genauigkeit verstehen, interpretieren und erzeugen. Dieser bedeutende Sprung zeigt sich in hochentwickelten Chatbots, Sprachübersetzungsdiensten und sprachgesteuerten Assistenten.
Um die Genauigkeit Ihres KI-Modelle zu verbessern, sollten Sie mehr hochwertige und vielfältige Trainingsdaten sammeln. Fine-tunen Sie außerdem die Hyperparameter Ihres Models, experimentieren Sie mit verschiedenen Algorithmen und wenden Sie Techniken wie Kreuzvalidierung an, um die Performance zu optimieren.
Verhindern Sie KI-Overfitting, indem Sie Regularisierungstechniken anwenden, Dropout-Schichten in neuronalen Netzen implementieren und Early Stopping während des Trainings einsetzen. Auch die Vergrößerung Ihres Datasets und die Sicherstellung der Datenvielfalt können dazu beitragen, dass Ihr Model besser auf neue Eingaben generalisiert.
Diese Forschung zitieren
Wählen Sie das Format, das zu Ihrem Veröffentlichungsort passt. Wenn Sie die Link-Version in Ihr CMS einfügen, bleibt der Backlink erhalten.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Ermut, Sıla},
  title  = {{20 Strategien zur KI-Verbesserung & Beispiele}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/ai-improvement}},
  note   = {AIMultiple. Abgerufen am 15. Juni 2026}
}Ergebnisse und Zeitstempel von 4 Datenpunkten. Laden Sie die Zusammenfassungsdaten aus den Diagrammen und Tabellen dieses Artikels als ZIP-Datei herunter, die eine CSV-Datei enthält.
Möchten Sie die granularen Daten dahinter? Premium beitreten
Änderungsprotokoll
10 AktualisierungenErsetzte das „Praxisbeispiel: GPT4 mit MoE“ in Abschnitt 7 durch „Praxisbeispiel: Kimi K2.5“.
Referenzlinks
Cems Arbeit bei AIMultiple wurde von führenden globalen Publikationen wie Business Insider, Forbes, Morning Brew und Washington Post, von globalen Unternehmen wie Deloitte und HPE, von NGOs wie dem World Economic Forum und von supranationalen Organisationen wie der European Commission zitiert. [1], [2], [3], [4], [5]
Im Laufe seiner Karriere war Cem als Tech-Berater, Tech-Einkäufer und Tech-Unternehmer tätig. Er beriet Unternehmen bei ihren Technologieentscheidungen bei McKinsey & Company und Altman Solon über mehr als ein Jahrzehnt. Er veröffentlichte außerdem einen McKinsey-Bericht zur Digitalisierung.
Er leitete Technologiestrategie und -beschaffung eines Telekommunikationsunternehmens und berichtete dabei direkt an den CEO. Außerdem verantwortete er das kommerzielle Wachstum des Deep-Tech-Unternehmens Hypatos, das innerhalb von zwei Jahren von 0 einen siebenstelligen jährlich wiederkehrenden Umsatz und eine neunstellige Bewertung erreichte. Cems Arbeit bei Hypatos wurde von führenden Technologiepublikationen wie TechCrunch und Business Insider aufgegriffen.
Cem spricht regelmäßig auf internationalen Technologiekonferenzen. Er absolvierte die Bogazici University als Computeringenieur und hat einen MBA von der Columbia Business School.

Zuvor arbeitete sie als Personalvermittlerin in Projektmanagement- und Beratungsunternehmen. Sıla hat einen Master of Science in Sozialpsychologie und einen Bachelor of Arts in Internationalen Beziehungen.





Seien Sie der Erste, der kommentiert
Ihre E-Mail-Adresse wird nicht veröffentlicht. Alle Felder sind erforderlich. Kommentare werden in ihrer Originalsprache belassen.