


Große multimodale Modelle (LMMs) vs. LLMs

Bewerten Sie LLMs und LMMs, indem Sie deren Benchmark-Ergebnisse und reale Latenz vergleichen, indem Sie in der folgenden Tabelle auf den Namen des Modells klicken. Sie können außerdem deren Ein- und Ausgabepreise abwägen, um Gesamteffizienz und -wert zu beurteilen.
Große multimodale Modelle mit offenen Gewichten
*Audio ist nativ nur bei den Modellen E2B, E4B und 12B.
Gemma 4 (Google DeepMind)
Verfügbar in fünf Größen: E2B, E4B, 12B, 26B A4B und 31B. Die Familie verarbeitet Text und Bilder mit variablen Seitenverhältnissen und Auflösungen über alle Modelle hinweg. Sie unterstützt außerdem Video und Audio, wobei Audio nativ bei den Modellen E2B, E4B und 12B verfügbar ist.1
Die 12B-Variante ist architektonisch am bemerkenswertesten. Google ersetzte den Vision-Encoder durch ein leichtgewichtiges Einbettungsmodul und entfernte den Audio-Encoder vollständig, wodurch das rohe Audiosignal in denselben dimensionalen Raum wie Text-Tokens projiziert wird. Ohne multimodale Encoder in der Pipeline sinkt die Latenz, und das Modell wird klein genug, um auf einem Laptop-GPU mit 16 GB Arbeitsspeicher ausgeführt zu werden.
Kimi K3 (Moonshot KI)
Ein 2.8T-Parameter-Modell, das auf Kimi Delta Attention und Attention Residuals aufbaut, mit nativen Vision-Fähigkeiten und einem 1-Million-Token-Kontextfenster. Moonshot beschreibt es als das erste offene Modell in der Klasse der 3-Billionen-Parameter.
Sein Vision-Encoder MoonViT-V2 wurde von Grund auf anhand des Next-Token-Vorhersageziels des Modells trainiert und wurde nicht aus einem kontrastiv vortrainierten Vision-Modell wie SigLIP initialisiert.2
MiniMax M3
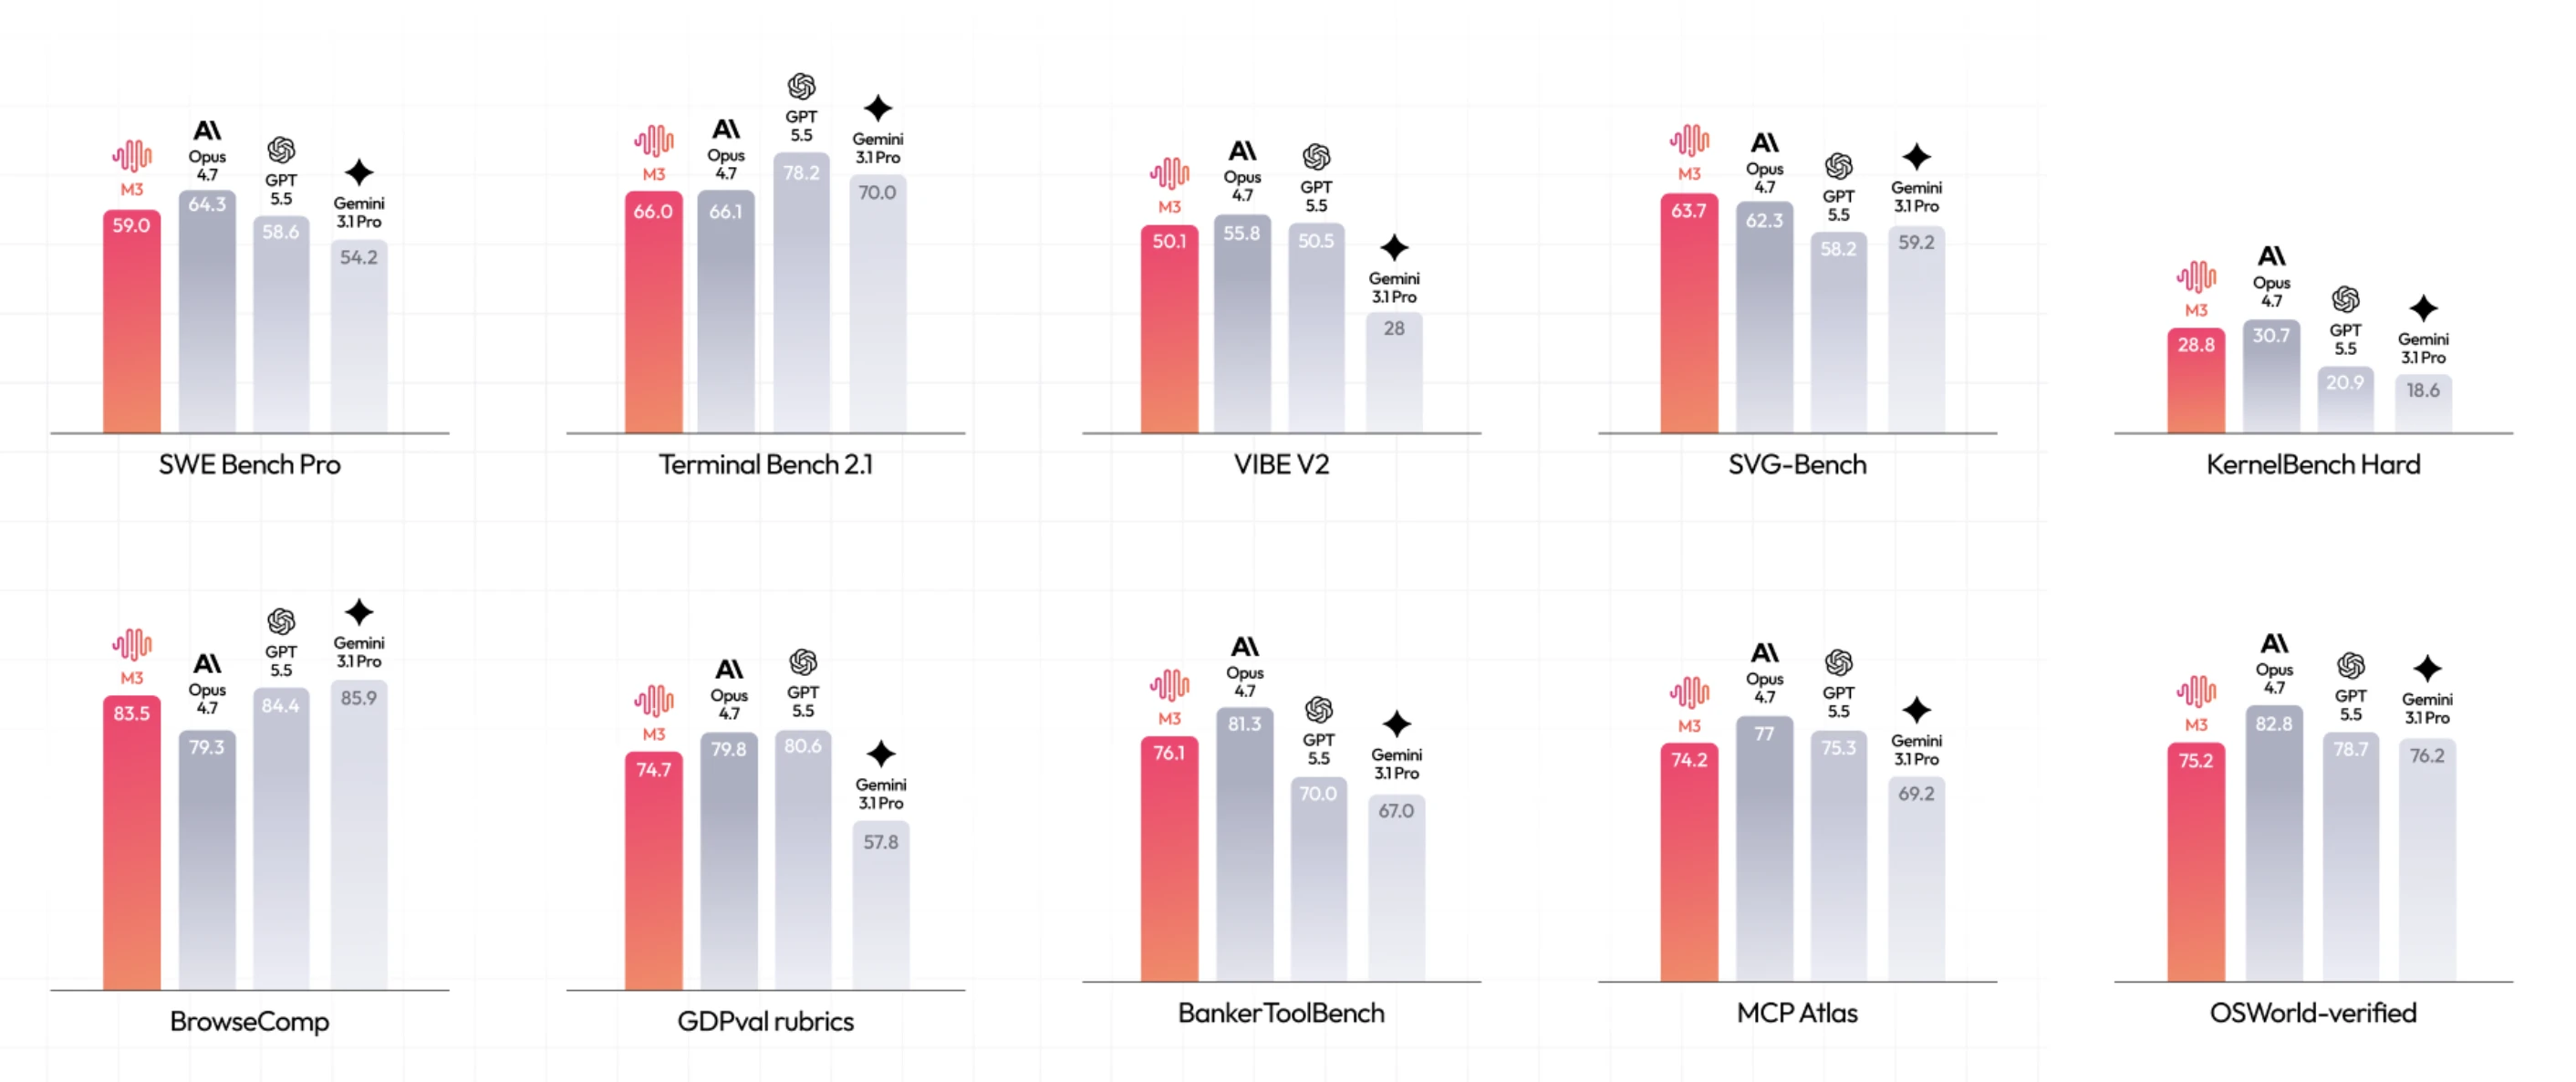
Ein natives multimodales Modell mit rund 428B Parametern und 23B aktivierten Parametern, trainiert auf gemischten Modalitäten (Text, Bild und Video). MiniMax präsentiert es als das erste Open-Weight-Modell, das Frontier-Coding-Leistung, ein 1M-Token-Kontextfenster und native Multimodalität in einem einzigen System vereint. Es kann außerdem einen Desktop-Computer anhand von Screenshots bedienen.
Abbildung 1: Minimax M3 Benchmark-Ergebnisse.3
GLM-5.3-Flash (Z.ai)
Das erste native multimodale Modell der GLM-5-Serie mit insgesamt 320B Parametern und 18B aktivierten Parametern und das erste Open-Source-Frontier-Modell, das spärliche und lineare Aufmerksamkeit kombiniert.
Z.ai berichtet, dass das Hybriddesign die Aufmerksamkeitsberechnung und den KV-Cache um 3.01x bzw. 4.44x gegenüber GLM-5.3 reduziert.4
DeepSeek-V4.1-Flash
DeepSeek-V4.1-Flash ist das kleinste Modell in der Architekturfamilie von DeepSeek und das erste in der Reihe, das natives visuelles Verständnis unterstützt.
Es verwendet ein 552-Billionen-Parameter-Mixture-of-Experts-Design mit einer Causal-Encoder-Decoder-Architektur und nutzt acht Milliarden aktive Parameter für die Eingabe und 16 Milliarden für die Ausgabe. Es ersetzte sowohl V4 Flash als auch das experimentelle V4 Flash Vision Exp, deren Modellnamen jetzt aus Kompatibilitätsgründen zum neuen Endpoint weitergeleitet werden.5
Proprietäre große multimodale Modelle
GPT-6 Astra (OpenAI)
OpenAI positioniert Astra als State-of-the-Art bei Computer-Nutzung, Browsing, Softwareentwicklung, Cybersicherheit, Wissenschaft und professioneller Arbeit, mit einem 98 %-Score bei FrontierMath Tier 4 und 99,9 % bei ARC-AGI-3.6
Es ist das erste Modell des Unternehmens, das unter seinem Preparedness Framework das Critical-Level der Cybersicherheitsfähigkeit erreicht, und die öffentlich verfügbare Version lehnt daher fortgeschrittene Cyberarbeit ab. Das Modell akzeptiert Text und Bilder und gibt Text zurück.
Gemini Omni (Google DeepMind)
Gemini Omni ist die Familie nativ multimodaler generativer Modelle von Google, und die erste Veröffentlichung ist Gemini Omni Flash.
Google beschreibt es als Modell, das aus jeder Eingabe alles erstellen kann, beginnend mit Video: Nutzer liefern eine beliebige Kombination aus Bildern, Audio, Video und Text und erhalten Video, das auf dem realen Weltwissen von Gemini basiert, das sie dann durch Konversation überarbeiten können, anstatt es von Grund auf neu zu generieren.7
Qwen3.8-Omni-Flash (Alibaba)
Qwen3.8-Omni-Flash akzeptiert Text, Bild, Audio und Video innerhalb eines einzigen 1M-Token-Kontexts, verarbeitet pro Aufruf bis zu einer Stunde kontinuierliches Audio und Video und gibt Text zurück.
Bei einem Video und einer Frage erkennt es, was weitere Untersuchung verdient, durchsucht multimodale Quellen im Web und erstellt einen illustrierten Forschungsbericht. Nutzer können nur über die gehostete API darauf zugreifen; beim Start gibt es keine offenen Gewichte.
Claude Opus 5 (Anthropic)
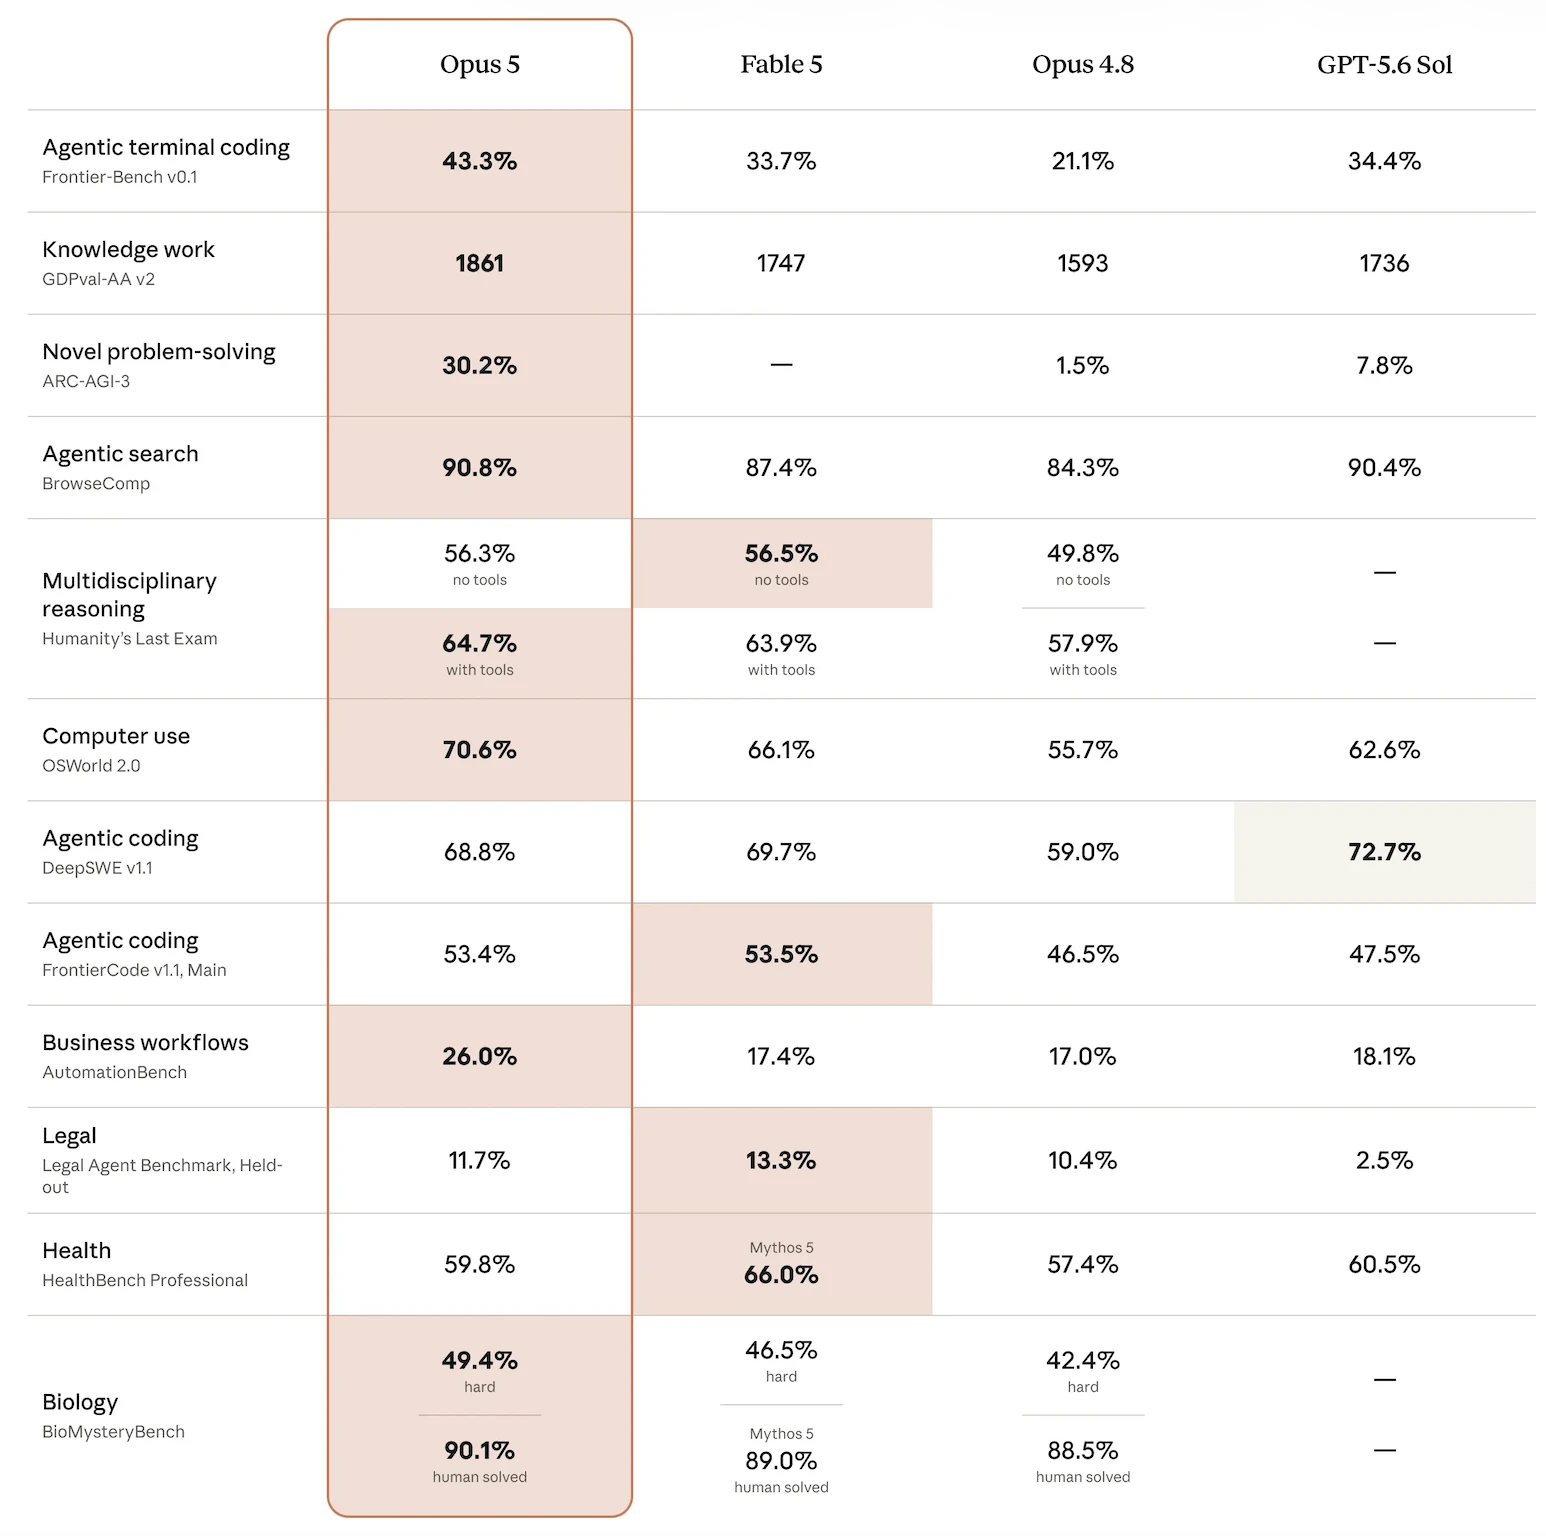
Anthropic’s Modell Opus 5 wird als nahe an der Frontier-Intelligenz von Claude Fable 5 positioniert, und das bei halben Kosten. Bei Evaluierungen für Programmierung und Wissensarbeit, einschließlich Frontier-Bench und GDPval-AA, bezeichnet Anthropic es als State of the Art, weist jedoch darauf hin, dass es bei Cybersicherheitsaufgaben hinter Mythos 5 zurückliegt.
Der Preis beträgt $5 pro Million Eingabe-Tokens und 25 $ pro Million Ausgabe-Tokens, wie bei Opus 4.8, mit einem Fast-Modus, der etwa zweieinhalb Mal so schnell wie die Standardgeschwindigkeit läuft, zum doppelten Basistarif.
Abbildung 2: Claude Opus 5 Benchmark-Ergebnisse.8
Grok 4.6 (xAI)
Aufbauend auf Grok 4.5 konzentriert es sich auf lang laufende Agenten und ambitioniertere interaktive und visuelle Arbeit, wobei es eine Aufgabe über viele Schritte hinweg beibehält, ob es ein Thema recherchiert, an einer Codebasis arbeitet oder eine Idee in eine fertige Anwendung verwandelt.
In den veröffentlichten Evaluierungen von xAI erreicht Grok 4.6 69,9 % bei CursorBench v3.2, vor GPT-5.6 Sol Max mit 67,2 % und knapp hinter Fable 5 Max mit 70,5 %, und erzielt den höchsten Score der vier verglichenen Modelle bei Harvey LAB mit 15,8 %. Der Preis beginnt bei $2 pro Million Eingabe-Tokens und $6 pro Million Ausgabe-Tokens, mit einer schnellen Variante zum doppelten Tarif.9
Muse Spark (Meta)
Muse Spark ist das erste Modell der Muse-Familie von Meta Superintelligence Labs. Meta beschreibt es als nativ multimodales Reasoning-Modell, das Tool-Nutzung, visuelles Chain-of-Thought und Multi-Agenten-Orchestrierung unterstützt.
Das Modell integriert visuelle Informationen über Domänen und Tools hinweg und schneidet bei visuellen MINT-Fragen, Entitätserkennung und Lokalisierung gut ab. Zu den Anwendungsfällen gehören das Erstellen kleiner Spiele oder die Fehlerbehebung bei einem Haushaltsgerät mit Anmerkungen, die über das gezeichnet werden, was die Kamera sieht.
Für den Gesundheitsbereich arbeitete Meta mit mehr als tausend Ärzten zusammen, um Trainingsdaten zu kuratieren, und das Modell erzeugt interaktive Darstellungen, die Informationen wie den Nährstoffgehalt von Lebensmitteln oder die bei einer bestimmten Übung beanspruchten Muskeln erklären.
Amazon Nova 2 Omni
Amazon Nova 2 Omni verarbeitet Text-, Bild-, Video- und Spracheingaben und generiert gleichzeitig Text und Bilder, wobei es bis zu 750.000 Wörter, stundenlanges Audio, lange Videos und hundertseitige Dokumente in einem einzigen Durchgang verarbeitet.
Seit Ende Juli ist das Modell für Nova-Forge-Kunden im Early Access verfügbar.10
Was sind die Unterschiede zwischen LMMs und LLMs?
Wie funktionieren LMMs?
Große multimodale Modelle weisen in Training, Design und Betrieb Ähnlichkeiten mit großen Sprachmodellen auf. Sie verwenden dieselbe Transformer-Architektur und dieselben Trainingsstrategien. Große multimodale Modelle werden trainiert mit:
- Textdaten
- Millionen oder Milliarden von Bildern mit Textbeschreibungen
- Videoclips
- Audioausschnitte
- Weitere Eingabedaten, wie Code
Dieses Training umfasst das gleichzeitige Lernen mehrerer Datenmodalitäten und ermöglicht es dem Modell:
- Ein Foto von einer Katze zu erkennen
- Ein Wort in einem Audioausschnitt zu identifizieren
- Konzepte und sensorische Details über Text hinaus zu verstehen
Auf diese Weise können Nutzer Folgendes hochladen:
- Ein Bild, um:
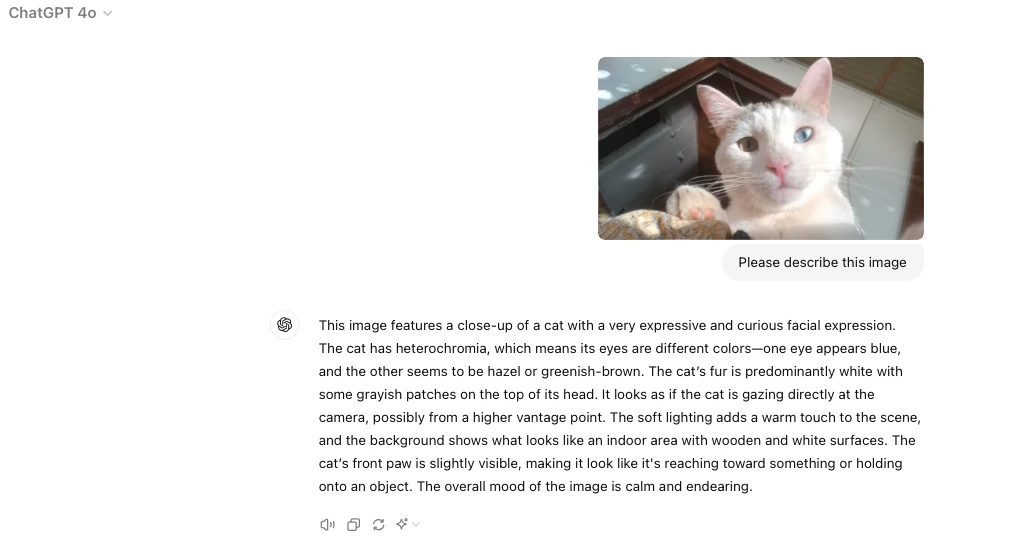
- Eine Beschreibung dessen zu erhalten, was passiert
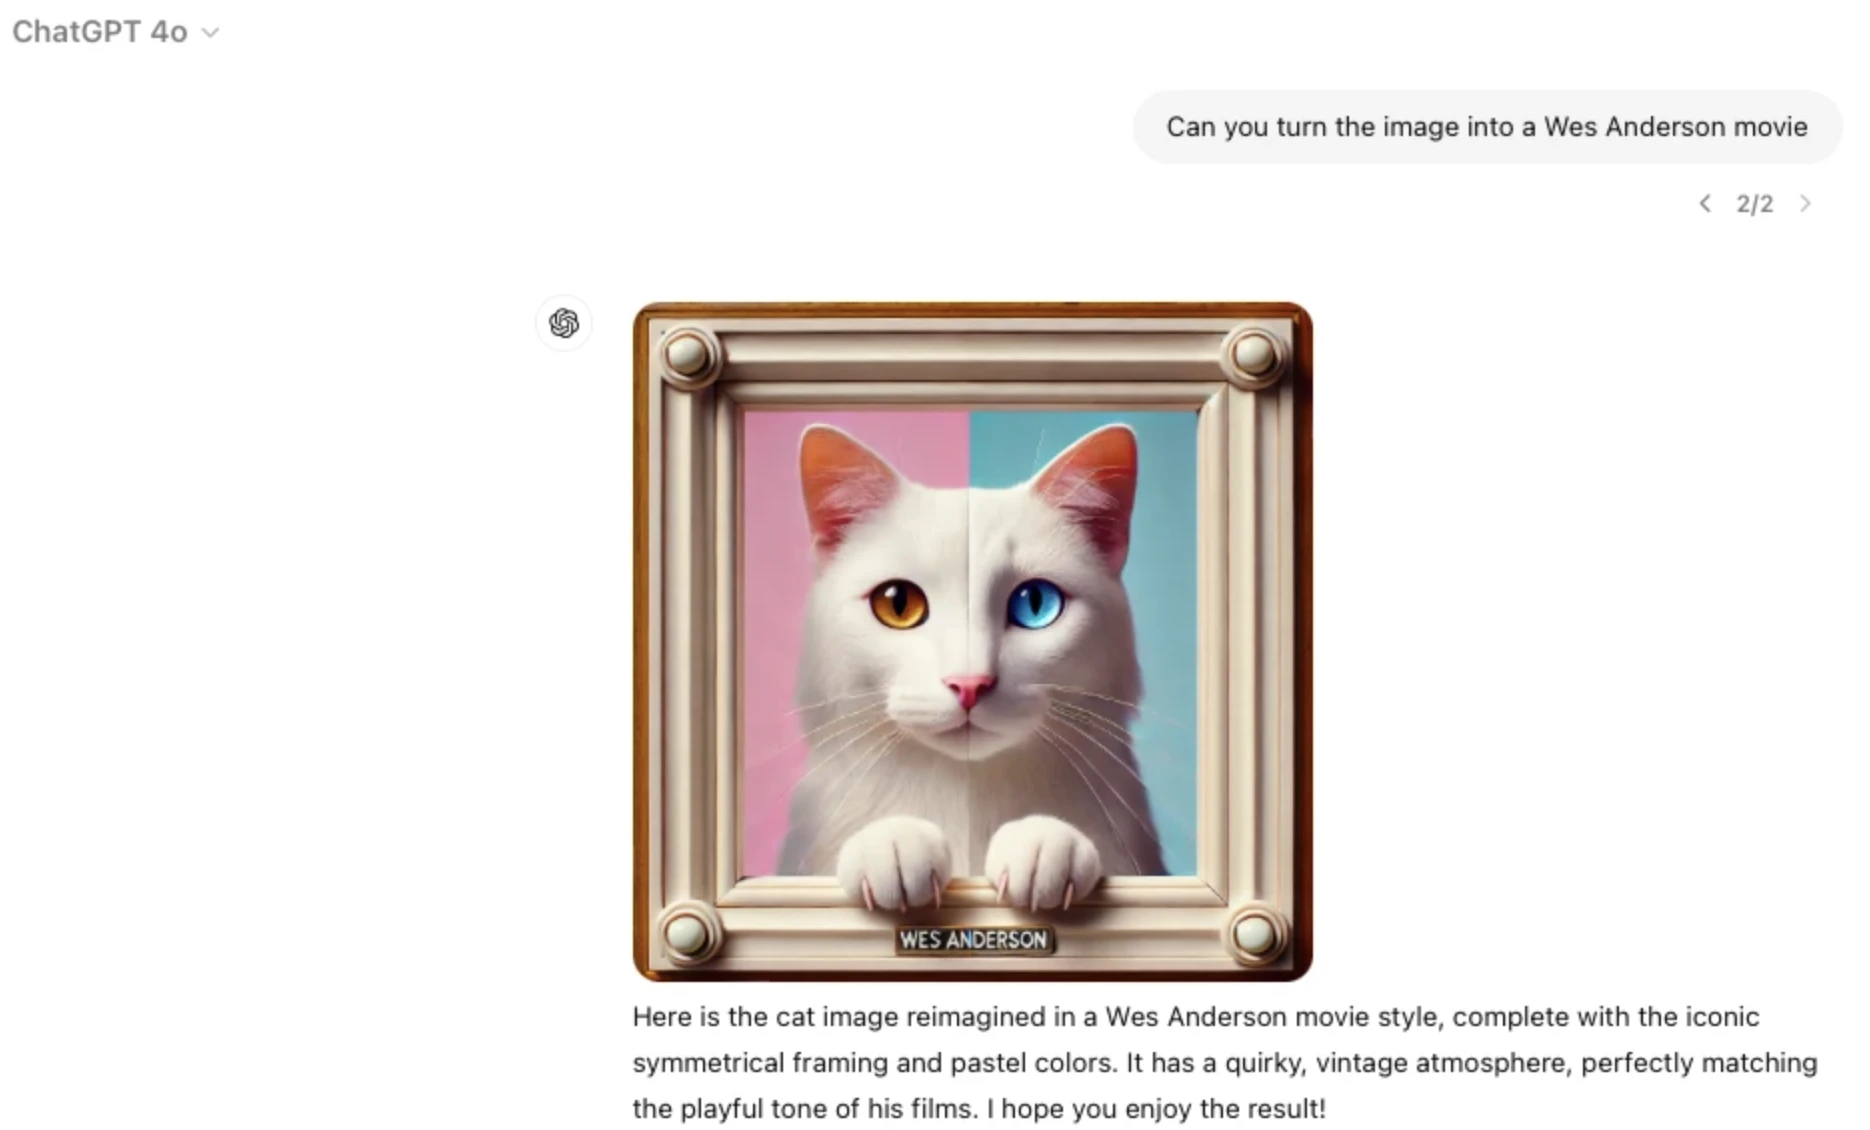
- Das Bild als Teil eines Prompts zu verwenden, um Text oder Bilder zu generieren
- Folgefragen zu bestimmten Elementen des Bildes zu stellen
- Den Text des Bildes in eine andere Sprache zu übersetzen (z. B. Menü)
Abbildung 3: Hochladen eines Bildes einer Katze auf ChatGPT, um es zu beschreiben.
- Diagramme und Grafiken, um:
- Komplizierte Folgefragen zu dem, was sie zeigen, zu stellen
- Design-Mockup, um:
- Den HTML- und CSS-Code zu erhalten, der zum Erstellen erforderlich ist.
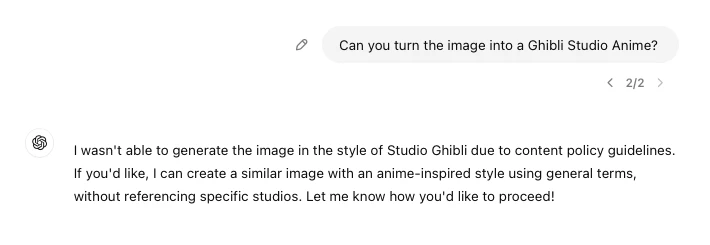
Abbildung 4: Prompting des Bildes im Stil eines Wes-Anderson-Films. ChatGPT leitet den Prompt an ein Bildgenerierungsmodell (wie DALL·E) weiter, das die Anfrage interpretiert und das gestaltete Bild erzeugt.
Nach dem Training können Modelle ungesunde Stereotype und toxische Ideen enthalten. Um sie zu verfeinern, können Techniken wie die folgenden eingesetzt werden:
- Reinforcement Learning mit menschlichem Feedback (RLHF)
- Überwachte KI-Modelle
- Red Teaming (Testen der Robustheit des Modells) eingesetzt werden.
Abbildung 5: ChatGPT lehnt meine Anfrage aufgrund von Richtlinien zu Inhalten ab, um Urheberrechte zu schützen.
Das Ziel ist die Entwicklung eines funktionalen multimodalen Systems, das Folgendes bewältigen kann:
- Text-zu-Bild-Synthese
- Bildbeschriftung
- Textbasierte Bildsuche
- Visuelle Fragenbeantwortung.
 Als bevorzugte Quelle hinzufügen
Diese Forschung zitieren
Wählen Sie das Format, das zu Ihrem Veröffentlichungsort passt. Wenn Sie die Link-Version in Ihr CMS einfügen, bleibt der Backlink erhalten.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Ermut, Sıla},
  title  = {{Große multimodale Modelle (LMMs) vs. LLMs}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/large-multimodal-models}},
  note   = {AIMultiple. Abgerufen am 21. September 2026}
}Ergebnisse und Zeitstempel von 49 Datenpunkten. Laden Sie die Zusammenfassungsdaten aus den Diagrammen und Tabellen dieses Artikels als ZIP-Datei herunter, die 4 CSV-Dateien enthält.
Möchten Sie die granularen Daten dahinter? Premium beitreten
Änderungsprotokoll
22 AktualisierungenDen Qwen3-VL-Modelleintrag im Produktabschnitt durch Qwen2.5-VL ersetzt.
Ein Gemini-3-Abschnitt hinzugefügt und die Qwen2.5-VL-Einträge durch Qwen3-VL-Modellbeschreibungen ersetzt.
Video-first multimodale Grundlagenmodelle, Mistral 3 multimodale Frontier-Veröffentlichung und Open-Source MoE Vision-Sprachmodelle wurden dem Abschnitt „Jüngste Fortschritte bei multimodalen Modellen“ hinzugefügt.
Referenzlinks
Cems Arbeit bei AIMultiple wurde von führenden globalen Publikationen wie Business Insider, Forbes, Morning Brew und Washington Post, von globalen Unternehmen wie Deloitte und HPE, von NGOs wie dem World Economic Forum und von supranationalen Organisationen wie der European Commission zitiert. [1], [2], [3], [4], [5]
Im Laufe seiner Karriere war Cem als Tech-Berater, Tech-Einkäufer und Tech-Unternehmer tätig. Er beriet Unternehmen bei ihren Technologieentscheidungen bei McKinsey & Company und Altman Solon über mehr als ein Jahrzehnt. Er veröffentlichte außerdem einen McKinsey-Bericht zur Digitalisierung.
Er leitete Technologiestrategie und -beschaffung eines Telekommunikationsunternehmens und berichtete dabei direkt an den CEO. Außerdem verantwortete er das kommerzielle Wachstum des Deep-Tech-Unternehmens Hypatos, das innerhalb von zwei Jahren von 0 einen siebenstelligen jährlich wiederkehrenden Umsatz und eine neunstellige Bewertung erreichte. Cems Arbeit bei Hypatos wurde von führenden Technologiepublikationen wie TechCrunch und Business Insider aufgegriffen.
Cem spricht regelmäßig auf internationalen Technologiekonferenzen. Er absolvierte die Bogazici University als Computeringenieur und hat einen MBA von der Columbia Business School.

Zuvor arbeitete sie als Personalvermittlerin in Projektmanagement- und Beratungsunternehmen. Sıla hat einen Master of Science in Sozialpsychologie und einen Bachelor of Arts in Internationalen Beziehungen.






Seien Sie der Erste, der kommentiert
Ihre E-Mail-Adresse wird nicht veröffentlicht. Alle Felder sind erforderlich. Kommentare werden in ihrer Originalsprache belassen.