


Vergleich großer Vision-Modelle: GPT-4o vs YOLOv8n
Große Vision-Modelle (LVMs) können visuelle Aufgaben wie Fehlererkennung, medizinische Diagnose und Umweltüberwachung automatisieren und verbessern.
Wir haben drei Objekterkennungsmodelle verglichen: YOLOv8n, DETR und GPT-4o Vision über jeweils 1.000 Bilder und dabei Metriken wie mAP@0.5, Inferenzgeschwindigkeit, FLOPs und Parameteranzahl gemessen. Um einen fairen Vergleich zu gewährleisten, wurden alle Bilder auf 800×800 Pixel skaliert und mit identischer Vorverarbeitung, identischen Konfidenzschwellen und IoU-basierten Abgleichskriterien ausgewertet.
Benchmark zur Objekterkennung: GPT-4o (Vision), YOLOv8n, DETR
mAP@0.5: Mittlere durchschnittliche Präzision (Mean Average Precision) bei einem Intersection over Union (IoU)-Schwellenwert von 0.5, die Genauigkeit der Objekterkennung durch Abwägung von richtig positiven und falsch positiven Ergebnissen misst.
Latenz (ms): Die durchschnittliche Verarbeitungszeit pro Bild, gemessen in Millisekunden, gibt die Geschwindigkeit des Modells an.
Benchmark-Ergebnisse
Die Objekterkennungsfähigkeiten von GPT-4o bleiben im Vergleich zu spezialisierten Modellen wie YOLOv8n und DETR begrenzt.
Genauigkeit:
- DETR: mAP@0.5 = 0.55
- YOLOv8n: 0.20
- GPT-4o: 0.02
Diese Ergebnisse zeigen, dass GPT-4o noch nicht für praktische Objekterkennungsaufgaben geeignet ist.
Latenz:
- YOLOv8n: 365 ms
- DETR: 3145 ms
- GPT-4o: 5150 ms
YOLOv8n bietet die schnellste Inferenz, aber eine geringere Genauigkeit, während DETR eine bessere Genauigkeit auf Kosten einer langsameren Verarbeitung erzielt.
Alle Modelle wurden aus Konsistenzgründen mit 800×800 Eingabebildern evaluiert. Parameteranzahl und FLOPS waren für YOLOv8n und DETR verfügbar, jedoch nicht für GPT-4o, was einen vollständigen Vergleich der Recheneffizienz verhindert.
Modellkomplexität:
- DETR: 41.52M Parameter, 59.56 GFLOPS
- YOLOv8n: 3.15M Parameter, 6.83 GFLOPS
Dies zeigt die Effizienz von YOLOv8n für Echtzeitanwendungen, während DETR Geschwindigkeit gegen höhere Genauigkeit und einen höheren Rechenaufwand eintauscht. Das Fehlen architektonischer Details zu GPT-4o schränkt eine tiefergehende Effizienzanalyse ein.
Siehe unsere Benchmark-Methodik.
Mögliche Gründe für die Leistungsunterschiede
Die drei Modelle zeigten unterschiedliche Genauigkeits- und Geschwindigkeitsniveaus, weil sie für unterschiedliche Zwecke gebaut sind und visuelle Informationen auf unterschiedliche Weise verarbeiten. GPT-4o ist ein multimodales großes Sprachmodell, das sowohl Text als auch Bilder akzeptiert, während YOLOv8n und DETR Objekterkennungssysteme sind, die nur mit Bildern arbeiten.
GPT-4o interpretiert visuelle Eingaben über eine sprachgesteuerte Argumentations-Pipeline. Es kann Szenen beschreiben und Objekte identifizieren, ist aber nicht dafür ausgelegt, Begrenzungsrahmen zu zeichnen oder eine hochpräzise räumliche Lokalisierung durchzuführen.
Seine Ausgaben hängen von multimodalem Denken ab und nicht von erkennungsspezifischen Mechanismen. Dadurch ist es bei Erkennungsaufgaben langsamer und ungenauer.
YOLOv8n und DETR verwenden Architekturen, die explizit für die Objekterkennung entwickelt wurden. Sie erzeugen Begrenzungsrahmen direkt, statt über sie nachzudenken.
YOLOv8n ist mit einer leichten Struktur auf Geschwindigkeit optimiert, während DETR ein transformerbasierter Detektor ist, der Bilder anders als YOLO verarbeitet und auf präzisere Vorhersagen abzielt.
Beide Modelle konzentrieren sich ausschließlich auf visuelle Eingaben und folgen Trainingszielen, die Bildmuster Objektpositionen zuordnen.
Zu den wichtigsten Unterschieden gehören:
- Eingabetyp
- GPT-4o: Bild und Text
- YOLOv8n und DETR: nur Bild
- Hauptfunktion
- GPT-4o: multimodales Verstehen und Denken
- YOLOv8n und DETR: Objekterkennung
- Ausgabemechanismus
- GPT-4o: zeichnet von sich aus keine Begrenzungsrahmen
- YOLOv8n und DETR: sagen Begrenzungsrahmen direkt voraus
Da YOLOv8n und DETR ausschließlich für die Objekterkennung entwickelt wurden, schneiden sie in Benchmarks zu Genauigkeit und Latenz naturgemäß besser ab.
Das breite, nicht erkennungszentrierte multimodale Design von GPT-4o führt bei gleicher Evaluierung zu einem niedrigeren mAP und höheren Inferenzzeiten.
Detaillierte Bewertung großer Vision-Modelle
OpenAI GPT-4o (Vision)
GPT-4o (Vision) ist eine multimodale Erweiterung von OpenAIs GPT-4, die darauf ausgelegt ist, Antworten aus Text und Bildern zu verarbeiten und zu generieren.
Diese Fähigkeit ermöglicht es GPT-4o, visuelle Inhalte zusammen mit textuellen Informationen zu interpretieren, und ermöglicht eine Reihe von Anwendungen, die das Verstehen und Analysieren von Bildern erfordern.
- Bildinterpretation: GPT-4o kann den Inhalt von Bildern analysieren und beschreiben, einschließlich der Identifizierung von Objekten, der Interpretation von Szenen und der Extraktion von Textinformationen aus visuellen Inhalten. Dies macht es nützlich für Aufgaben wie Bildbeschriftung und Inhaltszusammenfassung.
- Visuelle Datenanalyse: Das Modell kann Diagramme, Grafiken und Schaubilder interpretieren und Einblicke und Erklärungen auf der Grundlage visueller Daten liefern. Diese Funktion ist für Datenanalyse- und Bildungsanwendungen vorteilhaft.
- Multimodales Inhaltsverständnis: GPT-4o kann durch die Kombination von Text- und Bildeingaben umfassendere Antworten liefern. Es kann auch Anwendungen in der Social-Media-Analyse und Inhaltsmoderation verbessern. Zum Beispiel kann es die Stimmung bewerten oder Fehlinformationen in Beiträgen erkennen, die sowohl Text als auch Bilder enthalten.
Trotz seiner fortschrittlichen Fähigkeiten kann GPT-4o manchmal ungenaue oder unzuverlässige Ausgaben erzeugen. Es kann visuelle Elemente falsch interpretieren, Details übersehen oder falsche Informationen generieren, sodass bei kritischen Aufgaben eine menschliche Überprüfung erforderlich ist.
Das Modell kann auch Verzerrungen aus seinen Trainingsdaten widerspiegeln, was zu verzerrten Interpretationen oder der Verstärkung von Stereotypen führen kann. Dies ist in sensiblen Anwendungen ein Problem, in denen Unparteilichkeit entscheidend ist, etwa bei demografischen Schlussfolgerungen oder der Inhaltsmoderation.
OpenAI Sora
Sora ist ein Text-zu-Video-Modell, das von OpenAI entwickelt wurde. Es erzeugt kurze Videoclips aus Benutzereingaben und kann auch bestehende Videos verlängern. Die zugrunde liegende Technologie ist eine Adaption des DALL-E-3-Modells.
Sora ist ein Diffusions-Transformer, ein entrauschendes latentes Diffusionsmodell, das einen Transformer verwendet. Videos werden zunächst in einem latenten Raum erzeugt, indem 3D-„Patches“ entrauscht werden, und dann mithilfe eines Video-Dekompressors in den Standardraum konvertiert.
Re-Captioning wird eingesetzt, um den Trainingsprozess zu verbessern, wobei ein Video-zu-Text-Modell detaillierte Beschreibungen für Videos generiert.
Mit den neuesten Entwicklungen können Nutzer jetzt Videos mit bis zu 1080p-Auflösung, einer maximalen Dauer von 20 Sekunden und im Breitbild-, Hoch- oder Quadratformat erzeugen. Sie können auch eigene Assets einbinden, um bestehende Inhalte zu verlängern, neu zu mischen und zu verschmelzen oder neue Videos aus Textaufforderungen zu erstellen.
Abbildung 1: Soras Videogenerierungsbeispiel mit dem Prompt: „Eine weite, ruhige Aufnahme einer Familie von Wollmammuts in einer offenen Wüste“.1
Landing KI LandingLens
LandingLens vereinfacht die Entwicklung und Bereitstellung von Computer-Vision-Modellen. Es richtet sich an verschiedene Branchen, ohne tiefgehende KI- oder komplexe Programmierkenntnisse zu erfordern.
Die Plattform standardisiert Deep-Learning-Lösungen, verkürzt die Entwicklungszeit und ermöglicht eine einfache globale Skalierung von Projekten. Ohne die Produktionsgeschwindigkeit zu beeinträchtigen, können Nutzer eigene Deep-Learning-Modelle erstellen und die Prüfgenauigkeit optimieren.
Es bietet eine schrittweise Benutzeroberfläche, die den Entwicklungsprozess vereinfacht.
Abbildung 2: Das Diagramm veranschaulicht den LandingLens KI-Workflow, bei dem Eingabebilder zu Daten verarbeitet, zum Trainieren von Modellen verwendet, über Cloud, Edge oder Docker bereitgestellt und durch Feedback kontinuierlich verbessert werden.2
Stable Diffusion
Stable Diffusion ist ein Deep-Learning-Modell, das darauf ausgelegt ist, hochwertige Bilder aus Textbeschreibungen zu erstellen:
- Stable Diffusion basiert auf Diffusion. Der Prozess beginnt mit dem Hinzufügen von zufälligem Rauschen zu einem Bild, und das Modell lernt dann, das Original durch Umkehrung dieses Rauschens zu rekonstruieren.
- Dieser Prozess ermöglicht es dem Modell, völlig neue Bilder zu erzeugen, indem es die verrauschte Eingabe über mehrere Schritte verfeinert, bis ein klares, kohärentes Bild entsteht.
Stable Diffusion nutzt ein latentes Diffusionsmodell, um die Effizienz zu verbessern. Statt direkt mit hochauflösenden Bildern zu arbeiten, komprimiert es diese zunächst mithilfe eines variationalen Autoencoders (VAE) in einen niedrigerdimensionalen latenten Raum.
Dieser Ansatz reduziert den Rechenaufwand erheblich und ermöglicht den Betrieb auf Consumer-Hardware mit GPUs.
Anwendungen:
Neben der Erzeugung von Bildern aus Text kann Stable Diffusion für verschiedene kreative Aufgaben verwendet werden, wie zum Beispiel:
- Inpainting: Wiederherstellen oder Ausfüllen fehlender Teile eines Bildes.
- Outpainting: Erweitern der Bildränder, um mehr Inhalt hinzuzufügen.
- Bild-zu-Bild-Übersetzung: Umwandeln eines vorhandenen Bildes in einen anderen Stil oder Ändern seines Aussehens auf der Grundlage von Texteingaben.
Midjourney
Midjourney ist ein Kunstgenerator, der Textbeschreibungen in hochwertige Bilder umwandelt.
Funktionen
Midjourney Version 7 verfügt über eine komplett neu aufgebaute Architektur mit deutlichen Verbesserungen bei Qualität und Funktionalität.
Bilderzeugung: V7 erzeugt hochskalierte Bilder mit 2048 x 2048 Pixeln mit außergewöhnlicher Prompt-Präzision und nahezu fotografischer Qualität. Zu den wichtigsten Verbesserungen gehören reichere Texturen, die präzise Darstellung komplexer Elemente wie Hände und Gesichter sowie ein ausgefeiltes Verständnis von Licht und Komposition.
Videoerzeugung: Erstellt 5-21 Sekunden lange Videoclips mit hoher Bild-zu-Bild-Konsistenz. Das System erzeugt aus sechs Bildern in etwa drei Stunden ungefähr 60 Sekunden Video und zielt auf professionelle Anwendungen in Marketing, Filmproduktion und Content-Erstellung ab.
3D-Funktionen: Die Text-zu-3D-Generierung mithilfe NeRF-artiger Modellierung erstellt volumetrische Objekte und immersive Szenen. Diese Funktionen unterstützen Spieleentwicklung, Produktvisualisierung und Architekturanwendungen.
Abbildung 3: Die Bildbearbeitungsfunktion von Midjourney.3
DeepMind Flamingo
DeepMinds Flamingo ist ein Vision-Sprache-Modell, das darauf ausgelegt ist, Bilder und Videos mit minimalen Trainingsbeispielen zu verstehen und darüber nachzudenken (Few-Shot-Learning). Hier sind einige der wichtigsten Funktionen:
- Multimodales Few-Shot-Learning: Flamingo kann neue Aufgaben mit nur wenigen Beispielen effizient ausführen, im Gegensatz zu herkömmlichen KI-Modellen, die umfangreiche beschriftete Datensätze benötigen.
- Perceiver-Resampler-Mechanismus: Flamingo verwendet einen „Perceiver Resampler“, um visuelle Eingaben effizient zu verarbeiten. Er komprimiert Bild- und Videodaten in ein Format, das in ein großes vortrainiertes Sprachmodell integriert werden kann.
- Vision-Sprache-Abgleich mit Gated-Cross-Attention-Schichten: Spezielle Gated-Cross-Attention-Schichten helfen Flamingo, visuelle Daten mit textuellem Denken abzugleichen und zu integrieren. Diese Anwendung kann für das Verständnis bildbasierter Konversationen wichtig sein.
Flamingo verwendet eine bildweise Verarbeitung, zerlegt Videos in Schlüsselbilder und extrahiert Informationen, um visuelle Elemente effizient zu analysieren.
Seine kontextbewussten Antworten helfen, Untertitel, Beschreibungen und Antworten auf der Grundlage des Ereignisverlaufs in einem Video zu generieren, um ein kohärentes Verständnis des Inhalts zu gewährleisten.
Darüber hinaus zeigt Flamingo zeitliches Denken, um Sequenzen, Ursache-Wirkungs-Beziehungen und komplexe Interaktionen im Zeitverlauf zu verstehen. Dies macht es besonders effektiv für Videoanalysen und multimodale Denkaufgaben.
OpenAIs CLIP (Kontrastives Sprach-Bild-Vortraining)
CLIP ist ein neuronales Netz, das auf einer Vielzahl von Bildern und Textunterschriften trainiert wurde.
Dieses Modell kann verschiedene Bildverarbeitungsaufgaben ausführen, einschließlich Zero-Shot-Klassifizierung, indem es Bilder im Kontext natürlicher Sprache versteht.
CLIP wird auf 400 Millionen (Bild, Text)-Paaren trainiert, um die Lücke zwischen Computer-Vision-Aufgaben und natürlicher Sprachverarbeitung effektiv zu schließen. Dies hilft CLIP, Untertitelvorhersagen oder Bildzusammenfassungen zu erstellen, ohne explizit für diese spezifischen Aufgaben trainiert worden zu sein.
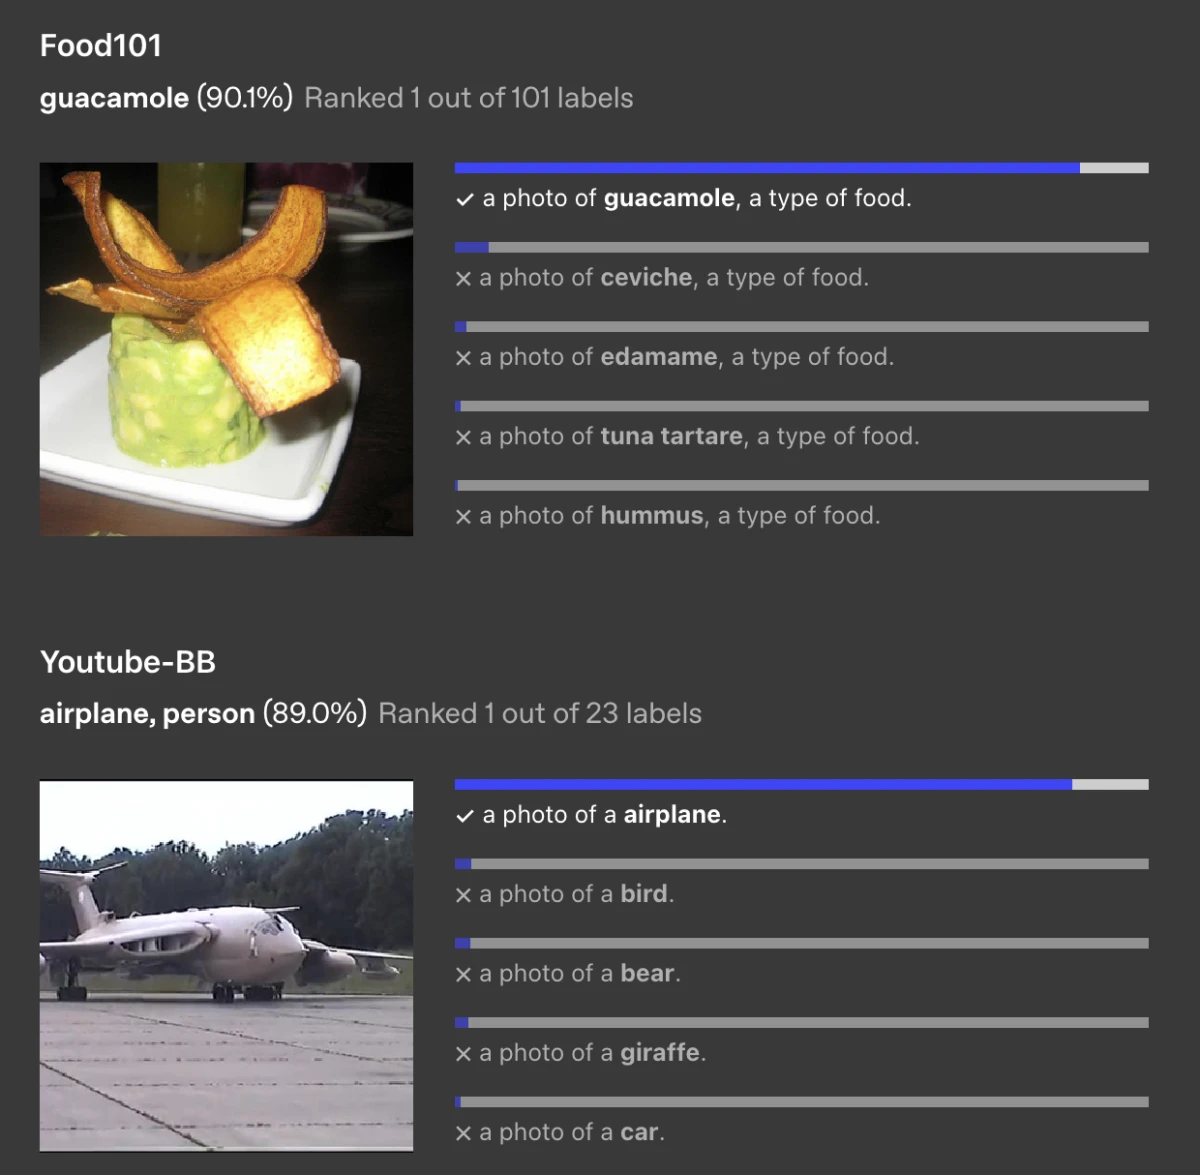
Abbildung 4: Bildidentifizierung durch CLIP aus verschiedenen Datensätzen.4
Googles Vision Transformer (ViT)
Vision Transformer wendet die Transformer-Architektur, die ursprünglich in der natürlichen Sprachverarbeitung verwendet wird, auf Bilderkennungsaufgaben an.
Es verarbeitet Bilder auf ähnliche Weise wie Transformer Wortfolgen verarbeiten, und es hat sich als effektiv beim Lernen relevanter Merkmale aus Bilddaten für Klassifizierungs- und Analyseaufgaben erwiesen.
Im Vision Transformer werden Bilder als eine Folge von Patches behandelt. Jeder Patch wird zu einem einzigen Vektor abgeflacht, ähnlich wie Wort-Embeddings in Transformern für Text verwendet werden.
Dieser Ansatz ermöglicht es ViT, die Bildstruktur zu lernen und unabhängig Klassenbezeichnungen vorherzusagen.
Video-native Foundation-Modelle
Video-native Foundation-Modelle stellen eine grundlegende Abkehr von traditionellen Computer-Vision-Ansätzen dar. Anders als frühere Systeme, die Videos als Folgen unabhängiger Einzelbilder verarbeiteten, behandeln diese Modelle Zeit als integrale Dimension visueller Daten.
Wichtige architektonische Innovationen
OpenAIs Sora veranschaulicht diese Entwicklung durch seine Diffusions-Transformer-Architektur:
- 3D raumzeitliche Patches: Verarbeitet Videodaten ganzheitlich statt Bild für Bild
- Zeitliche Konsistenz: Erhält die visuelle Qualität und narrative Kohärenz über Sequenzen hinweg aufrecht
- Langreichweitige Abhängigkeiten: Erfasst Ursache-Wirkungs-Beziehungen und Bewegungsmuster
- Physikbewusste Generierung: Versteht realistische Bewegung und Objektinteraktionen
Aktuelle Anwendungen
Content-Erstellung:
- Automatisierte Videobearbeitung und Szenensynthese
- Stilübertragung mit zeitlicher Konsistenz
- Narrative Videogenerierung aus Text-Prompts
Medizinische Bildgebung:
- Analyse der Herzbewegung in Echokardiogrammen
- Visualisierung des Blutflusses in der Angiographie
- Bewertung des dynamischen Gewebeverhaltens
Sicherheit und Überwachung:
- Aktivitätserkennung und -verfolgung
- Anomaly-Erkennung im Zeitverlauf
- Kontextbewusste Verhaltensanalyse
Verbleibende Herausforderungen
Trotz Fortschritten bestehen weiterhin mehrere Einschränkungen:
- Rechenaufwand: Die Generierung von Langformat-Videos bleibt ressourcenintensiv
- Physikalische Plausibilität: Komplexe Szenarien können unrealistische Physik erzeugen
- Charakterkonsistenz: Die Beibehaltung der Identität über längere Sequenzen hinweg ist schwierig
- Trainingsanforderungen: Große Videodatensätze mit Annotationen sind rar und teuer
On-Device-Inferenz und Edge-Optimierung
Edge-Bereitstellung ermöglicht es, Vision-Modelle lokal auf Smartphones, IoT-Geräten und eingebetteten Systemen auszuführen, wodurch die Abhängigkeit von Cloud-Infrastruktur entfällt.
Warum Edge-Bereitstellung wichtig ist
Datenschutzvorteile:
- Sensible visuelle Daten verlassen das Gerät nie
- Entscheidend für Gesundheitswesen, Überwachung und persönliche Anwendungen
- Einhaltung von Datenschutzbestimmungen
Leistungsvorteile:
- Nahezu keine Latenz ohne Netzwerk-Roundtrips
- Echtzeitverarbeitung für AR und autonome Systeme
- Zuverlässiger Betrieb in Offline-Umgebungen
Kosteneffizienz:
- Reduzierter Bandbreitenverbrauch
- Geringere Cloud-Computing-Kosten
- Minimale laufende Betriebskosten
Modellkomprimierungstechniken
Um große Vision-Modelle auf Edge-Geräten praktikabel zu machen, ist eine ausgefeilte Optimierung erforderlich:
- Quantisierung: Reduziert die Genauigkeit von 32-Bit auf 8-Bit- oder 4-Bit-Ganzzahlen
- Geringere Modellgröße
- Minimaler Genauigkeitsverlust
- Pruning: Entfernt redundante Parameter und Verbindungen
- Erzeugt dünn besetzte Netzwerke
- Behält die Leistung mit weniger Berechnungen bei
- Wissensdestillation: Überträgt Wissen von großen auf kleine Modelle
Was ist ein großes Vision-Modell (LVM)?
Große Vision-Modelle (LVMs) sind darauf ausgelegt, visuelle Daten wie Bilder oder Videos zu verarbeiten, zu analysieren und zu interpretieren. Sie zeichnen sich durch ihre große Anzahl an Parametern aus, oft in Millionen- oder Milliardenhöhe. Dadurch können sie komplexe Muster, Merkmale und Beziehungen in visuellen Inhalten lernen.
Ähnlich wie große Sprachmodelle (LLMs) für Text werden LVMs auf riesigen Datensätzen trainiert, was sie mit Fähigkeiten zur Objekterkennung, Bilderzeugung, Szenenverständnis und multimodalem Denken (Integration visueller und textueller Informationen) ausstattet.
Diese Modelle können Anwendungen in Bereichen wie autonomem Fahren, medizinischer Bildgebung, Content-Erstellung und erweiterter Realität unterstützen.
Struktur und Design
Große Vision-Modelle werden mit fortschrittlichen neuronalen Netzwerkarchitekturen erstellt. Ursprünglich waren Convolutional Neural Networks (CNNs) in der Bildverarbeitung vorherrschend, da sie Pixeldaten effizient verarbeiten und hierarchische Muster erkennen können.
In jüngster Zeit wurden Transformer-Modelle, die ursprünglich für die natürliche Sprachverarbeitung entwickelt wurden, auch für viele verschiedene Bildverarbeitungsaufgaben adaptiert und bieten in einigen Szenarien eine verbesserte Leistung.
Training
Das Training großer Vision-Modelle umfasst die Zuführung visueller Daten wie Internetbilder oder -videos zusammen mit relevanten Labels oder Annotationen im neuartigen sequenziellen Modellierungsansatz. Trainer beschriften Bildbibliotheken, um die Modelle zu füttern.
Bei Bildklassifizierungsaufgaben wird beispielsweise jedes Bild mit der Klasse beschriftet, zu der es gehört. Das Modell lernt, indem es seine Parameter anpasst, um den Unterschied zwischen seinen Vorhersagen und den tatsächlichen Labels zu minimieren.
Dieser Prozess erfordert erhebliche Rechenleistung und einen großen, vielfältigen Datensatz, um sicherzustellen, dass das Modell gut auf neue und unbekannte Daten verallgemeinern kann.
Abbildung 3: Trainingsdiagramm großer Vision-Modelle auf OpenAI.4
Sehen Sie sich Dienste zur Erfassung von Bilddaten an, um mehr über Trainingsdaten für die Bildklassifizierung zu erfahren.
Hauptmerkmale großer Vision-Modelle
Modelltyp bezieht sich auf die Architektur und die Designprinzipien eines Vision-Modells. Er definiert, wie das Modell visuelle Daten verarbeitet und interpretiert, ob es mehrere Modalitäten integriert (z. B. Text und Bilder) und welche zugrunde liegenden Mechanismen (z. B. Transformer, kontrastives Lernen, Diffusion) es einsetzt, um aussagekräftige Repräsentationen zu extracten:
- Transformerbasiertes multimodales LLM: Eine Modellarchitektur, die Transformer mit multimodalen Fähigkeiten kombiniert. Sie ermöglicht das gleichzeitige Verstehen visueller und textueller Eingaben. Sie wird mit groß angelegten Datensätzen trainiert, um komplexe Schlussfolgerungen über mehrere Datentypen hinweg durchzuführen.
- Kontrastives Lernen: Eine Technik, die beim Training von Modellen verwendet wird, um zwischen ähnlichen und unähnlichen Datenpunkten zu unterscheiden. Dieser Prozess beinhaltet die Maximierung der Ähnlichkeit verwandter Eingaben bei gleichzeitiger Minimierung der Ähnlichkeit nicht verwandter Eingaben. Dies wird häufig beim selbstüberwachten Lernen eingesetzt, um die Merkmalsrepräsentation zu verbessern.
- KI-Vision-Plattform: Dieses System bietet Infrastruktur, Tools und vortrainierte Modelle für verschiedene Computer-Vision-Aufgaben, wie Bilderkennung, Objekterkennung und Segmentierung. Es umfasst in der Regel Modelltraining, Bereitstellung und Inferenzfunktionen.
- Transformer: Eine Deep-Learning-Architektur, die Selbstaufmerksamkeitsmechanismen nutzt, um Eingabedaten zu verarbeiten. Sie ermöglicht es Modellen, langreichweitige Abhängigkeiten zu erfassen, was sie für natürliche Sprach- und Bildverarbeitungsaufgaben effektiv macht.
- Diffusionsmodell: Ein generatives Modell, das nach und nach Rauschen aus einer anfänglich verrauschten Eingabe entfernt und sie Schritt für Schritt verfeinert, um eine klare und strukturierte Ausgabe zu erzeugen. Es wird häufig für die Bilderzeugung und -verbesserung verwendet.
Trainingsziel: Das Ziel oder die Optimierungsfunktion, die steuert, wie ein Modell aus Daten lernt. Es bestimmt, wie das Modell während des Trainings seine internen Parameter anpasst, um die Leistung bei bestimmten Aufgaben zu verbessern. Dazu gehören das Vorhersagen des nächsten Datenpunkts (autoregressiv), das Unterscheiden ähnlicher/unähnlicher Eingaben (kontrastives Lernen) oder das Klassifizieren von Bildern in Kategorien:
- Autoregressiv: Ein Trainingsansatz, bei dem ein Modell den nächsten Datenpunkt in einer Sequenz auf der Grundlage zuvor beobachteter Eingaben vorhersagt. Dies wird häufig bei der Sprachmodellierung und bei generativen Vision-Modellen verwendet.
- Kontrastives Lernen: Ein selbstüberwachtes Lernziel, bei dem das Modell lernt, indem es zwischen ähnlichen und unähnlichen Datenpaaren unterscheidet. Es hilft, die Fähigkeit zu verbessern, aussagekräftige Repräsentationen ohne explizite Labels zu erfassen.
- Überwachtes Lernen: Ein Lernparadigma, bei dem das Modell mit gekennzeichneten Daten trainiert wird, d. h. jede Eingabe ist mit einer entsprechenden korrekten Ausgabe verknüpft. Dieser Ansatz wird häufig bei Aufgaben wie Klassifizierung und Segmentierung verwendet.
- Bildklassifizierung: Ein spezifisches Trainingsziel, bei dem ein Modell lernt, Bilder anhand visueller Merkmale in vordefinierte Klassen zu kategorisieren. Der Trainingsprozess umfasst die Optimierung einer Verlustfunktion, um die Klassifizierungsgenauigkeit zu maximieren.
- Entrauschende Diffusion: Ein generativer Lernansatz, bei dem ein Modell trainiert wird, saubere Bilder aus verrauschten Eingaben wiederherzustellen. Dieser Prozess beinhaltet die Umkehrung eines fortschreitenden Rauschhinzufügungsprozesses, um die Bildrekonstruktion und -erzeugung zu verbessern.
Fine-Tuning-Unterstützung: Die Fähigkeit eines Modells, durch Training auf kleineren, domänenspezifischen Datensätzen an bestimmte Aufgaben angepasst zu werden, während das Wissen aus der Vortrainingsphase erhalten bleibt.
Fine-Tuning trägt dazu bei, die Leistung bei spezialisierten Anwendungen zu verbessern.
Zero-Shot-/Few-Shot-Lernen: Die Fähigkeit eines Modells, Aufgaben mit wenig oder gar keinen aufgabenspezifischen Trainingsdaten auszuführen.
Zero-Shot-Lernen ermöglicht Inferenz auf unbekannten Kategorien, während Few-Shot-Lernen die Anpassung mit minimalen beschrifteten Beispielen ermöglicht.
Multimodale Unterstützung: Die Fähigkeit eines Modells, Informationen aus mehreren Modalitäten zu verarbeiten und zu integrieren (z. B. Text, Bilder, Audio).
Open Source vs. proprietär: Open-Source-Modelle haben öffentlich verfügbaren Code und Gewichte, sodass die Community sie ändern und bereitstellen kann,
Proprietäre Modelle sind im Besitz und unter der Kontrolle privater Einrichtungen und können den Zugang und die Anpassung einschränken.
Edge-Bereitstellung: Die Fähigkeit eines Modells, auf Edge-Geräten (z. B. Mobiltelefonen, IoT-Geräten) zu laufen, statt auf cloudbasierte Server angewiesen zu sein.
Edge-Bereitstellung trägt dazu bei, die Latenz zu reduzieren, den Datenschutz zu verbessern und Echtzeitverarbeitung in ressourcenbeschränkten Umgebungen zu ermöglichen.
 Als bevorzugte Quelle hinzufügen
Was sind die Anwendungsfälle großer Vision-Modelle?
Gesundheitswesen und medizinische Bildgebung
- Krankheitsdiagnose: Erkennen von Krankheiten aus medizinischen Bildern wie Röntgenaufnahmen, MRTs oder CT-Scans, um Tumore, Frakturen oder Anomalien zu identifizieren.
- Pathologie: Analyse von Gewebeproben in der Pathologie auf Anzeichen von Krebs.
- Ophthalmologie: Diagnose von Krankheiten anhand von Netzhautbildern.
Autonome Fahrzeuge und Robotik
- Navigation und Hinderniserkennung: Unterstützung autonomer Fahrzeuge und Drohnen bei der Navigation und Vermeidung von Hindernissen durch die Interpretation visueller Echtzeitdaten.
- Robotik in der Fertigung: Unterstützung von Robotern bei Sortier-, Montage- und Qualitätsprüfungsaufgaben.
Sicherheit und Überwachung
- Aktivitätsüberwachung: Analyse von Videostreams zur Erkennung ungewöhnlichen oder verdächtigen Verhaltens.
- Gesichtserkennung: Wird in Sicherheitssystemen zur Identitätsprüfung und -verfolgung verwendet. Beispielsweise ist Amazon Rekognition ein cloudbasierter Dienst von Amazon Web Services (AWS), der Bild- und Videoanalysefunktionen wie Gesichtserkennung, Objekt- und Szenenidentifizierung sowie Textextraktion bietet. Er kann Emotionen, Altersgruppen und Aktivitäten analysieren, was für Personalisierung und Sicherheit nützlich wäre.
Sehen Sie sich das Video unten an, um Amazon Rekognition in Aktion zu sehen.5
Einzelhandel und E-Commerce
- Visuelle Suche: Ermöglicht es Kunden, Produkte anhand von Bildern statt Text zu suchen.
- Bestandsverwaltung: Automatisierung der Überwachung und Verwaltung von Beständen durch visuelle Erkennung.
Landwirtschaft
- Überwachung und Analyse von Pflanzenbeständen: Überwachung von Pflanzengesundheit und -wachstum mithilfe von Drohnen- oder Satellitenbildern.
- Schädlingserkennung: Identifizierung von Schädlingen und Krankheiten, die Pflanzen befallen.
Umweltüberwachung
- Wildtierverfolgung: Identifizieren und Verfolgen von Wildtieren zur Unterstützung von Naturschutzbemühungen.
- Analyse von Landnutzung und Bodenbedeckung: Überwachung von Veränderungen der Landnutzung und Vegetationsbedeckung im Laufe der Zeit.
Content-Erstellung und Unterhaltung
- Film- und Videobearbeitung: Automatisierung von Videobearbeitungs- und Postproduktionsprozessen.
- Spieleentwicklung: Verbesserung realistischer Umgebungs- und Charaktererstellung.
- Foto- und Videoverbesserung: Verbesserung der Qualität von Bildern und Videos.
- Inhaltsmoderation: Automatisches Erkennen und Markieren unangemessener oder schädlicher visueller Inhalte.
Was sind die Herausforderungen großer Vision-Modelle?
Rechenressourcen
Das Training und die Bereitstellung dieser Modelle erfordern erhebliche Rechenleistung und Speicher, was sie ressourcenintensiv machen kann.
Datenanforderungen
Sie benötigen riesige und vielfältige Datensätze für das Training. Das Sammeln, Beschriften und Verarbeiten solch großer Datensätze kann schwierig und teuer sein. Crowdsourcing-Unternehmen können jedoch dabei helfen, dies zu bewältigen.
Verzerrung und Fairness
Modelle können Verzerrungen aus ihren Trainingsdaten übernehmen, was zu unfairen oder unethischen Ergebnissen führen kann, insbesondere in sensiblen Anwendungen wie der Gesichtserkennung.
Interpretierbarkeit und Erklärbarkeit
Es kann schwierig sein zu verstehen, wie diese Modelle Entscheidungen treffen, was Anwendungen betrifft, bei denen Transparenz entscheidend ist. Sehen Sie sich erklärbare KI an, um zu erfahren, wie dieser Prozess funktioniert und wie er der KI-Ethik dient.
Generalisierung
Während sie bei Daten, die ihrem Trainingssatz ähneln, gut abschneiden, können sie mit völlig neuen oder anderen Datentypen Schwierigkeiten haben.
Datenschutzbedenken
Der Einsatz großer visueller Modelle, insbesondere bei Überwachung und Gesichtserkennung, wirft erhebliche Datenschutzbedenken auf.
Regulatorische und ethische Herausforderungen
Sicherzustellen, dass diese Modelle mit rechtlichen und ethischen Standards konform sind, wird immer wichtiger, insbesondere da sie stärker in die Gesellschaft integriert werden.
Methodik des Objekterkennungs-Benchmarks
In diesem Benchmark wurden die Leistungen der Objekterkennungsmodelle YOLOv8n, DETR (DEtection TRansformer) und GPT-4o Vision auf dem COCO-2017-Validierungsdatensatz verglichen. Für den Vergleich wurden 1000 Bilder pro Modell verwendet. Alle Bilder wurden auf 800×800 Pixel skaliert, um konsistente Eingabedimensionen über alle Modelle hinweg sicherzustellen.
Das Modell YOLOv8n wurde mit vortrainierten Gewichten (yolov8n.pt) aus dem Ultralytics-Repository geladen, und die Inferenz wurde mit der predict()-Methode über die Ultralytics YOLO API durchgeführt. Das DETR-Modell wurde mit der detr_resnet50-Architektur aus der Facebook-Research-Bibliothek geladen, und seine Ausgaben, die ursprünglich im Format [center_x, center_y, width, height] normalisiert waren, wurden neu skaliert und in das Koordinatenformat [x1, y1, x2, y2] umgewandelt. Auf die Ergebnisse beider Modelle wurde ein Konfidenzschwellenwert von 0.5 angewendet.
Das Modell GPT-4o Vision wurde über OpenAIs API auf Objekterkennungsfähigkeiten evaluiert. Für dieses Modell wurden Bilder aus dem COCO-Validierungsdatensatz heruntergeladen, Annotationen geladen und jedes Bild in das geeignete Format konvertiert (auf 800×800 Pixel skaliert), bevor es an die API gesendet wurde. Es wurden nur Erkennungen angefordert, die zu COCO-Klassen gehören, im JSON-Format, und die von der API zurückgegebenen Vorhersagen wurden mit demselben Konfidenzschwellenwert (0.5) und demselben Koordinatenformat ausgewertet.
Bei der Evaluierung wurden die vorhergesagten Begrenzungsrahmen der Modelle mit den Ground-Truth-Rahmen verglichen, indem die Intersection over Union (IoU) berechnet wurde, wobei IoU ≥ 0.5 als korrekt positive Übereinstimmung gewertet wurde. Für jede Klasse wurde die Average Precision (AP) berechnet, und der Mittelwert aller Klassen wurde als Metrik mAP@0.5 angegeben. Neben der Genauigkeit wurden die Inferenzzeiten gemessen und verglichen. Zusätzlich wurde die Modellkomplexität anhand von FLOPs und der Gesamtzahl der Parameter analysiert.
Um einen fairen Vergleich zu gewährleisten, wurden alle Modellinferenzen auf derselben Hardware durchgeführt (identische GPU/CPU). Dieselben Vorverarbeitungsschritte – das Skalieren aller Bilder auf 800×800 Pixel und das Anwenden der erforderlichen Normalisierung – wurden auf alle Modelle angewendet. Für die Nachbearbeitung wurden die Vorhersagen in dasselbe Koordinatenformat konvertiert, ein Konfidenzschwellenwert von 0.5 wurde konsistent angewendet, und bei der Evaluierung wurden einheitliche IoU-Berechnungskriterien verwendet.
In diesem Rahmen wurden die Modelle YOLOv8n, DETR und GPT-4o Vision hinsichtlich Leistung und Geschwindigkeit bei der Objekterkennung verglichen; zusätzliche Anpassungen und Methoden wurden eingesetzt, um die Fähigkeiten von GPT-4o Vision mit aktuellen Objekterkennungsmodellen zu vergleichen.
Fazit
Große Vision-Modelle (LVMs) verändern die Art und Weise, wie Maschinen visuelle Daten in verschiedenen Bereichen interpretieren und darauf reagieren, darunter Gesundheitswesen, autonome Systeme, Sicherheit und die Kreativwirtschaft.
Durch die Nutzung fortschrittlicher Architekturen wie Transformer und Diffusionsmodelle unterstützen LVMs eine breite Palette komplexer Aufgaben, darunter medizinische Bildgebung, Objekterkennung in Echtzeit, Text-zu-Bild-Generierung und Videogenerierung.
Ihre Fähigkeit, aus riesigen, multimodalen Datensätzen zu lernen, ermöglicht flexible Bereitstellungsszenarien, die von cloudbasierter Inferenz bis hin zu Edge-Computing reichen und maßgeschneiderte Anwendungen ermöglichen, die von der industriellen Inspektion bis zur personalisierten Content-Erstellung reichen.
Diese Fähigkeiten gehen jedoch mit erheblichen Herausforderungen einher. Der Rechenaufwand für das Training und die Bereitstellung von LVMs bleibt hoch und erfordert oft leistungsfähige Hardware und spezialisierte Infrastruktur.
Probleme wie Datenverzerrung, eingeschränkte Interpretierbarkeit und ethische Bedenken im Zusammenhang mit Überwachung und Privatsphäre unterstreichen die Notwendigkeit einer sorgfältigen Modell-Governance. Da sich LVMs weiterentwickeln, wird es entscheidend sein, ein Gleichgewicht zwischen Innovation und Verantwortung zu finden, um sicherzustellen, dass sie effektiv und gerecht in verschiedenen Sektoren eingesetzt werden.
Zitieren Sie diesen Benchmark
Wählen Sie das Format, das zu Ihrem Veröffentlichungsort passt. Wenn Sie die Link-Version in Ihr CMS einfügen, bleibt der Backlink erhalten.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Ermut, Sıla},
  title  = {{Vergleich großer Vision-Modelle: GPT-4o vs YOLOv8n}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/large-vision-models}},
  note   = {AIMultiple. Abgerufen am 10. Juni 2026}
}Ergebnisse und Zeitstempel von 3 Datenpunkten. Laden Sie die Zusammenfassungsdaten aus den Diagrammen und Tabellen dieses Artikels als ZIP-Datei herunter, die eine CSV-Datei enthält.
Möchten Sie die granularen Daten dahinter? Premium beitreten
Änderungsprotokoll
11 AktualisierungenDie Midjourney-Funktionen wurden durch eine aktualisierte Beschreibung von Version 7 ersetzt.
Referenzlinks
Cems Arbeit bei AIMultiple wurde von führenden globalen Publikationen wie Business Insider, Forbes, Morning Brew und Washington Post, von globalen Unternehmen wie Deloitte und HPE, von NGOs wie dem World Economic Forum und von supranationalen Organisationen wie der European Commission zitiert. [1], [2], [3], [4], [5]
Im Laufe seiner Karriere war Cem als Tech-Berater, Tech-Einkäufer und Tech-Unternehmer tätig. Er beriet Unternehmen bei ihren Technologieentscheidungen bei McKinsey & Company und Altman Solon über mehr als ein Jahrzehnt. Er veröffentlichte außerdem einen McKinsey-Bericht zur Digitalisierung.
Er leitete Technologiestrategie und -beschaffung eines Telekommunikationsunternehmens und berichtete dabei direkt an den CEO. Außerdem verantwortete er das kommerzielle Wachstum des Deep-Tech-Unternehmens Hypatos, das innerhalb von zwei Jahren von 0 einen siebenstelligen jährlich wiederkehrenden Umsatz und eine neunstellige Bewertung erreichte. Cems Arbeit bei Hypatos wurde von führenden Technologiepublikationen wie TechCrunch und Business Insider aufgegriffen.
Cem spricht regelmäßig auf internationalen Technologiekonferenzen. Er absolvierte die Bogazici University als Computeringenieur und hat einen MBA von der Columbia Business School.

Zuvor arbeitete sie als Personalvermittlerin in Projektmanagement- und Beratungsunternehmen. Sıla hat einen Master of Science in Sozialpsychologie und einen Bachelor of Arts in Internationalen Beziehungen.


Seien Sie der Erste, der kommentiert
Ihre E-Mail-Adresse wird nicht veröffentlicht. Alle Felder sind erforderlich. Kommentare werden in ihrer Originalsprache belassen.