


Beste KI-Web-Scraping-Tools im Benchmark
Wir haben führende KI-Web-Scraping-Tools mit 25.000 Anfragen, 5.000 pro Tool, über 500 URLs auf jeder der 10 meistbesuchten Domains getestet, um ihre Leistung zu sehen, und außerdem verglichen, wie jedes einzelne KI nutzt.
KI-Web-Scraping-Benchmark
Siehe den Abschnitt Benchmark-Methodik für weitere Details zum Testverfahren.
Vollständigkeit & Genauigkeit im Vergleich
Für jede Domain haben wir die Felder abgefragt, die auf dem jeweiligen Seitentyp wichtig sind: Preis und Währung auf E-Commerce-Seiten, Beitragstext, Likes und Autor auf sozialen Seiten. Um die Leistung dieser Tools zu messen, haben wir drei Kennzahlen verwendet: Erfolg, Vollständigkeit und Genauigkeit. Drei sind nötig, weil ein Tool etwas zurückgeben kann, ohne alles zurückzugeben, und alles, ohne dass irgendetwas davon korrekt ist.
Erfolg: der Anteil der Anfragen, die mit mindestens einem der angeforderten Felder zurückkamen.
Vollständigkeit: der Anteil der angeforderten Felder, die tatsächlich zurückkamen, gemittelt über alle Anfragen.
Genauigkeit: der Anteil überprüfbarer Felder, die mit einem korrekten Wert zurückkamen, geprüft anhand einer Referenz oder anhand dessen, worauf sich die anderen Tools geeinigt haben. Ein Feld, das nie zurückkam, zählt als falsch.
Statistische Methodik
Die Konfidenzintervalle wurden mit Bootstrap-Perzentil-Resampling berechnet:
Resamples: 10.000
Konfidenzniveau: 95 %
Resampling-Einheit: URL, wobei alle fünf Anbieter bei derselben Ziehung erneut gesampled wurden
Kennzahlen: Erfolgsquote, Vollständigkeit, Genauigkeit und Abschlusszeit
Stichprobengröße: N = 5.000 URLs pro Anbieter (500 auf jeder der 10 Domains)
Die Domain-Ergebnisse werden zuerst berechnet und dann über die zehn Domains gemittelt
Ergebnisse des KI-Web-Scraping-Benchmarks
Über 5.000 URLs auf den 10 Domains haben wir jedes Tool so aufgerufen, wie seine eigene API aufgebaut ist. Bright Data, Apify und Firecrawl akzeptieren eine Liste von URLs in einer Anfrage, daher haben wir 100 URLs pro Anfrage gesendet. Oxylabs und ScrapingBee akzeptieren eine URL pro Anfrage, daher haben wir sie einzeln gesendet. Die Parallelität war bei jedem Tool gleich, fünf parallele Anfragen, daher besteht der einzige Unterschied darin, was die jeweilige API unterstützt.
- Bright Data erzielte bei allen drei Qualitätskennzahlen die höchsten Werte: 85 % Erfolg, 76 % Vollständigkeit, 60 % Genauigkeit.
- Die höchste Genauigkeit im Testfeld lag bei 60 %. Zwei von fünf überprüfbaren Feldern kamen fehlend oder falsch zurück.
- Die Vollständigkeit reichte von Bright Data mit 76 % bis hinunter zu Apify mit 32 %, mit Oxylabs bei 59 %, Firecrawl bei 53 % und Scraping Bee bei 41 %.
- Firecrawl war am schnellsten mit unter einer halben Sekunde pro URL, verglichen mit den 4,6 Sekunden von Bright Data, und lag bei der Genauigkeit 22 Punkte niedriger. Oxylabs war am langsamsten mit 35 Sekunden.
Jeder Anbieter verfolgt einen anderen Ansatz für KI, und unser Ziel war es, diese Ansätze und die damit verbundenen Kompromisse zu vergleichen.
Wichtigste Erkenntnisse zu KI-Web-Scraping-Tools aus dem Benchmark
- Fehler können wie Daten aussehen. Wenn ein Tool einen Preis nicht lesen kann, oft weil die Seite gegen Bots gesperrt ist, kann es 0 statt eines Fehlers zurückgeben. Ein null-Wert kann erneut versucht oder übersprungen werden, aber eine 0 besteht die Validierung unbemerkt. Apify und Oxylabs gaben in diesen Fällen null zurück. Die Dokumentation von Firecrawl empfiehlt, jedem Schemafeld die Anweisung „Return null if not found on the page“ hinzuzufügen, damit das Model keinen Wert errät.
- Zusätzliche Felder: Ein Prompt, der nach Preis und Währung fragt, kann auch Marke, Beschreibung oder Bild-URLs zurückgeben. Ein Schema begrenzt die Antwort auf die von Ihnen benannten Felder. Bright Data sperrt das Ausgabeschema zur Build-Zeit, sodass jeder Aufruf dieselben Felder zurückgibt.
- Falsches Element: Auf Seiten, die einen reduzierten und einen ursprünglichen Preis, Preise mit und ohne Steuern oder regionale Preisoptionen anzeigen, kann ein Tool die falsche Zahl extracten.
- Veränderte Zahlen: Prompt-zu-JSON-Tools können Dezimalstellen hinzufügen, Werte abschneiden oder währungsumgerechnete Näherungen zurückgeben, die nicht auf der Seite erscheinen.
- Standort verändert den Preis: Einige Websites legen die Preise anhand des IP-Standorts des Besuchers fest, sodass ein Tool über US-Proxys einen anderen Preis sieht als ein europäischer Nutzer.
Schema und Proxy-Region sind die Parameter, mit denen Sie das meiste davon abfangen können, bevor es Ihre Daten erreicht.
Preise für KI-Web-Scraping-Tools
Kadoa ist nicht in der Preistabelle enthalten, da es keine Preise veröffentlicht. Kadoa bietet eine verbrauchsbasierte Flex-Stufe und eine Enterprise-Stufe an, deren Preise über den Vertrieb angefragt werden.
Vergleich der KI-Web-Scraping-Tools
Zeit bis zum ersten Scraper: Für Tools, die einen Scraper erstellen, den Sie dann per ID aufrufen, wie lange die Einrichtung dauert. „Single HTTP-Aufruf“ bedeutet, dass es überhaupt keinen Build-Schritt gibt.
Benutzerdefiniertes Ausgabeschema: Ob Sie die Ausgabefelder und ihre Typen selbst festlegen können, bevor der Scrape ausgeführt wird, statt sie in einem Prompt zu beschreiben und das LLM die Struktur zur Laufzeit entscheiden zu lassen.
Build-once, call-many-Endpoint: Ob der Scraper einmal erstellt, auf Anbieterseite gespeichert und danach nur noch mit einer URL aufgerufen wird. Dabei läuft das LLM (oder bei aufzeichnungsbasierten Tools Ihr Durchklicken) zur Build-Zeit, und seine Ausgabe wird in einem Scraper eingefroren, den Sie besitzen und an Ort und Stelle ändern können, und an den Zeitpläne, Webhooks und Integrationen gebunden sind. Wenn dies fehlt, wird die Extraktion bei jedem Aufruf neu ermittelt, und die vollständige Definition reist mit jeder Anfrage mit.
Selbstheilender gespeicherter Scraper: Ob ein gespeicherter Scraper repariert wird, wenn sich die Zielseite ändert, ohne ihn von Grund auf neu zu erstellen. Die Korrektur wird auf denselben gespeicherten Scraper unter seiner bestehenden Kennung angewendet, sodass Trigger, Zeitpläne und Integrationen weiter funktionieren.
* Kadoa speichert den Scraper und ruft ihn per ID auf, aber die Ziel-URLs werden beim Erstellen des Workflows gebunden. Um ihn auf eine neue URL zu richten, ist vor dem Lauf ein separates Metadaten-Update erforderlich.
Tools, die bei jedem Aufruf ein LLM über die Seite laufen lassen, werden hier nicht berücksichtigt: Es gibt keine persistierte Extraktionslogik, die repariert werden könnte, was sie tolerant gegenüber Layoutänderungen macht, aber auch bedeutet, dass es kein Artefakt zum Prüfen, Versionieren oder Genehmigen gibt. Auch interne Caches ohne Kennung, auf die Sie zeigen können, zählen nicht dazu, da es wiederum nichts zu prüfen, versionieren oder genehmigen gibt.
Abgesehen von Dingen wie ständig wechselnden Seiten benötigen Sie in agentischen Pipelines oft eine einfache API, die Sie aufrufen können: URL angeben, strukturierte Daten zurückbekommen. Aber Sie finden nicht immer eine fertige Scraper-API für jede Domain, die Sie regelmäßig scrapen müssen; und selbst wenn, fehlen möglicherweise die gewünschten Felder, oder Sie müssen das Schema an Ihre eigenen Bedürfnisse anpassen. Es gibt verschiedene Ansätze, die diese Probleme adressieren.
Build-once, call-many-KI-Web-Scraping-Plattformen
Wenn Sie Ihren eigenen Scraper erstellen, müssen Sie den Crawler schreiben, Proxys anbinden, headless Browser ausführen und sich selbst um Warteschlangen, Wiederholungen und Anti-Bot-Maßnahmen kümmern.
KI-Web-Scraping-Tools reduzieren diesen Aufwand. Build-once, call-many-Plattformen wie Bright Data Scraper Studio, Browse KI und Kadoa erstellen einen Scraper einmalig, aus einem Prompt oder einer Klickaufzeichnung, und speichern ihn, damit Sie ihn mit einer URL aufrufen können.
Bright Data Scraper Studio erstellt einen Scraper aus einem Prompt und stellt ihn dann als stabile API bereit. Nach der einmaligen Einrichtung benötigt jeder Aufruf nur noch eine URL.
Sie beschreiben die Felder, die Sie extracten möchten, in einfacher Sprache, und können optional CSS-Selektoren, erforderliche Aktionen auf der Seite oder das Ladeverhalten der Seite hinzufügen.
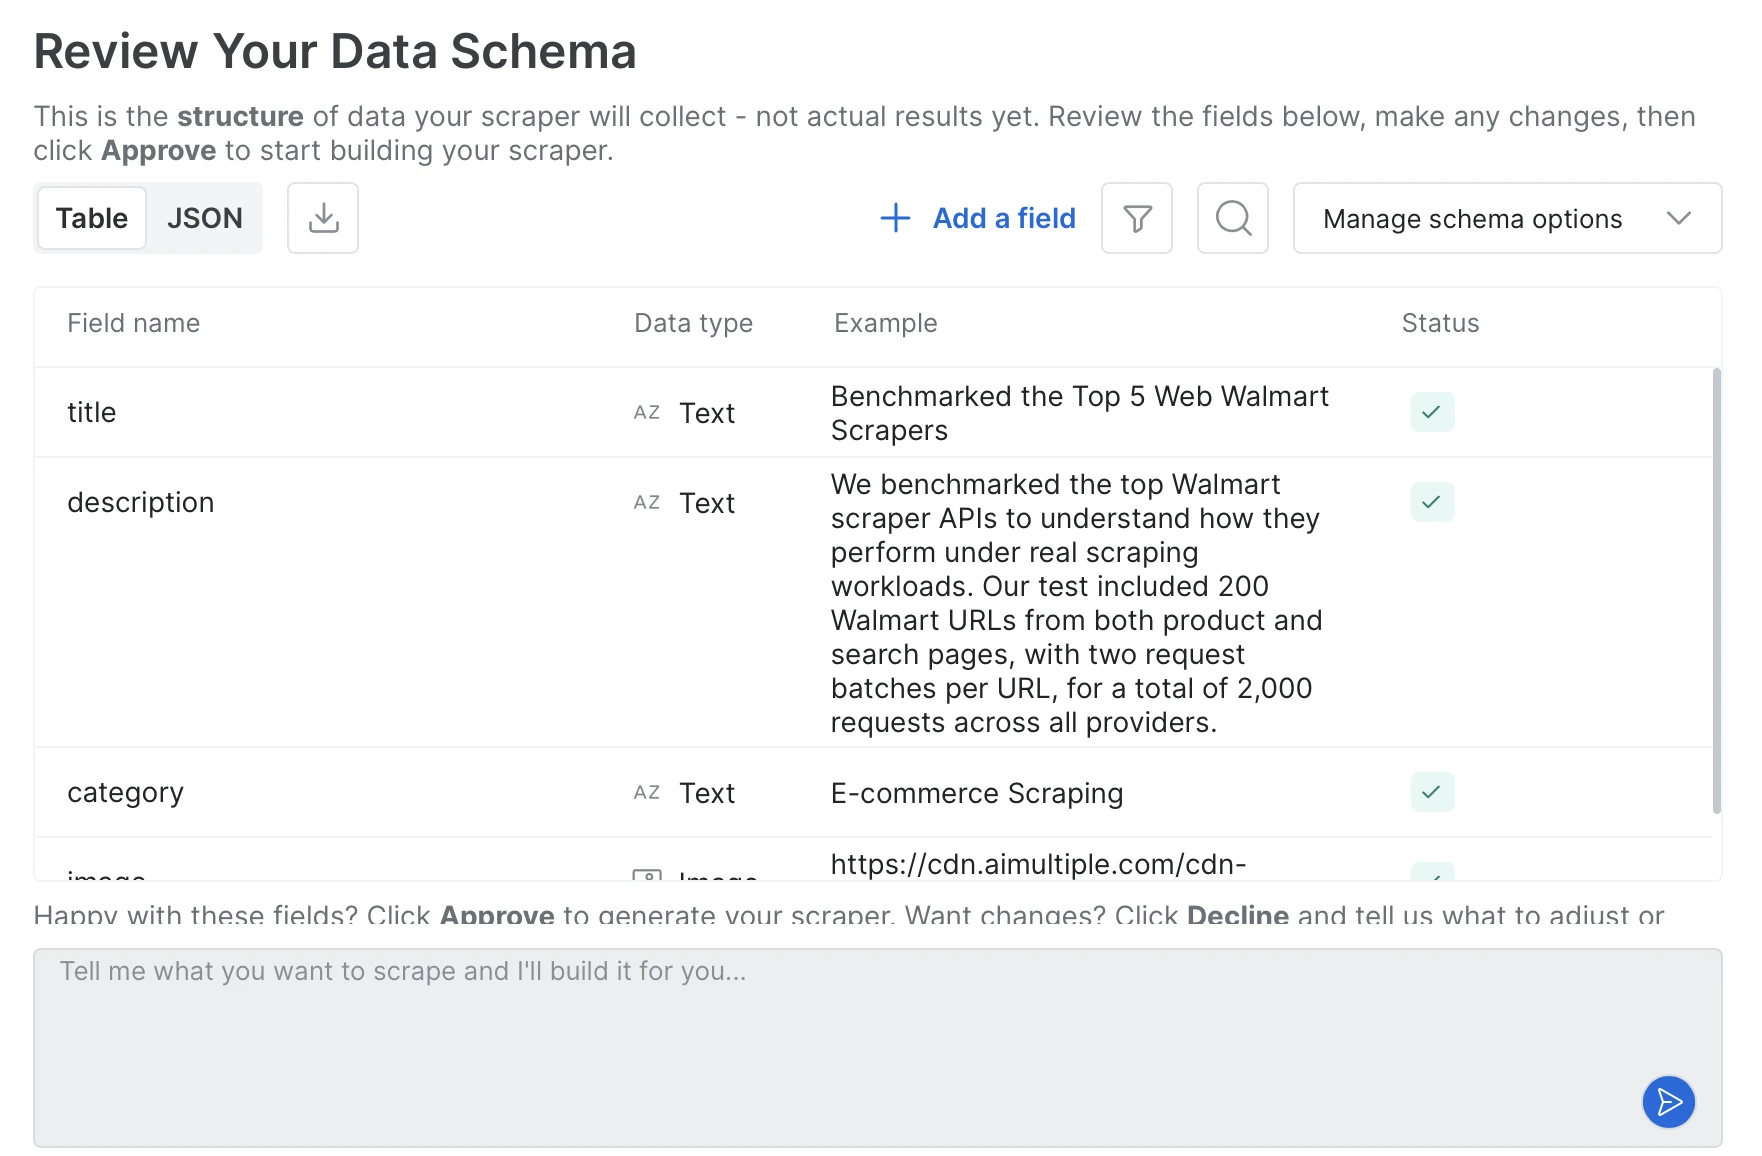
Der Scraper Studio Agent generiert das Ausgabeschema aus dem Prompt. Sie überprüfen das Schema, fügen Felder hinzu oder entfernen sie oder ändern Typen, und der Agent schreibt anschließend den Scraper-Code.
- Build-once, call-many-Endpoint: Sobald Sie das Schema genehmigen, wird der Scraper als langlebiger Endpoint mit einer festen Kennung registriert. Jeder Aufruf trifft denselben Endpoint nur mit einer URL, und das Ausgabeschema bleibt über alle Aufrufe hinweg gleich. In unseren Tests dauerte die Erstellung eines dedizierten Scrapers durchschnittlich etwa 10 Minuten.
- Zwei Build-Methoden: Sie können im Browser mit dem Agenten chatten oder die CLI von Bright Data verwenden, um den Scraper von Ihrem Terminal aus mit einem einzigen Befehl zu erstellen, der eine URL und einen Prompt entgegennimmt. Beide erzeugen denselben Scraper.
- Coding-Agent-Workflow: Die Terminalbefehle laufen unverändert in Claude Code, Cursor und Codex, sodass der Agent einen Scraper erstellen, ausführen oder selbst heilen kann, ohne den Editor zu verlassen. Sie können die Kennung des Scrapers auch in der Regeldatei des Agenten verankern, damit künftige Sitzungen sie wiederverwenden.
- Lieferung: API, SDK, CLI, Webhooks oder direkte Lieferung in Cloud-Speicher auf S3, GCS, Azure oder OSS.
- Kombination mit vorgefertigten Scrapers: Bright Data pflegt eine Bibliothek fertiger Scraper für beliebte Websites wie Amazon, LinkedIn und Zillow.
Automatische Selbstheilung
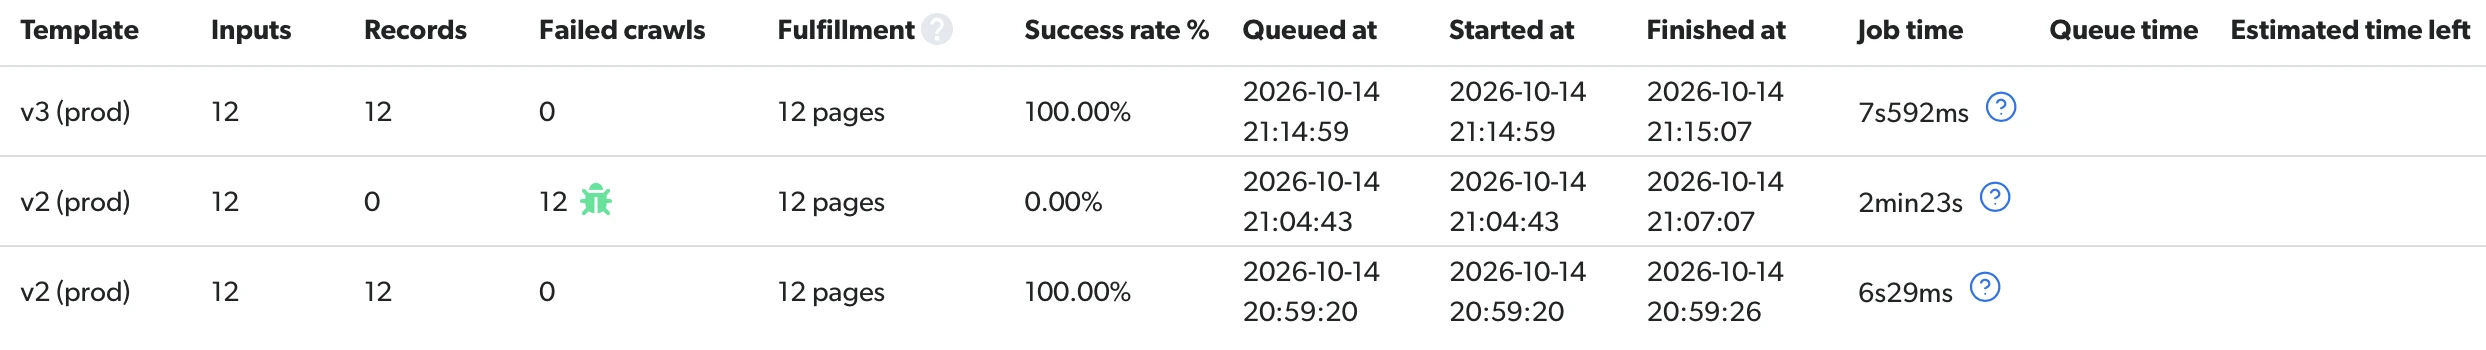
Das Scraper Studio von Bright Data kann einen gespeicherten Scraper selbstständig reparieren. Wir haben es auf von uns gehosteten Produktseiten getestet und nach Titel, Preis, Währung, Verkäufer und Verfügbarkeit gefragt. Der erste Lauf lieferte Datensätze mit 100 % Erfolg.
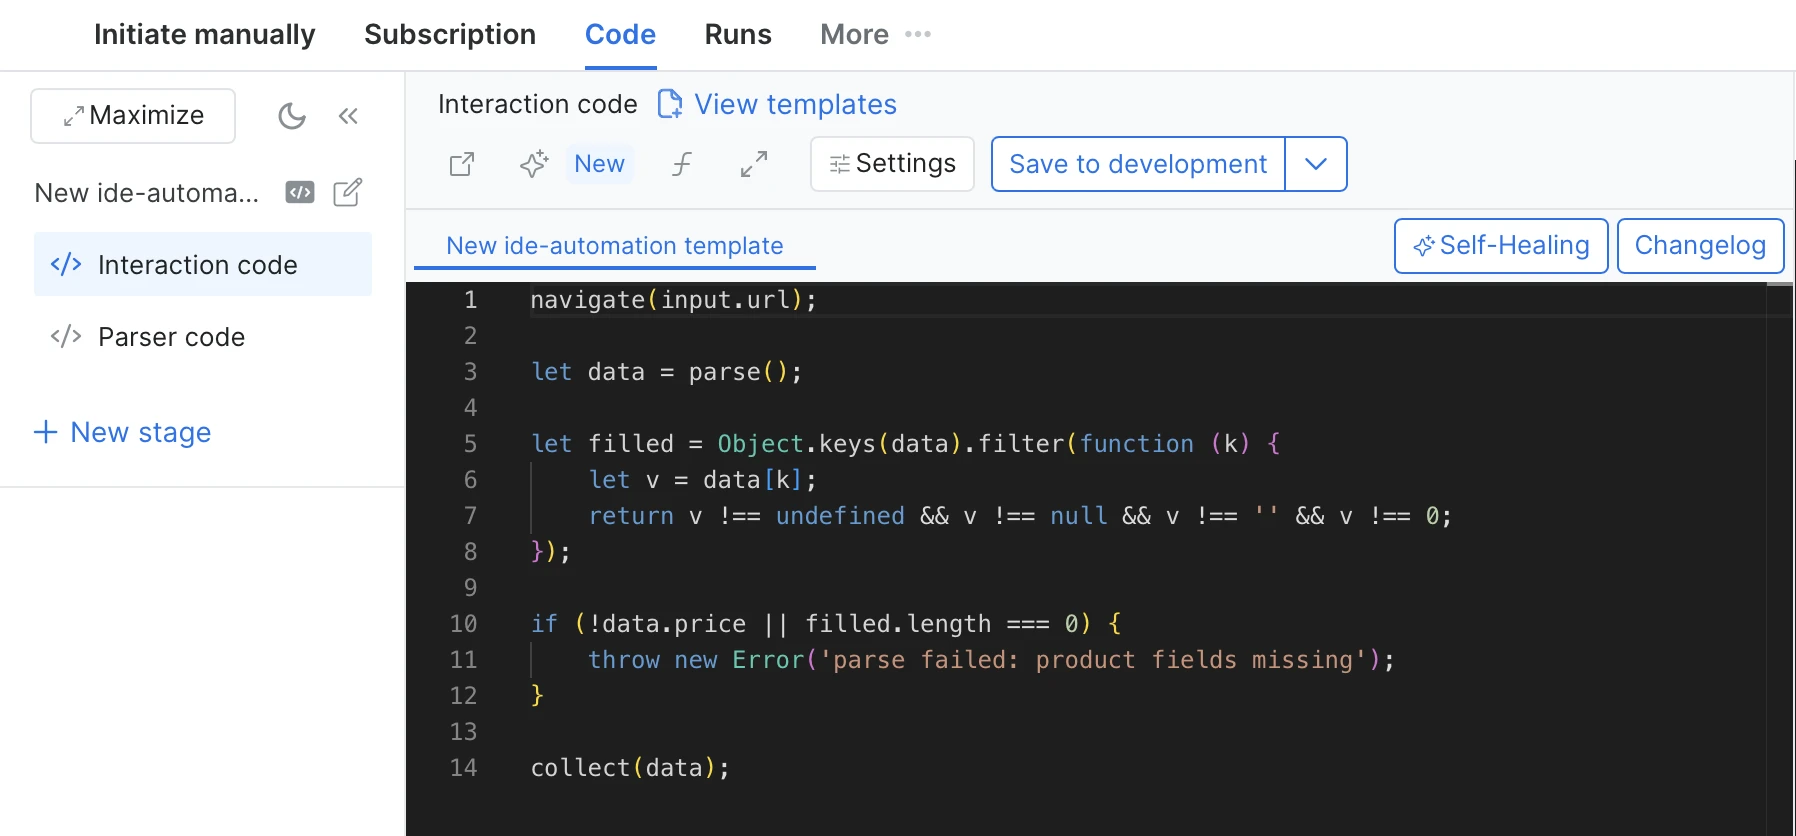
Wir haben dem generierten Code eine Prüfung hinzugefügt. Wenn der Preis fehlt oder überhaupt kein Feld zurückkommt, wirft der Lauf einen Fehler, statt einen leeren Datensatz zu erfassen.
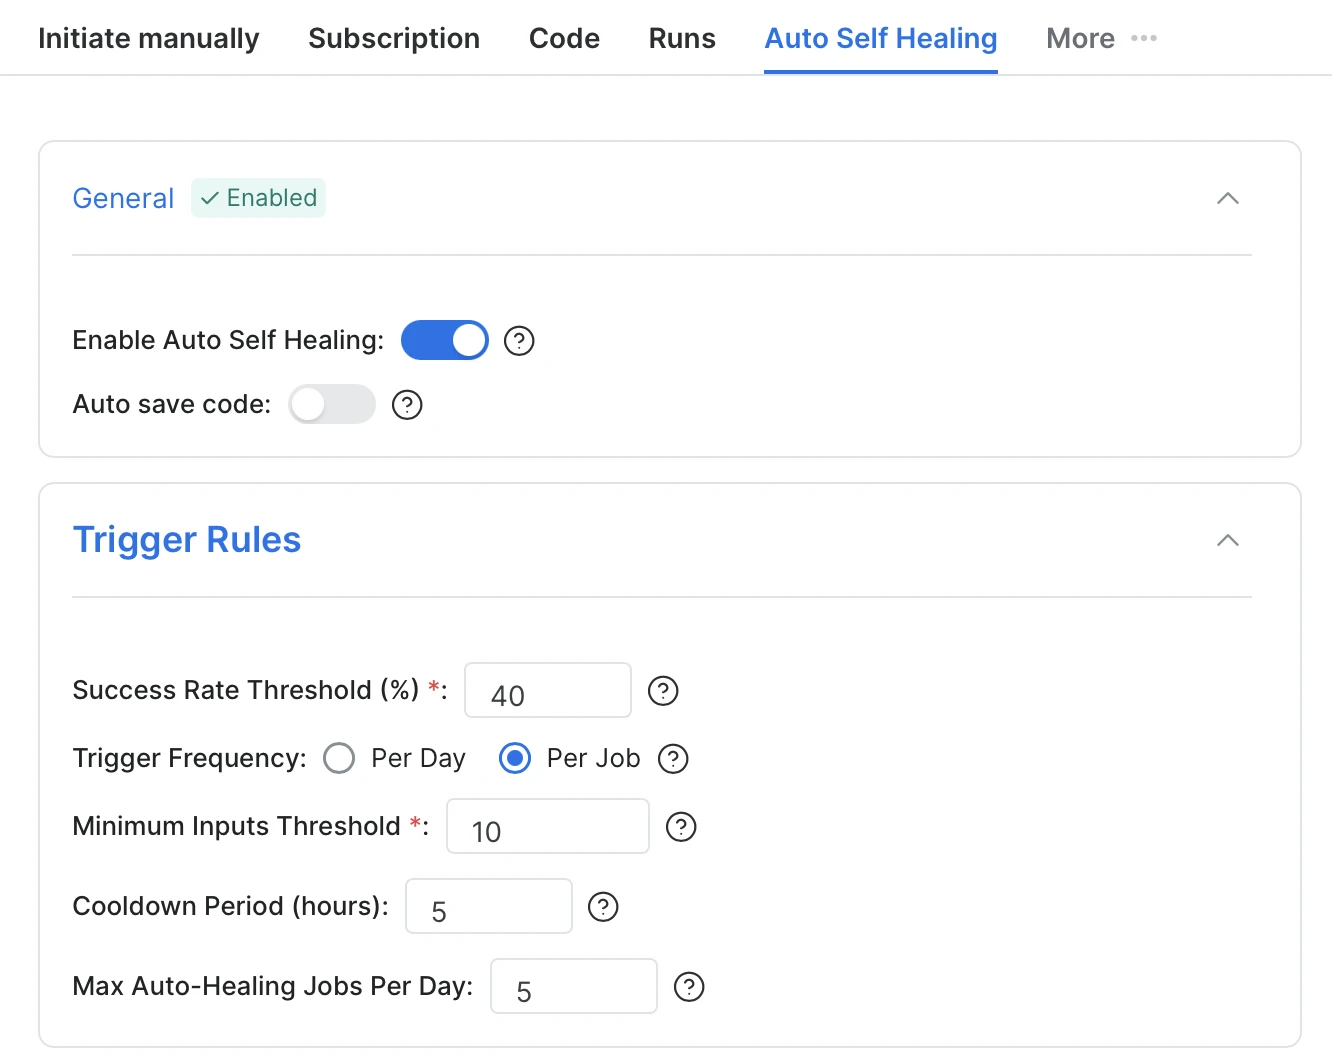
Wir haben Automatisch Self-Healing mit den Standard-Triggerregeln aktiviert: Die Heilung startet, wenn die Erfolgsquote unter 40 % fällt, geprüft nach jedem Job, bei Läufen mit mindestens 10 Eingaben. Wir ließen das automatische Speichern von Code ausgeschaltet, sodass jede Neuschreibung auf Genehmigung warten würde.
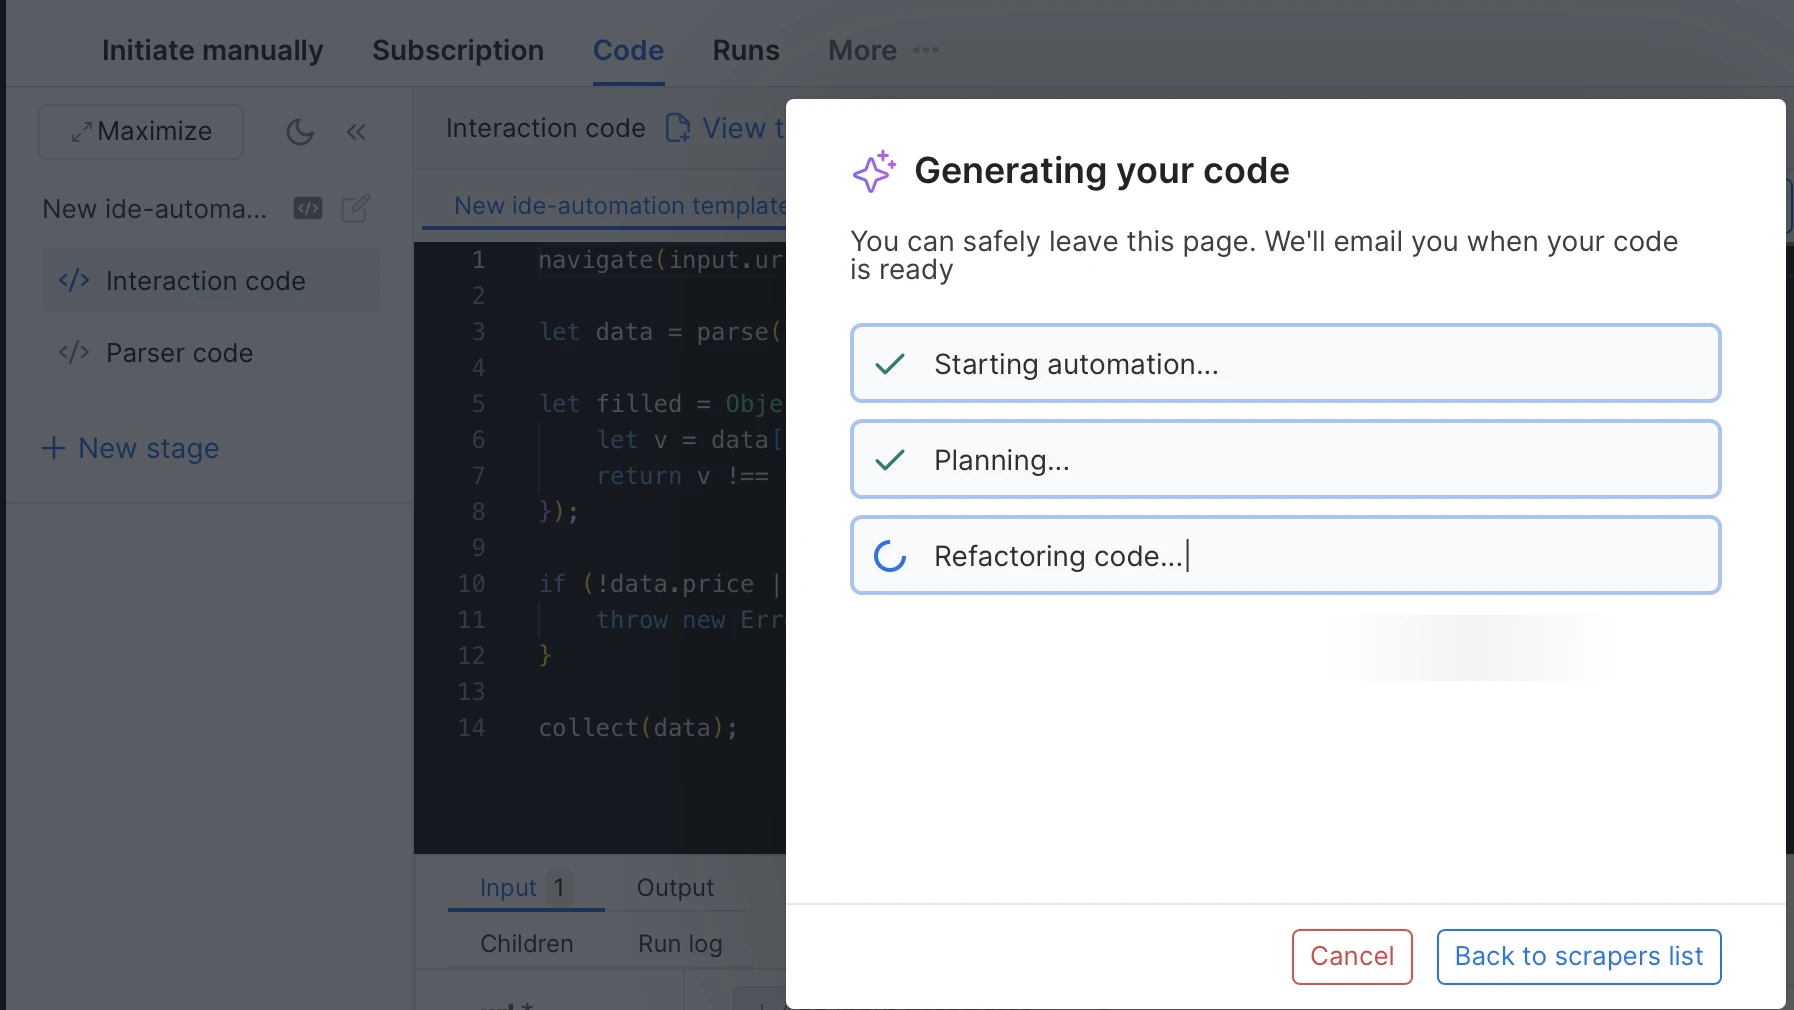
Anschließend haben wir die Seiten hinter denselben URLs neu gestaltet, Tags und Klassennamen geändert, aber jeden Wert im HTML als Klartext belassen. Der nächste Lauf meldete 12 fehlgeschlagene Crawls und 0 % Erfolg, und die Heilung startete ohne unser Zutun.
Die reparierte Version gab auf denselben URLs alle Datensätze mit 100 % zurück.
Dieselben URLs erzielten 100 % auf dem ursprünglichen Layout, 0 % nach der Neugestaltung und erneut 100 %, nachdem Automatisch Self-Healing den Collector neu geschrieben hatte.
Dies ist für Scraper wichtig, die Sie in einer Pipeline behalten: Wenn sich das Layout der Website ändert, repariert sich der von Ihnen erstellte Scraper selbst und nimmt die Arbeit wieder auf, sofern der Fehler die Erfolgsquote unter den von Ihnen festgelegten Schwellenwert fallen lässt.
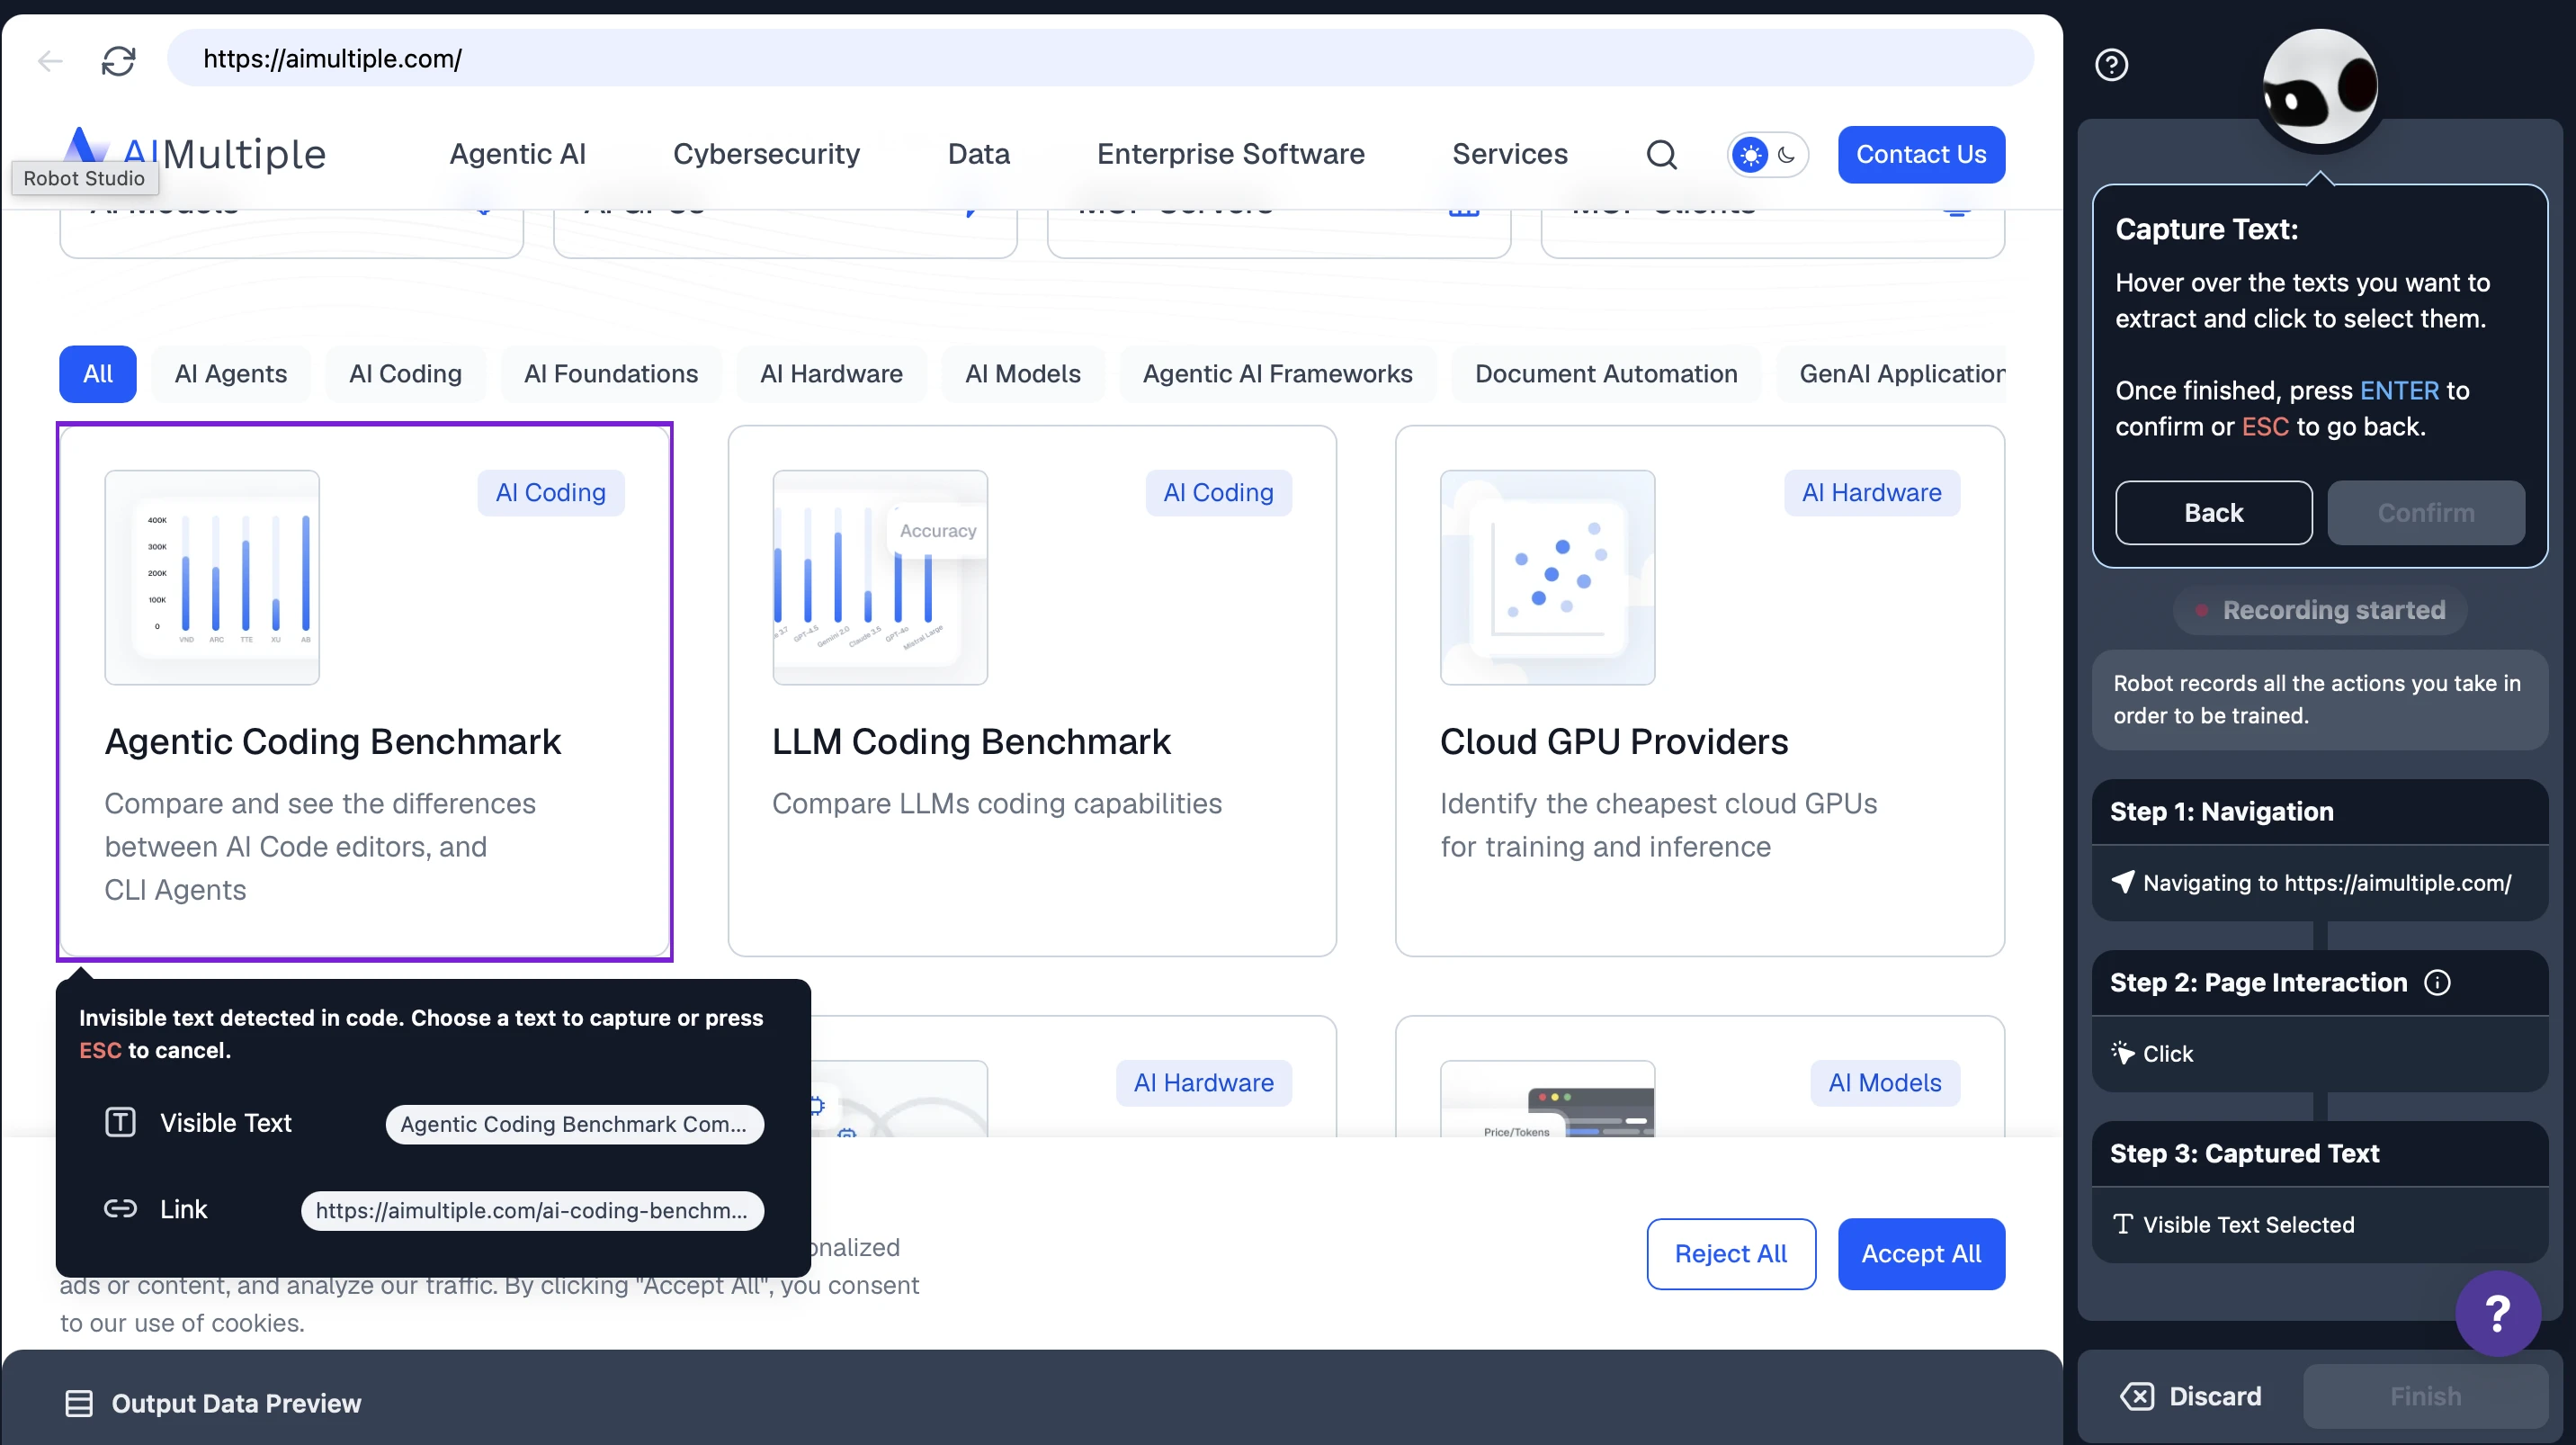
Browse KI erstellt Scraper, sogenannte Roboter, aus einer visuellen Aufzeichnung. Sie öffnen die Zielseite und klicken auf die zu erfassenden Felder. Der Roboter speichert die Navigationsschritte und die ausgewählten Felder als Aufzeichnung und spielt sie bei jedem Lauf erneut ab.
- Visuelle Einrichtung mit Robot Studio: Scraper werden mit einem Ablauf aus Klicken → Feld erfassen → Speichern erstellt.
- Integriertes Monitoring und Alerting: Stündliche, tägliche oder wöchentliche Zeitpläne, Änderungserkennung sowie E-Mail- oder Webhook-Alerts im selben Produkt.
- Das Schema entsteht aus den erfassten Feldern: Für jedes Feld wird ein separater Erfassungsschritt hinzugefügt; kein Prompt-zu-Schema.
- Automatische Anpassung: Die Engine von Browse KI passt den Scraping-Code an, wenn sich eine Website ändert, und die meisten Roboter laufen ohne Eingriff weiter. Wenn die Anpassung nicht ausreicht, trainieren Sie den Roboter neu, wobei seine Historie, Läufe und Workflows erhalten bleiben.
Kadoa erstellt einen Scraper, genannt Workflow, aus einem Prompt und speichert ihn als generierten Code, sodass es ein konkretes Artefakt zum Überwachen und Reparieren gibt.
- Build-once, call-many-Endpoint: Ein gespeicherter Workflow erhält eine persistente ID und wird mit
PUT /v4/workflows/{id}/runaufgerufen. Die Anfrage enthält nur Variablen und ein Zeilenlimit; das Schema und der Extraktionscode bleiben auf Kadoas Seite. Um denselben Workflow auf eine andere URL zu richten, muss zuerst seine Metadaten aktualisiert werden, daher ist es kein einzelner Aufruf mit einer URL darin. - Prompt zu typisiertem Schema: Sie beschreiben die Daten im Einrichtungs-Prompt und Kadoa schlägt ein Schema vor, das Sie in einer visuellen oder JSON-Ansicht bearbeiten. Felder tragen Typen wie STRING, NUMBER, MONEY, DATE und LINK und können als Schlüssel markiert werden.
- Selbstheilender gespeicherter Scraper: Die Reparatur wird durch einen fehlgeschlagenen Lauf ausgelöst und nicht durch einen Zeitplan. Kadoa regeneriert den Extraktionscode und validiert ihn anhand zuvor extrahierter Daten unter derselben Workflow-ID, sodass Zeitpläne und Integrationen weiter funktionieren. Es gibt keinen Genehmigungsschritt, bevor die Korrektur live geht. Wenn die automatische Wiederherstellung fehlschlägt, geht ein Ticket an das Kadoa-Ops-Team.
- Coding-Agent-Workflow: Ein gehosteter MCP-Server mit 40+ Tools sowie First-Party-Node- und Python-SDKs und einer CLI (
kadoa create,kadoa run,kadoa export). - Lieferung: API, SDK, CLI, MCP und Google Sheets für Pull; S3, GCS, Azure Blob, Webhooks, WebSockets, E-Mail und Slack für Push; Snowflake und Databricks für die gemeinsame Nutzung. Cloud-Speicher-Connectoren werden über den Support statt im Self-Service eingerichtet.
One-Shot-KI-Extraktions-APIs
One-Shot-KI-Extraktions-APIs speichern keinen Scraper. Jeder Aufruf sendet eine URL mit einem Prompt oder einem Schema, und das Tool ruft die Seite ab und führt die LLM-Extraktion zur Anfragezeit aus. Oxylabs KI Studio, Apifys KI Web Scraper Actor, Firecrawl und ScrapingBee funktionieren auf diese Weise.
Oxylabs KI Studio ist eine Suite aus fünf separaten KI-Anwendungen unter einem einzigen SDK (pip install oxylabs-ai-studio): AiScraper, AiCrawler, BrowserAgent, AiSearch und AiMap. Serverseitig wird nichts persistiert; jeder Scrape-Aufruf führt einen frischen Abruf plus LLM-Extraktion aus.
- AiScraper-Ablauf: generate_schema(prompt=…) ruft optional das LLM auf, um ein JSON-Schema zu erzeugen; dann ruft scrape(url, schema) die Seite ab und führt die LLM-Extraktion aus. Sie können das Schema auf Ihrer Seite behalten und wiederverwenden, aber der Server registriert keinen langlebigen Scraper.
- Fünf Anwendungen, ein SDK: AiScraper für strukturierte Extraktion einzelner URLs, AiCrawler für promptgesteuerte Website-Durchquerung, BrowserAgent für Aktionen auf der Seite, AiSearch für natürliche Sprachsuche plus Extraktion und AiMap für gefilterte URL-Karten einer Website.
- Ausgabeformate: Markdown (Standard), JSON, CSV, Toon (ein token-optimiertes Format), Screenshot und HTML (nur Browser-Agent).
- Handschriftliche Schemas:
generate_schemaist optional. Der Parameterschemaakzeptiert jedes von Ihnen geschriebene JSON Schema, und die eigenen Beispiele von Oxylabs übergeben ein handgeschriebenes Pydantic-Model. Ein Schema ist für die Ausgabe von JSON, CSV und TOON obligatorisch. - Bemerkenswerte Parameter: render_javascript=”automatisch” lässt den Dienst entscheiden, ob JS-Rendering erforderlich ist, geo_location nimmt einen ISO-Ländercode oder -Namen für den Proxy-Standort entgegen, und max_credits legt eine Ausgabenobergrenze pro Anfrage fest.
Apify bietet ein offenes Entwickler-Ökosystem, in dem „Actors“, ausführbare Scraping- und Automatisierungsprogramme, auf seiner Plattform erstellt und ausgeführt werden. Sie können Ihren eigenen Actor von Grund auf neu schreiben, mit einer fertigen Vorlage beginnen oder Actors verwenden, die andere im Apify Store veröffentlicht haben.
- KI-Extraktions-Actor: Apify bietet außerdem einen fertigen Actor apify/ai-web-scraper, der einen natürlichsprachigen Prompt entgegennimmt und strukturiertes JSON von jeder URL zurückgibt. Sie geben den Prompt bei jedem Lauf erneut ein, und die JSON-Ausgabe bleibt zwischen Aufrufen nicht garantiert konsistent, was bei promptgesteuerten Tools üblich ist.
- Nur Prompt: Die Eingabe des Actors hat fünf Felder:
startUrls,extractionMode,prompt,maxPagesToVisitundmaxCrawlDepth. Es gibt keinen Parameter für ein benutzerdefiniertes Ausgabeschema. - Eigenen Actor erstellen: Wenn für Ihre Zielseite kein fertiger Scraper existiert oder keiner die gewünschten Datenfelder scrapt, schreiben Sie Ihren eigenen Actor und entscheiden, welche Felder Sie extracten, wo sie auf der Seite liegen und wie Sie den Rest behandeln. Wie lange das dauert, hängt von Ihren Programmierkenntnissen und der Komplexität der Website ab. Wenn Sie es nicht selbst erstellen möchten, können Sie auch Hilfe von den Professional Services von Apify erhalten.
- Kombination mit vorgefertigten Scrapers: Im Apify Store werden Actors aufgelistet, die Entwickler veröffentlichen. Die meisten Scraper für beliebte Websites werden von Drittentwicklern veröffentlicht und gepflegt.
- Plattformdienste: Actors werden ab Werk mit Zeitplanung, Monitoring, Dataset-Speicher, Proxy-Pool und API-Zugriff geliefert.
- Agentenzugriff: Der MCP-Server von Apify ermöglicht es einem Coding-Agenten, Actors zu suchen und auszuführen, bietet jedoch keinen integrierten Ablauf zum Erstellen oder Pflegen eines Actors aus dem Agenten heraus.
- Verantwortung für die Wartung: Wenn Sie den Actor selbst erstellt haben, beheben Sie ihn, wenn sich die Website ändert. Wenn Sie einen aus dem Store verwenden, warten Sie darauf, dass der Eigentümer des Actors die Korrektur nach seinem Zeitplan veröffentlicht.
Firecrawl wandelt eine URL plus einen Prompt oder ein JSON-Schema in einem einzigen synchronen Aufruf in JSON um. Jede Anfrage führt die Extraktions-Pipeline in dem Moment aus, in dem der Aufruf erfolgt.
- Prompt oder Schema: Ein Schema legt die Feldnamen und -typen vor dem Aufruf fest, sodass die Antwort nur die von Ihnen benannten Felder enthält. Ein Prompt überlässt die Struktur dem Model, was schneller zu schreiben ist, aber zwischen Aufrufen variieren kann.
- Seitentyp-Formate:
product,menu,branding,audioundvideogeben eine feste, von Firecrawl festgelegte Struktur zurück.productdeckt Titel, Preis, Verfügbarkeit, Varianten und Verkaufspreis ab. Sie akzeptieren keine Parameter und laufen ohne ein LLM. deterministicJson: Nimmt ein Schema entgegen und cached einen generierten Extraktor pro Website, sodass wiederholte Scrapes das LLM überspringen. Kann nicht mit dem Formatjsonkombiniert werden.- Ausführung pro Anfrage: Jeder Aufruf trägt seinen eigenen Prompt oder sein eigenes Schema und wird zur Anfragezeit ausgeführt, sodass die Ausgabe die Seite so widerspiegelt, wie sie in diesem Moment aussieht, und im Vorfeld nichts registriert werden muss.
- Coding-Agent-Unterstützung: Offizieller MCP-Server und CLI, mit Schnellstarts für Claude Code, Cursor, Codex CLI und Gemini CLI sowie einem offiziellen Claude-Plugin.
- Agent: Firecrawl bietet außerdem ein Agent-Produkt an, bei dem die URL optional ist. Sie beschreiben, was Sie möchten, und der Agent navigiert im Web, um es zu finden.
ScrapingBee ist eine One-Shot-Extraktions-API wie Firecrawl: Jeder Aufruf ist unabhängig und speichert nichts. ScrapingBee unterscheidet sich darin, wie Sie die gewünschten Daten beschreiben.
- Drei Extraktionsmodi: ai_query für ein einzelnes Feld in natürlicher Sprache (gibt einen String zurück), ai_extract_rules für ein JSON-Schema, in dem jedes Feld eine eigene Beschreibung hat, und eine erweiterte Form davon mit Typen, Enums und verschachtelter Ausgabe.
- ai_selector: Übergeben Sie einen CSS-Selektor, um das LLM auf einen bestimmten Teil der Seite zu fokussieren. Schneller und genauer, als es das gesamte DOM lesen zu lassen.
- Klassisches Scraping im selben Aufruf: render_js für JS-lastige Websites, screenshot, extract_rules für CSS/XPath-Extraktion ohne KI und json_response, um HTML, cookies, XHRs und iframes in einem Umschlag zu erhalten.
Wie wählen Sie das richtige Tool für Ihre Pipeline?
Das richtige Tool hängt davon ab, wie oft Ihre Pipeline dieselben Websites scrapt und wer den Scraper pflegt:
Einmaliges oder gelegentliches Scraping
Für einmaliges oder gelegentliches Scraping sind One-Shot-KI-Extraktions-APIs wie Firecrawl, ScrapingBee und Oxylabs KI Studio die schnellste Option. Sie senden bei jedem Aufruf einen Prompt oder ein Schema, und es muss kein Scraper erstellt werden.
Wiederholtes Scraping in einer Pipeline
Für wiederholtes Scraping oder wenn Sie benutzerdefinierte Datenfelder benötigen, passt eine Build-once, call-many-Plattform wie Bright Data Scraper Studio, Browse KI oder Kadoa besser. Der gespeicherte Scraper liefert bei jedem Aufruf dasselbe Schema, und Ihre Pipeline übergibt nur URLs.
Wie lange die Einrichtung dauert
Die Build-Zeit variiert je nach Ansatz. Das Schreiben eines Scrapers oder Actors von Grund auf dauert in der Regel Tage bis Wochen, da Crawler, Proxy-Verdrahtung und Wiederholungen bei Ihnen liegen. Promptbasierte Plattformen generieren Schema und Code in Minuten. Aufzeichnungsbasierte Tools sind ebenfalls in wenigen Minuten einsatzbereit, mit Point-and-Click-Einrichtung statt eines Prompts. One-Shot-KI-Extraktions-APIs überspringen den Build-Schritt; die erste Antwort kommt in einem einzigen HTTP-Aufruf zurück.
Website bereits durch einen fertigen Scraper abgedeckt
Ein fertiger Scraper für eine beliebte Website ist in der Regel schneller als der eigene Aufbau, aber wer ihn funktionsfähig hält, hängt davon ab, woher er stammt. Eine vom Anbieter gepflegte Bibliothek wie die von Bright Data wird vom Anbieter aktualisiert, wenn sich die Website ändert. Ein Drittanbieter-Scraper, wie die meisten Actors für beliebte Websites im Apify Store, wird nach dem Zeitplan seines Eigentümers repariert.
Website durch nichts Fertiges abgedeckt
Bei Websites ohne fertigen Scraper stellt sich die Frage, wer den Scraper repariert, wenn sich das Layout ändert. Wenn Sie Ihren eigenen erstellen, warten Sie ihn selbst. Mit einem aufzeichnungsbasierten Tool wie Browse KI passt sich der Roboter den meisten Änderungen selbstständig an, und Sie trainieren ihn neu, wenn er es nicht kann. Mit KI-Selbstheilung repariert das Tool Ihren gespeicherten Scraper unter derselben ID: Bright Data zeigt die Korrektur zur Genehmigung an, bevor sie live geht, während Kadoa sie automatisch anwendet.
Erstellung mit Coding-Agenten
Wenn Ihr Workflow über Claude Code, Cursor oder Codex läuft, ist es wichtig, ob das Tool eine CLI oder eine MCP-Integration bereitstellt, die der Agent durchgängig steuern kann, oder ob der Agent nur eine einfache HTTP-API aufrufen kann.
 Als bevorzugte Quelle hinzufügen
Methodik des KI-Web-Scraping-Benchmarks
Benchmark-Domains:
Zehn Domains im KI-Web-Scraping-Benchmark stammen aus dem Semrush-Ranking der meistbesuchten Websites. Fünf sind E-Commerce (amazon, ebay, etsy, aliexpress, walmart) und fünf sind sozial (facebook, instagram, reddit, tiktok, x). Wir haben 500 URLs von jeder gesammelt, insgesamt 5.000, und jede einzelne an alle fünf Tools gesendet, was 25.000 Anfragen ergibt.
Prompts:
Jedes Tool erhielt für einen bestimmten Seitentyp exakt denselben Prompt, ohne toolspezifische Anpassung:
- E-Commerce: Extract den Preis und die Währung des Produkts und gib json zurück
- Social: Extract den Beitragstext, die Anzahl der Likes und den Benutzernamen des Autors des Beitrags und gib json zurück
Bright Data nimmt den Prompt einen Schritt früher entgegen als die anderen. Statt bei jedem Aufruf aus einem Prompt zu scrapen, geben Sie ihm den Prompt einmal, und es erstellt einen Scraper und gibt eine Collector-ID zurück, die Sie dann wiederholt aufrufen. Dieser Build-Schritt ist kein Scraping, sondern das Erzeugen einer API durch das Tool, und er erfolgt pro Domain einmal, bevor ein Benchmarking beginnt, daher ist er nicht in den Zeitmessungen enthalten. Wir haben ab der Collector-ID gemessen, wo der Prozess mit den anderen vier übereinstimmt. Um es als Zero-Shot zu belassen, wurde das von Bright Data generierte Schema automatisch so akzeptiert, wie es von der API zurückkam, ohne Prüfung und ohne Korrektur.
Jedes Tool wurde so aufgerufen, wie seine eigene API aufgebaut ist. Bright Data, Apify und Firecrawl sind darauf ausgelegt, eine Liste von URLs in einer Anfrage entgegenzunehmen, daher haben wir 100 URLs pro Anfrage gesendet. Oxylabs und ScrapingBee sind nicht so aufgebaut; ihre APIs nehmen eine URL nach der anderen entgegen, also haben wir sie so aufgerufen. Die Parallelität war bei jedem Tool gleich, fünf parallele Anfragen.
Kennzahlen:
Erfolg ist der Anteil der Anfragen, die mit mindestens einem der angeforderten Felder zurückkamen. Leere Strings, Nullen anstelle einer Zahl und Antworten, die den Prompt zurückgeben, zählen nicht als Feld.
Vollständigkeit gibt an, wie viele der angeforderten Felder zurückkamen, gemittelt über die Anfragen. Eine soziale Seite, auf der nur der Autor ankommt, erhält einen von drei Punkten.
Genauigkeit ist der Anteil der überprüfbaren Werte, die korrekt waren. Ein Feld, das Tool nie zurückgegeben hat, zählt als falsch, da ein fehlender Wert und ein falscher Wert downstream dieselben Kosten verursachen.
Jede Kennzahl wird pro Domain berechnet und dann über die zehn Domains gemittelt.
Ermittlung der korrekten Antwort
Wir haben zwei Methoden verwendet. Wo Ground Truth verfügbar war, haben wir daran gemessen: Einige Antworten stecken in der URL selbst, etwa der Autor-Handle in einem x.com- oder tiktok.com-Link, und für andere haben wir eine unabhängige Referenz außerhalb der fünf Tools erhoben, etwa Produktpreise und Reddit-Stimmenzahlen.
Wo keine Ground Truth existierte, haben wir nach Konsens bewertet. Ein Feld wird auf diese Weise nur dann entschieden, wenn mindestens vier der fünf Tools es beantwortet haben. Dann haben wir das zu bewertende Tool beiseitegelegt und den Rest betrachtet: Wenn derselbe Wert in mehr als der Hälfte davon und in mindestens zwei auftaucht, wird dieser Wert zur Referenz. Ein Tool stimmt nie über seine eigene Antwort ab, und ein Feld, auf das sich die anderen nicht einigen konnten, wird aus dem Genauigkeitswert ausgeschlossen.
Zahlen müssen nicht exakt übereinstimmen. Ein Wert gilt als korrekt innerhalb von 10 % der Referenz, mit einer kleinen absoluten Untergrenze obendrauf, sodass ein Beitrag mit 5 Likes nicht wegen einer Differenz von eins durchfällt, während ein Beitrag mit 90.000 weiterhin anhand des Prozentsatzes beurteilt wird.
Konfidenzintervalle
Alle Zahlen tragen 95 %-Konfidenzintervalle aus 10.000 Bootstrap-Resamples auf URL-Ebene. Die den einzelnen Zahlen zugrunde liegenden Anfragedaten werden mit den Ergebnissen veröffentlicht.
FAQs
Ja. Open-Source-Bibliotheken wie Crawl4AI, Skyvern und Browser Use sind kostenlos zum Self-Hosting, und die meisten kommerziellen Tools, darunter Browse KI, Firecrawl und Thunderbit, bieten eine free-Stufe mit Nutzungslimits.
Diese Forschung zitieren
Wählen Sie das Format, das zu Ihrem Veröffentlichungsort passt. Wenn Sie die Link-Version in Ihr CMS einfügen, bleibt der Backlink erhalten.
@misc{sipi2026,
  author = {Şipi, Nazlı},
  title  = {{Beste KI-Web-Scraping-Tools im Benchmark}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/ai-web-scraping}},
  note   = {AIMultiple. Abgerufen am 2. Oktober 2026}
}Ergebnisse und Zeitstempel von 25.1 Tausend Datenpunkten. Laden Sie die Zusammenfassungsdaten aus den Diagrammen und Tabellen dieses Artikels als ZIP-Datei herunter, die 7 CSV-Dateien und eine README enthält.
Möchten Sie die granularen Daten dahinter? Premium beitreten
Änderungsprotokoll
5 AktualisierungenHinzugefügt: ein Benchmark-Abschnitt, der KI-Web-Scraping-Tools auf führenden E-Commerce-Seiten vergleicht.
Ersetzte die Tool-Liste durch benannte Einträge für Browse AI, Firecrawl, ScrapeGraphAI, Diffbot, Kadoa, Skyvern und andere und fügte einen FAQ-Abschnitt hinzu.
Die Einführung in KI-Web-Scraping-Tools wurde durch eine Beschreibung von autonomen KI-Agenten, visionsbasiertem Scraping (VLM) und selbstheilenden Scrapern ersetzt.



Seien Sie der Erste, der kommentiert
Ihre E-Mail-Adresse wird nicht veröffentlicht. Alle Felder sind erforderlich. Kommentare werden in ihrer Originalsprache belassen.