


Herramientas de detección de alucinaciones de IA: W&B Weave y Comet

Hicimos un benchmark de tres herramientas de detección de alucinaciones: W&B Weave HallucinationFree Scorer (parte de CoreWeave Forge, anteriormente Weights & Biases), Arize Phoenix HallucinationEvaluator y Comet Opik Hallucination Metric, en 100 casos de prueba.
Cada herramienta se evaluó en exactitud, precisión, sensibilidad y latencia.
Benchmark de herramientas de detección de alucinaciones de IA
Probamos 100 respuestas (50 correctas, 50 alucinadas) de escenarios de preguntas y respuestas factuales en comparación con su contexto de origen.
Comparación de exactitud y latencia
Consulte la sección metodología del benchmark. para obtener más detalles sobre el proceso de prueba.
W&B Weave y Arize Phoenix ofrecieron una exactitud casi idéntica, del 91 % y el 90 % respectivamente. Ambas herramientas demostraron un rendimiento fiable en todo el dataset. Comet Opik se quedó atrás con una exactitud del 72 %, clasificando correctamente solo 72 de 100 pruebas, una brecha significativa impulsada por su enfoque conservador.
En cuanto a velocidad, Arize Phoenix fue la herramienta ganadora, con 2 segundos por prueba, lo que la hace adecuada para aplicaciones en tiempo real. W&B Weave procesó las pruebas en 4 segundos, lo que es razonable para la mayoría de los casos de uso en producción. Comet Opik fue notablemente más lenta, con 8,5 segundos por prueba, lo que podría afectar la experiencia del usuario en aplicaciones sensibles a la latencia.
Puntuación F1, precisión y sensibilidad
Las puntuaciones F1 (media armónica de precisión y sensibilidad) confirmaron estos patrones: W&B Weave con un 90,5 % y Phoenix con un 89,4 % lograron un rendimiento sólido y equilibrado. En comparación, el 61,1 % de Opik reflejó el equilibrio entre una precisión perfecta y una sensibilidad débil. Los cero falsos positivos de Opik se produjeron a costa de 28 falsos negativos, lo que lo hace adecuado solo para escenarios en los que las falsas alarmas son más costosas que las detecciones no realizadas.
La sensibilidad (capacidad de detectar alucinaciones reales) reveló estrategias distintas. W&B Weave lideró con una sensibilidad del 86 %, detectando 43 de 50 alucinaciones y omitiendo solo 7. Phoenix le siguió de cerca con un 84 %, detectando 42 alucinaciones y omitiendo 8. La sensibilidad de Comet Opik fue sustancialmente inferior, del 44 %, detectando solo 22 alucinaciones y omitiendo 28; más de la mitad de todas las alucinaciones reales pasaron desapercibidas.
La precisión (fiabilidad de las alertas) mostró una variación significativa. Comet Opik alcanzó una precisión perfecta del 100 % con cero falsos positivos; cuando marcó algo como alucinación, siempre tuvo razón. Tanto Phoenix (95,5 %) como Weave (95,6 %) mostraron una precisión casi idéntica, cada una con solo 2 falsos positivos de 50 respuestas legítimas, lo que demuestra una gran fiabilidad sin ser demasiado conservadoras.
Factores que podrían afectar las diferencias de rendimiento
Las diferencias de rendimiento observadas posiblemente se deben a la filosofía de diseño, la selección de umbrales y la interpretación de la fundamentación.
Diferencias en la estrategia de detección y los objetivos de optimización
- Las herramientas parecen estar optimizadas para distintos compromisos de error y no para el mismo objetivo.
- W&B Weave y Arize Phoenix buscan un rendimiento equilibrado, manteniendo una alta precisión y capturando la mayoría de las alucinaciones.
- Comet Opik adopta una estrategia muy conservadora, priorizando cero falsos positivos incluso si se omiten muchas alucinaciones.
- Esta elección estratégica explica directamente la precisión perfecta de Opik y su sensibilidad sustancialmente menor.
Compromisos entre precisión y sensibilidad incorporados en el diseño de las herramientas
- Los cero falsos positivos de Comet Opik indican un umbral de decisión estricto, que marca alucinaciones solo cuando la confianza es muy alta.
- W&B Weave y Phoenix utilizan umbrales menos restrictivos, permitiendo algunos falsos positivos a cambio de una sensibilidad mucho mayor.
- Estas diferencias de umbral pueden dar lugar a:
- Una precisión similar entre Weave y Phoenix
- Grandes brechas de sensibilidad entre Opik y las otras dos herramientas
- Diferencias correspondientes en la puntuación F1 y en la exactitud general
Variaciones en la implementación de LLM como juez
- Aunque las tres herramientas utilizan un enfoque de LLM como juez, sus implementaciones difieren.
- W&B Weave hace hincapié en el razonamiento de cadena de pensamiento, lo que puede mejorar la sensibilidad a afirmaciones sutiles no fundamentadas.
- Arize Phoenix incorpora salidas basadas en etiquetas con puntuaciones de confianza, lo que permite juicios más matizados.
- Comet Opik se centra en decisiones binarias de alta confianza, lo que reduce las falsas alarmas pero limita la sensibilidad a alucinaciones límite.
Diferencias de latencia impulsadas por la profundidad de la evaluación
- La menor latencia de Arize Phoenix sugiere una pipeline de evaluación más ligera o simplificada, adecuada para uso en tiempo real.
- La latencia moderada de W&B Weave es coherente con un razonamiento más rico y un registro de trazabilidad.
- La mayor latencia de Comet Opik probablemente refleja un razonamiento interno o pasos de verificación más extensos, lo que refuerza su diseño conservador.
Herramientas de detección de alucinaciones de IA
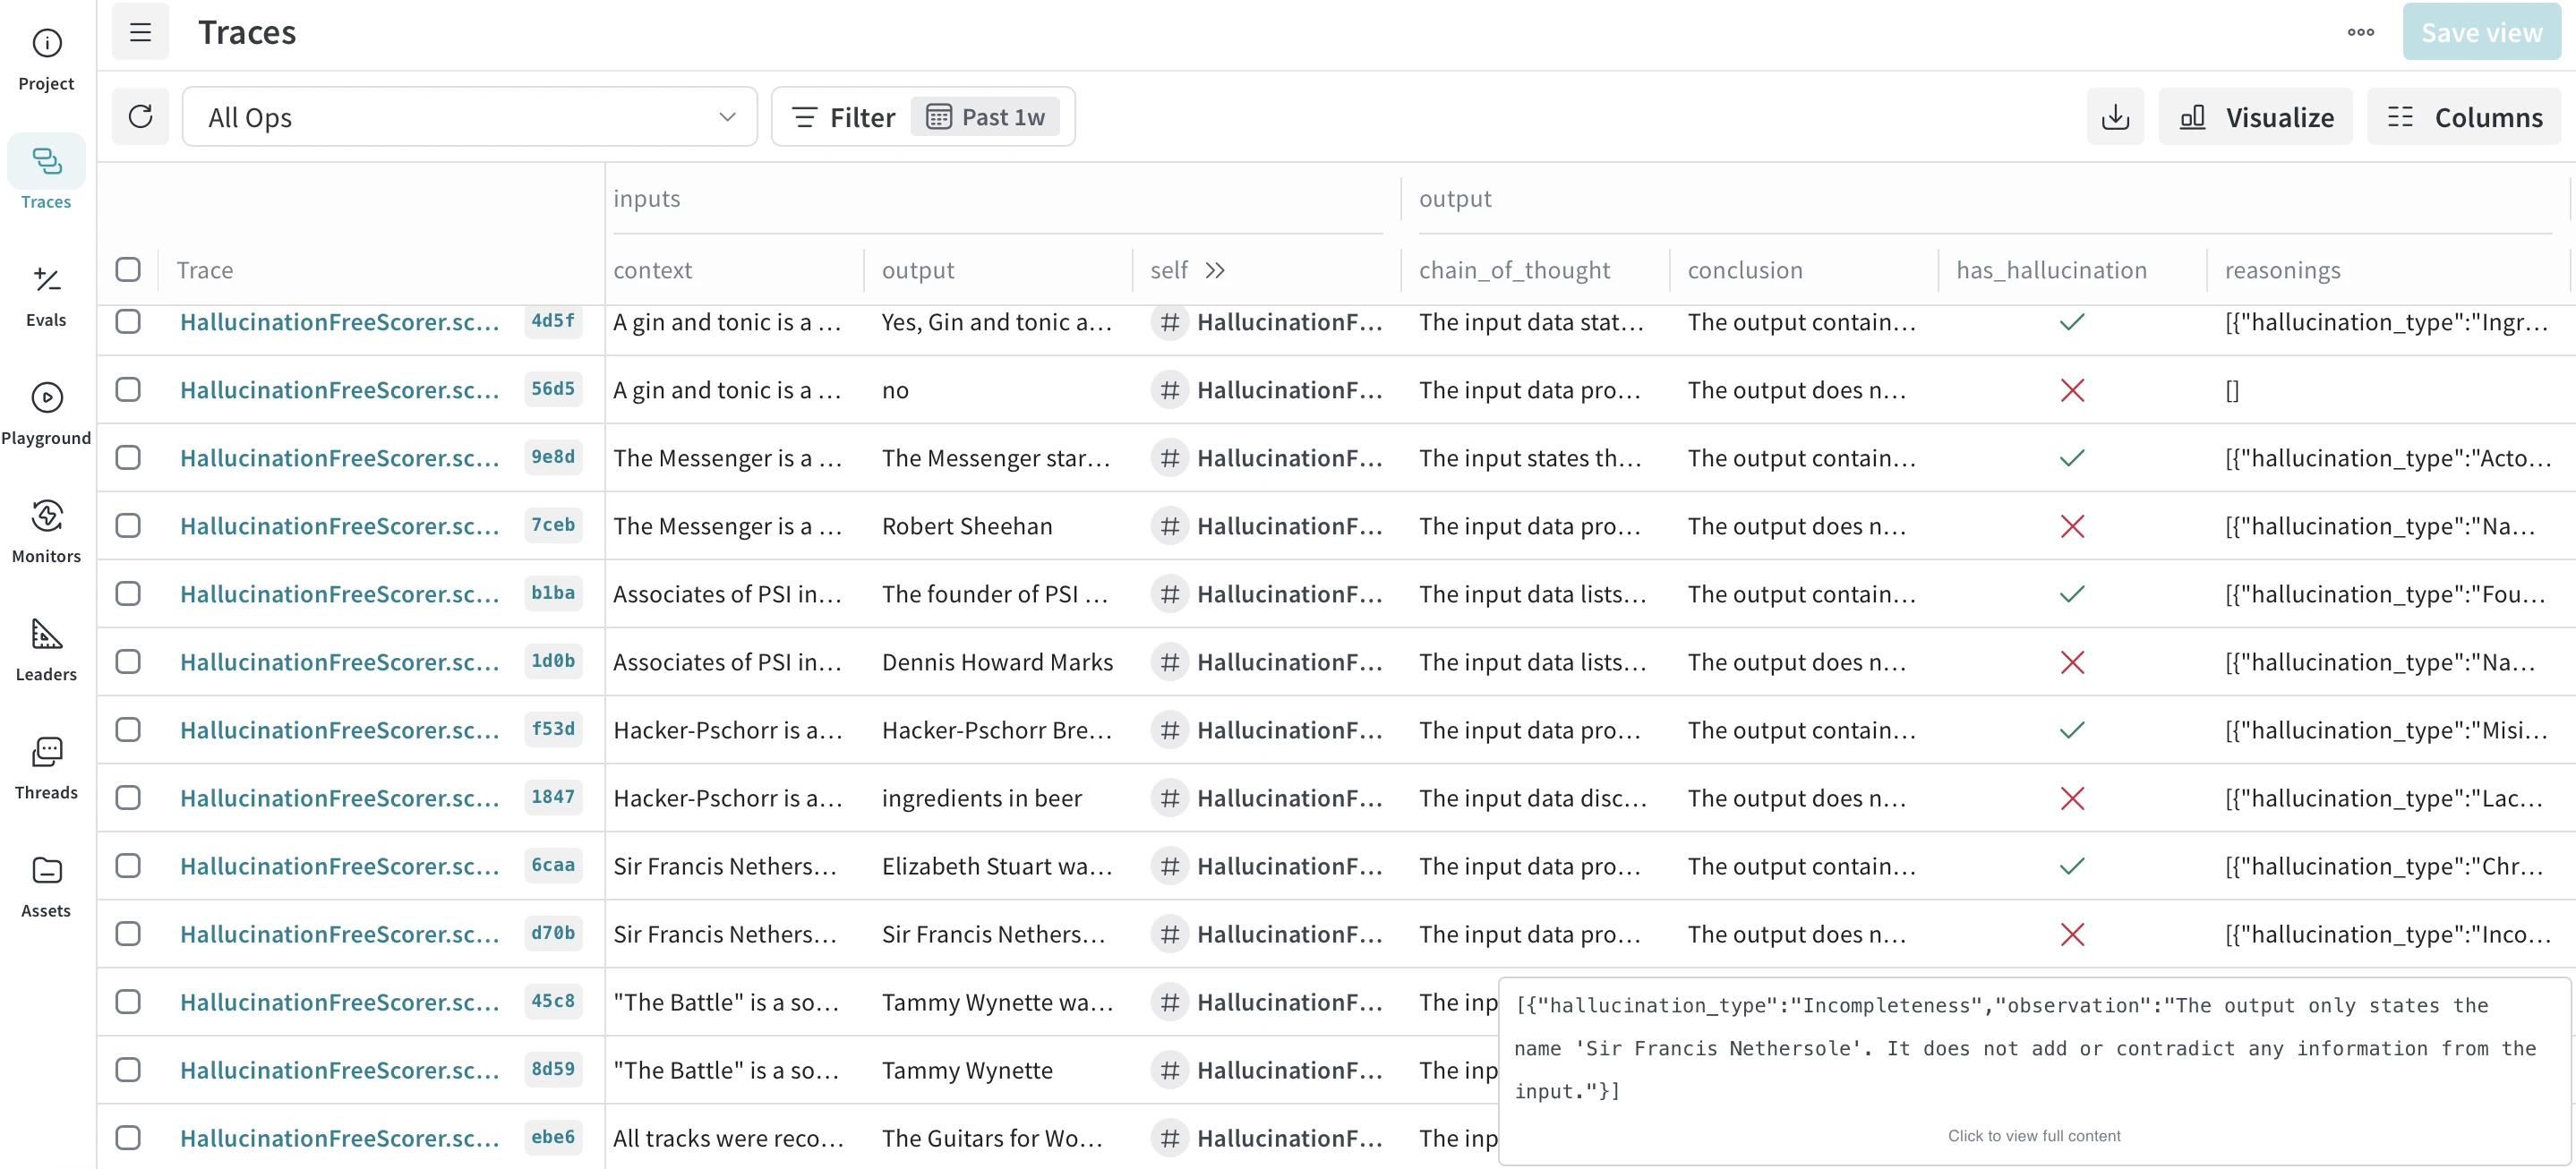
HallucinationFree Scorer de W&B Weave
Figura 1: Panel de trazas de W&B Weave.
CoreWeave Forge incluye un HallucinationFree Scorer que marca las salidas de LLM que introducen afirmaciones no presentes en el contexto de origen. Ejecuta un juez LLM sobre cada respuesta y devuelve un veredicto de fundamentada/no fundamentada junto con el razonamiento que lo sustenta.
El scorer recibe dos entradas: el contexto (material de origen) y la salida (respuesta generada por LLM). Después utiliza un language model para analizar si la salida introduce información no presente en el contexto. El resultado incluye una marca booleana has_hallucination y el razonamiento que explica la decisión.
Características principales:
- Razonamiento de cadena de pensamiento: Cada evaluación incluye una explicación de por qué la salida se marcó como alucinación o no.
- Clasificación binaria: Devuelve decisiones claras de verdadero/falso con evidencia de respaldo.
- Integración con el seguimiento de Weave: Los resultados se registran automáticamente en el panel de Weave para su visualización.
- Model personalizable: Admite diferentes jueces LLM, incluidos OpenAI, Anthropic y otros proveedores.
HallucinationEvaluator de Arize Phoenix
Arize Phoenix incluye un HallucinationEvaluator que marca las respuestas que se desvían de su material de referencia. Para cada salida, un juez LLM decide si la respuesta está fundamentada en el contexto suministrado y adjunta una puntuación de confianza a su veredicto.
El evaluador recibe tres entradas: la consulta del usuario (entrada), el texto de referencia (contexto) y la respuesta del model (salida). Analiza si la respuesta contiene información que no puede derivarse del contexto y devuelve un resultado etiquetado («factual» o «alucinada») junto con una explicación y una puntuación de confianza.
Características principales:
- Rendimiento equilibrado: Ofrece resultados tanto en las métricas de precisión como en las de sensibilidad.
- Salida basada en etiquetas: Devuelve etiquetas categóricas («factual» o «alucinada») en lugar de solo puntuaciones numéricas.
- Explicaciones detalladas: Proporciona el razonamiento de cada decisión de evaluación.
Hallucination Metric de Comet Opik
La Hallucination Metric de Comet Opik puntúa cada respuesta de LLM en relación con su contexto de origen y devuelve un juicio binario sobre si la salida es fiel a ese contexto. La comprobación se ejecuta a través de un juez LLM ajustado para marcar solo los casos de alta confianza de afirmaciones no fundamentadas.
La métrica acepta tres entradas: la consulta del usuario (entrada), el material de origen (contexto) y la respuesta del model (salida). Evalúa si la salida introduce afirmaciones no respaldadas por el contexto.
El resultado incluye una puntuación binaria (0 para ausencia de alucinación, 1 para alucinación detectada) y un razonamiento detallado que explica la evaluación.
Características principales:
- Explicaciones detalladas: Cada evaluación proporciona un razonamiento exhaustivo sobre por qué el contenido se marcó o se aprobó.
- Análisis de tres entradas: Considera la consulta, el contexto y la respuesta conjuntamente para la evaluación.
- Seguimiento de experimentos: Los resultados se registran automáticamente en el sistema de seguimiento de experimentos de Opik.
- Enfoque conservador: Diseñado para minimizar los falsos positivos marcando solo alucinaciones de alta confianza.
Galileo Luna-2
Galileo Luna-2 es una capa de detección de alucinaciones y barreras de protección en tiempo de ejecución integrada en la plataforma más amplia de observabilidad de IA de Galileo. 1
El sistema está diseñado para ejecutarse en línea en las rutas de inference de producción, bloqueando el contenido no fundamentado antes de que llegue al usuario, mientras que Signals, la capa automatizada de análisis de fallos de Galileo, saca a la luz las causas raíz de los errores de producción sin revisión manual de registros.
Características principales:
Detección multimétodo: Combina la similitud de embedding, el análisis de cadena de pensamiento y la puntuación de factualidad G-Eval en lugar de depender de una única estrategia de juzgamiento.
Barreras de protección en tiempo de ejecución: Luna-2 puede bloquear o reescribir las salidas no fundamentadas en línea en la ruta de inference, no solo marcarlas a posteriori.
Observabilidad de extremo a extremo: Captura entradas, salidas y trazas de razonamiento interno en flujos de trabajo de agentes de varios pasos, y Signals automatiza el análisis de causas raíz.
DeepEval
DeepEval es un framework de evaluación de LLM de código abierto de Confident IA, diseñado para sentirse como Pytest pero para aplicaciones de LLM. Su HallucinationMetric utiliza un LLM como juez para decidir si la salida del model es factualmente coherente con el contexto proporcionado, y el framework está diseñado para ejecutarse dentro de cualquier pipeline de CI/CD.23
La métrica recibe tres entradas obligatorias: la consulta del usuario (input), la respuesta del model (actual_output) y el material de referencia (context). Puntúa cada salida utilizando la fórmula Alucinación = (Número de contextos contradichos) / (Número total de contextos), donde una puntuación más baja indica una mejor fundamentación. Una salida se considera aprobada cuando su puntuación es igual o inferior al umbral configurado.
Características principales:
- Flujo de trabajo de pruebas familiar: Las comprobaciones de alucinación se escriben y ejecutan como pruebas unitarias normales, de modo que los equipos que ya usan Pytest no necesitan aprender una herramienta nueva.
- Rigor ajustable: Los equipos pueden relajar o endurecer el umbral de aprobación, o cambiar a un modo estricto de aprobado/reprobado para contenido de alto riesgo.
- Explicaciones para cada resultado: Cada veredicto incluye un motivo, de modo que queda claro por qué se marcó una salida.
¿Qué es la alucinación de IA?
Las alucinaciones de IA son salidas que se leen como coherentes pero no son factuales. El model produce estas afirmaciones con confianza incluso cuando el contexto de origen o los datos de entrenamiento no las respaldan. Una encuesta sobre el tema atribuye esto a que los models se apoyan en sesgos lingüísticos en lugar de evidencia verificable del contexto proporcionado.4 El problema aparece en ámbitos de alto riesgo como la atención sanitaria, los servicios jurídicos, la búsqueda empresarial y la atención al cliente, por lo que la detección de salidas fundamentadas se ha convertido en una parte estándar deLLM la implementación.
Fuentes y taxonomía de las alucinaciones
Las alucinaciones provienen de dos grandes fuentes. Entre los factores internos del model se incluyen la dependencia excesiva de los patrones estadísticos, las lagunas en los datos de entrenamiento y la naturaleza probabilística de la generación de secuencias; un análisis sobre la detección y mitigación de alucinaciones señala que los LLM a menudo infieren continuaciones probables en lugar de recuperar evidencia verificable, lo que produce una salida segura pero incorrecta.5
Los factores contextuales abarcan fallos de recuperación en RAG sistemas, los prompts ambiguos, la fundamentación incompleta y, en multimodal models, confusiones de objetos o detalles de escena inventados.
Detección de alucinaciones en flujos de trabajo de agentes
Los agentes de varios pasos introducen riesgos de alucinación que los LLM de un solo turno no presentan: una afirmación inventada en un paso temprano se propaga a llamadas a herramientas, recuperaciones y salidas finales posteriores.
Retos clave en la detección de alucinaciones en agentes:
- Propagación de errores: Un hecho inventado en la fase de planificación puede influir en la selección de herramientas, la recuperación de datos y las respuestas finales.
- Alucinaciones en las llamadas a herramientas: Los agentes pueden invocar herramientas con parámetros incorrectos o malinterpretar las salidas de las herramientas.
- Corrupción del estado: La información alucinada almacenada en la memoria del agente afecta a pasos de razonamiento futuros.
- Complejidad de atribución: Identificar qué paso introdujo la alucinación requiere un seguimiento de extremo a extremo.
Enfoques de detección para sistemas agénticos:
- Verificación a nivel de paso: Validar cada salida intermedia antes de que el agente continúe con la siguiente acción.
- Validación de salidas de herramientas: Contrastar las respuestas de las herramientas con los formatos esperados y las restricciones conocidas.
- Análisis de trayectoria: Revisar la secuencia completa de decisiones del agente para identificar dónde el razonamiento se desvió de la información fundamentada.
- Comprobaciones de coherencia entre pasos: Comparar las afirmaciones realizadas en diferentes etapas para detectar contradicciones.
El HallucinationFree Scorer de W&B Weave y el HallucinationEvaluator de Arize Phoenix pueden aplicarse en cada paso del agente, mientras que sus paneles integrados muestran la traza de ejecución completa para el análisis de causas raíz.
 Añadir como fuente preferida
Prevención de alucinaciones en tiempo real
La detección posterior a la generación saca a la luz los problemas, pero no impide que las salidas incorrectas lleguen a los usuarios. La prevención en tiempo real ejecuta la comprobación en línea, antes de que se entregue la respuesta.
Mecanismos de prevención:
- Barreras de protección de salida: Filtros que analizan el contenido generado según criterios de factualidad antes de devolverlo al usuario.
- Umbrales de confianza: Bloquear o marcar respuestas cuando la confianza interna del model cae por debajo de niveles aceptables.
- Puertas de validación de recuperación: Verificar que las afirmaciones generadas estén respaldadas por documentos recuperados antes de finalizar la respuesta.
- Estrategias de respaldo: Devolver una respuesta predeterminada segura o escalar a colas de revisión cuando el riesgo de alucinación es alto.
Capacidades de las herramientas para la prevención en tiempo real:
- W&B Weave integra la puntuación de alucinaciones en las pipelines de producción, lo que permite comprobaciones automáticas antes de servir las respuestas.
- Arize Phoenix ofrece monitoreo en tiempo real con capacidades de alerta que marcan las salidas de alto riesgo para su revisión inmediata.
- Comet Opik ofrece seguimiento de experimentos con evaluación automatizada, lo que permite a los equipos establecer puertas de calidad que bloquean las respuestas que superan los umbrales de alucinación.
Enfoques para la detección de alucinaciones
Tres enfoques son directamente relevantes para el funcionamiento de Weave, Phoenix y Opik:
1. Métodos basados en la coherencia
Los métodos basados en la coherencia evalúan una respuesta comparándola con varias generaciones alternativas mediante similitud semántica, superposición de n-gramas o verificación pregunta-respuesta. Cuando las respuestas se contradicen entre sí o contienen inconsistencias lógicas, la probabilidad de alucinación aumenta. Una técnica relacionada, la entropía semántica, agrupa las respuestas por significado en lugar de por redacción y utiliza la inestabilidad conceptual como señal de alucinación.
2. Detección basada en probabilidad y confianza
Las probabilidades a nivel de token, los valores de entropía, las curvas de calibración y las estimaciones de confianza basadas en márgenes revelan la creencia interna del model sobre su propia salida. Los segmentos de baja confianza suelen correlacionarse con tasas de alucinación más altas. La entropía bruta puede inducir a error debido a la redacción variable, pero las señales de confianza siguen siendo útiles cuando se combinan con indicadores basados en la coherencia. Arize Phoenix expone una puntuación de confianza junto con su etiqueta, lo que encaja en esta categoría.
3. Detección basada en referencias o en el contexto
La evaluación basada en referencias compara la salida del model con el contexto proporcionado o con fuentes externas, y es el mecanismo central detrás de RAG en las comprobaciones de calidad. Entre las técnicas típicas se incluyen models de implicación que comprueban si los documentos recuperados respaldan la respuesta, métodos de alineación y fundamentación que validan el respaldo probatorio y métricas de factualidad que miden si las afirmaciones coinciden con el texto de apoyo. Las tres herramientas incluidas en el benchmark operan principalmente en este modo: reciben un contexto de entrada y juzgan si la salida se mantiene dentro de él.
Técnicas y algoritmos de detección de alucinaciones de IA
Los métodos de detección operan en tres granularidades:
- A nivel de token: Marca tramos sospechosos dentro de una salida. Utiliza datasets de alucinaciones anotados por humanos, la divergencia entre las probabilidades de token anteriores y posteriores dado el contexto, o clasificadores de etiquetado de secuencias.
- A nivel de frase: Juzga enunciados completos. Las comprobaciones de autocoherencia basadas en muestreo comparan varias generaciones para detectar inestabilidad, la entropía semántica señala incertidumbre conceptual sin etiquetas y los clasificadores de implicación detectan afirmaciones no respaldadas o contradictorias.
- A nivel de flujo de trabajo: Rastrea pipelines de varios pasos mediante grafos de procedencia, comprobaciones de implicación a nivel de paso, validación del razonamiento intermedio y rastreo de dependencias para tareas de múltiples saltos.
Las tres herramientas que incluimos en el benchmark operan principalmente a nivel de frase, y Weave y Phoenix se extienden al uso a nivel de flujo de trabajo a través de sus paneles de trazabilidad.
Patrones industriales y buenas prácticas
Los equipos de producción rara vez dependen de un único método. Los patrones comunes incluyen:
- Detección en capas: Las comprobaciones de coherencia, la puntuación de probabilidad y la validación de implicación se ejecutan en la misma pipeline.
- Monitoreo en tiempo real: Los paneles rastrean la deriva y los cambios de confianza a lo largo del tiempo.
- Ajuste de prompts: Los prompts se refinan para reducir la ambigüedad que conduce a salidas no fundamentadas.
- Revisión experta: Reservada para contenido legal, médico o financiero donde los errores conllevan un coste real.
- Integración CI/CD: Las comprobaciones de calidad automatizadas se ejecutan antes del despliegue para que las regresiones se detecten pronto.
- Monitoreo de agentes: Los complementos observan las llamadas a herramientas y los pasos de razonamiento intermedio para detectar anomalías a medida que aparecen.
Metodología del benchmark de herramientas de detección de alucinaciones de IA
El benchmark utilizó un dataset controlado de 50 elementos de conocimiento extraídos de escenarios de preguntas y respuestas factuales. Cada elemento incluía un contexto de origen, una pregunta, una respuesta correcta fundamentada en ese contexto y una respuesta alucinada que contenía información inventada. Por ejemplo, una prueba preguntaba por la ubicación de la sede de The Oberoi Group, donde la respuesta correcta «Delhi» se contrastaba con la respuesta alucinada «Mumbai».
Cada elemento de conocimiento generó dos casos de prueba: uno con la respuesta correcta (esperado: sin alucinación) y otro con la respuesta alucinada (esperado: alucinación detectada). Esto creó una división equilibrada 50/50 que suma 100 casos de prueba. Las tres herramientas procesaron los mismos casos de prueba de forma secuencial, y cada una recibió entradas idénticas (contexto, pregunta y salida).
Medimos la latencia de cada caso de prueba individualmente para garantizar una comparación justa, evitando los escollos del procesamiento en paralelo o la evaluación por lotes que podrían sesgar los resultados. Las etiquetas de referencia se verificaron manualmente para garantizar la exactitud en el cálculo de verdaderos positivos, falsos positivos, verdaderos negativos y falsos negativos.
Cita este benchmark
Elige el formato que se ajuste al lugar donde vas a publicar. Pegar la versión con enlace en tu CMS conserva el enlace de retroceso.
@misc{ermut2026,
  author = {Ermut, Sıla and Şipi, Nazlı},
  title  = {{Herramientas de detección de alucinaciones de IA: W&B Weave y Comet}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/ai-hallucination-detection}},
  note   = {AIMultiple. Recuperado el 18 de junio de 2026}
}Resultados y marcas de tiempo de 12 puntos de datos. Descargue los datos resumidos que se muestran en los gráficos y las tablas de este artículo como un archivo ZIP que contiene 4 archivos CSV.
¿Quieres los datos granulares que hay detrás? Únete a Premium
Registro de cambios
3 actualizacionesSe añadieron Galileo Luna-2 y DeepEval como nuevas secciones de herramientas junto a las herramientas de detección de alucinaciones evaluadas.
Se añadió "Hallucination detection in agentic workflows" a la sección "What is AI hallucination?".
Enlaces de referencia
Anteriormente trabajó como reclutadora en empresas de gestión de proyectos y consultoría. Sıla tiene un máster en Psicología Social y una licenciatura en Relaciones Internacionales.

Siguiente para leer
Navegadores Web con IA: Guía de Selección

Comparativa de los 20 principales detectores de texto generado por IA

Comparativa de los 7 principales detectores de imágenes de IA

HALC-Bench: LLM Alucinación en el benchmark de recuperación de contexto largo


Las 14 mejores herramientas de detección y prevención de intrusiones (IDPS/IPS)
Principales 20 empresas de tecnología de engaño

Sé el primero en comentar
Tu dirección de correo electrónico no será publicada. Todos los campos son obligatorios. Los comentarios se dejan en su idioma original.