


LLM Orquestación: 21 frameworks y pasarelas

Optimizar la orquestación de LLM es clave para mejorar el rendimiento manteniendo el uso de recursos bajo control. Para evaluar cómo se desempeñan los distintos enfoques de orquestación en la práctica, realizamos un benchmark de:
- Frameworks de orquestación agéntica: Usando un flujo de trabajo idéntico de planificación de viajes de cinco agentes, ejecutado 100 veces cada uno, midiendo la latencia del pipeline, el uso de tokens, las transiciones agente a agente y los intervalos de ejecución agente a herramienta.
- Pasarelas de IA: OpenRouter, SambaNova, TogetherAI, Groq y IA/ML API probados en latencia del primer token, latencia total y recuento de tokens de salida con 300 pruebas de prompts cortos (≈18 tokens) y largos (≈203 tokens).
Descubra herramientas de orquestación de LLM seleccionadas, incluidos frameworks para desarrolladores y pasarelas empresariales:
¿Qué es la orquestación en LLM?
La orquestación de LLM implica gestionar e integrar múltiples Large Language Models (LLMs) para realizar tareas complejas de manera eficiente. Garantiza la interacción entre models, flujos de trabajo, fuentes de datos y pipelines, optimizando el rendimiento como un sistema unificado. Las organizaciones utilizan la orquestación de LLM para tareas como la generación de lenguaje natural, la traducción automática, la toma de decisiones y los chatbots.
Aunque los LLMs poseen capacidades fundacionales sólidas, están limitados en el aprendizaje en tiempo real, la retención de contexto y la resolución de problemas de varios pasos. Además, gestionar múltiples LLMs a través de diversas APIs de proveedores añade complejidad de orquestación.
Los frameworks de orquestación de LLM abordan estos desafíos simplificando la ingeniería de prompts, las interacciones con APIs, la recuperación de datos y la gestión del estado. Estos frameworks permiten que los LLMs colaboren de manera eficiente, mejorando su capacidad de generar resultados precisos y conscientes del contexto.
¿Cuál es la mejor plataforma para la orquestación de LLM?
Los frameworks de orquestación de LLM pueden gestionar, coordinar y optimizar el uso de Large Language Models (LLMs) en diversas aplicaciones. Un sistema de orquestación de LLM permite la integración con diferentes componentes de IA, facilita la ingeniería de prompts, gestiona flujos de trabajo y mejora el monitoreo del rendimiento.
Son especialmente útiles para aplicaciones que involucran sistemas multiagente, generación aumentada por recuperación (RAG), IA conversacional y toma de decisiones autónoma.
Para facilitar la navegación, las herramientas se dividen en dos categorías:
1. Plataformas basadas en pasarelas
Las plataformas de pasarela son soluciones centradas en empresas que centralizan el acceso a los LLMs, aplican políticas de seguridad, gestionan el cumplimiento normativo y proporcionan monitoreo del uso. Estas plataformas son ideales para organizaciones que necesitan una implementación de LLM controlada, escalable y gobernada.
A continuación se presentan algunas de las pasarelas de IA y sus puntuaciones en GitHub:
Resultados del benchmark de pasarelas de IA
Nuestro benchmark utilizó la latencia del primer token (FTL) y la latencia total con salida de tokens para evaluar con qué eficiencia las pasarelas seleccionan proveedores y entregan respuestas. Estos son algunos de nuestros resultados:
- Mejores resultados:
- Groq: FTL más rápido en prompts largos (0.14 s) y baja latencia total (2.7 s) con 1.900 tokens
- SambaNova: Empató en el FTL más rápido en prompts cortos (0.13 s) y la segunda latencia total más baja (3 s) produciendo la mayor cantidad de tokens (1.997)
- Resultados moderados:
- OpenRouter: FTL de 0.40–0.45 s, latencia total de 25 s en prompts largos, salida de tokens moderada
- TogetherAI: FTL de 0.43–0.45 s, latencia total de 11 s con 1.812 tokens
- Peor resultado: IA/ML API, el FTL más alto (0.84–0.90 s) y la latencia total más alta (13 s), a pesar de una salida de tokens moderada.
Para más detalles y metodología, consulte nuestro artículo de benchmark de pasarelas de IA.
A continuación se muestra una lista de plataformas basadas en pasarelas para la orquestación de LLM, ordenadas alfabéticamente:
Bifrost de Maxim IA
Bifrost es una pasarela de IA que unifica el acceso a más de 15 proveedores de LLM a través de una única OpenAI-compatible API, con soporte para failover automatizado, balanceo de carga y políticas de gobernanza centralizadas.
Característica única: Integración de Model Context Protocol (MCP), que permite streaming, monitoreo basado en plugins y analítica para LLMs de múltiples proveedores.
Cloudflare IA Gateway
Cloudflare IA Gateway es un proxy de inference de IA y una plataforma de orquestación que proporciona acceso a múltiples large language models, ofreciendo facturación unificada, monitoreo de costes y características de resiliencia automatizadas para cargas de trabajo técnicas de IA.
Característica única: Failover multiproveedor y almacenamiento en búfer de streaming en el edge, que protege las respuestas de streaming de aplicaciones de larga duración frente a desconexiones al almacenar en caché la salida de inference directamente en la red global de Cloudflare.
Kong
Kong IA Gateway es una pasarela de IA semántica que centraliza y asegura el tráfico de LLM, permitiendo a las organizaciones integrar, gobernar y monitorear múltiples models de IA para el cumplimiento y el seguimiento de recursos.
Característica única: Seguridad semántica de prompts, incluida la sanitización de PII y plantillas de prompts avanzadas para proteger información confidencial.
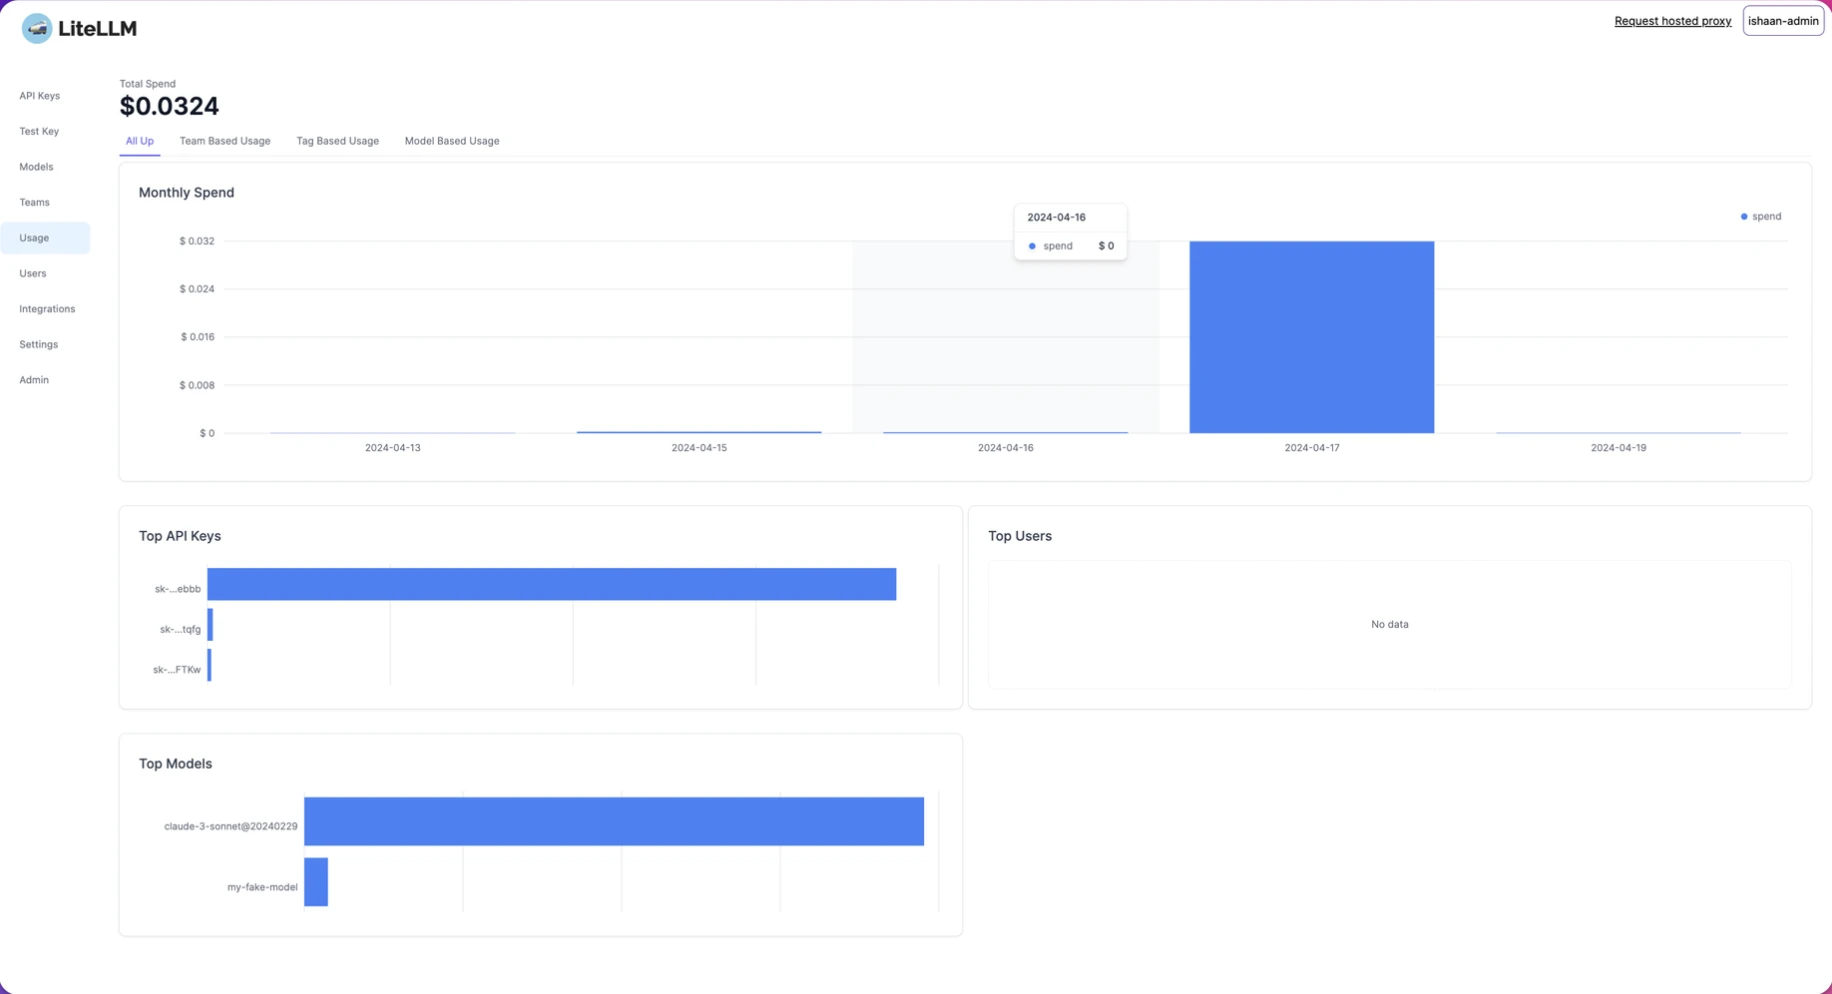
LiteLLM
LiteLLM proporciona acceso a múltiples LLMs a través de una interfaz unificada, ofreciendo tanto un servidor proxy (LLM Gateway) como un SDK de Python para la gestión centralizada y la observabilidad del sistema.
Característica única: Integración del SDK de Python para la gestión y observabilidad programática de LLM, lo que permite a los desarrolladores integrar controles de IA centralizados directamente en el código.
Prisma AIRS IA Gateway (Formerly Portkey)
Prisma AIRS IA es una pasarela de IA y una plataforma de orquestación que conecta a los desarrolladores con múltiples LLMs, con soporte para enrutamiento programático, failover, monitoreo de costes y funciones de implementación para equipos técnicos de IA.
Característica única: Soporte multimodal de LLM, incluidos models de texto, imagen, audio y visión con capacidades de fine-tuning para una mayor consistencia de la salida.
2. Frameworks para desarrolladores
Los frameworks para desarrolladores están diseñados para ingenieros y desarrolladores de IA que desean un control total sobre la construcción y orquestación de flujos de trabajo de LLM. Proporcionan SDKs, APIs y módulos prediseñados para encadenar models, gestionar prompts y manejar interacciones multi-LLM.
A continuación se muestra la lista completa de herramientas de orquestación de LLM para desarrolladores y sus estrellas en GitHub en orden alfabético:
Resultados del benchmark
Principales hallazgos del benchmark de frameworks de orquestación:
- LangGraph: Se ejecuta más rápido con la gestión de estado más eficiente
- LangChain: Consume más tokens debido a un manejo más pesado de memoria e historial
- AutoGen: Tiene un desempeño moderado con un comportamiento de coordinación consistente
- CrewAI: Experimenta los mayores retrasos debido a la deliberación autónoma antes de las llamadas a herramientas.
Para conocer la metodología y un análisis más detallado del benchmark, consulte el benchmark de orquestación agéntica.
Las herramientas que se explican a continuación se enumeran en orden alfabético:
Agency Swarm
Agency Swarm es un framework de sistema multiagente (MAS) que proporciona herramientas para construir, orquestar y gestionar enjambres de agentes de IA, utilizando el SDK de agentes de OpenAI.
Características clave:
- Soporta la coordinación multiagente, lo que permite que múltiples agentes de IA intercambien datos y ejecuten flujos de trabajo de forma concurrente.
- Incluye herramientas de simulación y visualización que ayudan a probar y monitorear las interacciones de los agentes en un entorno simulado.
- Permite interacciones de IA basadas en el entorno, ya que los agentes de IA pueden responder dinámicamente a condiciones cambiantes.
AutoGen
AutoGen, desarrollado por Microsoft, es un framework de orquestación multiagente de código abierto que simplifica la automatización de tareas de IA mediante agentes conversacionales.
Características clave:
- Framework de conversación multiagente que permite a los agentes de IA comunicarse y coordinar tareas.
- Funciona con múltiples proveedores de models, incluidos OpenAI y Azure
- Arquitectura modular y configurable, una configuración personalizable para diversas aplicaciones de IA.
crewAI
crewAI es un framework multiagente de código abierto. Permite que los agentes de IA de juego de roles colaboren en tareas estructuradas.
Características clave:
- Automatización de flujos de trabajo basada en agentes que asigna a los agentes de IA roles específicos en la ejecución de tareas.
- Soporta tanto usuarios técnicos como no técnicos
- Versión empresarial (crewAI+) disponible
Haystack
Haystack es un framework de Python de código abierto que permite la creación flexible de pipelines de IA mediante un enfoque basado en componentes. Soporta aplicaciones de recuperación de información y de preguntas y respuestas.
Características clave:
- Diseño de sistemas de IA basado en componentes que es un enfoque modular para ensamblar funciones de IA.
- Integración con bases de datos vectoriales y proveedores de LLM que permite trabajar con diversos almacenes de datos y models de IA.
- Soporta búsqueda semántica y extracción de información, permitiendo búsquedas avanzadas y recuperación de conocimiento.
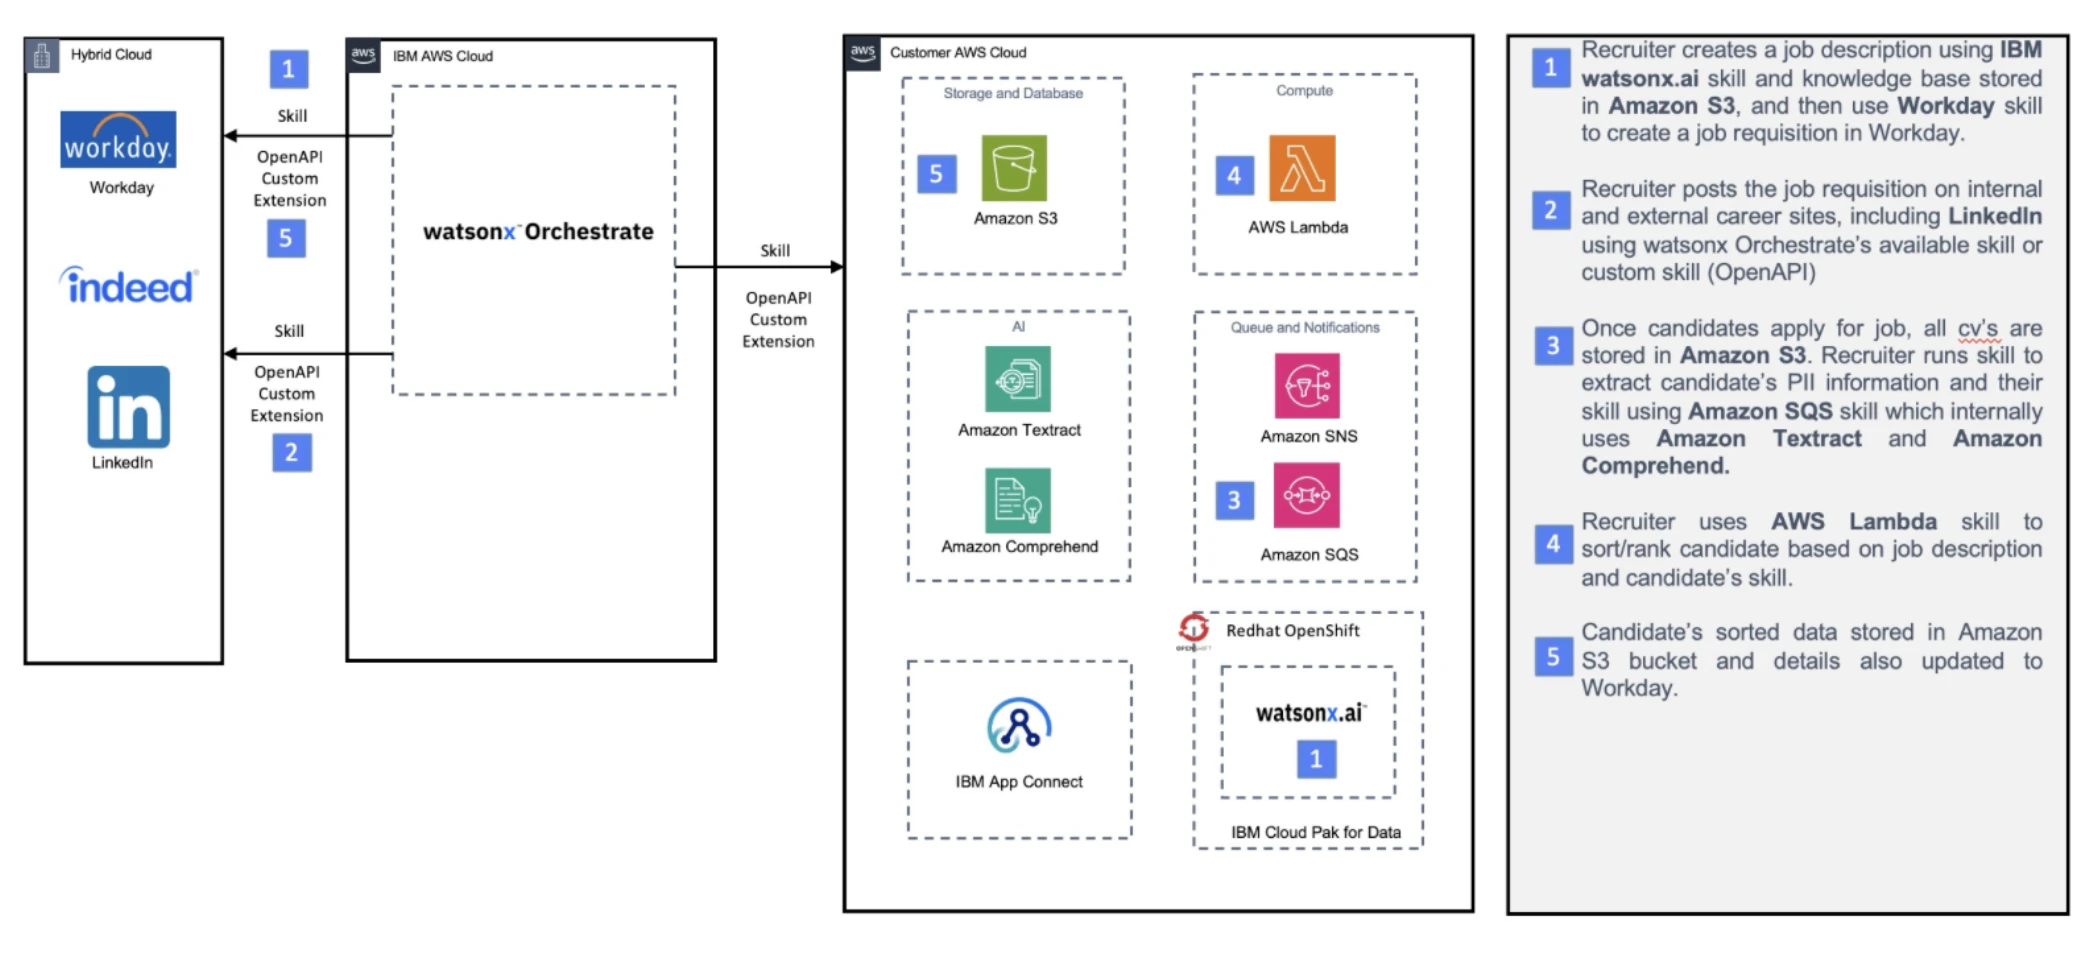
IBM watsonx orchestrate
IBM watsonx orchestrate es un framework propietario de orquestación de IA que utiliza procesamiento de lenguaje natural (NLP) para automatizar flujos de trabajo empresariales.
Características clave:
- Automatización de flujos de trabajo impulsada por IA que puede automatizar procesos empresariales repetitivos mediante IA.
- Aplicaciones y conjuntos de habilidades prediseñados, que proporcionan herramientas de IA listas para usar en diferentes industrias.
- Integración centrada en la empresa, conectando con software y flujos de trabajo empresariales existentes.
LangChain
LangChain es un framework de Python de código abierto para crear aplicaciones de LLM, centrado en el aumento de herramientas y la orquestación de agentes. Proporciona interfaces para embedding models, LLMs y almacenes vectoriales.
Características clave:
- RAG soporte
- Integración con múltiples componentes de LLM
- Framework ReAct para razonamiento y acción
LlamaIndex
LlamaIndex es un framework de integración de datos de código abierto diseñado para crear aplicaciones de LLM aumentadas por contexto. Permite recuperar fácilmente datos de múltiples fuentes.
Características clave:
- Conectores de datos para más de 160 fuentes, lo que permite que la IA acceda a diversos datos estructurados y no estructurados.
- Soporte de generación aumentada por recuperación (RAG)
- Conjunto de módulos de evaluación para el seguimiento del rendimiento
LOFT
LOFT, desarrollado por Master of Code Global, es un Large Language Model-Orchestrator Framework diseñado para optimizar las interacciones con clientes impulsadas por IA. Utiliza una arquitectura basada en colas diseñada para gestionar solicitudes concurrentes e implementaciones multiusuario.
Características clave:
- Agnóstico de framework: Se integra en cualquier sistema backend sin dependencias de frameworks HTTP.
- Prompts calculados dinámicamente: Soporta prompts generados de forma personalizada para interacciones personalizadas con los usuarios.
- Detección y manejo de eventos: Incluye mecanismos integrados para detectar y gestionar eventos basados en chat, incluido el filtrado de alucinaciones.
Microchain
Microchain es un framework de orquestación de LLM ligero y de código abierto conocido por su simplicidad, pero no recibe mantenimiento activo.
Características clave:
- Soporte de razonamiento en cadena de pensamiento que ayuda a la IA a descomponer problemas complejos paso a paso.
- Enfoque minimalista para la orquestación de IA.
Orq IA
Orq es una plataforma de colaboración de IA generativa y una herramienta de LLMOps diseñada para gestionar el ciclo de vida de implementación de aplicaciones de LLM. Proporciona funciones para que equipos técnicos y no técnicos construyan, implementen y monitoreen funcionalidades de IA.
Características clave:
- Orquestación serverless de LLM: Proporciona infraestructura de implementación mediante una API unificada, con enrutamiento integrado, control de versiones, fallbacks y reintentos.
- Observabilidad y evaluación: Ofrece monitoreo en tiempo real, trazas, registros y evaluadores personalizados para garantizar el rendimiento y la calidad de salida de los LLM.
- Pasarela de IA y RAG: Otorga acceso de punto único a múltiples models de IA y herramientas para construir pipelines de generación aumentada por recuperación (RAG).
Semantic Kernel
Semantic Kernel (SK) es un framework de orquestación de IA de código abierto de Microsoft. Ayuda a los desarrolladores a integrar large language models (LLMs) como GPT de OpenAI con la programación tradicional para crear aplicaciones impulsadas por IA.
Características clave:
- Gestión de memoria y contexto: SK permite almacenar y recuperar interacciones pasadas, ayudando a mantener el contexto a lo largo de las conversaciones.
- Embeddings y búsqueda vectorial: Soporta búsquedas basadas en embeddings, lo que lo hace compatible con casos de uso de generación aumentada por recuperación (RAG).
- Soporte multimodal: Funciona con texto, código, imágenes y más.
Cómo elegir el framework de orquestación de LLM adecuado
El número de estrellas en GitHub puede indicar popularidad, pero la elección ideal depende de varios factores, incluida la experiencia técnica de su equipo, la escala del proyecto, el presupuesto y las integraciones deseadas.
Tenga en cuenta la experiencia técnica del equipo:
- Para equipos altamente técnicos, como desarrolladores y científicos de datos que necesitan un control granular y flexibilidad, frameworks como LangChain, AutoGen y LlamaIndex son excelentes opciones. Son code-first y requieren un sólido conocimiento de Python y de los principios de la IA.
- Para usuarios de negocio o equipos con preferencia low-code/no-code, las plataformas centradas en interfaces declarativas son más adecuadas. Loft y crewAI ofrecen flujos de trabajo simplificados, lo que permite la creación rápida de prototipos sin una codificación extensa.
Revise la escala del proyecto:
- Para sistemas multiagente complejos, los frameworks diseñados específicamente para este propósito, como AutoGen, crewAI o Agency Swarm, proporcionan la arquitectura necesaria para que los agentes se comuniquen y colaboren.
- Para aplicaciones empresariales de misión crítica a gran escala que requieren alto rendimiento, seguridad y soporte dedicado, las soluciones propietarias como IBM watsonx orchestrate suelen ser la opción preferida.
- Para aplicaciones ligeras de prueba de concepto (POC), un framework minimalista puede ser suficiente, ya que su simplicidad reduce la sobrecarga.
Piense en las restricciones presupuestarias:
- Los frameworks de código abierto como LangChain y Haystack son gratis de usar, pero conllevan los “costes ocultos” de la infraestructura en la nube, el mantenimiento y un equipo especializado.
- Las soluciones propietarias pueden ofrecer una estructura de precios predecible que incluye soporte y pueden ser más rentables para organizaciones sin un equipo de MLOps dedicado.
Tenga en cuenta su stack tecnológico existente.
- Si su empresa está invertida en un ecosistema específico, eliminar los frameworks que no pueden funcionar con ese ecosistema es un paso útil. Por ejemplo, Semantic Kernel para entornos de Microsoft o Haystack para aplicaciones centradas en la recuperación de documentos pueden proporcionar integración.
¿Cómo funcionan las herramientas de orquestación de LLM?
Los frameworks de orquestación de LLM gestionan la interacción entre los diferentes componentes de las aplicaciones impulsadas por LLM, asegurando flujos de trabajo estructurados y una ejecución eficiente. La capa de orquestación desempeña un papel central en la coordinación de procesos como la gestión de prompts, la asignación de recursos, el preprocesamiento de datos y las interacciones entre models.
Capa de orquestación
La capa de orquestación actúa como el sistema de control central dentro de una aplicación impulsada por LLM. Gestiona las interacciones entre varios componentes, incluidos LLMs, plantillas de prompts, bases de datos vectoriales y agentes de IA. Al supervisar estos elementos, la orquestación garantiza un rendimiento cohesivo en diferentes tareas y entornos.
Tareas clave de orquestación
Gestión de cadenas de prompts
- El framework estructura y gestiona las entradas de los LLM (prompts) para optimizar la salida.
- Proporciona un repositorio de plantillas de prompts, lo que permite una selección dinámica basada en el contexto y las entradas del usuario.
- Secuencia los prompts de forma lógica para mantener flujos de conversación estructurados.
- Evalúa las respuestas para refinar la calidad de la salida, detectar inconsistencias y garantizar el cumplimiento de las directrices.
- Se pueden implementar mecanismos de verificación de hechos para reducir inexactitudes, y las respuestas marcadas se dirigen a revisión humana.
Gestión de recursos y rendimiento de LLM
- Los frameworks de orquestación monitorean el rendimiento de los LLM mediante pruebas de benchmark y paneles en tiempo real.
- Proporcionan herramientas de diagnóstico para el análisis de causa raíz (RCA) que facilitan la depuración.
- Asignan recursos computacionales de manera eficiente para optimizar el rendimiento.
Gestión y preprocesamiento de datos
- El orquestador recupera datos de fuentes específicas mediante conectores o APIs.
- El preprocesamiento convierte los datos brutos a un formato compatible con los LLMs, garantizando la calidad y relevancia de los datos.
- Refina y estructura los datos para mejorar su idoneidad para el procesamiento por parte de diferentes algoritmos.
Integración e interacción de LLM
- El orquestador inicia las operaciones de los LLM, procesa la salida generada y la enruta al destino apropiado.
- Mantiene almacenes de memoria que mejoran la comprensión contextual al preservar las interacciones previas.
- Los mecanismos de retroalimentación evalúan la calidad de la salida y refinan las respuestas basándose en datos históricos.
Medidas de observabilidad y seguridad
- El orquestador soporta herramientas de monitoreo para rastrear el comportamiento del model y garantizar la fiabilidad de la salida.
- Implementa frameworks de seguridad para mitigar los riesgos asociados con salidas no verificadas o inexactas.
Mejoras adicionales
Integración de flujos de trabajo
- Incorpora herramientas, tecnologías o procesos en los sistemas operativos existentes para mejorar la eficiencia, la coherencia y la productividad.
- Garantiza transiciones fluidas entre diferentes proveedores de models manteniendo la calidad de los prompts y de la salida.
Cambio de proveedores de models
- Algunos frameworks permiten cambiar de proveedor de models con cambios mínimos, reduciendo la fricción operativa.
- Actualizar las importaciones de proveedores, ajustar los parámetros del model y modificar las referencias de clase facilitan las transiciones.
Gestión de prompts
- Mantiene la coherencia en la creación de prompts y ayuda a los usuarios a iterar y experimentar de manera más productiva.
- Se integra con pipelines de CI/CD para optimizar la colaboración y automatizar el seguimiento de cambios.
- Algunos sistemas rastrean automáticamente las modificaciones de los prompts, lo que ayuda a detectar impactos inesperados en la calidad de los prompts.
Patrón emergente: ingeniería de contexto
A medida que evoluciona la orquestación de LLM, ha surgido una nueva disciplina: la ingeniería de contexto. Se centra en optimizar qué información se incluye en la entrada de un LLM, especialmente al combinar recuperación en tiempo real, interacciones pasadas y memoria para mejorar la calidad y eficiencia de las respuestas.
Esta práctica puede enmarcarse como un patrón de orquestación, donde el contexto se convierte en un recurso gestionado que se recupera, filtra y moldea con precisión para ajustarse a la intención del usuario y a los límites de tokens.
Los elementos clave de este patrón de orquestación incluyen:
- Context broker: Una unidad centralizada en la capa de orquestación que recopila y normaliza entradas de memoria, módulos de recuperación e interacciones recientes. Garantiza la coherencia en todos los flujos de trabajo conscientes del contexto.
- Módulos y rutas: Componentes especializados (como resumidores, motores de recuperación o búsquedas en memoria) se activan selectivamente mediante mecanismos dinámicos de despacho de herramientas según la naturaleza de la consulta del usuario o el estado del sistema.
- Context packing: El contenido recuperado y recordado se clasifica, comprime y organiza en prompts estructurados. Este empaquetado selectivo garantiza que la información de alto valor encaje dentro de la ventana de entrada del LLM sin exceder las restricciones de tokens.
- Guardrails y adaptación: Las restricciones integradas pueden imponer respuestas solo de recuperación, y las actualizaciones de la memoria a largo plazo aseguran que el sistema refine la selección de contexto.
Este patrón es cada vez más esencial en sistemas que utilizan generación aumentada por recuperación (RAG), colaboración multiagente y copilotos impulsados por LLM, donde cada consulta debe activar los módulos correctos y mostrar la información más relevante.
 Añadir como fuente preferida
4 prácticas recomendadas de orquestación de LLM
1-Comience con una arquitectura modular sólida
- Descomposición de tareas: Defina claramente su flujo de trabajo y divida el problema en pasos pequeños, distintos y comprobables. Diseñe su pipeline de modo que las funciones clave (por ejemplo, la creación de prompts, el acceso a la memoria, la lógica avanzada) estén aisladas en sus propios módulos.
- Diseño iterativo: Comience con el prototipo funcional más simple (un “producto mínimo viable”) y añada complejidad de forma incremental. Valide que cada paso, desde la recuperación de datos hasta la salida final, funcione de forma aislada antes de integrarlo en una cadena compleja.
2-Enrutamiento y selección dinámica de models
- Optimice coste y velocidad: Evite utilizar el LLM más caro y grande para cada tarea. Implemente en el orquestador la lógica para enrutar consultas simples (como clasificación o resumen) a models más baratos y pequeños, y reserve los models de primer nivel para razonamientos complejos o análisis de varios pasos.
- Agnosticismo de proveedor: Estructure su capa de orquestación para permitir un cambio fácil entre proveedores de models (por ejemplo, OpenAI, Anthropic, Google) para mitigar la dependencia de un proveedor, gestionar los límites de tasa de las API y aprovechar los models con mejor rendimiento a medida que evoluciona el mercado.
3-Implemente observabilidad y monitoreo sólidos
- Registre todo: Registre las entradas y salidas de cada paso de la cadena, no solo el resultado final. Esto es crucial para depurar flujos conversacionales de varios pasos y realizar análisis de causa raíz (RCA) de errores.
- Monitoree métricas clave: Monitoree la latencia, el rendimiento, el consumo de tokens (para control de costes) y las tasas de error de los models en tiempo real. Deben configurarse alertas automáticas para marcar de inmediato picos de alucinaciones o fallos.
4-Compruebe la gobernanza y las guardrails de seguridad
- Comprobaciones previas y posteriores al procesamiento: Envuelva todas las llamadas a LLM con guardrails. Use comprobaciones previas al procesamiento (por ejemplo, filtrado de contenido, listas negras de temas no permitidos) en la entrada del usuario y comprobaciones posteriores al procesamiento (por ejemplo, verificación del formato de salida estructurado, comprobaciones de seguridad) en la respuesta del model antes de la entrega.
- Cumplimiento normativo: Para datos sensibles, implemente capas de permisos, anonimización y cifrado desde el principio del diseño para mantener el cumplimiento (por ejemplo, HIPAA, GDPR).
4 desafíos de orquestación de LLM y estrategias de mitigación
Estos son algunos problemas asociados con la orquestación de LLM y los métodos para abordarlos: desafíos centrales en la orquestación multi-LLM
1.Coordinación y bloqueos de flujo de trabajo
Debido a la naturaleza no determinista de los LLM, definir transiciones claras entre roles especializados de LLM es difícil. Esto da lugar a solapamiento de tareas (uso redundante de tokens) o bloqueos de flujo de trabajo (una instancia de LLM espera indefinidamente una salida ambigua de otra).
Mitigue con flujo de trabajo estructurado y comunicación
- Utilice un controlador de flujo de trabajo para descomponer el objetivo en un grafo acíclico dirigido (DAG) de subtareas.
- Imponga un protocolo de comunicación Pydantic/JSON para todas las transferencias de tareas. Esto obliga al LLM a generar datos legibles por máquina y validados por esquema, lo que hace que las señales de progreso sean inequívocas y evita ciclos.
2. Deriva contextual e inconsistencia de memoria
La ventana de contexto fija de los LLM y su falta de estado inherente los hacen propensos a la deriva contextual, donde un rol de LLM olvida el objetivo general o hechos previos cruciales. En una configuración multi-LLM, esto crea decisiones conflictivas y salidas generales inconsistentes.
Mitigue utilizando una base de conocimiento externalizada con RAG
- Implemente un sistema de memoria externa (base de datos vectorial o grafo de conocimiento). Los roles especializados de LLM registran hechos, decisiones y salidas clave como datos estructurados. Cuando una instancia de LLM necesita contexto, utiliza generación aumentada por recuperación (RAG) para consultar esta fuente externa, asegurando que recupera la información más relevante y no redundante.
3. Salida no determinista y alucinación en cascada
La salida probabilística de los LLM significa que las respuestas no son fiables. Cuando una instancia de LLM (el productor) fabrica información (alucina), una instancia de LLM posterior (el consumidor) la trata como un hecho, lo que conduce a un fallo en cascada completo del flujo de trabajo multi-LLM.
Mitigue con mecanismos de consenso y validación
- Emplee un patrón de consenso para salidas críticas. El controlador de flujo de trabajo enruta la salida inicial a un rol secundario de validador de LLM o a una base de datos/API externa para verificación de hechos. El flujo de trabajo continúa si la salida se verifica correctamente, mitigando eficazmente el riesgo de los errores no deterministas del model.
4. Contención de recursos y sobrecoste
Escalar flujos de trabajo multi-LLM genera una alta demanda de la LLM API (un recurso costoso y limitado por tasa). Esto da lugar a fallos por límite de tasa (limitación de la API) y a un consumo masivo de tokens (sobrecoste) por trabajo redundante o bucles.
Mitigue con encolado asíncrono y guardrails de presupuesto
- Utilice una cola de tareas asíncrona (por ejemplo, Celery) con un limitador de tasa para controlar la concurrencia de ejecución de llamadas a la API.
- Implemente herramientas de observabilidad para rastrear el uso de tokens por tarea y establezca presupuestos automáticos de tokens (interruptores de circuito) que terminen o pausen cualquier instancia de LLM descontrolada, gestionando el coste operativo en tiempo real.
¿Es la orquestación un componente clave de LLM?
Sí. La orquestación es un componente clave en los sistemas basados en LLM, pero no es un componente central del model como los pesos del model o el tokenizador. En cambio, es una capacidad a nivel de sistema que hace que los LLM sean utilizables en aplicaciones del mundo real.
Entre los componentes esenciales, la orquestación suele situarse junto a:
- LLM model: Un Large Language Model (LLM) procesa grandes cantidades de datos para comprender y generar texto similar al humano. Los models de código abierto ofrecen flexibilidad, mientras que los de código cerrado proporcionan facilidad de uso y soporte. Los LLMs de propósito general manejan diversas tareas, mientras que los models específicos de dominio atienden a industrias especializadas.
- Prompts: Los prompts eficaces guían las respuestas de los LLM.
- Prompts zero-shot: Generan respuestas sin ejemplos previos.
- Prompts few-shot: Utilizan algunas muestras para refinar la precisión. Obtenga más información sobre el aprendizaje por prompting few-shot y otros métodos de fine tuning de LLM.
- Prompts de cadena de pensamiento: Fomentan el razonamiento lógico para obtener mejores respuestas.
- Base de datos vectorial: Almacena datos estructurados como vectores numéricos. Los LLMs utilizan búsquedas por similitud para recuperar el contexto relevante, mejorando la precisión y evitando respuestas obsoletas.
- Obtenga más información sobre bases de datos vectoriales y LLMs, herramientas de bases de datos vectoriales de código abierto y casos de uso de bases de datos vectoriales.
- Agentes y herramientas: Amplían las capacidades de los LLM ejecutando búsquedas web, código o consultando bases de datos. Mejoran la automatización impulsada por IA y las soluciones empresariales.
- Orquestador (capa de control): Integra LLMs, prompts, bases de datos vectoriales y agentes en un sistema cohesivo. Garantiza una coordinación fluida para aplicaciones eficientes impulsadas por IA.
- Monitoreo: Rastrea el rendimiento, detecta anomalías y registra interacciones. Garantiza respuestas de alta calidad y ayuda a mitigar errores en las salidas de los LLM.
Cita esta investigación
Elige el formato que se ajuste al lugar donde vas a publicar. Pegar la versión con enlace en tu CMS conserva el enlace de retroceso.
@misc{simsek2026,
  author = {Şimşek, Hazal},
  title  = {{LLM Orquestación: 21 frameworks y pasarelas}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/llm-orchestration}},
  note   = {AIMultiple. Recuperado el 21 de octubre de 2026}
}Resultados y marcas de tiempo de 206 puntos de datos. Descargue los datos resumidos que se muestran en los gráficos y las tablas de este artículo como un archivo ZIP que contiene 5 archivos CSV.
¿Quieres los datos granulares que hay detrás? Únete a Premium
Registro de cambios
9 actualizacionesSe eliminó la sección de preguntas frecuentes y la entrada Nexos.ai de la lista de gateways de IA.
Se añadieron resultados de benchmark a la introducción y a una nueva sección.
Se amplió la sección "Herramientas de orquestación de LLM" con una nueva categorización de herramientas en "Plataformas basadas en pasarela" y "Marcos de desarrollo."
Enlaces de referencia
Siguiente para leer
Densidad de inteligencia de 71 LLMs para modelos más inteligentes y densos
LLM Motores de Inferencia: vLLM vs LMDeploy vs SGLang


Los 10+ mejores frameworks y herramientas de orquestación agéntica

Simulación de audiencia: ¿Pueden los LLMs predecir el comportamiento humano?


Benchmark de 90+ LLMs en Finanzas: Claude Opus 5.5 y Gemini 4 Argon
Comparativa de las 10 mejores plataformas de orquestación de servicios





Sé el primero en comentar
Tu dirección de correo electrónico no será publicada. Todos los campos son obligatorios. Los comentarios se dejan en su idioma original.