


Comparativa de modelos de IA multimodal en razonamiento visual

Evaluamos 40 modelos de IA multimodal líderes en razonamiento visual usando 200 preguntas visuales. La evaluación constó de dos bloques: 100 preguntas de comprensión de gráficos que ponen a prueba la interpretación de visualizaciones de datos, y 100 preguntas de lógica visual que evalúan el reconocimiento de patrones y el razonamiento espacial.
Benchmark de razonamiento visual
Consulte nuestra metodología de benchmark para conocer nuestros procedimientos de prueba.
Todos los modelos obtienen peor puntuación en lógica visual que en gráficos. La diferencia es menor en qwen3.8-flash (58 % frente a 78 %) y mayor en claude-sonnet-4.5 (35 % frente a 77 %).
- gemini-4-argon obtiene la puntuación más alta en ambas categorías: 62 % en lógica visual y 87 % en comprensión de gráficos. También ocupa el primer puesto global con 74,5 %, 1 punto por delante de gemini-3.7-flash y claude-opus-5.5 (73,5 % cada uno). Eso supone una diferencia de 2 preguntas sobre 200, por lo que los tres primeros están separados por pocas preguntas entre sí.
- gemini-3.5-flash-lite (36,5 %) y llama-4-maverick (38,5 %) ocupan los últimos puestos globales debido a la lógica visual. Responden correctamente al 22 % y al 19 % de estas preguntas, y claude-haiku-4.5 responde al 20 %. Los tres están cerca del 20 % que otorga la respuesta aleatoria con cinco opciones. En gráficos, estos mismos tres modelos también ocupan los últimos puestos, con un 51 % a 61 %.
Comparativa de coste & latencia
Preguntas del benchmark sobre dónde los LLM destacan y más fallan
Pregunta de gráficos con la tasa de éxito más baja de los LLM
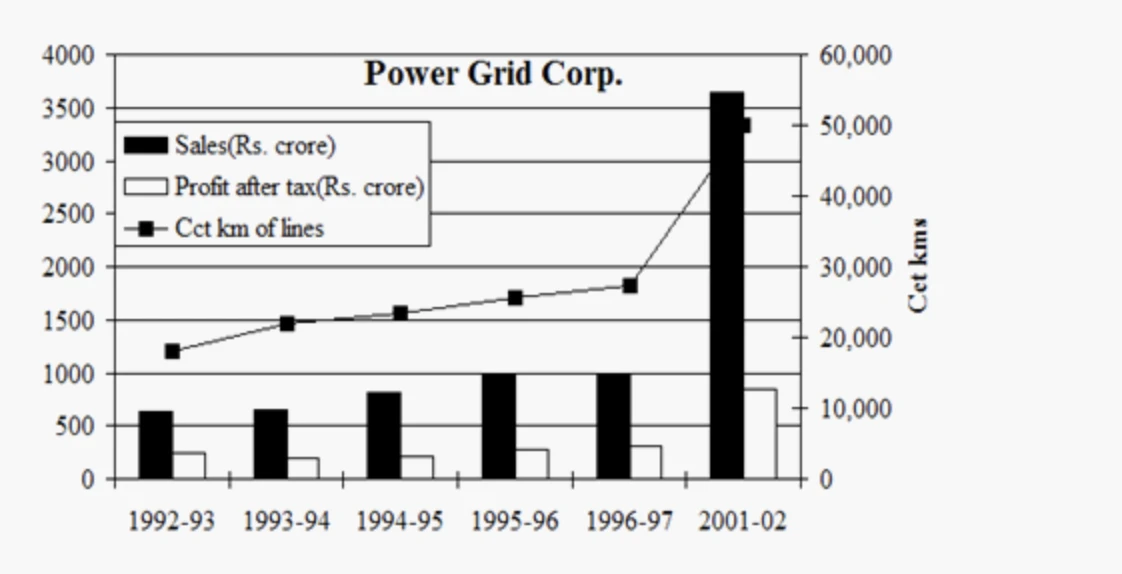
Figura 1: Gráfico de barras de Power Grid Corp. que muestra las ventas (barras negras) y el beneficio después de impuestos (barras blancas) de 1992-93 a 1996-97 y 2001-02, con una línea para los kilómetros de circuito de líneas en un segundo eje y.
Nota: Todos los gráficos se obtuvieron de Hitbullseye.1
Pregunta: La rentabilidad (beneficio / ventas) es más alta en: A. 1992-93 B. 1993-94 C. 2001-02 D. 1996-97
Ninguno de los 40 modelos respondió correctamente (la respuesta es D, 1996-97), y 38 de ellos eligieron 1992-93. El cálculo es una sola división por año, por lo que la dificultad está en leer el gráfico.
Las barras de beneficio son pequeñas y blancas, de solo unos cientos de crore en un eje de 0-4.000 con líneas de cuadrícula cada 500. Las diferencias entre años se reducen a unos pocos píxeles. El segundo eje y y la línea superpuesta añaden ruido visual. Los modelos tenían que comparar estas barras blancas cortas con barras negras mucho más altas, y bastaba un pequeño error al leer la altura de las barras para cambiar la respuesta.
Pregunta de gráficos con la tasa de éxito más alta de los LLM
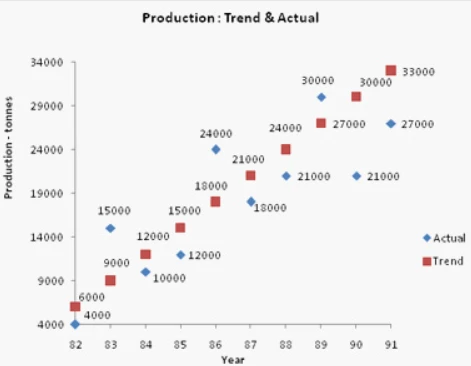
Figura 2: Diagrama de dispersión que muestra la producción real y la tendencia (en toneladas) de 1982 a 1991. Los rombos azules marcan los valores reales, los cuadrados rojos marcan los valores de tendencia y cada punto está etiquetado con su valor.
Pregunta: La tendencia se ha establecido como: A. La producción de este año es una vez y media la del año pasado. B. La producción de este año es el doble que la del año pasado. C. La producción de este año es tres mil toneladas mayor que la del año pasado. D. La producción de este año es cuatro mil quinientas toneladas mayor que la del año pasado.
Todos los modelos respondieron correctamente a esta pregunta. Los puntos de la tendencia aumentan la misma cantidad cada año (6.000, 9.000, 12.000 y así sucesivamente hasta 33.000). Como cada punto lleva su valor como etiqueta, los modelos podían leer las cifras directamente en lugar de estimar posiciones respecto al eje.
El gráfico de Power Grid requería comparar las alturas de barras pequeñas. Aquí no hace falta estimar alturas: las etiquetas dan valores exactos y el único paso restante es una simple resta.
Pregunta de lógica visual con la tasa de éxito más alta de los LLM
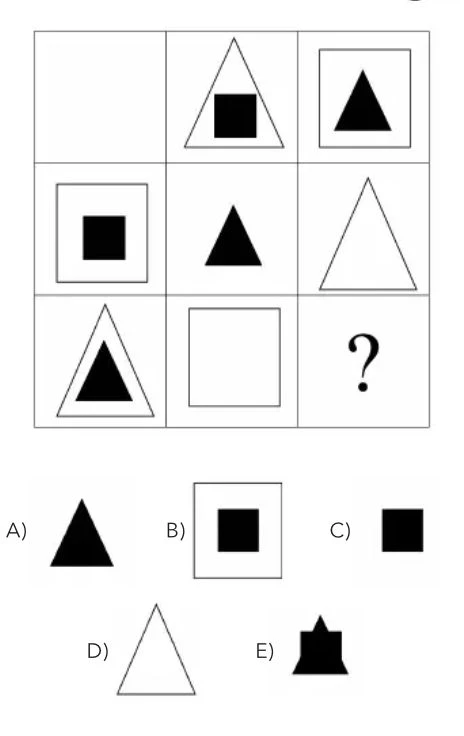
Figura 4: Una cuadrícula de 3×3 en la que cada celda contiene un triángulo o un cuadrado blanco o negro, solos o anidados unos dentro de otros. Falta la celda inferior derecha y se ofrecen cinco opciones.
Pregunta: ¿Qué opción completa la cuadrícula?
38 de los 40 modelos respondieron correctamente (la respuesta es C, un cuadrado negro). Solo claude-haiku-4.5 y llama-4-maverick fallaron. Cada fila y columna contiene un triángulo blanco, un cuadrado blanco, un triángulo negro y un cuadrado negro exactamente una vez. Por tanto, la pieza que falta se puede encontrar enumerando lo que ya está presente.
En la cuadrícula de hexágonos, la regla dependía de cómo se dividían las formas en regiones. Aquí cada elemento es una forma separada y claramente dibujada que los modelos pueden identificar y contar.
Pregunta de lógica visual con la tasa de éxito más baja de los LLM
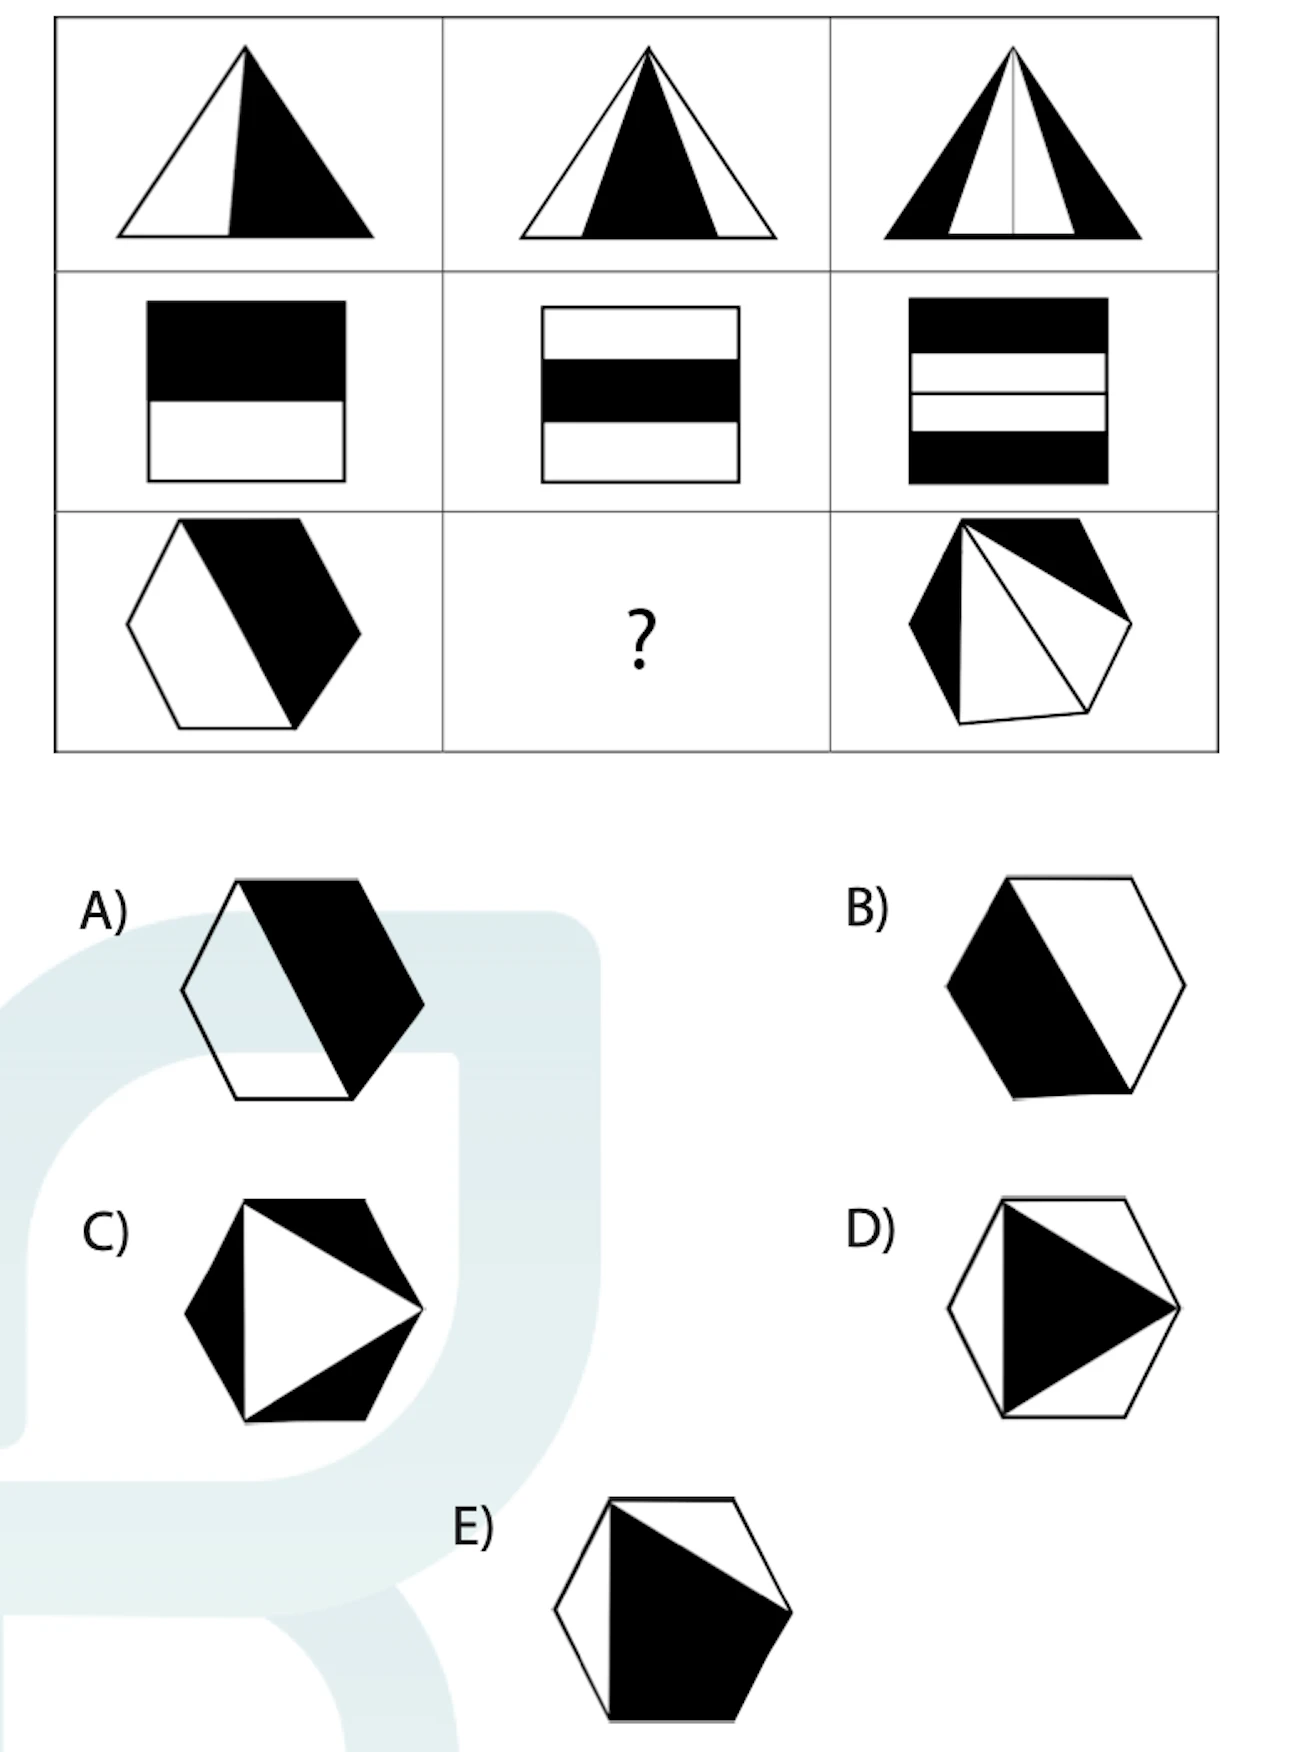
Figura 3: Una cuadrícula de formas de 3×3: triángulos en la primera fila, rectángulos en la segunda y hexágonos en la tercera. Cada forma está dividida en regiones negras y blancas, y falta el hexágono central. Se ofrecen cinco hexágonos como opciones.
Pregunta: ¿Qué opción completa la cuadrícula?
Ninguno de los 40 modelos respondió correctamente. La pregunta no tiene números ni cálculos; la única tarea es ver cómo cambian las regiones negras y blancas en cada fila.
Metodología del benchmark
Evaluamos 40 modelos con capacidad de visión en 200 preguntas de opción múltiple basadas en imágenes.
- Razonamiento: Cada modelo se configuró con el máximo esfuerzo de razonamiento que admite (max, xhigh o high, según el modelo). En algunos modelos no se aceptó ningún parámetro de esfuerzo de razonamiento, por lo que se aplicó el valor predeterminado del proveedor:
- gemini-3.1-pro-preview, gemini-3.6-flash, gemini-3.7-flash, gemini-3.8-flash, gpt-5.2-pro y qwen3.8-flash seguían razonando de forma predeterminada. claude-haiku-4.5 y gemini-3.5-flash-lite no produjeron tokens de razonamiento. kimi-k2.5 razonó solo en 34 de sus 200 llamadas.
- Temperatura: No se configuró, por lo que se aplicó el valor predeterminado de cada proveedor.
- Tokens máximos: Se configuró en 1.000.000 para que la longitud de salida no limitara el razonamiento. Si un proveedor rechazaba este valor, se utilizaba el límite máximo de salida propio del modelo.
- Ejecuciones: Cada pregunta se ejecutó una vez por modelo, con un total de 7.600 llamadas.
- Reintentos: Las llamadas fallidas se reintentaron hasta 3 veces, con 60 segundos de separación. En 4 preguntas de lógica visual, muse-wonder nunca devolvió una respuesta: su proveedor cerró la conexión después de aproximadamente 6.5 minutos en cada intento. Estas 4 preguntas cuentan como incorrectas, por lo que no se excluyó ninguna pregunta.
- Coste y latencia: El coste es el coste facturado que la pasarela comunicó en cada llamada. La latencia es la duración de la llamada exitosa, excluyendo las esperas de reintento.
El benchmark consistió en 200 preguntas de dos categorías: comprensión de gráficos (100 preguntas) y lógica visual (100 preguntas). Las preguntas de gráficos envían el gráfico como imagen, con la pregunta y las opciones como texto. Las preguntas de lógica visual incluyen toda la pregunta, con las opciones, dentro de la imagen. La mayoría de las preguntas de gráficos tienen cuatro opciones (89 de 100), y el resto tienen cinco o menos. Las preguntas de lógica visual tienen cinco opciones (A-E).
Preguntas:
- Comprensión de gráficos (100 preguntas). Evaluamos la capacidad de los modelos para extract, interpretar y analizar información de visualizaciones de datos:
- Gráficos de barras (40): de barras simples, agrupadas y de doble eje
- Diagramas de dispersión (26): lectura de valores y tendencias a partir de puntos etiquetados
- Gráficos circulares (14): distribuciones porcentuales y razonamiento proporcional
- Gráficos de líneas (10): tendencias de series únicas y múltiples a lo largo del tiempo
- Visualizaciones combinadas (10): un gráfico mostrado junto con un segundo gráfico o una tabla de datos
- Lógica visual (100 preguntas). Evaluamos el razonamiento abstracto y la inteligencia espacial mediante:
- Reconocimiento de patrones: identificación de secuencias y completado de patrones visuales
- Razonamiento espacial: transformaciones de formas y superposición de figuras
- Lógica matemática: patrones numéricos, razonamiento algebraico y combinatoria
- Pensamiento abstracto: manipulación de símbolos, deducción lógica e inferencia de reglas
 Añadir como fuente preferida
Cita este benchmark
Elige el formato que se ajuste al lugar donde vas a publicar. Pegar la versión con enlace en tu CMS conserva el enlace de retroceso.
@misc{sipi2026,
  author = {Şipi, Nazlı},
  title  = {{Comparativa de modelos de IA multimodal en razonamiento visual}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/visual-reasoning}},
  note   = {AIMultiple. Recuperado el 14 de octubre de 2026}
}Resultados y marcas de tiempo de 22.9 mil puntos de datos. Descargue los datos resumidos que se muestran en los gráficos y las tablas de este artículo como un archivo ZIP que contiene 4 archivos CSV y un README.
¿Quieres los datos granulares que hay detrás? Únete a Premium
Registro de cambios
6 actualizacionesActualizado el número de modelos comparados en la sección de evaluación comparativa de razonamiento visual.
Se reemplazó la configuración del parámetro de tokens máximos en la metodología de Benchmark.
Enlaces de referencia




Sé el primero en comentar
Tu dirección de correo electrónico no será publicada. Todos los campos son obligatorios. Los comentarios se dejan en su idioma original.