


Meilleurs outils de web scraping IA évalués

Nous avons évalué les meilleurs outils de web scraping IA avec 25 000 requêtes, 5 000 par outil, sur 500 URL sur chacun des 10 domaines les plus visités pour observer leurs performances, et avons également comparé la manière dont chacun exploite l'IA.
Benchmark du web scraping IA
Consultez la section méthodologie du benchmark pour plus de détails sur le processus de test.
Comparaison de l'exhaustivité et de la précision
Pour chaque domaine, nous avons demandé les champs qui comptent sur ce type de page : le prix et la devise sur les pages e-commerce, le texte du post, les likes et l'auteur sur les pages sociales. Pour mesurer les performances de ces outils, nous avons utilisé trois indicateurs : le succès, l'exhaustivité et la précision. Trois sont nécessaires car un outil peut renvoyer quelque chose sans tout renvoyer, et tout renvoyer sans que rien ne soit correct.
Succès : la part des requêtes qui sont revenues avec au moins un des champs demandés.
Exhaustivité : la part des champs demandés qui sont effectivement revenus, en moyenne sur l'ensemble des requêtes.
Précision : la part des champs vérifiables qui sont revenus avec une valeur correcte, vérifiée par rapport à une référence ou au consensus des autres outils. Un champ qui n'est jamais revenu compte comme faux.
Méthodologie statistique
Les intervalles de confiance ont été calculés à l'aide du rééchantillonnage bootstrap par percentile :
Rééchantillons : 10 000
Niveau de confiance : 95 %
Unité de rééchantillonnage : URL, avec les cinq fournisseurs rééchantillonnés sur le même tirage
Indicateurs : taux de succès, exhaustivité, précision et temps de réalisation
Taille de l'échantillon : N = 5 000 URL par fournisseur (500 sur chacun des 10 domaines)
Les scores des domaines sont d'abord calculés, puis moyennés sur les dix domaines
Résultats du benchmark du web scraping IA
Sur 5 000 URL réparties sur les 10 domaines, nous avons appelé chaque outil selon la manière dont sa propre API est conçue. Bright Data, Apify et Firecrawl acceptent une liste d'URL en une seule requête, nous avons donc envoyé 100 URL par requête. Oxylabs et ScrapingBee acceptent une URL par requête, nous les avons donc envoyées une par une. La concurrence était la même pour tous les outils, cinq requêtes parallèles, de sorte que la seule différence réside dans ce que chaque API prend en charge.
- Bright Data a obtenu les meilleurs scores sur les trois mesures de qualité : 85 % de succès, 76 % d'exhaustivité, 60 % de précision.
- La précision la plus élevée obtenue a été de 60 %. Deux champs vérifiables sur cinq sont revenus manquants ou incorrects.
- L'exhaustivité variait de Bright Data à 76 % jusqu'à Apify à 32 %, avec Oxylabs à 59 %, Firecrawl à 53 % et Scraping Bee à 41 %.
- Firecrawl a été le plus rapide avec moins d'une demi-seconde par URL, contre Bright Data et ses 4,6 secondes, et 22 points de moins en précision. Oxylabs a été le plus lent avec 35 secondes.
Chaque fournisseur adopte une approche différente de l'IA, et notre objectif était de comparer ces approches et les compromis qu'elles impliquent.
Principales conclusions sur les outils de web scraping IA issues du benchmark
- Les échecs peuvent ressembler à des données. Lorsqu'un outil ne peut pas lire un prix, souvent parce que la page a rencontré un mur anti-bot, il peut renvoyer 0 au lieu d'un échec. Une valeur nulle peut être réessayée ou ignorée, mais un 0 passe la validation sans être remarqué. Apify et Oxylabs ont renvoyé null dans ces cas. La documentation de Firecrawl recommande d'ajouter « Renvoyer null s'il n'est pas trouvé sur la page » à chaque champ de schéma afin que le modèle ne devine pas une valeur.
- Champs supplémentaires : un prompt qui demande le prix et la devise peut également renvoyer la marque, la description ou des URL d'images. Un schéma limite la réponse aux champs que vous nommez. Bright Data verrouille le schéma de sortie au moment de la construction, de sorte que chaque appel renvoie les mêmes champs.
- Mauvais élément : sur les pages qui affichent un prix barré et un prix d'origine, des prix avec et sans taxe, ou des options de prix régionales, un outil peut extract le mauvais chiffre.
- Nombres modifiés : les outils de conversion prompt-vers-JSON peuvent ajouter des décimales, tronquer des valeurs ou renvoyer des approximations converties en devises qui n'apparaissent pas sur la page.
- La localisation modifie le prix : certains sites fixent les prix en fonction de la localisation IP du visiteur, de sorte qu'un outil utilisant des proxies américains voit un prix différent de celui d'un utilisateur européen.
Le schéma et la région du proxy sont les paramètres qui vous permettent de détecter la plupart de ces problèmes avant qu'ils n'atteignent vos données.
Tarifs des outils de web scraping IA
Kadoa n'apparaît pas dans le tableau des tarifs car il ne publie aucun prix. Kadoa propose une offre Flex basée sur la consommation et une offre Enterprise dont le prix est communiqué par l'équipe commerciale.
Comparaison des outils de web scraping IA
Temps jusqu'au premier scraper : Pour les outils qui construisent un scraper que vous appelez ensuite par identifiant, la durée de la configuration. « Appel HTTP unique » signifie qu'il n'y a aucune étape de construction.
Schéma de sortie défini par l'utilisateur : Indique si vous pouvez définir vous-même les champs de sortie et leurs types avant l'exécution du scraping, au lieu de les décrire dans un prompt et de laisser le LLM décider de la structure au moment de l'exécution.
Endpoint à construction unique et appels multiples : Indique si le scraper est construit une seule fois, stocké côté fournisseur, puis appelé avec une simple URL. Ici, le LLM (ou, pour les outils basés sur l'enregistrement, votre parcours de clics) s'exécute au moment de la construction et sa sortie est figée dans un scraper que vous possédez et pouvez modifier sur place, et auquel les planifications, webhooks et intégrations sont liés. Lorsque cela fait défaut, l'extraction est recalculée à chaque appel et la définition complète voyage avec chaque requête.
Scraper enregistré auto-réparant : Indique si un scraper enregistré est réparé lorsque le site cible change, sans avoir à le reconstruire de zéro. La correction s'applique au même scraper stocké sous son identifiant existant, de sorte que les déclencheurs, les planifications et les intégrations continuent de fonctionner.
* Kadoa stocke le scraper et l'appelle par identifiant, mais les URL cibles sont liées lors de la création du workflow. L'orienter vers une nouvelle URL nécessite une mise à jour distincte des métadonnées avant l'exécution.
Les outils qui exécutent un LLM sur la page à chaque appel ne sont pas comptés ici : il n'existe aucune logique d'extraction persistante à réparer, ce qui les rend tolérants aux changements de mise en page, mais signifie également qu'il n'y a aucun artefact à inspecter, versionner ou approuver. Les caches internes sans identifiant exploitable ne le sont pas non plus, car il n'y a là encore rien à inspecter, versionner ou approuver.
Au-delà des problèmes tels que les pages qui changent constamment, dans les pipelines agentiques, vous avez souvent besoin d'une simple API que vous pouvez appeler : fournissez une URL, récupérez des données structurées. Mais vous ne trouvez pas toujours une API de scraper prête pour chaque domaine que vous devez scraper régulièrement ; et quand c'est le cas, les champs souhaités peuvent ne pas s'y trouver, ou vous devez personnaliser le schéma selon vos besoins. Différentes approches permettent de résoudre ces problèmes.
Plateformes de web scraping IA à construction unique et appels multiples
Si vous construisez votre propre scraper, vous devez écrire le crawler, configurer les proxies, exécuter des navigateurs sans tête et gérer les files d'attente, les nouvelles tentatives et l'anti-bot vous-même.
Les outils de web scraping IA réduisent ce travail. Les plateformes à construction unique et appels multiples telles que Bright Data Scraper Studio, Browse IA et Kadoa construisent un scraper une seule fois, à partir d'un prompt ou d'un enregistrement de parcours de clics, et le stockent afin que vous puissiez l'appeler avec une URL.
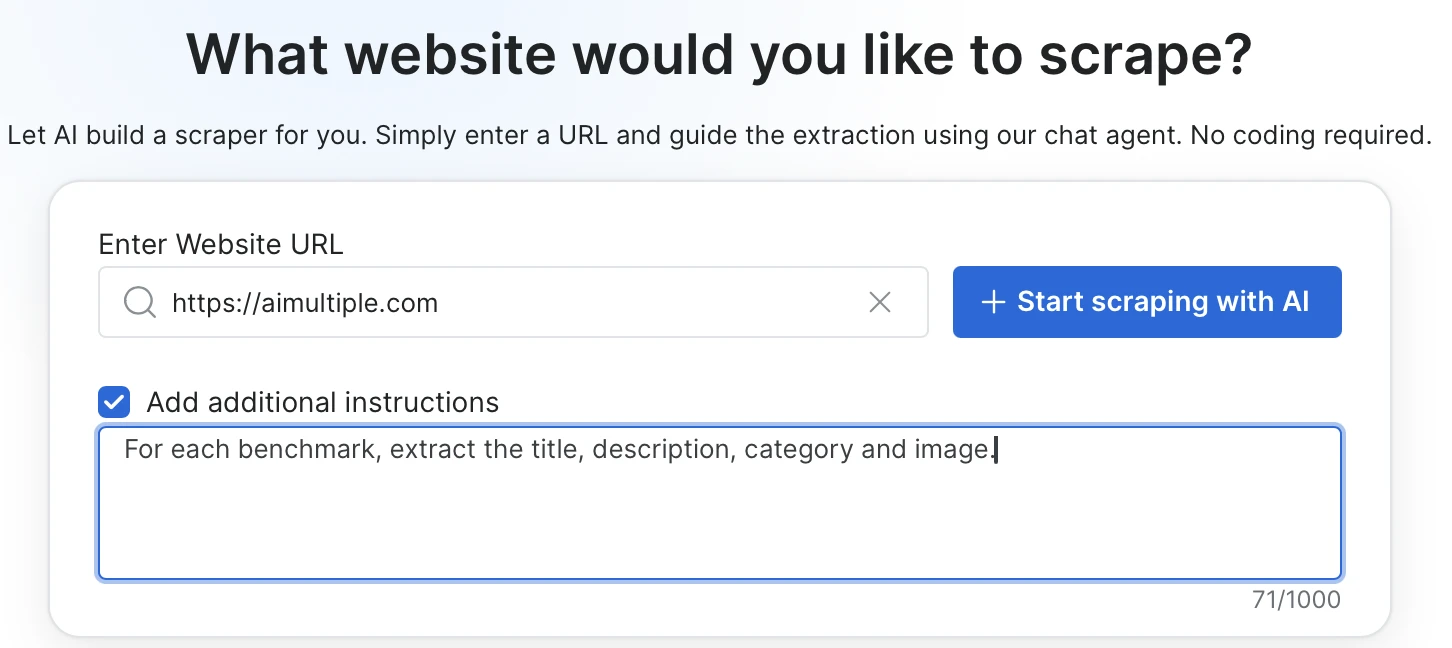
Bright Data Scraper Studio construit un scraper à partir d'un prompt, puis le met à disposition sous forme d'API stable. Après la configuration initiale, chaque appel ne prend qu'une URL.
Vous décrivez les champs que vous souhaitez extract en langage clair, et vous pouvez éventuellement ajouter des sélecteurs CSS, des actions requises sur la page ou le comportement de chargement de page.
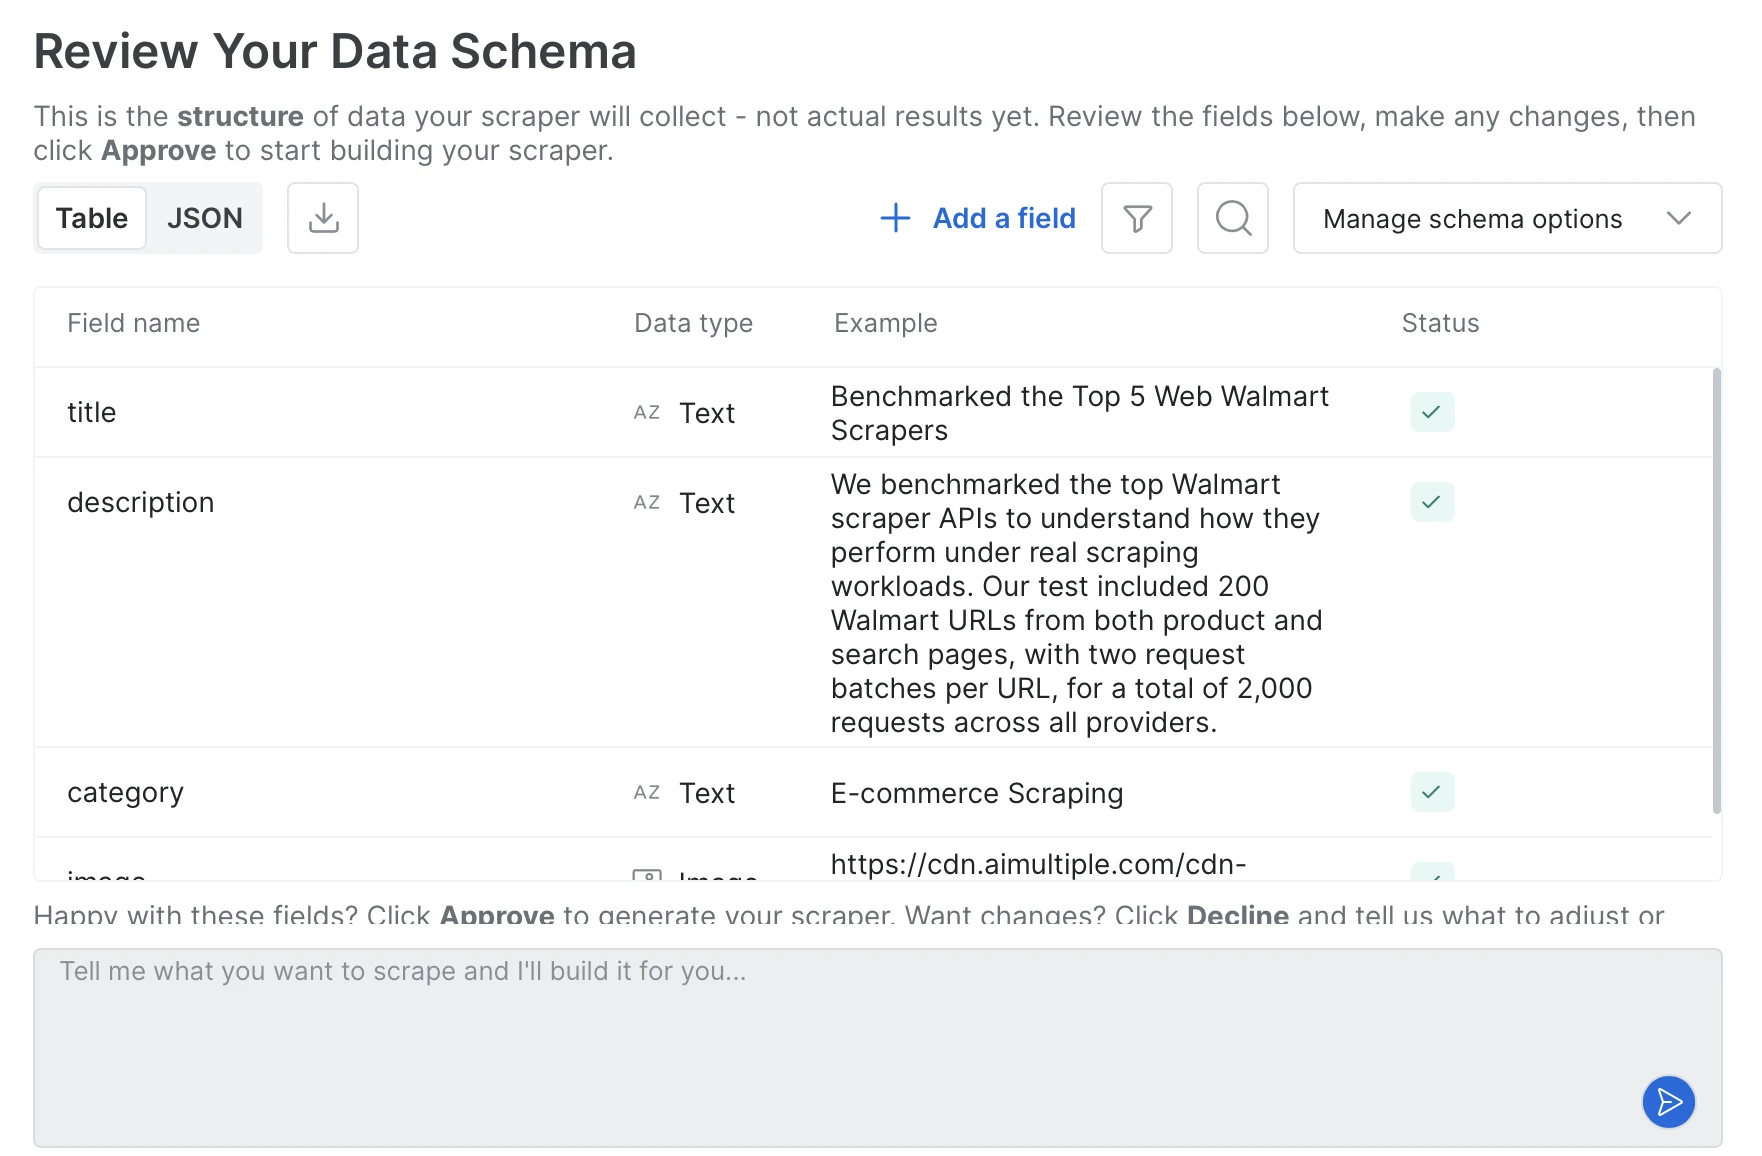
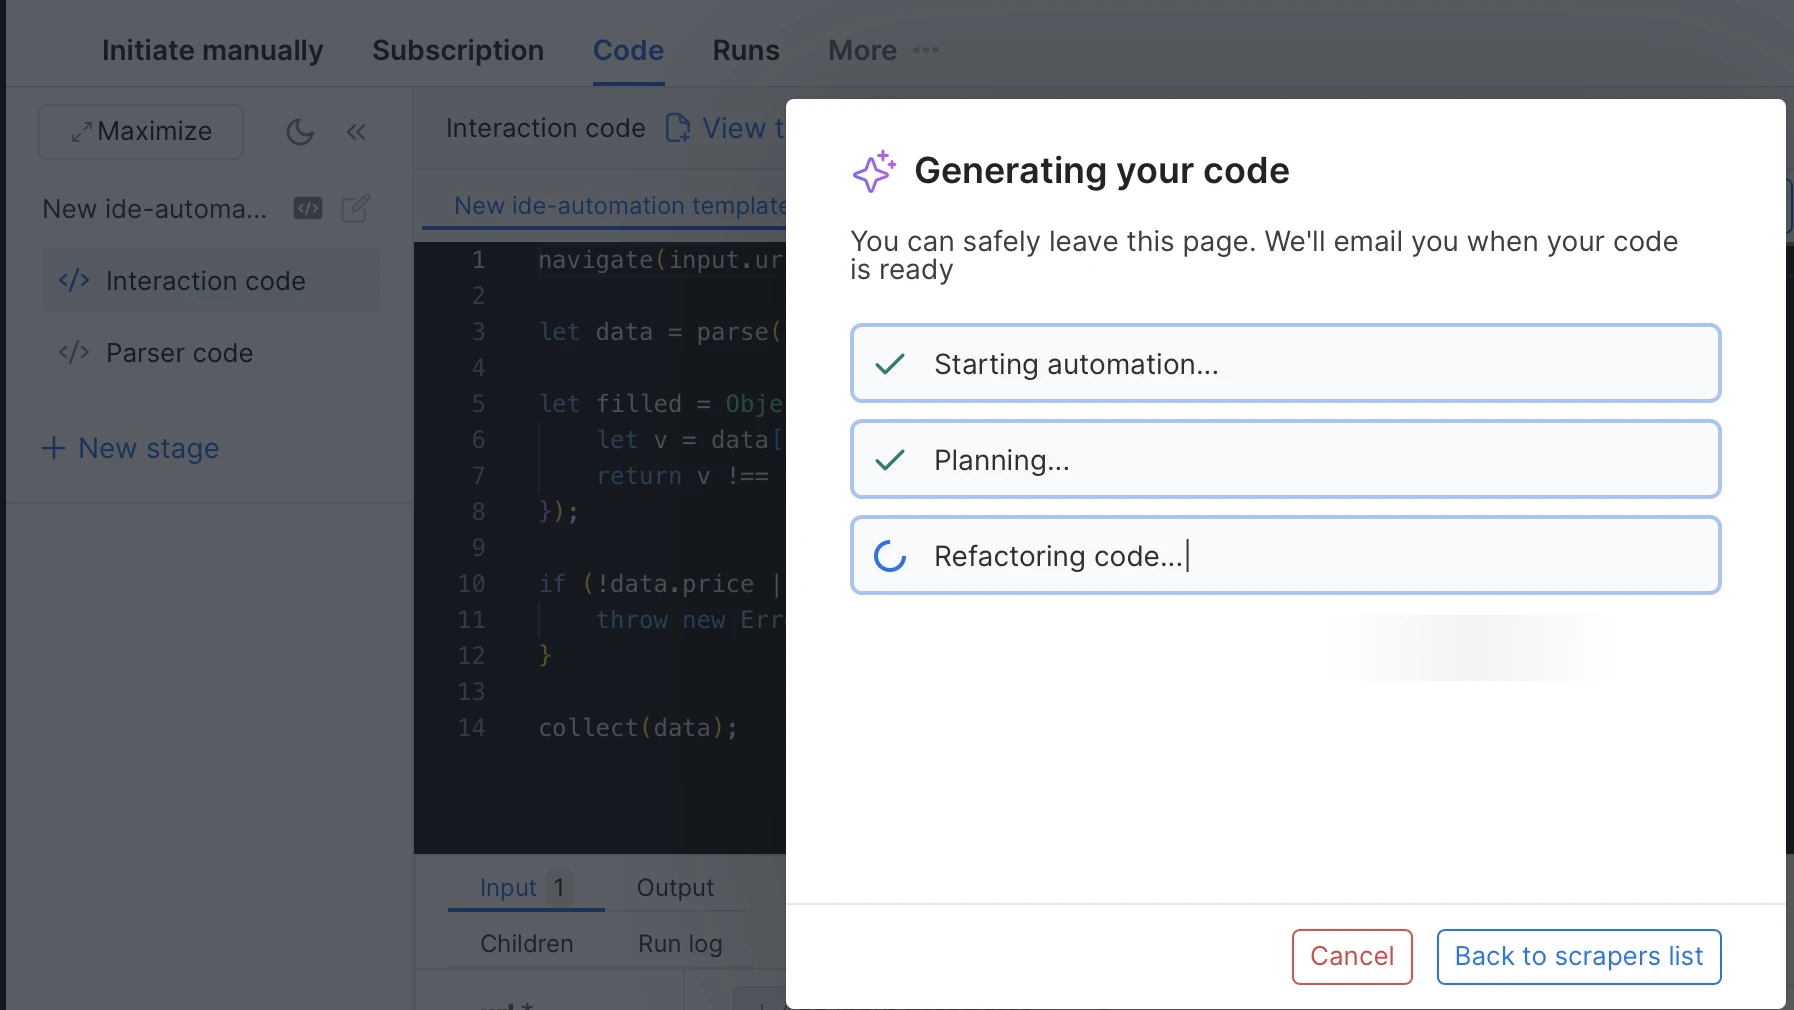
L'agent de Scraper Studio génère le schéma de sortie à partir du prompt. Vous examinez le schéma, ajoutez ou supprimez des champs ou modifiez les types, puis l'agent écrit le code du scraper.
- Endpoint à construction unique et appels multiples : Une fois le schéma approuvé, le scraper est enregistré comme un endpoint persistant avec un identifiant fixe. Chaque appel atteint le même endpoint avec une simple URL, et le schéma de sortie reste identique d'un appel à l'autre. Lors de nos tests, la construction d'un scraper dédié a pris environ 10 minutes en moyenne.
- Deux méthodes de construction : Vous pouvez discuter avec l'Agent dans le navigateur, ou utiliser la CLI Bright Data pour construire le scraper depuis votre terminal avec une seule commande qui prend une URL et un prompt. Les deux produisent le même scraper.
- Workflow avec agents de codage : Les commandes du terminal s'exécutent telles quelles dans Claude Code, Cursor et Codex, de sorte que l'agent peut construire, exécuter ou auto-réparer un scraper sans quitter l'éditeur. Vous pouvez également épingler l'identifiant du scraper dans le fichier de règles de l'agent afin que les sessions futures le réutilisent.
- Livraison : API, SDK, CLI, webhooks, ou livraison directe vers le stockage cloud sur S3, GCS, Azure ou OSS.
- Combiné avec des scrapers prêts à l'emploi : Bright Data maintient une bibliothèque de scrapers prêts pour les sites populaires comme Amazon, LinkedIn et Zillow.
Auto-réparation automatisée
Le Scraper Studio de Bright Data peut réparer seul un scraper enregistré. Nous l'avons testé sur des pages produit que nous hébergeons, en demandant le titre, le prix, la devise, le vendeur et la disponibilité. La première exécution a renvoyé des enregistrements avec 100 % de succès.
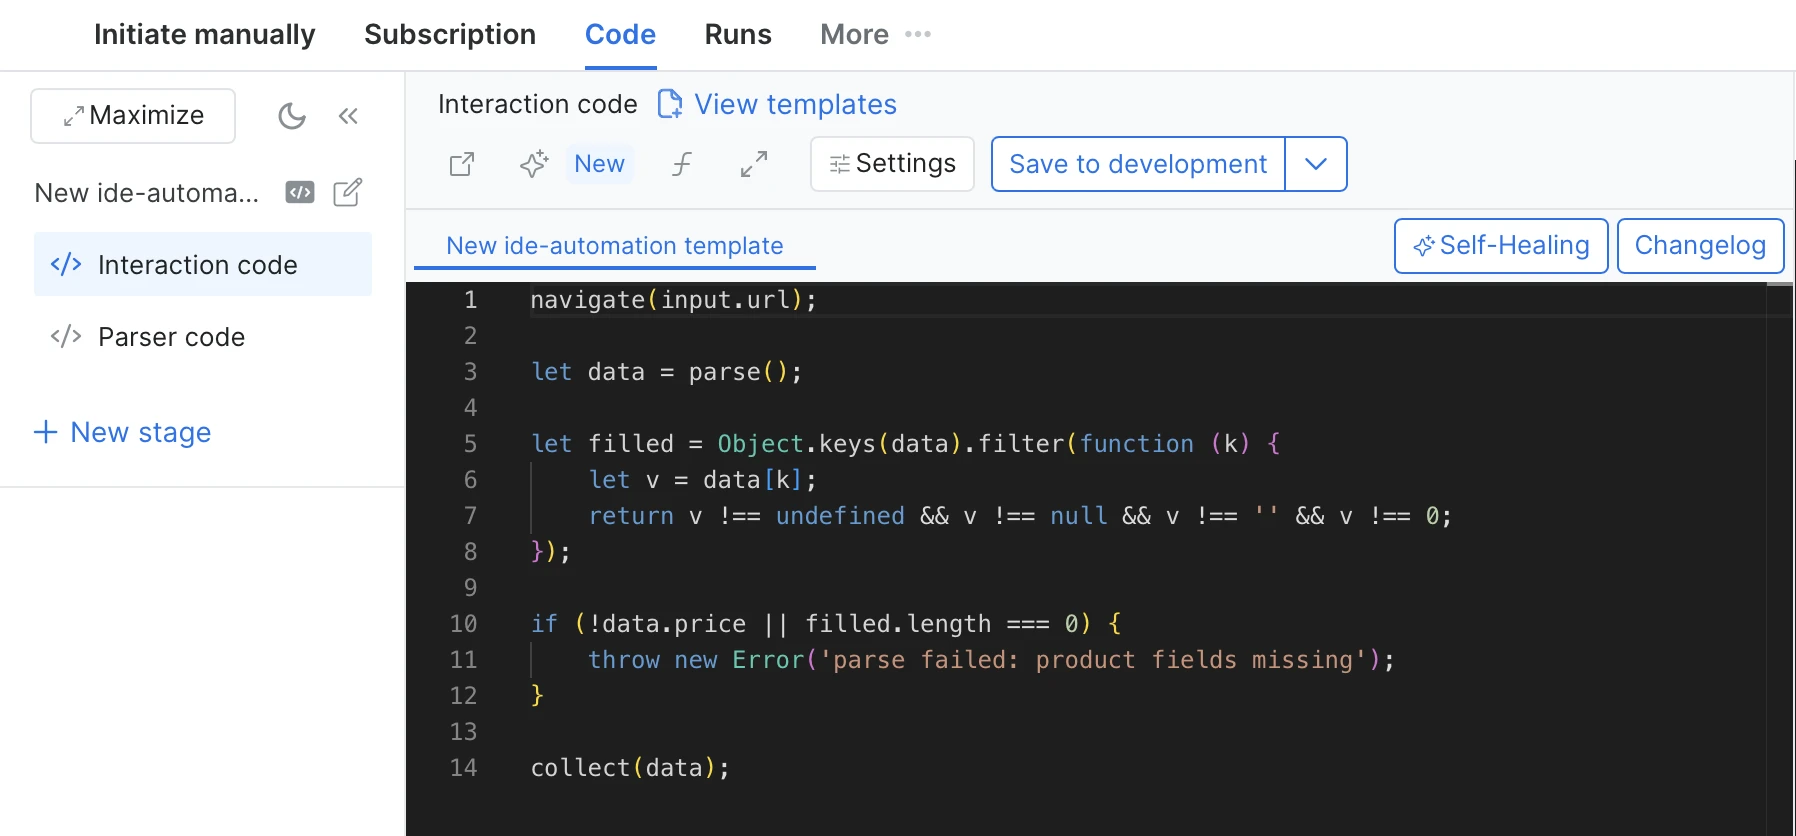
Nous avons ajouté une vérification au code généré. Si le prix est manquant, ou si aucun champ n'est renvoyé, l'exécution lève une exception au lieu de collecter un enregistrement vide.
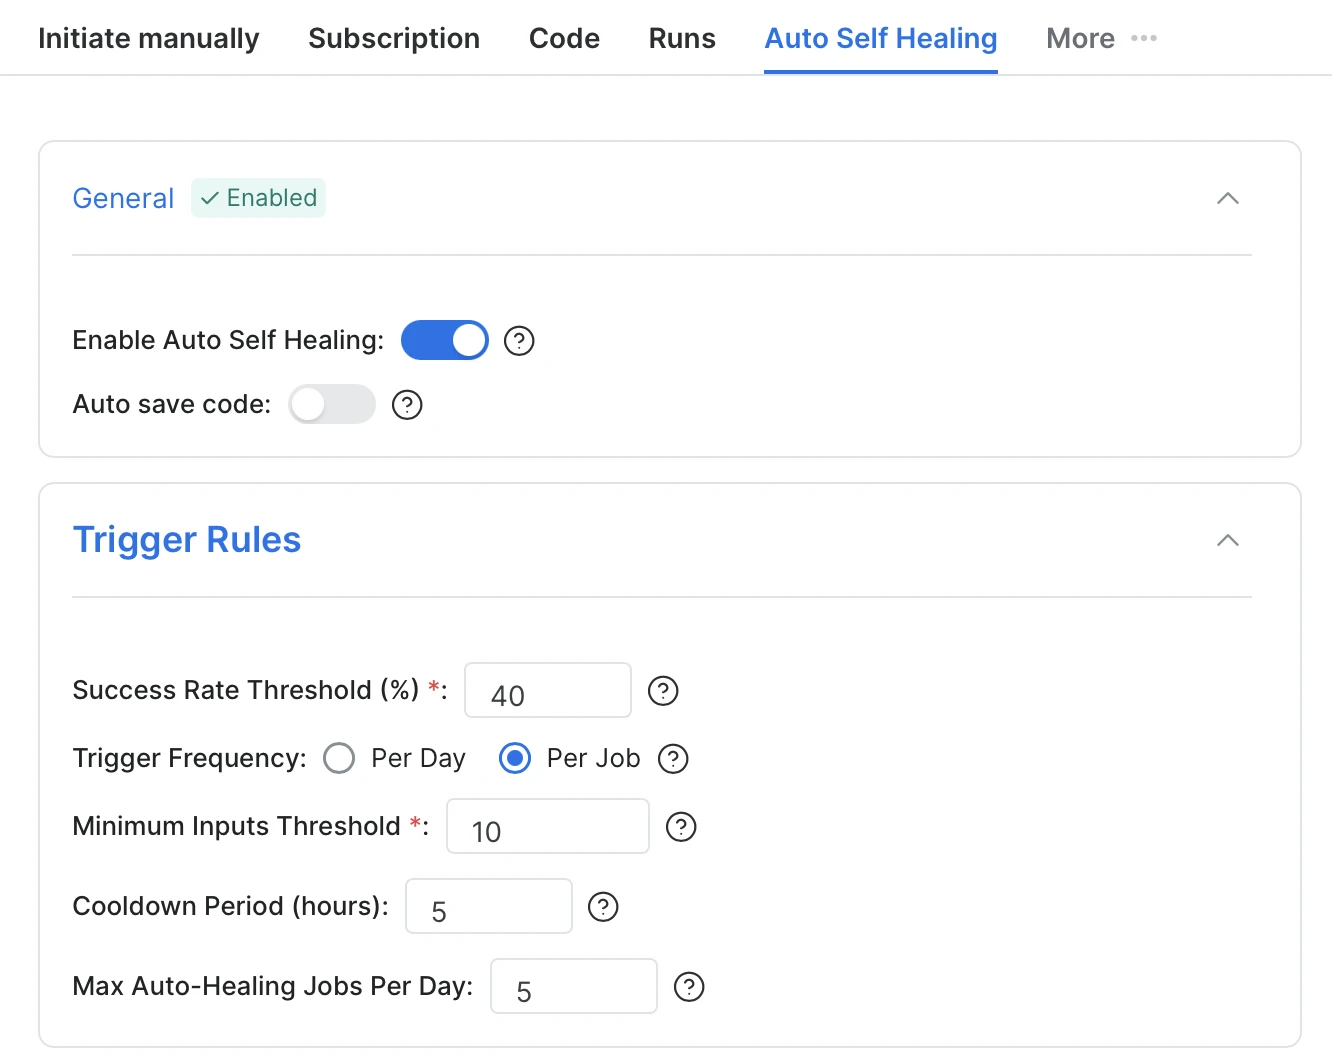
Nous avons activé l'auto-réparation automatique avec les règles de déclenchement par défaut : la réparation démarre lorsque le taux de succès tombe sous 40 %, vérifié après chaque tâche, sur des exécutions avec au moins 10 entrées. Nous avons laissé la sauvegarde automatique du code désactivée, afin que toute réécriture attende l'approbation.
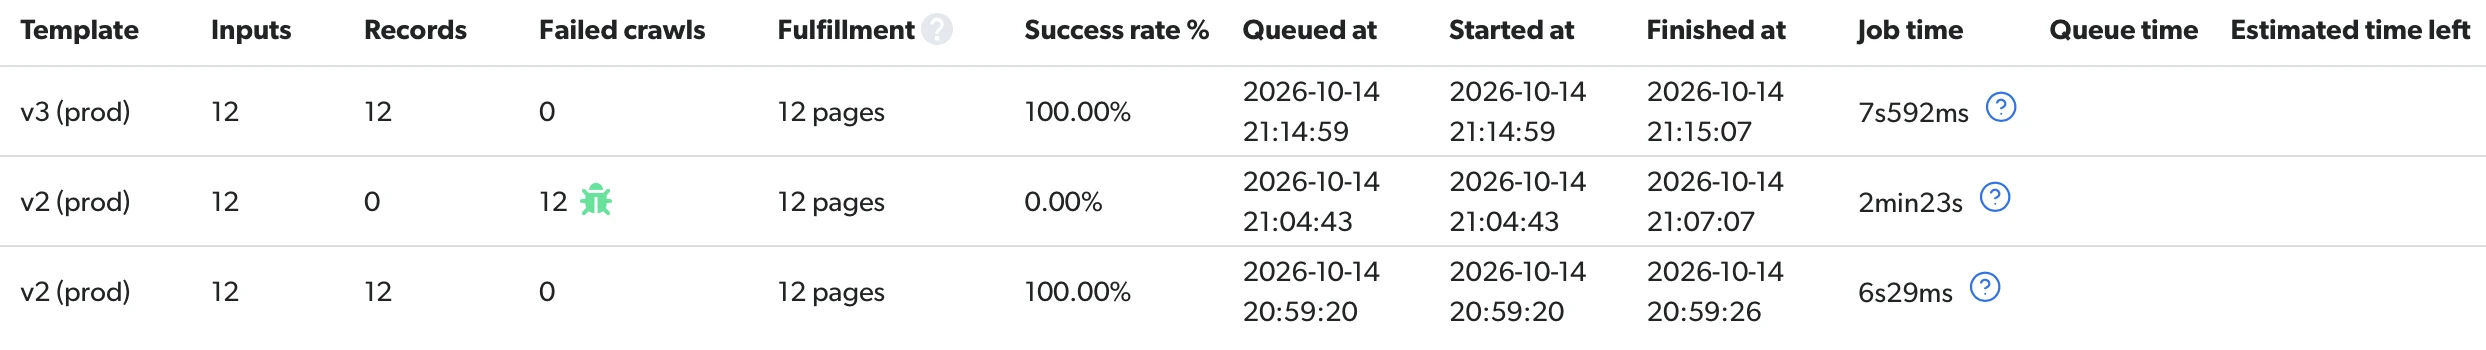
Nous avons ensuite redessiné les pages derrière les mêmes URL, en modifiant les balises et les noms de classe tout en laissant chaque valeur dans le HTML sous forme de texte brut. L'exécution suivante a signalé 12 crawls échoués et 0 % de succès, et la réparation a démarré sans que nous le demandions.
La version réparée a renvoyé tous les enregistrements avec 100 % de succès sur les mêmes URL.
Les mêmes URL ont obtenu 100 % sur la mise en page d'origine, 0 % après la refonte, puis 100 % après que l'auto-réparation a réécrit le collecteur.
C'est important pour les scrapers que vous conservez dans un pipeline : lorsque le site modifie sa mise en page, le scraper que vous avez construit se répare et reprend, tant que l'échec fait chuter le taux de succès sous le seuil que vous avez défini.
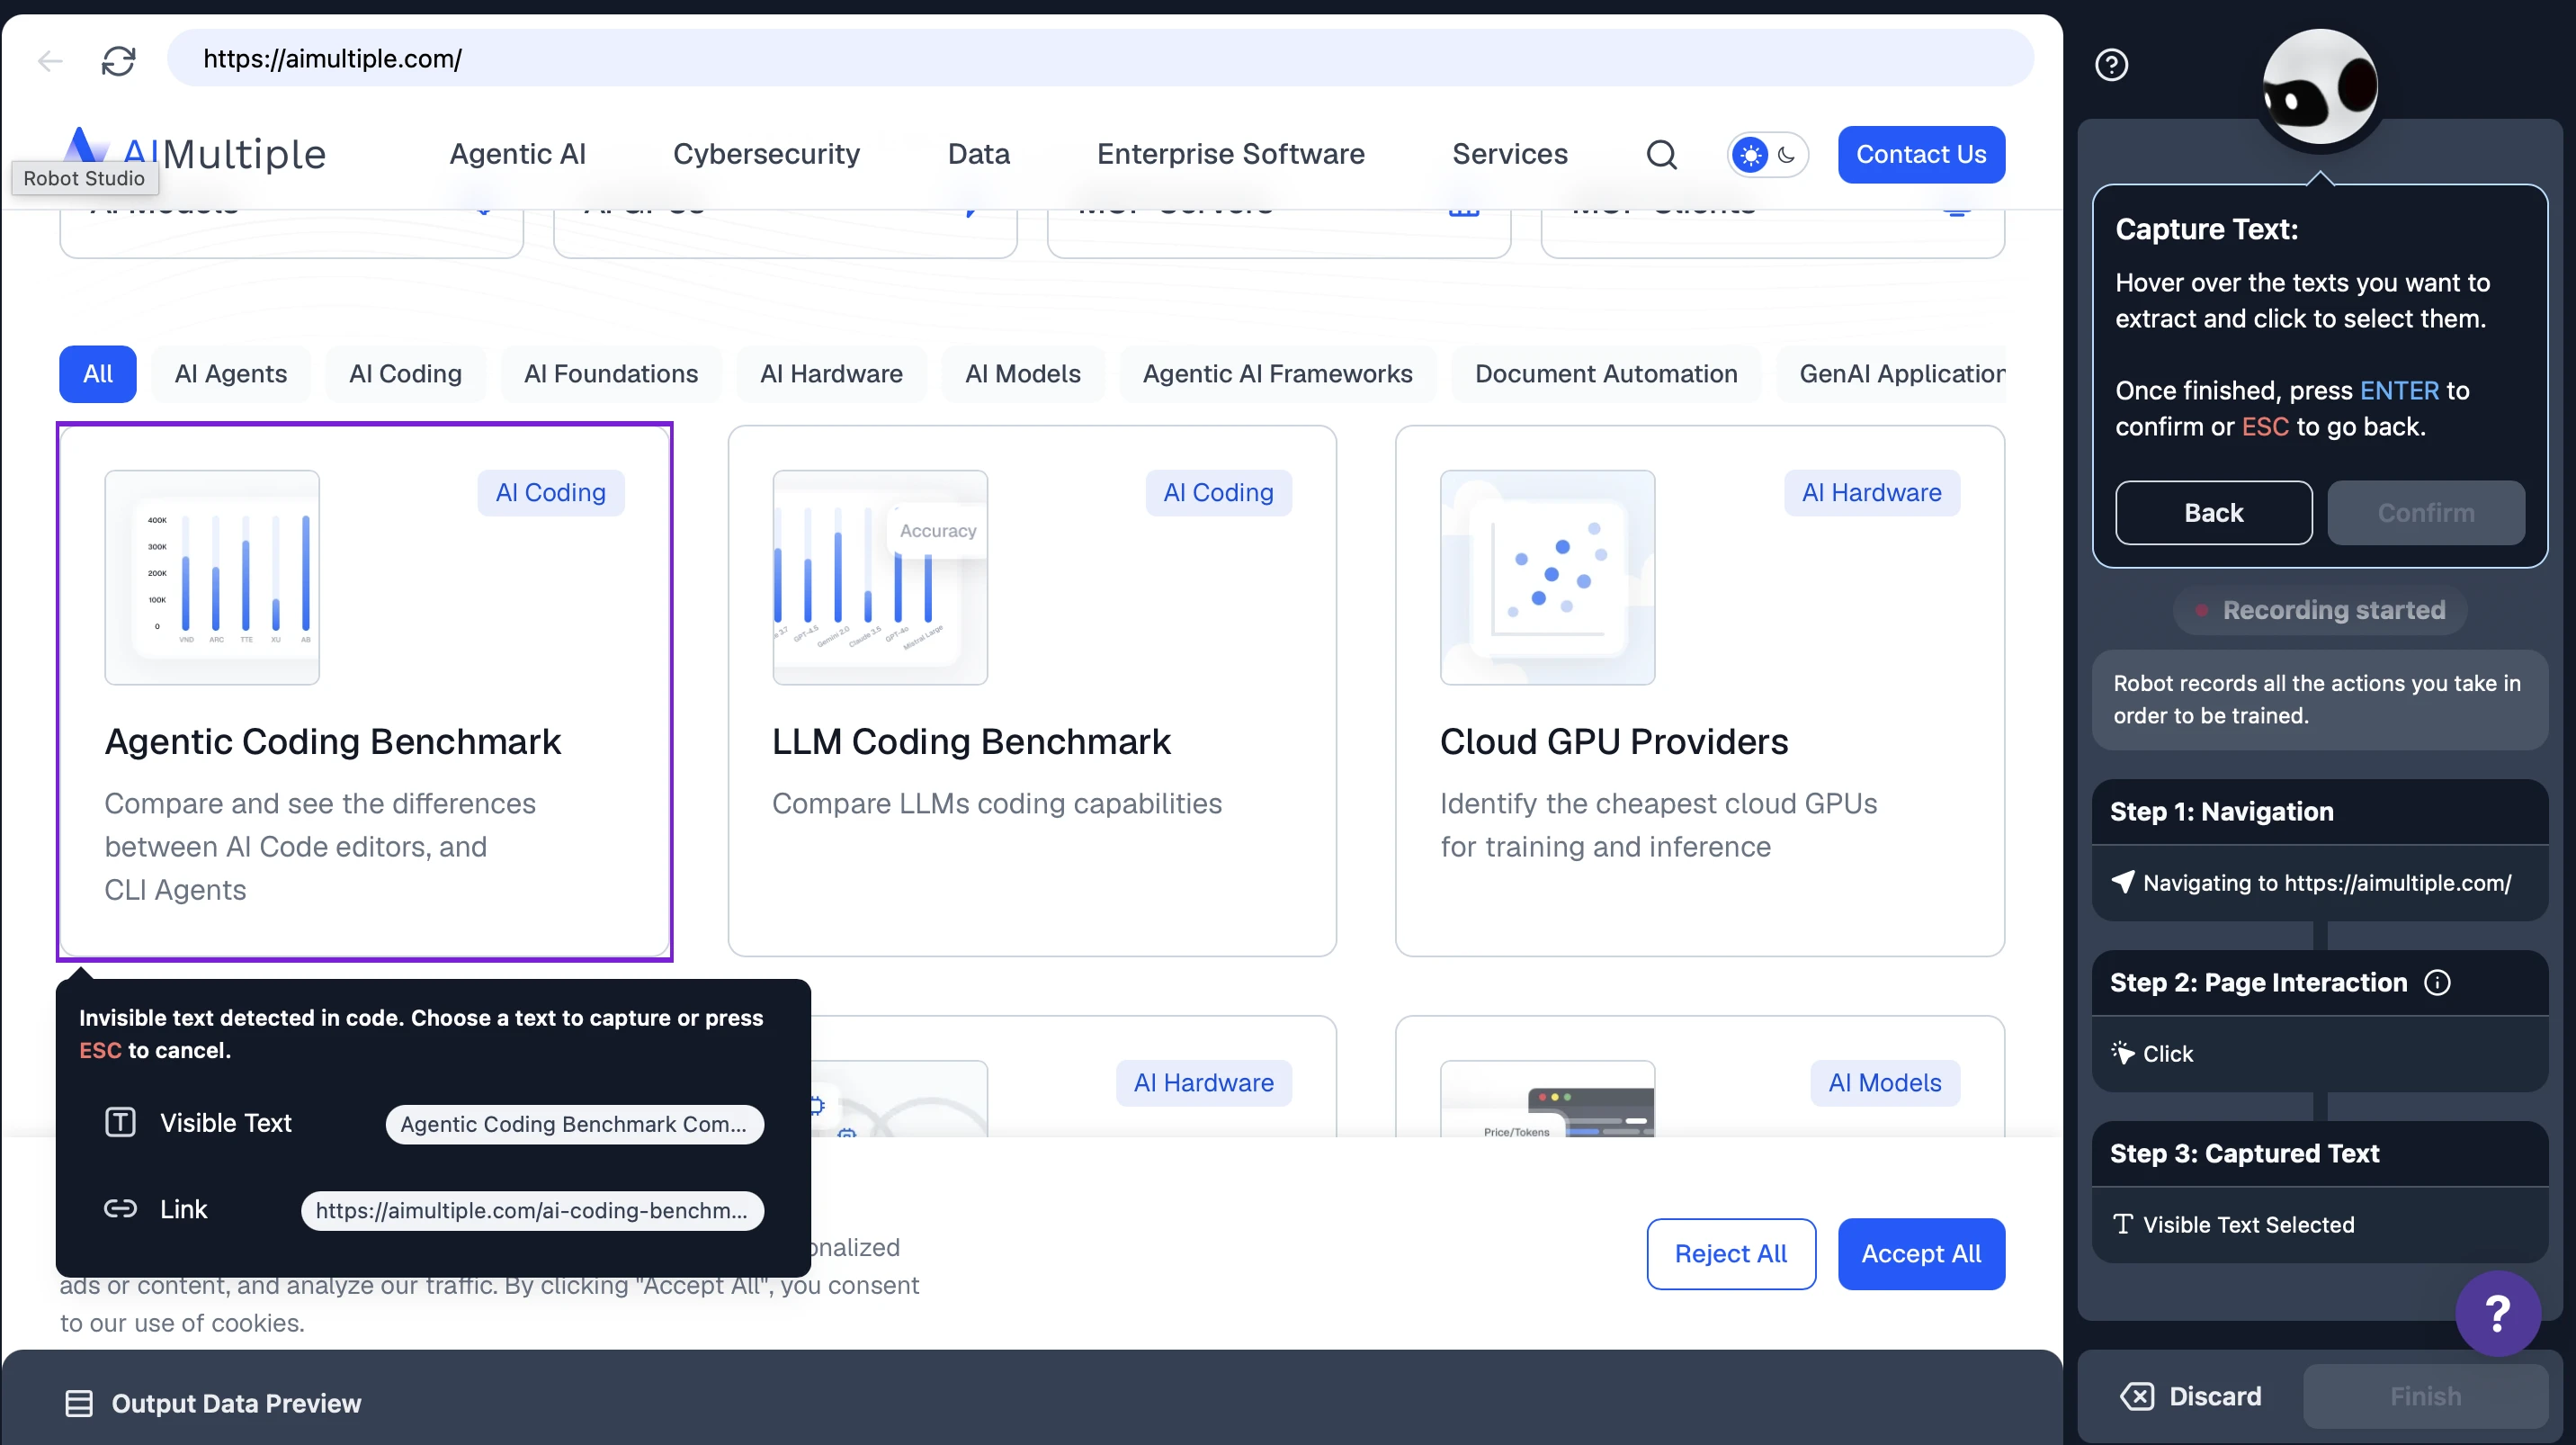
Browse IA construit des scrapers, appelés robots, à partir d'un enregistrement visuel. Vous ouvrez la page cible et cliquez sur les champs à capturer. Le robot enregistre les étapes de navigation et les champs sélectionnés sous forme d'enregistrement, puis le rejoue à chaque exécution.
- Configuration visuelle avec Robot Studio : Les scrapers sont construits selon un flux clic → capture du champ → sauvegarde.
- Surveillance et alertes intégrées : Planifications horaires, quotidiennes ou hebdomadaires, détection des changements et alertes par e-mail ou webhook dans le même produit.
- Le schéma est formé à partir des champs capturés : Une étape de capture distincte est ajoutée pour chaque champ ; pas de génération de schéma à partir d'un prompt.
- Adaptation automatique : Le moteur de Browse IA adapte le code de scraping lorsqu'un site change, et la plupart des robots continuent de fonctionner sans intervention. Lorsque l'adaptation ne suffit pas, vous réentraînez le robot, ce qui préserve son historique, ses exécutions et ses workflows.
Kadoa construit un scraper, appelé workflow, à partir d'un prompt et le stocke sous forme de code généré, afin de disposer d'un artefact concret à surveiller et à réparer.
- Endpoint à construction unique et appels multiples : Un workflow enregistré reçoit un identifiant persistant et est appelé avec
PUT /v4/workflows/{id}/run. La requête ne transporte que des variables et une limite de lignes ; le schéma et le code d'extraction restent du côté de Kadoa. Orienter le même workflow vers une URL différente implique d'abord de mettre à jour ses métadonnées, ce n'est donc pas un simple appel contenant une URL. - Du prompt au schéma typé : Vous décrivez les données dans le prompt de configuration et Kadoa propose un schéma que vous modifiez dans une vue visuelle ou JSON. Les champs portent des types tels que STRING, NUMBER, MONEY, DATE et LINK, et peuvent être marqués comme clés.
- Scraper enregistré auto-réparant : La réparation est déclenchée par une exécution échouée plutôt que par une planification. Kadoa régénère le code d'extraction et le valide par rapport aux données précédemment extraites, sous le même identifiant de workflow, de sorte que les planifications et les intégrations continuent de fonctionner. Il n'y a pas d'étape d'approbation avant la mise en ligne de la correction. Lorsque la récupération automatique échoue, un ticket est transmis à l'équipe opérationnelle de Kadoa.
- Workflow avec agents de codage : Un serveur MCP hébergé avec plus de 40 outils, plus des SDK Node et Python internes et une CLI (
kadoa create,kadoa run,kadoa export). - Livraison : API, SDK, CLI, MCP et Google Sheets pour le pull ; S3, GCS, Azure Blob, webhooks, WebSockets, e-mail et Slack pour le push ; Snowflake et Databricks pour le partage. Les connecteurs de stockage cloud sont configurés via le support plutôt qu'en libre-service.
APIs d'extraction IA en un seul appel
Les APIs d'extraction IA en un seul appel ne stockent aucun scraper. Chaque appel envoie une URL avec un prompt ou un schéma, et l'outil récupère la page et exécute l'extraction par LLM au moment de la requête. Oxylabs IA Studio, l'Actor IA Web Scraper d'Apify, Firecrawl et ScrapingBee fonctionnent de cette manière.
Oxylabs IA Studio est une suite de cinq applications d'IA distinctes sous un seul SDK (pip install oxylabs-ai-studio) : AiScraper, AiCrawler, BrowserAgent, AiSearch et AiMap. Rien n'est persisté côté serveur, chaque appel de scraping exécute une nouvelle récupération plus une extraction LLM.
- Flux AiScraper : generate_schema(prompt=…) appelle éventuellement le LLM pour produire un schéma JSON, puis scrape(url, schema) récupère la page et exécute l'extraction LLM. Vous pouvez conserver et réutiliser le schéma de votre côté, mais le serveur n'enregistre pas de scraper persistant.
- Cinq applications, un seul SDK : AiScraper pour l'extraction structurée à URL unique, AiCrawler pour le parcours de site piloté par prompt, BrowserAgent pour les actions sur la page, AiSearch pour la recherche en langage naturel plus extraction, et AiMap pour des cartes d'URL filtrées d'un site.
- Formats de sortie : markdown (par défaut), json, csv, toon (un format optimisé pour les tokens), screenshot, et html (agent navigateur uniquement).
- Schémas écrits à la main :
generate_schemaest facultatif. Le paramètreschemaaccepte tout schéma JSON que vous écrivez, et les exemples fournis par Oxylabs passent un modèle Pydantic écrit à la main. Un schéma est obligatoire pour la sortie JSON, CSV et TOON. - Paramètres notables : render_javascript="auto" laisse le service décider si le rendu JS est nécessaire, geo_location prend un code pays ISO ou un nom pour la localisation du proxy, et max_credits définit un plafond de dépenses par requête.
Apify propose un écosystème de développeurs ouvert où les « Actors », des programmes exécutables de scraping et d'automatisation, sont construits et exécutés sur sa plateforme. Vous pouvez écrire votre propre Actor à partir de zéro, partir d'un modèle prêt à l'emploi ou utiliser des Actors publiés par d'autres dans le Store Apify.
- Acteur d'extraction IA : Apify dispose également d'un Actor apify/ai-web-scraper prêt à l'emploi qui prend un prompt en langage naturel et renvoie du JSON structuré à partir de n'importe quelle URL. Vous ressaisissez le prompt à chaque exécution, et la sortie JSON n'est pas garantie de rester cohérente d'un appel à l'autre, ce qui est un comportement courant pour les outils pilotés par prompt.
- Prompt uniquement : L'entrée de l'Actor comporte cinq champs :
startUrls,extractionMode,prompt,maxPagesToVisitetmaxCrawlDepth. Il n'existe aucun paramètre pour un schéma de sortie défini par l'utilisateur. - Construisez votre propre Actor : S'il n'existe aucun scraper prêt pour votre site cible ou si aucun d'eux n'extrait les champs de données souhaités, vous écrivez votre propre Actor et décidez quels champs extract, où ils se trouvent sur la page et comment gérer le reste. La durée dépend de vos compétences en codage et de la complexité du site. Si vous préférez ne pas le construire vous-même, vous pouvez également obtenir de l'aide auprès des services professionnels d'Apify.
- Combiné avec des scrapers prêts à l'emploi : le Store d'Apify répertorie les Actors publiés par les développeurs. La plupart des scrapers pour les sites populaires sont publiés et maintenus par des développeurs tiers.
- Services de la plateforme : Les Actors sont livrés avec planification, surveillance, stockage de datasets, pool de proxies et accès API prêts à l'emploi.
- Accès par agent : Apify dispose d'un serveur MCP qui permet à un agent de codage de rechercher et d'exécuter des Actors, mais il n'existe pas de flux intégré pour construire ou maintenir un Actor depuis l'agent.
- Responsabilité de la maintenance : Si vous avez construit l'Actor vous-même, vous le corrigez lorsque le site change. Si vous en utilisez un du Store, vous attendez que le propriétaire de l'Actor publie la correction selon son calendrier.
Firecrawl transforme une URL plus un prompt ou un schéma JSON en JSON en un seul appel synchrone. Chaque requête exécute le pipeline d'extraction au moment où l'appel est effectué.
- Prompt ou schéma : Un schéma fixe les noms et types des champs avant l'appel, de sorte que la réponse ne contient que les champs que vous avez nommés. Un prompt laisse la structure au modèle, ce qui est plus rapide à écrire mais peut varier d'un appel à l'autre.
- Formats par type de page :
product,menu,branding,audioetvideorenvoient une structure fixe définie par Firecrawl.productcouvre le titre, le prix, la disponibilité, les variantes et le prix soldé. Ils ne prennent aucun paramètre et s'exécutent sans LLM. deterministicJson: Prend un schéma et met en cache un extracteur généré par site, de sorte que les scrapings répétés évitent le LLM. Ne peut pas être combiné avec le formatjson.- Exécution par requête : Chaque appel transporte son propre prompt ou schéma et s'exécute au moment de la requête, de sorte que la sortie reflète la page telle qu'elle se présente à cet instant et qu'il n'y a rien à enregistrer au préalable.
- Prise en charge des agents de codage : Serveur MCP et CLI officiels, avec des guides de démarrage rapide pour Claude Code, Cursor, Codex CLI et Gemini CLI, ainsi qu'un plugin officiel Claude.
- Agent : Firecrawl propose également un produit Agent où l'URL est facultative. Vous décrivez ce que vous voulez et l'agent navigue sur le Web pour le trouver.
ScrapingBee est une API d'extraction en un seul appel comme Firecrawl : chaque appel est indépendant et ne stocke rien. ScrapingBee se distingue par la manière dont vous décrivez les données souhaitées.
- Trois modes d'extraction : ai_query pour un champ unique en langage naturel (renvoie une chaîne), ai_extract_rules pour un schéma JSON où chaque champ possède sa propre description, et une forme avancée de celui-ci avec des types, des énumérations et une sortie imbriquée.
- ai_selector : Passez un sélecteur CSS pour concentrer le LLM sur une partie spécifique de la page. Plus rapide et plus précis que de le laisser lire l'intégralité du DOM.
- Scraping classique dans le même appel : render_js pour les sites riches en JS, screenshot, extract_rules pour l'extraction CSS/XPath sans IA, et json_response pour obtenir HTML, cookies, XHR et iframes dans une seule enveloppe.
Comment choisir le bon outil pour votre pipeline ?
Le bon outil dépend de la fréquence à laquelle votre pipeline scrape les mêmes sites et de qui assure la maintenance du scraper :
Scraping ponctuel ou occasionnel
Pour un scraping ponctuel ou occasionnel, les APIs d'extraction IA en un seul appel telles que Firecrawl, ScrapingBee et Oxylabs IA Studio sont l'option la plus rapide. Vous envoyez un prompt ou un schéma avec chaque appel, et il n'y a aucun scraper à construire.
Scraping répété dans un pipeline
Pour un scraping répété, ou lorsque vous avez besoin de champs de données personnalisés, une plateforme à construction unique et appels multiples telle que Bright Data Scraper Studio, Browse IA ou Kadoa convient mieux. Le scraper stocké renvoie le même schéma à chaque appel, et votre pipeline ne fournit que des URL.
Durée de la configuration
La durée de construction varie selon l'approche. Écrire un scraper ou un actor à partir de zéro prend généralement des jours, voire des semaines, car le crawler, la configuration des proxies et les nouvelles tentatives sont à votre charge. Les plateformes basées sur les prompts génèrent le schéma et le code en quelques minutes. Les outils basés sur l'enregistrement prennent également quelques minutes, avec une configuration par pointer-cliquer au lieu d'un prompt. Les APIs d'extraction IA en un seul appel suppriment l'étape de construction ; la première réponse revient en un seul appel HTTP.
Site déjà couvert par un scraper prêt
Un scraper prêt pour un site populaire est généralement plus rapide que de construire le vôtre, mais sa maintenance dépend de sa provenance. Une bibliothèque maintenue par le fournisseur, comme celle de Bright Data, est mise à jour par le fournisseur lorsque le site change. Un scraper tiers, comme la plupart des Actors de sites populaires dans le Store d'Apify, est corrigé selon le calendrier de son propriétaire.
Site non couvert par une solution prête
Pour les sites sans scraper prêt, la question est de savoir qui corrige le scraper lorsque la mise en page change. Si vous construisez le vôtre, vous le maintenez. Avec un outil basé sur l'enregistrement tel que Browse IA, le robot s'adapte seul à la plupart des changements, et vous le réentraînez lorsqu'il ne le peut pas. Avec l'auto-réparation IA, l'outil répare votre scraper stocké sous le même identifiant : Bright Data vous montre la correction pour approbation avant sa mise en ligne, tandis que Kadoa l'applique automatiquement.
Construction avec des agents de codage
Si votre workflow passe par Claude Code, Cursor ou Codex, il importe que l'outil expose une CLI ou une intégration MCP que l'agent peut piloter de bout en bout, ou que l'agent puisse uniquement passer un simple appel HTTP vers une API.
 Ajouter comme source préférée
Méthodologie du benchmark du web scraping IA
Domaines du benchmark :
Les dix domaines du benchmark de web scraping IA proviennent du classement Semrush des sites les plus visités. Cinq sont des sites e-commerce (amazon, ebay, etsy, aliexpress, walmart) et cinq des réseaux sociaux (facebook, instagram, reddit, tiktok, x). Nous avons collecté 500 URL de chacun, 5 000 au total, et les avons toutes envoyées aux cinq outils, soit 25 000 requêtes.
Prompts :
Chaque outil a reçu exactement le même prompt pour un type de page donné, sans réglage spécifique à l'outil :
- E-commerce : Extract le prix et la devise du produit et renvoyer du json
- Réseaux sociaux : Extract le texte du post, le nombre de likes et le nom d'utilisateur de l'auteur du post et renvoyer du json
Bright Data prend le prompt une étape plus tôt que les autres. Plutôt que de scraper à partir d'un prompt à chaque appel, vous lui donnez le prompt une seule fois et il construit un scraper, renvoyant un identifiant de collecteur que vous appelez ensuite de manière répétée. Cette étape de construction n'est pas du scraping, c'est l'outil qui génère une API, et elle se produit une fois par domaine avant le début du benchmark, elle n'est donc pas incluse dans les mesures. Nous avons mesuré à partir de l'identifiant du collecteur, là où le processus correspond aux quatre autres. Pour le garder en zéro shot, le schéma généré par Bright Data a été accepté automatiquement tel qu'il est revenu de l'API, sans révision ni correction.
Chaque outil a été appelé selon la manière dont sa propre API est conçue. Bright Data, Apify et Firecrawl sont conçus pour prendre une liste d'URL en une seule requête, nous avons donc envoyé 100 URL par requête. Oxylabs et ScrapingBee ne sont pas conçus ainsi, leurs APIs prennent une URL à la fois, c'est donc ainsi que nous les avons appelés. La concurrence était la même pour chaque outil, cinq requêtes parallèles.
Indicateurs :
Le succès est la part des requêtes qui sont revenues avec au moins un des champs demandés. Les chaînes vides, les zéros à la place d'un nombre et les réponses qui répètent le prompt ne comptent pas comme un champ.
L'exhaustivité correspond au nombre de champs demandés qui sont revenus, en moyenne sur l'ensemble des requêtes. Une page sociale où seul l'auteur arrive obtient un score de un sur trois.
La précision est la part des valeurs vérifiables qui étaient correctes. Un champ que l'outil n'a jamais renvoyé compte comme faux, car en aval, une valeur manquante et une valeur erronée coûtent la même chose.
Chaque mesure est calculée par domaine, puis moyennée sur les dix.
Établir la bonne réponse
Nous avons utilisé deux méthodes. Lorsque la vérité de terrain était disponible, nous avons comparé à celle-ci : certaines réponses se trouvent dans l'URL elle-même, comme le pseudonyme de l'auteur dans un lien x.com ou tiktok.com, et pour d'autres, nous avons collecté une référence indépendante en dehors des cinq outils, comme les prix des produits et les compteurs de votes Reddit.
Lorsqu'aucune vérité de terrain n'existait, nous avons évalué par consensus. Un champ n'est tranché de cette manière que lorsqu'au moins quatre des cinq outils y ont répondu. Nous avons ensuite mis de côté l'outil évalué et examiné le reste : si la même valeur apparaît dans plus de la moitié d'entre eux, et dans au moins deux, cette valeur devient la référence. Un outil ne vote jamais sur sa propre réponse, et un champ sur lequel les autres n'ont pas pu s'accorder est exclu du score de précision.
Les nombres n'ont pas besoin de correspondre exactement. Une valeur est considérée comme correcte dans une marge de 10 % de la référence, avec un petit plancher absolu en plus, de sorte qu'un post avec 5 likes n'échoue pas pour une différence de un, tandis qu'un post avec 90 000 est toujours jugé sur le pourcentage.
Intervalles de confiance
Tous les chiffres comportent des intervalles de confiance à 95 % issus de 10 000 rééchantillonnages bootstrap au niveau des URL. Les données par requête derrière chaque nombre sont publiées avec les résultats.
FAQ
Oui. Les bibliothèques open source telles que Crawl4AI, Skyvern et Browser Use sont gratuit à auto-héberger, et la plupart des outils commerciaux, notamment Browse IA, Firecrawl et Thunderbit, proposent une offre gratuit avec des limites d'utilisation.
Citer cette recherche
Choisissez le format qui correspond à votre lieu de publication. Coller la version avec lien dans votre CMS préserve le lien retour.
@misc{sipi2026,
  author = {Şipi, Nazlı},
  title  = {{Meilleurs outils de web scraping IA évalués}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/ai-web-scraping}},
  note   = {AIMultiple. Consulté le 2 octobre 2026}
}Résultats et horodatages de 25.1 mille points de données. Téléchargez les données de synthèse présentées dans les graphiques et les tableaux de cet article sous forme de fichier ZIP contenant 7 fichiers CSV et un README.
Vous voulez les données détaillées derrière ? Rejoindre Premium
Journal des modifications
5 mises à jourAjout d'une section de benchmark comparant les outils de web scraping IA sur les principaux sites e-commerce.
Remplacé la liste d'outils par des entrées nommées pour Browse AI, Firecrawl, ScrapeGraphAI, Diffbot, Kadoa, Skyvern et d'autres, et ajouté une section FAQ.
Remplacement de l'introduction aux outils de web scraping IA par une description des agents IA autonomes, du scraping basé sur la vision (VLM) et des scrapers auto-réparateurs.
À lire ensuite
Top 5 des extensions Chrome gratuites pour le Web Scraping

Le scraping web est-il légal ? Lois et bonnes pratiques
Web Scraping à Grande Échelle: 7 Fournisseurs Évalués


Meilleures bibliothèques Python pour le web scraping
Nous avons comparé les meilleurs outils de web scraping
Web Scraping pour les recruteurs: meilleurs outils et techniques





Soyez le premier à commenter
Votre adresse courriel ne sera pas publiée. Tous les champs sont obligatoires. Les commentaires sont laissés dans leur langue d'origine.